COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
207.1. Transmitir un mensaje cuando la salida puede cambiar
La codificación sin pérdida supone que podemos interpretar la representación recibida. Un canal ruidoso añade otra dificultad, porque lo que llega puede diferir de lo que se envió. El problema consiste en recuperar mensajes con una probabilidad de error controlada y con recursos limitados.
Podemos responder añadiendo estructura al mensaje. De todas las secuencias posibles, usamos como mensajes solo un conjunto de secuencias suficientemente separadas según las perturbaciones del canal; así, algunas modificaciones pueden reconocerse y corregirse.
La redundancia añadida reduce la cantidad de mensajes distintos por uso del canal, pero puede aumentar la fiabilidad. La teoría de capacidad pregunta cuál es la mayor tasa compatible con un error que pueda hacerse arbitrariamente pequeño bajo condiciones especificadas.
La capacidad es un límite de un modelo de transmisión que depende de las probabilidades de error, de las restricciones de entrada y de la definición de uso del canal. No debe confundirse con una velocidad comercial, un tamaño de almacenamiento o una frecuencia de envío de símbolos.
Tampoco implica que un código corto funcione sin errores en ese límite. Los resultados fundamentales suelen considerar familias de códigos con bloques cada vez más largos. La existencia de un límite asintótico y la construcción de un procedimiento eficiente son cuestiones relacionadas pero distintas.
Este capítulo presentará canales discretos sin memoria, códigos sencillos y ejemplos de capacidad. Después examinaremos qué cambia al exigir error exactamente cero, al limitar el tamaño de bloque o al introducir restricciones físicas.
La finalidad es mantener conectados modelo, tasa, error y recursos. Un número aislado de capacidad carece de interpretación si no sabemos a qué canal corresponde ni qué condiciones sostienen el resultado.
207.2. Un canal como distribución condicional
Un canal discreto se describe mediante la distribución condicional , que da la probabilidad de recibir una salida cuando enviamos una entrada ; para cada entrada, las probabilidades de salida suman uno.
Si elegimos una distribución de entradas , obtenemos una distribución conjunta y podemos calcular la información mutua entre lo enviado y lo recibido. Esa cantidad depende tanto del canal como del modo en que usamos sus entradas.
La capacidad de un canal discreto sin memoria y sin restricciones adicionales es
Con logaritmos binarios, se mide en bits por uso del canal. Si hay un costo, una limitación de potencia o una distribución de entrada obligatoria, el conjunto de distribuciones admisibles debe restringirse.
La condición sin memoria significa que, dada una secuencia de entradas, las salidas se producen mediante el producto de las reglas individuales. No implica que las entradas codificadas sean independientes; un código puede introducir dependencias deliberadas entre ellas.
La memoria del canal describe cómo una perturbación relaciona usos sucesivos, mientras que la estructura del código describe cómo seleccionamos y organizamos las entradas para representar mensajes. Confundirlas puede invalidar una fórmula de capacidad.
Un canal determinista puede perder información si varias entradas producen la misma salida. Un canal aleatorio puede conservar parte de la información si sus distribuciones de salida distinguen entradas. La mera presencia de azar no decide si la capacidad es cero.
Si todas las entradas producen exactamente la misma distribución de salidas, observar la salida no permite distinguir qué se envió y la capacidad es cero. La salida puede seguir siendo muy variable, pero esa variabilidad no informa sobre la entrada.
La matriz del canal debe estimarse o justificarse para el régimen de uso. Los cambios de ruido, la deriva de los sensores o la dependencia temporal pueden hacer que una capacidad calculada para un modelo ideal no describa el sistema real.
207.3. El canal binario de inversión
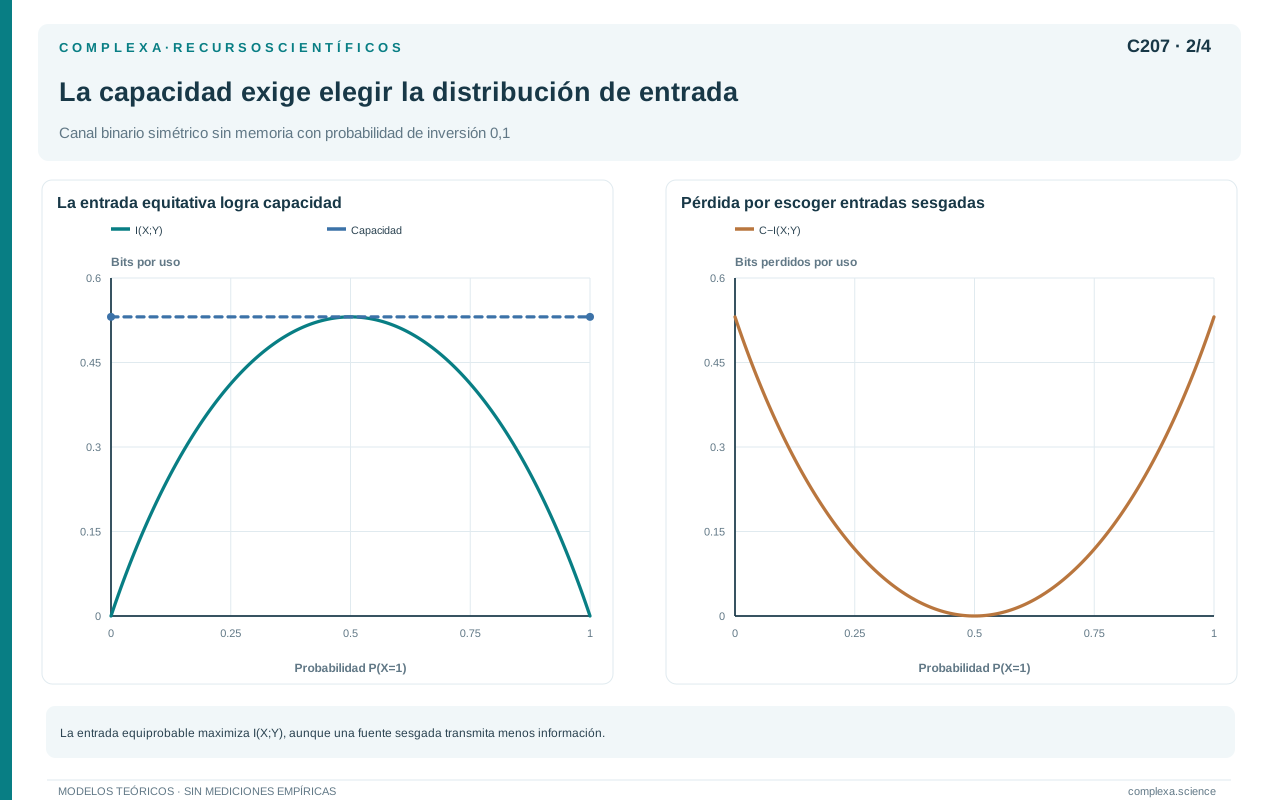
En un canal binario simétrico, cada bit cambia con probabilidad y permanece igual con probabilidad . Consideraremos inversiones independientes entre usos del canal.
Si la probabilidad de enviar uno es , la probabilidad de recibir uno es . La entropía de la salida condicionada a la entrada es , independientemente de la distribución elegida para la entrada.
La información mutua resulta
La entropía binaria de salida no supera un bit. Ese máximo se alcanza con entradas equiprobables, de modo que
Con una probabilidad de inversión de una décima, la capacidad es aproximadamente bits por uso; con una centésima, aumenta a aproximadamente . Ambos valores son tasas máximas asintóticas bajo el modelo y no deben confundirse con probabilidades de acierto.
Cuando la inversión tiene probabilidad de un medio, la salida es independiente de la entrada y la capacidad es cero. Cuando la inversión es segura, el receptor puede deshacerla y la capacidad vuelve a un bit.
La capacidad es simétrica respecto de sustituir la probabilidad de inversión por su complemento. Una tendencia sistemática conocida a invertir puede corregirse mediante otra inversión; el problema reside en la incertidumbre sobre qué usos cambiaron.
Si usamos una distribución de entradas muy desigual, la información mutua puede ser menor que la capacidad. La capacidad corresponde a la mejor utilización permitida, que una fuente cualquiera no tiene por qué alcanzar.
En una aplicación debemos además distinguir error por bit sin codificación, error de símbolos codificados y error del mensaje reconstruido. Una misma probabilidad básica de inversión puede producir resultados muy diferentes según el código y el tamaño del mensaje.
La fórmula es exacta para el modelo indicado, pero no incluye errores en ráfagas, pérdidas de sincronización ni inserciones o eliminaciones de bits. Esas perturbaciones requieren canales y procedimientos de decodificación diferentes.
207.4. Borrado conocido y error desconocido
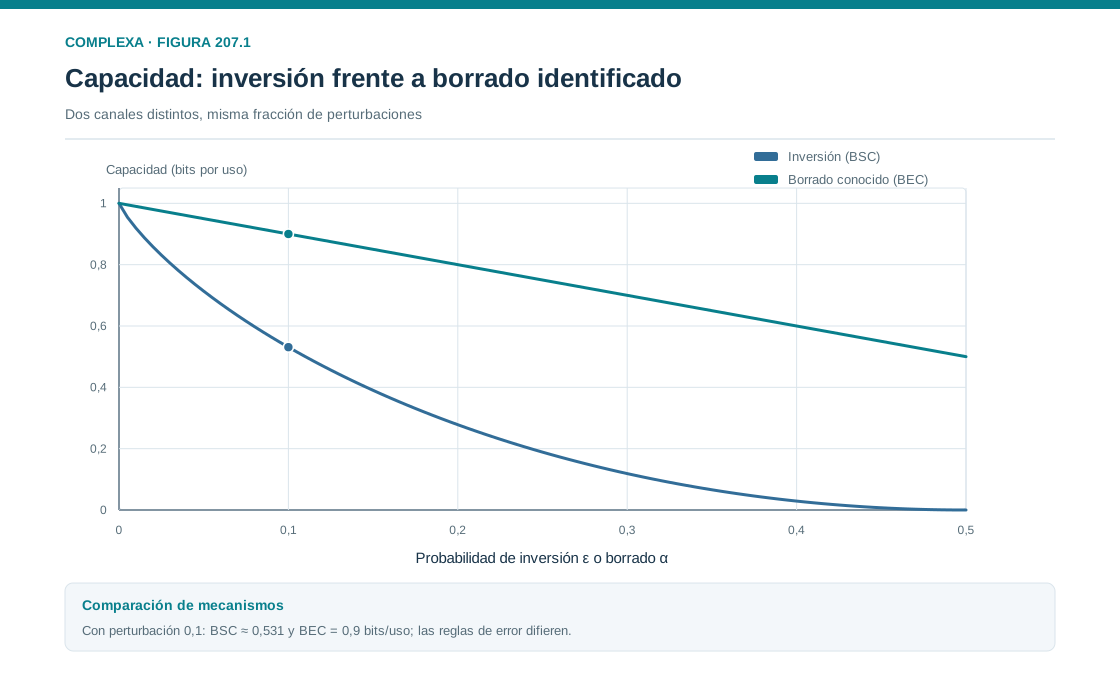
Un canal binario de borrado conserva cada bit con probabilidad y lo reemplaza por una marca explícita de ausencia con probabilidad . El receptor sabe qué posiciones se borraron, aunque no conoce sus valores.
Cuando no hay borrado, la entrada queda identificada. Cuando lo hay y la marca es independiente del valor enviado, permanece su incertidumbre inicial. Por tanto,
La capacidad es bits por uso y se alcanza con entradas equiprobables. Con una décima de borrados vale bits por uso, más que la capacidad del canal binario simétrico con una décima de inversiones.
La comparación se limita a dos mecanismos precisos y no vale para cualquier sistema con pérdidas frente a cualquiera con errores. Conocer la ubicación de una pérdida elimina una incertidumbre que persiste cuando una inversión no está identificada.
La salida tiene tres categorías (cero, uno y borrado). Con entradas equiprobables, su entropía es , que puede superar un bit. La parte correspondiente a saber si hubo borrado no comunica información adicional sobre el valor enviado.
Este ejemplo separa entropía de salida y capacidad. Un canal puede producir nuevas distinciones debidas al ruido o a marcas de estado sin que esas distinciones equivalgan a más información sobre el mensaje.
Una retransmisión podría usar la marca de borrado para pedir datos adicionales. Ese protocolo incorpora nuevos usos del canal y posiblemente una vía de retorno. Su rendimiento debe calcularse contando esos recursos.
La estructura de error también puede orientar el código. Un procedimiento diseñado para borrados conocidos no tiene necesariamente la misma eficacia ante inversiones desconocidas. El modelo del canal forma parte de la justificación de cualquier garantía de recuperación.
Un código de tres posiciones ilustra la ventaja de conocer dónde falta un símbolo. Enviamos dos bits de datos y un tercero igual a su XOR. Si se borra cualquiera de las tres posiciones, las otras dos permiten reconstruirla.
Si falta el bit de paridad, lo calculamos a partir de los datos. Si falta un dato, lo obtenemos combinando el otro con la paridad. La tasa es dos tercios de bit de mensaje por uso del canal y la recuperación es exacta siempre que haya como máximo un borrado.
Con borrados independientes de probabilidad , la probabilidad de dos o tres borrados es . Ese número es la probabilidad de perder la garantía de reconstrucción única y puede no coincidir con la probabilidad final de error si el receptor adivina entre posibilidades.
Ante una inversión desconocida, la misma comprobación de paridad puede indicar una inconsistencia sin identificar cuál de las tres posiciones cambió. Con el mismo código y la misma tasa, lo que cambió es la información disponible sobre la perturbación.
207.5. Tasa, bloques y el significado del teorema de codificación
Un código de bloque asigna a cada mensaje una secuencia de entradas del canal. Si hay mensajes posibles, su tasa es el logaritmo binario de dividido por .
La teoría habitual considera mensajes equiprobables y una probabilidad promedio de error de decodificación. Esa definición difiere, aunque se relaciona con ellas, de las garantías para cada mensaje o para otras distribuciones de uso.
El resultado fundamental afirma, para el canal discreto sin memoria pertinente, que tasas estrictamente inferiores a la capacidad pueden alcanzarse mediante familias de códigos cuya probabilidad de error tiende a cero al crecer el bloque.
Para tasas superiores a la capacidad, en esas mismas condiciones, la probabilidad de error no puede tender a cero. La frontera describe un compromiso entre número de mensajes distinguibles, longitud de transmisión y fiabilidad.
El resultado no indica cuál es el mejor algoritmo para un tamaño concreto. Una demostración de existencia puede usar conjuntos de códigos difíciles de almacenar o decodificar. La ingeniería de códigos busca estructuras que acerquen el rendimiento al límite con recursos viables.
También debemos conservar el carácter asintótico. Un bloque de longitud cien y otro de un millón no dejan el mismo margen respecto de la capacidad para un error pequeño. La latencia y el costo de esperar a completar un bloque pueden importar tanto como su tasa.
La capacidad tampoco es una promesa de error exactamente cero. Hacer la probabilidad de error arbitrariamente pequeña admite eventos raros de fallo; exigir que ningún patrón permitido por el canal produzca error es otra pregunta.
La compresión de la fuente y la protección del canal pueden analizarse como etapas separadas bajo condiciones apropiadas. La primera reduce la tasa necesaria para representar la fuente; la segunda añade estructura para transmitir esa representación con fiabilidad.
Esa separación ideal puede requerir bloques largos y modelos compatibles. En sistemas con restricciones estrictas de tiempo, variaciones rápidas o costos particulares, el diseño conjunto puede presentar compromisos que una comparación simple de tasas no resuelve.
La diferencia entre error promedio y peor mensaje puede reducirse asintóticamente mediante una selección. Si el error promedio de un código es , al menos la mitad de sus mensajes tienen error individual no mayor que ; de otro modo, el promedio superaría el valor declarado.
Conservar únicamente esa mitad produce un código cuyo error máximo está acotado por el doble del promedio original. El número de mensajes se reduce como máximo a la mitad y la tasa disminuye en no más de un bit dividido por la longitud del bloque.
Esta cuenta explica cómo se relacionan ambos criterios en el régimen de bloques grandes. En un código finito, sin embargo, los dos errores pueden diferir y sigue siendo necesario declarar cuál se midió; un promedio pequeño puede coexistir con algunos mensajes particularmente difíciles.
207.6. Repetición y un código que corrige un error
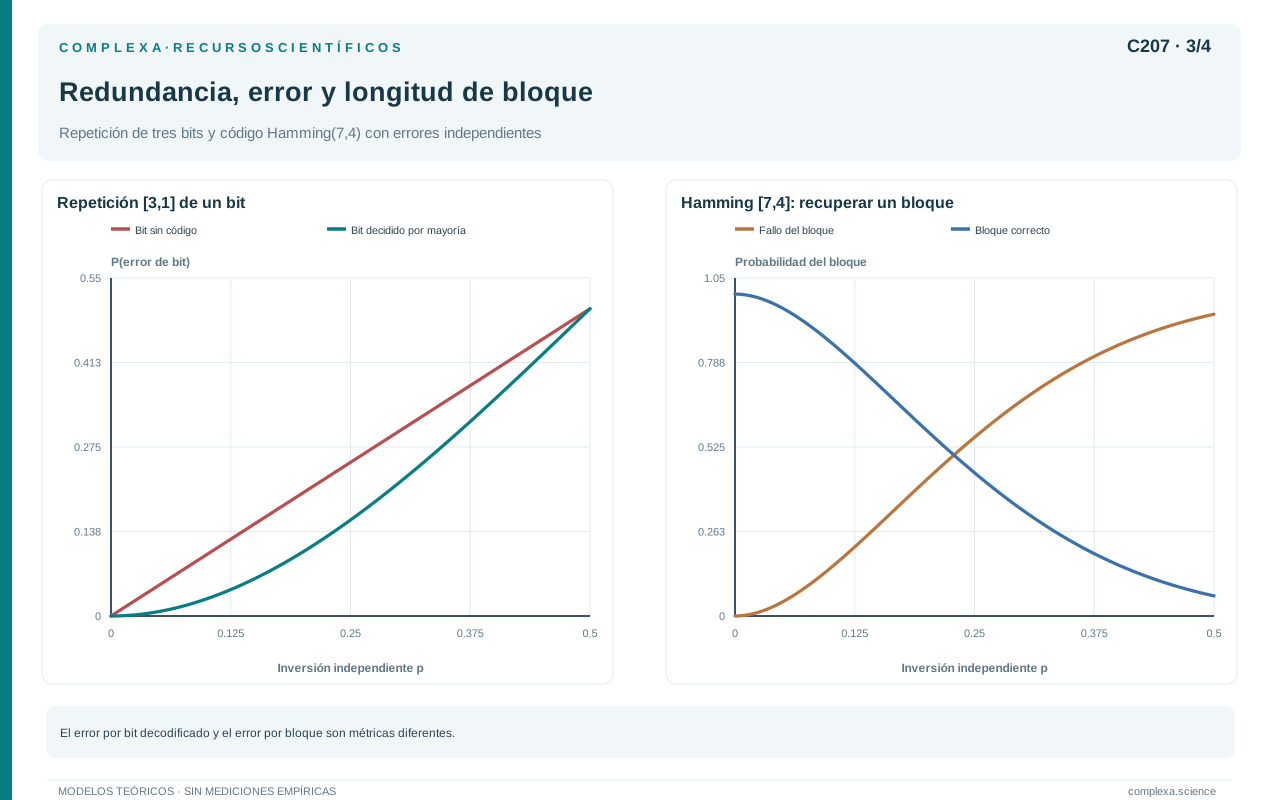
Una estrategia elemental repite cada bit tres veces y decide por mayoría. En un canal binario simétrico con probabilidad de inversión de una décima, la decisión es incorrecta si ocurren dos o tres inversiones.
La probabilidad de error es . La tasa es un tercio de bit de mensaje por uso del canal; hemos reducido el error a costa de usar tres transmisiones por bit.
La repetición es sencilla, pero de ella no se sigue que podamos alcanzar cualquier tasa inferior a la capacidad con error de bloque decreciente. Si repetimos el mismo código corto para muchos bits, cada decisión conserva su probabilidad de error y el mensaje completo puede fallar en alguna posición.
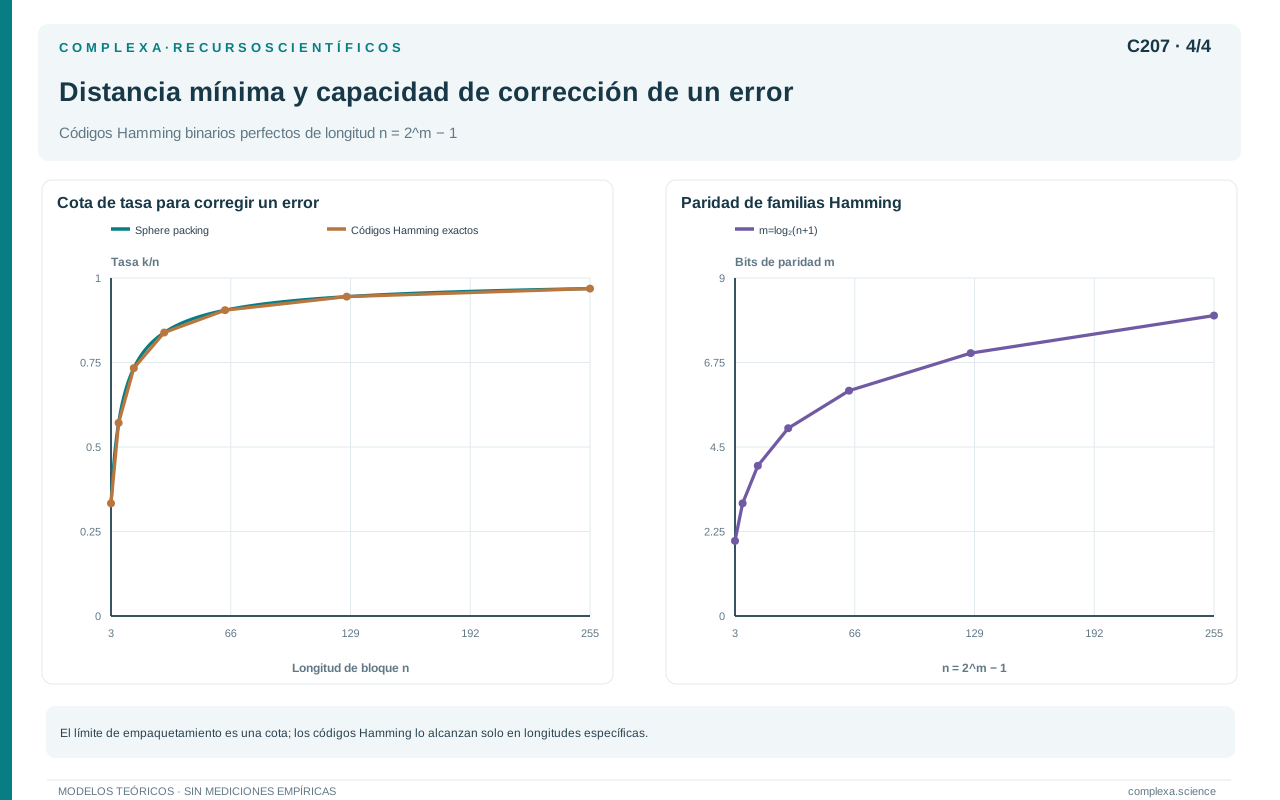
Los códigos de Hamming introducen una estructura más eficiente para ciertos requisitos. El código binario de siete posiciones y cuatro bits de datos puede corregir una inversión mediante tres comprobaciones de paridad.
Los datos van en las posiciones tres, cinco, seis y siete; las paridades, en uno, dos y cuatro. Cada comprobación usa un conjunto de posiciones definido de modo que una inversión única produzca un patrón que identifica su ubicación.
Con datos 1011 en ese orden, una elección de paridades pares produce la palabra 0110011. Si se invierte la posición cinco, recibimos 0110111.
Las comprobaciones sobre las posiciones uno, tres, cinco y siete; dos, tres, seis y siete; y cuatro, cinco, seis y siete producen, respectivamente, los valores uno, cero y uno. Interpretados con los pesos uno, dos y cuatro, identifican la posición cinco.
El receptor corrige esa posición y recupera la palabra original. La operación funciona para cualquier inversión única en este código. Dos inversiones, en cambio, pueden producir un patrón que el decodificador interprete como otra inversión única y conducir a una corrección equivocada.
Debemos separar detección y corrección. Una distancia mínima de tres permite corregir una inversión o, si solo verificamos la pertenencia al código, detectar hasta dos. Lo que no garantiza es detectar dos inversiones si corregimos indiscriminadamente todo patrón como si fuera un único error.
La tasa del código es cuatro séptimos. Su utilidad depende de la probabilidad de errores y del criterio de fallo. Un código finito con una tasa concreta no contradice el límite de capacidad si acepta una probabilidad de error positiva.
La distancia mínima del código de Hamming puede comprobarse mediante sus columnas de paridad. Cada posición tiene un patrón de comprobaciones distinto y no nulo. Por ello, una inversión produce un síndrome no nulo; dos inversiones producen la suma binaria de dos columnas distintas, que tampoco es cero.
Hay, en cambio, tres columnas cuya suma binaria es cero, como las de las posiciones uno, dos y tres. Esa propiedad explica que la distancia mínima sea tres y que una perturbación de peso tres pueda transformar una palabra válida en otra.
Para el decodificador que corrige cualquier síndrome como una inversión única, la palabra original se recupera exactamente cuando hubo cero o una inversiones. Con inversiones independientes, la probabilidad de error de bloque es
Con inversión de una décima, vale aproximadamente ; con una centésima, disminuye a aproximadamente . El cálculo se refiere al error del mensaje completo de cuatro bits; el error promedio de cada bit de datos es otra cantidad.
La tasa de cuatro séptimos supera la capacidad del canal con inversión de una décima, pero el código acepta un error de bloque apreciable y no ofrece una familia de esa tasa con error arbitrariamente pequeño. Comparar únicamente su tasa con la capacidad y omitir el error produciría una aparente contradicción.
La repetición de bloques cortos muestra otra diferencia. Si codificamos cada bit tres veces y transmitimos un mensaje de bits con errores independientes, la probabilidad de al menos una decisión equivocada es .
Esa probabilidad tiende a uno al aumentar el número de bits del mensaje, aunque cada bit individual tenga un error relativamente pequeño. La fiabilidad del bloque completo exige un diseño que controle el evento pertinente a esa escala.
207.7. Por qué superar la capacidad impide fiabilidad arbitraria
Podemos ver el límite mediante una cota de incertidumbre residual. Si un mensaje uniforme entre posibilidades se reconstruye con probabilidad de error , la desigualdad de Fano acota la entropía condicional del mensaje en función de esa probabilidad.
Una forma útil acota esa entropía por un bit más la probabilidad de error multiplicada por el logaritmo del número de mensajes. El primer término corresponde a indicar si hubo error; si lo hubo, todavía hay que distinguir entre alternativas.
La información que pueden transportar usos del canal discreto sin memoria no supera bajo el modelo habitual. Al combinar esa cota con la incertidumbre residual, obtenemos
Si fijamos una tasa superior a la capacidad y dejamos crecer el bloque, esta desigualdad impide que la probabilidad de error tienda a cero.
El argumento usa el número de mensajes y la información realmente disponible en la salida. Un decodificador más complicado no puede distinguir de manera fiable más posibilidades de las que el canal permite bajo esas condiciones.
Un decodificador deficiente sí puede mejorarse, porque un procedimiento práctico puede estar lejos del límite. La teoría distingue entre el margen de mejora dentro del modelo y las promesas que requerirían cambiar el canal, las restricciones o la información disponible.
La cota también recuerda que error promedio y tasa deben evaluarse conjuntamente, porque un sistema puede aumentar el número de mensajes por bloque aceptando errores mayores.
Para interpretar una afirmación de rendimiento necesitamos además conocer cómo se eligieron los mensajes, qué errores se contabilizan y si se incluyen fallos de sincronización o detección. Una definición favorable del error puede ocultar limitaciones que el usuario final sí experimenta.
La cota de Fano puede entenderse introduciendo un indicador que vale uno cuando la decisión es incorrecta. Ese indicador tiene como máximo un bit de entropía. Si sabemos que no hubo error, el mensaje queda determinado por la decisión; si sabemos que lo hubo, quedan como máximo alternativas.
Si llamamos a la variable mensaje, a su reconstrucción y mantenemos como número de mensajes posibles, obtenemos . La variable aleatoria y el tamaño de su conjunto tienen papeles distintos.
Como la decisión se obtiene de la salida del canal, la salida original no deja más incertidumbre que esa decisión procesada. Combinamos entonces la cota residual con la identidad que descompone la entropía del mensaje en información recibida e incertidumbre restante.
Esta derivación muestra dónde entran las hipótesis. La uniformidad fija la entropía inicial mediante el número de mensajes. El canal sin memoria permite acotar la información de varios usos mediante su capacidad, mientras que la regla de decodificación conecta la salida con el indicador de error.
La desigualdad demuestra que el error no puede desaparecer por encima de la capacidad. Con ella sola no hemos obtenido una tasa exacta de crecimiento del error, ni la forma completa de la frontera a tamaño finito, ni una garantía numérica óptima para cada longitud de bloque.
207.8. Error cero y tamaño finito
En un canal binario simétrico con probabilidad de inversión estrictamente entre cero y uno, cualquier salida binaria de longitud finita tiene probabilidad positiva desde cualquier entrada de esa longitud. Los soportes de salida de mensajes distintos se solapan por completo.
Por tanto, ningún decodificador puede garantizar error exactamente cero para dos mensajes distintos en un bloque finito. Aun así, cuando la probabilidad de inversión difiere de un medio, la capacidad con error que tiende a cero es positiva.
Una probabilidad diminuta puede ser aceptable según un criterio y quedar excluida según otro. Shannon estudió la capacidad de error cero como un problema distinto del límite habitual de fiabilidad asintótica.
El tamaño finito introduce otro compromiso. Para una longitud y una probabilidad de error deseadas, la tasa máxima suele quedar por debajo del límite asintótico. En ese régimen cuentan las fluctuaciones de la información que el canal transmite en un bloque.
Polyanskiy, Poor y Verdú desarrollaron resultados sobre este régimen. Para determinados canales y condiciones, una aproximación normal expresa una penalización de tasa proporcional a la raíz inversa del tamaño de bloque, además de términos de orden menor.
La constante que interviene, llamada dispersión del canal, describe la variación de la información por uso en el régimen correspondiente. No debe confundirse con la varianza física del ruido ni usarse sin verificar las condiciones de la aproximación.
Una tasa calculada con esa aproximación no garantiza el rendimiento de un código implementado; para eso hacen falta cotas o análisis del código y del canal concretos. La aproximación ayuda a comprender escalas y a comparar posibilidades.
Un bloque más largo puede mejorar la eficiencia y la fiabilidad, pero exige más memoria, espera y cálculo; la elección práctica pondera esos costos junto con la proximidad a la capacidad.
En un canal binario simétrico no degenerado, una aproximación normal habitual para la tasa a tamaño finito tiene la forma
además de términos menores. Aquí es la probabilidad de error de bloque objetivo y es la inversa de la función de cola de una normal estándar. La dispersión binaria, en unidades de bits al cuadrado por uso, es
Con inversión de una décima, la dispersión es aproximadamente . Para mil usos y error objetivo de una milésima, el término normal principal sugiere una tasa cercana a bits por uso, inferior a la capacidad de .
Ese número solo indica una escala, ya que hemos omitido las correcciones de orden menor y no hemos construido un codificador ni demostrado una cota de rendimiento para él. La distinción es necesaria cuando una aproximación asintótica se usa con un bloque concreto.
En esta expansión la probabilidad objetivo se mantiene fija mientras crece la longitud. Para el canal binario simétrico considerado, los dos términos principales se aplican tanto al criterio de error máximo como al promedio; eso no implica que ambos errores coincidan en cualquier código. Si el error objetivo también disminuye con la longitud, hay que revisar el régimen asintótico.
Si disminuimos el error exigido, el cuantil aumenta y la penalización principal crece. Si alargamos el bloque, esa penalización disminuye. La fórmula hace explícito un compromiso que una única cifra de capacidad oculta.
207.9. Restricciones físicas y límites de un modelo
En un canal continuo, permitir amplitudes o precisión ilimitadas puede producir capacidades que no corresponden a ningún sistema físico realizable. Las restricciones de potencia, resolución, ancho de banda o costo deben formar parte del modelo.
Para un uso real de un canal gaussiano aditivo, con ruido independiente de varianza y una restricción de potencia media sobre la entrada, la capacidad es
bits por uso real, bajo las condiciones habituales del modelo. El factor y las unidades dependen de qué llamamos un uso; no debemos trasladar esta expresión a bits por segundo sin introducir una escala temporal.
Son indispensables la restricción de potencia, el carácter gaussiano e independiente del ruido y la manera de usar el canal. La fórmula no se aplica directamente a señales con saturación, interferencias variables o memoria.
La derivación se apoya en que, cuando el ruido es aditivo e independiente, la información mutua es la entropía diferencial de la salida menos la del ruido. Con una varianza de salida acotada, la distribución gaussiana maximiza la entropía diferencial. Una entrada gaussiana apropiada alcanza esa cota en el modelo ideal.
Al restar las dos entropías gaussianas, sus factores comunes se cancelan y queda el logaritmo de una razón adimensional entre potencia total y potencia de ruido. Por eso cambiar coherentemente las unidades de amplitud no altera la capacidad calculada.
Una razón de potencia a ruido de tres produce un bit por uso real; una razón de quince produce dos. Como la relación es logarítmica, la capacidad no crece en proporción a esa razón. Estos valores son propios del canal gaussiano definido; no valen para cualquier enlace que tenga una medida llamada señal a ruido.
La conversión temporal requiere otra cantidad. Si un canal discreto permite mil usos por segundo y su capacidad es bits por uso, el límite correspondiente es de unos quinientos treinta y un bits por segundo bajo el modelo. Las cabeceras y otras operaciones del protocolo pueden reducir la tasa de datos útiles.
Asimismo, un bloque largo puede ocupar un intervalo de transmisión apreciable aunque su tasa sea eficiente. La capacidad por uso, el rendimiento útil por segundo y la demora hasta decodificar deben presentarse por separado.
En redes, la tasa extremo a extremo depende además de recursos compartidos, rutas, coordinación y protocolos; la capacidad de un enlace aislado es solo uno de los factores que determinan el rendimiento de toda la infraestructura.
Las colas y las demoras plantean preguntas que la información mutua por uso no responde completamente. Un canal puede tener capacidad suficiente en promedio y, aun así, sufrir episodios en que la espera resulta incompatible con una tarea.
En aplicaciones biológicas o sociales, llamar canal a una relación requiere definir entradas, salidas y condiciones de observación. Una información mutua medida en datos no equivale en general a una capacidad, porque quizá no podamos variar libremente la distribución de entradas ni identificar un mecanismo estable de transmisión.
La teoría es más útil cuando delimita qué parte del problema modela. Puede cuantificar límites bajo un modelo y orientar experimentos, pero no sustituye la identificación del sistema ni la evaluación de las restricciones reales.
207.10. Fiabilidad, tasa y recursos deben presentarse juntos
Un canal ruidoso permite distinguir mensajes a través de salidas inciertas. La capacidad cuantifica una tasa límite bajo condiciones precisas, mientras que los códigos convierten esa posibilidad en procedimientos con costos y errores concretos.
Los ejemplos separaron inversiones, borrados conocidos y transformaciones sistemáticas. También mostraron por qué una salida muy variable no implica mucha información sobre la entrada y por qué la fiabilidad arbitraria no equivale a error exactamente cero.
La repetición y el código de Hamming ilustraron cómo añadir redundancia útil; la cota de Fano, un límite que ningún decodificador puede eludir dentro del modelo. El análisis a tamaño finito recordó que alcanzar una tasa exige considerar longitud, latencia y cálculo.
Una evaluación completa debe declarar fuente, canal, restricciones, tasa, definición de error y recursos. Solo entonces podemos decidir si una mejora procede del código, de una nueva observación, de un cambio de canal o de aceptar otro compromiso.
El próximo capítulo cambiará el requisito de reconstrucción. Dejaremos de exigir la recuperación exacta de cada resultado y admitiremos una distorsión definida. Esa decisión plantea otro problema, el de qué información podemos descartar cuando la pregunta admite aproximaciones.
Referencias
- Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379–423. DOI.
- Hamming, R. W. (1950). Error detecting and error correcting codes. The Bell System Technical Journal, 29(2), 147–160. DOI.
- Shannon, C. E. (1956). The zero error capacity of a noisy channel. IRE Transactions on Information Theory, 2(3), 8–19. DOI.
- Polyanskiy, Y., Poor, H. V., y Verdú, S. (2010). Channel coding rate in the finite blocklength regime. IEEE Transactions on Information Theory, 56(5), 2307–2359. DOI.