COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
210.1. El encargo y las preguntas
Un equipo necesita conservar registros de un sistema que puede encontrarse en cuatro estados, llamados A, B, C y D. Cada registro contiene treinta y dos observaciones tomadas a intervalos regulares de un segundo. El equipo quiere reducir el tamaño de los archivos sin perder la posibilidad de estudiar cuántas veces aparece cada estado y cómo se organizan los episodios del estado D.
Añadiremos una columna numérica para estudiar un segundo problema, el de si redondear mediciones modifica una decisión basada en un umbral. Todos los datos de este capítulo son sintéticos; sirven para hacer cálculos exactos y mostrar errores de razonamiento que pueden surgir al reducir información. No describen resultados de una investigación ni propiedades de una población real.
Antes de elegir un compresor, escribimos tres preguntas. La primera pide la fracción de observaciones en cada estado. La segunda pregunta si existe algún episodio de al menos tres observaciones consecutivas en D. La tercera pregunta qué observaciones numéricas superan estrictamente el valor uno.
Estas preguntas no requieren exactamente la misma información. Las frecuencias de estados bastan para la primera, mientras que la segunda necesita el orden temporal. La tercera depende de conservar una relación específica entre cada valor numérico y el umbral. Un formato podría responder correctamente una pregunta y fallar en otra.
También fijamos el significado de conservar. Para las dos primeras preguntas, exigiremos respuestas exactas sobre el registro recibido. Para la columna numérica, compararemos por separado la fidelidad de los valores y la del indicador de umbral.
El inicio del registro, el intervalo temporal, la longitud y los significados de las categorías forman parte de los metadatos. Cuando comparemos cargas de datos, supondremos que esos metadatos comunes ya están disponibles para todos los formatos. Si un método requiere información adicional, la contaremos por separado.
Así no atribuiremos a un algoritmo el ahorro de eliminar metadatos que otro conserva. Tampoco llamaremos compresión sin pérdida a transformar el objeto original sin declarar el cambio. Nuestro objeto inicial es la secuencia ordenada de estados y valores, junto con sus convenciones de interpretación.
El resultado final será una elección justificada de representaciones, acompañada de pruebas de reconstrucción y de respuesta a las preguntas. La cifra de bytes será una parte de la evaluación, pero no sustituirá la comprobación de qué evidencia sigue disponible.
210.2. Dos registros con las mismas frecuencias
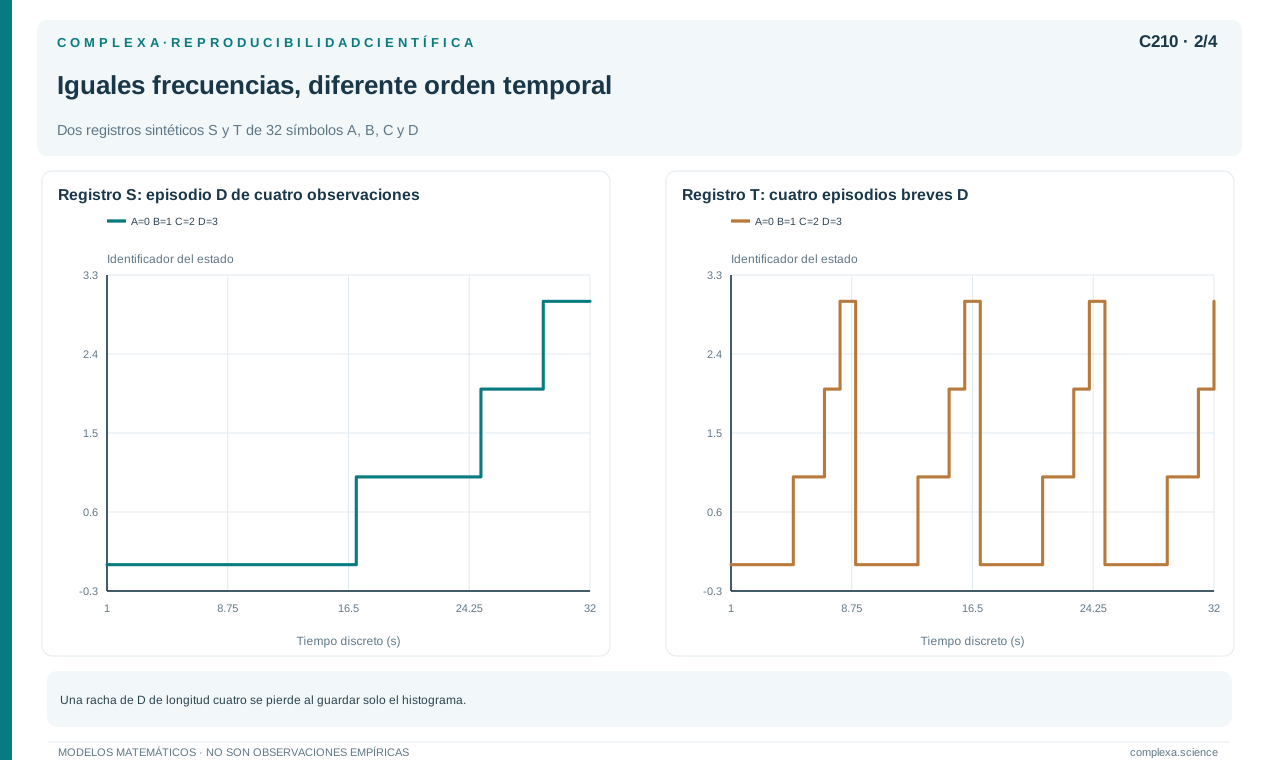
Construimos el registro S colocando primero dieciséis observaciones A, después ocho B, después cuatro C y finalmente cuatro D. El registro T repite cuatro veces el bloque de ocho observaciones AAAABBCD, formado por cuatro A, dos B, una C y una D.
Ambos contienen las mismas cantidades de cada categoría. Sus frecuencias son una mitad, una cuarta parte, una octava parte y una octava parte. La entropía calculada a partir de ese histograma es 1,75 bits por observación.
Esa igualdad no implica que los registros tengan la misma organización. En S hay cuatro rachas de estados constantes y tres cambios entre observaciones consecutivas. En T hay dieciséis rachas y quince cambios. Las rachas D duran cuatro observaciones en S y una observación en cada una de sus cuatro apariciones en T.
La pregunta sobre un episodio D de longitud al menos tres tiene respuesta afirmativa para S y negativa para T. Si contamos ventanas de tres posiciones completamente ocupadas por D, S tiene dos ventanas superpuestas. Si contamos episodios máximos de duración suficiente, tiene un episodio. Hay que especificar cuál de esas cantidades interesa.
Dos implementaciones pueden dar números diferentes si una cuenta ventanas y la otra episodios. La compresión no puede resolver una definición de evento que todavía es ambigua; debemos fijarla antes de usar el conteo como criterio de validación.
La duración está expresada aquí en número de observaciones consecutivas. Cuatro muestras separadas por un segundo abarcan tres segundos entre la primera y la última. Esas observaciones no permiten afirmar que el sistema permaneciera continuamente en D entre mediciones ni establecen el instante exacto de entrada o salida; para interpretar una duración física continua harían falta supuestos sobre el proceso entre muestras. El formato puede conservar perfectamente las observaciones y, aun así, dejar esa incertidumbre intacta. Distinguir entre la fidelidad del registro y el conocimiento del proceso evita exigir al compresor información que el instrumento nunca recogió.
La cifra de 1,75 bits también requiere interpretación, porque es la entropía de una distribución empírica de símbolos. Sin más información, no permite concluir que la fuente sea independiente entre tiempos ni determina la entropía de sus bloques. Dos secuencias con el mismo histograma pueden tener regularidades temporales muy distintas.
Si ajustáramos un modelo independiente con esas frecuencias, asignaríamos la misma probabilidad a S y T, porque el producto de probabilidades depende únicamente de las cantidades de símbolos. Esa igualdad sería una propiedad del modelo independiente y no demostraría que ambas secuencias son igualmente plausibles bajo cualquier mecanismo generador.
El caso comienza, por tanto, con una separación concreta, ya que la primera pregunta no distingue S de T y la segunda sí. Cualquier representación que los convierta en el mismo objeto podrá conservar la primera respuesta, pero no garantizar la segunda.
210.3. Codificación por símbolos como referencia sin pérdida
El formato de referencia asigna dos bits a cada estado. Por ejemplo, A recibe cero-cero, B cero-uno, C uno-cero y D uno-uno. Treinta y dos observaciones requieren sesenta y cuatro bits de carga, equivalentes a ocho bytes cuando se empaquetan sin otros campos.
También podemos usar un código de longitud variable en el que A se representa por cero, B por uno-cero, C por uno-uno-cero y D por uno-uno-uno. Ninguna palabra es prefijo de otra, por lo que el receptor puede identificar los símbolos recorriendo los bits desde el comienzo.
Con los conteos del caso, A contribuye con dieciséis bits, B con otros dieciséis y C y D con doce bits cada uno. La carga total es de cincuenta y seis bits, equivalentes a siete bytes. El ahorro frente al código fijo es de ocho bits, un 12,5 por ciento.
La longitud es igual para S y T porque este código trata cada símbolo por separado. Sin embargo, conserva su orden exacto. Al decodificar recuperamos las mismas treinta y dos posiciones, de modo que ambas preguntas sobre estados permanecen disponibles.
La longitud media coincide aquí con la entropía empírica porque las frecuencias son potencias inversas de dos y las longitudes del código corresponden exactamente a sus logaritmos negativos. Esta coincidencia particular no demuestra que cualquier muestra pueda comprimirse exactamente hasta su entropía sin costos adicionales.
El receptor necesita conocer el código, que en esta comparación hemos fijado como parte del formato compartido. Si tuviéramos que añadir un identificador adicional de un byte únicamente a esta alternativa, la ventaja de ocho bits desaparecería para un registro tan corto. Si el código se transmitiera en una cabecera mucho mayor, el tamaño total podría aumentar.
El ahorro depende también de la referencia de comparación. Guardar las treinta y dos letras como caracteres ASCII ocupa treinta y dos bytes de carga, antes de considerar saltos de línea u otros elementos. Reducir ese texto a siete bytes parece un ahorro mayor que reducir una representación binaria de ocho bytes a siete. Las dos cifras responden a puntos de partida distintos.
Para verificar el formato hay que codificar, decodificar y comparar posición por posición. Después se repiten los conteos y la detección de episodios. Si la reconstrucción es exacta, cualquier pregunta determinista sobre esa secuencia podrá reproducirse, siempre que también se conserven las convenciones necesarias para interpretarla.
210.4. El histograma reduce más, pero cambia el objeto
Una alternativa tentadora conserva únicamente cuántas veces aparece cada categoría. Como la longitud total es treinta y dos, podemos guardar tres conteos y deducir el cuarto por diferencia. Cada conteo puede ir de cero a treinta y dos, por lo que seis bits por conteo bastan en una representación fija sencilla.
La carga total es entonces de dieciocho bits, bastante menos que los cincuenta y seis del código anterior. Sin embargo, el archivo ya solo guarda un histograma; S y T producen exactamente el mismo contenido.
La fracción de observaciones en D sigue siendo una octava parte y puede recuperarse sin error. En cambio, no podemos decidir si hubo un episodio de tres D consecutivos. Si el programa responde afirmativamente para el histograma de S, responderá lo mismo para el de T, porque recibe exactamente los mismos datos.
No es cuestión de encontrar un mejor decodificador. Ningún procedimiento que reciba solo ese histograma puede responder correctamente en ambos casos, porque la representación fusionó dos registros con respuestas diferentes.
El número de secuencias que corresponden a este histograma es
Identificar cualquiera de ellas mediante un índice de longitud fija, una vez conocido el histograma, requiere cuarenta y nueve bits, porque el logaritmo en base dos de esa cantidad es aproximadamente 48,944. Los conteos no contienen ese índice.
Si añadimos ese índice al formato sencillo de dieciocho bits, obtenemos sesenta y siete bits y recuperamos una representación sin pérdida. El resultado supera tanto los sesenta y cuatro bits del código fijo como los cincuenta y seis del código por símbolos.
Esto no demuestra que la codificación por conteos e índices sea siempre ineficiente. Nuestro formato de conteos es sencillo y deja combinaciones sin usar. Hay 6.545 histogramas posibles de treinta y dos observaciones distribuidas entre cuatro categorías. Identificarlos con longitud fija requiere trece bits, frente a dieciocho. Con ese refinamiento y el índice de cuarenta y nueve bits, este histograma concreto necesita sesenta y dos bits.
El ejemplo distingue entre resumir una secuencia mediante conteos y codificarla con conteos más información sobre el orden. La primera operación pierde información; la segunda puede conservarla. Llamar a ambas compresión sin distinguir sus objetos oculta precisamente la información que nuestra pregunta temporal necesita.
210.5. Aprovechar las rachas sin eliminar el orden
El registro S tiene largas repeticiones consecutivas, una regularidad que el código por símbolos no explota. Podemos representar cada racha mediante su estado y su duración. Si el formato permite reconstruir cada racha en el mismo orden, sigue siendo una compresión sin pérdida.
Definamos un formato explícito para registros de treinta y dos posiciones. Primero guardamos el número de rachas menos uno usando cinco bits. Después guardamos cada estado usando dos bits y cada duración menos uno usando cinco bits. La suma de duraciones debe ser treinta y dos y dos rachas consecutivas no deben tener el mismo estado.
Si el registro contiene un número de rachas dado, la carga ocupa cinco bits más siete por cada racha. S tiene cuatro, de modo que requiere treinta y tres bits. T tiene dieciséis y requiere ciento diecisiete bits.
Ambos registros se reconstruyen exactamente. La diferencia de rendimiento procede de su organización temporal; un formato eficaz para largas rachas puede expandir una secuencia con muchos cambios. No hay contradicción con la entropía marginal idéntica, porque estamos usando información sobre una estructura que ese resumen marginal no distingue.
Nuestro formato contiene redundancias. La duración de la última racha podría deducirse de las anteriores y ciertos patrones de estados están prohibidos por definición de racha. Esas restricciones permitirían diseñar otro formato, pero no descontaremos esos bits sin especificar cómo funcionaría la nueva codificación.
Podemos elegir automáticamente entre el código por símbolos y el código por rachas. Si solo hay esas dos opciones, un bit puede indicar cuál se ha usado. Para S escogeríamos rachas y obtendríamos treinta y cuatro bits; para T escogeríamos símbolos y obtendríamos cincuenta y siete.
Al almacenar archivos independientes en bytes completos, treinta y cuatro bits necesitan cinco bytes, mientras que cincuenta y siete necesitan ocho. El bit de selección hace que T pase de siete a ocho bytes, si no existe otro mecanismo de empaquetado compartido. Una mejora expresada en bits puede desaparecer al incluir la alineación.
Si añadimos una tercera alternativa, como el código fijo, ya no basta un indicador fijo de un bit para distinguir todas las opciones. El formato debe establecer cómo se comunica la elección. La comparación del tamaño final debe incluir ese costo.
Con este ejercicio buscamos hacer verificable cada cifra, sin pretender un compresor competitivo para archivos grandes. Sabemos qué información almacena cada campo, cómo se reconstruye y por qué ocupa determinado espacio. Esa claridad permite separar un ahorro real de una reducción aparente obtenida al omitir parte del problema.
210.6. Una pequeña distorsión que borra un umbral
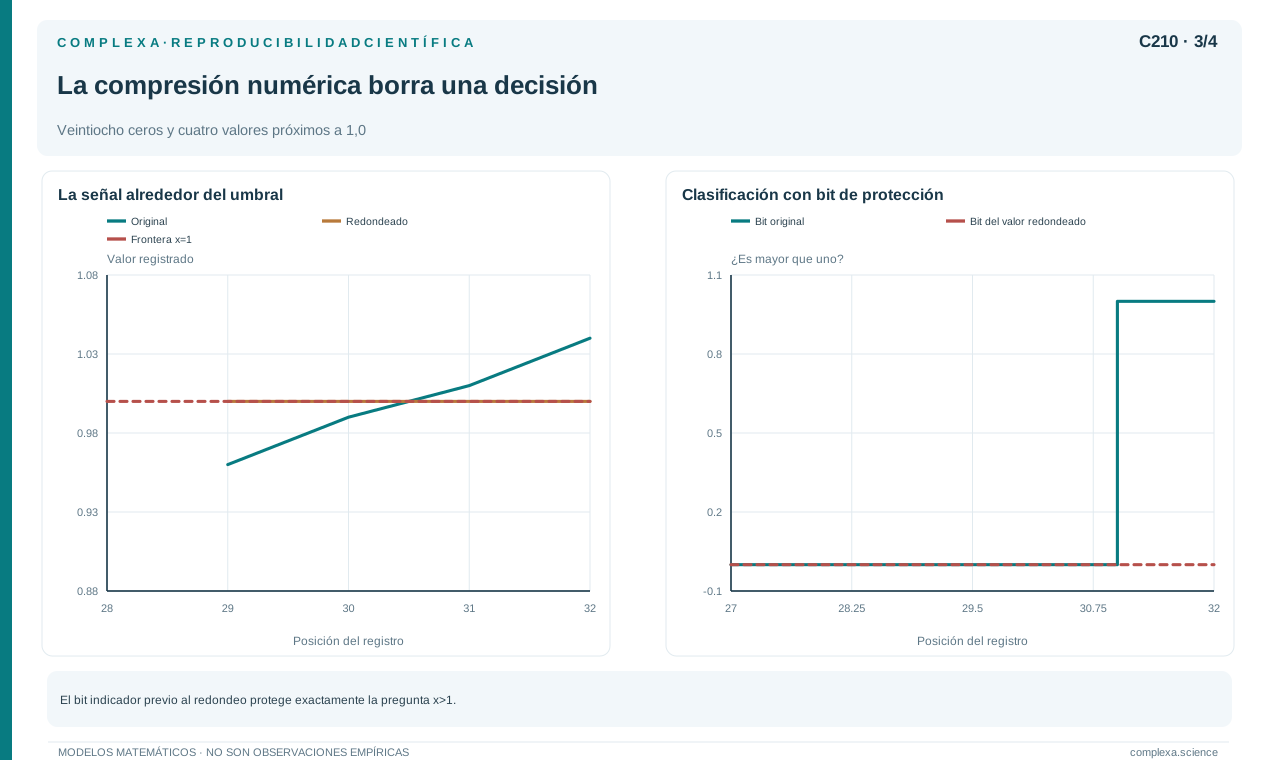
Añadamos al registro S una columna numérica. Las primeras veintiocho posiciones valen cero. Las cuatro últimas contienen, en orden, 0,96; 0,99; 1,01 y 1,04. Consideraremos que los valores originales están medidos en centésimas y pertenecen al intervalo de cero a 1,27, inclusive.
Cada valor puede representarse como un entero entre cero y ciento veintisiete, con siete bits por observación. La columna completa requiere doscientos veinticuatro bits de carga, antes de otros costos comunes.
Ahora redondeamos cada valor a la décima más cercana. Los veintiocho ceros permanecen iguales y los otros cuatro valores se convierten en uno. Bajo el rango declarado, los índices de décimas posibles van de cero a trece, por lo que bastan cuatro bits por observación y la carga queda en ciento veintiocho bits.
La media original es 0,125 y la media reconstruida también. Los errores de las cuatro últimas posiciones son, en valor absoluto, cuatro centésimas, una centésima, una centésima y cuatro centésimas. El error cuadrático medio sobre las treinta y dos observaciones es 0,00010625.
Según la media y el error cuadrático global, la reducción parece muy favorable. Sin embargo, nuestra pregunta era qué posiciones superaban estrictamente el valor uno. En el original lo hacen las posiciones treinta y uno y treinta y dos. Después del redondeo, ninguna lo hace.
Si evaluamos únicamente la exactitud global del indicador, obtenemos treinta aciertos de treinta y dos, un 93,75 por ciento. Si evaluamos la conservación de los casos positivos, obtenemos cero de dos. Ambas cifras son correctas, pero muestran aspectos muy diferentes.
Cambiar el criterio a mayor o igual que uno tampoco resuelve el problema. En el registro redondeado clasificaría las cuatro posiciones como positivas, incluidas dos que originalmente estaban por debajo del umbral estricto. Modificar la pregunta después de comprimir no recupera la distinción perdida.
Este ejemplo demuestra que conservar una media puede coexistir con perder por completo un evento definido por umbral. La pequeña magnitud del error numérico no garantiza la estabilidad de una decisión cuando los valores se encuentran cerca de su frontera.
Si solo necesitáramos la media de este registro concreto, podríamos conservarla directamente, aunque eso no preservaría otras preguntas sobre valores individuales. Antes de aceptar un resumen, conviene especificar qué consultas futuras se consideran parte del encargo y cuáles dejarían de ser posibles.
210.7. Proteger una pregunta sin prometer fidelidad completa
Podemos conservar la columna redondeada y añadir un indicador por posición que registre si el valor original superaba estrictamente uno. Los treinta y dos indicadores ocupan treinta y dos bits en una representación directa. Sumados a los ciento veintiocho bits de valores redondeados, producen una carga de ciento sesenta bits.
Esta alternativa ahorra sesenta y cuatro bits respecto de los doscientos veinticuatro de la columna original y preserva exactamente la respuesta al umbral especificado, siempre que el indicador se calcule antes de redondear y se conserve su alineación con las posiciones.
Los valores aproximados no se convierten en originales exactos y la magnitud de las dos observaciones positivas sigue siendo incierta dentro de lo que permite la representación. Tampoco podemos responder automáticamente qué posiciones superaban 1,02, porque ese umbral separa 1,01 de 1,04, que siguen fusionados numéricamente.
La representación protege una pregunta concreta. Si anticipamos varios umbrales, podemos proteger varios indicadores o diseñar intervalos que respeten todas sus fronteras; en ese caso, el costo crecerá o la cuantización deberá adaptarse. No existe una conservación universal de cualquier pregunta sobre valores que hemos decidido fusionar.
En este registro, el indicador tiene solo dos unos y podría codificarse de manera más compacta, pero habría que contar el formato, la posición de los unos y cualquier información necesaria para decodificarlo. No restaremos un ahorro hipotético del tamaño calculado.
También podríamos almacenar con exactitud solo los valores cercanos al umbral y cuantizar los demás. Esa política exige una regla de selección y una manera de señalar qué tratamiento sigue cada posición. Puede ser útil, pero debe evaluarse también sobre datos distintos de los de un ejemplo construido para favorecerla.
La alineación merece una comprobación específica. Si falta una observación y las columnas se desplazan, un indicador correcto puede asociarse al valor equivocado. La conservación del orden y la identificación de ausencias forman parte de la fidelidad del registro, aunque no aparezcan en una medida de error numérico.
El formato debería declarar que el indicador proviene del valor original y que la columna numérica es aproximada. De otro modo, quien recalcule el umbral sobre la reconstrucción podría obtener otra respuesta y tomar por inconsistentes dos campos con funciones diferentes.
Esta estrategia muestra que la fidelidad puede diseñarse por componentes; podemos exigir exactitud para ciertas etiquetas y tolerar aproximación en otros valores. Cada garantía debe tener un significado verificable y no extenderse, por un lenguaje ambiguo, a propiedades que el formato no conserva.
210.8. Reconstruir con un modelo no recupera el registro
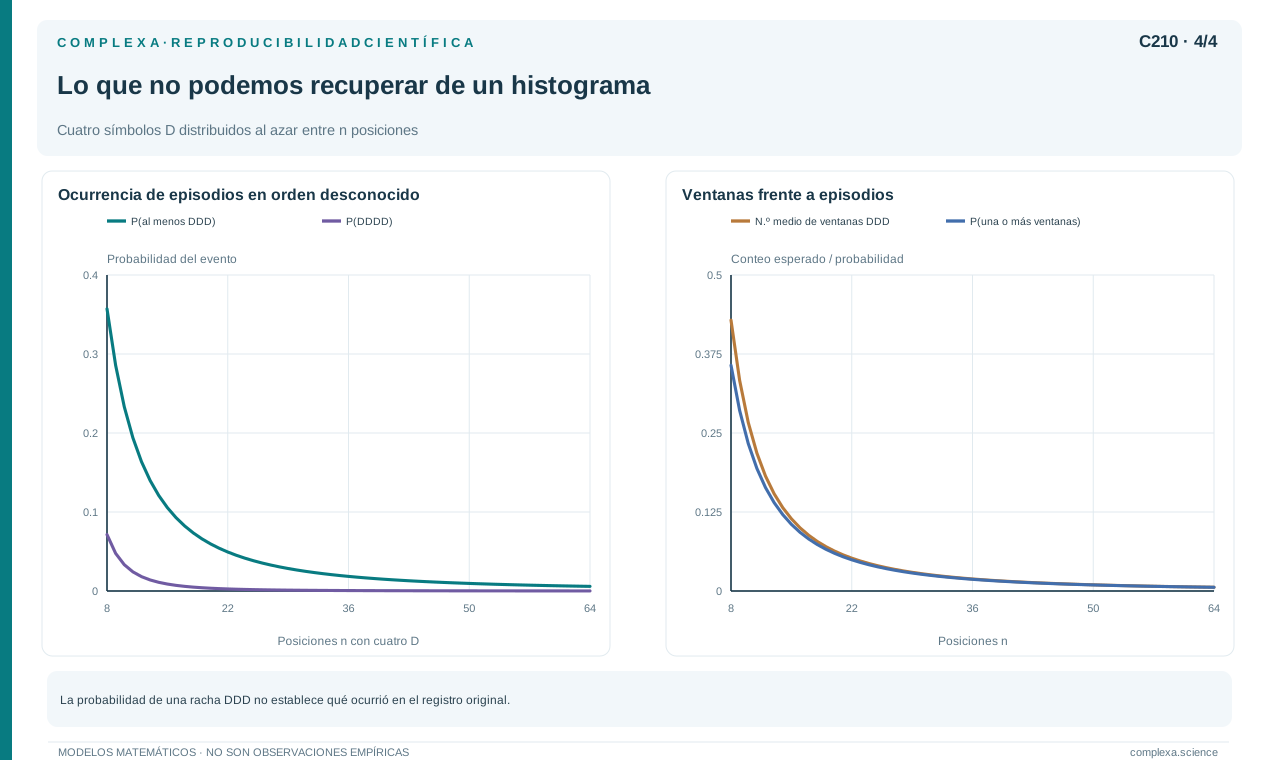
Supongamos que solo conservamos el histograma de estados y que alguien propone reconstruir una secuencia mediante máxima entropía. Si exigimos exactamente dieciséis A, ocho B, cuatro C y cuatro D, la distribución de máxima entropía sobre las secuencias compatibles es uniforme entre todas sus permutaciones distintas.
Podemos generar una secuencia de esa distribución, pero no hay razón para que coincida con S o con T. La entropía del conjunto de secuencias compatibles es aproximadamente 48,944 bits. Una realización aleatoria selecciona una posibilidad, pero no es evidencia de cuál fue observada.
Si usamos, en cambio, un modelo independiente con probabilidades iguales a las frecuencias del histograma, las secuencias generadas ni siquiera tendrán necesariamente los mismos conteos; solo los conservarán en valor esperado. Condicionar ese modelo independiente a los conteos exactos conduce a la distribución uniforme sobre las secuencias compatibles.
Estas dos construcciones responden a restricciones distintas (frecuencias esperadas y cantidades exactas por registro). Confundirlas puede producir una reconstrucción que no conserve ni siquiera el resumen que supuestamente motivó el procedimiento.
Un modelo temporal podría asignar mayor probabilidad a largas rachas y favorecer reconstrucciones parecidas a S. Otro podría favorecer alternancias y parecerse más a T. La elección incorpora información o supuestos externos al histograma. Puede ser útil para inferencia, pero debe presentarse como tal.
La pregunta correcta sería entonces probabilística. Dados una referencia y un histograma, ¿qué probabilidad asignamos a que hubiera un episodio largo? Esa pregunta no equivale a verificar si el episodio ocurrió en el registro original. Una respuesta posterior razonable puede seguir equivocándose sobre un caso particular.
Algo semejante ocurre si completamos las diferencias numéricas borradas por el redondeo. Un modelo puede proponer valores plausibles dentro de los intervalos, pero la plausibilidad no demuestra que fueran los valores observados. Si después analizamos la secuencia reconstruida como evidencia exacta, mezclamos datos y supuestos.
Por eso conviene conservar etiquetas de procedencia y, cuando corresponde, varias realizaciones o una distribución de incertidumbre. El propósito es impedir que el formato haga desaparecer la diferencia entre medición original, aproximación determinista e imputación probabilística, sin prohibir los modelos de reconstrucción.
En nuestro encargo, la solución más sencilla para la pregunta temporal es mantener una representación sin pérdida de los estados, algo que nuestros métodos explícitos permiten con pocas decenas de bits. Descartar el orden y después intentar reconstruirlo añade una incertidumbre que no era necesaria para alcanzar un tamaño razonable.
210.9. Una auditoría que comprueba las preguntas
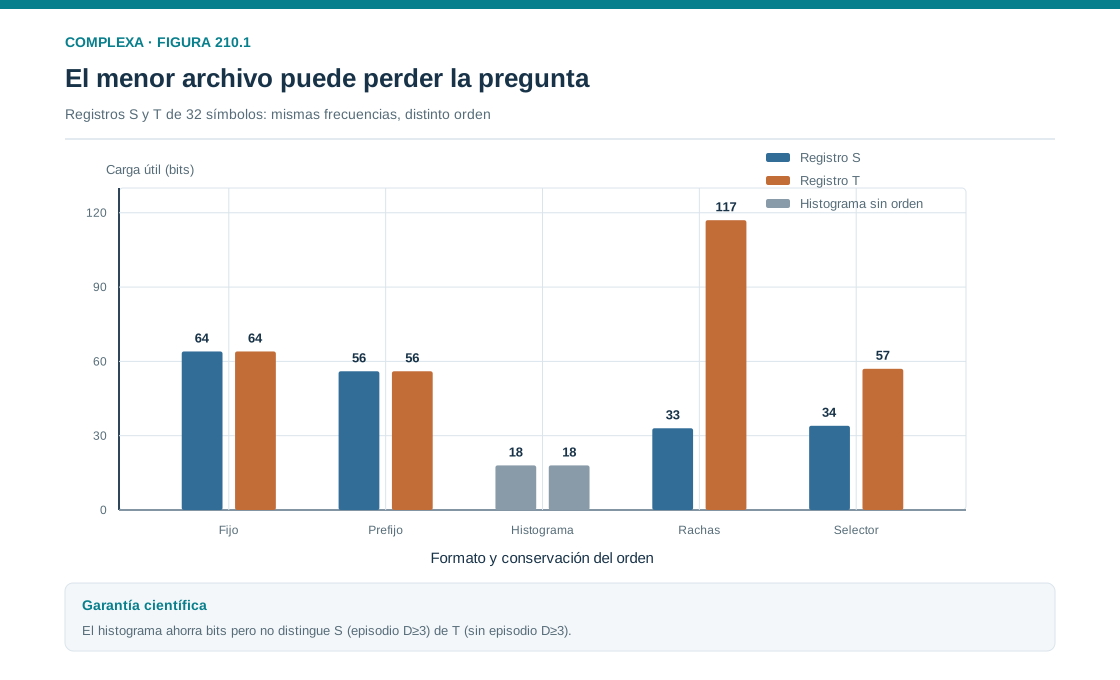
La auditoría comienza con una tabla de tamaños y garantías, con cargas en bits antes del redondeo a bytes y bajo las convenciones compartidas ya descritas.
| Representación de estados | S | T | Frecuencias exactas | Orden exacto |
|---|---|---|---|---|
| Dos bits por símbolo | 64 | 64 | Sí | Sí |
| Código prefijo por símbolos | 56 | 56 | Sí | Sí |
| Tres conteos de seis bits | 18 | 18 | Sí | No |
| Rachas con formato explícito | 33 | 117 | Sí | Sí |
| Selección entre prefijo y rachas | 34 | 57 | Sí | Sí |
El histograma tiene la carga más pequeña de las mostradas, pero no satisface el encargo temporal. El formato por rachas es el mejor de los formatos individuales para S y el peor para T.
Después verificamos la reconstrucción. Para cada formato sin pérdida, codificar y decodificar debe producir la secuencia original exacta. Además de comparar símbolos, comprobamos la longitud, la suma de duraciones y el tratamiento del último bloque. Una palabra incompleta o una duración que exceda el total debe detectarse como formato inválido.
Repetimos luego las preguntas científicas. Ambos registros deben conservar cuatro observaciones D. S debe conservar un episodio D de longitud cuatro y T, cuatro episodios de longitud uno. El detector de episodios de al menos tres debe distinguirlos.
Para la columna numérica, revisamos por separado la igualdad de valores, la media, el error cuadrático y los indicadores de umbral. La representación redondeada no debe etiquetarse como exacta por el hecho de conservar la media. La representación con indicador protegido debe reproducir las posiciones treinta y uno y treinta y dos como positivas.
Las pruebas deben incluir casos de frontera (un valor exactamente igual al umbral, valores inmediatamente a ambos lados y observaciones ausentes, si el formato las admite). En este ejemplo no hay observaciones ausentes, pero admitirlas en una aplicación real exigiría una convención explícita; no deben sustituirse silenciosamente por cero.
Finalmente, contamos el archivo completo, con la identificación de formato, la longitud, el inicio, el intervalo temporal, las unidades, los rangos y cualquier diccionario adicional. Si esos campos son idénticos en varias alternativas, pueden cancelarse al comparar diferencias, pero siguen ocupando espacio real.
Esta revisión demuestra algo concreto, que cada ahorro informado corresponde a un formato definido y que sus garantías coinciden con las preguntas declaradas. No demuestra que el formato sea el mejor diseño posible.
210.10. La decisión y sus límites
Para el campo de estados, elegimos una representación sin pérdida. Si los registros son muy cortos y queremos un formato sencillo, el código prefijo compartido tiene una carga de cincuenta y seis bits para ambos ejemplos. Si sabemos que las rachas largas son habituales, podemos evaluar un formato adaptativo e incluir en la cuenta su indicador y su alineación.
El histograma puede mantenerse como resumen adicional para consultas rápidas, pero no sustituye la secuencia cuando interesa la duración de episodios. Conservar ambos no obliga a duplicar toda la información, porque los conteos pueden calcularse al leer el registro o almacenarse como un índice cuya coherencia se compruebe.
Para la columna numérica, la elección depende del alcance acordado. Si se requiere recuperar todos los valores originales, mantenemos sus enteros de centésimas o aplicamos un compresor sin pérdida a esa representación. Si se acepta aproximación y solo se protege el umbral uno, el formato redondeado con indicador conserva esa pregunta concreta.
La decisión debe registrar qué nuevas preguntas quedarían fuera de garantía. Un umbral diferente, una distribución precisa de magnitudes o una relación entre diferencias pequeñas podrían necesitar los originales. Esta limitación define el alcance del formato sin invalidarlo.
También debemos mantener el contexto temporal. Omitir marcas individuales es seguro en nuestro ejemplo porque el intervalo es exactamente regular, la longitud es conocida y no hay observaciones ausentes. Si esas condiciones cambian, el ahorro basado en tiempo implícito necesita revisión.
El caso muestra que información, tamaño y utilidad no son sinónimos. Una codificación puede reducir el tamaño sin perder distinciones, mientras que un resumen puede perder muchas distinciones y conservar una pregunta. Una reconstrucción generativa puede recuperar la apariencia sin recuperar la evidencia. Cada operación exige una descripción diferente.
La teoría de la información ayuda a formular límites y comparaciones, pero el trabajo decisivo comienza al declarar qué objeto se conserva y para qué. En este registro, la diferencia entre contar estados y estudiar episodios basta para cambiar una decisión de almacenamiento. En problemas mayores, esa misma diferencia puede quedar oculta detrás de archivos y métricas mucho más complejos.
El siguiente módulo extenderá estas preguntas al tiempo, la predicción y la información distribuida entre varias variables. La lección práctica que trasladamos es que, antes de interpretar una medida de complejidad, debemos comprobar qué distinciones conserva la representación que la hizo calculable.
Referencias
- Shannon, C. E. (1948). A Mathematical Theory of Communication. The Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x.
- Huffman, D. A. (1952). A Method for the Construction of Minimum-Redundancy Codes. Proceedings of the IRE, 40(9), 1098–1101. https://doi.org/10.1109/JRPROC.1952.273898.
- Shannon, C. E. (1959). Coding Theorems for a Discrete Source With a Fidelity Criterion. IRE International Convention Record, 7, parte 4, 142–163. Reimpresión del artículo.
- Jaynes, E. T. (1957). Information Theory and Statistical Mechanics. Physical Review, 106(4), 620–630. https://doi.org/10.1103/PhysRev.106.620.
Los registros, formatos, comparaciones y cálculos de este caso son construcciones didácticas originales. Las referencias fundamentan las herramientas generales; no constituyen fuentes empíricas de los datos sintéticos.