COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
205.1. Procesar puede ayudar sin crear evidencia
Una señal puede hacerse más fácil de interpretar después de filtrarla, resumirla o transformarla. Un conjunto de variables puede volverse más útil para un algoritmo cuando construimos una representación adecuada. Esa mejora práctica no significa que el procesamiento haya creado información nueva sobre el fenómeno observado.
La desigualdad de procesamiento de datos establece un límite preciso. Si una representación se obtiene únicamente a partir de una observación, sin acceso adicional al objetivo, no puede contener más información mutua sobre ese objetivo que la observación de la que procede.
El resultado vale solo bajo sus hipótesis. Una transformación puede incorporar otra medición, conocimiento externo o etiquetas usadas durante el entrenamiento; en ese caso, debemos incluir esas fuentes en el sistema que analizamos. Comparar solo el archivo inicial con el resultado ampliado puede ocultar la entrada adicional.
También debemos distinguir información disponible y facilidad de uso. Un algoritmo limitado puede usar mejor un resumen que una señal completa. Un lector puede entender mejor un gráfico que una tabla extensa. El límite informacional no afirma que todas las representaciones tengan igual costo de interpretación.
Este capítulo estudiará qué se pierde, cuándo puede conservarse toda la información relevante y cómo comparar transformaciones. Usaremos ejemplos binarios que permiten calcular los resultados y distinguir conservación del registro completo de conservación de una pregunta particular.
La idea de suficiencia será central. Una representación puede descartar muchos detalles y conservar exactamente la información sobre un objetivo dentro de un modelo. Esa propiedad no hace del resumen una representación suficiente para cualquier pregunta futura.
Antes de diseñar una transformación debemos especificar, por tanto, qué observación tenemos, qué queremos conocer y qué recursos adicionales puede usar el procedimiento. Solo entonces podremos interpretar una ganancia práctica o una pérdida informacional.
205.2. La condición de Markov del procesamiento
Denotemos por el objetivo, por la observación original y por la representación procesada. La condición relevante se escribe como una cadena
En términos probabilísticos, significa que, una vez conocido , la distribución de no depende adicionalmente de . Podemos factorizar la distribución conjunta mediante la distribución de la observación y una regla de procesamiento que usa solo esa observación.
Si es una transformación determinista, la condición se cumple automáticamente dentro del modelo correspondiente. Si el procesamiento usa aleatoriedad, esta debe generarse sin información adicional sobre el objetivo una vez conocida la observación.
La condición no exige que la observación original sea perfecta; puede contener ruido, pérdidas y limitaciones. El teorema compara lo disponible en esa observación con lo que obtenemos procesándola, sin afirmar que el registro conserve todo el estado del sistema.
Tampoco debemos confundir esta cadena con una afirmación causal completa sobre el mundo. Aquí expresa una relación de independencia condicional, que basta para el resultado. En aplicaciones, el diseño del procesamiento suele justificarla, pero deben examinarse las entradas ocultas y la selección de datos.
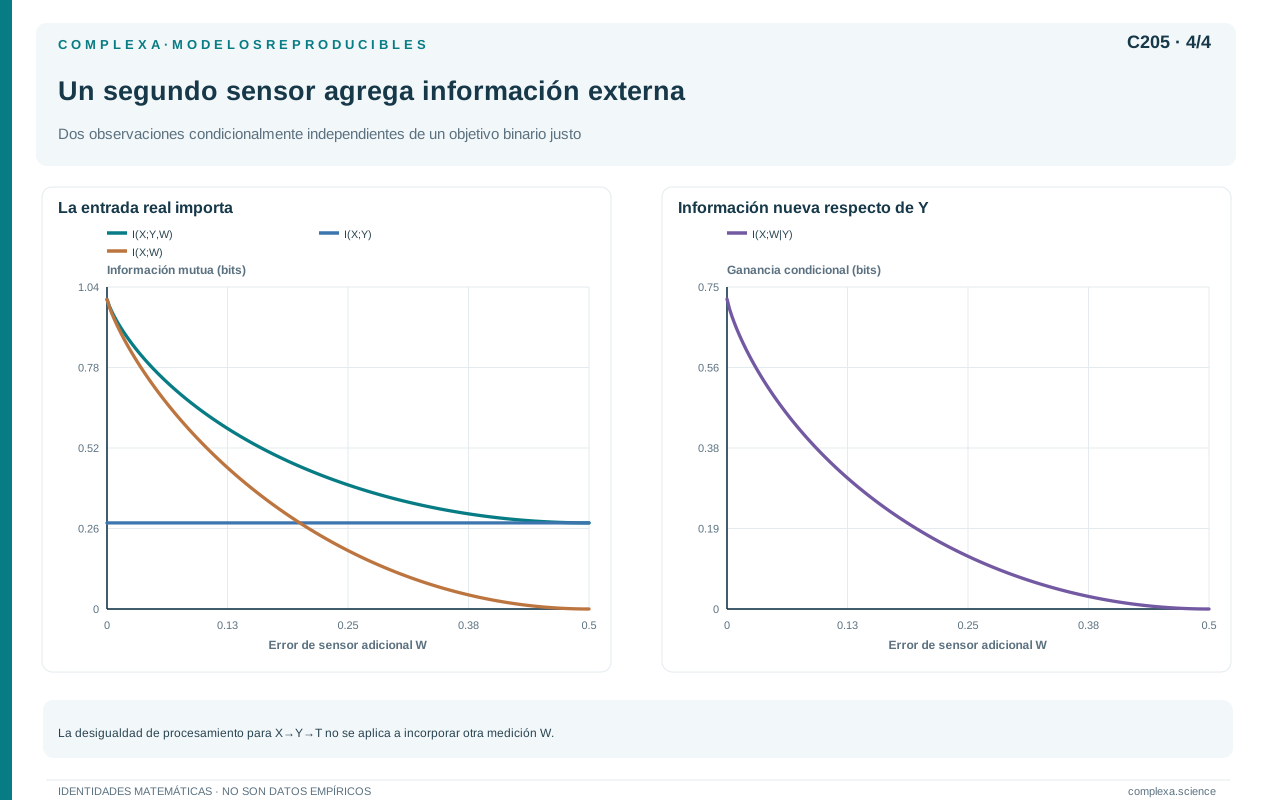
Si un procedimiento consulta una segunda señal , su entrada real es la pareja y el límite correspondiente compara la salida con esa pareja. La salida puede contener más información que por separado sin violar ninguna desigualdad.
Si un algoritmo usa directamente el valor del objetivo al construir la salida, la condición original falla. Es lo que ocurre en ciertas formas de fuga de información durante la evaluación, cuando una representación puede parecer extraordinariamente predictiva porque incorporó resultados que debían permanecer desconocidos.
Una auditoría del procesamiento debe registrar todas las entradas, incluidas calibraciones, parámetros aprendidos y criterios de inclusión. La notación compacta de una cadena solo es útil cuando describe fielmente ese flujo de información.
En variables discretas, la regla de procesamiento puede escribirse como una matriz de probabilidades condicionales. Cada fila suma uno y describe qué salidas puede producir una entrada. Un resumen determinista es el caso en que cada entrada selecciona una sola salida.
Un ejemplo de información auxiliar usa un bit objetivo equiprobable y una máscara binaria independiente, también equiprobable. La observación combina objetivo y máscara mediante XOR. Sin conocer la máscara, esa observación es independiente del objetivo y su información mutua es cero.
Si el procesador recibe además la máscara, puede aplicar otra vez XOR y recuperar exactamente el objetivo. Su salida tiene un bit de información, pero la entrada completa era la pareja formada por observación y máscara, que ya contenía el bit.
La máscara por separado tampoco informaba sobre el objetivo; la información aparecía al combinar ambas entradas. El ejemplo conecta procesamiento e información multivariada y muestra que omitir una entrada del diagrama puede producir una aparente creación de información, que desaparece al escribir correctamente el sistema.
Si usamos una variable de contexto conocida durante el procesamiento, el análisis puede formularse también mediante información mutua condicionada a ese contexto. Lo esencial es conservar la misma información disponible en ambos lados de la comparación.
205.3. Demostrar el límite y localizar la pérdida
La desigualdad principal es
Para hacer las restas siguientes suponemos alfabetos finitos o condiciones que aseguren información finita. La desigualdad tiene formulaciones más generales, pero una resta de infinitos no demuestra la identidad de pérdida.
Podemos demostrarla con dos órdenes de la regla de la cadena. Por la condición de procesamiento, la información mutua entre y condicionada a es cero. Por tanto,
Si revelamos primero , la misma cantidad es
El último término es no negativo. Al comparar ambas expresiones obtenemos, además de la desigualdad, una identidad más informativa
La pérdida es la información sobre el objetivo que todavía conserva la observación original después de conocer el resumen. Si esa información residual es cero, la representación conserva todo lo pertinente para ese objetivo bajo el modelo.
Esta identidad distingue una transformación invertible de una suficiente pero no invertible. La primera permite recuperar toda la observación; la segunda puede perder detalles de la observación que no aportaban información adicional sobre el objetivo.
En variables discretas, un resumen determinista también satisface . Sin embargo, la conservación de información relevante depende de algo más que esa desigualdad entre entropías. Un procesamiento aleatorio puede aumentar la entropía mientras pierde información sobre .
Por ejemplo, podemos adjuntar a la observación un bit aleatorio independiente. La entropía del registro ampliado aumenta en un bit, pero su información sobre el objetivo permanece igual.
Podemos también reemplazar toda la observación por ruido independiente. La salida puede tener mucha entropía y ninguna información sobre el objetivo. Medir únicamente cuánta variación contiene una representación no permite evaluar su valor informacional.
La cadena da además una cota basada en la relación entre observación y salida. En las condiciones pertinentes, la información de la salida sobre el objetivo no supera la que la salida comparte con su propia entrada. Las distintas cotas describen límites del mismo sistema probabilístico.
205.4. Dos etapas de error que se pueden calcular
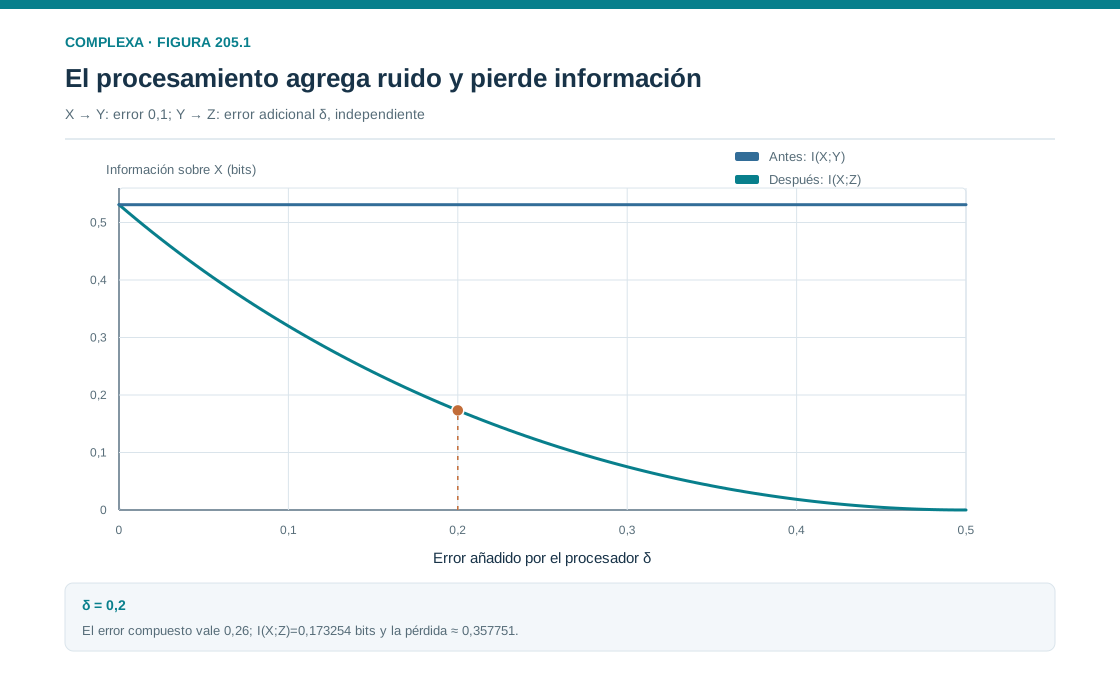
Tomemos un objetivo binario equiprobable. La observación copia ese bit con probabilidad de error . Después, el procesamiento produce invirtiendo nuevamente el bit con probabilidad , mediante un error independiente.
El resultado final es incorrecto si ocurre exactamente una de las dos inversiones; si ocurren ambas, se cancelan. La probabilidad de error total es
Con los valores elegidos, el error total es . La información de la observación original sobre el objetivo es aproximadamente bits. La información de la salida final es
La pérdida debida a la segunda etapa es aproximadamente bits. Ambas salidas binarias siguen siendo equiprobables y tienen un bit de entropía marginal, de modo que la pérdida está en su relación con el objetivo.
Si la segunda inversión fuera segura, no perderíamos información adicional, porque sería una transformación invertible conocida. Si ocurriera con probabilidad de un medio, la salida final sería independiente de la observación y del objetivo.
El ejemplo distingue inversión sistemática de ruido desconocido. Un procedimiento puede cambiar todos los valores literales y conservar la información si sabemos cómo deshacerlo. La semejanza superficial entre entrada y salida no es un criterio suficiente.
También debemos conservar la independencia del segundo error. Si el procesador tuviera acceso a información que revelara cuándo ocurrió el primero, podría corregirlo. Entonces la entrada real incluiría esa información y la cadena de tres variables ya no representaría el sistema.
La afirmación de que un filtro recupera señal debe analizarse con la misma precisión. El filtro puede explotar estructura redundante presente en una observación extensa o incorporar un modelo, pero no puede recuperar con garantía una distinción eliminada de todas sus entradas sin una fuente adicional.
La desigualdad no prohíbe estimaciones útiles. Establece qué evidencia está disponible y exige distinguir esa evidencia de las suposiciones usadas para escoger entre reconstrucciones posibles.
205.5. Tres sensores, conservación del conteo y pérdida de la confianza
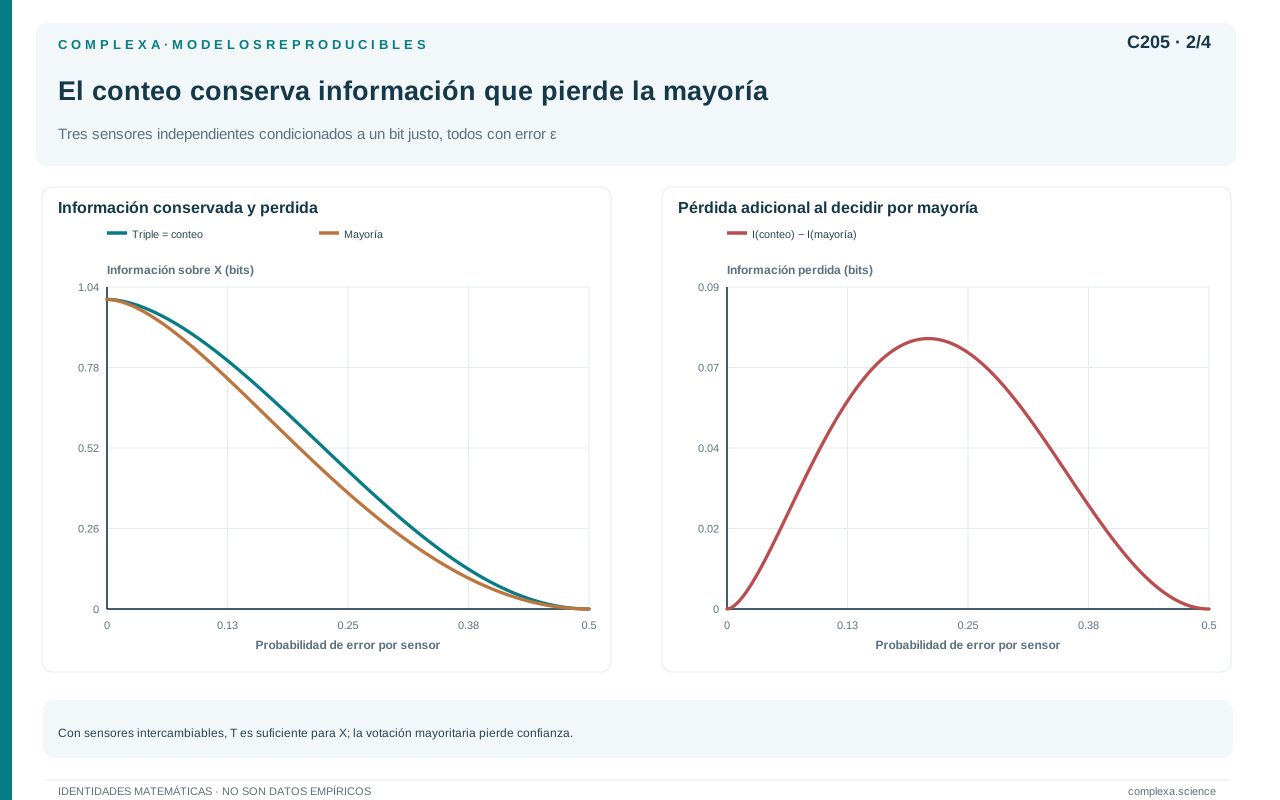
Consideremos tres sensores binarios del mismo objetivo equiprobable. Cada sensor tiene probabilidad de error de una décima y sus errores son independientes condicionados al objetivo. La observación original es el triple completo.
Podemos resumirlo mediante el número de unos, que toma valores entre cero y tres. Dado el objetivo, todas las configuraciones con el mismo número de unos tienen la misma probabilidad. Por tanto, la posterior del objetivo depende solo del conteo, sea cual sea el orden de las salidas.
El conteo conserva toda la información del triple sobre el objetivo bajo este modelo. Sin embargo, pierde qué sensor produjo cada resultado, un detalle que sería relevante para otras preguntas, como investigar un sensor con error distinto.
Las probabilidades de conteos cero y tres son cada una. Las de conteos uno y dos son cada una. Cuando todos coinciden, la probabilidad posterior de que estén equivocados es .
Cuando hay una mayoría de dos contra uno, la probabilidad posterior de que la mayoría esté equivocada es una décima. Así, la confianza depende de la intensidad del acuerdo además de su dirección.
La incertidumbre residual del objetivo es
El triple y el conteo comparten aproximadamente bits con el objetivo. El resumen reduce la descripción de la observación sin reducir esa información específica.
Ahora resumamos todavía más y conservemos solo la decisión mayoritaria. Su probabilidad de error, la de que se equivoquen dos o tres sensores, es .
La información mutua de la mayoría es aproximadamente bits, cerca de bits menos que la del conteo. La decisión mayoritaria conserva la categoría más probable, pero elimina la distinción entre unanimidad y mayoría estrecha.
El ejemplo muestra que un resumen puede conservar la decisión óptima bajo pérdida de cero o uno y perder información útil para probabilidades, costos diferentes o decisiones posteriores.
Podemos cuantificar el ahorro descriptivo del conteo. La entropía del triple completo es aproximadamente bits; la del conteo, aproximadamente . La diferencia corresponde al orden de las respuestas cuando hay una mayoría estrecha.
Esos casos tienen probabilidad total y admiten tres ubicaciones equiprobables del sensor disidente. Por ello, la entropía descartada es . Bajo la simetría del modelo, ese detalle no ayuda a inferir el objetivo.
La pérdida adicional al conservar solo la mayoría puede modificar decisiones con costos desiguales. Supongamos, como ejercicio, que una decisión positiva equivocada cuesta noventa y nueve unidades y una negativa equivocada cuesta una. La decisión positiva conviene solo cuando su probabilidad posterior supera .
El conteo permite reconocer la unanimidad positiva, cuya posterior supera ese umbral; una mayoría de dos votos positivos no lo supera. Si solo conservamos la mayoría, la posterior positiva es y no podemos distinguir los casos de unanimidad.
Con el registro suficiente, la regla actúa positivamente solo ante tres unos. Su costo esperado es . Con la mayoría sola, la mejor decisión bajo esos costos es siempre negativa y el costo esperado es .
Los costos son hipotéticos y sirven para mostrar una diferencia matemática. Ambas representaciones daban el mismo error mínimo cuando los dos errores costaban lo mismo. Cambiar la pregunta decisional hace relevante una distinción que la mayoría había descartado.
También conviene comparar la mayoría con su verdadera entrada. Su información sobre el objetivo es mayor que la de un sensor individual, pero menor que la del triple. El procesamiento parte de tres observaciones y saca partido de su redundancia; compararlo solo con una de ellas ocultaría parte de la evidencia recibida.
205.6. Suficiencia depende del modelo y de la pregunta
La igualdad en el procesamiento ocurre cuando conocer la observación original no añade información sobre el objetivo después de conocer el resumen. Para una transformación determinista, esto puede expresarse como igualdad entre las posteriores del objetivo para entradas que producen el mismo resumen.
La propiedad es relativa al objetivo y a la distribución considerada. No significa que el resumen permita reconstruir el registro completo, ni garantiza que siga siendo suficiente si cambian las relaciones entre variables o las condiciones de medición.
Un ejemplo clásico es una secuencia de ensayos binarios independientes con probabilidad desconocida de uno. La verosimilitud de una secuencia depende del número de unos y del número de ceros, mediante potencias de esa probabilidad y de su complemento.
De ahí que el conteo de unos sea suficiente para esa familia de probabilidades bajo el modelo independiente. Condicionado al conteo, todas las secuencias compatibles tienen la misma probabilidad, independientemente del parámetro.
Si el proceso tiene memoria, el resultado puede cambiar. Las secuencias 0011 y 0101 contienen el mismo número de unos, pero tienen uno y tres cambios de estado, respectivamente. Un modelo que asigne una probabilidad desconocida al cambio de estado distingue sus verosimilitudes.
En ese modelo temporal, conservar solo el número de unos pierde información sobre la probabilidad de transición. Un resumen suficiente para una familia puede ser insuficiente para otra. La pérdida no se detecta mirando únicamente el tamaño del archivo.
También debemos distinguir la suficiencia definida para una familia completa de parámetros de una igualdad informacional bajo una previa específica. Una igualdad obtenida bajo un modelo conjunto particular no implica que el resumen conserve todas las comparaciones posibles entre parámetros de una familia más amplia.
Kullback y Leibler relacionaron información y suficiencia en su trabajo fundacional. El principio práctico es identificar qué distinciones entre hipótesis sobreviven a una estadística y cuáles quedan fusionadas.
Una representación útil debe acompañarse de esa declaración de alcance. Si nuevas preguntas requieren detalles descartados, puede ser necesario conservar también el registro original o diseñar otro resumen; la conveniencia de hacerlo depende de costos y objetivos concretos.
La suficiencia del conteo depende también de la simetría entre sensores. Supongamos que el primero tiene error de una centésima y los otros dos, de dos décimas, con independencia condicional. Los triples 100 y 010 tienen el mismo conteo de unos, pero la evidencia que dan es muy diferente.
Para 100, las probabilidades del registro bajo objetivos uno y cero son y . Con una previa uniforme, la probabilidad posterior de objetivo uno es , aproximadamente .
Para 010, esas probabilidades son y , de modo que la posterior de objetivo uno es . El conteo fusiona una evidencia favorable al uno con otra fuertemente favorable al cero. Ya no es suficiente.
La identidad del sensor resulta relevante porque sus errores difieren. Una reducción basada en supuestos de simetría debe revisarse si cambian calibraciones o condiciones. Conocer únicamente un error promedio de los tres no recupera el detalle perdido.
El ejemplo temporal admite una comprobación semejante. En una cadena binaria estacionaria con probabilidad de cambio , la secuencia 0011 tiene probabilidad y la secuencia 0101, . Ambas tienen dos unos, pero sus probabilidades difieren en un factor de ochenta y uno debido al número de transiciones.
205.7. Procesar también reduce discrepancias entre distribuciones
La divergencia de Kullback–Leibler satisface un límite análogo. Si aplicamos la misma regla probabilística de procesamiento a dos distribuciones de entrada, la divergencia entre las distribuciones de salida no puede superar la divergencia entre las entradas.
Si, en cambio, transformamos cada distribución con un procedimiento que usa su identidad como etiqueta, podemos introducir distinciones adicionales y estaremos comparando otro problema.
Para demostrar la desigualdad, construimos las distribuciones conjuntas de entrada y salida bajo ambos modelos. Como comparten el mismo mecanismo condicional de procesamiento, la divergencia conjunta coincide con la de las entradas.
Al descomponer esa divergencia empezando por la salida, aparece la divergencia entre salidas más una divergencia condicional no negativa entre las entradas dadas las salidas. Descartar este último término produce la cota.
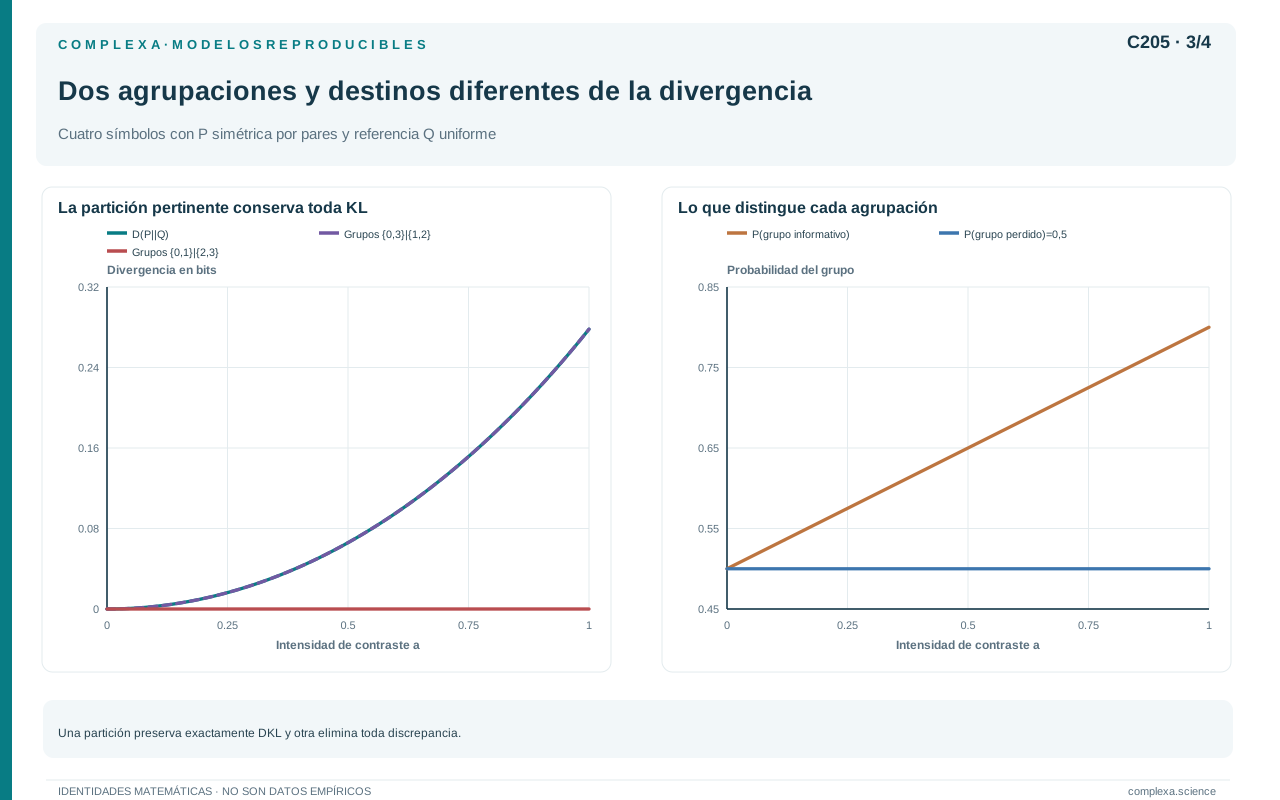
Consideremos cuatro categorías con distribución y una referencia uniforme . Su divergencia es aproximadamente bits.
Si agrupamos la primera categoría con la cuarta y la segunda con la tercera, las distribuciones resultantes son y . La divergencia se conserva exactamente.
Dentro de cada grupo, el cociente de probabilidades entre modelos es constante. La etiqueta del grupo conserva toda la distinción relevante para comparar estos dos modelos, aunque descarte cuál de las dos categorías internas ocurrió.
Si agrupamos, por el contrario, las dos primeras categorías y las dos últimas, ambas distribuciones de salida son uniformes. La divergencia cae a cero y los modelos se vuelven indistinguibles mediante ese resumen.
El mismo número de grupos puede conservar toda la discrepancia o eliminarla por completo. La pérdida depende, más que del grado de reducción, de cómo se alinean los grupos con la pregunta de comparación.
Esta propiedad ayuda a evaluar discretizaciones y resúmenes. También impide interpretar una discrepancia pequeña después de un procesamiento muy agresivo como prueba de que los modelos originales eran semejantes en todos sus detalles.
205.8. Por qué un algoritmo puede mejorar después de resumir
La desigualdad trata de la información disponible para procedimientos ideales bajo un modelo. Un algoritmo concreto puede tener restricciones de capacidad, tiempo, datos de entrenamiento o forma funcional. Una transformación puede hacer accesible una relación que ese algoritmo no sabía explotar.
Supongamos que dos bits observados determinan un objetivo mediante XOR. La observación de ambos contiene un bit completo sobre el objetivo. Una representación que calcula directamente XOR también contiene ese bit, aunque reduzca dos entradas a una salida.
Un clasificador que solo puede trazar una separación lineal en el espacio de los dos bits no representa perfectamente esa regla. Después de transformar las entradas, una decisión sencilla puede resolverla. La representación cambió el problema computacional disponible para el clasificador sin crear información.
La reducción de ruido irrelevante o de dimensiones también puede ayudar con muestras pequeñas. Un modelo menos flexible puede generalizar mejor al evitar ajustes a detalles accidentales. Esa mejora corresponde al procedimiento de aprendizaje y a su cantidad de datos.
Una idea relacionada aparece en la teoría de comparación de experimentos, desarrollada por Blackwell. Quien dispone de la observación original puede simular un procesamiento de ella y luego aplicar cualquier decisión basada en la salida. Por ello, sin restricciones adicionales, tener la observación original no obliga a una decisión peor.
En la práctica, conservar y procesar el original puede tener costos. Un resumen puede reducir memoria, latencia o esfuerzo de interpretación. La elección adecuada pondera la información relevante frente a los recursos disponibles.
Los parámetros aprendidos también necesitan una contabilidad explícita. Si una transformación depende de un conjunto de entrenamiento, podemos condicionar el análisis a ese conjunto y estudiar la información disponible sobre nuevos casos. Si incorpora etiquetas de los mismos casos usados para evaluar, aparece fuga de información.
Un resultado excelente en entrenamiento no demuestra que la representación conserve una relación reproducible. Debemos evaluar su desempeño sobre observaciones pertinentes que no determinaron su construcción, respetando la estructura temporal o grupal del problema.
La comparación decisional puede expresarse sin apelar a un algoritmo específico. Una regla que usa la salida asigna una distribución de acciones a cada valor procesado. Quien observa la entrada puede generar esa salida con el mismo procesamiento y aplicar después exactamente la misma regla.
El procedimiento compuesto reproduce la distribución de acciones y resultados, de modo que tiene el mismo costo esperado para cualquier función de pérdida admisible. Al optimizar sobre todas las reglas basadas en la entrada, el costo mínimo no puede ser mayor.
Esta demostración explica tanto el límite como su alcance. Si imponemos restricciones computacionales, almacenamiento limitado o costos de acceso, las clases de procedimientos ya no son las mismas. Una representación reducida puede ser preferible en la práctica aunque la observación completa siga siendo más informativa en el sentido ideal.
Por eso una evaluación debe declarar qué recursos están incluidos en el objetivo. El costo de obtener, almacenar y usar una señal puede cambiar la decisión sin alterar ninguna identidad informacional.
Si llamamos al conjunto de entrenamiento y la representación se construye como , podemos comparar con bajo la condición de procesamiento correspondiente. Condicionar mantiene fija la información aprendida en ambos lados. Comparar una salida que usa ese conjunto con una entrada descrita sin él puede ocultar el conocimiento auxiliar y producir una interpretación equivocada.
205.9. Auditar una transformación en datos reales
Comenzamos describiendo las entradas y salidas con precisión suficiente para reconstruir el procedimiento. Identificamos si es determinista, si usa aleatoriedad y si consulta datos o parámetros adicionales. Después definimos el objetivo respecto del cual queremos evaluar la conservación.
Conviene distinguir pérdidas por medición, por almacenamiento y por procesamiento. Un sensor puede eliminar una distinción antes de que el archivo exista; una compresión posterior no es responsable de esa pérdida inicial, aunque puede añadir otras.
Una transformación invertible puede cambiar mucho la apariencia de los datos y conservar todas las distinciones. Una transformación aparentemente pequeña, como redondear cerca de un umbral importante, puede eliminar información decisiva para una pregunta concreta.
Las estimaciones de información deben compararse bajo una distribución coherente. Si construimos una distribución empírica conjunta y aplicamos un resumen determinista, la desigualdad también vale exactamente para esa distribución empírica. El error de muestreo no autoriza una violación algebraica interna.
Si diferentes estimadores o resoluciones producen una aparente ganancia, debemos examinar sus aproximaciones antes de anunciar una excepción al teorema. También puede haber cambiado la población analizada, por ejemplo al descartar registros después de observar el resultado.
En modelos de reconstrucción, una salida plausible no garantiza recuperación del detalle verdadero. Si varias entradas físicas distintas producen la misma observación disponible, un algoritmo puede escoger una reconstrucción apoyándose en una distribución previa. Esa elección debe distinguirse de una identificación respaldada por el registro.
La evaluación puede usar tareas concretas y comparaciones de probabilidades, además de una medida global. Un resumen puede conservar un objetivo y perjudicar otro. Documentar ese intercambio facilita decidir si conviene mantener diferentes niveles de representación.
También es útil comprobar casos límite conocidos. Una copia invertible debe conservar información, una salida constante debe perderla (salvo que el objetivo ya fuera independiente) y un ruido adicional independiente no debe aumentar la información sobre el objetivo. Son controles de interpretación y de implementación.
Hay un límite adicional para la idea de un resumen suficiente para cualquier pregunta futura. Si una transformación fusiona dos observaciones distintas que tienen probabilidad positiva, podemos construir un objetivo que distinga precisamente esas dos observaciones.
La observación original determina ese objetivo. El resumen fusionado ya no lo determina dentro del grupo correspondiente, por lo que deja una incertidumbre condicional positiva. En consecuencia, ha perdido información para al menos una pregunta.
Otra forma de verlo es tomar como objetivo la propia observación original. Conservar toda su información exige que pueda recuperarse a partir de la representación, salvo resultados de probabilidad nula. En ese sentido, la conservación universal conduce a una transformación invertible sobre el soporte pertinente.
Un resumen no invertible puede ser excelente para un conjunto definido de objetivos. Lo que no puede prometer, sin más condiciones, es preservar toda posible distinción que alguien decida estudiar después. Esta limitación es matemática y no depende de la sofisticación del algoritmo usado.
La decisión de archivo debe reconocer ese intercambio. Podemos conservar un resumen operativo y otro nivel más detallado para análisis posteriores, o aceptar una pérdida porque su costo es menor que el de almacenar el original. La justificación debe relacionar las preguntas previstas con los recursos disponibles y dejar explícitas las distinciones descartadas.
205.10. Conservar lo relevante exige definirlo
El procesamiento de datos establece un límite sobre una cadena de observaciones y representaciones. Una transformación que solo usa la entrada no puede añadir información sobre un objetivo que la entrada no contenía. La pérdida puede localizarse mediante una información condicional residual.
Los ejemplos mostraron que el tamaño del resumen no determina su calidad. El conteo de tres sensores conserva la información pertinente bajo simetría e independencia condicional; la mayoría conserva una decisión pero pierde confianza; otra agrupación puede borrar por completo la diferencia entre modelos.
La suficiencia requiere un modelo y una pregunta. Cambiar la estructura temporal, las tasas de error o el objetivo puede volver insuficiente un resumen antes adecuado. La conservación debe demostrarse o evaluarse bajo condiciones explícitas.
También distinguimos límites informacionales de mejoras computacionales. Una representación puede facilitar el aprendizaje y reducir costos sin crear evidencia nueva. El análisis es más claro cuando reconoce ambas dimensiones.
El siguiente capítulo estudiará la codificación sin pérdida, es decir, cómo representar las distinciones que decidimos conservar mediante secuencias de símbolos, qué restricciones permiten recuperarlas y cómo interviene la redundancia estadística.
Referencias
- Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379–423. DOI.
- Kullback, S., y Leibler, R. A. (1951). On information and sufficiency. The Annals of Mathematical Statistics, 22(1), 79–86. DOI.
- Blackwell, D. (1953). Equivalent comparisons of experiments. The Annals of Mathematical Statistics, 24(2), 265–272. DOI.