COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 22. Información temporal, multivariada y entre escalas
218.1. Precisar qué significa una ventaja
Una descripción macroscópica reúne muchos estados microscópicos bajo una misma etiqueta. Podemos describir una multitud mediante sus integrantes o mediante una densidad; una red mediante sus nodos o mediante comunidades; una dinámica mediante configuraciones completas o mediante clases de comportamiento.
La descripción agregada suele ser más breve. También puede facilitar predicciones, decisiones y explicaciones. Afirmar que posee mayor capacidad causal exige, sin embargo, especificar qué intervenciones se permiten, qué resultados se distinguen y qué cantidad se usa para evaluarlos.
Hoel, Albantakis y Tononi propusieron estudiar una forma de emergencia causal mediante información efectiva. Bajo ciertas construcciones, una escala macroscópica obtiene un valor mayor que una escala microscópica. El resultado es matemático dentro de un protocolo definido y debe interpretarse con sus supuestos.
Hay una dificultad que parece inmediata. Si la variable macroscópica se calcula a partir del estado microscópico, no puede contener más información que ese estado sobre un mismo objetivo bajo una misma distribución. La desigualdad de procesamiento de datos sigue vigente.
Para resolverla hay que examinar qué permanece fijo y qué cambia. Algunas comparaciones de información efectiva usan intervenciones uniformes sobre los estados de cada escala. La distribución uniforme sobre grupos no suele coincidir con la distribución inducida al intervenir uniformemente sobre todos los estados individuales.
Por tanto, podemos estar comparando dos experimentos de intervención diferentes. El resultado es compatible con esa desigualdad, aunque obliga a explicar qué representa cada experimento y por qué interesa confrontarlos.
En este capítulo construiremos un sistema pequeño donde aparece la ventaja, calcularemos sus valores y mostraremos qué sucede al mantener fija la distribución. Después examinaremos los problemas de agrupación, memoria y validación.
Queda fuera de la discusión resolver todos los sentidos filosóficos de emergencia o deducir que una escala sea siempre superior para cualquier tarea. Buscamos una afirmación evaluable, según la cual, bajo una medida y un conjunto de intervenciones especificados, una representación puede distinguir mejor ciertas consecuencias.
Una ventaja práctica de un modelo y una ganancia de información efectiva están relacionadas en algunas situaciones, aunque son resultados distintos. Podemos tener un modelo agregado útil sin ganancia informativa, o una ganancia informativa cuyo protocolo de intervención sea difícil de realizar.
218.2. Información efectiva de un canal de intervención
Supongamos un sistema finito con estado actual X y estado posterior Y. Conocemos una matriz de transición cuyas filas especifican la distribución del resultado al fijar experimentalmente cada estado inicial.
La interpretación causal requiere que esas filas representen intervenciones válidas o estén identificadas mediante supuestos adecuados. Una matriz de frecuencias observadas no adquiere automáticamente ese significado.
Elegimos una distribución de intervenciones sobre los estados iniciales. Si todos los estados son equiprobables, construimos una distribución conjunta multiplicando cada fila de transición por el inverso del número de estados.
En la formulación que usaremos, la información efectiva es la información mutua entre intervención y resultado bajo esa distribución uniforme
El primer término mide la diversidad de resultados bajo el conjunto de intervenciones. El segundo mide la incertidumbre media que permanece después de fijar la intervención.
Si todas las intervenciones producen exactamente la misma distribución de resultados, la información efectiva es cero. Observar el resultado no ayuda a distinguir qué intervención se aplicó.
Si cada intervención produce de manera determinista un resultado distinto, la información efectiva alcanza el logaritmo del número de estados iniciales. El canal conserva todas las distinciones entre esas intervenciones.
Un sistema puede ser determinista y tener información efectiva baja; basta con que muchas intervenciones conduzcan al mismo resultado.
También puede existir ruido dentro de grupos de resultados mientras se preserva perfectamente una distinción agregada. Ese será el mecanismo de nuestro primer ejemplo.
La distribución uniforme es una convención experimental específica. No coincide necesariamente con la frecuencia espontánea de los estados, con una distribución estacionaria o con el conjunto de intervenciones físicamente accesibles.
Si algunos estados no pueden prepararse, asignarles peso uniforme define un experimento idealizado. Puede ser útil teóricamente, pero debemos distinguirlo del experimento realizable. Si las intervenciones tienen costos diferentes, equipararlas en probabilidad tampoco las equipara en recursos.
La información efectiva se expresa en bits y no tiene unidades de energía, fuerza ni beneficio. El adjetivo causal proviene del origen de la matriz de transición. La cantidad informativa no recoge todas las propiedades que podríamos exigir a una noción general de causalidad.
218.3. Un sistema de cuatro estados
Consideremos cuatro estados microscópicos, llamados cero, uno, dos y tres. Desde cualquiera de los tres primeros, el sistema pasa con igual probabilidad a uno de esos mismos tres estados. Desde el cuarto, permanece en el cuarto.
La matriz de transición es
Las filas corresponden al estado preparado y las columnas al estado posterior. Cada fila suma uno. Los tres primeros estados forman el grupo A y el último forma el grupo B; la dinámica conserva la pertenencia a cada grupo.
Bajo intervenciones microscópicas uniformes, cada fila recibe peso de un cuarto. La distribución de salida también es uniforme sobre los cuatro estados y su entropía vale dos bits.
La incertidumbre condicional de cada una de las tres primeras filas es el logaritmo de tres. La última fila tiene incertidumbre cero, así que la incertidumbre condicional media es tres cuartos del logaritmo de tres.
Por tanto,
El sistema no conserva cuál de los tres estados del grupo A fue preparado. Esas tres intervenciones tienen consecuencias idénticas. Sí conserva perfectamente si la intervención pertenecía al grupo A o al grupo B.
Ahora describamos únicamente esa pertenencia. El sistema macroscópico tiene dos estados y su transición es la identidad (A permanece en A y B permanece en B).
Si intervenimos uniformemente sobre estos dos estados macroscópicos, cada uno recibe probabilidad de un medio. El resultado identifica perfectamente la intervención y la información efectiva macroscópica vale un bit.
La diferencia, calculada con una matriz completamente especificada, es aproximadamente 0,188722 bits a favor de la escala macroscópica.
Hemos cambiado solo la representación y el protocolo de selección de intervenciones, sin crear una nueva transición ni añadir una fuerza. En la escala microscópica, el grupo A recibía tres cuartos de la probabilidad; en la macroscópica, recibe un medio.
La distinción entre grupos se transmite sin error en ambos experimentos, pero su incertidumbre inicial es diferente. Una elección binaria equilibrada transporta más información que una elección con probabilidades de tres cuartos y un cuarto.
El ejemplo permite separar el cálculo de su interpretación. Podemos comprobar la ganancia sin concluir que los detalles microscópicos hayan dejado de determinar el comportamiento agregado.
La ventaja tampoco procede solamente de reducir el número de estados. Si reemplazamos la matriz por la identidad de cuatro estados, cada intervención microscópica conserva una distinción diferente y la información efectiva vale dos bits.
La misma agrupación en tres estados frente a uno produce una identidad macroscópica de dos estados, con un bit bajo intervenciones equilibradas. Ahora la agregación pierde un bit respecto de la evaluación microscópica uniforme.
Podemos construir otro control con dos grupos de dos estados cada uno y mezclas uniformes dentro de cada grupo. La evaluación microscópica uniforme ya equilibra las pertenencias. Su información efectiva vale un bit, igual que la macroscópica, de modo que la agregación simplifica la descripción sin generar una ganancia.
Estos controles distinguen una ventaja bajo ponderaciones diferentes, una igualdad cuando solo se eliminan distinciones irrelevantes y una pérdida cuando se eliminan distinciones transmitidas. La dirección del cambio depende de la dinámica y del protocolo, además del tamaño de la representación.
218.4. Mantener fija la distribución resuelve la aparente paradoja
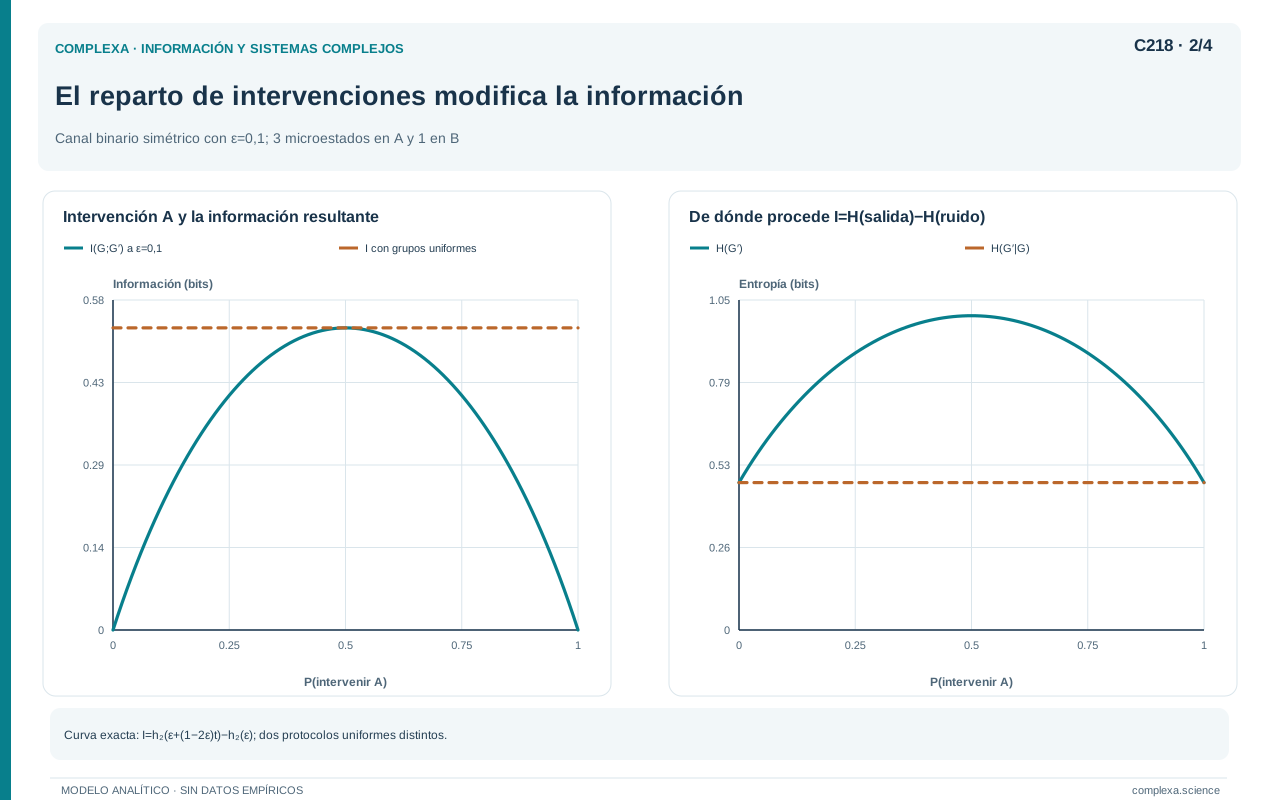
Rehagamos la comparación con una sola distribución conjunta. Conservemos las intervenciones uniformes sobre los cuatro estados microscópicos y calculemos las variables de grupo antes y después de la transición.
La probabilidad inicial del grupo A es tres cuartos y la del grupo B, un cuarto. Como la pertenencia se conserva, la información mutua entre grupos inicial y final vale la entropía binaria de un cuarto (aproximadamente 0,811278 bits).
La información microscópica bajo ese mismo experimento también vale 0,811278 bits. La agregación conserva toda la información relevante en este ejemplo, pero no la aumenta.
Podemos hacer la comparación inversa. Empecemos seleccionando los dos grupos con probabilidades iguales. Dentro del grupo A, preparemos uniformemente uno de sus tres estados; dentro del grupo B solo hay una opción.
La distribución microscópica inducida será
Bajo ese experimento, la entropía de salida microscópica vale aproximadamente 1,792481 bits. La incertidumbre condicional media vale aproximadamente 0,792481. Su diferencia es un bit.
La información macroscópica también vale un bit. De nuevo, al mantener una distribución coherente entre escalas no aparece un aumento por procesamiento.
En términos generales, si las variables agregadas se obtienen mediante funciones deterministas de los estados inicial y final, la desigualdad de procesamiento de datos establece que para una distribución conjunta fija. La distribución puede proceder de observación o de intervención; el teorema no depende de cómo fue obtenida.
La comparación de información efectiva entre escalas usa distribuciones uniformes diferentes. Por ello no está comparando directamente los dos lados de esa desigualdad con la misma distribución.
La comparación sigue siendo útil, porque puede interesarnos saber qué representación tiene un conjunto de intervenciones más equilibrado respecto de consecuencias distinguibles. Esa afirmación concreta es diferente de asegurar que una función del estado contiene más información que el estado completo.
Una presentación rigurosa debe mostrar ambas comparaciones cuando la distinción sea central. La comparación con distribuciones uniformes propias de cada escala describe la medida propuesta; la comparación bajo una distribución común permite identificar cuánto depende el resultado de la ponderación.
Conviene evitar expresiones ambiguas como «la macroescala tiene más información» si no se especifica sobre qué resultado y bajo qué experimento. El mismo sistema puede producir igualdad, ventaja aparente o pérdida según la pregunta y la distribución usadas.
La frecuencia espontánea plantea una comparación adicional. En el ejemplo sin cambios entre grupos, una trayectoria iniciada en A nunca visita B. Un registro temporal de esa trayectoria no permite estimar cómo responde el sistema al preparar B.
La matriz completa puede conocerse por construcción o mediante experimentos separados, pero no se deduce de ese registro por el simple hecho de ser largo. Una mezcla de trayectorias iniciadas en ambos grupos puede recuperar más información, aunque sus pesos dependerán del diseño. La diferencia entre exploración espontánea y preparación experimental debe permanecer explícita al conectar el ejemplo con datos.
218.5. Añadir ruido entre grupos
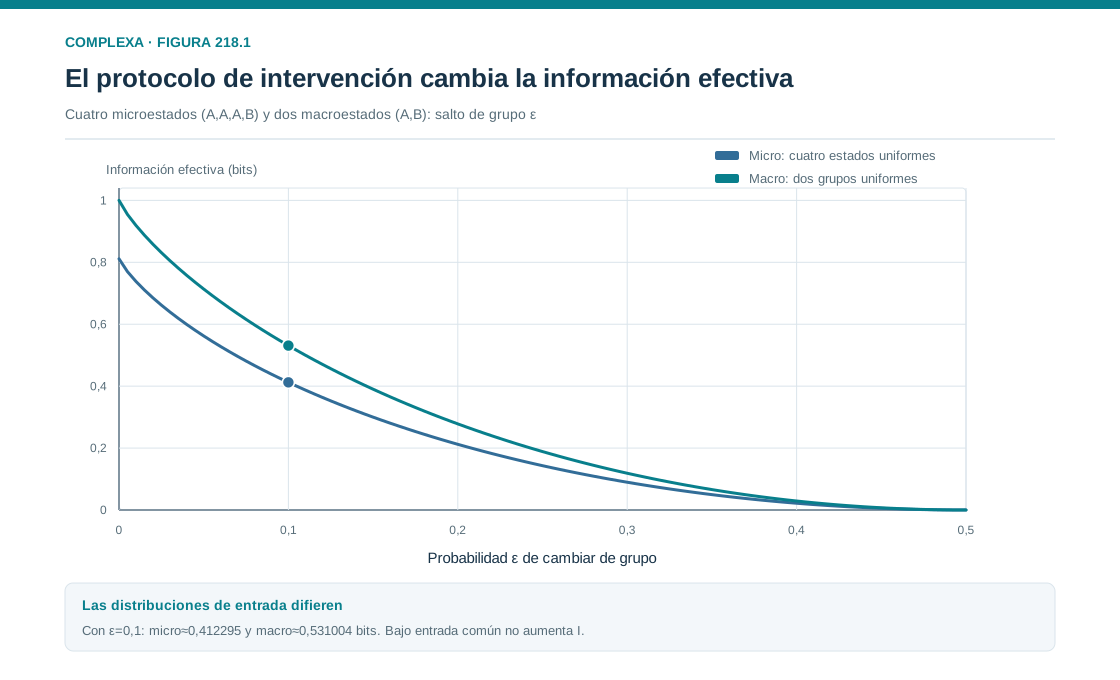
Modifiquemos el sistema para que la pertenencia al grupo pueda cambiar. Con probabilidad epsilon, una transición salta al grupo contrario; con la probabilidad restante conserva el grupo. Cuando el destino es A, se elige uniformemente uno de sus tres estados.
Cada una de las tres filas de A asigna uno menos epsilon dividido por tres a cada destino de A y epsilon a B. La fila de B asigna epsilon dividido por tres a cada destino de A y uno menos epsilon a B.
La dinámica agregada es un canal binario simétrico. Bajo intervenciones macroscópicas equilibradas, su información efectiva vale
En el experimento microscópico uniforme, la probabilidad inicial de B sigue siendo un cuarto. Su probabilidad final pasa a un cuarto más epsilon dividido por dos.
Como los detalles internos de A no distinguen sus intervenciones originales, la información microscópica es
La diferencia entre las dos escalas es uno menos la entropía binaria de la probabilidad final de B. Para epsilon igual a una décima, la escala macroscópica obtiene aproximadamente 0,531004 bits y la microscópica, 0,412295.
La ventaja es aproximadamente 0,118709 bits. Es menor que en el caso sin cambios de grupo, pero sigue siendo positiva bajo los protocolos definidos.
Podemos comprobar el cálculo desde las entropías microscópicas completas. La distribución de salida asigna siete décimos de masa al grupo A y tres décimos a B. La entropía de salida vale aproximadamente 1,990765 bits.
La incertidumbre condicional media vale aproximadamente 1,578469 y la resta reproduce los 0,412295 bits anteriores. El ruido interno de A aparece en ambos términos y se cancela porque no transporta información sobre cuál de sus estados fue preparado.
Si epsilon vale un medio, la salida agregada es independiente del grupo inicial y las dos informaciones efectivas se anulan. Una representación más pequeña no puede recuperar una distinción que la dinámica ya no transmite.
La capacidad del canal permite otra comparación. Si podemos optimizar libremente la distribución de intervenciones microscópicas, podemos equilibrar los grupos. En este ejemplo, la capacidad microscópica alcanza el mismo valor que la información efectiva macroscópica.
Por ello, la escala macroscópica supera la evaluación microscópica con intervenciones uniformes sobre los cuatro estados, pero solo iguala la mejor codificación microscópica disponible en este canal. Hoel relaciona esta cuestión con la selección de códigos y la capacidad de canal; el ejemplo permite observar la diferencia sin depender de una analogía.
La cota puede entenderse para cualquier preparación que seleccione un microestado a partir del macroestado y use después el mismo canal microscópico. La cadena formada por preparación, transición y lectura agregada está sometida a procesamiento de datos, de modo que su información no puede superar la capacidad del canal original. Esta afirmación presupone que no cambiamos el mecanismo, el tiempo de transición ni los recursos permitidos durante la comparación.
218.6. Una agrupación necesita una dinámica bien definida
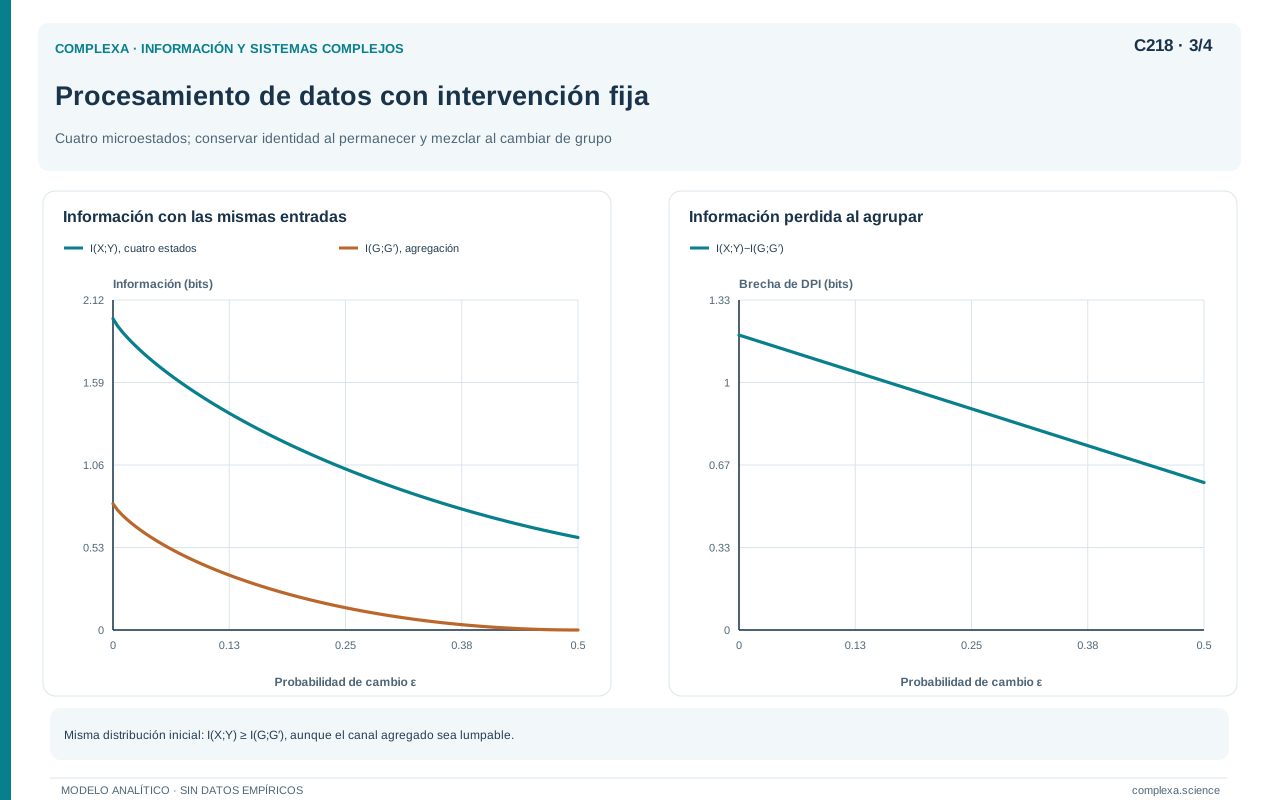
Para construir un modelo macroscópico no basta agrupar nombres. Necesitamos saber si todos los estados de un grupo producen las mismas probabilidades de llegar a cada grupo de destino.
Una condición suficiente, conocida como agrupabilidad fuerte, exige que dos estados pertenecientes al mismo grupo tengan idéntica suma de probabilidades de transición hacia cualquier grupo de destino.
Bajo esta condición, el proceso agregado de una cadena de Markov puede describirse mediante una matriz de transición independiente de cómo se distribuya la probabilidad dentro del grupo inicial.
Nuestro ejemplo de cuatro estados satisface esa condición. Todas las filas de A tienen las mismas probabilidades de destino agregado, tanto en el caso sin ruido como en su modificación.
Veamos qué ocurre cuando la condición falla. Consideremos tres estados que recorren un ciclo determinista en el que cero pasa a uno, uno a dos y dos a cero. Agrupemos cero y uno en A; el estado dos queda en B.
Desde el estado cero, el próximo grupo es A. Desde el estado uno, el próximo grupo es B. Saber únicamente que estamos en A no permite asignar una probabilidad de salida sin conocer cómo se reparte la masa entre sus dos estados.
Si promediamos uniformemente dentro de A, obtendremos una fila con probabilidades iguales de A y B. Desde B siempre pasamos a A. Esa matriz puede describir una preparación particular de un paso, pero no necesariamente la dinámica agregada de varios pasos.
Preparemos el estado B, que corresponde al estado microscópico dos. Tras un paso estamos en cero y, tras dos pasos, en uno. El grupo observado es A en ambos momentos.
La matriz macroscópica promediada predeciría, en cambio, una probabilidad de un medio de estar en B después de dos pasos. Ha olvidado que llegar desde B determina cuál de los dos estados de A ocupamos.
La historia contiene información que la etiqueta agregada no retiene. Podemos ampliar el estado macroscópico con memoria, modificar la agrupación o limitar explícitamente el modelo a un experimento de un paso con una preparación interna especificada.
No debemos multiplicar una matriz agregada como si fuera una dinámica autónoma sin revisar esta cuestión. Una puntuación informativa atractiva en un paso puede coexistir con predicciones incorrectas al iterar el modelo.
También hay agrupaciones que funcionan bajo una distribución inicial particular sin cumplir la condición fuerte para todas las preparaciones. Su validez debe enunciarse con ese alcance limitado.
La condición fuerte se puede verificar directamente en una matriz finita. Para cada grupo de origen, sumamos en cada fila las probabilidades correspondientes a cada grupo de destino. Después comparamos esos vectores de sumas entre todas las filas del grupo de origen.
Si coinciden, la probabilidad de destino agregado no depende del estado microscópico particular dentro del grupo. Al promediar con cualquier distribución interna obtenemos el mismo vector. Así se explica que la condición elimine la dependencia de la preparación en las transiciones agregadas.
218.7. Qué significa intervenir sobre un estado macroscópico
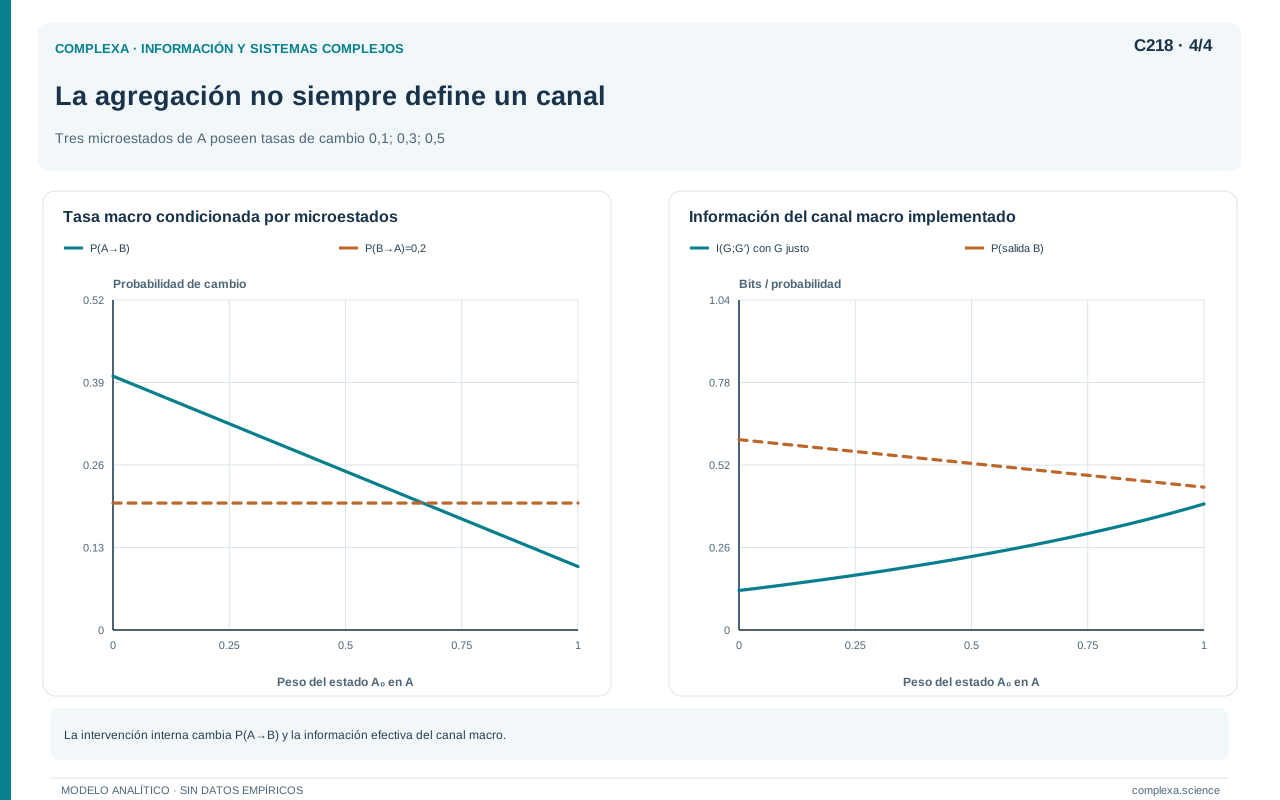
Una etiqueta agregada suele corresponder a muchas configuraciones microscópicas. Preparar el macroestado requiere decidir cuál de esas configuraciones se realiza y con qué probabilidad. Esa regla de preparación forma parte del protocolo.
Podemos representarla mediante una distribución de estados microscópicos condicionada por el macroestado elegido. La transición macroscópica se obtiene promediando las consecuencias microscópicas según esa preparación y agrupando después los resultados.
Si existe agrupabilidad fuerte, la elección de distribución interna no cambia las probabilidades de destino agregado. Si no existe, distintas preparaciones del mismo macroestado pueden producir efectos distintos.
Pensemos en una variable agregada que es un promedio. Muchas configuraciones comparten ese promedio. Cambiar el promedio mediante un elemento extremo, mediante un cambio uniforme de todos o mediante una redistribución selectiva puede afectar de manera diferente al futuro. Por eso una intervención sobre el promedio necesita una realización operacional. La notación de intervención sobre una variable agregada no especifica cómo se actúa sobre el sistema.
Hay que considerar también la accesibilidad. Algunas configuraciones pueden ser formalmente posibles en el modelo y prácticamente imposibles de preparar. Otras pueden violar restricciones de conservación que el espacio de estados simplificado omitió.
Una distribución uniforme sobre un espacio mal definido puede dar peso a situaciones que no corresponden al sistema estudiado. Antes de interpretar la información efectiva conviene revisar qué estados son admisibles y cómo se justificó su conjunto.
El costo de intervención introduce otra dimensión. Si una preparación macroscópica requiere un control microscópico muy preciso, su ventaja informativa puede no convertirse en una ventaja experimental o tecnológica.
Podemos estudiar entonces la información por unidad de costo, las restricciones de canal o el desempeño en una tarea concreta. Esas cantidades requieren definiciones adicionales y no deben confundirse con la información efectiva sin restricciones.
La elección de escala temporal presenta un problema semejante. Comparar un paso microscópico con varios pasos macroscópicos cambia el tiempo disponible para que se manifiesten consecuencias. La comparación puede ser pertinente, pero debe declarar esa diferencia.
Un modelo agregado útil puede sacrificar detalles rápidos para describir una evolución lenta. Su valor depende de la pregunta y del horizonte. La información por transición y la información por unidad de tiempo pueden ordenar de manera diferente las representaciones.
218.8. Otras formulaciones de emergencia informativa
El nombre emergencia causal también aparece en propuestas basadas en información multivariada y capacidad predictiva. Rosas y colaboradores desarrollaron un marco que relaciona propiedades colectivas con información sobre el futuro que no está disponible en componentes considerados individualmente.
Este enfoque no equivale directamente a una ganancia de información efectiva entre distribuciones uniformes, ya que cambian la pregunta, los objetos comparados y las condiciones bajo las cuales se interpreta el resultado.
La distinción puede verse con una propiedad de paridad. Si el futuro preserva la paridad de varios bits, una variable colectiva que la registra puede predecirla aunque cada bit aislado no lo consiga.
El estado microscópico completo también permite calcular esa paridad. La ventaja de la propiedad colectiva se establece frente a componentes o grupos restringidos; la información conjunta del estado completo, bajo la misma distribución, queda fuera de esa comparación.
La descomposición parcial de información ayuda a formalizar estas diferencias. Sin embargo, como vimos, su elección introduce supuestos sobre redundancia, exclusividad y sinergia. Una conclusión debe identificar la construcción usada.
También debemos distinguir distribuciones observacionales de distribuciones obtenidas mediante intervención. Un resultado predictivo puede describir una dependencia temporal sin identificar qué ocurriría al modificar una variable del sistema.
Los autores del marco multivariado discuten expresamente esa diferencia. En aplicaciones observacionales, la interpretación causal puede referirse al sentido predictivo de Wiener–Granger, con sus condiciones y limitaciones.
No es adecuado trasladar un resultado de un marco a otro solo porque ambos usan la palabra emergencia. Si una propiedad cumple un criterio y no otro, eso puede indicar que responden a preguntas distintas, sin que uno de ellos contenga necesariamente un error.
Una comparación útil construye un mismo sistema sintético, especifica las distribuciones y aplica cada definición por separado. Después identifica la propiedad que produce el acuerdo o el desacuerdo.
Estas medidas tampoco resuelven cuestiones sobre conciencia, significado o autonomía ontológica. Pueden contribuir a modelos de fenómenos concretos, pero la conexión exige hipótesis y evidencia que no se desprenden de una desigualdad informativa aislada.
218.9. Cómo auditar una afirmación de ventaja macroscópica
La auditoría comienza con el espacio de estados y la matriz de transición. Debemos saber si fueron definidos por un modelo, estimados de observaciones o identificados mediante experimentos, porque cada procedencia permite interpretaciones diferentes.
Después examinamos la función de agrupación. Una tabla debe permitir reconstruir qué estados microscópicos pertenecen a cada macroestado. Si se descartan estados, debe explicarse cómo cambia el experimento.
El tercer elemento es la distribución de intervenciones en cada escala. Conviene calcular la distribución microscópica inducida por las intervenciones macroscópicas, ya que esa operación revela si la comparación mantiene o cambia las ponderaciones.
La regla de preparación interna requiere especial atención cuando los macroestados tienen tamaños diferentes. Preparar grupos equiprobables y elegir uniformemente dentro de ellos produce probabilidades microscópicas inversamente proporcionales al tamaño de cada grupo.
Luego verificamos normalización, entropías y valores informativos. En un sistema pequeño, calcular la información tanto mediante diferencias de entropías como mediante la definición de información mutua da una comprobación independiente.
La validez dinámica requiere revisar la agrupabilidad o cuantificar la memoria residual. Comparar predicciones de varios pasos puede detectar una agregación que parece adecuada únicamente en transiciones aisladas.
Si la agrupación fue seleccionada explorando muchas alternativas, debemos considerar el sesgo de selección. Una mejora obtenida en los mismos datos usados para buscarla puede no reproducirse en registros nuevos.
Las pruebas fuera de muestra, las simulaciones con parámetros conocidos y los análisis de perturbación ayudan a evaluar la estabilidad. No sustituyen la definición causal, pero permiten separar una propiedad robusta de una selección accidental.
Una mejor predicción empírica de la escala macroscópica también puede deberse a que requiere estimar menos parámetros. Con datos limitados, un modelo microscópico flexible puede sobreajustar y generalizar peor. Esa ventaja estadística es relevante, pero debe distinguirse de una comparación entre canales conocidos exactamente. Para separarlas podemos simular muestras de distintos tamaños y comprobar si la diferencia disminuye al mejorar la estimación microscópica o persiste por la definición de intervenciones empleada.
También conviene comparar con agrupaciones de referencia. Una reducción arbitraria puede mejorar ciertas puntuaciones normalizadas simplemente porque disminuye el número de estados. Mostrar valores absolutos y criterios de referencia ayuda a detectar esa posibilidad.
Por ejemplo, dividir la información efectiva por el logaritmo del número de estados produce una fracción de la cota máxima correspondiente a esa escala. Esa fracción y la información absoluta responden a preguntas distintas.
Un modelo con un bit de dos posibles tiene fracción de un medio; otro con tres cuartos de bit de uno posible tiene una fracción mayor y una cantidad absoluta menor. Presentar solo la fracción podría ocultar la pérdida de información total. La decisión sobre qué desempeño importa debe preceder a la comparación.
El informe debe distinguir resultados exactos del modelo y estimaciones empíricas. En nuestro ejemplo, la ventaja de 0,188722 bits es un cálculo de una distribución conocida. No es una medición de un sistema natural ni una estimación con un intervalo de confianza implícito.
218.10. Qué permite concluir el ejemplo
El sistema de cuatro estados muestra que una agrupación puede tener mayor información efectiva cuando cada escala se evalúa con intervenciones uniformes propias. La ganancia surge porque las distinciones relevantes se equilibran de manera diferente.
Al mantener fija una distribución conjunta, la agregación no aumenta la información mutua. En el ejemplo conserva exactamente la información sobre pertenencia a grupos y elimina detalles que no distinguen intervenciones.
La modificación con ruido muestra que la ventaja puede persistir cuando la transmisión entre grupos es imperfecta. También muestra que desaparece cuando las consecuencias dejan de depender de la intervención.
El ciclo de tres estados revela que una etiqueta macroscópica no siempre define un estado suficiente para predecir la siguiente transición. Sin una preparación especificada o una propiedad de cierre, el modelo agregado puede adquirir memoria.
Estas observaciones permiten valorar una propuesta de emergencia causal sin convertirla en una afirmación total sobre todas las escalas. La pregunta pertinente es qué regularidad captura, bajo qué intervenciones y con qué pérdida de detalles.
Una descripción macroscópica puede ser muy útil porque conserva las distinciones necesarias, facilita el control o permite predicciones estables. Demostrar cualquiera de esas ventajas exige una comparación explícita. La información efectiva es una de esas comparaciones; su alcance se vuelve más claro cuando representación, distribución y dinámica se mantienen visibles.
Referencias
- Hoel, E. P., Albantakis, L., y Tononi, G. (2013). Quantifying causal emergence shows that macro can beat micro. Proceedings of the National Academy of Sciences, 110(49), 19790–19795. DOI: 10.1073/pnas.1314922110.
- Hoel, E. P. (2017). When the Map Is Better Than the Territory. Entropy, 19(5), 188. DOI: 10.3390/e19050188.
- Rosas, F. E., Mediano, P. A. M., Jensen, H. J., Seth, A. K., Barrett, A. B., Carhart-Harris, R. L., y Bor, D. (2020). Reconciling emergences: An information-theoretic approach to identify causal emergence in multivariate data. PLOS Computational Biology, 16(12), e1008289. DOI: 10.1371/journal.pcbi.1008289.