COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 22. Información temporal, multivariada y entre escalas
216.1. Una distribución, varias preguntas legítimas
La información mutua permite cuantificar cuánto reduce una observación la incertidumbre sobre un objetivo. Cuando hay varias fuentes, esa respuesta puede ser insuficiente. Queremos distinguir información compartida, información exclusiva de cada fuente e información que aparece al combinar observaciones.
Esta distinción es útil para estudiar sensores, secuencias, sistemas de aprendizaje y registros fisiológicos. Sin embargo, las palabras redundancia y sinergia no determinan una única operación matemática. Antes de calcularlas necesitamos decidir qué significa que dos fuentes informen sobre lo mismo.
Consideremos dos instrumentos que identifican aspectos distintos de un objeto. Ambos pueden reducir su incertidumbre en un bit. La igualdad de cantidades no garantiza identidad de contenido; conocer el color y conocer la forma pueden ser resultados igualmente informativos y claramente diferentes.
Dos instrumentos también pueden tener capacidades equivalentes para decidir sobre un objetivo, aunque en una realización concreta produzcan observaciones diferentes. Una definición centrada en esas capacidades puede clasificarlos de manera distinta a otra centrada en la coincidencia de sus cambios de probabilidad.
La descomposición parcial de información, o PID por sus siglas en inglés, organiza estas preguntas mediante componentes que deben reconstruir la información total. Williams y Beer propusieron un marco general; trabajos posteriores desarrollaron criterios alternativos. Aquí examinaremos tres construcciones para dos fuentes y un objetivo finitos.
El propósito es poder leer una descomposición con precisión. Un valor de sinergia debe ir acompañado de la definición usada, la distribución analizada y las decisiones sobre las variables; el nombre de un algoritmo no sustituye esa especificación.
Trabajaremos con probabilidades conocidas en ejemplos sintéticos para separar la ambigüedad conceptual de la incertidumbre estadística. Primero veremos que hay desacuerdos sin errores de muestreo; la estimación vendrá después.
Todos los logaritmos serán de base dos. Las cantidades se expresarán en bits y los términos de probabilidad nula se tratarán mediante sus límites habituales. Las referencias al final permiten identificar las propuestas originales; los ejemplos se desarrollan aquí de forma explícita.
216.2. Las identidades que cualquier propuesta debe completar
Sean un objetivo discreto y dos fuentes . Escribamos sus informaciones individuales como e y la conjunta como . Una descomposición bivariada introduce redundancia , información exclusiva y sinergia tales que
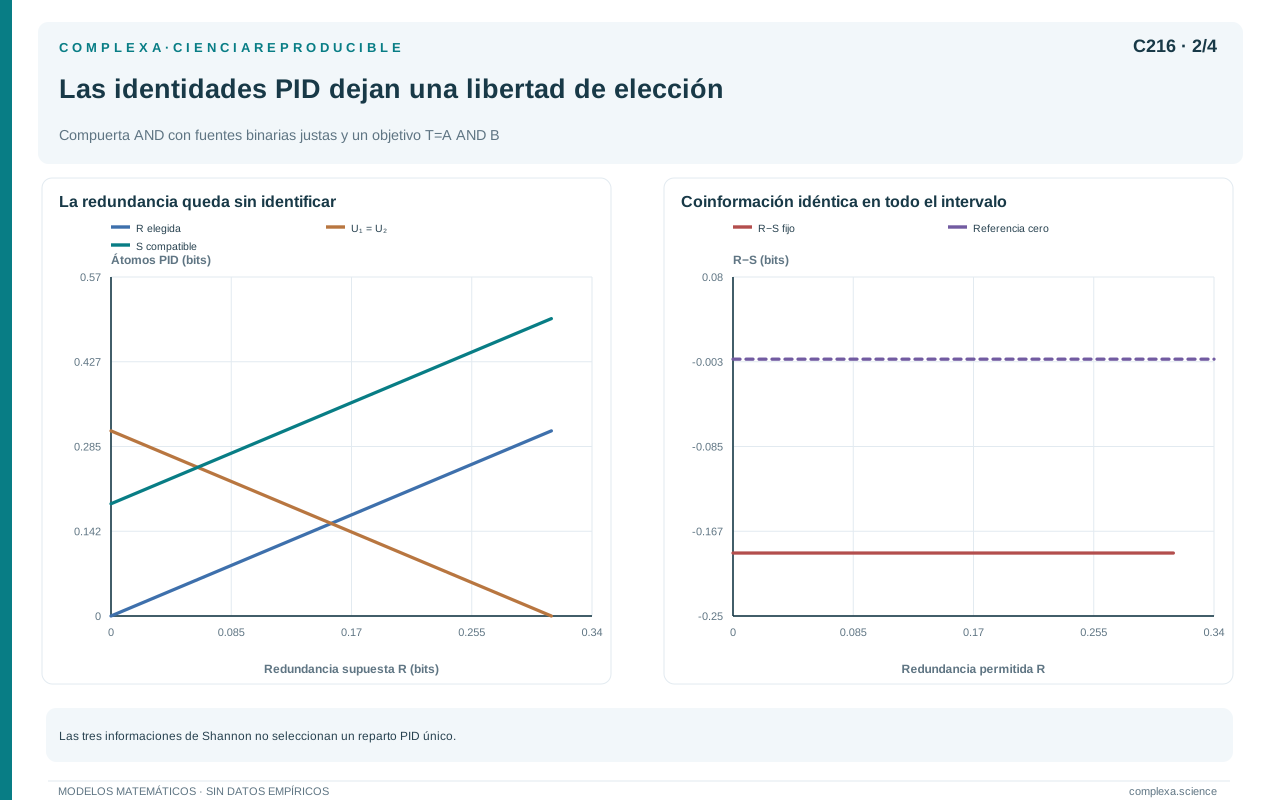
Tenemos tres ecuaciones y cuatro incógnitas. Si elegimos la redundancia, los demás componentes quedan fijados. Ese valor adicional no se deduce de las identidades de Shannon.
Si exigimos componentes no negativos, la redundancia queda restringida al intervalo
Este intervalo puede reducirse a un punto en ejemplos especiales. Si ambas fuentes son copias del mismo bit justo que es el objetivo, las tres informaciones valen uno; la redundancia debe valer uno y los demás componentes deben desaparecer.
Si las fuentes son bits independientes y el objetivo es su paridad, las informaciones individuales son cero y la conjunta vale uno. La no negatividad obliga a clasificar ese bit como sinérgico. Estos casos son pruebas básicas, pero no resuelven todas las distribuciones.
La simetría exige que intercambiar los nombres de las fuentes intercambie sus componentes exclusivos y conserve redundancia y sinergia. La autorredundancia exige que la redundancia de una única fuente coincida con su información mutua sobre el objetivo.
La monotonicidad debe interpretarse con cuidado. Pedir información común a más fuentes separadas puede restringir lo compartido. En cambio, añadir observaciones dentro de una fuente compuesta puede aumentar sus capacidades. Son operaciones distintas, aunque ambas se describan informalmente como agregar variables.
Otro criterio, formalizado por Harder, Salge y Polani, es la propiedad de identidad. Según ella, cuando el objetivo es exactamente la pareja de fuentes, la redundancia debería coincidir con la información mutua entre ellas. Esta exigencia no se deduce de las tres ecuaciones anteriores.
Elegir axiomas es decidir qué comportamientos consideramos indispensables. Podemos valorar la comparación de decisiones, la geometría de las distribuciones posteriores o la información sobre resultados concretos. Una auditoría debe identificar esas prioridades antes de declarar que dos métodos miden la misma cosa.
La coincidencia numérica tampoco demuestra equivalencia conceptual. Dos propuestas pueden responder igual en copias perfectas y paridades, pero separarse en una tercera distribución. Conviene incluir ejemplos capaces de distinguirlas, además de los casos en que todas deberían coincidir.
216.3. Información específica y la construcción mínima
La propuesta denominada compara cuánto informa cada fuente sobre cada resultado del objetivo. Para un resultado de probabilidad positiva definimos la información específica
Esta cantidad es no negativa y su promedio sobre los resultados del objetivo es la información mutua. Conviene distinguirla de otras cantidades locales que también reciben nombres relacionados con la información específica y que pueden tomar valores negativos.
Williams y Beer definen la redundancia promediando, sobre los resultados del objetivo, la menor información específica entre las fuentes
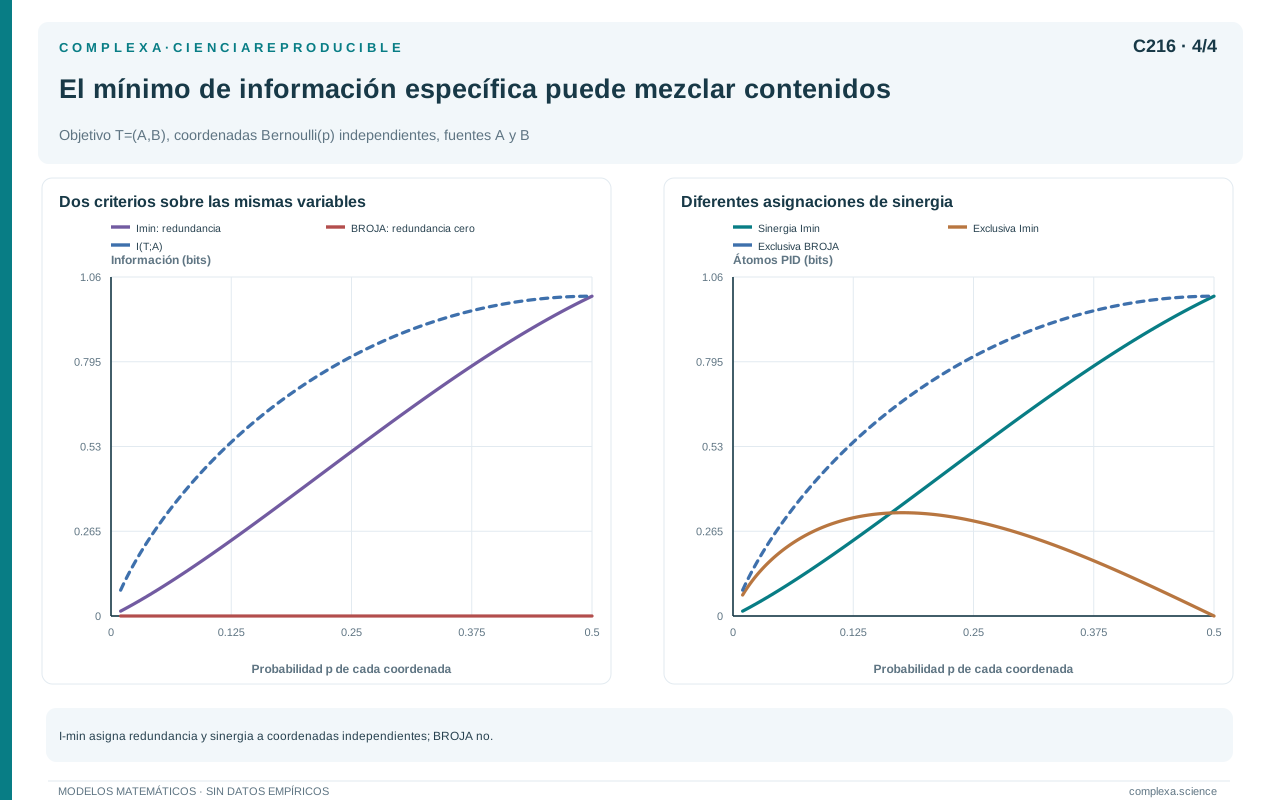
La operación tiene una lectura sencilla, pues para cada resultado no atribuye como compartida una cantidad mayor que la disponible en cualquiera de las fuentes. Sin embargo, compara cantidades escalares; esa característica es decisiva al interpretar sus resultados.
Consideremos dos bits justos independientes, y . El objetivo es la pareja ordenada y cada fuente observa una coordenada (la primera conoce el primer bit y la segunda, el segundo).
Hay cuatro objetivos posibles, todos igualmente probables. Conocer una coordenada descarta dos de ellos, así que para cualquiera de los cuatro resultados la información específica de cada fuente vale un bit. El mínimo también vale uno y su promedio no cambia.
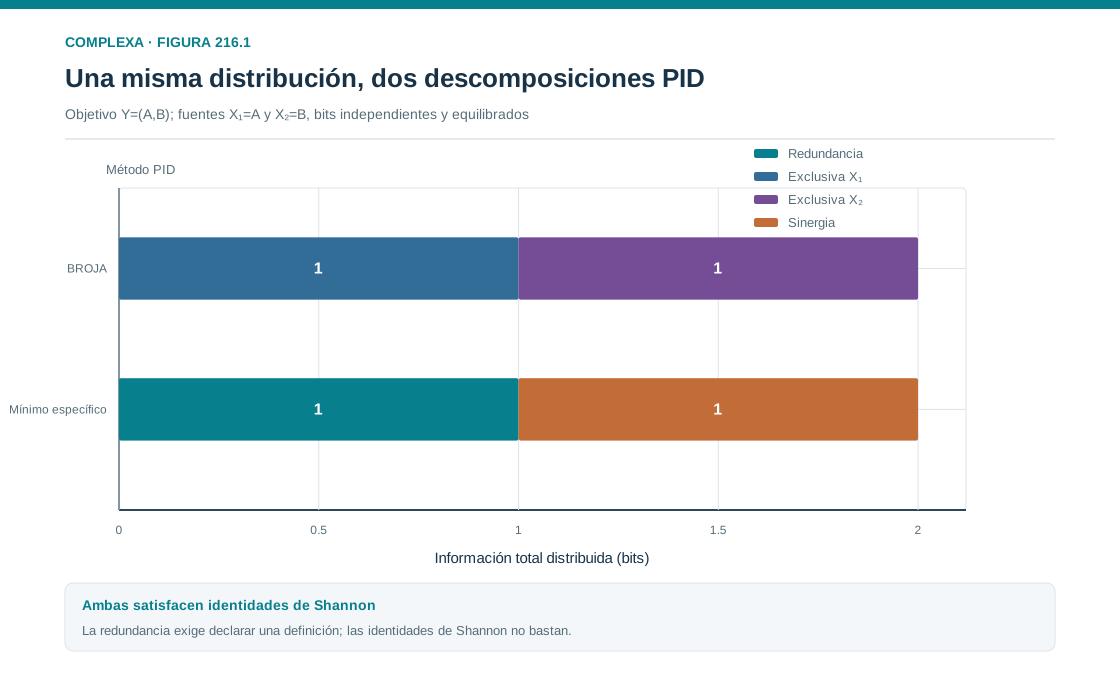
Por tanto, esta construcción asigna un bit de redundancia. Como cada información individual vale uno y la conjunta vale dos, las identidades obligan a asignar cero información exclusiva y un bit de sinergia.
El cálculo satisface sus reglas, pero muestra una tensión conceptual. Las fuentes identifican coordenadas independientes; si queremos que esa situación cuente como dos aportes exclusivos, necesitamos una condición que distinga igualdad de cantidad e identidad de información.
La propiedad de identidad resuelve este ejemplo de otra manera. Como la información mutua entre los dos bits independientes es cero, exige redundancia nula. Entonces cada fuente aporta un bit exclusivo y no aparece sinergia.
Ambas respuestas se obtienen con la distribución exacta, sin redondeo ni muestreo; la diferencia proviene del criterio usado para llamar compartida a una información.
Podemos modificar el ejemplo haciendo coincidir los dos bits. Ahora las dos fuentes y el objetivo contienen el mismo dato; las dos lecturas concuerdan en una redundancia de un bit. Era, pues, la independencia de las coordenadas lo que permitía distinguir los criterios.
También podemos entregar a cada fuente el objetivo completo. Las informaciones individuales y la conjunta pasan a dos bits y toda la información resulta redundante bajo una descomposición no negativa. Saber cuántos valores puede tomar una fuente no decide el reparto; hay que especificar su relación con el objetivo y con la otra observación.
216.4. Comparar distribuciones posteriores mediante proyecciones
Una segunda construcción, propuesta por Harder, Salge y Polani, compara los cambios de distribución del objetivo que permiten las fuentes. La información queda representada por qué probabilidades cambian, además de por cuánto disminuye la incertidumbre.
Cada resultado de la segunda fuente produce una distribución posterior sobre el objetivo. Las mezclas de esas distribuciones, con pesos no negativos que suman uno, forman su envolvente convexa.
Para cada resultado de la primera fuente buscamos dentro de ese conjunto la distribución más cercana a su posterior, usando una dirección especificada de la divergencia de Kullback–Leibler. Hay que fijar la dirección porque esta divergencia no es simétrica.
La información proyectada se escribe
donde contiene las mezclas de posteriores de la segunda fuente. La redundancia es el menor de los valores obtenidos en las dos direcciones de proyección.
Podemos comprobar el ejemplo de las dos coordenadas sin resolver un problema numérico general. Ordenemos los objetivos como cero cero, cero uno, uno cero y uno uno. Saber que el primer bit es cero produce el vector de probabilidades
Las mezclas de posteriores que se obtienen con la segunda fuente tienen la forma
Ninguna de estas mezclas concentra toda la masa en los dos primeros objetivos. La segunda fuente distingue columnas de la tabla; la primera distingue filas.
La divergencia desde el posterior de la primera fuente hasta esa mezcla vale
Su mínimo se alcanza en un medio y vale un bit. Al restarlo del bit de información individual, la información proyectada queda en cero. La otra dirección da el mismo resultado, de modo que la redundancia desaparece.
La geometría reconoce que ambas fuentes desplazan las probabilidades en direcciones diferentes, así que una misma cantidad de información no implica superposición.
En una copia perfecta sucede lo contrario. El posterior que genera una fuente está directamente entre los posteriores de la otra, así que la divergencia mínima es cero y la información proyectada conserva toda la información individual.
Las proyecciones también tienen límites interpretativos, porque se hacen en un espacio de distribuciones. Una coincidencia de posteriores no demuestra una conexión causal entre instrumentos ni una duplicación material de señales.
Para aplicar esta propuesta hay que declarar los estados del objetivo y las fuentes. Una agrupación de categorías cambia las distribuciones posteriores y puede cambiar la redundancia. La elección de representación forma parte del análisis, incluso cuando el procedimiento de optimización es exacto.
216.5. Información exclusiva y distribuciones alternativas
La construcción de Bertschinger, Rauh, Olbrich, Jost y Ay, conocida como BROJA, parte de otra pregunta. Busca qué información exclusiva puede garantizar una fuente al comparar sus capacidades individuales con las de la otra.
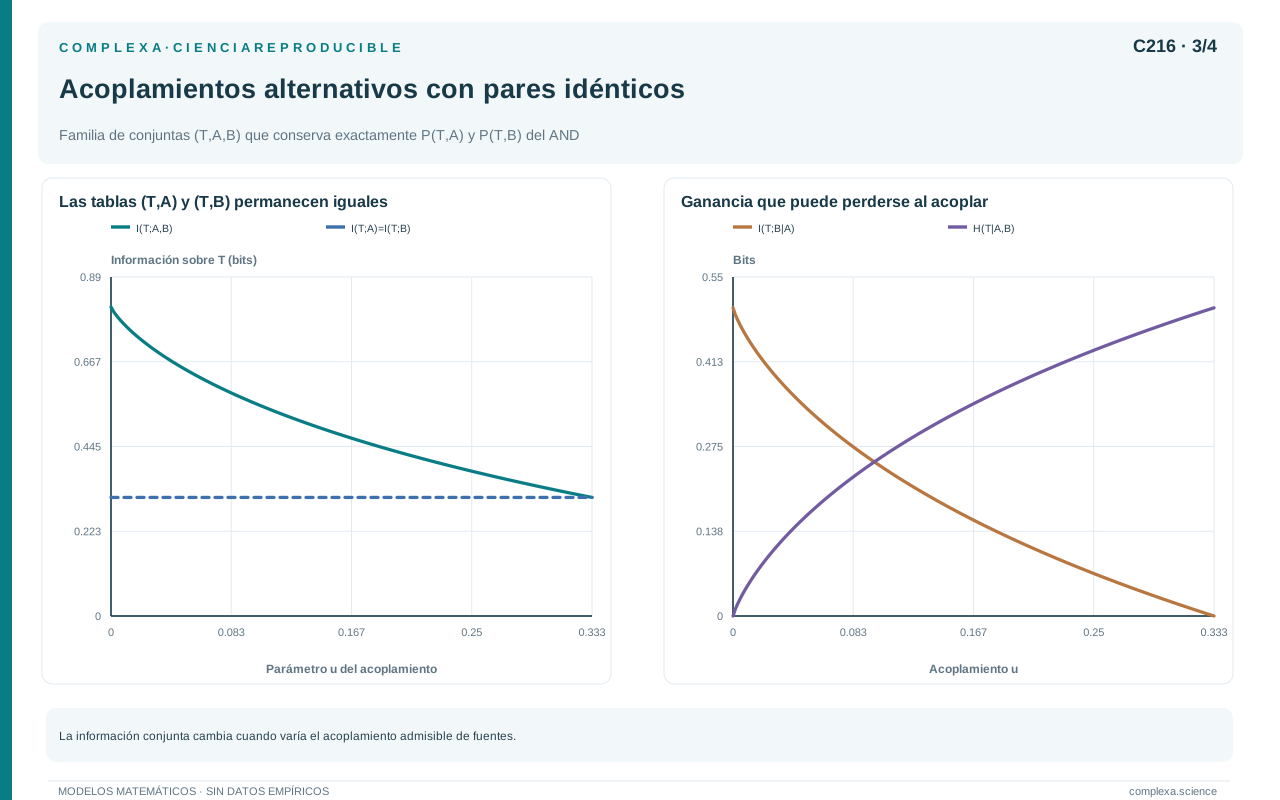
Se mantiene la distribución conjunta del objetivo con cada fuente por separado, pero se permite variar cómo se acoplan las dos fuentes entre sí dado el objetivo.
Sea el conjunto de distribuciones que conservan los dos marginales relevantes de la distribución original
Definimos la menor información conjunta compatible con esos marginales
Como las informaciones individuales permanecen fijas, los cuatro componentes son
La primera expresión también equivale a minimizar la información condicional de la primera fuente dada la segunda. En espacios finitos, el conjunto de distribuciones admisibles es compacto y las cantidades informativas relevantes son continuas.
Estas distribuciones alternativas son instrumentos de definición; nada garantiza que sean intervenciones realizables sobre el sistema observado. En particular, conservar dos marginales no obliga a conservar una regla determinista que relacionaba originalmente las tres variables.
Volvamos a la paridad de bits independientes. Cada fuente por separado es independiente del objetivo, de modo que entre las distribuciones permitidas hay una en la que las tres variables son independientes. Su información conjunta sobre el objetivo es cero.
Como la información mutua no puede ser negativa, ese cero es el mínimo. La distribución original tenía un bit conjunto, de manera que la diferencia se asigna íntegramente a sinergia, como ya imponía la no negatividad.
En la copia perfecta, los marginales ya obligan a que ambas fuentes coincidan con el objetivo. No hay ninguna redistribución admisible que reduzca esa información conjunta; el mínimo vale uno y toda la información es redundante.
En el ejemplo de las dos coordenadas independientes, cada marginal obliga a que una fuente corresponda a su coordenada del objetivo. Esas condiciones fijan también su combinación. El mínimo conjunto vale dos, la redundancia es cero y cada fuente conserva un bit exclusivo.
La lógica de la optimización también aclara un resultado frecuente. Que la información exclusiva de una fuente sea cero no significa que la fuente sea inútil al combinarla con la otra; puede carecer de una ventaja individual que la otra no pueda ofrecer y, aun así, participar en información sinérgica.
Tampoco podemos reemplazar la minimización por una simple permutación de muestras. Una permutación arbitraria puede destruir los marginales que debían conservarse.
216.6. Una compuerta AND muestra qué se está conservando
Tomemos como fuentes dos bits independientes y justos. El objetivo vale uno únicamente cuando ambos bits valen uno, así que esta regla AND da un objetivo igual a uno con probabilidad de un cuarto.
La entropía del objetivo es aproximadamente 0,811278 bits. Observar una sola fuente deja una incertidumbre media de medio bit, porque si esa fuente vale cero el objetivo queda resuelto y si vale uno depende de la otra.
Cada información individual vale, por tanto, aproximadamente 0,311278 bits. Las dos fuentes juntas identifican exactamente el objetivo, de modo que la información conjunta coincide con su entropía.
Para calcular BROJA usaremos una distribución alternativa cuyos únicos eventos con probabilidad positiva son los de la tabla siguiente.
| Objetivo | Primera fuente | Segunda fuente | Probabilidad |
|---|---|---|---|
| 0 | 0 | 0 | 1/2 |
| 0 | 1 | 1 | 1/4 |
| 1 | 1 | 1 | 1/4 |
En esta distribución las fuentes coinciden siempre. Sin embargo, cada una mantiene exactamente la misma distribución conjunta con el objetivo que tenía en el sistema AND original.
Podemos verificarlo para la primera fuente. El par objetivo cero y fuente cero tiene probabilidad de un medio; objetivo cero y fuente uno tiene un cuarto; objetivo uno y fuente uno tiene un cuarto. El cuarto par tiene probabilidad cero. Lo mismo ocurre con la segunda fuente.
Como las fuentes coinciden, observar ambas no añade información a observar una. La información conjunta alternativa vale 0,311278 bits. Ninguna distribución compatible puede tener información conjunta menor que su información individual, así que hemos alcanzado el mínimo.
La descomposición resultante asigna redundancia de 0,311278 bits, información exclusiva nula para cada fuente y sinergia de medio bit. La suma reconstruye los 0,811278 bits originales.
El valor exacto de esa redundancia es tres cuartos del logaritmo en base dos de cuatro tercios. El factor de tres cuartos es indispensable, porque el logaritmo sin ese factor vale aproximadamente 0,415037 bits y no reproduce las informaciones individuales de este ejemplo.
El evento con objetivo cero y ambas fuentes iguales a uno era imposible bajo la regla AND original, pero aparece con probabilidad de un cuarto en la distribución alternativa. Eso no invalida la optimización, porque sus restricciones solo exigían conservar los marginales.
Si exigiéramos preservar también la regla AND en cada distribución alternativa, estaríamos definiendo otro problema. No sería correcto añadir esa restricción en silencio y presentar el resultado como la misma medida.
También se aclara la aparente paradoja de que dos fuentes independientes tengan redundancia. La redundancia es información sobre el objetivo; respecto de él, las dos fuentes son canales individuales equivalentes, aunque no sean copias mutuas en los datos originales.
La propuesta mínima basada en información específica produce aquí el mismo reparto, porque ambas fuentes tienen la misma información específica para cada resultado. Esta coincidencia no elimina su diferencia en el ejemplo de las dos coordenadas.
El ejemplo AND muestra además que sería incorrecto llamar exclusiva a toda ganancia condicional. La ganancia de añadir una fuente después de observar la otra vale medio bit y, bajo esta descomposición, corresponde a sinergia.
216.7. Comparaciones que conviene separar
Los ejemplos anteriores caben en una tabla pequeña, que no debe leerse como una clasificación universal de los métodos. Cada tupla indica, en este orden, redundancia, información exclusiva de la primera fuente, información exclusiva de la segunda y sinergia.
| Sistema | Construcción mínima | Construcción BROJA |
|---|---|---|
| Dos copias de un bit objetivo | ||
| Paridad de dos bits justos independientes | ||
| Objetivo formado por dos coordenadas independientes | ||
| AND de dos bits justos independientes |
La construcción por proyecciones coincide con el reparto de dos aportes exclusivos en el ejemplo de las coordenadas. Lo hemos demostrado directamente, sin necesidad de suponer que coincide con BROJA en todas las distribuciones.
La tabla permite separar el desacuerdo conceptual del numérico. Si dos implementaciones de una misma definición producen resultados diferentes para una distribución exacta, debemos revisar código, tolerancias y convenciones. Si implementan definiciones distintas, primero examinamos qué propiedad las separa.
Una buena comparación conserva el mismo objetivo, las mismas fuentes y el mismo tratamiento de probabilidades nulas. Cambiar simultáneamente la medida y la discretización impide atribuir la diferencia a una sola decisión.
Hay transformaciones que deberían dejar intacta la pregunta. Si intercambiamos las etiquetas cero y uno de una fuente, conservando todas las probabilidades correspondientes, no hemos perdido observaciones. Una descomposición basada en esas distribuciones debe reconocer la equivalencia.
Por ejemplo, una fuente puede copiar el objetivo y otra entregar su complemento. Las observaciones nunca coinciden como símbolos, pero cualquiera de ellas identifica perfectamente el objetivo. Bajo las construcciones examinadas la redundancia es completa; una comparación literal de símbolos habría inducido a error.
En cambio, reemplazar una fuente por una constante no es un simple cambio de etiquetas, porque destruye su información. Si la otra sigue copiando un bit objetivo justo, la única descomposición no negativa compatible asigna ese bit como exclusivo de la fuente conservada.
El contraste permite evaluar un procesamiento previo. Una codificación reversible preserva las distinciones disponibles, mientras que una agrupación irreversible puede fusionar estados que antes se distinguían. Aunque ambas operaciones cambien la apariencia de los datos, solo la segunda modifica necesariamente qué observaciones pueden recuperarse.
También podemos añadir a una fuente una variable independiente de todo el sistema. El nuevo ruido aumenta la entropía de esa fuente, pero no su información mutua sobre el objetivo. Una interpretación que atribuyera mayor capacidad predictiva únicamente por ese aumento confundiría tamaño de la observación y relevancia.
Las unidades deben mantenerse. Un resultado en nats difiere de otro en bits por un factor constante, que no indica ninguna estructura informativa nueva.
La normalización introduce otra decisión. Dividir cada componente por la información conjunta puede facilitar comparaciones, pero no está definido cuando esa información es cero. Además, una fracción grande puede corresponder a una cantidad absoluta muy pequeña.
En un informe conviene mostrar la fracción y la cantidad absoluta cuando sea pertinente. Una sinergia de la mitad del total puede significar medio bit o una milésima de bit, según el sistema.
Puede ser un resultado útil que ciertas conclusiones sobrevivan a criterios alternativos. Cuando no sobreviven, hay que localizar y explicar el desacuerdo; promediar los componentes de métodos incompatibles no resuelve el problema conceptual.
216.8. Tiempo, condicionamiento y causalidad
Podemos elegir como objetivo el futuro de una señal y como fuentes dos historias temporales. La descomposición ayuda entonces a distinguir entre información predictiva compartida y conjunta. La elección de retardos determina exactamente qué observaciones se consideran disponibles.
Si una fuente es el pasado del propio objetivo y otra es el pasado de una señal externa, la información condicional usada en la entropía de transferencia reúne componentes exclusivos y sinérgicos bajo una PID compatible.
Así, una transferencia positiva no equivale necesariamente a información aportada de forma autónoma por la fuente externa; parte de su utilidad puede depender de combinarla con la historia del objetivo.
El condicionamiento por una tercera variable también requiere una definición. Una opción es descomponer por separado la distribución de cada estrato y promediar los componentes con sus probabilidades; otra construcción puede imponer restricciones globales diferentes. Hay que indicar cuál se usa.
Una variable de contexto puede ser una condición experimental, una etapa temporal o una observación previa. Incluirla cambia la pregunta, porque pasamos a medir lo que las fuentes aportan una vez conocido ese contexto.
No debemos condicionar automáticamente por cualquier variable disponible. Si incorporamos una consecuencia futura, podemos introducir información inaccesible en la predicción original. Si seleccionamos mediante un efecto común, pueden aparecer dependencias que no existían en la población.
La PID observacional no elimina estos problemas. Distribuciones iguales producen los mismos componentes aunque procedan de mecanismos causales distintos. Para interpretar redundancia o sinergia causal necesitamos especificar intervenciones y justificar la distribución que generan.
Un sistema puede tener información sinérgica sin que sus fuentes cooperen como agentes. La palabra describe una relación informativa respecto de un objetivo; atribuir intención, coordinación o beneficio adaptativo requiere evidencia adicional.
La escala temporal introduce otra distinción. Dos fuentes pueden ser redundantes respecto del próximo símbolo y aportar información diferente sobre una secuencia futura más extensa. Al cambiar el objetivo cambia la distribución que descomponemos, de modo que no hay contradicción en que también cambie el reparto.
Supongamos que el objetivo inmediato es una coordenada de un estado compuesto y el objetivo de largo plazo incluye las dos. Una fuente que observa solo la segunda coordenada puede ser irrelevante en la primera tarea y exclusiva en la segunda. El horizonte predictivo forma parte de la definición operacional.
La interpretación local exige precaución adicional. Que los componentes promediados sean no negativos no garantiza que lo sea cualquier fórmula propuesta para atribuirlos a eventos individuales. Para estudiar episodios concretos hay que especificar también la construcción local y comprobar que su promedio reproduce la cantidad global anunciada.
216.9. Estimación y verificación computacional
Hasta ahora conocíamos la distribución exacta. Con datos finitos hay que estimarla y el número de combinaciones puede crecer rápidamente. Una tabla casi vacía puede producir repartos aparentemente precisos que dependen mucho de unas pocas observaciones.
Conviene separar la incertidumbre de la distribución de la incertidumbre del optimizador. Repetir una minimización con distintas inicializaciones examina el optimizador, pero no estima cuánto cambiaría el resultado con otra muestra. Un remuestreo, a su vez, no garantiza que cada problema numérico haya convergido correctamente.
Para una optimización con marginales fijos debemos comprobar que las probabilidades finales son no negativas, suman uno y reproducen los marginales dentro de una tolerancia declarada. También hay que revisar el valor de la función minimizada y las condiciones de convergencia.
Las identidades de reconstrucción son otra verificación necesaria. La suma de los componentes debe recuperar la información conjunta y las combinaciones correspondientes deben recuperar cada información individual. Cumplirlas no demuestra que el cálculo sea completamente correcto, pero incumplirlas revela un problema.
Un valor negativo diminuto puede deberse a tolerancias numéricas en una construcción teóricamente no negativa. Antes de truncarlo a cero hay que registrar su tamaño y comprobar su origen. Un valor negativo grande exige investigar la implementación o los supuestos.
Los ejemplos de copia, paridad y coordenadas independientes son referencias exactas. El ejemplo AND añade una solución explícita con marginales verificables. Estas pruebas son más informativas que comprobar únicamente que el programa termina sin errores.
La discretización merece análisis propio. Cambiar el número de categorías puede alterar tanto la distribución poblacional representada como el sesgo de estimación. Una aparente transición hacia mayor sinergia puede deberse a una resolución distinta o a un alfabeto demasiado grande para la muestra.
En series temporales, las observaciones cercanas no son necesariamente independientes y la estimación de la incertidumbre debe respetar esa dependencia; mezclar tiempos arbitrariamente puede destruir la estructura que se pretendía medir.
Un error fácil de detectar es confundir probabilidades conjuntas y condicionales. Las primeras deben sumar uno sobre todos los eventos; las segundas, dentro de cada condición que tenga probabilidad positiva. Una tabla normalizada por filas no puede introducirse directamente donde se espera una distribución conjunta.
Otra comprobación es calcular las informaciones individuales como diferencia de entropías y como divergencia entre la distribución conjunta y el producto de marginales. Para tablas pequeñas conocidas exactamente, ambas deben coincidir dentro del error aritmético. La comparación ayuda a localizar errores anteriores a la descomposición.
Si el objetivo tiene una única categoría observada, todas sus informaciones estimadas serán cero. Ese resultado no demuestra que el proceso real carezca de estructura, porque puede indicar que la muestra no capturó otros resultados. Una normalización automática puede ocultar el problema al producir valores indefinidos o convenciones arbitrarias.
216.10. Elegir una definición mediante la pregunta
Una elección defendible comienza por especificar qué queremos distinguir. Si necesitamos reconocer como exclusivos los aportes sobre coordenadas independientes, la propiedad de identidad es pertinente. Si comparamos capacidades individuales de observación, conviene examinar las restricciones de la construcción basada en marginales.
Después definimos objetivo, fuentes, escalas y contexto. La misma colección de variables puede producir preguntas diferentes cuando una de ellas pasa de fuente a objetivo. La asimetría de esos papeles debe quedar visible en la notación y en el texto.
El informe debe identificar la fórmula concreta dentro de la familia PID. También debe distinguir las cantidades poblacionales calculadas exactamente de las estimaciones obtenidas con datos; una tabla de resultados puede parecer idéntica en ambos casos y tener grados de incertidumbre muy distintos.
Una conclusión adecuada podría afirmar que, para una representación y una medida especificadas, parte de la información predictiva conjunta se clasifica como sinérgica. Una conclusión sobre integración funcional o causal necesitaría conectar ese resultado con hipótesis y evidencia adicionales.
La comparación entre alternativas obliga a saber qué propiedades necesitamos y qué implicaciones aceptamos. Esa decisión, que no requiere declarar una medida ganadora para toda situación, hace que la descomposición sea interpretable y que sus desacuerdos puedan convertirse en preguntas científicas concretas.
Extender el análisis a tres o más fuentes requiere otro desarrollo, porque aparecen combinaciones de grupos de observaciones y nuevas formas de compartir información. Repetir una descomposición de dos fuentes para cada pareja es insuficiente, ya que esas respuestas no reconstruyen necesariamente la estructura conjunta completa.
Por eso conviene separar los resultados bivariados demostrados de las generalizaciones propuestas. Un método que funciona bajo un conjunto de axiomas para dos fuentes no adquiere automáticamente todas las propiedades deseadas al aumentar su número. Especificar el alcance evita convertir una herramienta concreta en una afirmación más amplia de lo que sus supuestos permiten.
Referencias
- Williams, P. L., y Beer, R. D. (2010). Nonnegative Decomposition of Multivariate Information. Prepublicación. arXiv:1004.2515.
- Harder, M., Salge, C., y Polani, D. (2013). Bivariate measure of redundant information. Physical Review E, 87, 012130. DOI: 10.1103/PhysRevE.87.012130.
- Bertschinger, N., Rauh, J., Olbrich, E., Jost, J., y Ay, N. (2014). Quantifying Unique Information. Entropy, 16, 2161–2183. DOI: 10.3390/e16042161.