COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 22. Información temporal, multivariada y entre escalas
220.1. Diseñar una comparación con respuestas conocidas
Un análisis puede declarar que una señal es más compleja que otra y obtener la conclusión contraria al cambiar de medida. Antes de atribuirlo a una contradicción, debemos preguntar qué propiedad mide cada cantidad y cuánto error introduce su estimación.
Resolveremos un caso sintético con cuatro procesos binarios. Como conocemos sus reglas, podemos calcular cantidades poblacionales exactas; después generaremos registros finitos y compararemos esas respuestas con estimaciones empíricas.
El proceso A produce bits independientes y justos. Cada observación vale cero o uno con igual probabilidad y no depende de las anteriores.
El proceso B es una cadena de Markov binaria estacionaria. Su estado inicial es justo y en cada paso cambia con probabilidad de una décima. Las decisiones de cambio son independientes entre sí.
El proceso C repite indefinidamente el patrón cero, cero, uno, uno. Para definir un proceso estacionario elegimos al comienzo una de sus cuatro fases con igual probabilidad. La fase permanece fijada durante toda la realización.
El proceso D elige un bit justo al comienzo y lo repite para siempre, de modo que cada realización es constante en cero o en uno.
Las cuatro reglas definen procesos estacionarios, pero no todos permiten estimar sus distribuciones de conjunto mediante frecuencias de una única trayectoria. Esa diferencia será parte del caso, especialmente para el proceso constante.
Las cantidades principales serán la entropía de un símbolo, la tasa de entropía, la información entre símbolos vecinos y la información compartida entre pasado y futuro completos. Miden, respectivamente, la incertidumbre instantánea, la producción de incertidumbre nueva, la dependencia visible a un retardo concreto y la memoria predictiva total.
Los registros finitos contendrán 65.536 símbolos. Las simulaciones de A y B usarán semillas explícitas. Para C elegiremos una realización de fase cero y para D una realización constante generada mediante otra semilla.
Se trata de un banco de prueba sintético, construido para separar propiedades matemáticas conocidas de errores que también aparecerían al analizar datos reales.
220.2. La entropía de un símbolo no distingue las reglas
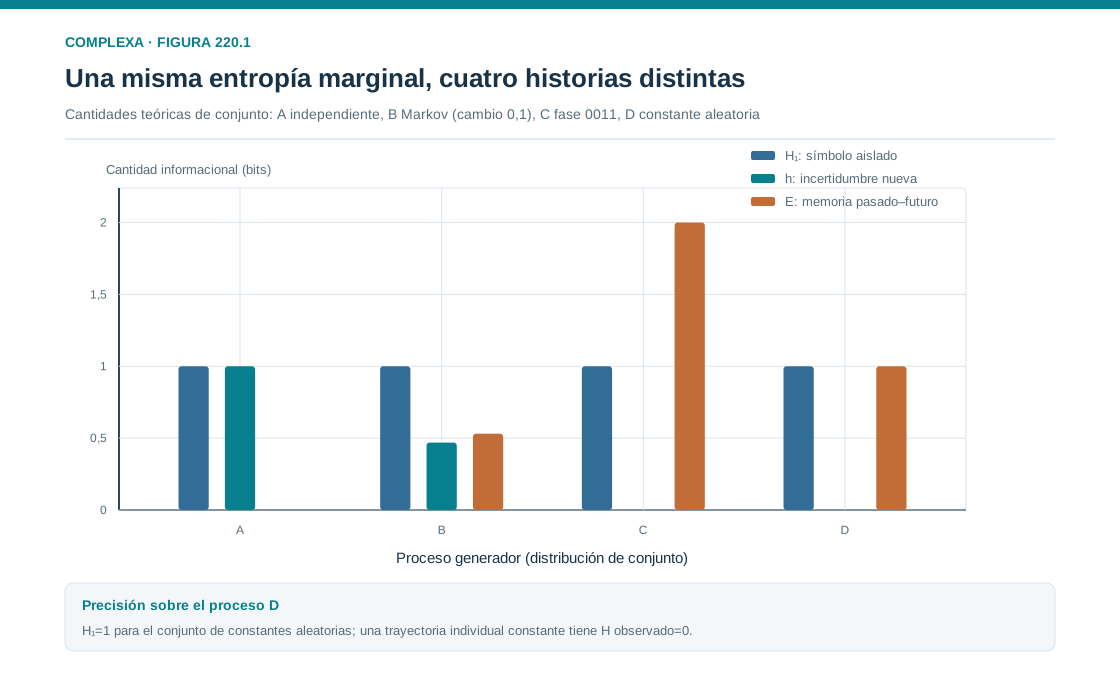
En el conjunto de realizaciones, las cuatro señales tienen la misma distribución marginal, con cero y uno equiprobables. Por tanto, la entropía de un símbolo es un bit en todos los casos.
Para A esto corresponde a incertidumbre nueva en cada instante. Para D corresponde únicamente a no saber qué constante fue elegida al comienzo. El mismo valor marginal resume situaciones temporales completamente distintas.
En C, la elección uniforme de fase garantiza que cada posición observada sea cero o uno con igual probabilidad. La periodicidad no reduce esa incertidumbre marginal antes de conocer la fase.
En B, la transición simétrica conserva una distribución equilibrada de estados. La persistencia aparece en las probabilidades entre instantes, mientras que las frecuencias marginales siguen siendo iguales.
Podemos ampliar la observación a dos símbolos. Para A, las cuatro parejas son equiprobables y la entropía del bloque es dos bits.
En C también aparecen con igual probabilidad las cuatro parejas (cero cero, cero uno, uno uno y uno cero), por lo que su entropía de bloque de longitud dos también vale dos bits.
En B, las parejas iguales tienen probabilidad de 0,45 cada una y las diferentes de 0,05 cada una. La entropía del bloque vale un bit más la entropía binaria de una décima, aproximadamente 1,468996 bits.
En D solo aparecen las parejas cero cero y uno uno, con igual probabilidad entre realizaciones. La entropía del bloque permanece en un bit.
La tabla siguiente muestra qué distinciones aparecen al aumentar apenas la longitud.
| Proceso | Entropía de un símbolo | Entropía de dos símbolos |
|---|---|---|
| A: independiente | 1 | 2 |
| B: persistente | 1 | 1,468996 |
| C: patrón 0011 | 1 | 2 |
| D: constante aleatoria | 1 | 1 |
El proceso periódico y el independiente siguen siendo indistinguibles mediante estas dos entropías, porque aún no hemos observado bloques suficientemente largos para separar sus estructuras.
En C, los dos símbolos anteriores determinan el siguiente, ya que cada pareja identifica una fase del ciclo. Esa regularidad aparece al analizar tríos o al condicionar correctamente, aunque no se vea en la distribución de vecinos.
220.3. La tasa separa renovación de incertidumbre y memoria
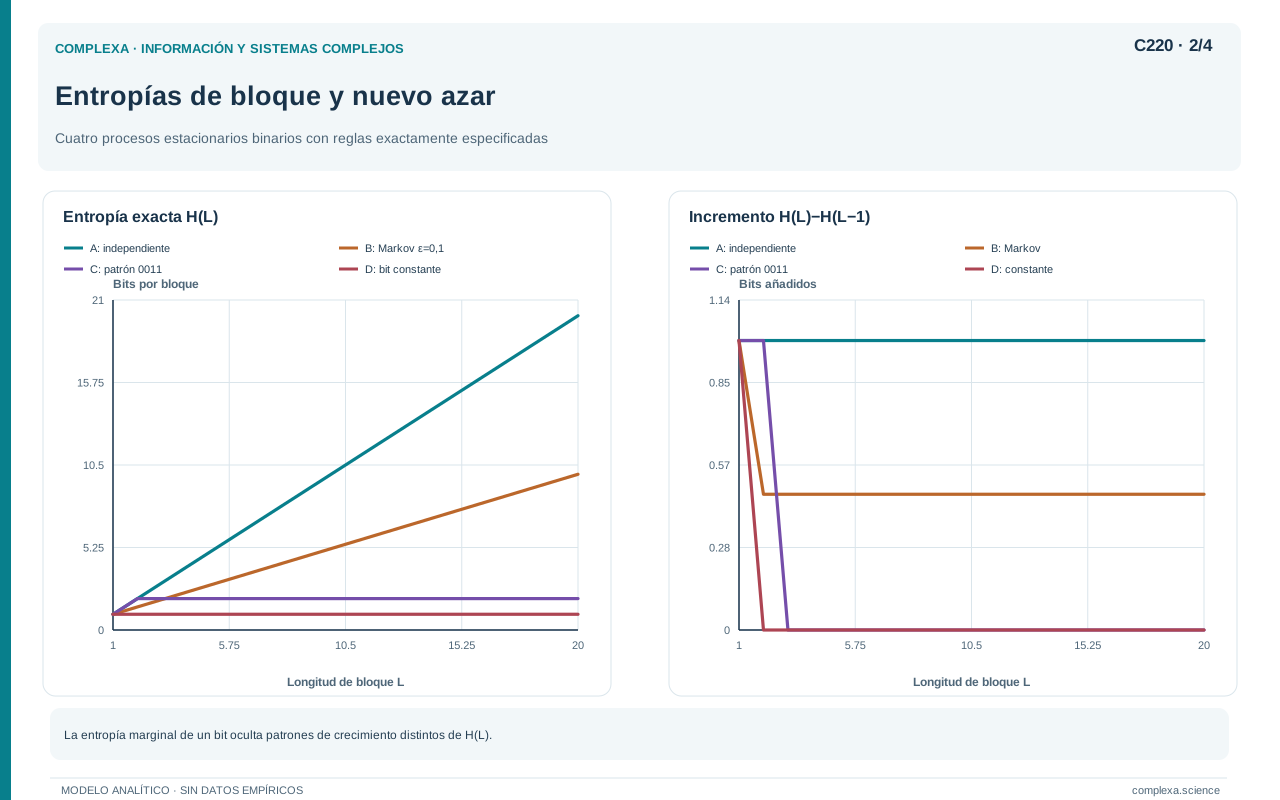
La tasa de entropía mide cuánta incertidumbre añade, en promedio, un nuevo símbolo cuando disponemos de una historia suficientemente larga. Para los procesos estacionarios finitos considerados, podemos obtenerla mediante el crecimiento de entropías de bloque.
En A, la entropía de un bloque de longitud n vale n bits. Cada símbolo añade un bit independiente y la tasa es uno.
En B, el primer símbolo requiere un bit y cada transición añade la entropía binaria de la decisión de cambio, por lo que
Su tasa es aproximadamente 0,468996 bits por símbolo. Aunque cada símbolo aislado sea justo, conocer el anterior reduce la incertidumbre porque la persistencia es probable.
En C, un bloque de longitud dos o mayor identifica la fase y tiene entropía de dos bits. Al aumentar la longitud no aparecen nuevas fases posibles ni nuevas decisiones aleatorias, así que su tasa de entropía es cero. En D, cualquier bloque no vacío tiene entropía de un bit, por lo que su tasa también es cero.
Si definimos informalmente mayor complejidad como mayor incertidumbre nueva por símbolo, el orden sería A, después B y finalmente un empate entre C y D.
Ese orden, sin embargo, no distingue una secuencia periódica con cuatro fases de una constante con dos posibilidades. La tasa descarta la incertidumbre inicial al dividir por longitudes cada vez mayores.
La diferencia finita entre entropía de dos símbolos y de uno ilustra otro peligro. En C vale un bit, exactamente como en A. Si la usáramos como tasa sin examinar memorias más largas, clasificaríamos la secuencia periódica como plenamente aleatoria.
Con tres símbolos, la entropía de C sigue siendo dos bits; la nueva diferencia se vuelve cero y revela que bastan dos símbolos de historia.
En B, la diferencia ya alcanza su valor asintótico al usar una transición porque el proceso tiene orden de Markov uno. En A no se necesita historia y en D basta conocer una observación.
La longitud de contexto necesaria para estimar una tasa depende del proceso, de modo que un mismo procedimiento con retardo fijo puede ser adecuado para una señal e insuficiente para otra.
La precisión también depende de conocer el orden. En un registro empírico, que las diferencias se estabilicen aproximadamente no descarta una memoria más larga y difícil de detectar.
220.4. La información pasado–futuro produce otro orden
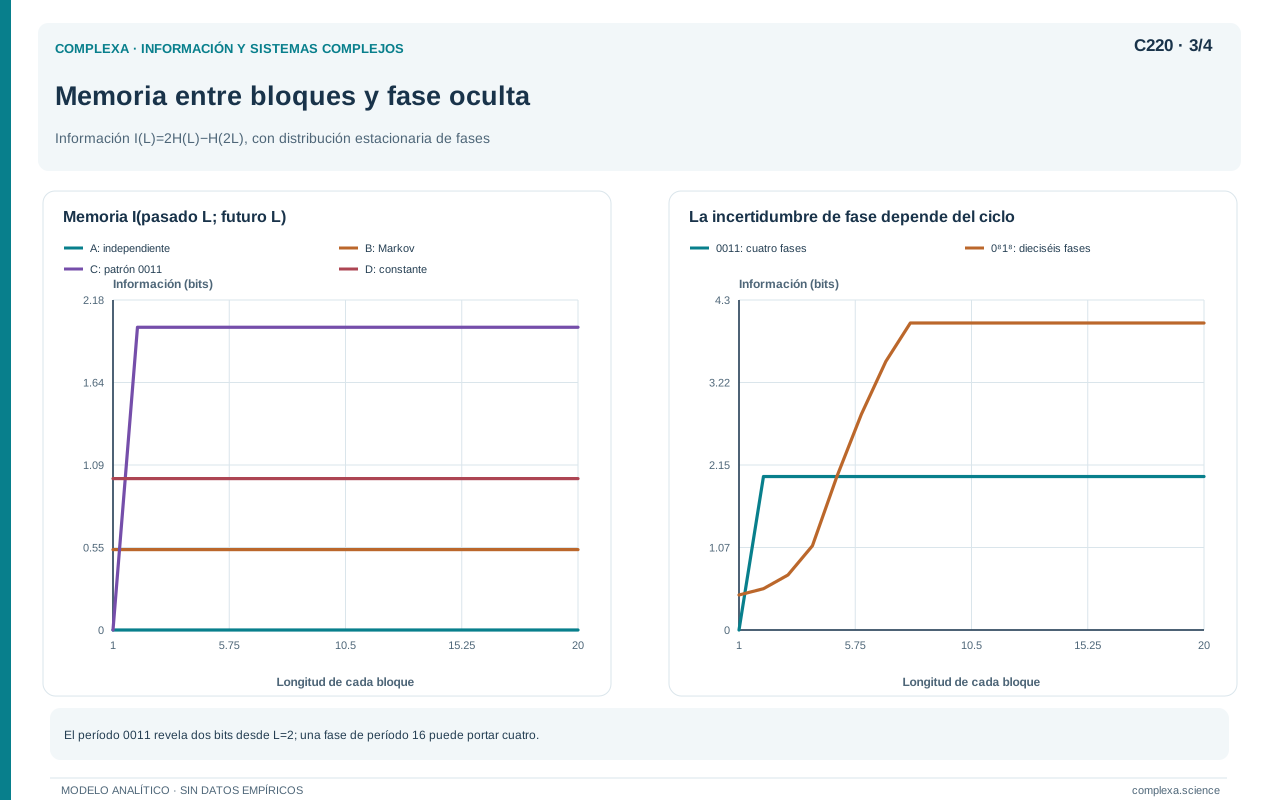
La entropía excesiva cuantifica la información compartida entre pasado y futuro completos, cuando esa cantidad está bien definida. En nuestros cuatro procesos podemos calcularla exactamente.
Para A, pasado y futuro son independientes. La entropía excesiva vale cero, aunque la tasa de entropía sea máxima.
Para B, la conexión entre ambas mitades de la historia pasa por el estado cercano a la frontera temporal. La cantidad compartida vale un bit menos la entropía binaria de una décima,
En C, el pasado identifica la fase del ciclo y el futuro también. Esa fase tiene cuatro posibilidades equiprobables, por lo que comparten dos bits.
En D, las dos mitades identifican el mismo bit constante. Comparten un bit, aunque ninguna transición produzca incertidumbre nueva.
La tabla siguiente reúne la comparación completa.
| Proceso | Tasa de entropía | Entropía excesiva |
|---|---|---|
| A: independiente | 1 | 0 |
| B: persistente | 0,468996 | 0,531004 |
| C: patrón 0011 | 0 | 2 |
| D: constante aleatoria | 0 | 1 |
Si usamos memoria predictiva compartida como criterio, C supera a D, D supera a B y B supera a A. El proceso que encabezaba el orden por tasa ocupa ahora el último lugar.
No hay inconsistencia. La primera medida favorece la renovación de incertidumbre; la segunda registra la información que persiste entre pasado y futuro.
La información entre símbolos vecinos da un tercer perfil. Vale cero para A, aproximadamente 0,531004 para B, cero para C y un bit para D.
El cero de C vuelve a ser instructivo. Sus vecinos son independientes en la distribución estacionaria, pero sus bloques más largos están completamente organizados por una fase común.
La independencia de una pareja de variables no implica independencia de todo el proceso. Tampoco una autocorrelación pequeña en un retardo concreto demuestra ausencia de estructura temporal.
En C, observar dos símbolos consecutivos basta para identificar la fase. Dos bloques adyacentes de longitud dos comparten dos bits, mientras que dos bloques de longitud uno no comparten información.
Esta diferencia sugiere examinar cómo cambia la cantidad con la escala temporal, sin olvidar que a la vez crecen el espacio de estados y las exigencias de muestra.
La memoria de fase tampoco debe confundirse con la dificultad de describir una regla. Consideremos un patrón que repite ocho ceros seguidos de ocho unos, con fase inicial uniforme. Su período mínimo es dieciséis y su entropía excesiva vale cuatro bits.
Esa cantidad supera los dos bits de C, aunque ambas reglas pueden expresarse mediante una instrucción breve de repetición. La entropía excesiva registra que hay más fases que identificar; de ello no se sigue que el mecanismo necesite una descripción proporcionalmente más sofisticada.
Si aumentamos la duración de los tramos constantes, podemos aumentar esa incertidumbre de fase sin introducir decisiones aleatorias nuevas por paso. El ejemplo ayuda a leer la medida como memoria predictiva, sin convertirla en una valoración universal de riqueza estructural.
220.5. Los registros finitos y sus primeras estimaciones
Generamos los registros con Python estándar. Para A usamos una secuencia de bits pseudoaleatorios con semilla 1729; para B, la semilla 1730 y decisiones de cambio con probabilidad de una décima.
El registro C repite el patrón con fase cero. El registro D usa el bit inicial obtenido con semilla 1731, que en este experimento es cero. Las reglas completas permiten repetir el cálculo.
Estimamos entropías de bloque contando todas las ventanas contiguas de una longitud dada, sin cerrar artificialmente el final del registro con su comienzo. Para comparar bloques vecinos usamos una misma tabla conjunta y sus marginales.
Las entropías empíricas de un símbolo son aproximadamente 0,999996 bits para A, 0,999941 para B, uno para C y cero para D.
El valor cero de D no es un fallo del conteo, ya que una realización constante contiene un solo símbolo. Su diferencia con la entropía de conjunto exige una interpretación que desarrollaremos más adelante.
La diferencia empírica entre las entropías de bloques de longitud dos y uno es aproximadamente 0,999985 para A y 0,463329 para B. El segundo valor se acerca a la tasa poblacional de 0,468996 sin coincidir con ella.
Para C esa diferencia sigue prácticamente en uno, como anticipaba el problema de contexto insuficiente; para D vale cero.
No añadimos intervalos de confianza ficticios a estos valores, que proceden de realizaciones sintéticas específicas. Una evaluación de variabilidad requeriría repetir el diseño con varias semillas o aplicar un procedimiento justificado por la dependencia de cada proceso.
Las ventanas se superponen, de modo que su número no equivale al de observaciones independientes.
El sesgo por escasez se vuelve más visible al aumentar la longitud. En A, la entropía empírica de bloques de ocho símbolos es aproximadamente 7,997078 bits, muy cercana a los ocho bits verdaderos.
Para bloques de dieciséis símbolos, el valor empírico es aproximadamente 15,179139 bits, mientras que el verdadero es dieciséis. Hay 65.536 palabras binarias posibles y solo 65.521 ventanas de esa longitud en el registro.
Con un número de ventanas parecido al de categorías posibles no se puede estimar con precisión toda la distribución, porque muchas palabras aparecen pocas veces o no aparecen.
Las semillas fijadas hacen reproducible el experimento computacional. El modelo poblacional de A supone bits independientes ideales; un generador pseudoaleatorio finito solo imita esa fuente infinita como herramienta de simulación.
Conocer el algoritmo, su estado y la semilla permitiría reproducir todos sus valores. Aquí evaluamos el comportamiento estadístico de los registros como muestras simuladas del modelo; la impredecibilidad que les atribuimos es relativa a un observador que desconoce esos parámetros.
220.6. Una dependencia aparente creada por la estimación
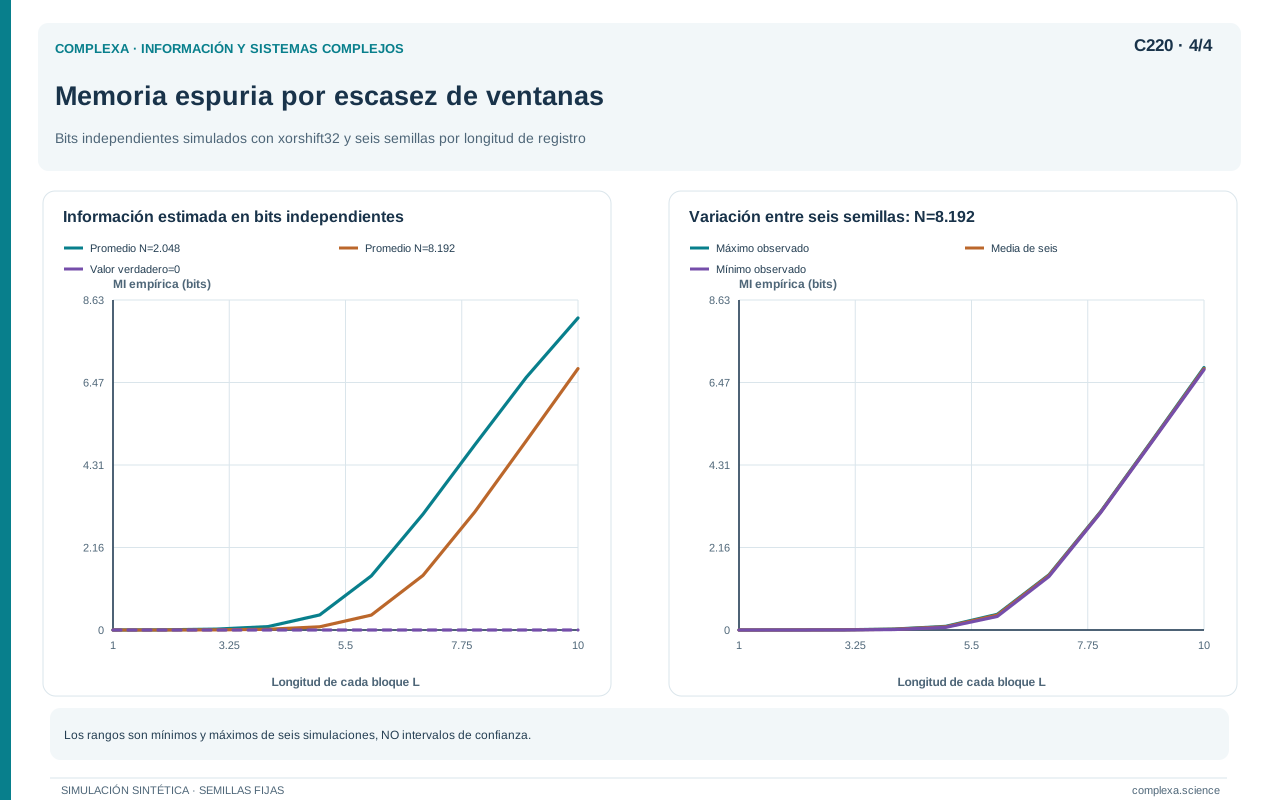
Para cada longitud L calculamos la información mutua empírica entre dos bloques adyacentes de esa longitud. Construimos la tabla de parejas a partir de ventanas de longitud doble y obtenemos de ella ambos marginales.
Esta coherencia evita una diferencia pequeña pero innecesaria entre poblaciones de ventanas. Restar entropías obtenidas con longitudes distintas sin alinear las muestras no produce exactamente la información mutua de una única tabla empírica.
La tabla siguiente recoge los valores del experimento.
| Longitud de cada bloque | A: independiente | B: persistente | C: periódico |
|---|---|---|---|
| 1 | 0,000011 | 0,536612 | 0,000000 |
| 2 | 0,000143 | 0,536639 | 2,000000 |
| 4 | 0,002558 | 0,538826 | 2,000000 |
| 8 | 0,815024 | 0,629514 | 2,000000 |
Los valores poblacionales son cero para A y aproximadamente 0,531004 para B en todas estas longitudes. En C, el valor es cero para longitud uno y dos bits desde longitud dos.
La estimación de A parece razonable con bloques pequeños, pero aumenta bruscamente con bloques de ocho símbolos, hasta superar la estimación correspondiente a B.
Sería incorrecto concluir que la señal independiente desarrolla más memoria que la cadena persistente al cambiar la escala. El generador no cambió. Cambió la dificultad estadística de estimar su distribución conjunta.
La tabla conjunta de bloques de ocho contiene hasta 65.536 categorías, mientras que cada marginal contiene solo 256. El error de estimar la entropía conjunta no se cancela necesariamente con los errores marginales.
En A, las entropías marginales quedan próximas a ocho bits, pero la conjunta se subestima considerablemente. Su resta produce una información positiva que no existe en la población.
B también muestra desviación con bloques largos, aunque su distribución está más concentrada en palabras con pocas transiciones. El patrón de sesgo depende de la distribución y no se corrige restando automáticamente el mismo número a todas las señales.
Para esto sirve un caso de referencia. Si hubiéramos analizado los registros sin conocer sus reglas, una curva creciente podría haberse interpretado como memoria de largo alcance.
La corrección científica consiste en revisar representación, tamaño de muestra y estimador. Elegir un nombre más elaborado para la cantidad no elimina la escasez de datos que la produjo.
Podemos anticipar otra señal de saturación. Si cada palabra conjunta observada apareciera una sola vez, su entropía empírica sería el logaritmo del número de ventanas, aunque el alfabeto poblacional fuera mucho mayor.
Ese techo muestral no equivale a una restricción dinámica. Para distinguirlos podemos comparar registros de longitudes diferentes manteniendo fija la representación. Una supuesta característica del sistema que se desplaza continuamente con el techo de muestra necesita una revisión antes de interpretarse como estructura.
220.7. Una trayectoria constante y la distribución de conjunto
El proceso D exige separar dos tipos de experimento. Antes de generar una realización, elegimos un bit justo. En el conjunto de realizaciones, cada instante tiene entropía de un bit y pasado y futuro comparten ese mismo bit.
Después de observar una realización, todos sus símbolos son iguales. Las frecuencias temporales de esa trayectoria asignan probabilidad uno a una categoría y cero a la otra.
Esas frecuencias no convergen hacia la distribución equilibrada al alargar el registro, porque la trayectoria permanece en el componente elegido inicialmente.
El proceso es estacionario, pero no ergódico respecto de esa mezcla. La estacionariedad mantiene la distribución al trasladar el tiempo; no garantiza que una sola trayectoria explore todas las posibilidades del conjunto.
Si queremos estimar la incertidumbre de la elección inicial, necesitamos realizaciones independientes o información sobre el mecanismo de preparación. Repetir muchas veces el mismo símbolo dentro de una trayectoria no añade nuevas elecciones iniciales.
Así se aclara una aparente contradicción. La entropía marginal poblacional de D vale uno, mientras que la empírica temporal vale cero, porque cada una se calcula sobre una distribución distinta.
La fase aleatoria de C se comporta de otro modo. Durante una trayectoria periódica recorremos las cuatro fases y las frecuencias de bloques reflejan la distribución uniforme sobre ese ciclo, salvo pequeños efectos de borde.
Que ambos procesos elijan una condición inicial aleatoria no implica que sus frecuencias temporales se comporten igual. La dinámica posterior determina qué posibilidades recorre cada trayectoria.
Esta diferencia tiene consecuencias para el remuestreo. Extraer símbolos con reemplazo de una trayectoria constante seguirá produciendo la misma constante y no recreará la incertidumbre sobre qué realización podría haberse generado.
En estudios con varios sujetos, sesiones o sistemas, podemos encontrar una distinción semejante entre variabilidad dentro de una unidad y variabilidad entre unidades. No deben mezclarse sin definir la población y la unidad de muestreo.
Sin prescribir un modelo para esas aplicaciones, el caso sintético sugiere preguntarse, como control, si la incertidumbre que queremos medir se renueva dentro del registro o procede de diferencias entre realizaciones que el registro no explora.
También importa si conocemos la preparación. Si sabemos de antemano que D fue fijado en cero, incluso su incertidumbre de conjunto condicionada por esa información es cero. El bit de entropía correspondía al experimento en el que la preparación era desconocida y se distribuía entre dos opciones.
La información disponible para el observador debe especificarse cuando formulamos una tarea predictiva. Un cambio de conocimiento puede reducir incertidumbre sin que cambie la trayectoria física. Esta distinción evita atribuir al sistema una propiedad que pertenece al diseño de observación.
220.8. La representación también puede cambiar el resultado
Hasta ahora observamos todos los símbolos en su orden original. Una transformación de la representación puede conservar algunas cantidades y modificar otras.
Si intercambiamos las etiquetas cero y uno en toda una señal, las probabilidades de bloques solo cambian de nombre. Las entropías, tasas e informaciones consideradas permanecen iguales.
Si permutamos los instantes, conservamos el histograma marginal pero alteramos las dependencias temporales. Una medida basada exclusivamente en frecuencias de símbolos no detectará ese cambio.
En C, tomar un símbolo de cada dos produce una secuencia alternante. Su tasa sigue siendo cero, pero solo quedan dos fases distinguibles y la entropía excesiva pasa de dos bits a uno.
Tomar un símbolo de cada cuatro produce una realización constante. En el conjunto de fases iniciales, el símbolo elegido sigue siendo justo, pero una trayectoria muestreada muestra únicamente un valor.
La pérdida de información sobre la fase se debe al muestreo. La regla original es la misma; solo hemos modificado qué partes de la historia quedan disponibles.
En B, tomar un símbolo de cada cinco aumenta la probabilidad de cambio entre observaciones a aproximadamente 0,33616. La tasa por símbolo observado se vuelve aproximadamente 0,921097 bits.
Ese aumento no significa que el proceso produzca más incertidumbre por unidad de tiempo original. Como cada nueva observación abarca cinco pasos, la tasa por paso original asociada al registro reducido es aproximadamente 0,184219 bits.
Las unidades temporales son parte de la comparación. Una señal puede parecer más impredecible por observación después de espaciar el muestreo y, al mismo tiempo, contener menos información total sobre la trayectoria original.
Otra transformación consiste en registrar si B cambia entre dos instantes consecutivos. Esa nueva señal de cambios es independiente entre pasos y tiene probabilidad de una décima para el uno.
Su tasa es la misma entropía binaria de una décima, pero su entropía excesiva es cero. La representación de estados mostraba memoria porque el estado actual acumulaba las decisiones de cambio anteriores.
Con la condición inicial y toda la secuencia de cambios podemos reconstruir los estados. La diferencia entre cantidades temporales no implica una pérdida arbitraria de información global; refleja cómo repartimos lo que describimos entre condición inicial, observaciones y fronteras temporales.
220.9. Redactar conclusiones que correspondan al cálculo
Una conclusión basada en entropía marginal afirmaría que A, B, C y D tienen igual incertidumbre de conjunto por símbolo. Esa afirmación es correcta dentro del diseño y no establece igualdad de organización temporal.
Una conclusión basada en tasa afirmaría que A renueva más incertidumbre por símbolo que B, mientras que C y D no mantienen producción asintótica de incertidumbre nueva.
Una conclusión basada en entropía excesiva destacaría la fase de C, el bit persistente de D y la dependencia de frontera de B. A no comparte información entre pasado y futuro.
Podemos formular también una pregunta predictiva concreta. Si solo conocemos el símbolo anterior, la mejor precisión de predicción del siguiente es un medio para A, nueve décimos para B, un medio para C y uno para D.
Si conocemos dos símbolos anteriores, la precisión de C pasa a uno. Una comparación que limite la memoria del predictor puede clasificar como difícil una señal que resulta trivial para un predictor con el contexto adecuado.
Estas precisiones no son intercambiables con los bits de información. La pérdida por equivocación y la pérdida logarítmica valoran aspectos diferentes de las probabilidades, así que conviene elegir la medida según la tarea.
La estimación con bloques largos deja una conclusión metodológica. El valor empírico de 0,815024 bits para A es un artefacto del procedimiento en esa muestra, de modo que no es evidencia de memoria del generador.
En cuanto al muestreo, la trayectoria D muestra que las frecuencias temporales no siempre identifican la distribución entre realizaciones. El valor que estimamos depende de cuál de esas poblaciones corresponde al registro.
Por tanto, una frase general como «C es la más compleja» necesita completarse. Podemos afirmar que C tiene la mayor información pasado–futuro entre estos cuatro procesos, bajo la representación y el conjunto de realizaciones definidos.
Esa formulación, menos ambigua, permite comprobar la afirmación, comparar otros procesos y reconocer cuándo un cambio de representación produce una pregunta nueva.
El caso prepara además la distinción entre aleatoriedad y longitud de descripción. Una secuencia periódica puede tener memoria de fase y una regla breve; una secuencia independiente puede tener poca memoria predictiva y ser difícil de comprimir. Las próximas herramientas deberán mantener separadas esas propiedades.
220.10. Reproducir el experimento y ampliar la pregunta
El código siguiente contiene el núcleo del experimento y usa solo la biblioteca estándar de Python. Las ventanas se recorren sin cierre circular y las informaciones de bloques se calculan a partir de una tabla conjunta coherente.
from collections import Counter
import math
import random

N = 65536
r = random.Random(1729)
A = [r.getrandbits(1) for _ in range(N)]
r = random.Random(1730)
B = [r.getrandbits(1)]
for _ in range(N - 1):
    B.append(B[-1] ^ (r.random() < 0.1))
C = [(0, 0, 1, 1)[i % 4] for i in range(N)]
D = [random.Random(1731).getrandbits(1)] * N

def entropy(counts):
    total = sum(counts.values())
    return -sum(v / total * math.log2(v / total)
                for v in counts.values())

def adjacent_information(seq, length):
    pairs = Counter(
        (tuple(seq[i:i + length]),
         tuple(seq[i + length:i + 2 * length]))
        for i in range(len(seq) - 2 * length + 1)
    )
    left, right = Counter(), Counter()
    for (a, b), count in pairs.items():
        left[a] += count
        right[b] += count
    return entropy(left) + entropy(right) - entropy(pairs)

for name, seq in [("A", A), ("B", B), ("C", C), ("D", D)]:
    print(name, [adjacent_information(seq, length)
                 for length in [1, 2, 4, 8]])
Repetir el cálculo permite verificar la tabla. Para estudiar la variabilidad del estimador necesitamos varias realizaciones generadas con el mismo protocolo.
Una ampliación útil consiste en fijar la longitud de bloque y aumentar el registro; otra, en fijar el registro y aumentar la longitud. Son experimentos diferentes, porque el primero mejora la cobertura y el segundo aumenta la dificultad estadística.
Para estudiar el sesgo de manera sistemática conviene generar registros independientes para cada repetición, conservar una lista de semillas y comparar la media de las estimaciones con el valor teórico. La dispersión entre repeticiones describe la variabilidad; el desplazamiento de la media respecto del valor teórico describe el sesgo.
Esas dos cantidades no pueden inferirse de la tabla de una única realización. La tabla muestra un fallo concreto y reproducible del procedimiento elegido, mientras que una evaluación general necesitaría explorar otros tamaños, distribuciones y configuraciones.
También podemos variar la probabilidad de cambio de B. Al aproximarla a un medio, su tasa se acerca a uno y su entropía excesiva a cero. Al reducirla, aumenta la persistencia y disminuye la incertidumbre nueva.
Si la probabilidad de cambio fuera nueve décimos, la tasa y la entropía excesiva serían iguales a las del proceso con cambio de una décima. Sin embargo, la mejor regla predictiva sería invertir el símbolo anterior. Las cantidades informativas coinciden porque la incertidumbre residual es la misma. Así, incluso un conjunto de medidas coincidentes puede dejar sin especificar aspectos del mecanismo y de la tarea predictiva.
El límite de cambio cero merece cuidado porque el proceso deja de recorrer ambos estados dentro de una trayectoria. Su comportamiento de conjunto se aproxima al del proceso constante y la cuestión ergódica pasa a ser central.
El caso no admite un ranking único y se resuelve con varias conclusiones compatibles. Las medidas poblacionales distinguen incertidumbre nueva, memoria y fase; los registros finitos muestran sesgo y límites de cobertura; las transformaciones revelan la dependencia de la escala y de la representación.
La pregunta científica debe decidir cuál de esas propiedades importa. Solo después tiene sentido escoger una medida, estimarla y usar la palabra complejidad con un significado que pueda contrastarse.
Referencias
- Crutchfield, J. P., y Feldman, D. P. (2003). Regularities unseen, randomness observed: Levels of entropy convergence. Chaos, 13(1), 25–54. DOI: 10.1063/1.1530990.
- Bialek, W., Nemenman, I., y Tishby, N. (2001). Predictability, Complexity, and Learning. Neural Computation, 13(11), 2409–2463. DOI: 10.1162/089976601753195969.
- Paninski, L. (2003). Estimation of Entropy and Mutual Information. Neural Computation, 15(6), 1191–1253. DOI: 10.1162/089976603321780272.