COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 22. Información temporal, multivariada y entre escalas
219.1. La cantidad poblacional y su estimación
Una fórmula informativa puede ser exacta y su estimación ser deficiente. La entropía se define a partir de una distribución de probabilidades; una base de datos contiene un conjunto finito de observaciones. Pasar de esas observaciones a una distribución exige decisiones y produce incertidumbre.
Si observamos únicamente dos lanzamientos de una moneda justa y ambos muestran la misma cara, la distribución empírica asigna probabilidad uno a esa cara. Su entropía es cero, aunque la entropía de la moneda sea un bit.
El cálculo es aritméticamente correcto; el problema está en interpretar una propiedad de la muestra como si fuera exactamente la propiedad de la población que la generó.
Esta distinción afecta a la entropía, la información mutua, la transferencia, las dimensiones generalizadas y las descomposiciones multivariadas. Las cantidades más elaboradas heredan los problemas de estimar sus distribuciones, además de los propios de sus definiciones.
La primera decisión es identificar qué queremos estimar. No es lo mismo la entropía de una variable categórica conocida que la entropía diferencial de una variable continua, ni la información de observaciones simultáneas que la información condicional entre historias temporales.
También debemos precisar cómo se obtuvieron los datos. Los supuestos de observaciones independientes e idénticamente distribuidas no se cumplen automáticamente en una serie temporal, una muestra agrupada por personas o un experimento con cambios de condiciones.
Paninski estudió sistemáticamente límites y sesgos de estimadores informativos. Su trabajo muestra por qué una corrección nominal o un intervalo estrecho no garantizan una estimación adecuada en regímenes de escasez de datos.
Aquí comenzaremos con ejemplos exactos que permiten ver el sesgo sin simulaciones. Después compararemos familias de estimadores y construiremos un protocolo de validación que mantenga separadas la pregunta científica, la representación y la incertidumbre.
Más que un procedimiento universal, buscamos reconocer qué información permiten obtener los datos y qué parte del resultado depende de supuestos que deben declararse.
219.2. El estimador por frecuencias y su sesgo
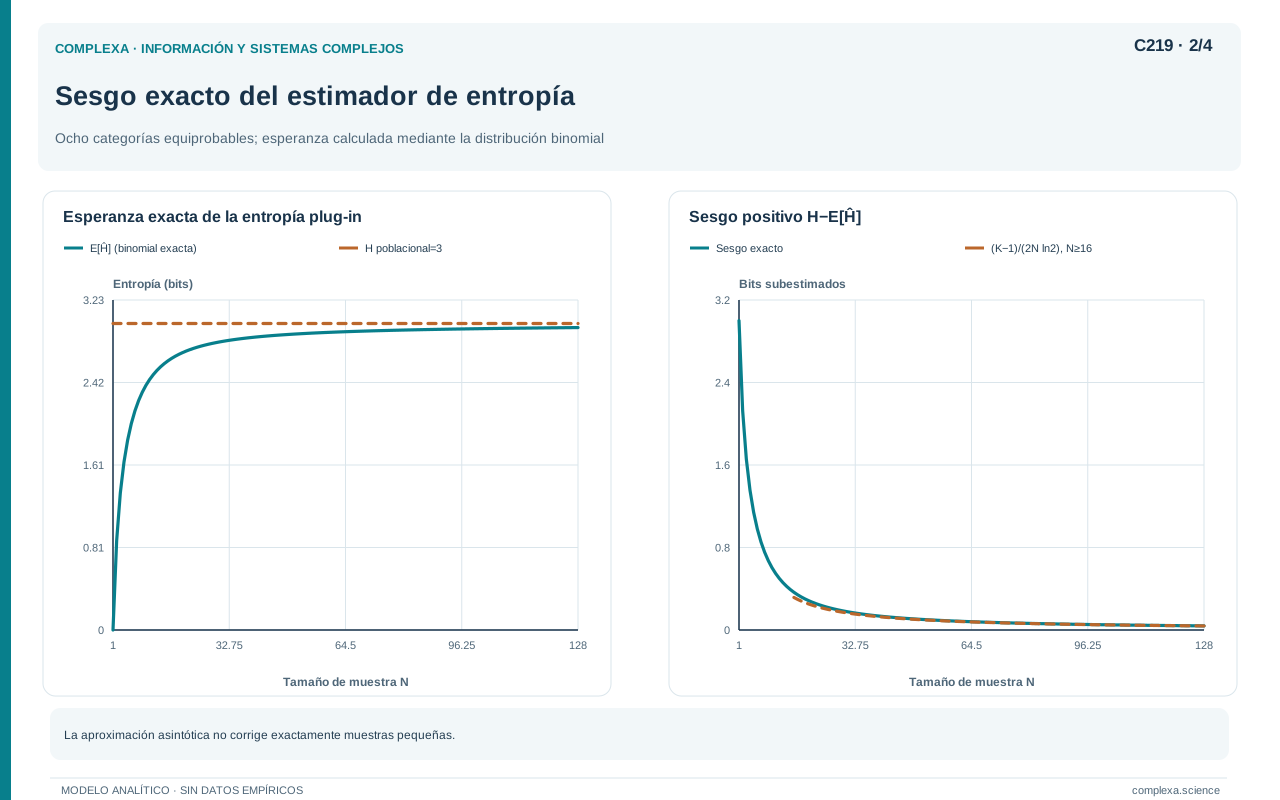
Para una variable con categorías discretas, podemos contar cuántas veces aparece cada una y dividir por el tamaño de muestra; esa frecuencia relativa estima su probabilidad.
El estimador directo de entropía, también llamado de sustitución, introduce esas frecuencias en la fórmula de Shannon
En un alfabeto fijo y bajo muestreo independiente, la concavidad de la entropía implica que este estimador tiene sesgo no positivo, es decir, que en promedio sobre muestras tiende a subestimar la entropía poblacional.
El ejemplo de dos lanzamientos permite calcularlo exactamente. Con probabilidad un medio ambos resultados coinciden y la entropía empírica es cero; con la misma probabilidad difieren y la entropía empírica vale un bit.
La esperanza del estimador es medio bit. Como la moneda tiene entropía de un bit, el sesgo es menos medio bit. Repetir el mismo cálculo sobre esa muestra particular no lo elimina.
Para una moneda justa podemos promediar sobre todos los posibles conteos mediante la distribución binomial. Los valores de la tabla siguiente son exactos salvo redondeo.
| Número de lanzamientos | Entropía empírica esperada | Déficit respecto de un bit |
|---|---|---|
| 2 | 0,500000 | 0,500000 |
| 4 | 0,780639 | 0,219361 |
| 10 | 0,923499 | 0,076501 |
| 100 | 0,992750 | 0,007250 |
La mejora con el tamaño de muestra es clara, pero su velocidad depende de la distribución y del número de categorías. No podemos extrapolar esta tabla binaria a un problema con miles de estados.
En el régimen asintótico de un alfabeto fijo con probabilidades positivas y observaciones independientes, el término principal del sesgo del estimador es
Esta expresión motiva la corrección de Miller–Madow, que exige un régimen donde la aproximación sea razonable. Cuando muchas categorías relevantes no se observan, añadir ese término no resuelve el problema general.
Para la moneda con cien observaciones, la aproximación predice un déficit de aproximadamente 0,007213 bits, cercano al valor exacto. Con dos observaciones predice aproximadamente 0,360674, lejos del déficit real de medio bit.
La corrección es una aproximación que solo vale en ese régimen asintótico; su desempeño depende también de cómo se estima o conoce el tamaño del soporte.
El sesgo y la variabilidad son propiedades diferentes. Un estimador puede fluctuar poco entre muestras y estar sistemáticamente desplazado; otro puede tener poco sesgo medio y presentar grandes fluctuaciones. Para evaluar la precisión necesitamos considerar ambas contribuciones.
El error cuadrático medio es la suma del cuadrado del sesgo y la varianza. Reducir uno de esos componentes puede aumentar el otro. Esa es una razón para no elegir un estimador solo porque se anuncia como corregido por sesgo.
También debemos distinguir el error de estimación del cambio de población. Si la moneda modifica su probabilidad durante el registro, aumentar la muestra no garantiza aproximarnos a una única distribución constante, porque podemos estar promediando regímenes diferentes.
219.3. Lo que una muestra no puede mostrar
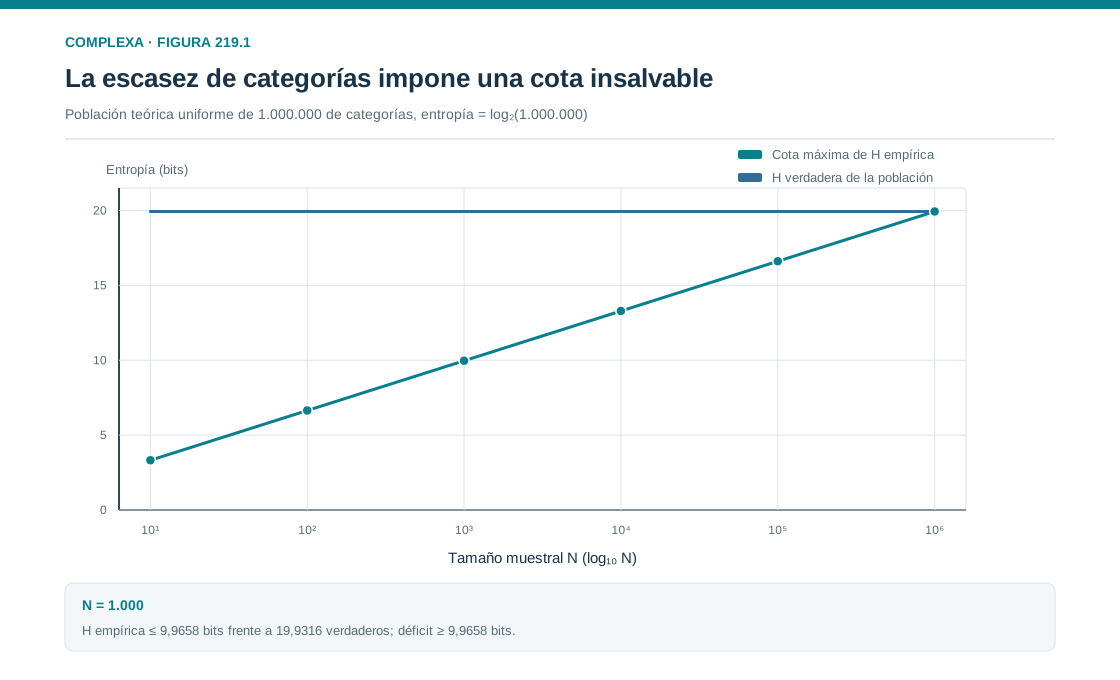
Una muestra de N observaciones contiene como máximo N categorías diferentes, de modo que su entropía empírica no puede superar el logaritmo de N, sea cual sea el número de categorías de la población.
Consideremos una distribución uniforme sobre un millón de categorías. Su entropía es aproximadamente 19,931569 bits. Con mil observaciones, la entropía empírica no puede superar aproximadamente 9,965784 bits.
Hay así un déficit de al menos 9,965784 bits para cualquier muestra de ese tamaño, incluso si todos los resultados observados son distintos.
Si usáramos únicamente el número de categorías observadas en una corrección asintótica, el término añadido sería como máximo aproximadamente 0,720626 bits. Esa cantidad no compensa la diferencia de casi diez bits.
Aunque la corrección esté bien programada, la hemos aplicado fuera del régimen en que podría resolver la escasez de cobertura.
Las categorías no observadas pueden contener una masa total considerable. Con una sola muestra, decidir si existe una cola de muchísimas categorías raras o si el soporte está casi completamente cubierto requiere supuestos.
Los modelos de suavizado asignan probabilidad a categorías no observadas o estabilizan conteos pequeños. Esto puede ser útil, pero introduce información adicional mediante una familia de distribuciones, una prior o una regla de regularización.
En un modelo bayesiano, la incertidumbre posterior depende de esas elecciones. Debemos distinguir la entropía de la distribución predictiva posterior de la esperanza posterior de la entropía de la distribución desconocida.
La concavidad implica que la entropía de una mezcla puede ser mayor que la mezcla de entropías. Parte de la incertidumbre predictiva puede corresponder a incertidumbre sobre los parámetros, además de la variabilidad de una distribución particular.
El remuestreo ordinario de una muestra tampoco genera categorías nunca observadas. Puede describir cierta variabilidad alrededor de la distribución empírica, pero no recoge automáticamente toda la masa ausente.
Volvamos a los dos lanzamientos que produjeron la misma cara. Cualquier remuestra de tamaño dos extraída con reemplazo de esos registros repite esa cara y tiene, por tanto, entropía empírica cero.
Un intervalo construido únicamente con esos valores puede colapsar en cero, aunque la moneda generadora sea justa y tenga entropía de un bit. El procedimiento parece extremadamente preciso porque solo contempla las posibilidades presentes en una muestra sin diversidad.
El remuestreo puede ser útil, pero este caso muestra que hay que verificar su régimen de validez y su capacidad para representar la incertidumbre relevante. Cuando el soporte está insuficientemente observado, la variabilidad de las remuestras puede omitir el problema principal.
Por eso un intervalo estrecho obtenido mediante remuestreo no garantiza que el sesgo sea pequeño.
La respuesta práctica depende de la pregunta. Podemos reducir la resolución, incorporar supuestos defendibles, aumentar los datos o reconocer que la cantidad no está identificada con precisión suficiente. Presentar más decimales no es una de esas opciones.
219.4. Información mutua positiva bajo independencia
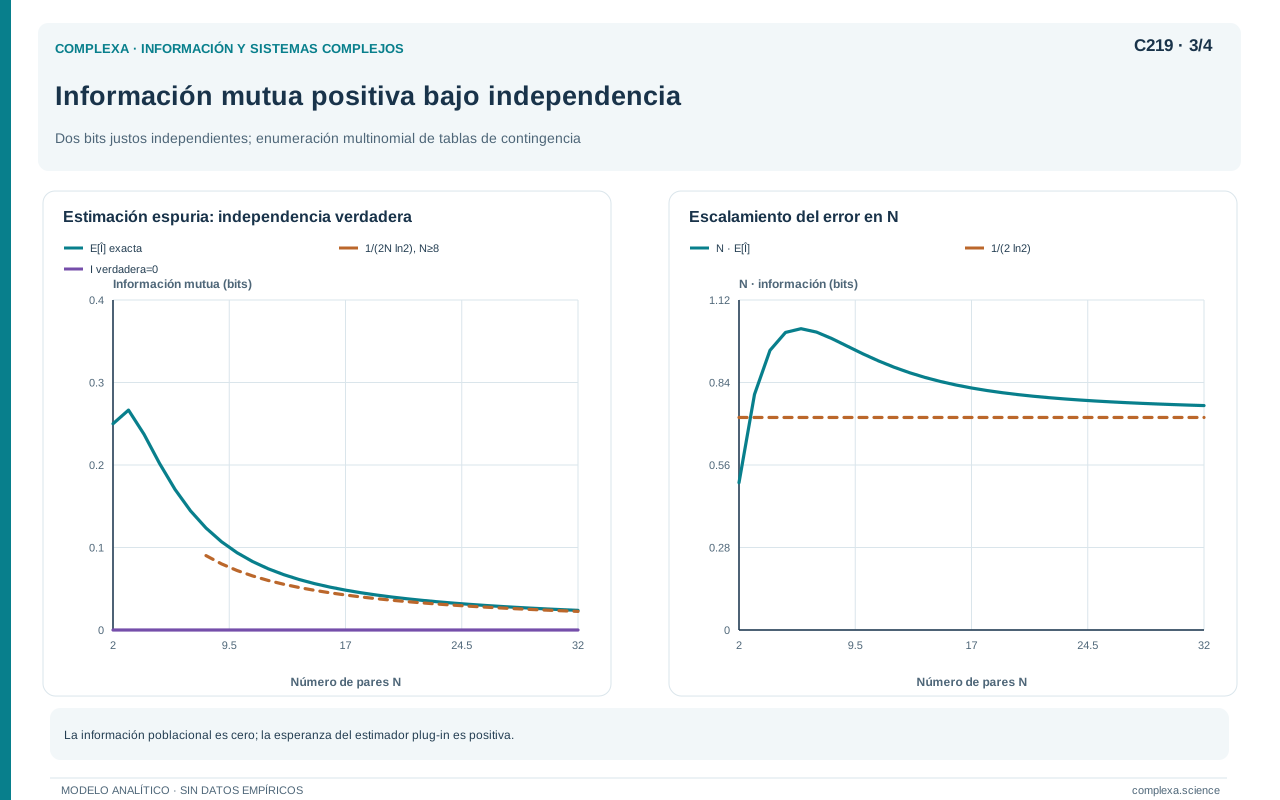
La información mutua poblacional es cero cuando dos variables son independientes. Sin embargo, una tabla empírica finita casi nunca reproduce exactamente el producto de sus marginales.
El estimador directo de información mutua es la información mutua de esa tabla. Es no negativo, pero puede ser positivo por fluctuaciones de muestreo aunque la población sea independiente.
Podemos demostrarlo con un caso mínimo. Observemos dos pares de bits, donde cada componente es justo y todas las elecciones son independientes. Hay dieciséis muestras ordenadas equiprobables.
En cuatro de ellas cambian tanto el primer componente como el segundo entre la primera y la segunda observación. La muestra contiene entonces una relación perfecta de igualdad o de complemento entre las dos variables; la información mutua empírica vale un bit.
En las otras doce muestras al menos una variable es constante, de modo que la información mutua empírica es cero. La esperanza del estimador vale un cuarto de bit, aunque la información poblacional sea cero.
Este ejemplo muestra que una estimación positiva es insuficiente como evidencia de dependencia. Hay que compararla con la distribución que produciría el procedimiento bajo una hipótesis pertinente.
Para dos variables discretas independientes, con tamaños de soporte fijos y tablas suficientemente pobladas, el término principal del sesgo asintótico es
La fórmula muestra que el sesgo crece con el número de categorías. Para dos variables binarias y cien observaciones, el término es aproximadamente 0,007213 bits. Es una aproximación para muestras grandes; en una tabla concreta el sesgo exacto puede diferir.
Un contraste por permutación puede evaluar la independencia cuando las observaciones son intercambiables bajo la hipótesis nula. Permutar una variable destruye su emparejamiento con la otra y conserva sus valores marginales.
El contraste responde, sin embargo, a una pregunta de significación y deja sin estimar el tamaño de la información poblacional. Un efecto pequeño puede resultar significativo con muchos datos, mientras que un efecto relevante puede ser incierto con pocos.
Restar la media de las permutaciones al valor observado produce una medida ajustada respecto de ese nulo. Esa medida no es necesariamente un estimador insesgado de la información real, porque la distribución nula puede tener un sesgo diferente del que aparece bajo dependencia.
Si examinamos muchas parejas, retardos o discretizaciones y seleccionamos el máximo, también debemos tener en cuenta la búsqueda. El resultado elegido combina la señal con la oportunidad de seleccionar una fluctuación favorable.
El contraste por permutación también puede ser poco informativo con muestras diminutas. Si en dos observaciones cada variable contiene un cero y un uno, las dos formas de emparejarlas producen igualdad perfecta o complemento perfecto, ambas con información mutua empírica de un bit.
El valor observado parece grande, pero todas las permutaciones compatibles con esos marginales producen el mismo valor, por lo que no es evidencia contra el nulo de emparejamiento aleatorio. El contraste explica por qué una relación perfecta en dos puntos puede ser estadísticamente poco convincente.
Con tablas mayores, podemos inspeccionar además los conteos. Una tabla binaria de cien observaciones con frecuencias treinta, veinte, veinte y treinta tiene marginales equilibrados e información empírica de aproximadamente 0,029049 bits. Esa cifra debe evaluarse con su incertidumbre y su diseño de muestreo, además de compararse con cero.
219.5. Variables continuas y discretización
Una variable continua requiere especial cuidado. La entropía diferencial depende de las unidades y puede ser negativa. La información mutua, en cambio, es invariante bajo transformaciones invertibles apropiadas de cada variable, cuando está bien definida.
Una estrategia es discretizar las observaciones mediante intervalos y estimar la información entre las categorías resultantes. Esa cantidad corresponde a una pregunta con una resolución determinada.
La información entre las variables discretizadas no puede superar la información de las variables originales bajo la misma distribución. Sin embargo, su estimador empírico puede estar sesgado hacia arriba, de modo que el orden poblacional no garantiza el mismo orden entre las estimaciones.
Si usamos intervalos muy grandes, perdemos distinciones. Si usamos demasiados, la tabla conjunta queda poco poblada. La elección es un compromiso entre resolución y error de estimación.
Los intervalos de igual anchura y los de igual frecuencia responden de manera diferente a distribuciones concentradas o con colas. Ninguno de los dos esquemas basta para eliminar el problema de dimensión ni garantiza estabilidad.
La selección de intervalos debe separarse de la evaluación cuando se optimiza usando el resultado que queremos detectar. Si elegimos límites para maximizar una dependencia y después tratamos ese máximo como si la partición hubiera sido fijada de antemano, ignoramos una fuente de adaptación.
Podemos usar datos de entrenamiento para seleccionar la representación y datos independientes para evaluar el procedimiento completo. En estudios pequeños, esta separación reduce aún más los datos disponibles, pero evita una precisión aparente basada en reutilizarlos.
Un modelo paramétrico es otra vía. Para variables conjuntamente gaussianas, la información mutua entre dos componentes escalares, expresada mediante su correlación, es
Con correlación de ocho décimos, el valor poblacional es aproximadamente 0,736966 bits. La fórmula es exacta bajo el modelo gaussiano; introducir una correlación estimada añade incertidumbre y sesgo.
Fuera de ese modelo, la expresión no es una equivalencia universal entre correlación e información, porque hay dependencias no lineales con correlación cero e información positiva. La corrección publicada del artículo de Kraskov y colaboradores advierte, además, sobre una afirmación general incorrecta de cota basada solamente en covarianza.
Las relaciones deterministas continuas requieren otro cuidado. Si una variable continua se copia exactamente con precisión ilimitada, su información mutua consigo misma puede ser infinita. Una estimación finita obtenida de datos redondeados no contradice ese resultado, porque trabaja con una resolución o un procedimiento finitos.
El ruido de medición puede convertir esa relación singular en una distribución con información finita. Por ello conviene especificar si el modelo supone una copia exacta, una observación ruidosa o una discretización instrumental. Son preguntas distintas aunque sus gráficos se parezcan.
La validez del modelo es parte del análisis. Una fórmula compacta puede ser muy eficiente cuando sus supuestos describen los datos y producir resultados engañosos cuando no lo hacen.
219.6. Estimadores mediante vecinos próximos
Los estimadores de Kraskov, Stögbauer y Grassberger usan distancias entre observaciones para estimar información mutua en variables continuas. Adaptan la escala local a la densidad de datos y coordinan conteos en los espacios conjuntos y marginales.
La idea se entiende sin desarrollar toda la derivación. En una región densa necesitamos un radio pequeño para encontrar un número determinado de vecinos; en una región dispersa, uno mayor.
La comparación de ocupación conjunta y marginal informa sobre cuánto difiere la distribución conjunta del producto de las distribuciones marginales. El procedimiento evita fijar una malla global uniforme.
El número de vecinos, habitualmente denominado k, regula la escala local. Un valor pequeño puede captar variaciones finas y aumentar la variabilidad. Un valor grande suaviza más y puede ocultar estructura local.
No hay un valor universal adecuado para cualquier distribución, dimensión y tamaño de muestra. Conviene examinar la estabilidad en un conjunto razonable de valores y validar con casos sintéticos que se parezcan al problema.
El algoritmo también depende de la métrica, la normalización y el tratamiento de empates. Variables registradas con pocos valores distintos no cumplen automáticamente los supuestos de una densidad continua sin empates.
Añadir un ruido diminuto para romper empates cambia los datos y puede afectar distancias pequeñas. Si se usa, debe justificarse y comprobarse su influencia. Ese ruido no convierte una variable categórica en una observación continua equivalente.
La invariancia de la información mutua poblacional bajo transformaciones invertibles no significa que un estimador finito produzca exactamente el mismo valor después de cualquier transformación. La geometría de los vecinos y el error de aproximación pueden cambiar.
La dimensionalidad sigue siendo un problema. En espacios de muchas coordenadas, los vecinos disponibles pueden estar lejos y las aproximaciones locales perder precisión. Evitar histogramas no elimina la necesidad de cobertura.
Estos estimadores pueden producir valores ligeramente negativos en muestras finitas, aunque la información mutua poblacional sea no negativa. Truncarlos automáticamente a cero modifica su distribución de error y debe declararse.
El buen comportamiento observado por los autores en ejemplos independientes tampoco debe presentarse como una demostración universal de ausencia de sesgo, porque el trabajo original formula esa exactitud como una conjetura apoyada en sus pruebas numéricas. Una estimación concreta sigue requiriendo evaluación del error bajo la distribución y el régimen de muestra utilizados.
La publicación original incluye una corrección de una afirmación del apéndice sobre cotas mediante covarianza; los autores indican que no afecta a los otros resultados del artículo. Esa corrección no invalida los estimadores en general, pero debe mencionarse siempre que se invoque aquella cota.
Una implementación fiable exige identificar la variante exacta y sus convenciones. Dos programas pueden usar el nombre KSG y diferir en conteos de frontera, exclusión del propio punto o unidades del logaritmo.
219.7. Tiempo, condicionamiento y crecimiento del espacio
En series temporales, cada observación puede contener información repetida respecto de las anteriores. El número de registros no equivale necesariamente al número de realizaciones independientes.
Para ilustrarlo, en un proceso autorregresivo estacionario simple con correlación temporal geométrica, la varianza de la media puede aproximarse mediante un tamaño efectivo de muestra. Con coeficiente de nueve décimos y registros largos, ese tamaño es aproximadamente una diecinueveava parte del número de observaciones.
Así, mil novecientas observaciones pueden aportar, para estimar la media, una precisión comparable a la de unas cien observaciones independientes del mismo proceso marginal. Esta equivalencia vale para esa estadística y ese modelo.
Ese tamaño efectivo no debe reemplazar a N en toda fórmula de entropía o información mutua, porque distintas estadísticas dependen de estructuras de correlación diferentes.
El condicionamiento añade otra dificultad. Para estimar la transferencia entre dos señales binarias usando diez valores pasados de cada una y un símbolo futuro, la tabla conjunta tiene hasta dos elevado a veintiuno combinaciones.
Son más de dos millones de celdas, que una muestra de diez mil transiciones no puede poblar en general. Algunas restricciones del proceso pueden reducir el soporte, pero deben demostrarse o modelarse.
Añadir historia puede reducir un sesgo conceptual por memoria omitida y aumentar a la vez el error estadístico. La elección de retardos debe considerar ambos problemas; más condicionamiento no siempre mejora la estimación.
La selección de variables puede usar conocimiento del sistema, modelos parsimoniosos o procedimientos validados. Sin embargo, seleccionar y evaluar sobre los mismos datos puede favorecer conexiones espurias.
Un caso extremo ayuda a entenderlo. Si cada contexto pasado aparece una sola vez en el registro, la distribución empírica del símbolo futuro condicionada por cada contexto tiene un único resultado y su entropía condicional empírica es cero.
Eso puede ocurrir incluso cuando los símbolos futuros son independientes y justos en la población. Hemos creado contextos tan específicos que cada observación parece perfectamente predecible a posteriori. El registro no permite comprobar qué pasaría al repetir el mismo contexto.
La reducción empírica de incertidumbre proviene entonces de memorizar observaciones. La validación con datos nuevos o con realizaciones independientes del proceso puede distinguir esa memorización de una regla estable.
Las permutaciones también requieren adaptación. Permutar instantes arbitrariamente destruye autocorrelaciones y puede producir un nulo inadecuado. Desplazamientos, permutaciones por bloques o datos sustitutos responden a hipótesis diferentes.
Ningún método de sustitución es adecuado para todas las preguntas. Para cada uno debemos especificar qué conserva, qué destruye y por qué esas propiedades corresponden a la hipótesis que queremos contrastar.
Los cambios de régimen pueden invalidar una única distribución estacionaria para todo el registro. Mezclar períodos distintos puede crear dependencias o esconderlas. La segmentación debe justificarse y su incertidumbre formar parte de la interpretación.
219.8. Predicción, validación y pérdidas logarítmicas
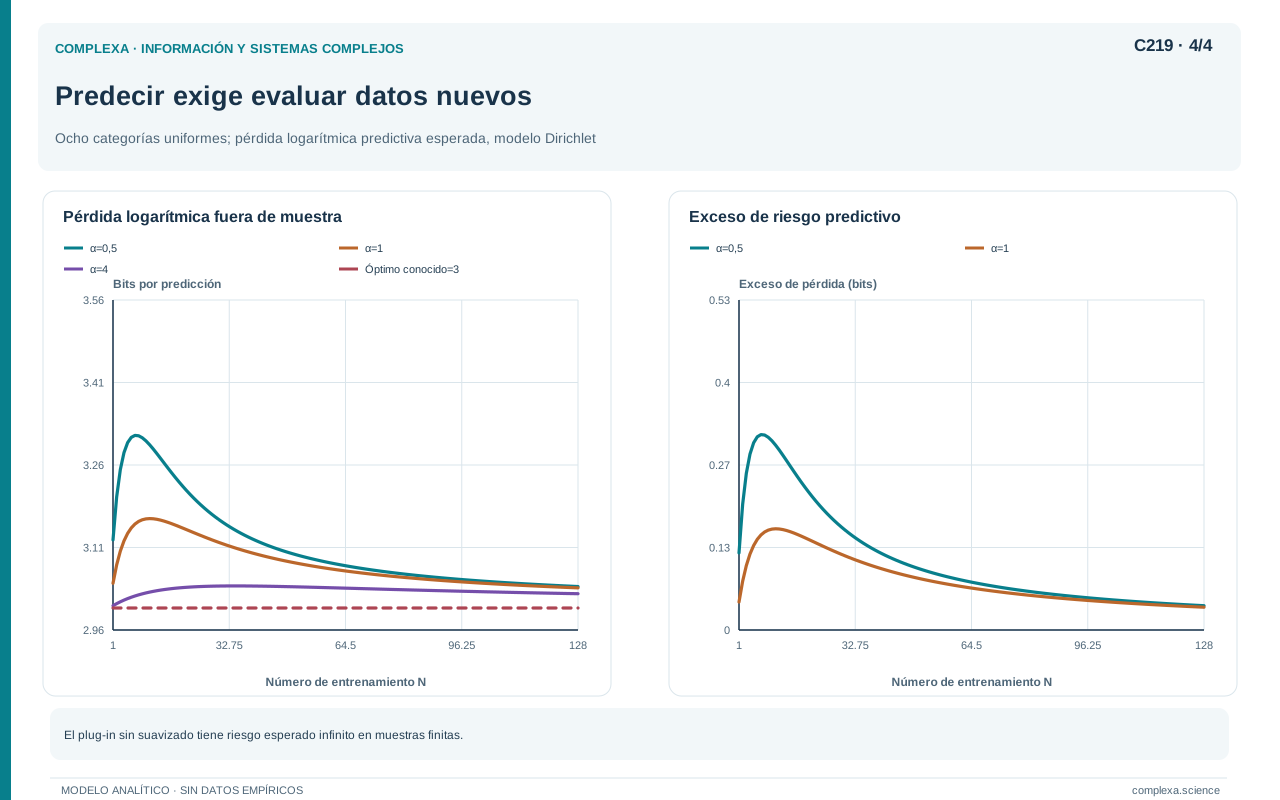
Otra vía es relacionar la información con el desempeño predictivo. Si conocemos la distribución marginal del objetivo y evaluamos un predictor probabilístico, su pérdida logarítmica media puede compararse con la entropía del objetivo.
La mejor pérdida logarítmica condicional posible coincide con la entropía condicional. Un predictor imperfecto tiene una pérdida adicional igual a la divergencia esperada entre las probabilidades verdaderas y las predichas.
Por ello, cuando la entropía marginal es conocida exactamente y la pérdida se evalúa en la población, la diferencia entre esa entropía y la pérdida de un predictor no supera la información mutua
Esta relación permite interpretar una mejora predictiva como información que usa el modelo, siempre que se cumplan esas condiciones. Si también estimamos la entropía marginal y la pérdida con pocos datos, la diferencia empírica ya no es una cota garantizada.
La evaluación debe hacerse con datos que no se usaron para ajustar el predictor. Un modelo suficientemente flexible puede memorizar etiquetas y producir una pérdida de entrenamiento casi nula aunque no exista una relación generalizable.
La validación cruzada requiere respetar la estructura de muestreo. Si varias observaciones pertenecen a la misma persona, separar registros sin separar personas puede compartir información entre entrenamiento y evaluación.
En series temporales, entrenar con observaciones futuras para predecir el pasado puede responder a una tarea diferente de la predicción prospectiva. Los filtros y normalizaciones también pueden introducir información del conjunto de evaluación si se calculan antes de dividir los datos.
Una mejora de clasificación no equivale necesariamente a una mejora de información estimada. La precisión usa decisiones discretas; la pérdida logarítmica evalúa probabilidades. Dos modelos pueden acertar lo mismo y asignar niveles de confianza muy diferentes.
Los resultados deben mantener visible esa distinción. Una estimación informativa, un contraste de independencia y una comparación de predicción son procedimientos relacionados, pero cada uno responde a una pregunta propia.
219.9. Un análisis de sensibilidad que pueda interpretarse
La validación comienza con distribuciones de referencia cuyo valor informativo es conocido. La independencia, la copia binaria con ruido y la familia gaussiana permiten examinar comportamientos distintos.
Comprobar un único tamaño de muestra es insuficiente. Conviene estudiar si el error disminuye al aumentar los datos y si los intervalos reflejan las fluctuaciones observadas en simulaciones repetidas.
También debemos variar la desigualdad de las probabilidades, la dimensión, el ruido, la dependencia temporal y el número de estados. Un estimador que funciona con variables equilibradas puede fallar con categorías muy raras.
El análisis de sensibilidad de parámetros debe mostrar resultados comparables. Si cambiamos simultáneamente discretización, selección de retardos y estimador, no podremos atribuir la diferencia a una decisión concreta.
Una tabla puede registrar valor estimado, incertidumbre, representación y configuración. Eso es preferible a quedarse con la combinación que produce el resultado más grande o más significativo.
Los intervalos deben corresponder al procedimiento completo cuando este incluye selección de modelos. Evaluar únicamente la variabilidad de la última fórmula puede omitir la incertidumbre de todas las decisiones anteriores.
La precisión numérica también debe ajustarse a la evidencia. Si el resultado cambia varias centésimas de bit al modificar razonablemente un parámetro, mostrar seis decimales no comunica una precisión real.
Las estimaciones negativas, los ceros frecuentes y los valores cercanos a cotas máximas merecen revisión. Pueden ser resultados legítimos de un procedimiento o señales de escasez, saturación o errores de implementación.
La revisión debe incluir las probabilidades además del escalar final. Una suma que difiere de uno, una categoría duplicada por diferencias de codificación o un valor ausente tratado como categoría informativa pueden alterar el resultado sin generar errores del programa.
Si los datos faltantes dependen del objetivo, excluirlos cambia la distribución analizada; no equivale a perder observaciones al azar. Conviene describir la población que queda después de cada exclusión y comprobar si la conclusión vale para ella o pretende extrapolarse a la población inicial.
Una auditoría reproducible conserva todo lo necesario para repetir el análisis, es decir, la definición de variables, las unidades, las reglas de exclusión, los parámetros, las particiones de datos y las versiones del procedimiento. La reproducibilidad del cálculo es necesaria, aunque no garantiza la validez de la interpretación.
Finalmente, las unidades deben revisarse en la propia implementación. Un procedimiento que usa logaritmos naturales devuelve nats, que se expresan en bits dividiendo por el logaritmo natural de dos. Esa conversión debe aplicarse tanto al valor central como a sus errores e intervalos.
219.10. Qué comunicar cuando los datos son limitados
Un resultado informativo debe presentarse junto con la cantidad que intenta estimar y el procedimiento usado. La expresión «la entropía es» puede ser demasiado fuerte cuando solo disponemos de una estimación sensible al método.
Podemos comunicar una estimación bajo una discretización concreta, un contraste de independencia bajo una hipótesis nula o una mejora predictiva fuera de muestra. Cada formulación identifica qué evidencia se ha obtenido.
Cuando distintos métodos razonables discrepan, conviene localizar la causa. Puede ser un cambio de objetivo por discretización, una violación de supuestos, una diferencia de sesgo o una falta de datos. El desacuerdo es información sobre los límites del análisis.
Reconocer esos límites no le quita utilidad al trabajo, porque puede orientar un diseño de muestreo, una reducción de dimensión o una pregunta más identificable. A veces el resultado más sólido es una comparación relativa estable, aunque la cantidad absoluta siga siendo incierta.
Los ejemplos exactos de este capítulo muestran que una muestra puede producir entropía demasiado baja e información mutua positiva sin dependencia real. Estos efectos nacen de la estadística del muestreo y deben evaluarse antes de interpretarlos como estructura del sistema.
La estimación de información exige coordinar teoría, representación y datos. Una fórmula correcta es el comienzo; la evidencia surge cuando el procedimiento conserva su significado bajo los supuestos, las escalas y los tamaños de muestra del problema.
Referencias
- Paninski, L. (2003). Estimation of Entropy and Mutual Information. Neural Computation, 15(6), 1191–1253. DOI: 10.1162/089976603321780272.
- Kraskov, A., Stögbauer, H., y Grassberger, P. (2004). Estimating mutual information. Physical Review E, 69, 066138. DOI: 10.1103/PhysRevE.69.066138.
- Kraskov, A., Stögbauer, H., y Grassberger, P. (2011). Erratum: Estimating mutual information. Physical Review E, 83, 019903. DOI: 10.1103/PhysRevE.83.019903.