COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 17. Renormalización, universalidad y descripción multiescala
162.1. Microestados y particiones
Una descripción macroscópica es autónoma si permite predecir su evolución sin reconstruir las variables microscópicas descartadas. La prueba es comprobar si microestados hoy indistinguibles producirán la misma evolución observable. Intervienen la dinámica, la información retenida por la agregación y las preparaciones iniciales admisibles.
Sea el espacio de microestados y el de macroestados. Una aplicación sobreyectiva asigna a cada microestado una descripción reducida; cada macroestado tiene así al menos un representante microscópico. La relación suele ser muchos-a-uno, es decir, varios valores de , con componentes internos distintos, dan el mismo . El conjunto de microestados compatibles con un macroestado es la fibra de sobre ,
Las fibras forman una partición, pues son no vacías, disjuntas dos a dos y cubren el espacio microscópico. Equivalentemente, cada bloque es una clase de estados indistinguibles bajo la relación si .
Un observable agregado es una magnitud calculable a partir del macroestado. Si , su expresión microscópica es constante en cada fibra. Para dos abundancias no negativas, por ejemplo, puede elegirse . El total es observable y la composición, en general, no lo es; registrar diez individuos no distingue diez de la primera especie, diez de la segunda ni una combinación intermedia.
Si cada especie crece a una tasa propia, y implican que la derivada del total es . Con tasas distintas, composiciones de igual total pueden tener derivadas distintas, de modo que el tamaño presente no determina su cambio instantáneo. Las observaciones pasadas podrían ayudar a inferir la composición oculta, pero introducirían memoria en la descripción reducida.
La pregunta central es cuándo la evolución respeta las fibras de una agregación. En sistemas deterministas se exigirá igualdad de las derivadas macroscópicas; en cadenas de Markov, igualdad de las probabilidades de transición entre bloques. Si estas igualdades fallan, habrá que identificar cuándo pueden aproximarse, su horizonte de validez y los errores relevantes para cada tarea.
162.2. Autonomía determinista
Considérese un sistema y una aplicación diferenciable . Buscamos un campo macroscópico tal que toda trayectoria proyectada satisfaga . La autonomía se exige para cualquier condición inicial del dominio considerado, durante el intervalo en que exista la solución. Supondremos la regularidad necesaria para aplicar la regla de la cadena y, cuando se requiera una predicción única, para garantizar la unicidad de las soluciones macroscópicas.
La regla de la cadena da la derivada del observable siguiendo la trayectoria microscópica. Para que esta expresión dependa solo de su imagen, debe factorizarse a través de . La condición de cierre es, por tanto, que en todos los microestados admisibles se cumpla la identidad
La necesidad se obtiene evaluando la ecuación en el instante inicial de una trayectoria que parte de cualquier . Si existe una ley autónoma común, su derivada inicial debe coincidir con la expresión anterior; en particular, dos puntos de una fibra han de generar la misma derivada macro. Para la suficiencia, se define usando cualquier representante de la fibra. La igualdad entre representantes hace que la definición sea inequívoca; al sustituirla en la regla de la cadena, toda trayectoria proyectada satisface la ecuación cerrada.
El intercambio entre dos especies es un caso sencillo de cierre exacto. Si y , los términos de transferencia se cancelan al sumar y para resulta , cualquiera que sea la composición. Las abundancias individuales pueden cambiar intensamente mientras el observable agregado permanece inmóvil; la autonomía de este observable no implica que represente toda la actividad del sistema.
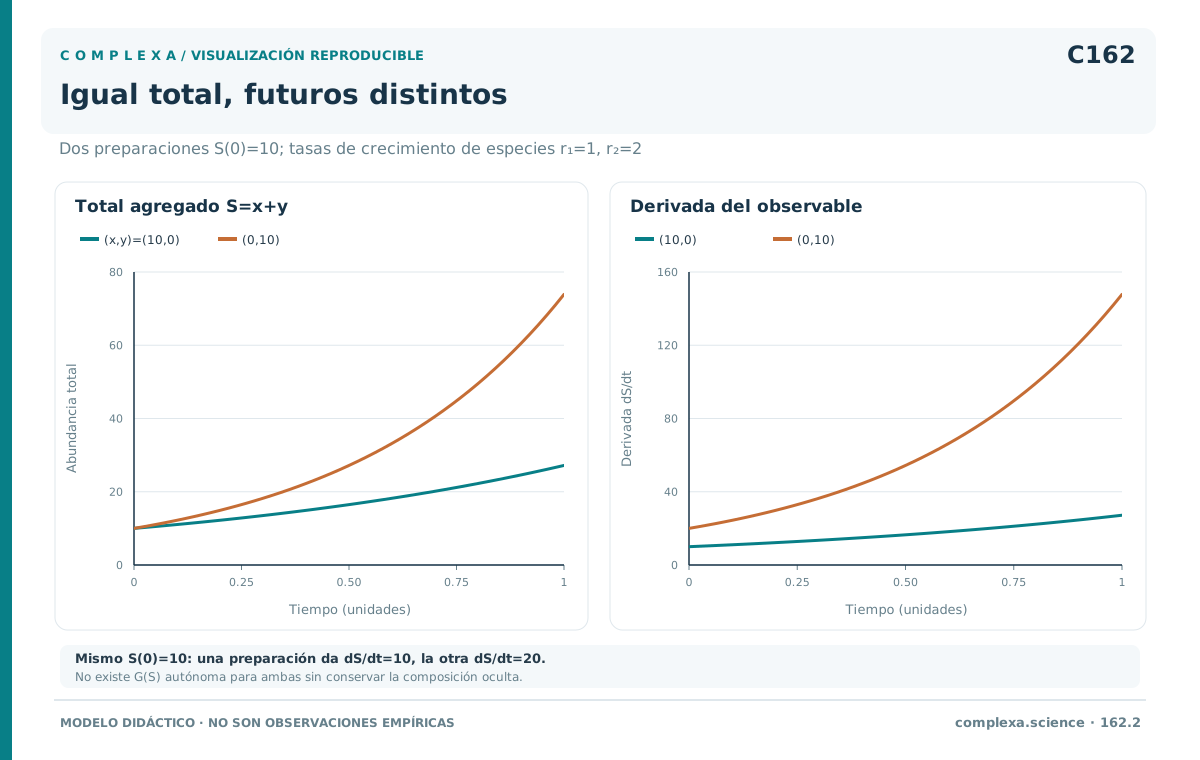
Con crecimiento desigual, en cambio, . Con y , las condiciones iniciales y tienen ambas total diez, pero sus derivadas iniciales son diez y veinte. Sus totales futuros son, respectivamente, y . La discrepancia surge antes de cualquier ajuste estadístico, porque una misma entrada macroscópica requeriría dos salidas distintas del supuesto campo .
Si las tasas fueran iguales, la expresión se reduciría a y el total cerraría exactamente. También podría restringirse el conjunto de estados a una familia invariante con composición determinada, pero esa autonomía tendría un dominio más limitado. Hay que declarar si se pretende una ley válida en todo el espacio o solo sobre ciertas preparaciones. Una relación ajustada en una trayectoria particular no demuestra que la derivada sea constante en las demás fibras explorables.
Otra respuesta al fracaso del cierre es ampliar el observable. Para las dos poblaciones de tasas diferentes, conservemos el total y la fracción , definida cuando . La regla del cociente da
La composición que faltaba vuelve a estar representada y el sistema queda cerrado. Con dos variables, igual que en la descripción original, el paso es un cambio de coordenadas que separa tamaño y composición. Presentarlo como reducción dimensional sería incorrecto, aunque la nueva representación ayude a interpretar el crecimiento.
En una comunidad con muchas especies podría bastar un número pequeño de composiciones si grupos de especies comparten tasas o si ciertos contrastes internos se relajan rápidamente, posibilidad que debe demostrarse o validarse. Agregar una variable porque mejora un ajuste no garantiza que se haya recuperado toda la información predictiva pertinente. Conviene volver a preparar microestados con el mismo macroestado ampliado y comprobar si sus futuros siguen diferenciándose.
162.3. Cierre lineal
Para un sistema lineal y una observación , el cierre puede comprobarse con una identidad matricial. Sean y . Una matriz macroscópica da una ley válida para todos los estados si y solo si . Con esa igualdad, las dos maneras de calcular la derivada observada coinciden para cualquier representante microscópico,
Las diferencias entre dos estados con igual observación pertenecen al núcleo de . Si , la igualdad matricial implica . Por ello también pertenece al núcleo; las diferencias inicialmente invisibles siguen siendo invisibles al evolucionar. Recíprocamente, si el núcleo es invariante bajo , la asignación está bien definida, porque cambiar de representante añade un vector del núcleo cuya imagen observada sigue siendo nula.
Esta asignación define un operador lineal sobre . Si es sobreyectiva, la imagen es todo el espacio macro y queda determinada de manera única. Si no lo es, el operador puede extenderse de distintas maneras a un complemento de la imagen. Las extensiones dan matrices diferentes que coinciden sobre todos los macroestados realizables; esa falta de unicidad no afecta a las trayectorias realmente observadas.
Como ejemplo, agreguemos las dos primeras coordenadas de un sistema tridimensional, conservemos la tercera y verifiquemos el cierre por multiplicación directa con las matrices
La primera fila de es la suma de las dos primeras filas de , por lo que vale cero. La segunda es , igual a la segunda fila de . Así, permanece constante y . El núcleo está generado por , que transforma en ; la invariancia queda comprobada también geométricamente.
La utilidad predictiva depende de qué variables se retengan. Si observáramos solo , obtendríamos un cierre exacto con , pero perderíamos la relajación de la tercera coordenada. El cierre de dos componentes sí predice su aproximación al valor . Una constante exacta puede bastar para una pregunta de conservación y resultar trivial para otra sobre tiempos de respuesta. La exactitud algebraica debe evaluarse junto con la información que exige el problema.
162.4. Cadenas de Markov y agregabilidad fuerte
Sea una cadena de Markov homogénea en tiempo discreto sobre un conjunto finito. Usaremos una matriz estocástica por filas, en la que es la probabilidad de pasar del estado al estado . La propiedad de Markov establece que, conocido el estado presente, la historia anterior no modifica la distribución del siguiente estado. Para historias de probabilidad positiva, se escribe
Una partición divide los estados en bloques y define , el bloque ocupado. Aunque el proceso microscópico sea markoviano, el agregado puede conservar memoria. Saber que el sistema está en un bloque no identifica el estado interno, cuya distribución puede cambiar con las observaciones anteriores. Si los estados internos tienen probabilidades de salida distintas, la predicción dependerá de esa información histórica.
La agregabilidad fuerte exige igualdad de las masas de transición hacia cada bloque destino; con ella puede definirse una matriz agregada sin elegir una composición interna particular. Para cualesquiera estados de un mismo bloque y para todo bloque , debe cumplirse
Para demostrarlo, fijemos una historia macroscópica que termina en . La probabilidad de que el siguiente bloque sea es el promedio de las probabilidades microscópicas de salida sobre los posibles estados internos, con pesos . La propiedad de Markov microscópica permite reemplazar cada probabilidad futura condicionada por la suma de la fila correspondiente hacia .
Por la igualdad de masas, todos los términos promediados valen . Al factorizar ese valor queda multiplicado por , así que el resultado no depende de la historia ni de los pesos internos. Se obtiene una cadena macroscópica homogénea con matriz , válida para cualquier distribución inicial. Sus filas suman uno porque los bloques destino forman una partición del espacio microscópico.
La condición también es necesaria si se exige una misma matriz macro para todas las preparaciones iniciales. Basta comparar distribuciones concentradas en dos estados del mismo bloque, cuyas probabilidades a un paso deben coincidir hacia cada destino. Esta formulación caracteriza la agregabilidad fuerte empleada aquí (Buchholz, 1994). Exige más que reproducir un promedio observado, ya que asegura que ninguna redistribución inicial dentro de un bloque altera la ley de transición macroscópica, siempre que la matriz microscópica permanezca fija.
162.5. Caso resuelto
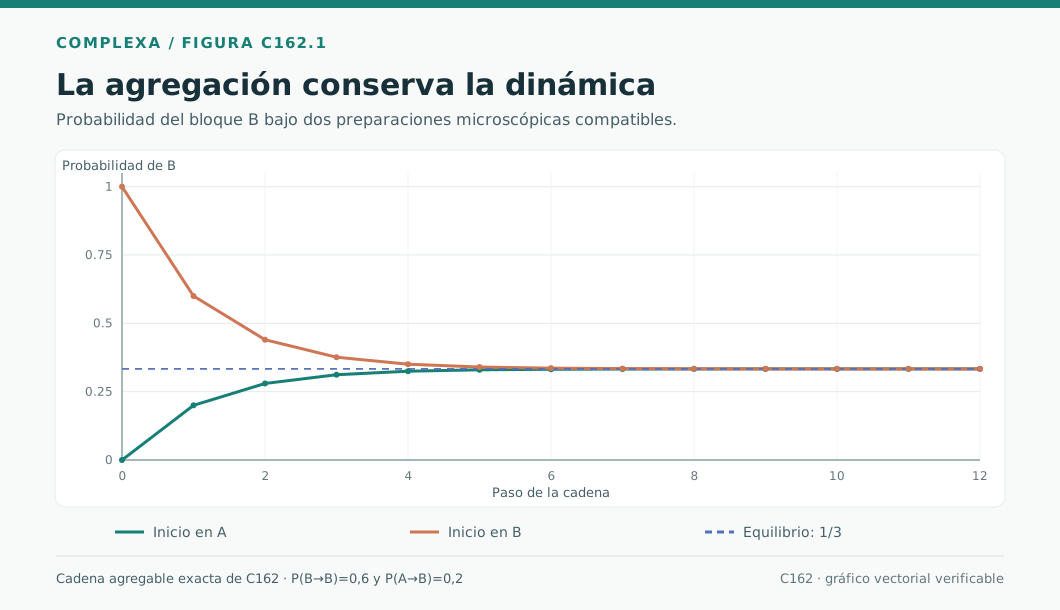
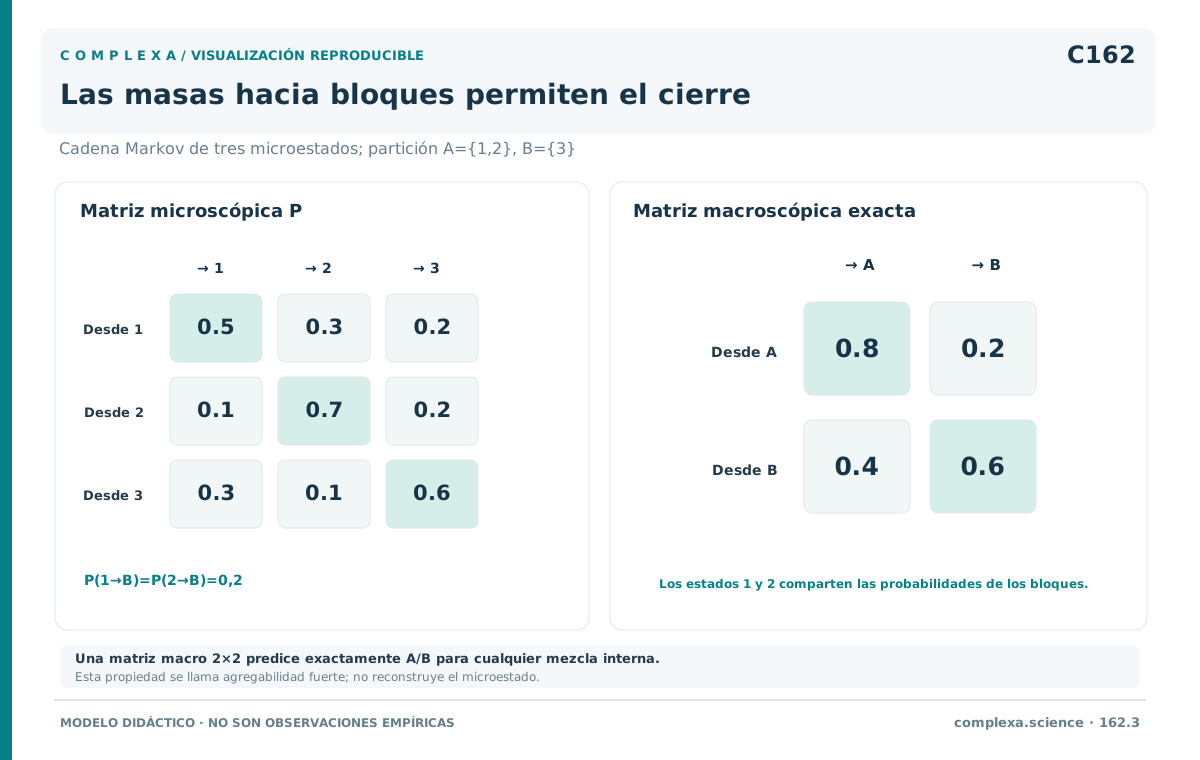
Consideremos los bloques y , con matrices microscópica y agregada
Las filas 1 y 2 envían a masas y ; a envían ambas , de modo que se cumple la agregabilidad fuerte. Desde el único estado de , las masas son hacia y hacia .
Sea . La probabilidad de estar en al paso siguiente, , combina las entradas desde con las permanencias en . El punto fijo satisface , así que y la estacionaria macro es . Restando el punto fijo e iterando se obtiene
La tabla da las predicciones para las preparaciones extremas y , junto con el factor de convergencia.
| 0 | 0 | 1 | 1 |
| 1 | 0,2 | 0,6 | 0,4 |
| 2 | 0,28 | 0,44 | 0,16 |
| 3 | 0,312 | 0,376 | 0,064 |
| 4 | 0,3248 | 0,3504 | 0,0256 |
Los autovalores de la matriz macro son 1 y ; el segundo gobierna la relajación. Para estos dos bloques, la distancia en variación total al equilibrio es y cada paso deja de la desviación anterior. La distribución dentro de puede depender del microestado inicial sin que ello afecte a las probabilidades de los bloques. La agregación predice exactamente la ocupación de , su equilibrio y su convergencia, aunque no reconstruye la distribución microscópica.
La autonomía también puede comprobarse con tiempos de llegada. En la matriz agregable de esta sección, sea el número de transiciones necesarias para alcanzar por primera vez partiendo de cualquier estado de . Para continuar en durante varias transiciones hay que permanecer en ese bloque en cada paso. La agregabilidad fuerte mantiene la probabilidad de permanencia en , cualquiera que sea la composición interna producida por las permanencias anteriores. Así,
La esperanza vale cinco pasos, pero el resultado especifica la distribución completa, incluida su cola; la probabilidad de continuar en después de diez transiciones es aproximadamente . Reemplazar todas las visitas por una duración fija de cinco pasos conservaría el promedio y perdería una parte relevante de la variabilidad. Según el problema, esa pérdida puede pesar más que una pequeña discrepancia en la ocupación estacionaria.
La permanencia en tiene una probabilidad de salida de por paso y una duración media de . La unidad de tiempo debe declararse. Si el paso corresponde a una hora, las duraciones se expresan en horas; si es una actualización de un algoritmo, carece de duración física mientras no se establezca una correspondencia. La estacionaria microscópica del ejemplo es ; sus dos primeras componentes suman , como exige la agregación.
162.6. Qué falla al romper la condición
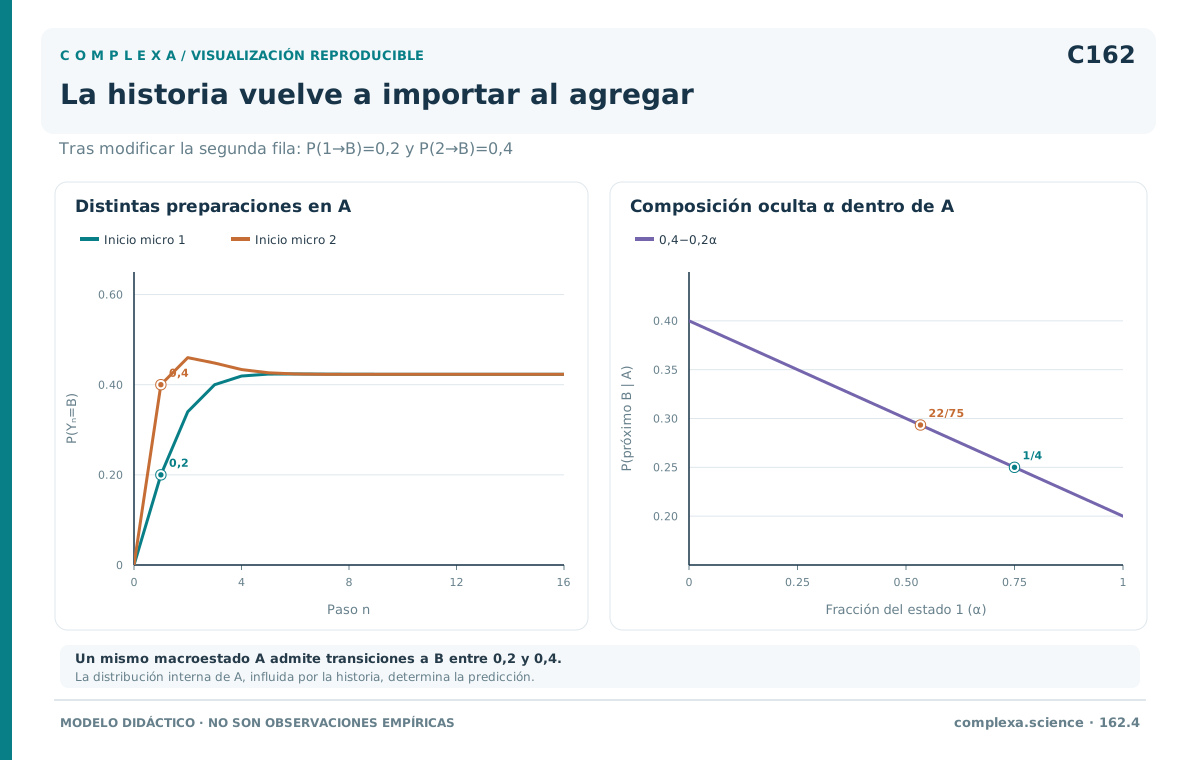
Sustituyamos solo la segunda fila del ejemplo anterior por y mantengamos la partición , . Desde el estado uno, la probabilidad de alcanzar es ; desde el estado dos pasa a ser . La nueva matriz,
sigue siendo estocástica, pero deja de satisfacer la igualdad entre representantes de un mismo bloque.
Preparemos primero toda la masa en el estado uno y después en el estado dos. Ambas preparaciones tienen el mismo macroestado inicial, , pero sus probabilidades de estar en tras un paso son y . Tras dos pasos, multiplicar cada fila inicial por la tercera columna da, respectivamente, y . La discrepancia persiste aunque cambie de magnitud.
En general, si la fracción condicional del estado uno dentro de es , la probabilidad de salir hacia vale . El macroestado presente no determina . Observar que el proceso ha permanecido en modifica, además, esa composición. Partiendo del estado uno, los pesos después de una permanencia son y la siguiente probabilidad de salida es entonces .
La dependencia histórica puede comprobarse dentro de una misma ley inicial estacionaria. La distribución estacionaria microscópica de es . Condicionando solo a estar en , los pesos internos son y la probabilidad siguiente de es . Si además sabemos que el bloque anterior fue , los pesos pasan a , porque las entradas desde el estado tres son y .
Con esa historia adicional, la probabilidad futura de es , distinta de . Ambas condiciones tienen probabilidad positiva bajo la preparación estacionaria. Queda así demostrado que el pasado macro contiene información predictiva aun conocido el presente y que la estacionariedad, aunque estabilice las distribuciones marginales y las frecuencias medias, no garantiza la propiedad de Markov del proceso agregado.
La agregabilidad débil permite que una partición genere un proceso de Markov para ciertas distribuciones iniciales particulares, sin exigirlo para todas. Su existencia requiere una comprobación específica, porque el equilibrio microscópico no la implica. Una matriz macro estimada promediando composiciones puede describir bien las transiciones observadas y fallar al cambiar la preparación. En la matriz modificada, incluso la preparación estacionaria muestra memoria.
162.7. Cierre de momentos
Otra forma de agregación sustituye una distribución de estados por algunos de sus momentos. Consideremos trayectorias que obedecen la ecuación logística , con . La aleatoriedad procede solo de las condiciones iniciales o del muestreo de un conjunto de trayectorias deterministas; no hay ecuación diferencial estocástica ni término de ruido. Supondremos momentos finitos y condiciones que permitan intercambiar derivación y esperanza.
Al promediar la ecuación trayectoria por trayectoria se obtiene una identidad exacta para la media . La no linealidad introduce un momento de segundo orden, que el primero no determina,
La segunda igualdad usa . Dos conjuntos de trayectorias con la misma media pueden tener varianzas distintas y, por ello, derivadas medias diferentes. La fibra de la agregación contiene aquí distribuciones completas que comparten un momento. Con el mismo criterio de autonomía que antes, la derivada del observable debería ser constante sobre todas esas distribuciones compatibles con su valor presente.
El cierre promedio más sencillo reemplaza por y predice . La diferencia entre la derivada exacta y la predicha, evaluadas en una misma media, es . Como es negativa o nula, este cierre sobreestima la derivada instantánea. El signo también se explica por la concavidad de la función logística, ya que promediar la respuesta a estados dispersos reduce el crecimiento respecto de evaluarla en el estado medio.
Con , , media cincuenta y varianza cien, el segundo momento es . La derivada exacta resulta , mientras que el cierre da , una diferencia de menos uno. Una preparación equiprobable en cuarenta y sesenta tiene esos momentos; una preparación concentrada en cincuenta comparte la media, pero tiene varianza cero y derivada veinticinco. Son dos representantes de la misma fibra con futuros medios diferentes.
Añadir la varianza como variable requiere determinar su evolución. En general aparece entonces el tercer momento y, con él, una jerarquía que necesita nuevas hipótesis de cierre. Tampoco puede suponerse constante la varianza inicial, porque cambia a medida que evolucionan las trayectorias. La eliminación de variables puede expresarse mediante términos de memoria, como muestra el marco de predicción óptima de Chorin, Hald y Kupferman (2000). Una aproximación sin memoria exige justificar por qué esa dependencia histórica es despreciable en el régimen y el horizonte usados; el cálculo instantáneo del sesgo no es todavía una cota global del error.
162.8. Autonomía aproximada
Un agregado puede ser aproximadamente autónomo cuando la distribución interna de cada bloque pierde rápidamente la información inicial y las transiciones entre bloques son poco frecuentes. El parámetro pequeño mide esa separación de escalas. Una formulación habitual es , donde es diagonal por bloques y describe el mezclado interno. La perturbación introduce escapes y los ajustes necesarios para que las filas de sigan sumando uno.
Para construir un cierre se necesita que cada bloque de tenga una distribución estacionaria interna única y que la convergencia hacia ella sea suficientemente rápida. Irreducibilidad y aperiodicidad son condiciones naturales en el caso finito; además importa que la brecha de mezclado no desaparezca al reducir . Sin este control, una probabilidad de escape pequeña puede coexistir con una relajación interna igualmente lenta.
Como ejemplo numérico, tomemos una construcción ilustrativa con dos estados en , un estado absorbente y escapes de uno y dos por ciento por paso,
Para , las dos filas internas son y cualquier composición se mezcla en un paso. Promediar los escapes con esa distribución interna da . Una preparación concentrada en el estado uno tiene salida inicial ; otra concentrada en el dos, . El error inicial del cierre es en cada extremo, con signo opuesto. Por tanto, ni siquiera este mezclado especialmente rápido elimina el transitorio de preparación.
Tras un paso, condicionando a no haber escapado, las composiciones son y . Sus probabilidades siguientes de escape son aproximadamente y , ya próximas a . La supervivencia selecciona ligeramente los estados de menor escape, de modo que la distribución condicional casi fija no coincide exactamente con el equilibrio de . Ese sesgo es una de las correcciones que la aproximación principal omite.
Bajo hipótesis de mezclado uniforme, regularidad y un horizonte especificado, pueden obtenerse errores de orden en la evolución reducida sobre la escala lenta, después de tratar la capa inicial. La escala temporal debe declararse, porque errores pequeños por paso pueden acumularse durante muchos pasos. También quedan correcciones por composición interna y memoria del bloque de procedencia. La utilidad del cierre depende de verificar esas hipótesis y de medir el error para las preparaciones relevantes, especialmente cuando entradas repetidas a un bloque perturban de nuevo su distribución interna.
En modelos deterministas también podemos cuantificar qué implica un cierre aproximado. Sean la proyección exacta y el campo reducido propuesto. El defecto de cierre es la diferencia entre la derivada proyectada real y la que predice el modelo,
Supongamos que su norma no supera en toda la región visitada. Si es Lipschitz con constante , comparemos con una trayectoria reducida iniciada en el mismo valor. La diferencia de sus derivadas contiene un término de propagación de la discrepancia y el defecto recién definido. Integrando y aplicando la desigualdad de Grönwall obtenemos
Para , la cota es . Un error local pequeño puede acumularse hasta producir una separación importante. La cota exige controlar el defecto en todas las microconfiguraciones realmente visitadas; unas pocas configuraciones elegidas por conveniencia no bastan. Su valor es metodológico, porque transforma la afirmación «el cierre funciona bastante bien» en una relación entre precisión local, estabilidad y horizonte.
La cota puede ser conservadora. Cuando el campo reducido satisface la condición de contracción , con una tasa uniforme , mejora a . En ese caso la perturbación y la contracción se compensan y la cota permanece finita. Dos modelos con el mismo defecto instantáneo pueden tener horizontes predictivos muy diferentes según la estabilidad de sus ecuaciones.
162.9. Validación
La validación de una descripción macroscópica debe explorar la información que elimina. El protocolo básico prepara varias microconfiguraciones con el mismo macroestado inicial y compara sus distribuciones futuras. En un sistema determinista se contrastan derivadas y trayectorias proyectadas; en uno probabilístico se comparan leyes de transición y distribuciones a diferentes horizontes. Una sola trayectoria observacional puede recorrer una parte demasiado pequeña de las fibras para revelar la dependencia de las variables ocultas.
Para distribuciones discretas y , la variación total cuantifica la mayor diferencia de probabilidad que ambas asignan a un evento. El error cuadrático medio es otra medida, sensible a la representación numérica elegida. En una variable binaria con probabilidad de ocupar , la variación total entre dos predicciones se reduce a la diferencia absoluta entre sus probabilidades de . Ambas medidas se definen como
Retomemos la matriz modificada de 162.6. Preparar los estados uno y dos da probabilidades de iguales a y al primer paso. Sus leyes macro están separadas por una variación total de . Cualquier predictor único basado solo en el macroestado incurre en un error absoluto de al menos para alguna preparación. Elegir iguala ambos errores y minimiza el peor de ellos.
Si las dos preparaciones reciben el mismo peso, esa predicción tiene error cuadrático medio . A dos pasos, las probabilidades verdaderas son y ; la distancia entre sus leyes baja a . Un ajuste puntual podría predecir , con error absoluto en ambos casos. Sin embargo, una colección de ajustes por horizonte no demuestra que exista una matriz homogénea cuya iteración reproduzca todas esas predicciones.
Deben evaluarse por separado el error a un paso, las distribuciones a varios pasos, las leyes de trayectorias, las tasas de relajación y la estacionaria. Dos modelos pueden compartir equilibrio y diferir en los tiempos de llegada; también pueden coincidir en ciertas marginales y discrepar en probabilidades condicionadas a una historia. En cadenas observadas mediante muestras, la incertidumbre estadística debe acompañar las discrepancias estimadas. Aumentar datos reduce esa incertidumbre, pero no corrige una insuficiencia estructural del agregado.
Las intervenciones son una prueba especialmente informativa. Redistribuir masa entre los estados uno y dos mantiene el macroestado presente, cambia su futuro y rompe un cierre aprendido con una composición habitual. Modificar las tasas microscópicas puede invalidar incluso una agregación antes exacta. Por ello, la validación debe declarar qué preparaciones, intervenciones y horizontes están cubiertos. La tolerancia aceptable se fija según el observable objetivo; una buena predicción de ocupación estacionaria deja sin validar las predicciones causales o transitorias.
Una prueba empírica de autonomía debe distinguir entre la dependencia del pasado y el ruido de medición. Si el aparato agrupa valores próximos o registra con retraso, dos observaciones iguales pueden corresponder a estados macroscópicos verdaderos diferentes. La historia ayuda entonces a estimar el estado actual, aun cuando su dinámica física sea markoviana. Conviene formular conjuntamente un modelo de transición, que explica cómo cambia el estado, y otro de observación, que describe cómo se produce el dato registrado. Repetir el análisis con varias precisiones y frecuencias de muestreo permite localizar parte de esa dependencia. Una memoria que desaparece al mejorar la resolución tiene una interpretación distinta de la que persiste con medidas precisas. Esta distinción también orienta la elección de variables adicionales, porque puede bastar con estimar mejor el estado presente o puede ser necesario conservar una composición interna que la agregación había eliminado.
162.10. Elegir la agregación según la tarea
La agregación debe preservar los observables relevantes para el propósito predictivo. Una variable constante puede bastar para estudiar una cantidad conservada, pero ser insuficiente si interesan tiempos de respuesta, composición, flujos o riesgos de transición.
Hay que decidir qué futuros distinguir y con qué precisión (distribuciones instantáneas o trayectorias completas; equilibrio, transitorio o ambos) y qué microconfiguraciones comparten macroestado. Esas decisiones fijan las fibras y los horizontes donde probar el cierre; una tolerancia explícita permite evaluar aproximaciones sin confundirlas con identidades exactas.
La agregación exacta es una propiedad conjunta de la dinámica y la partición; el cierre determinista, la invariancia del núcleo y la igualdad de masas de transición no dependen de la voluntad de simplificar. Si fallan, puede ampliarse el macroestado, restringirse las preparaciones o admitirse memoria. Cada opción delimita el modelo reducido; una descripción sencilla puede ser eficaz en su dominio sin ser universal.
También deben especificarse las intervenciones. Una redistribución interna puede dejar intacto el macroestado y alterar su evolución; un cambio de parámetros puede destruir una igualdad exacta. En aproximaciones multiescala se examinan la rapidez del mezclado, el sesgo de la distribución condicional, la duración de la capa inicial y el escape. La separación de escalas justifica una reducción solo después de comprobar esos efectos y las perturbaciones del sistema.
Agregar estados identifica microestados mediante una aplicación muchos-a-uno. Renormalizar puede combinar la eliminación de grados de libertad con el reescalado de longitudes, tiempos y parámetros. Ambas operaciones pueden coincidir en problemas multiescala, pero sus objetivos y condiciones de validez difieren; hablar de escalas no demuestra autonomía ni evalúa los observables conservados.
Documentar el cierre exige identificar agregación, dinámica microscópica, preparaciones admitidas, horizonte y medida de error. Si se usa una distribución interna de referencia, se explica cómo se obtiene y cuándo deja de representar al sistema. Así se distingue entre resultado exacto, aproximación controlada y ajuste empírico; también se determinan las comprobaciones necesarias tras cambiar la tarea o intervenir sobre el modelo.
Referencias
Buchholz, P. (1994). Exact and ordinary lumpability in finite Markov chains. Journal of Applied Probability, 31(1), 59–75. DOI.
Chorin, A. J., Hald, O. H. y Kupferman, R. (2000). Optimal prediction and the Mori–Zwanzig representation of irreversible processes. Proceedings of the National Academy of Sciences, 97(7), 2968–2973. DOI.