COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
206.1. Representar menos sin perder lo que se definió
Un registro puede contener regularidades que permiten describirlo con menos símbolos que una representación directa. Una categoría frecuente puede recibir una palabra corta; una repetición puede describirse mediante un valor y una longitud; una secuencia puede aprovechar dependencias entre sus partes.
La codificación sin pérdida exige que el receptor pueda reconstruir exactamente el objeto definido como original. Esa exigencia necesita precisión. Recuperar los mismos bytes, recuperar los mismos valores numéricos y conservar una interpretación científica son objetivos distintos.
Por ejemplo, transformar el texto «1.0» en «1» conserva un valor bajo ciertas reglas numéricas, pero no conserva el texto exacto. Eliminar espacios puede preservar una tabla interpretada y modificar un documento. Antes de evaluar compresión debemos fijar qué cuenta como reconstrucción.
La teoría de la información relaciona probabilidades de resultados y longitudes promedio de representación. Los resultados frecuentes pueden usar palabras cortas si los raros reciben palabras suficientemente largas para mantener una decodificación inequívoca.
El ahorro procede de representar de otra manera el mismo conjunto de distinciones según su estructura. Si fusionamos resultados que el receptor ya no puede separar, hemos pasado a una forma de pérdida.
El capítulo desarrollará códigos de longitud fija y variable, restricciones de decodificación, límites entrópicos y ejemplos de compresión. Distinguiremos entre el rendimiento ideal de una fuente y el tamaño final de un archivo con encabezados, tablas y convenciones.
La redundancia puede ser una oportunidad de compresión estadística o una estructura añadida deliberadamente para detectar errores. Reducir una clase de redundancia y añadir otra pueden ser decisiones compatibles cuando responden a etapas diferentes.
206.2. Códigos fijos, códigos variables y ambigüedad
Un código de longitud fija asigna el mismo número de bits a cada símbolo. Para cuatro símbolos bastan dos bits; para cinco, necesitamos tres si queremos representar cada símbolo por separado mediante palabras binarias de igual longitud.
El costo de un alfabeto de tres símbolos equiprobables sería dos bits por símbolo con esa regla, aunque su entropía sea el logaritmo de tres, aproximadamente . La diferencia se explica por la restricción de representar cada símbolo por separado.
Podemos reducirla codificando bloques. Un bloque de símbolos de ese alfabeto tiene posibilidades y puede representarse con el techo de bits. El costo por símbolo se aproxima al logaritmo de tres al crecer el bloque.
Los códigos de longitud variable asignan palabras cortas a resultados frecuentes y largas a los raros. Sin embargo, concatenar palabras requiere que el receptor pueda identificar sus límites.
Un código es unívocamente decodificable cuando dos secuencias distintas de símbolos nunca producen la misma secuencia codificada. Esta condición exige más que asignar palabras diferentes a los símbolos individuales.
Consideremos las palabras 0, 01 y 10. La secuencia de bits 010 puede interpretarse como 0 seguido de 10 o como 01 seguido de 0. El código distingue símbolos aislados, pero falla al concatenarlos.
Un código de prefijo evita esta dificultad imponiendo que ninguna palabra completa sea el comienzo de otra. El receptor puede reconocer una palabra en cuanto llega al final de ella, sin esperar a descubrir si era parte de una palabra más larga.
Las palabras 0, 10, 110 y 111 forman un código de prefijo. Después de leer un cero inicial, la primera palabra queda identificada. Después de un uno, necesitamos continuar hasta distinguir alguna de las restantes.
Todo código de prefijo es unívocamente decodificable, pero no ocurre necesariamente lo contrario. El código con palabras 0 y 01 puede decodificarse sin ambigüedad aunque no sea de prefijo; requiere considerar el contexto siguiente o el final del mensaje.
La distinción entre decodificación inequívoca e instantánea es relevante en sistemas que procesan flujos. Una propiedad garantiza recuperar el mensaje; la otra añade una condición sobre cuándo puede identificarse cada símbolo.
La longitud del mensaje debe formar parte del acuerdo. Si la fuente solo tiene un símbolo posible y el receptor conoce cuántas veces se emitió, no hace falta transmitir bits para identificar los símbolos. Si desconoce esa cantidad, todavía necesita recibir una descripción de la longitud.
Por eso una entropía cero por símbolo no significa que cualquier mensaje de longitud desconocida pueda reconstruirse desde un archivo vacío. En los resultados habituales de códigos por símbolo consideramos un alfabeto no degenerado o tratamos por separado la información de longitud y terminación.
La palabra vacía requiere especial atención, porque asignarla a un símbolo repetible sin otra estructura volvería ambiguo cuántas veces apareció. Las convenciones que permiten usarla en un caso degenerado no pueden trasladarse automáticamente a un flujo arbitrario.
206.3. La desigualdad de Kraft y el espacio de palabras
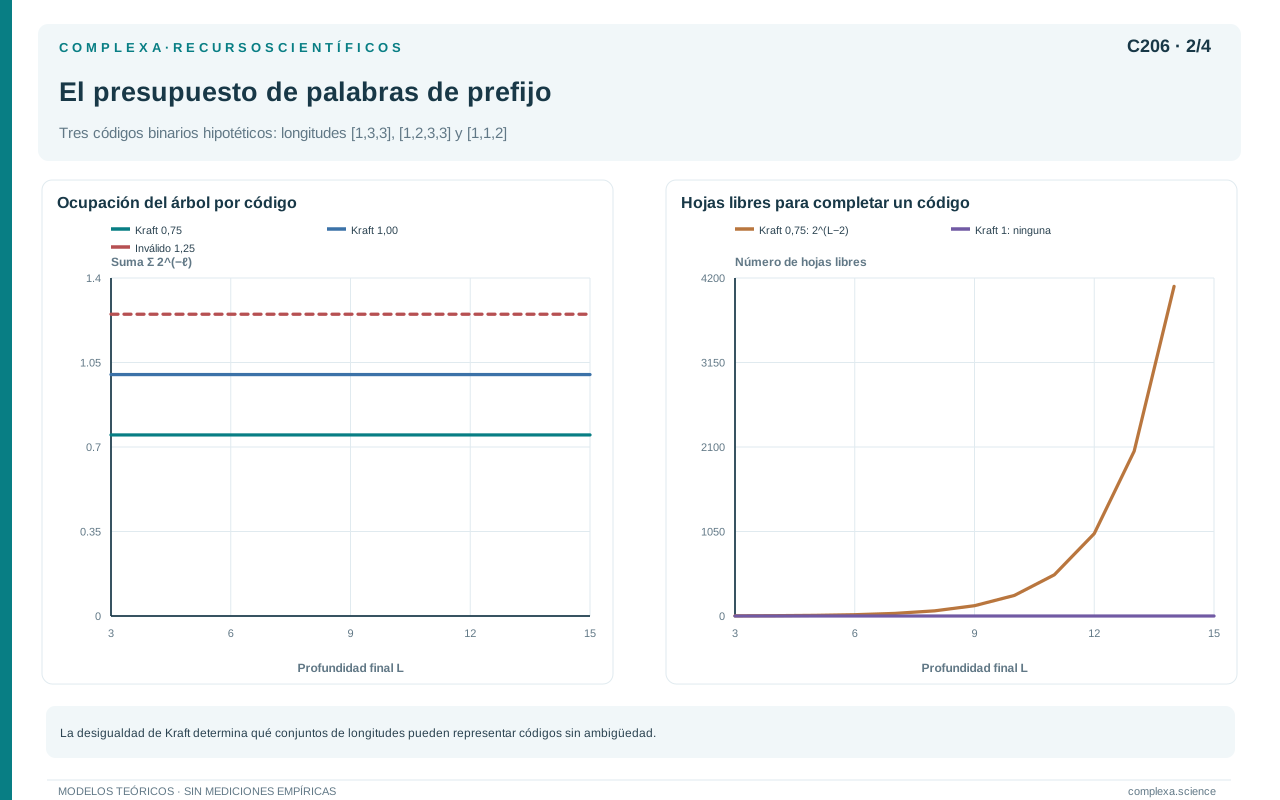
Si las longitudes de un código binario de prefijo son , deben satisfacer
Podemos interpretar la condición mediante un árbol binario. Una palabra de longitud uno ocupa la mitad de las continuaciones posibles; una de longitud dos, un cuarto. Si una palabra ya está asignada, ninguna extensión suya puede asignarse a otro símbolo.
Los conjuntos de continuaciones de las palabras de un código de prefijo son disjuntos, de modo que sus fracciones no pueden sumar más que el espacio total. Esa observación explica la desigualdad sin tratar las longitudes como números independientes de la decodificación.
La condición también es suficiente para construir un código de prefijo con esas longitudes enteras. Podemos asignar espacios en el árbol de manera que ninguna palabra ocupe una región ya reservada por otra.
Las longitudes uno, dos, tres y tres satisfacen la igualdad, porque un medio más un cuarto más dos octavos es uno. En cambio, uno, uno y dos sumarían uno coma veinticinco y no permiten un código de prefijo.
El resultado de McMillan extiende la condición necesaria a códigos unívocamente decodificables, aunque no sean de prefijo. Así, permitir retraso de decodificación no elimina la restricción básica sobre longitudes.
La desigualdad se generaliza a alfabetos de código con otro número de símbolos. Debemos ajustar la base y mantener coherencia entre unidades de información y longitud. Una palabra de cinco símbolos ternarios no equivale a cinco bits.
Que la suma sea menor que uno indica que queda espacio disponible en el árbol. Eso no implica necesariamente que cada palabra pueda acortarse de manera independiente, porque la estructura conjunta debe seguir respetando la condición de prefijo.
También conviene distinguir la longitud de cada palabra del número de palabras posibles. Un alfabeto con muchos símbolos exige repartir espacio entre más regiones. Favorecer demasiado a varios símbolos frecuentes puede dejar sin representación válida a los demás.
La desigualdad convierte la compresión en un problema con restricciones, porque las longitudes deseadas para cada símbolo deben formar una familia que pueda interpretarse como un sistema completo.
206.4. Entropía y longitud promedio
Si un símbolo tiene probabilidad y longitud de código , la longitud promedio es
Para códigos binarios unívocamente decodificables sobre una fuente de símbolos, la entropía es una cota inferior de la longitud promedio, . La restricción de decodificación es esencial; sin ella podríamos asignar palabras cortas ambiguas y fingir un ahorro inexistente.
Una demostración usa la suma de Kraft, que llamaremos . Normalizamos los números para obtener una distribución auxiliar . La identidad entre entropía cruzada y divergencia produce
La divergencia es no negativa y el logaritmo de una cantidad no mayor que uno es no positivo. Ambos términos adicionales impiden que la longitud promedio caiga por debajo de la entropía.
Podemos construir un código cercano a la cota eligiendo longitudes enteras iguales al techo del logaritmo negativo de cada probabilidad positiva. Esas longitudes satisfacen Kraft y producen una longitud promedio menor que la entropía más un bit.
La desigualdad habitual es, por tanto, para la construcción correspondiente y sus condiciones. No afirma que cualquier código esté a menos de un bit de la entropía. Un código mal diseñado puede desperdiciar mucho más.
Si las probabilidades son potencias inversas de dos compatibles con un código completo, las longitudes ideales son enteras y puede alcanzarse la entropía exactamente. El ejemplo de probabilidades un medio, un cuarto y dos octavos cumple esa condición.
En fuentes con otras probabilidades aparece una diferencia por redondeo y estructura del código. Codificar bloques permite repartir esa diferencia entre varios símbolos y acercar la tasa promedio al límite pertinente.
Estas cuentas consideran el modelo de fuente y el costo de las palabras. Un archivo real puede necesitar transmitir el alfabeto, las probabilidades, una descripción del código y su longitud. Esos costos deben añadirse al evaluar un uso concreto.
206.5. Construir un código de Huffman
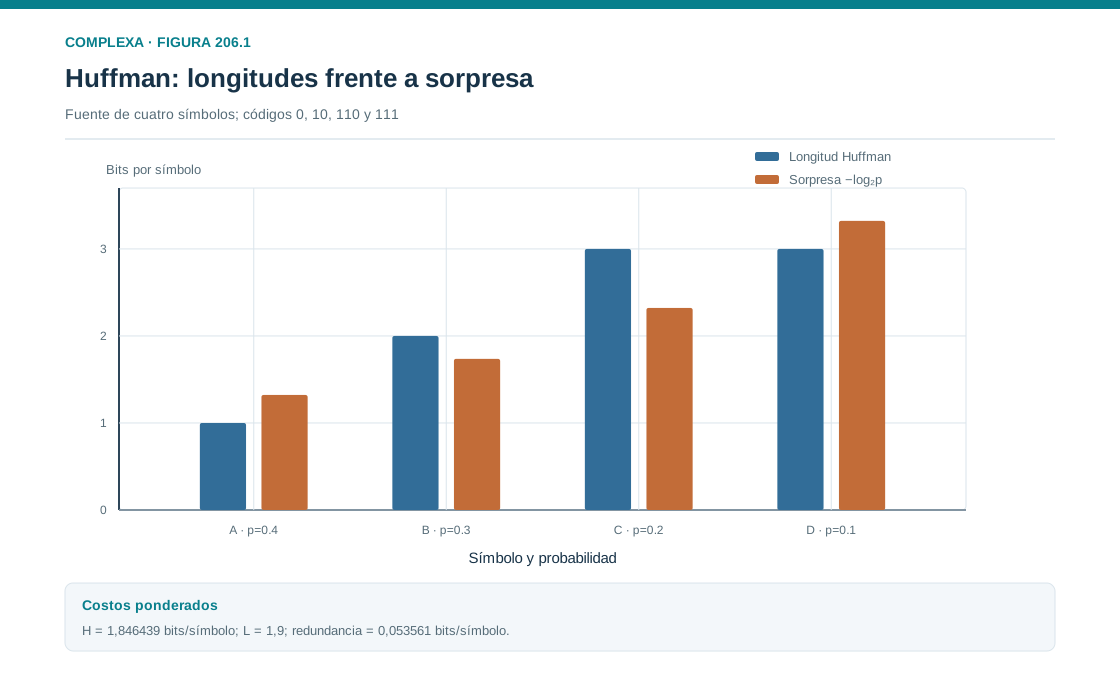
Huffman propuso un procedimiento para obtener un código de prefijo con longitud esperada mínima cuando conocemos probabilidades de símbolos y cada bit tiene el mismo costo. El algoritmo combina repetidamente los dos pesos más pequeños.
Consideremos cuatro símbolos con probabilidades , , y . Primero unimos los dos últimos, que forman un grupo de peso . Después unimos ese grupo con el símbolo que también tiene peso .
Quedan dos ramas de pesos y . Al asignar ceros y unos a las bifurcaciones, podemos obtener las palabras 0, 10, 110 y 111 para los símbolos ordenados de mayor a menor probabilidad.
Las longitudes son uno, dos, tres y tres. Su promedio es bits. La entropía de la fuente es aproximadamente bits, por lo que queda una diferencia de unos bits por símbolo.
La construcción puede justificarse mediante una propiedad de intercambio. En un código óptimo podemos situar los símbolos menos probables en hojas profundas sin aumentar el costo. Dos hojas hermanas pueden agruparse y reducir el problema a uno con menos símbolos.
Al resolver el problema reducido y volver a separar el grupo, recuperamos un código óptimo para el original. La recurrencia justifica la regla de combinar los dos pesos más pequeños.
Los empates pueden producir códigos distintos con el mismo costo esperado. Intercambiar ceros y unos en una rama también cambia las palabras sin cambiar longitudes ni rendimiento. El código óptimo, por tanto, no es necesariamente único.
La optimalidad vale para códigos de prefijo de los símbolos definidos, con las probabilidades y costos indicados. El código de Huffman no es necesariamente el compresor más eficaz para un archivo dado, sobre todo cuando existen dependencias o se permiten bloques diferentes.
Para cuatro símbolos, un código fijo usa dos bits para cada uno, con promedio dos. La distribución desigual permite bajar a uno coma nueve, aunque algunos símbolos pasan a necesitar tres bits.
El receptor debe conocer la correspondencia entre símbolos y palabras. Si esa tabla no estaba acordada, su descripción forma parte del costo de comunicación y puede dominar en mensajes cortos.
La optimalidad del ejemplo puede comprobarse sin enumerar todas las palabras binarias. Un árbol óptimo puede tomarse completo en sus bifurcaciones, porque una rama con un único descendiente permitiría acortar palabras sin perder decodificación.
Con cuatro hojas, las formas de longitudes relevantes son dos, dos, dos y dos, o uno, dos, tres y tres. La primera cuesta dos bits en promedio. En la segunda, asignar las longitudes menores a probabilidades mayores minimiza el costo y produce uno coma nueve.
Esta comprobación no reemplaza la demostración general de Huffman, pero verifica el caso resuelto por otra ruta. También muestra que cambiar etiquetas manteniendo su posición en el árbol puede destruir la optimalidad.
Una secuencia particular puede quedar por debajo o por encima de la entropía por símbolo. Cuatro apariciones del símbolo A usan cuatro bits con este código; cuatro apariciones del símbolo D usan doce. La cota entrópica restringe únicamente la longitud promedio bajo la fuente.
Un encabezado de código también puede cambiar el balance. Si describir la tabla costara cien bits y el ahorro promedio frente a longitud fija fuera una décima por símbolo, necesitaríamos más de mil símbolos para compensarlo. Esa cifra depende de los valores supuestos en el ejemplo.
206.6. Bloques y dependencias permiten otro nivel de ahorro
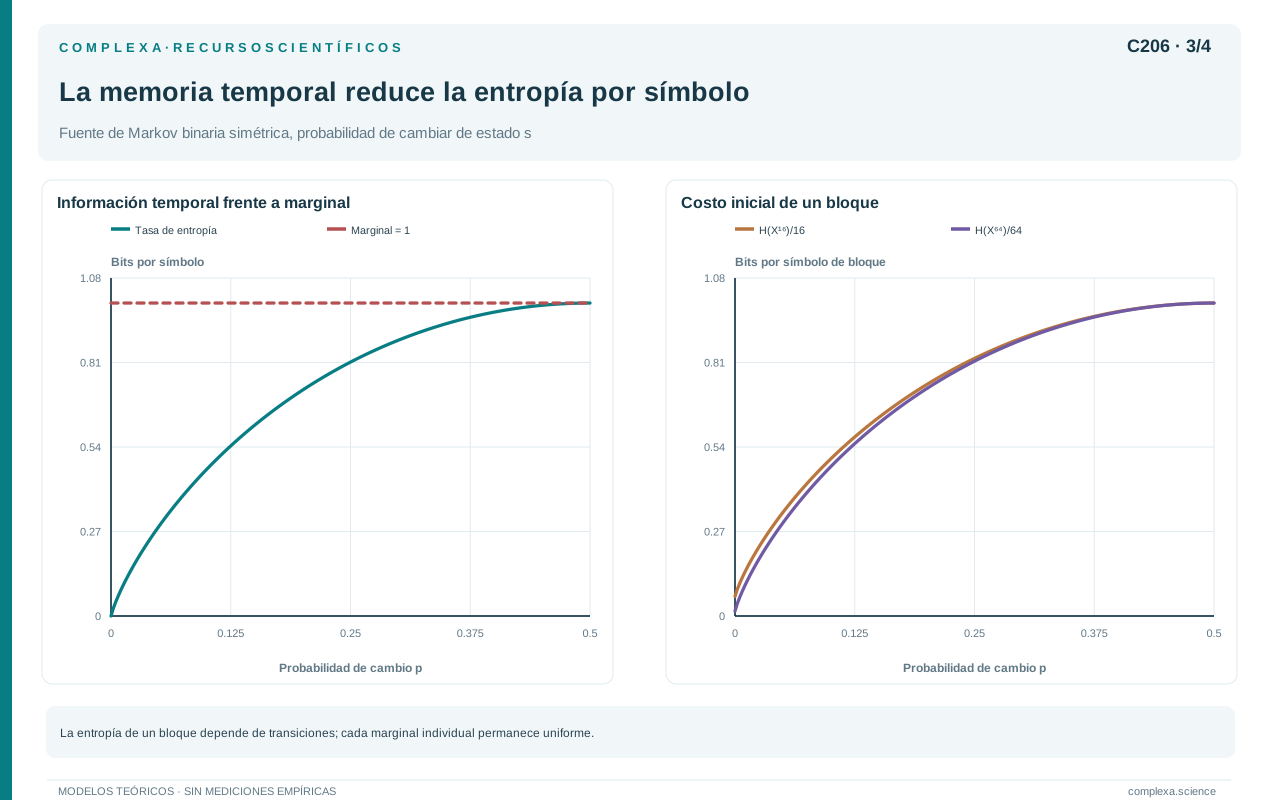
Una fuente binaria con probabilidades y tiene entropía aproximada de bits por símbolo. Sin embargo, un código de prefijo que trate los dos símbolos por separado necesita al menos un bit para cada uno.
Si agrupamos símbolos independientes de dos en dos, las cuatro probabilidades son , , y . Un código de Huffman puede asignar longitudes uno, dos, tres y tres; cuál de los dos resultados de probabilidad recibe la longitud más corta es una elección arbitraria.
La longitud promedio por pareja es bits, equivalente a por símbolo. La mejora procede de usar un alfabeto de bloques más grande, que reduce la penalización de las longitudes enteras.
En general, para bloques de longitud existe una construcción con longitud promedio por bloque menor que su entropía más un bit. Al dividir por , la diferencia de redondeo queda acotada por un bit dividido entre la longitud del bloque.
Si los símbolos son independientes y tienen la misma distribución, la entropía del bloque es . Si tienen memoria, debemos usar la entropía conjunta real. Sustituirla por la suma de marginales puede ignorar una oportunidad importante de compresión.
Una secuencia que repite siempre el mismo bit necesita describir cuál fue ese bit y cuánto dura la secuencia, si la longitud no era conocida. Codificar cada posición como si fuera independiente desperdicia la dependencia perfecta.
Un proceso que alterna de manera determinista también puede describirse a partir del primer bit y la longitud, bajo un modelo compartido de alternancia. Sus frecuencias equilibradas de ceros y unos no impiden una gran compresibilidad temporal.
Los bloques grandes pueden exigir tablas enormes y más recursos de cálculo. El beneficio estadístico debe compararse con el costo de representar el modelo y de codificar o decodificar. Una solución teórica asintótica no elimina esos costos.
Los métodos adaptativos y las representaciones de contexto buscan explotar regularidades sin enumerar de manera ingenua todas las secuencias posibles. Su rendimiento depende de qué estructuras pueden aprender y de cuántos datos reciben antes de usarlas.
La pregunta relevante es qué distribución de mensajes supone el compresor. Un límite basado en la entropía marginal puede ser demasiado alto si existe memoria, mientras que un modelo excesivamente optimista puede no reflejar los datos reales.
Un código adaptado a una distribución puede rendir mal cuando esta cambia. Si conservamos las longitudes uno, dos, tres y tres, pero las probabilidades pasan a ser , , y , la longitud promedio aumenta a bits.
La nueva fuente tiene la misma entropía que la anterior porque solo se permutaron sus probabilidades. Sin embargo, los símbolos ahora frecuentes recibieron palabras largas. Reorganizar el código según las nuevas probabilidades recuperaría el promedio de bits.
El ejemplo separa la incertidumbre de la fuente del rendimiento de una representación particular. Una entropía baja no garantiza compresión eficaz si el modelo del codificador está desactualizado. Un procedimiento adaptativo necesita aprender el cambio y comunicarlo o reproducirlo de manera sincronizada.
Durante esa adaptación puede haber un costo transitorio. Comparar únicamente el rendimiento después de que el modelo aprendió omite la fase inicial, que puede ser importante en archivos pequeños o fuentes que cambian con frecuencia.
206.7. Un formato de rachas y sus costos completos
Consideremos mensajes binarios de longitud dieciséis, conocida de antemano por emisor y receptor. Una racha es un tramo consecutivo del mismo valor. La secuencia con ocho ceros seguidos de ocho unos tiene dos rachas.
Diseñemos un formato sencillo, sin afirmar que sea óptimo. Guardamos el número de rachas menos uno en cuatro bits, el valor del primer bit en uno y cada longitud de racha menos uno en cuatro bits. Los valores posteriores alternan automáticamente.
Si hay rachas, el costo total es
El encabezado permite saber cuántas longitudes deben leerse. Cada longitud queda entre una y dieciséis posiciones. Un mensaje válido debe tener longitudes cuya suma sea dieciséis.
La secuencia de dos rachas ocupa trece bits y mejora los dieciséis de la representación directa. Una secuencia constante tiene una racha y ocupa nueve. Una secuencia completamente alternante tiene dieciséis rachas y ocupa sesenta y nueve bits.
El mismo formato comprime algunos mensajes y expande otros. No hay contradicción, porque explota una regularidad específica (las rachas largas). La alternancia es regular según otro modelo, pero este formato la codifica de manera ineficiente.
Si el proceso cambia de valor con probabilidad en cada una de las quince transiciones, el número esperado de rachas es . El costo esperado del formato es quince bits.
La entropía del bloque de ese proceso, con primer bit equiprobable, es aproximadamente bits. El formato todavía queda lejos del límite porque usa campos fijos y conserva redundancias que otra representación podría eliminar.
Podríamos ahorrar el último campo de longitud, porque su valor se deduce de las longitudes anteriores y del tamaño total, aunque eso daría otro formato. Para comparar resultados debemos declarar exactamente qué campos existen, metadatos incluidos.
También podríamos añadir una marca que elija entre formato directo y formato de rachas según cuál sea más corto. La marca tiene un costo y el receptor debe conocer la convención.
Otra representación exacta usa el número total de unos y la posición del mensaje entre todas las secuencias con ese conteo. Para longitud dieciséis conocida hay diecisiete conteos posibles, de cero a dieciséis, que podemos describir mediante cinco bits fijos.
Después de recibir el conteo , el receptor sabe que existen secuencias compatibles. Una enumeración compartida permite identificar la concreta mediante el techo del logaritmo binario de esa cantidad.
Si el conteo es cero, solo existe una secuencia compatible y no hace falta transmitir un índice adicional; el costo se reduce a cinco bits. Si el conteo es ocho, existen doce mil ochocientas setenta secuencias y el índice necesita catorce bits, para un total de diecinueve.
El formato vuelve a comprimir algunas cadenas y expandir otras, pero la estructura que explota es distinta de las rachas. Dos secuencias con igual conteo tienen el mismo costo aunque una esté agrupada y otra alternada.
El conteo comunica una propiedad del mensaje y el índice conserva el orden que esa propiedad no determina. Eliminar el índice convertiría la representación en un resumen con pérdida del registro, aunque el conteo fuera suficiente para alguna pregunta estadística.
206.8. Intervalos, modelos y codificación aritmética
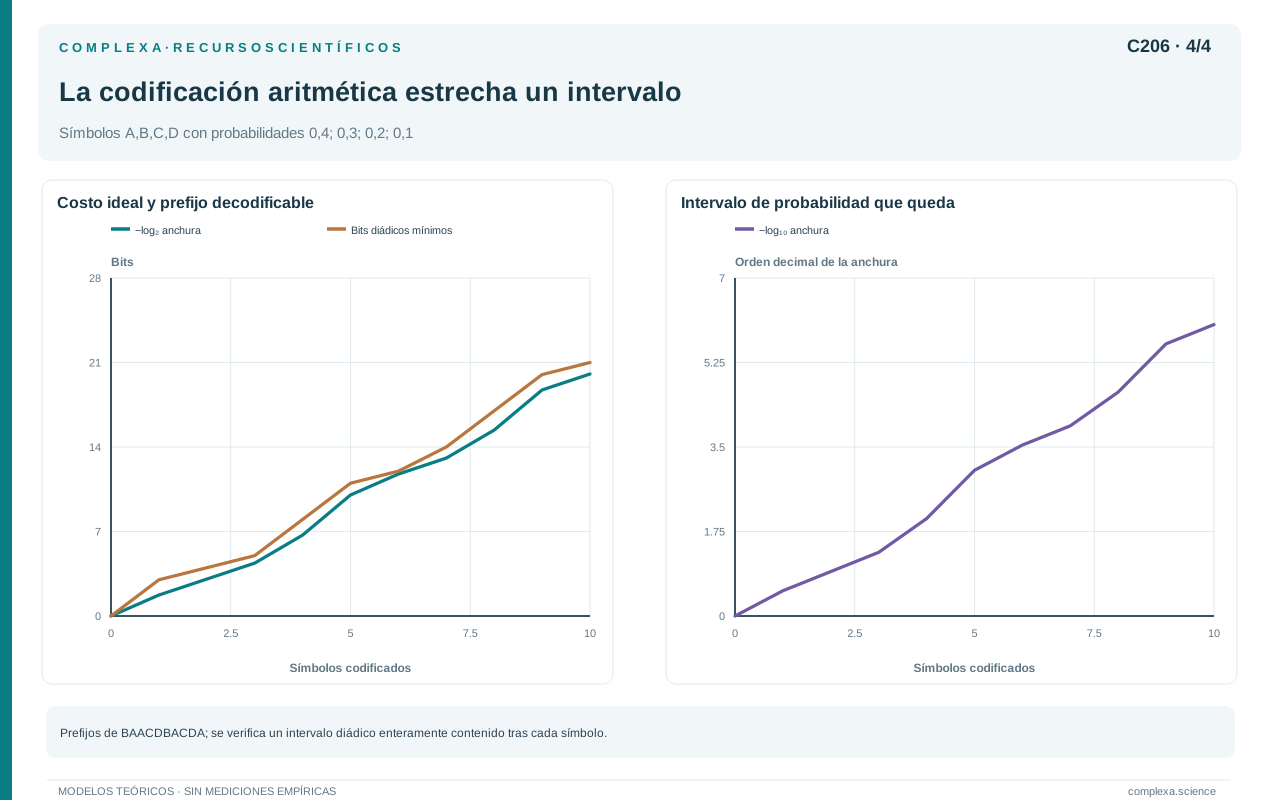
La codificación aritmética asigna a cada mensaje un intervalo cuya anchura es igual a su probabilidad bajo un modelo. Cada símbolo restringe el intervalo actual a una subregión proporcional a su probabilidad condicional.
Consideremos las probabilidades , , y para los símbolos A, B, C y D. En un intervalo inicial de cero a uno, asignamos a B la región de a .
Si el siguiente símbolo es A, conservamos el primer cuarenta por ciento de esa región. El intervalo del mensaje BA queda entre y , con anchura , igual al producto de probabilidades bajo independencia.
Podemos identificar una región binaria contenida en ese intervalo. El prefijo 0111 corresponde al intervalo entre y , que está dentro de la región del mensaje. Con las convenciones y longitud del mensaje acordadas, ese prefijo permite identificarlo.
El ejemplo muestra solo la idea geométrica. Un codificador real necesita reglas de terminación, precisión finita, reescalado y comunicación del modelo; un punto decimal aislado, sin una regla que diga cómo transmitirlo, todavía no es un código.
La ventaja conceptual es que la longitud se adapta a la probabilidad del mensaje completo, sin imponer una longitud entera separada a cada símbolo. Los costos de terminación pueden amortizarse sobre un bloque.
El intervalo binario debe quedar contenido en el del mensaje. Que un número representado aproximadamente caiga dentro de este es insuficiente, porque todas las continuaciones compatibles con el prefijo transmitido deben identificar el mismo mensaje bajo la convención usada.
Para mensajes de una longitud fija, los intervalos de mensajes distintos son disjuntos, salvo fronteras que se asignan mediante una convención coherente. Elegir un intervalo binario completamente contenido en cada uno evita confundir esas posibilidades. Las reglas de extremos, precisión y terminación forman parte de la demostración de recuperación.
El trabajo de Rissanen sobre desigualdades de Kraft y codificación aritmética estudia esta familia de representaciones. Nuestro intervalo de dos símbolos es una ilustración geométrica propia; una implementación necesita resolver los detalles aritméticos sin alterar el acuerdo entre codificador y decodificador.
El modelo puede actualizar probabilidades durante el mensaje, siempre que codificador y decodificador hagan las mismas actualizaciones con la misma información disponible. No hace falta transmitir cada nueva probabilidad si el procedimiento compartido permite reconstruirla.
Si sus estados se desalinean, la decodificación puede fallar. La compresión sin pérdida depende tanto del código como de que ambos extremos compartan las reglas y el estado pertinente. Un resultado corto no sirve si no puede recuperarse.
La codificación y el modelado son problemas distintos. Un buen mecanismo de representación no compensa probabilidades inadecuadas para la fuente. La entropía cruzada y la divergencia del capítulo anterior cuantifican parte de ese costo de desajuste.
206.9. Lo que ningún compresor puede prometer
Ninguna transformación reversible puede acortar todas las cadenas binarias de una longitud fija. Hay cadenas de longitud , pero solo cadenas de longitudes menores, contando incluso la cadena vacía.
Una representación inyectiva no puede colocar más entradas distintas que salidas disponibles, así que al menos una entrada no puede acortarse si todas deben recuperarse. El argumento no depende de la potencia del algoritmo.
La compresión eficaz se basa en que ciertos mensajes son más probables o pertenecen a una clase estructurada. Puede acortar esos mensajes a costa de expandir otros o de usar conocimiento compartido. Ante una promesa de reducción universal hay que examinar dónde se ocultan esos costos.
Un archivo ya comprimido puede tener pocas regularidades adicionales para el mismo método. Aplicar otro contenedor puede añadir encabezados y aumentar su tamaño. La ausencia de ahorro no demuestra que el contenido carezca de significado o estructura bajo cualquier otra representación.
La longitud comprimida también depende del algoritmo y del tamaño del archivo. Dos compresores pueden captar regularidades diferentes. Usar su tamaño como medida de complejidad requiere declarar esas decisiones y distinguirlo de una cantidad teórica universal.
Una verificación mínima de ausencia de pérdida consiste en decodificar y comparar el objeto reconstruido con el original según el criterio definido. Un tamaño menor o una apariencia visual parecida no prueban reversibilidad.
Las sumas de comprobación pueden ayudar a detectar alteraciones, pero no sustituyen una definición de lo que se conserva ni bastan para garantizar la reconstrucción frente a cualquier error. La protección de la transmisión es otro problema.
La redundancia añadida para detectar o corregir errores puede aumentar el tamaño después de comprimir. El objetivo conjunto puede ser reducir el mensaje fuente y después protegerlo frente a un canal imperfecto. Cada etapa tiene sus propios límites y costos.
En almacenamiento real, los bits suelen empaquetarse en unidades mayores. Una representación que no ocupa un número entero de bytes puede necesitar relleno y una indicación de cuántos bits son válidos. Ese costo puede ser pequeño para archivos grandes y decisivo para ejemplos cortos.
Las convenciones de caracteres también afectan las cuentas. Contar letras visibles no equivale a contar bytes de un texto codificado. Para evaluar una compresión de documentos debemos comparar tamaños sobre una representación definida y comprobar que la decodificación conserve los caracteres y la estructura requeridos.
Estas precisiones no alteran los límites teóricos; permiten conectarlos con una implementación y evitar que un ahorro aparente provenga de omitir información necesaria para interpretar el resultado.
206.10. Compresión como acuerdo verificable
La codificación sin pérdida transforma un objeto en una representación que permite recuperarlo. Su calidad depende de probabilidades, estructura de dependencias, restricciones de decodificación y costos de describir el modelo.
La desigualdad de Kraft muestra por qué las palabras cortas compiten por espacio. La entropía limita la longitud promedio bajo condiciones explícitas. Huffman da una solución óptima para un problema definido, mientras bloques, contextos y otros métodos aprovechan estructuras diferentes.
El ejemplo de rachas mostró que hay que contar los encabezados y reconocer las expansiones. El ejemplo de intervalos mostró cómo la probabilidad de un mensaje completo puede guiar su representación. Ninguno elimina la necesidad de un acuerdo preciso entre emisor y receptor.
Una comparación útil informa qué objeto se reconstruye, qué conocimiento se comparte, cuánto ocupa la representación completa y qué recursos exige. Así, la compresión deja de ser la impresión de que el archivo «contiene menos» y pasa a ser un resultado verificable.
El siguiente capítulo incorporará ruido durante la transmisión. Al problema de representar un mensaje con pocos símbolos se sumará el de recuperarlo con un error controlado cuando el canal puede modificar lo que se envía.
Referencias
- Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379–423. DOI.
- Huffman, D. A. (1952). A method for the construction of minimum-redundancy codes. Proceedings of the IRE, 40(9), 1098–1101. DOI.
- McMillan, B. (1956). Two inequalities implied by unique decipherability. IRE Transactions on Information Theory, 2(4), 115–116. DOI.
- Rissanen, J. (1976). Generalized Kraft inequality and arithmetic coding. IBM Journal of Research and Development, 20(3), 198–203. DOI.