COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
202.1. Dos incertidumbres no siempre se suman
Observamos dos variables binarias y comprobamos que cada una toma sus dos valores con la misma probabilidad, de modo que tiene un bit de entropía. ¿Cuánta incertidumbre contiene observarlas juntas? La respuesta no puede obtenerse únicamente de sus distribuciones individuales.
Si las variables son independientes, hay cuatro parejas equiprobables y la entropía conjunta es de dos bits. Si la segunda copia siempre a la primera, solo hay dos parejas y la entropía conjunta es de un bit. Las marginales son idénticas en ambos ejemplos, pero las relaciones entre variables cambian el resultado.
Esta diferencia aparece en muchos registros. Dos sensores pueden dar mediciones complementarias o repetir casi la misma señal. Dos preguntas pueden distinguir propiedades diferentes o preguntar de otra manera por una misma característica. Contar columnas no indica cuántas distinciones nuevas contiene una tabla.
Necesitamos una distribución conjunta que describa cómo aparecen los valores combinados. A partir de ella podemos obtener marginales, probabilidades condicionales y una contabilidad coherente de la incertidumbre. Cada operación responde a una pregunta diferente.
La entropía conjunta cuantifica la incertidumbre sobre la pareja completa. La entropía condicional cuantifica la incertidumbre que permanece sobre una variable cuando se conoce otra, promediada sobre los valores de esta última. La regla de la cadena relaciona ambas.
Estas definiciones tratan de distribuciones y observaciones; de ellas solas no se deduce una dirección causal ni una secuencia temporal. Podemos factorizar una distribución de varias maneras sin que todas representen mecanismos físicos distintos.
En este capítulo trabajaremos sobre todo con variables discretas de alfabeto finito, para evitar las ambigüedades propias de los infinitos y de las entropías diferenciales. Los ejemplos permiten calcular cada cantidad y mostrar cuándo una intuición aparentemente razonable resulta incorrecta.
El objetivo es aprender a tener presente qué incertidumbre se está contando, qué conocimiento se supone disponible y qué relaciones se perderían al reemplazar una distribución conjunta por sus marginales.
202.2. Distribuciones conjuntas y marginales
Sea la probabilidad de observar simultáneamente e . Todas las probabilidades son no negativas y su suma sobre las parejas posibles es uno. La distribución conjunta puede representarse como una tabla cuyos renglones y columnas corresponden a valores de las variables.
La probabilidad marginal de un valor de se obtiene sumando sobre todos los valores de
De manera análoga, sumamos sobre los valores de para obtener la marginal de . La marginal conserva la frecuencia de una variable, pero descarta cómo se combina con la otra.
La entropía conjunta se define como
Podemos entender la pareja como una nueva variable cuyos resultados son pares ordenados. La fórmula es la misma que usamos para una sola variable; solo cambia el espacio de resultados distinguibles.
Si intercambiamos los nombres y el orden de las coordenadas sin perder ninguna pareja, la entropía conjunta no cambia, porque ambas descripciones contienen las mismas posibilidades enumeradas de otra manera.
La independencia exige que la probabilidad de cada pareja sea el producto de sus marginales. No basta con que ambas variables tengan la misma distribución ni, en un problema más general, con que su correlación lineal sea cero.
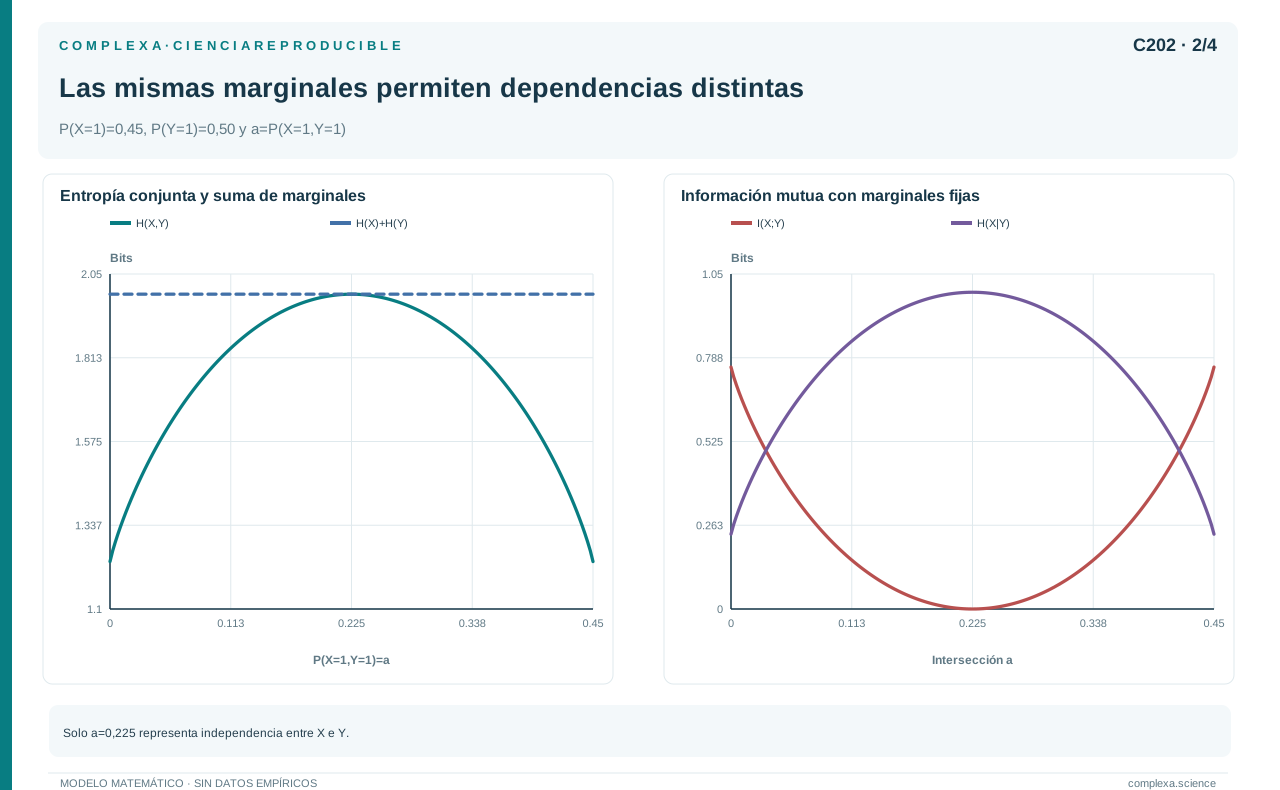
Para dos variables binarias uniformes, una tabla independiente asigna un cuarto a cada celda. Una tabla de copia asigna un medio a las dos celdas diagonales y cero a las otras. Sumar renglones o columnas produce exactamente las mismas marginales.
Si solo conservamos marginales, no podemos reconstruir cuál de esas tablas produjo los datos. Hay muchas distribuciones conjuntas compatibles con unas marginales dadas. Elegir una, por ejemplo el producto independiente, incorpora una hipótesis adicional.
Al combinar bases de datos, conocer la distribución de una propiedad en una muestra y la de otra propiedad en una muestra distinta no da automáticamente su distribución conjunta en los individuos. La correspondencia entre observaciones contiene información que las frecuencias separadas no conservan.
Las marginales también imponen límites a las tablas conjuntas admisibles. Para dos eventos, la probabilidad de que ambos ocurran no puede superar la menor de sus probabilidades. Tampoco puede ser menor que la suma de ambas menos uno, o que cero si esa suma es inferior a uno.
En la tabla que resolveremos después, las probabilidades de e son y . Su intersección puede variar entre cero y ; el valor elegido será . La independencia correspondería, en cambio, a .
Una vez fijadas esa celda y las dos marginales, las otras tres celdas quedan determinadas. Ese es el grado de libertad que falta cuando conocemos solo las frecuencias individuales. No podemos rellenar la tabla de cualquier manera, pero tampoco hay una única respuesta obligada.
Elegir una intersección fuera de esos límites obligaría a alguna otra celda a ser negativa. No basta, pues, con que coincidan los totales; una distribución válida necesita además probabilidades no negativas en todas sus combinaciones.
202.3. Condicionar significa cambiar el conjunto de referencia
Si un valor tiene probabilidad positiva, definimos
La expresión renormaliza las probabilidades dentro del grupo de observaciones donde ocurrió ese valor de . La suma sobre los valores de vuelve a ser uno. Condicionar no es eliminar filas y dejar intacto el denominador.
La entropía de esa distribución particular es . Diferentes valores de pueden producir incertidumbres diferentes. Algunos pueden determinar completamente y otros dejar abiertas muchas posibilidades.
La entropía condicional promedio es
Los pesos son las probabilidades de los grupos, que en general no son iguales. Promediar por igual un grupo muy raro y otro frecuente respondería a una distribución distinta de la que estamos analizando.
Un evento de probabilidad cero no tiene una distribución condicional ordinaria definida por el cociente anterior. En el caso discreto, su contribución al promedio es nula y podemos dejarla fuera.
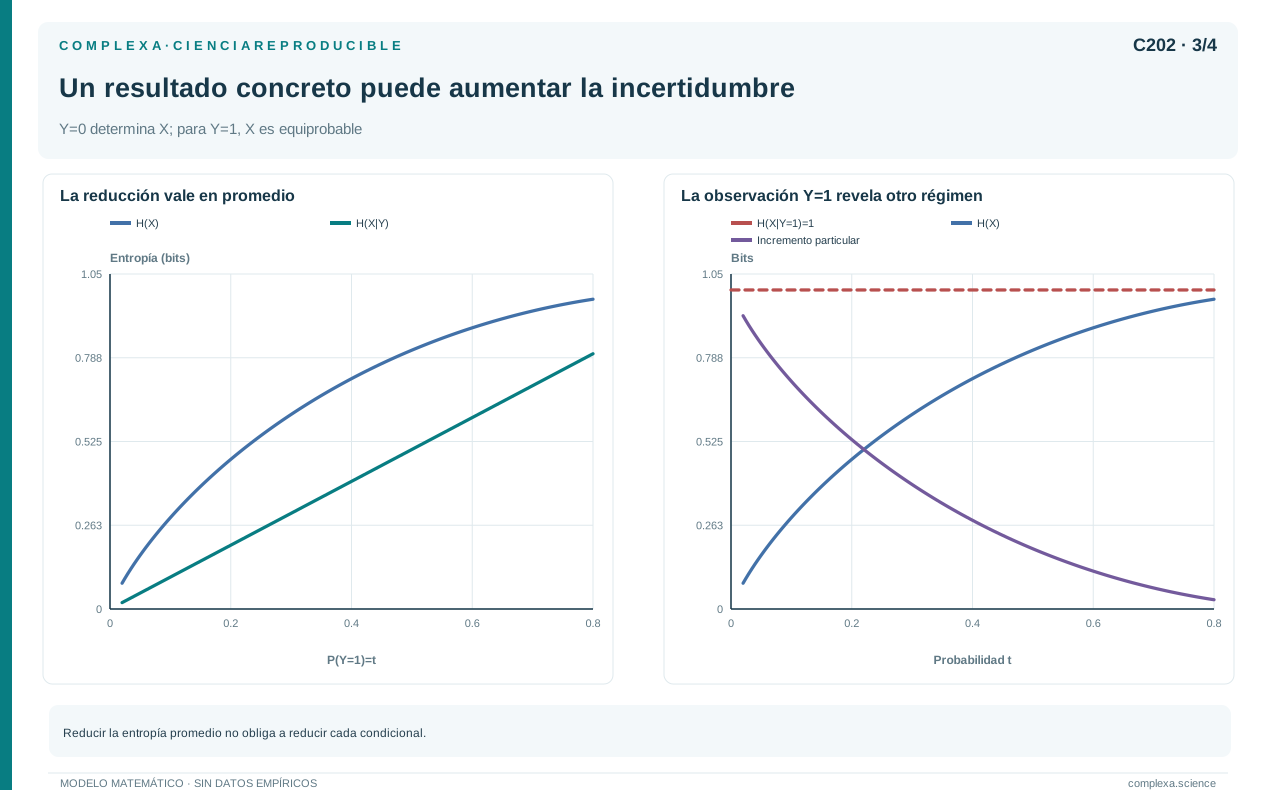
Hay que distinguir la entropía condicionada a un resultado concreto de la entropía condicional promedio. Una observación particular puede aumentar la incertidumbre sobre una variable aunque conocer otra variable reduzca esa incertidumbre en promedio.
Construyamos un ejemplo. Con probabilidad , un indicador vale cero y sabemos que . Con probabilidad , el indicador vale uno y es equiprobable entre cero y uno. Sin observar el indicador, la probabilidad de es .
La entropía inicial de es aproximadamente bits. Si observamos el indicador igual a uno, la entropía aumenta a un bit. Si observamos cero, disminuye a cero. La entropía condicional promedio es bits, inferior a la inicial.
La frase «observar siempre reduce la incertidumbre» debe precisar, por tanto, que habla de un promedio bajo un modelo fijo. No garantiza nada sobre cada resultado individual ni excluye sorpresas que revelen una situación menos determinada de lo que esperábamos.
La ponderación puede ilustrarse con mil registros divididos en dos grupos. En novecientos, el valor de una variable queda completamente determinado; en cien, sigue siendo binario y equiprobable. La entropía condicional promedio es una décima de bit, porque solo una décima de la población conserva un bit de incertidumbre.
Promediar las entropías de ambos grupos con pesos iguales daría medio bit. Ese número es correcto para una población artificial que concede la misma probabilidad a los dos grupos. Si un diseño de muestreo los equilibra deliberadamente, debemos distinguir la distribución de la muestra de la población que pretendemos describir.
La pregunta científica determina qué ponderación interesa. Podemos estudiar una población representativa, una distribución de intervención o una comparación estandarizada. Lo incorrecto sería cambiar entre ellas sin declarar que también cambió la cantidad estimada.
202.4. Derivar la regla de la cadena
La identidad fundamental de probabilidades es
para los valores pertinentes. Al aplicar el logaritmo negativo, la sorpresa de la pareja se descompone en la sorpresa del primer resultado observado y la sorpresa adicional del segundo dado ese conocimiento.
Promediamos la identidad sobre la distribución conjunta. El primer término depende solo de , por lo que sumar sobre recupera su marginal. El segundo es precisamente la definición de entropía condicional. Obtenemos
Podemos invertir el orden de la factorización y escribir también
El total es el mismo, aunque las contribuciones intermedias cambien. Conocer una variable primero puede dejar una cantidad distinta de incertidumbre residual que conocer la otra, porque sus entropías marginales no tienen por qué ser iguales.
La regla describe una forma de revelar o representar información sobre una pareja; nada en ella indica que el primer término cause el segundo. La elección del orden puede obedecer a comodidad matemática o a la disponibilidad de observaciones.
Para tres variables, una de las formas es
Cada término cuenta lo que todavía falta después de conocer las variables anteriores. Si olvidáramos el condicionamiento acumulado y sumáramos únicamente entropías marginales, contaríamos más de una vez parte de la incertidumbre compartida.
La generalización a una secuencia sigue la misma lógica. La incertidumbre del bloque es la del primer símbolo más la de cada símbolo posterior condicionado a todo el prefijo anterior. Si hay dependencias largas, reducir ese prefijo a una sola observación es una aproximación adicional.
En alfabetos finitos, las operaciones son directas. Con entropías infinitas, en cambio, una identidad válida entre sumas no justifica manipular sin cuidado expresiones como infinito menos infinito.
La regla puede interpretarse operacionalmente como una descripción por etapas. Primero comunicamos una parte y después lo que falta dadas las etapas previas. Para convertir esa contabilidad en un código realizable debemos añadir las condiciones de codificación correspondientes.
Un proceso temporal sencillo permite aplicar la regla de la cadena antes de desarrollar la teoría de la información temporal. Supongamos un bit inicial equiprobable y una dinámica que, en cada paso, cambia de valor con probabilidad independiente de una décima. El estado actual, dado el anterior, tiene entropía .
La propiedad de Markov establece que conocer estados aún más antiguos no añade información sobre el próximo una vez conocido el actual. Por tanto, un bloque de longitud tiene entropía . Para diez posiciones, el resultado es aproximadamente bits, aunque cada marginal tenga un bit.
Si la probabilidad de cambio fuera un medio, las posiciones serían independientes y el bloque tendría diez bits. Si fuera uno, la secuencia alternaría de manera determinista; bastaría conocer el primer bit y el bloque tendría un bit cualquiera que fuese su longitud.
Los tres procesos conservan marginales uniformes. Su diferencia aparece al condicionar a la historia y acumular incertidumbre nueva. La regla de la cadena localiza esa diferencia sin atribuir a la marginal propiedades temporales que no tiene.
En una aplicación, usar solo el estado previo requiere verificar o asumir la propiedad de Markov. Si el próximo resultado depende de una memoria más larga, omitirla aumenta la incertidumbre residual del modelo y modifica el cálculo del bloque.
202.5. Un ejemplo completo con dos variables binarias
Consideremos la distribución de la tabla siguiente, elegida con fines didácticos.
| Total | |||
|---|---|---|---|
| 0,45 | 0,10 | 0,55 | |
| 0,05 | 0,40 | 0,45 | |
| Total | 0,50 | 0,50 | 1,00 |
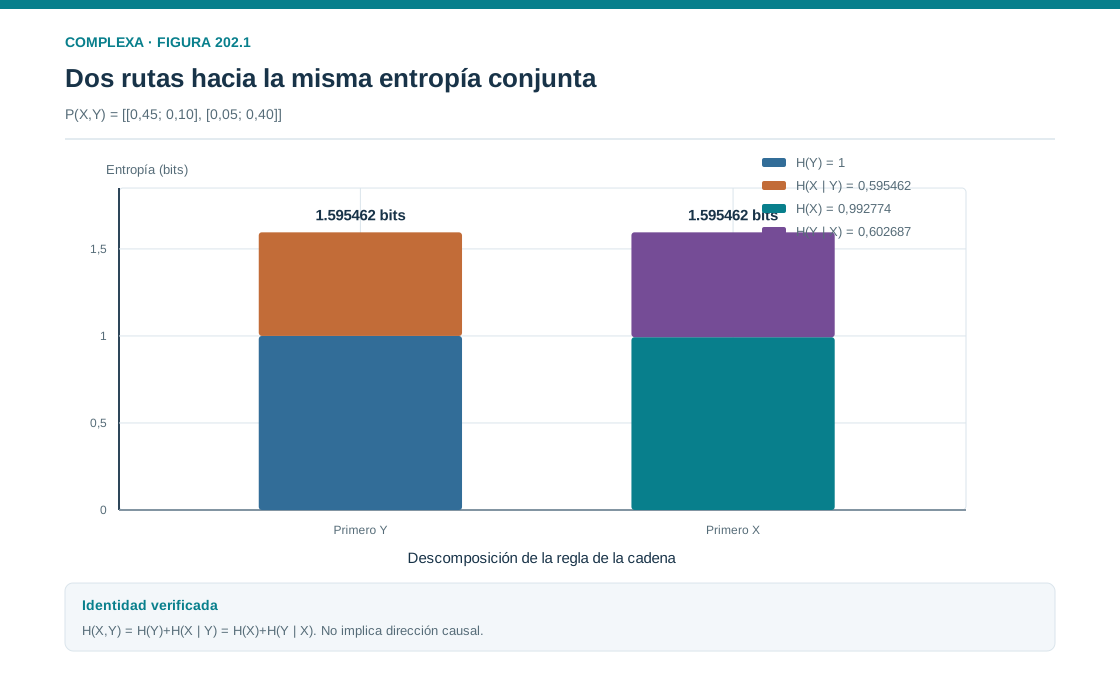
La variable es uniforme y tiene un bit de entropía. La variable tiene probabilidades y , por lo que su entropía es aproximadamente bits.
Cuando conocemos , las probabilidades de son y . La entropía correspondiente es aproximadamente bits. Cuando conocemos , son y , con entropía aproximada de bits.
Como ambos valores de aparecen con la misma probabilidad, la entropía condicional promedio es la media de esos dos números: aproximadamente bits. La regla de la cadena entrega una entropía conjunta de bits.
Podemos comprobarla directamente sumando las cuatro contribuciones de las celdas. La celda de probabilidad contribuye aproximadamente bits; la de , unos ; la de , unos ; y la de , unos .
La suma coincide, salvo redondeo, con el resultado por condicionamiento. La coincidencia es una identidad matemática y sirve además para comprobar la normalización de la tabla.
Si invertimos el orden, debemos obtener
En el grupo , la probabilidad de es . En el grupo , la probabilidad de es . Ponderar las entropías de esas distribuciones por y reproduce el mismo valor residual.
Las dos entropías condicionales son distintas. La diferencia se debe al reparto de la incertidumbre marginal y conjunta en esta distribución concreta; de ella no se deduce una dirección causal ni que una variable tenga más «influencia».
También podemos verificar una realización particular. La pareja tiene probabilidad y sorpresa aproximada de bits. La sorpresa de revelar primero es un bit; la de revelar después es . La suma coincide con la sorpresa de la pareja.
Para la misma pareja rara, revelemos primero . Ese resultado tiene probabilidad y sorpresa aproximada de bits. Dentro de ese grupo, ocurre con probabilidad de un noveno y su sorpresa es de aproximadamente bits.
La suma vuelve a ser . La sorpresa total de una pareja no depende del orden en que la describimos, aunque las contribuciones intermedias sí cambien. Esta identidad a nivel de resultado se convierte, al promediar, en la regla de la cadena para entropías.
La comparación muestra además por qué no debemos usar probabilidades marginales en ambas etapas. Sumar las sorpresas marginales de y de supondría una probabilidad conjunta de , muy distinta del real. El condicionamiento corrige precisamente esa diferencia.
202.6. Cuándo el condicionamiento reduce la entropía
Para variables discretas finitas,
La primera desigualdad procede de que cada entropía dentro de un grupo es no negativa. La segunda expresa que observar no aumenta, en promedio, la incertidumbre sobre bajo la distribución especificada.
Podemos demostrar la segunda mediante concavidad. La marginal de es una mezcla de sus distribuciones condicionadas, con pesos dados por las probabilidades de . La entropía de esa mezcla es al menos el promedio de las entropías de sus componentes.
La igualdad entre entropía marginal y condicional ocurre cuando las distribuciones condicionadas coinciden con la marginal para todos los grupos de probabilidad positiva. En ese caso conocer no modifica las probabilidades de , es decir, las variables son independientes.
En el extremo contrario, la entropía condicional es cero cuando cada valor pertinente de determina un único valor de . Esto significa que es una función de con probabilidad uno. Esa función no tiene por qué ser invertible.
Por ejemplo, si distingue cuatro categorías equiprobables y solo indica a cuál de dos grupos pertenece cada categoría, conocer determina , mientras que conocer todavía deja dos posibilidades para . Una determinación funcional puede ser asimétrica.
La regla de la cadena produce las cotas
La pareja no tiene menos incertidumbre que ninguna de sus componentes ni más que la suma de las incertidumbres separadas. El límite superior corresponde a la independencia. Las cotas ayudan a detectar errores de cálculo.
Estas afirmaciones no deben trasladarse sin modificaciones a la entropía diferencial. En variables continuas, una entropía condicional diferencial puede ser negativa y las cotas inferiores anteriores pueden fallar. El contexto discreto forma parte del resultado.
La reducción de entropía tampoco es idéntica a la reducción de error de una decisión concreta. En la tabla anterior, predecir siempre el valor más probable de sin observar produce error . Conocer y elegir el valor más probable dentro de cada grupo reduce el error a .
Esos errores y las entropías miden propiedades distintas de las mismas distribuciones. La predicción bajo pérdida de cero o uno usa el máximo de cada distribución; la entropía usa todas sus probabilidades mediante logaritmos. Un análisis debe elegir el criterio que corresponde a su objetivo.
Dos distribuciones sobre tres categorías ilustran la distinción entre entropía y error. Una asigna probabilidades , y cero; la otra, , y . En ambas, elegir la categoría dominante produce un error de cuatro décimas.
Sin embargo, la entropía de la primera es aproximadamente bits y la de la segunda, aproximadamente . La diferencia es exactamente cuatro décimas de bit, porque cuando no ocurre la categoría dominante la segunda distribución conserva una distinción binaria adicional.
Si el objetivo consiste solo en acertar la categoría más probable, esa distinción no cambia el error mínimo. Si necesitamos comunicar cuál de las categorías ocurrió, sí importa. Una misma distribución admite varias preguntas legítimas y la medida debe elegirse según la pregunta.
También podemos añadir una tercera observación al condicionamiento. La desigualdad se obtiene aplicando la concavidad dentro de cada grupo definido por y promediando después. No exige que las observaciones sean independientes.
202.7. Tres variables revelan estructura que las parejas ocultan
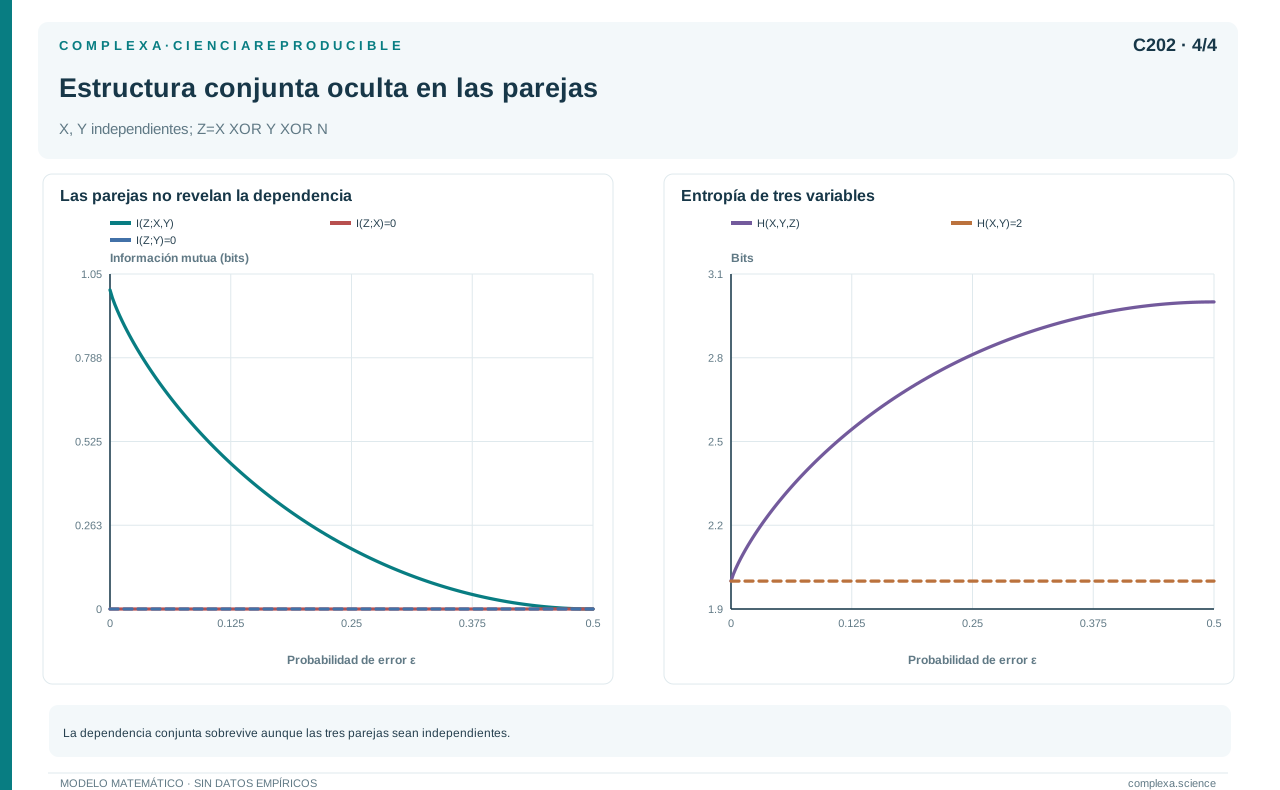
Tomemos dos bits independientes y equiprobables, e . Definimos un tercero mediante la operación XOR, de modo que vale uno cuando los dos bits son diferentes y cero cuando coinciden.
Hay cuatro triples equiprobables, porque las combinaciones de los dos primeros bits determinan el tercero. Cada variable tiene un bit de entropía. Cada pareja tiene dos bits y sus variables son independientes. Sin embargo, el triple completo tiene solo dos bits de entropía.
Según la regla de la cadena,
Conocer una sola entrada no reduce la incertidumbre sobre el resultado XOR. Conocer ambas lo determina. La relación conjunta no aparece en las distribuciones de parejas.
Por tanto, comprobar la independencia de cada pareja no demuestra la independencia conjunta de tres o más variables. Un modelo que reconstruya la distribución completa como producto de marginales asignaría probabilidad a triples imposibles en esta construcción.
Si añadimos una cuarta variable que copia exactamente , la entropía conjunta sigue siendo de dos bits. Hay una columna más, pero no añade incertidumbre una vez conocidas las anteriores.
Si la cuarta variable es una copia que cambia de valor con probabilidad independiente , la entropía conjunta aumenta en , aproximadamente bits. El incremento procede solo del ruido nuevo, que no informa sobre las entradas originales.
Este ejemplo anticipa problemas de información multivariada que estudiaremos después. La contribución de una variable depende de qué otras se conocen, de modo que no siempre puede describirse como una cantidad fija propia de cada columna por separado.
La contabilidad por cadenas sigue siendo válida, pero diferentes órdenes reparten de manera distinta las contribuciones incrementales. Para estudiar cómo varias fuentes informan sobre un objetivo harán falta definiciones adicionales de redundancia y sinergia.
En aplicaciones, el ejemplo advierte contra seleccionar variables únicamente por relaciones de parejas. Una variable que parece poco relacionada con el objetivo de manera aislada puede ser decisiva al combinarse con otra, siempre que esa estructura pueda estimarse y validarse con datos suficientes.
202.8. Condicionar no equivale a intervenir
Una distribución conjunta puede factorizarse empezando por cualquiera de sus variables. Esa libertad algebraica no significa que podamos invertir libremente un mecanismo causal. Observar una variable e imponerle externamente un valor son operaciones distintas.
Supongamos que una fuente común determina dos registros idénticos. Conocer uno elimina la incertidumbre sobre el otro. Sin embargo, modificar el archivo de uno de los sensores después de medir no cambia el fenómeno que originó el segundo registro.
La entropía condicional describe la relación observacional del modelo. Para predecir intervenciones necesitamos representar cómo se generan las variables y qué mecanismo cambia al actuar.
La selección puede producir relaciones dentro de un grupo que no existían en la población completa. En el ejemplo XOR, los dos bits originales son independientes. Si seleccionamos únicamente los registros donde el resultado XOR es cero, ambos bits coinciden y observar uno determina el otro.
Entre sus generadores no apareció ninguna interacción física; la selección solo restringió la población a resultados compatibles con una condición común.
Esto tampoco contradice que añadir conocimiento reduzca la entropía condicional promedio. Debemos comparar cantidades con el mismo conjunto de referencia. Una relación dentro de un grupo seleccionado y otra en la población original no responden exactamente a la misma pregunta.
Las decisiones de inclusión, los filtros de calidad y los criterios de clasificación pueden equivaler a condicionar. Si dependen de varias variables, pueden modificar sus asociaciones. Una auditoría informacional debe documentar qué registros entraron en cada cálculo.
Tampoco debemos leer el orden de una cadena como una cronología. Podemos escribir primero una variable medida después por comodidad matemática. La factorización seguirá siendo válida, pero ese orden no describe una transmisión retrospectiva de influencia.
Cuando interesa una dirección temporal, el modelo debe incluir tiempos, pasado disponible y una pregunta predictiva concreta. Más adelante veremos medidas que usan esa estructura. Incluso entonces, la identificación causal requerirá condiciones adicionales.
La selección puede cuantificarse sin ambigüedad en el ejemplo anterior. Antes del filtro hay cuatro parejas equiprobables de bits y la entropía conjunta es de dos bits. Conservar únicamente las parejas iguales deja dos posibilidades equiprobables y una entropía conjunta de un bit.
Cada marginal sigue siendo uniforme, de modo que observar solo las frecuencias individuales no revelaría el cambio. La entropía condicional de un bit dado el otro pasa de un bit a cero. Todo ese cambio procede del criterio de inclusión.
Si los registros descartados corresponden a valores ausentes por un mecanismo que depende de las dos variables, trabajar únicamente con casos completos puede producir una transformación semejante. Una fórmula informacional distinta no lo remedia; hay que representar el mecanismo de observación y la población sobre la que se quiere concluir.
202.9. Estimar cantidades compatibles
Si estimamos una distribución conjunta a partir de una misma tabla de frecuencias y derivamos de ella todas las marginales y condicionales, la regla de la cadena se cumple algebraicamente para la distribución empírica. El error de muestreo no rompe esa identidad interna.
Esto no significa que las estimaciones sean insesgadas o precisas respecto de la población. Todas pueden estar equivocadas de manera compatible. Una identidad correcta verifica la coherencia del cálculo, pero no garantiza la calidad inferencial.
Si estimamos cada cantidad con métodos o muestras diferentes, pueden aparecer discrepancias. Una entropía marginal calculada en todos los registros y una conjunta calculada solo en registros completos quizá describan poblaciones distintas. Restarlas como si fueran partes de la misma distribución puede producir interpretaciones erróneas.
El problema se agrava con muchas variables. El número de combinaciones posibles crece rápidamente y las tablas conjuntas se vuelven dispersas. Incluso cuando cada marginal está bien estimada, la estructura de dependencias puede quedar poco determinada.
Asignar cero a todas las combinaciones no observadas supone que son imposibles en el modelo empírico. Esa decisión puede reducir artificialmente las entropías conjuntas y condicionales. Los métodos de regularización necesitan preservar la normalización y declarar qué supuestos introducen.
Las celdas vacías también requieren un tratamiento cuidadoso de las condicionales. Un grupo sin observaciones no permite estimar sus probabilidades mediante división de conteos. Su ausencia muestral no equivale necesariamente a probabilidad poblacional cero.
El redondeo puede introducir discrepancias pequeñas. Conviene calcular con precisión suficiente, redondear solo al presentar los resultados y evitar normalizar varias veces cifras ya redondeadas. En el ejemplo resuelto, las últimas cifras pueden variar por esa razón sin alterar la identidad exacta.
Para estimar incertidumbre mediante remuestreo, la unidad debe respetar la dependencia del diseño. Si cada individuo tiene múltiples registros o las observaciones pertenecen a una serie temporal, tratarlas como filas independientes puede subestimar la variabilidad.
Una presentación reproducible conserva la tabla o el modelo conjunto, los criterios de inclusión y las operaciones realizadas. Así otra persona puede reconstruir las cantidades sin adivinar qué denominadores se usaron en cada etapa.
Teoría y estimación difieren también en otro punto. Disponer de una variable adicional nunca obliga a usarla; con probabilidades verdaderas conocidas, un procedimiento de decisión puede ignorar esa observación si no ayuda. En cambio, un modelo aprendido con pocos datos puede sobreajustar nuevas variables y predecir peor.
Ese deterioro empírico no contradice la desigualdad de entropías condicionales. La desigualdad compara cantidades de una distribución verdadera; el procedimiento de aprendizaje usa una estimación y tiene un costo de complejidad. Para evaluar si una observación adicional ayuda en la práctica, necesitamos medir el rendimiento fuera de los datos usados para ajustar.
Esta distinción reaparecerá cuando usemos la información para seleccionar variables. Una ganancia aparente calculada sobre la misma muestra puede deberse a la adaptación al ruido. La validación y el control del tamaño de muestra pertenecen a la inferencia, aunque la identidad algebraica siga siendo exacta.
202.10. Una contabilidad para conservar distinciones
La entropía conjunta cuenta incertidumbre sobre resultados combinados. El condicionamiento especifica qué cambia al conocer una parte. La regla de la cadena conecta ambas mediante una descomposición que evita contar más de una vez distinciones ya resueltas.
Los ejemplos mostraron tres límites de intuiciones frecuentes. Las marginales no determinan la distribución conjunta. Una observación particular puede aumentar la incertidumbre aunque la entropía condicional promedio disminuya. La independencia de todas las parejas no garantiza la independencia de un conjunto mayor.
También vimos que la coherencia algebraica y la explicación causal son problemas diferentes. Una factorización puede ser exacta sin representar una dirección de influencia. Una tabla empírica puede satisfacer todas las identidades y seguir estimando mal la distribución que interesa.
Para usar estas herramientas conviene preguntar qué variable se quiere conocer, qué otras están disponibles y bajo qué población o condición se realiza la comparación. Después podemos calcular las contribuciones sin perder su interpretación.
El siguiente capítulo cuantificará directamente cuánto reduce una variable la incertidumbre sobre otra. Esa cantidad, la información mutua, surge de las identidades que acabamos de construir, pero requiere todavía distinguir dependencia estadística, predicción y causalidad.
Referencias
- Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379–423. DOI.
- Shannon, C. E. (1948). A mathematical theory of communication, continuación. The Bell System Technical Journal, 27(4), 623–656. DOI.
- Kullback, S., y Leibler, R. A. (1951). On information and sufficiency. The Annals of Mathematical Statistics, 22(1), 79–86. DOI.