Módulo 23. Complejidad algorítmica, computacional y estadística
227.1. Recordar para anticipar
Un registro puede ser muy imprevisible y, al mismo tiempo, no exigir memoria para predecirlo correctamente. Una moneda independiente con probabilidades conocidas es el ejemplo más sencillo.
Aunque cada resultado sea incierto, observar los anteriores no cambia la distribución del siguiente. Al predictor le basta conocer la ley de la moneda, sin conservar ninguna historia particular de lanzamientos.
Una secuencia periódica presenta la situación complementaria. Una vez conocida la fase, el futuro puede ser determinista; sin embargo, necesitamos recordar en qué punto del ciclo estamos.
Estas situaciones separan incertidumbre y memoria predictiva. La tasa de entropía cuantifica información nueva por símbolo bajo condiciones apropiadas. La complejidad estadística, en el sentido de la mecánica computacional, cuantifica la información almacenada en los estados predictivos mínimos.
La expresión complejidad estadística tiene otros usos en la literatura. Aquí la reservaremos para esa definición concreta, introducida en el desarrollo de Crutchfield y Young y formalizada posteriormente por Shalizi y Crutchfield.
La pregunta central es qué diferencias entre historias importan para anticipar el futuro. Dos pasados pueden ser distintos como secuencias y equivalentes como fuentes de predicción.
Si producen exactamente la misma distribución de futuros, conservar cuál de ellos ocurrió no mejora la predicción. Podemos agruparlos en un mismo estado.
Si alguna distribución futura difiere, agruparlos pierde información predictiva exacta. La diferencia puede aparecer en el próximo símbolo o en una combinación situada más adelante.
La construcción comienza, por tanto, con la tarea específica de predecir distribuciones futuras a partir del pasado observado. No busca describir todos los detalles históricos ni identificar automáticamente causas físicas.
Los estados dependen del modelo de observación. Si registramos solo una parte del sistema, resumen lo que esa serie permite anticipar, que no tiene por qué coincidir con el estado microscópico completo.
También debemos distinguir conocer la ley del proceso de aprenderla. La definición ideal supone que las distribuciones condicionales están determinadas; inferirlas a partir de una muestra finita será otro problema.
Este capítulo desarrollará la idea mediante procesos simples donde podemos calcular las cantidades exactamente. La comparación mostrará por qué dos registros con la misma incertidumbre pueden exigir memorias diferentes.
El resultado será una noción precisa de estructura predictiva, con límites claros sobre lo que mide y sobre lo que una estimación empírica puede afirmar.
227.2. Equivalencia entre historias
Consideremos un proceso estacionario sobre un alfabeto finito. En el instante t llamaremos pasado a todos los símbolos anteriores a t y futuro a la secuencia que comienza en t.
La estacionariedad permite usar una misma ley al cambiar el origen temporal. No implica independencia ni ausencia de memoria.
Dos historias pertenecen al mismo estado predictivo si inducen la misma distribución sobre todos los futuros posibles. Podemos escribir la relación de equivalencia como
La igualdad es entre distribuciones; desde el mismo estado pueden producirse realizaciones futuras distintas con probabilidades determinadas.
Para evitar dificultades de notación con secuencias infinitas, podemos entenderla como igualdad de probabilidades para todos los bloques futuros finitos. Esa colección determina la distribución del futuro.
Las probabilidades condicionales se consideran donde están definidas y las equivalencias pertinentes se formulan salvo conjuntos de historias de probabilidad nula. No necesitamos asignar significado empírico arbitrario a pasados imposibles.
Cada clase de equivalencia es un estado causal en la terminología de la mecánica computacional. Denotaremos el estado del instante t por S_t.
El adjetivo causal indica aquí suficiencia predictiva; llamar así a una clase no prueba un efecto de intervención ni identifica una variable física que podamos manipular.
Una historia larga puede reducirse a una etiqueta pequeña. En una cadena de Markov de primer orden, por ejemplo, el último símbolo puede contener toda la información necesaria del pasado.
En otros procesos necesitamos una función más elaborada de la historia, como la fase de un ciclo, la paridad de un número de eventos o el tiempo transcurrido desde una señal.
La definición no exige que el número de estados sea finito. Puede haber un conjunto numerable o estructuras más generales; las fórmulas de entropía discreta que usaremos requieren el caso correspondiente.
Una etiqueta de estado tampoco tiene un significado privilegiado por su nombre. Renombrar las clases sin cambiar sus distribuciones futuras ni sus transiciones conserva la representación predictiva. La organización reside en las equivalencias y las probabilidades; llamar activo, inactivo o adaptativo a un estado es una interpretación adicional que necesita evidencia sobre el sistema observado.
Agrupar solo por el próximo símbolo no siempre basta. Dos historias pueden asignar la misma probabilidad a cero y uno en el siguiente paso y diferir en las probabilidades de pares o bloques más largos.
La equivalencia se construye respecto del futuro completo. Esa exigencia permite hablar de memoria predictiva del proceso, más allá de una tarea de horizonte uno.
227.3. Suficiencia y minimalidad
El estado S_t conserva toda la información del pasado necesaria para la distribución futura. En términos probabilísticos, el pasado y el futuro son condicionalmente independientes dado el estado.
La afirmación no significa que pasado y futuro sean independientes sin condicionar. Precisamente los estados capturan cómo la historia modifica la distribución de lo que viene.
Podemos comparar esta representación con otra variable R construida determinísticamente a partir del pasado. Supongamos que R también permite predecir exactamente todos los bloques futuros.
Si dos historias comparten el mismo valor de R, deben producir la misma distribución futura. De lo contrario, R no podría dar la predicción correcta para ambas.
Por tanto, cada valor de R está contenido dentro de una clase predictiva. El estado S puede recuperarse como función de R, salvo las excepciones de probabilidad nula pertinentes.
Cuando las entropías discretas están bien definidas y son finitas, esa relación implica que la entropía de S no supera la de R. Los estados causales son así una representación mínima dentro de esta clase de resúmenes predictivos exactos del pasado.
La minimalidad vale solo dentro de esa clase de comparación. El resultado no la afirma frente a cualquier dispositivo imaginable, representación cuántica o generador que no esté obligado a ser una función predictiva del pasado.
Tampoco demuestra que inferir los estados sea fácil. Una caracterización matemática mínima puede requerir mucha información para identificarse a partir de observaciones.
Podemos entender la minimalidad como eliminación de memoria irrelevante. Guardar toda la historia es suficiente, pero suele incluir diferencias que no cambian ninguna predicción futura.
Guardar demasiado poco produce el problema opuesto. Si conservamos solo la frecuencia global de unos en una cadena cuya transición depende del último símbolo, perdemos información necesaria para anticipar el siguiente.
La construcción ideal conserva todas las distinciones históricas necesarias para la predicción exacta y ninguna superflua.
Si aceptamos un error pequeño o un horizonte limitado, podemos fusionar más historias y reducir memoria. Esa es una tarea diferente, que requiere declarar una función de pérdida y una tolerancia.
Un estado predictivo tampoco tiene que coincidir con una palabra fija del registro. Varias historias de longitudes y contenidos distintos pueden compartir la misma función relevante. Por ejemplo, para recordar si desde una señal ha ocurrido un número par o impar de eventos, basta conservar una etiqueta binaria y actualizarla con cada evento. El pasado necesario para reconocer inicialmente esa etiqueta puede ser largo, aunque la memoria que debe mantenerse después sea pequeña. Esta distinción entre longitud de historia y tamaño del estado reaparecerá al construir máquinas predictivas.
227.4. Entropía de estados y cantidad de memoria
Si el proceso tiene estados predictivos discretos con probabilidades estacionarias pi_s, su complejidad estadística se define como la entropía de esa distribución
La unidad es el bit. La cantidad mide incertidumbre sobre el estado predictivo antes de identificar cuál corresponde a la historia observada.
Si hay un único estado, su probabilidad es uno y la complejidad estadística es cero. Si hay dos estados igualmente probables, es un bit.
No basta contar estados. Dos estados con probabilidades muy desequilibradas tienen una entropía menor que dos estados equiprobables.
Si hay M estados discretos, la entropía no supera el logaritmo en base dos de M. El máximo se alcanza cuando todos son igualmente probables.
Podemos construir dos estados desiguales mediante una cadena binaria que pase de cero a uno con probabilidad 0,05 y de uno a cero con probabilidad 0,45. El equilibrio de flujos exige que la probabilidad estacionaria de cero multiplicada por 0,05 iguale la de uno multiplicada por 0,45. Al normalizar, obtenemos probabilidades 0,9 y 0,1. Las distribuciones de transición siguen siendo distintas, de modo que ambos estados son necesarios, pero su entropía es aproximadamente 0,469 bits. Contar dos estados e informar siempre un bit ignoraría esa distribución.
Como medida de memoria, C_mu es una cantidad informacional promedio, que no mide el número exacto de bits físicos que ocupa una implementación concreta.
Un dispositivo con dos etiquetas suele reservar un bit aunque sus probabilidades sean desiguales. La entropía describe un límite de codificación promedio bajo condiciones apropiadas, que no obliga a fraccionar una celda de memoria.
Tampoco incluye automáticamente el costo de almacenar las probabilidades de transición o el programa que implementa el predictor. La ley del proceso se trata como conocida al evaluar la distribución de estados.
Un proceso independiente con una probabilidad real difícil de describir puede tener un solo estado causal y complejidad estadística cero. Eso no significa que especificar su parámetro exacto sea gratuito en cualquier tarea descriptiva.
La medida separa la memoria dinámica sobre la historia del costo de describir el modelo. Esta distinción la diferencia de la complejidad algorítmica y de la complejidad efectiva.
Si la distribución estacionaria de estados tiene entropía infinita, la complejidad estadística puede divergir. Para estados continuos, sustituir esta fórmula por una entropía diferencial no conserva todas sus interpretaciones; debemos especificar la representación y la medida apropiadas.
En los ejemplos siguientes trabajaremos con estados finitos y probabilidades explícitas, de modo que cada cálculo sea verificable.
227.5. Independencia y periodicidad
Una moneda independiente equilibrada asigna probabilidad un medio a cada símbolo en todos los instantes, sin importar la historia. Todos los pasados pertenecen a la misma clase predictiva.
Su complejidad estadística es cero, mientras que su tasa de entropía es un bit por símbolo. La incertidumbre futura es alta, pero recordar resultados anteriores no ayuda.
Si la moneda tiene probabilidad de uno igual a una quinta parte, sigue habiendo un único estado. Cambia la tasa de entropía, que se vuelve la entropía binaria de esa probabilidad, pero la memoria predictiva continúa siendo nula.
Variar la incertidumbre marginal no modifica necesariamente la complejidad estadística, porque ambas cantidades responden a preguntas distintas.
Consideremos ahora una alternancia determinista de ceros y unos. Para tratarla como proceso estacionario, elegimos inicialmente una de las dos fases con igual probabilidad.
Después de observar el último símbolo sabemos cuál será el próximo. Hay dos estados predictivos, uno que anuncia cero con certeza y otro que anuncia uno con certeza.
Cada estado aparece la mitad del tiempo. La complejidad estadística es un bit, pero la tasa de entropía es cero porque, conocida la fase, cada nuevo símbolo queda determinado.
La incertidumbre sobre la fase no se produce nuevamente en cada paso. Es una información inicial que persiste a través de la evolución.
Si el observador recibe una fase fija como información externa, la tarea condicional cambia. No podemos comparar ese caso con el proceso estacionario de fase desconocida sin señalar la diferencia.
Para una secuencia de período mínimo p y fase uniformemente distribuida, las fases distinguibles pueden formar p estados predictivos y la complejidad correspondiente es el logaritmo de p.
El período debe ser mínimo. Si escribimos dos veces un mismo bloque y llamamos período a su longitud duplicada, no hemos creado nuevas fases predictivamente diferentes.
Estos ejemplos permiten construir un plano conceptual. Una moneda independiente puede combinar alta tasa de entropía con memoria nula. Una periodicidad extensa puede combinar tasa nula con memoria de fase apreciable.
No hay, entonces, una regla general según la cual más azar implique más estructura predictiva. Tampoco basta observar regularidad para concluir memoria nula.
La estructura está en las distinciones que el predictor necesita conservar, al margen de la impresión visual de orden o desorden del registro.
227.6. Cálculo completo para un proceso con persistencia
Construyamos una cadena binaria de Markov que conserva el último símbolo con probabilidad 0,8 y lo cambia con probabilidad 0,2. Iniciamos la cadena en su distribución estacionaria.
Por simetría, ceros y unos tienen probabilidad un medio. Sin embargo, el último símbolo modifica la distribución del siguiente y debe conservarse para predecir exactamente.
Hay dos estados, según el último símbolo sea cero o uno. Sus probabilidades estacionarias son iguales, por lo que C_mu vale un bit.
La incertidumbre del próximo símbolo, conocida la historia, es la entropía de una elección entre permanecer y cambiar
Ese valor es la tasa de entropía en bits por símbolo. Memoria predictiva y novedad coexisten aquí con magnitudes distintas.
La entropía de un bloque de longitud L, para L al menos uno, se obtiene sumando la incertidumbre del primer símbolo y las incertidumbres condicionales de los siguientes
Para dos símbolos resulta aproximadamente 1,721928 bits. Las probabilidades conjuntas son 0,4 para 00 y 11; para 01 y 10 son 0,1.
Podemos comprobar la misma entropía directamente con esas cuatro probabilidades. La coincidencia verifica la aplicación de la regla de la cadena.
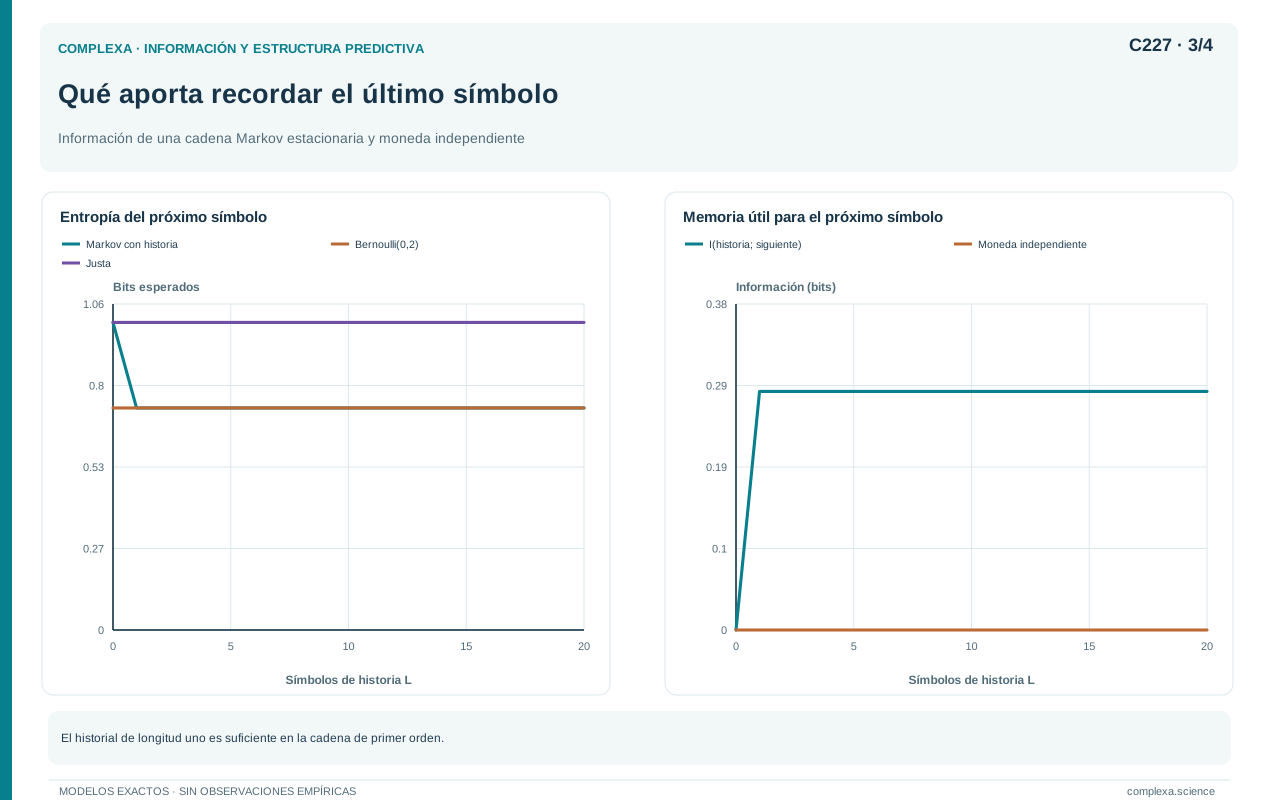
Un predictor que ignora el pasado y asigna siempre probabilidades iguales incurre en una pérdida logarítmica esperada de un bit por símbolo. El predictor que recuerda el último símbolo alcanza aproximadamente 0,721928.
La diferencia, cercana a 0,278072 bits por símbolo en esta comparación, cuantifica la mejora de predicción de un paso bajo pérdida logarítmica.
No debemos confundir esa ganancia con el bit completo almacenado en el estado. El estado contiene una distinción binaria, pero la transición introduce incertidumbre y no transmite toda esa distinción de manera recuperable.
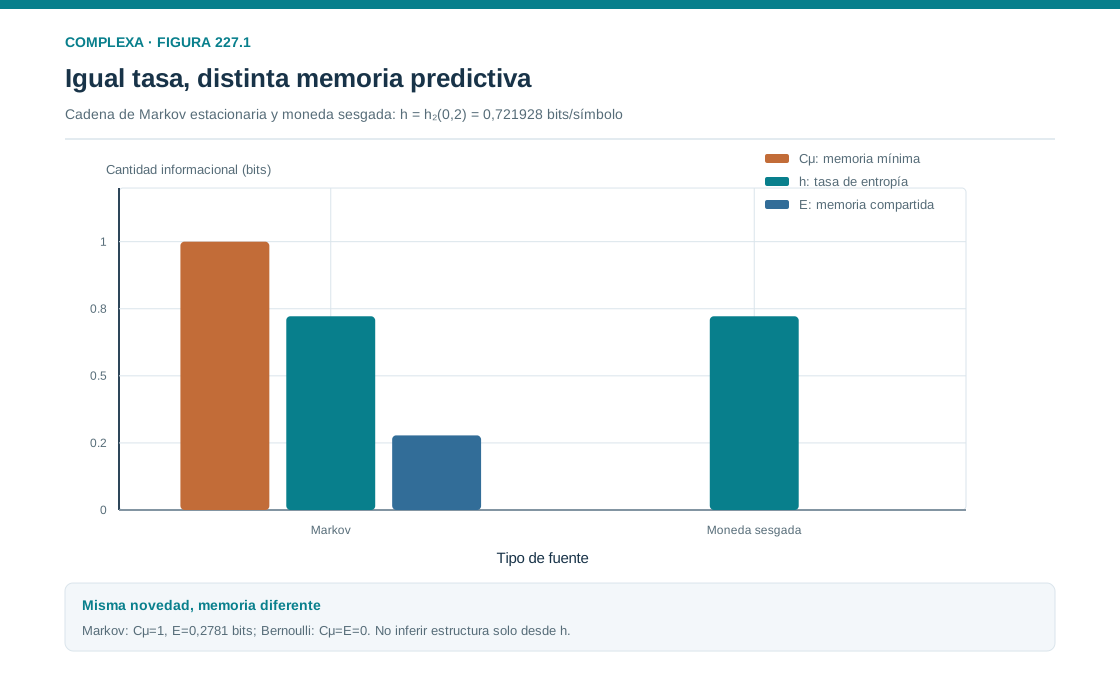
Comparemos con una moneda independiente sesgada que produce uno con probabilidad 0,2. Tiene la misma tasa de entropía, aproximadamente 0,721928, pero C_mu es cero.
Si solo conocemos la tasa de entropía, no podemos distinguir estos procesos; la complejidad estadística sí los separa, porque uno requiere memoria del último símbolo y el otro no.
Podemos calcular también el costo de una memoria redundante. Si guardamos los dos últimos símbolos, tenemos cuatro etiquetas con probabilidades 0,4, 0,1, 0,1 y 0,4. Su entropía es aproximadamente 1,721928 bits. Esa representación predice correctamente, pero el símbolo más antiguo no añade nada una vez conocido el último. La diferencia respecto del bit de estado mínimo cuantifica información histórica almacenada sin beneficio predictivo adicional en este modelo.
A dos pasos, la probabilidad de conservar el símbolo inicial es 0,8 al cuadrado más 0,2 al cuadrado, es decir, 0,68. Podemos llegar al mismo símbolo permaneciendo dos veces o cambiando dos veces. La predicción puntual se debilita con el horizonte, aunque el estado siga siendo suficiente para calcularla exactamente.
227.7. Memoria almacenada e información compartida
La entropía excedente E es la información mutua entre pasado y futuro. En los capítulos anteriores la usamos para estudiar dependencias temporales que atraviesan una frontera.
Los estados predictivos permiten precisar su relación con la memoria. Como S es una función del pasado y conserva su capacidad predictiva, la información mutua entre S y el futuro coincide con E.
Cuando C_mu es finita, obtenemos
La desigualdad expresa que el futuro no puede revelar más información sobre el estado que la incertidumbre total del estado.
En esta formulación direccional, la diferencia se conoce como cripticidad y es la entropía del estado condicionada al futuro completo
El término describe información del estado predictivo que no puede recuperarse completamente observando el futuro; no implica cifrado intencional ni secreto.
En la cadena persistente de primer orden, la información compartida entre pasado y futuro se reduce a la información mutua entre los símbolos situados a ambos lados de la frontera.
El primer símbolo futuro transmite toda la influencia relevante del pasado hacia el resto del futuro, por la propiedad de Markov. Por tanto, E vale uno menos la tasa de entropía.
Obtenemos aproximadamente 0,278072 bits de información compartida, frente a un bit de complejidad estadística. La diferencia es aproximadamente 0,721928 bits.
Aun conociendo todo el futuro, el símbolo inmediatamente anterior sigue siendo incierto, porque la primera transición pudo conservarlo o cambiarlo.
En la alternancia determinista, el futuro revela la fase sin ambigüedad. Allí E y C_mu coinciden en un bit.
En una fuente independiente, ambas son cero; no hay memoria predictiva ni información compartida entre pasado y futuro.
Ellison, Mahoney y Crutchfield desarrollaron relaciones entre representación predictiva, representación retrospectiva y estas cantidades. Su trabajo muestra por qué no debemos usar entropía excedente y complejidad estadística como sinónimos.
Una mide dependencia observable entre regiones temporales; la otra, la información del estado necesario para predecir exactamente. Esa diferencia puede ser científicamente relevante aunque ambas se expresen en bits.
227.8. Exactitud, discontinuidades y predicción aproximada
La definición de estado exige igualdad exacta de distribuciones futuras. Esa condición puede producir cambios bruscos en la complejidad estadística cuando modificamos parámetros de manera continua.
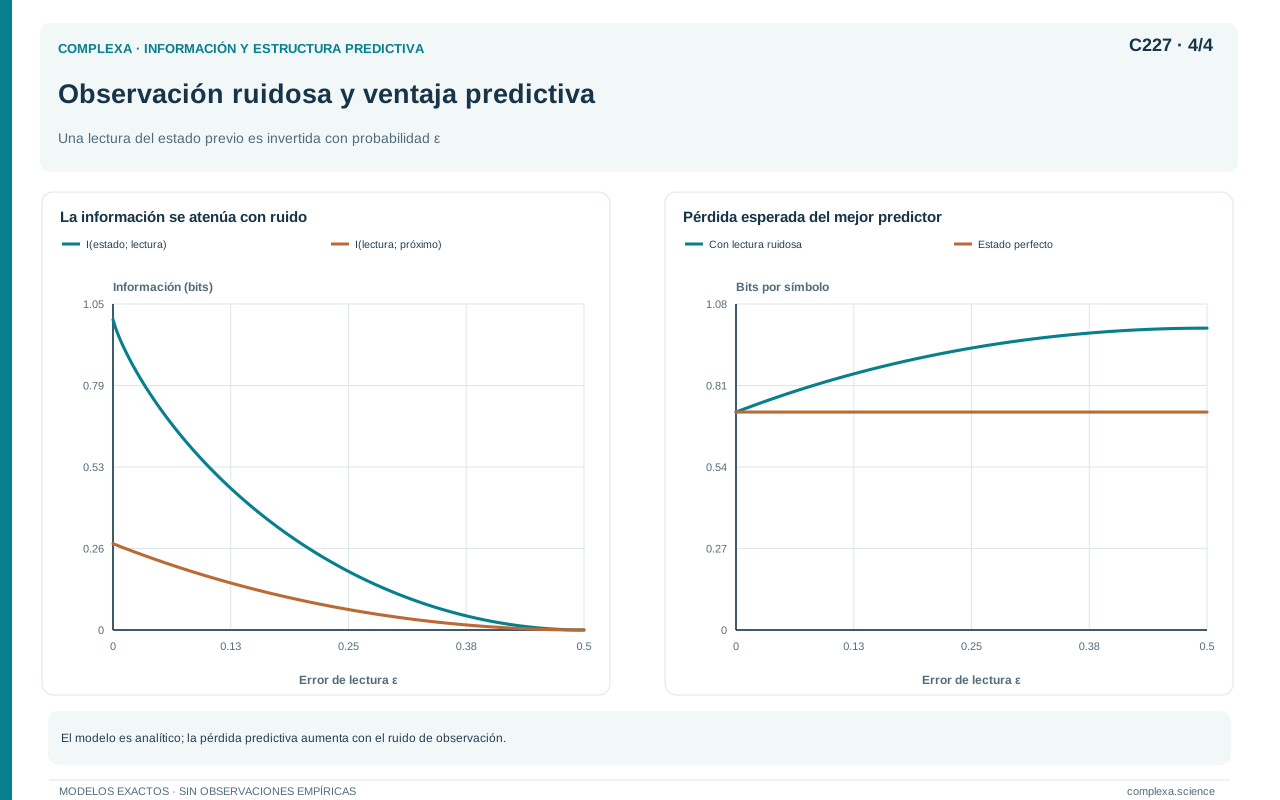
En la cadena simétrica anterior, llamemos p a la probabilidad de conservar el símbolo. Mientras p difiera de un medio y permanezca entre cero y uno, cada valor del último símbolo genera una distribución futura distinta.
La distribución estacionaria sigue siendo uniforme y C_mu vale un bit. En p igual a un medio, las transiciones dejan de depender del último símbolo y los dos estados se fusionan.
La complejidad estadística cae entonces a cero. La tasa de entropía, en cambio, varía de forma continua y alcanza un bit.
La discontinuidad refleja el costo de preservar una diferencia predictiva exacta, por pequeña que sea.
Si p está muy cerca de un medio, recordar el último símbolo mejora poco la predicción. Un predictor aproximado puede decidir que esa mejora no compensa la memoria.
El muestreo temporal produce una situación análoga. Si observamos la cadena persistente solo cada m pasos, la probabilidad de conservar el símbolo observado es la mitad de uno más 0,6 elevado a m. Para todo m finito permanece distinta de un medio, pero se aproxima a él cuando ampliamos el intervalo. La memoria exacta puede seguir siendo un bit mientras la ventaja predictiva disminuye. Los bits por observación, por su parte, no deben convertirse en bits por unidad de tiempo sin ajustar el intervalo.
Para formalizar esa decisión necesitamos una función de pérdida. La pérdida logarítmica mide discrepancias probabilísticas de una manera distinta al error de clasificación o al error cuadrático de otra variable.
También debemos especificar el horizonte. Dos estados pueden ser casi equivalentes para el siguiente símbolo y divergir en eventos que aparecen después.
Por ejemplo, una distribución futura puede concentrarse en los pares 00 y 11 con probabilidades iguales; otra, en 01 y 10. Ambas asignan probabilidades iguales al primer símbolo.
Sin embargo, predicen relaciones opuestas entre el primero y el segundo. Fusionarlas basándose solo en la próxima observación perdería una distinción evidente para el horizonte dos.
La predicción aproximada puede construir representaciones más pequeñas que los estados exactos, pero su minimalidad pertenece a otra tarea y depende de la tolerancia elegida.
En datos finitos tampoco podemos establecer igualdad exacta de distribuciones simplemente porque una prueba no detecte diferencias. La ausencia de evidencia puede deberse a una muestra pequeña.
Un procedimiento de inferencia debe equilibrar divisiones espurias y fusiones excesivas. La definición ideal fija el objetivo, mientras que el diseño estadístico determina qué podemos reconocer con los datos disponibles.
Esta separación evita interpretar cada cambio en el número estimado de estados como una transformación real y abrupta del sistema observado.
227.9. Del proceso conocido al registro observado
En los ejemplos anteriores conocíamos la ley generadora. Podíamos identificar estados, calcular su distribución estacionaria y evaluar entropías sin estimar probabilidades a partir de una muestra.
En un registro real debemos inferir esas propiedades. Las historias largas aparecen pocas veces y distintas distribuciones futuras pueden parecer iguales por falta de observaciones.
La longitud de historia considerada limita qué memoria podemos detectar. Un proceso puede exigir recordar una característica que no cabe en un sufijo corto.
También importa la longitud de futuro usada para comparar predicciones. Una equivalencia aparente a un paso puede desaparecer al examinar bloques más largos.
El crecimiento de posibilidades es rápido. Con un alfabeto binario hay dos elevado a L palabras de longitud L, aunque el proceso real pueda excluir muchas.
Por eso aumentar el horizonte sin aumentar datos puede empeorar las estimaciones. El intento de capturar más estructura debe acompañarse de control estadístico.
La no estacionariedad introduce otra dificultad. Si la ley cambia durante el registro, un algoritmo puede interpretar diferencias entre épocas como estados persistentes de una única dinámica estacionaria.
Puede ser apropiado modelar explícitamente regímenes, segmentar o formular una tarea dependiente del tiempo. La elección necesita evidencia y no debe ocultarse dentro de una estimación única.
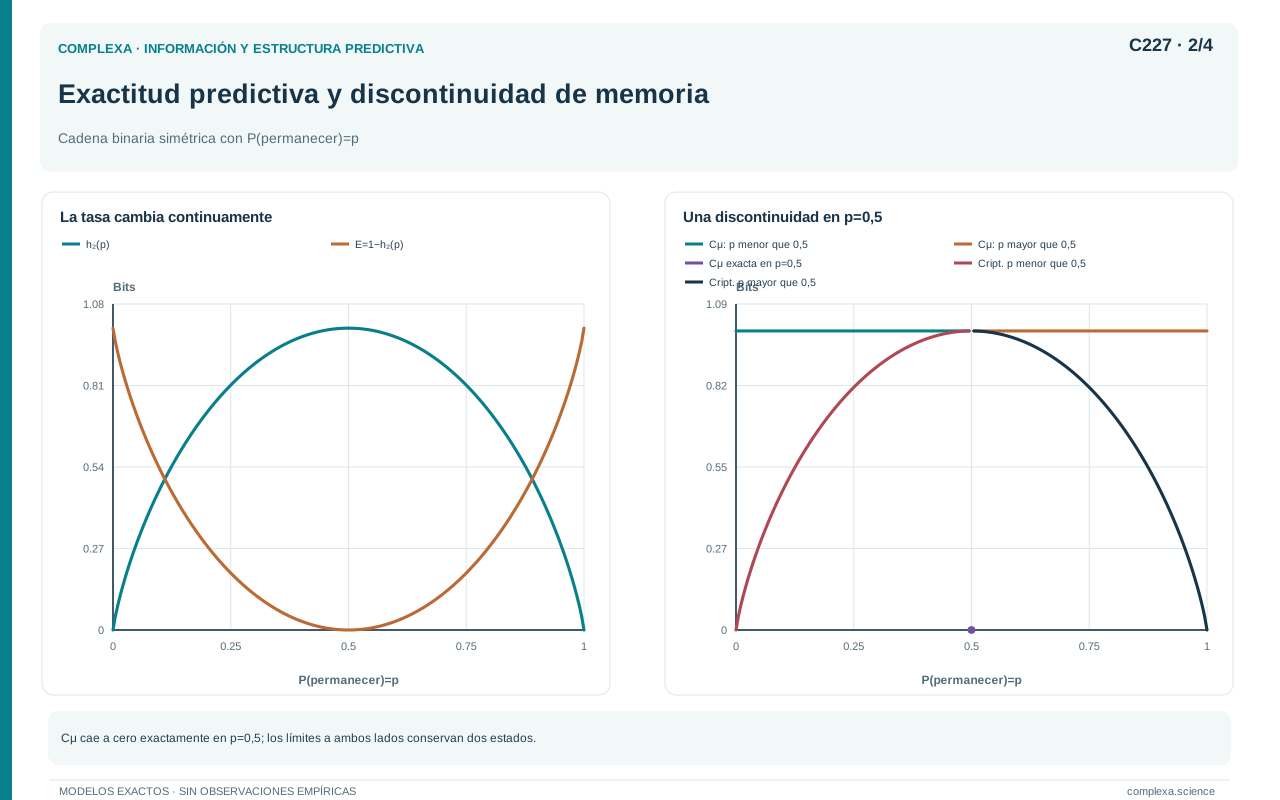
El ruido de observación puede crear memoria aparente. Una variable latente sencilla observada con errores puede requerir mantener una distribución de creencias sobre su estado.
Esa distribución puede tomar muchos valores aunque el mecanismo oculto tenga pocas etiquetas. La memoria predictiva de las observaciones no equivale necesariamente al número de estados físicos internos.
La discretización modifica la serie y sus estados. Agrupar valores puede borrar diferencias relevantes o generar dependencias de orden superior al ocultar información.
Una estimación útil debe evaluar predicciones en datos reservados, sensibilidad a horizontes y estabilidad de las conclusiones. El ajuste perfecto de la muestra no demuestra haber encontrado la estructura mínima del proceso.
Los próximos capítulos desarrollarán representaciones y procedimientos de inferencia. Por ahora, lo esencial es distinguir entre una propiedad ideal de una ley estocástica y una reconstrucción incierta obtenida de datos finitos.
227.10. Qué dimensión de organización hemos medido
La complejidad estadística cuantifica memoria predictiva en una clase bien definida de representaciones. Agrupa historias equivalentes y mide la entropía de los estados que permanecen.
No es la tasa de entropía, porque recordar y generar novedad son operaciones distintas. Tampoco es entropía excedente, porque parte de la información del estado puede no recuperarse del futuro.
Los ejemplos permiten comparaciones exactas. La moneda independiente equilibrada tiene máxima novedad binaria y memoria nula. La alternancia tiene novedad nula y memoria de fase de un bit.
La cadena persistente combina un bit de memoria con aproximadamente 0,722 bits de novedad por símbolo. Una moneda independiente sesgada comparte esa tasa de novedad y carece de la memoria correspondiente.
La medida depende del proceso observado, de su distribución y de la tarea de predicción exacta. Atribuir organización funcional, capacidad adaptativa o complejidad causal a un sistema físico completo exige información adicional.
Lo mismo vale para el término estado causal. Identificar una equivalencia predictiva no reemplaza un análisis de intervenciones ni elimina variables ocultas.
La minimalidad también tiene un alcance limitado a los resúmenes del pasado que conservan la distribución futura. Otros objetivos, como generar muestras o tolerar errores, pueden admitir representaciones diferentes.
En aplicaciones debemos informar cómo se estimaron estados y probabilidades, qué horizontes se usaron y qué incertidumbre permanece. Una cifra sin esa información resulta difícil de interpretar.
La principal ganancia conceptual es distinguir información nueva de información que debe conservarse. Esa separación permite describir procesos cuya organización no se reconoce mediante una única medida de irregularidad.
El capítulo siguiente representará estos estados y sus transiciones como máquinas épsilon. La estructura gráfica permitirá ver cómo la memoria se actualiza al recibir cada símbolo y cómo produce distribuciones de secuencias.
Así podremos pasar de una cantidad global a un modelo explícito de la organización predictiva, con reglas y probabilidades verificables.
Referencias
- Crutchfield, J. P., y Young, K. (1989). Inferring Statistical Complexity. Physical Review Letters, 63(2), 105–108. DOI: 10.1103/PhysRevLett.63.105.
- Shalizi, C. R., y Crutchfield, J. P. (2001). Computational Mechanics: Pattern and Prediction, Structure and Simplicity. Journal of Statistical Physics, 104, 817–879. DOI: 10.1023/A:1010388907793.
- Ellison, C. J., Mahoney, J. R., y Crutchfield, J. P. (2009). Prediction, Retrodiction, and the Amount of Information Stored in the Present. Journal of Statistical Physics, 136, 1005–1034. DOI: 10.1007/s10955-009-9808-z.
- Crutchfield, J. P., Ellison, C. J., y Mahoney, J. R. (2009). Time’s Barbed Arrow: Irreversibility, Crypticity, and Stored Information. Physical Review Letters, 103, 094101. DOI: 10.1103/PhysRevLett.103.094101.