Dos modelos pueden describir los mismos datos y discrepar sobre lo que ocurriría al intervenir. También pueden ordenar de igual manera a las personas según su riesgo y asignarles probabilidades muy distintas. La expresión «mejor modelo» resulta incompleta hasta especificar qué tarea debe resolver, en qué población y con qué información. Una comparación útil empieza por esa decisión, porque los criterios de éxito de una predicción, una explicación causal y una descripción no son intercambiables.
En un servicio de salud mental, anticipar demanda para el mes siguiente requiere información disponible antes de ese mes y una medida de error relacionada con la planificación. Estimar el efecto de modificar la organización exige definir la intervención y justificar cómo se compara con su alternativa. Describir las trayectorias registradas puede requerir una representación compacta de patrones, aunque no permita anticipar otros periodos ni identificar efectos. Los tres objetivos pueden compartir una base de datos y utilizar técnicas similares, pero sostienen afirmaciones diferentes.
Shmueli (2010) desarrolla esta distinción entre explicación, predicción y descripción. Un buen predictor puede utilizar señales que acompañan al desenlace sin representar sus causas. Un modelo causal puede necesitar variables que apenas mejoran la predicción, pero que permiten controlar un mecanismo de confusión. El ajuste dentro de la muestra tampoco acredita por sí mismo ninguna de esas interpretaciones. Antes de comparar algoritmos conviene establecer qué resultado se quiere obtener y qué evidencia permitiría considerar que el modelo lo obtiene adecuadamente.
La comparación tiene además un alcance relativo. Elegir el mejor entre varios candidatos no demuestra que alguno satisfaga los requisitos de la tarea. Si todos utilizan una medición sesgada, pueden coincidir con gran precisión sobre el mismo objeto equivocado. Si todos excluyen un mecanismo relevante, sus diferencias internas pueden ser pequeñas mientras el error compartido es grande. La incertidumbre sobre cuál candidato elegir y la incertidumbre sobre la familia de candidatos son problemas relacionados, pero distintos.
Una construcción causal muestra por qué la finalidad cambia la comparación. Supongamos dos variables binarias medidas sin información temporal que permita ordenar sus causas. En un primer mecanismo, es una moneda equilibrada y copia su valor con probabilidad , invirtiéndolo en el resto. En un segundo mecanismo, es la moneda equilibrada y copia su valor con la misma probabilidad. Las monedas que determinan la inversión son independientes de la variable inicial en cada mecanismo.
Ambos generan la misma distribución conjunta: las combinaciones iguales tienen probabilidad cada una y las distintas, cada una. Por ello, sus predicciones observacionales de a partir de coinciden exactamente. En cambio, imponer frente a cambia el riesgo de desde hasta en el primer mecanismo. En el segundo, intervenir en no modifica la moneda que genera , cuyo riesgo permanece en un medio. La diferencia causal es de sesenta puntos porcentuales en un mundo y cero en el otro.
Ninguna comparación basada únicamente en la distribución observada puede distinguir esos mundos. El ejemplo no afirma que siempre sean plausibles las dos direcciones causales: conocer el orden temporal o el mecanismo de asignación puede excluir una de ellas. Muestra qué información falta en un criterio de ajuste. Introducir una restricción causal defendible cambia el conjunto de modelos admisibles; mejorar la predicción sobre la misma distribución no proporciona por sí solo esa restricción.
Ordenar correctamente y estimar probabilidades
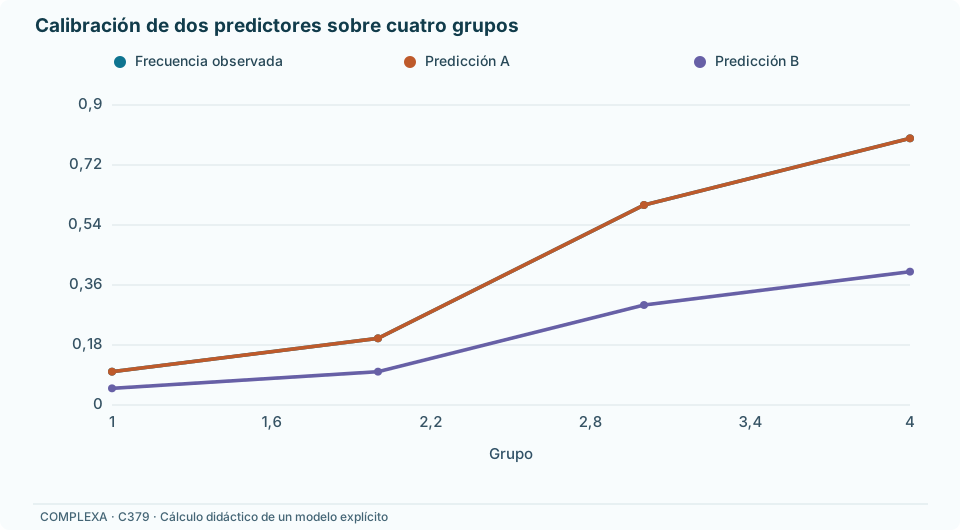
Consideremos ochenta registros construidos, distribuidos en cuatro grupos de veinte. En ellos se observan, respectivamente, dos, cuatro, doce y dieciséis desenlaces binarios. Estos números no proceden de un estudio clínico. Definimos dos modelos cuyas predicciones ya están fijadas antes de compararlas. El modelo A asigna a cada grupo su proporción observada de desenlaces; el modelo B asigna la mitad de esa probabilidad. La coincidencia del modelo A con las frecuencias forma parte de la construcción y no se presenta como un hallazgo de validación empírica.
| Grupo | Registros | Desenlaces | Predicción A | Predicción B |
|---|---|---|---|---|
| Primero | 20 | 2 | 0,10 | 0,05 |
| Segundo | 20 | 4 | 0,20 | 0,10 |
| Tercero | 20 | 12 | 0,60 | 0,30 |
| Cuarto | 20 | 16 | 0,80 | 0,40 |
Ambos modelos ordenan los grupos de la misma manera. Dentro de cada grupo asignan un empate a todas las personas. Por tanto, tienen la misma área bajo la curva ROC, o AUC, que resume la probabilidad de que un caso con desenlace reciba una puntuación mayor que otro sin desenlace, contando los empates como media concordancia. En esta tabla, el valor común es , aproximadamente . La transformación que divide las predicciones por dos conserva todos los órdenes y empates.
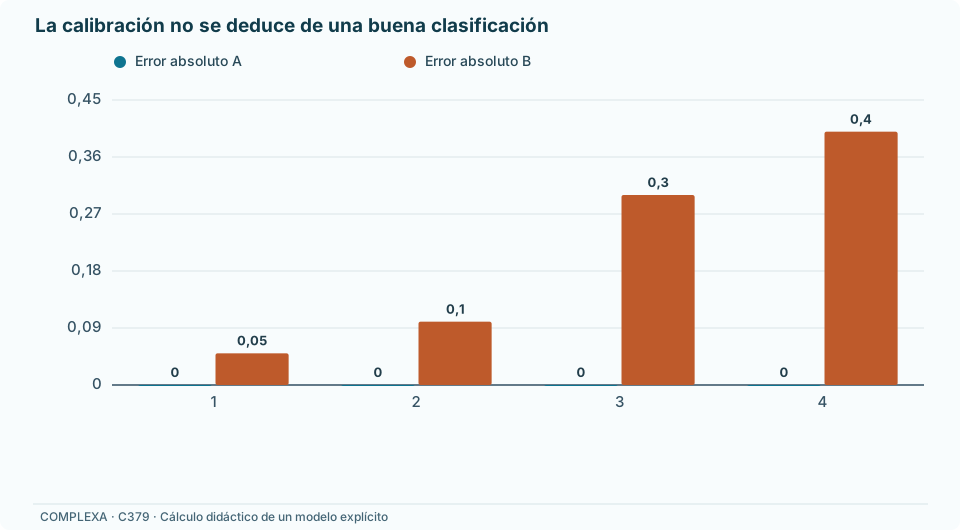
Sin embargo, los valores de las probabilidades difieren de manera sustantiva. Entre quienes reciben una predicción de cuarenta por ciento con B, el desenlace aparece en ochenta por ciento. B subestima sistemáticamente las frecuencias de esta tabla. A presenta concordancia exacta entre probabilidades y frecuencias en los cuatro grupos. Esta propiedad es una forma de calibración. Steyerberg y colaboradores (2010) explican por qué la discriminación, la calibración y el rendimiento probabilístico global deben distinguirse al evaluar un modelo.
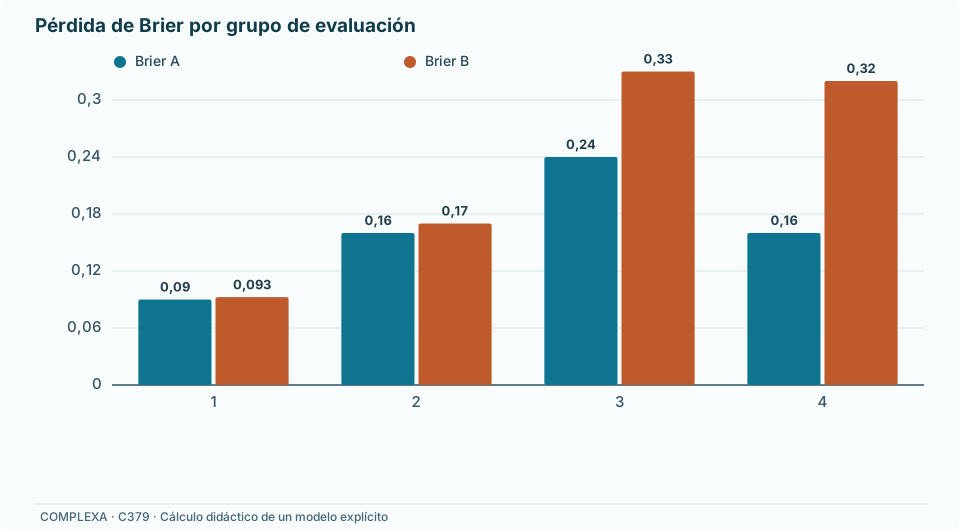
La puntuación de Brier resume el error cuadrático de las probabilidades:
donde es el desenlace binario y la probabilidad predicha para el registro correspondiente. Los valores menores indican mejor rendimiento bajo esta pérdida. Aplicada a la tabla, la puntuación de A es y la de B es . La igualdad de AUC no impide que el error probabilístico sea considerablemente distinto.
El cálculo puede entenderse dentro de cada grupo. Si la frecuencia del desenlace es y se predice una probabilidad constante , el error cuadrático medio es . El primer término permanece incluso cuando la predicción coincide con la frecuencia: una probabilidad correcta no anticipa con certeza cada resultado individual. El segundo penaliza el desacuerdo entre probabilidad y frecuencia. En nuestra tabla, A elimina ese segundo término en todos los grupos, mientras que B lo conserva.
La distinción afecta al uso del modelo. Si solo se dispone de recursos para revisar un número fijo de registros y se ordenan por puntuación, ambos modelos producen la misma selección. Si se actúa al superar una probabilidad concreta, pueden producir selecciones distintas. No se puede decidir cuál umbral es adecuado a partir de la AUC: hacen falta las consecuencias de actuar y de no actuar, además de probabilidades suficientemente interpretables para esa decisión. Un índice global no sustituye la definición de utilidad.
Tampoco basta la calibración promedio. A predice en conjunto treinta y cuatro desenlaces y B predice diecisiete, frente a los treinta y cuatro de la tabla. Corregir únicamente el promedio de B podría resolver esa discrepancia sin garantizar coincidencia dentro de cada subgrupo. Un modelo puede compensar sobreestimaciones en unas personas con subestimaciones en otras. Por eso la evaluación debe examinar las regiones de probabilidad y los grupos relevantes para la tarea, manteniendo presente la incertidumbre que producen sus tamaños.
En un conjunto real de ochenta observaciones, las frecuencias de grupos de veinte tendrían variación estadística. Una línea de calibración aparentemente perfecta o imperfecta podría cambiar al recoger nuevos datos. Aquí las cuentas exactas sirven para distinguir propiedades matemáticas de las medidas. No justifican afirmar que cuatro grupos bastan para establecer calibración en una población externa. El objetivo de evaluación y el alcance de los datos deben acompañar al resultado numérico.
Una comparación justa mantiene constante también el desenlace que se predice. Un algoritmo que recibe información recogida al final del seguimiento puede superar a otro que solo usa antecedentes basales, pero esa ventaja no sirve para una decisión tomada al inicio. Del mismo modo, predecir un desenlace a un mes y predecirlo a un año son tareas diferentes. Antes de atribuir una mejora a la arquitectura del modelo, conviene comprobar la fecha de disponibilidad de cada variable y el horizonte de todas las predicciones. Esa revisión puede revelar una diferencia de información en lugar de una diferencia de capacidad algorítmica.
La evaluación también puede sobreajustarse
Separar datos para evaluar un modelo reduce el optimismo de medirlo donde fue ajustado, pero la separación deja de proteger la evaluación si esos datos se usan repetidamente para elegir la versión final. Cawley y Talbot (2010) muestran que la selección puede sobreajustar un criterio estimado con datos finitos. La competencia entre modelos aprovecha diferencias reales de rendimiento y fluctuaciones favorables del criterio. Informar solamente el valor del ganador mezcla ambas contribuciones.
Un ejemplo extremo permite comprobar el mecanismo. Hay tres categorías de una variable predictora y el desenlace es una moneda equilibrada, independiente de la categoría. Definimos ocho candidatos: todas las funciones que asignan cero o uno a cada una de las tres categorías. Evaluamos cada candidato con un registro de cada categoría y elegimos el que coincide con las tres etiquetas observadas. Siempre existe exactamente uno que logra cero errores, porque la colección contiene todas las combinaciones posibles.
Ahora obtenemos tres etiquetas nuevas, una por categoría, con monedas independientes. Condicionado en cualquier conjunto de etiquetas anteriores, el modelo elegido conserva una probabilidad de error de un medio en cada observación nueva. Su error promedio esperado también es un medio. Enumerar las ocho configuraciones iniciales y las ocho posteriores confirma el resultado. El error aparente de selección es cero en todas las configuraciones, aunque la variable predictora no aporte información sobre el desenlace.
La tabla usada para escoger el candidato ha pasado a formar parte del ajuste. Llamarla «conjunto de prueba» no modifica ese hecho. El mismo problema puede aparecer de forma menos evidente al ensayar transformaciones, ajustar hiperparámetros, cambiar exclusiones o repetir particiones hasta obtener una cifra favorable. La unidad que debe evaluarse es el procedimiento completo que termina produciendo el modelo, incluida su selección, y no únicamente el candidato final aislado de ese proceso.
Una validación anidada separa esas funciones. Dentro de cada conjunto de entrenamiento se toman las decisiones de ajuste y selección; un conjunto exterior, que no interviene en ellas, evalúa el resultado. Esto exige volver a realizar la selección en cada repetición exterior. Elegir variables una sola vez con toda la base y después validar la regresión conserva una vía por la que la información de evaluación entra en el modelo. Las operaciones de imputación y transformación que aprenden de los datos necesitan la misma atención.
La partición debe corresponder además al uso previsto. Si una persona tiene varias observaciones, separar filas al azar puede dejar información suya tanto en entrenamiento como en evaluación. Esa prueba se parece a predecir otra medición de una persona conocida, no necesariamente a predecir una persona nueva. Si el destino es otro centro, reservar centros completos plantea una tarea diferente de reservar individuos dentro de los mismos centros. En predicción temporal, utilizar datos posteriores para evaluar retrospectivamente un modelo entrenado con información futura responde a otra pregunta que anticipar el futuro desde el presente.
Vehtari, Gelman y Gabry (2017a) explican la evaluación predictiva mediante validación dejando una unidad fuera y mediante WAIC en modelos bayesianos. La elección de la unidad de predicción afecta a la comparación: una observación, una persona completa o un grupo no representan necesariamente el mismo objetivo. Los criterios estiman rendimiento predictivo bajo condiciones específicas; no convierten automáticamente un modelo que predice mejor en una explicación causal preferible.
En PSIS-LOO, el parámetro de cola permite detectar observaciones cuya exclusión cambia mucho la distribución posterior. Vehtari y colaboradores (2024) precisan que el umbral diagnóstico depende también del número de simulaciones posteriores utilizadas: una referencia para considerar fiable la aproximación es . Si las simulaciones están muy autocorrelacionadas, utilizar su número nominal puede hacer optimista la evaluación. Un diagnóstico desfavorable aconseja examinar la observación influyente y, según el caso, reajustar el modelo sin ella o recurrir a validación cruzada por grupos. El valor de informa sobre la calidad de la aproximación por importancia; no mide por sí solo el rendimiento predictivo ni la validez causal del modelo.
WAIC presenta otra dificultad. Vehtari, Gelman y Gabry (2017a) observaron problemas en sus ejemplos cuando la varianza posterior de la contribución individual a la log-verosimilitud superaba aproximadamente . Es una advertencia empírica sobre la aproximación, no un umbral matemático de validez universal. Antes de comparar valores agregados de LOO o WAIC conviene revisar los diagnósticos por unidad y definir si la predicción futura se refiere a mediciones, personas o grupos completos.
Cuando los dos candidatos se evalúan sobre las mismas unidades, la diferencia de sus pérdidas es una comparación emparejada. Una persona difícil puede generar errores grandes para ambos, de modo que tratar sus resultados como si procedieran de muestras distintas pierde información sobre esa dependencia. Conviene estudiar la distribución de las diferencias por unidad, respetando también agrupaciones y tiempo cuando corresponda. Una ventaja pequeña frente a su incertidumbre puede no justificar una decisión tajante entre candidatos, especialmente si otras diferencias prácticas son relevantes.
La validación externa puede examinar dos cambios que conviene separar. En el nuevo contexto puede variar la composición de las personas, aun conservándose la relación condicional entre predictores y desenlace. También puede cambiar esa relación, por ejemplo porque se modificaron los procedimientos de atención o de registro. El rendimiento agregado puede deteriorarse en ambos casos, pero las respuestas serían diferentes. Reponderar una evaluación para representar otra composición no corrige automáticamente un cambio de mecanismo. Investigar dónde aparecen los errores ayuda a distinguir qué parte del resultado puede trasladarse.
Qué incertidumbre está representada
La incertidumbre muestral describe lo que variaría al observar otras unidades bajo un esquema de muestreo. Incluso con una relación correctamente especificada, una muestra limitada produce estimaciones variables. Un intervalo calculado bajo ese esquema puede representar esa fuente de variación. Su interpretación depende de cómo se seleccionaron las unidades, de su dependencia y del procedimiento que se repite. No representa por defecto todas las razones por las que una conclusión podría ser incorrecta.
La incertidumbre de parámetros suele presentarse condicionada en un modelo. Un análisis puede estimar con precisión la pendiente de una relación lineal asumida, mientras existe incertidumbre considerable sobre si esa forma lineal es adecuada. Si la pendiente cambia cuando se permiten umbrales o interacciones, el intervalo del modelo inicial no incorpora necesariamente esa variación. La incertidumbre entre modelos requiere examinar qué alternativas son defendibles y cómo cambia el objeto de interés al utilizarlas.
El procedimiento de remuestreo debe corresponder a lo que se pretende repetir. Si se generan nuevas muestras de la base y se vuelve a ajustar siempre la especificación que ganó en el análisis original, se estudia variación dentro de esa especificación. No se está representando la posibilidad de que otra muestra conduzca a seleccionar un modelo distinto. Para investigar esa posibilidad habría que repetir también la selección, respetando la unidad de muestreo y las demás decisiones del procedimiento. Esa repetición puede mostrar inestabilidad que el intervalo del modelo final oculta.
Repetir la selección no garantiza por sí solo que un intervalo tenga la cobertura deseada: la justificación depende del estimador, de sus condiciones y de cómo se construye el intervalo. El punto operativo consiste en identificar qué proceso se reproduce antes de nombrar su incertidumbre. Si los modelos seleccionados cambian mucho entre muestras, conviene examinar si sus predicciones también cambian o si varias especificaciones representan prácticamente el mismo patrón. La inestabilidad de nombres o coeficientes y la inestabilidad de la decisión final pueden tener consecuencias diferentes.
La medición añade otro nivel. Supongamos que varios modelos predicen un indicador administrativo de dificultad asistencial. Si ese indicador aparece con mayor frecuencia en personas que mantienen más contactos con el servicio, el proceso de observación participa en el resultado registrado. Una mejor predicción del indicador puede deberse a una mejor predicción de contactos, sin una mejora equivalente para la dificultad que se quería estudiar. Ajustar muchos modelos a la misma etiqueta no resuelve esa discrepancia entre constructo y medición.
La información necesaria para reducir cada incertidumbre es diferente. Más observaciones del mismo registro pueden estabilizar parámetros, pero conservar una definición inadecuada del desenlace. Una submuestra con medición independiente puede informar sobre esa definición, aunque sea pequeña. Una evaluación en otro centro puede mostrar cambios de calibración relacionados con la organización. Una intervención aleatorizada puede responder una pregunta causal que la validación predictiva deja abierta. Identificar la fuente dominante ayuda a elegir qué evidencia adicional vale la pena recoger.
Existe también incertidumbre computacional. Un estimador aproximado puede cambiar porque la optimización no alcanzó una solución estable o porque una simulación utiliza un número limitado de iteraciones. Aumentar ese número puede reducir el error de aproximación sin añadir información sobre el proceso estudiado. Vehtari y colaboradores distinguen la variación de las evaluaciones predictivas entre datos de la variación Monte Carlo de su cálculo. Confundirlas lleva a presentar más tiempo de cómputo como si aumentara el tamaño de la evidencia empírica.
Estos componentes pueden relacionarse. Un error de medición puede inducir una forma aparente que favorece cierto modelo; seleccionar ese modelo puede producir después un intervalo condicional estrecho. No siempre es posible asignar a cada componente una varianza independiente y sumarlas. Hacerlo exige un modelo que describa sus relaciones. Cuando ese modelo no existe, resulta más transparente presentar escenarios separados y explicar qué supuestos varían en cada uno.
Seleccionar un modelo y promediar modelos
Elegir un candidato concentra la inferencia en una representación. Promediar conserva contribuciones de varios candidatos, pero necesita definir qué se combina y con qué pesos. Promediar predicciones individuales, distribuciones predictivas o coeficientes de regresión son operaciones diferentes. Los coeficientes pueden incluso representar cantidades distintas si cambian las variables ajustadas o las escalas. Antes de combinarlos debe existir un objeto común cuya interpretación se conserve entre modelos.
Hoeting y colaboradores (1999), en la versión corregida de su tutorial, describen el promedio bayesiano de modelos como una mezcla de distribuciones posteriores ponderadas por probabilidades posteriores de modelo. Esas probabilidades dependen de las verosimilitudes, de las distribuciones previas y de la familia de candidatos. Un peso derivado de desempeño predictivo mediante otro procedimiento no adquiere automáticamente esa interpretación. Dos conjuntos de números que suman uno pueden tener justificaciones estadísticas diferentes.
Consideremos una construcción numérica sobre una cantidad común , expresada en unidades abstractas. Bajo el primer modelo, su distribución de incertidumbre tiene media dos y varianza uno. Bajo el segundo, media seis y varianza uno. Para ilustrar una mezcla, fijamos pesos de tres cuartos y un cuarto. Son supuestos del ejemplo; no los hemos estimado a partir de datos ni los hemos deducido de las puntuaciones de la tabla anterior.
La media de la mezcla es . Su varianza se obtiene conservando la variación dentro de los modelos y la separación entre sus medias:
El primer término vale uno. El segundo es . La varianza total vale cuatro y la desviación estándar vale dos. Si se eligiera el modelo con mayor peso y se informara únicamente su distribución condicional, se comunicarían media dos y desviación estándar uno. La diferencia refleja la incertidumbre entre las representaciones que la selección ha descartado.
No basta con promediar las dos varianzas condicionales, porque ese cálculo omitiría la separación entre las medias. Tampoco procede dividir la varianza entre el número de modelos como si cada modelo aportara una observación independiente de la misma cantidad. La mezcla describe alternativas sobre la distribución de un objeto; no es el promedio de dos mediciones independientes. Esta distinción evita confundir un procedimiento para conservar incertidumbre con otro que parece reducirla por acumulación de candidatos.
La media y la varianza tampoco definen necesariamente toda la distribución resultante. Si las distribuciones condicionales fueran normales con esas medias y varianzas, su mezcla tendría componentes separados; no sería una normal por el mero hecho de conocer sus dos primeros momentos. Construir automáticamente un intervalo con la media y un múltiplo de la desviación estándar puede ocultar esa forma. Si interesa una probabilidad o un intervalo de la mezcla, debe calcularse con la distribución combinada pertinente.
El promedio conserva sus límites. Si ambos modelos excluyen el mismo mecanismo, combinarlos no añade ese mecanismo. Si los pesos son sensibles a una elección previa, esa sensibilidad afecta al resultado. Si los modelos corresponden a intervenciones distintas, combinarlos puede borrar la pregunta original. La versión corregida de Hoeting y colaboradores deja explícito que las probabilidades se condicionan en el conjunto de modelos considerado. Examinar ese conjunto sigue siendo una decisión científica, aunque el cálculo de la mezcla esté bien definido.
La forma de enumerar los candidatos también merece atención. Si una familia conceptual se representa mediante numerosas variantes casi equivalentes y otra mediante un solo candidato, asignar el mismo peso previo a cada archivo no equivale a dar el mismo peso a las dos familias. Se ha introducido una preferencia mediante la representación del espacio de modelos. Esa decisión puede ser defendible, pero necesita explicarse. Duplicar una especificación no aporta datos nuevos ni debería confundirse con una razón empírica para confiar más en la familia que contiene esa copia.
Cuatro resultados pueden contener casi la misma información
La dependencia entre resultados tiene una consecuencia cuantitativa sencilla. Supongamos cuatro estimadores de una misma cantidad, cada uno con varianza uno. Si fueran independientes y se promediaran con pesos iguales, la varianza del promedio sería un cuarto. Su desviación estándar sería un medio. Esta reducción depende de que los errores de los cuatro estimadores no se muevan juntos.
Supongamos ahora que la correlación entre cada par de errores es . La matriz de covarianza tiene unos en la diagonal y fuera de ella. La varianza de la media es
La desviación estándar es aproximadamente , mucho mayor que el medio que resultaría al ignorar la correlación. Si los cuatro estimadores fueran copias exactas, la correlación sería uno y el promedio conservaría varianza uno. Cambiar el nombre del análisis o publicarlo en cuatro lugares no produciría nuevas realizaciones independientes del error.
El ejemplo se refiere a incertidumbre de muestreo bajo una estructura de covarianza especificada. Un sesgo compartido constituye otro problema. Si los cuatro estimadores incorporan un desplazamiento sistemático debido a la misma medición, promediarlos conserva ese desplazamiento aunque sus errores aleatorios sean independientes. Por tanto, muestras distintas pueden compartir una amenaza, y resultados obtenidos en una misma muestra pueden diferir en algunos supuestos de identificación. La dependencia estadística y la diversidad de sesgos deben examinarse por separado.
En revisiones de evidencia, esa separación exige reconstruir la procedencia. Dos artículos pueden usar participantes solapados, diferentes oleadas de una cohorte o la misma base administrativa enlazada. Dos equipos pueden aplicar algoritmos distintos y conservar las mismas exclusiones, etiquetas y variables omitidas. El número de publicaciones o modelos no informa directamente del número de fuentes independientes. Para interpretar una coincidencia hay que saber qué datos y decisiones comparten.
La comparación emparejada de predicciones y la síntesis de estimadores tampoco usan la covarianza con el mismo objetivo. En la primera interesa la incertidumbre de una diferencia entre modelos evaluados sobre las mismas personas. En la segunda puede interesar la incertidumbre de un promedio de estimaciones. Una correlación positiva puede reducir la variación de una diferencia y aumentar la de un promedio respecto de un cálculo que la ignore. El signo y la función de la dependencia se interpretan en relación con la operación concreta.
Con dos estimadores del ejemplo, la varianza de su diferencia sería . La dependencia permite que se comparen con mayor precisión porque parte de sus fluctuaciones se cancela al restarlos. En cambio, las fluctuaciones comunes persisten cuando se promedian. La misma covarianza que ayuda a distinguir dos procedimientos evaluados sobre datos compartidos limita cuánto se gana al presentarlos como estimaciones acumuladas de una cantidad. Separar ambas operaciones evita interpretar cualquier dependencia como un defecto uniforme.
Triangular mecanismos de error
Lawlor, Tilling y Davey Smith (2016) definen la triangulación causal mediante la integración de enfoques con fuentes principales de sesgo diferentes y suficientemente no relacionadas. La tarea consiste en hacer explícitas esas amenazas y, cuando sea posible, anticipar su dirección. Si mecanismos distintos, que tenderían a producir distorsiones diferentes, conducen a conclusiones compatibles sobre una pregunta común, la coincidencia resulta más informativa que repetir una comparación sometida al mismo problema.
La etiqueta de un diseño no garantiza esa diversidad. Dos estudios observacionales pueden diferir mucho en el patrón de confusión si la asignación de la exposición ocurre por razones distintas en sus contextos. Un experimento y una observación pueden compartir un error de medición del desenlace. Una comparación entre familiares puede controlar algunas causas comunes del entorno y conservar otras que varían entre ellos. Identificar las rutas de error requiere describir el mecanismo de cada estudio, en lugar de ordenar diseños en una lista abstracta de calidad.
Imaginemos que se quiere estudiar el efecto de una modalidad de coordinación sobre la continuidad posterior. Una comparación ajustada entre usuarios podría quedar confundida por necesidad no registrada. Un cambio de disponibilidad entre centros podría aportar otra comparación, pero estaría amenazado por modificaciones organizativas simultáneas. Una asignación aleatoria de la oferta resolvería parte del problema inicial, aunque conservaría dificultades de cumplimiento y de medición. Estas son posibilidades de diseño, no estudios que se hayan realizado aquí.
Para triangularlas habría que aclarar primero qué intervención representa cada una. Ofrecer coordinación, recibirla y mantenerla no son necesariamente el mismo tratamiento. Un efecto a corto plazo entre quienes aceptan una oferta no coincide automáticamente con un efecto poblacional de una política sostenida. Si los resultados difieren, parte de la diferencia puede deberse al estimando. Convertir todos los contrastes a una misma unidad numérica no elimina diferencias de población, duración o contenido de la intervención.
Una tabla de trabajo puede vincular cada enfoque con su contraste, los datos que utiliza, la amenaza principal y el patrón esperado si esa amenaza dominara. Por ejemplo, si mayor necesidad aumenta tanto la probabilidad de recibir atención como la dificultad posterior, la confusión podría desplazar una comparación cruda hacia un resultado desfavorable. Esa dirección depende de las relaciones supuestas; no debe asignarse por costumbre. El registro de los supuestos permite examinar si otra línea de evidencia está expuesta al mismo mecanismo o a uno diferente.
Munafò y Davey Smith (2018) argumentan que repetir un diseño puede reproducir sus debilidades junto con su resultado. Su propuesta de triangulación es un argumento metodológico, no una garantía de que toda combinación de métodos converja en la verdad. Si varias líneas dependen de la misma etiqueta diagnóstica problemática, un acuerdo puede sobrevivir a cambios de algoritmo, equipo o muestra. Una medición alternativa pertinente puede aportar más diversidad de evidencia que otra repetición del análisis sobre la misma etiqueta.
Triangular no exige que los resultados tengan idéntica magnitud ni que se promedien en un metanálisis. Lawlor y colaboradores subrayan la importancia del momento y la duración de la exposición al comparar enfoques. La síntesis puede consistir en examinar qué mecanismos causales y qué explicaciones de sesgo siguen siendo compatibles con el conjunto. Un promedio numérico prematuro puede ocultar precisamente las diferencias que hacen informativa la comparación.
Tampoco se debe equiparar triangulación con escoger los resultados concordantes. Una discrepancia puede revelar que una medición funciona de otra manera, que cambió la población o que un supuesto de identificación falla. Hace falta conservar los resultados discordantes y evaluar explicaciones específicas. Introducir después una explicación distinta para cada desacuerdo, sin posibilidad de contrastarla, convierte la síntesis en una narración difícil de refutar.
Supongamos que las comparaciones basadas en un indicador administrativo coinciden, mientras una medición externa de continuidad no muestra el mismo patrón. El siguiente análisis útil podría vincular ambos registros para estudiar cuándo divergen sus etiquetas y si esa divergencia depende del uso del servicio. Esa comprobación informa una amenaza compartida que ningún cambio de algoritmo resolvería. Si la discrepancia se concentra en personas con más contactos, revisar el proceso de medición pasaría a ser una condición para interpretar la coincidencia entre los modelos administrativos.
Referencias
Cawley, G. C., y Talbot, N. L. C. (2010). On over-fitting in model selection and subsequent selection bias in performance evaluation. Journal of Machine Learning Research, 11, 2079–2107. https://jmlr.org/papers/v11/cawley10a.html
Hoeting, J. A., Madigan, D., Raftery, A. E., y Volinsky, C. T. (1999). Bayesian model averaging: a tutorial. Statistical Science, 14(4), 382–417. https://doi.org/10.1214/ss/1009212519. Versión corregida consultada: https://sites.stat.washington.edu/www/research/online/hoeting1999.pdf
Hoeting, J. A., Madigan, D., Raftery, A. E., y Volinsky, C. T. (2000). Correction to: “Bayesian model averaging: a tutorial”. Statistical Science, 15(3), 193–195. https://doi.org/10.1214/ss/1009212814
Lawlor, D. A., Tilling, K., y Davey Smith, G. (2016). Triangulation in aetiological epidemiology. International Journal of Epidemiology, 45(6), 1866–1886. https://doi.org/10.1093/ije/dyw314
Munafò, M. R., y Davey Smith, G. (2018). Robust research needs many lines of evidence. Nature, 553, 399–401. https://doi.org/10.1038/d41586-018-01023-3
Shmueli, G. (2010). To explain or to predict? Statistical Science, 25(3), 289–310. https://doi.org/10.1214/10-STS330
Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., y Kattan, M. W. (2010). Assessing the performance of prediction models: a framework for some traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/EDE.0b013e3181c30fb2
Vehtari, A., Gelman, A., y Gabry, J. (2017a). Practical Bayesian model evaluation using leave-one-out cross-validation and WAIC. Statistics and Computing, 27, 1413–1432. https://doi.org/10.1007/s11222-016-9696-4
Vehtari, A., Gelman, A., y Gabry, J. (2017b). Erratum to: Practical Bayesian model evaluation using leave-one-out cross-validation and WAIC. Statistics and Computing, 27, 1433. https://doi.org/10.1007/s11222-016-9709-3
Vehtari, A., Simpson, D., Gelman, A., Yao, Y., y Gabry, J. (2024). Pareto smoothed importance sampling. Journal of Machine Learning Research, 25(72), 1–58. https://www.jmlr.org/papers/v25/19-556.html