Un programa termina sin errores y produce una curva suave. Otro programa, escrito con una biblioteca distinta, produce una curva casi idéntica. Esa coincidencia aporta información sobre los cálculos, pero todavía deja abiertas varias preguntas: si ambos implementan las ecuaciones previstas, cuánto se apartan de su solución exacta y si esas ecuaciones describen el sistema que interesa estudiar. Las respuestas requieren comparaciones diferentes. Una simulación puede ser reproducible y resolver con precisión un modelo cuya relación con las observaciones reales sigue sin comprobarse.
Para separar esas cuestiones realizaremos un experimento computacional sobre una desaparición exponencial. Primero calcularemos una cantidad continua mediante dos métodos numéricos; después simularemos unidades que desaparecen en momentos aleatorios. Ambas versiones admiten referencias analíticas, de modo que se puede medir qué aporta cada ejecución. Los parámetros son construidos y todos los resultados numéricos que se presentan proceden de esos cálculos. No se emplearon datos de un sistema físico, participantes ni registros clínicos, y no se pretende validar empíricamente una ley de desaparición.
La pregunta que recibe el programa
Un experimento computacional necesita especificar qué resultado permitiría responder a la pregunta. Aquí interesa conocer la fracción que permanece después de cuatro minutos y evaluar la precisión con que se calcula. También preguntaremos, en la versión aleatoria, con qué frecuencia permanecen al menos veinte unidades de las cien iniciales. La segunda cantidad no puede obtenerse leyendo únicamente una curva promedio. Fijar ambas preguntas antes de ejecutar ayuda a elegir referencias y resúmenes adecuados.
La verificación de la implementación examina si el programa representa las reglas declaradas. La evaluación del error numérico de una solución estudia la diferencia entre el resultado calculado y la solución matemática buscada. La validación empírica compara las predicciones con observaciones del sistema representado, considerando las condiciones de uso. Oberkampf y Trucano (2002) distinguen esas actividades y señalan que comparar programas o refinar una discretización no sustituye la comparación experimental. Un programa compartido por muchos investigadores puede contener errores compartidos, y una ecuación correctamente resuelta puede omitir un proceso relevante.
Sargent (2013) organiza la evaluación de modelos de simulación distinguiendo la validez conceptual, la verificación del modelo computarizado, la validez operacional y la de los datos. Esta separación permite localizar una discrepancia. Si el archivo de entrada contiene segundos donde el código espera minutos, el problema aparece antes de discutir la adecuación del mecanismo. Si la solución numérica es correcta y el patrón observado difiere sistemáticamente, la pregunta se traslada hacia la representación del sistema o hacia la medición utilizada para contrastarla.
En este ejemplo podemos conservar por separado la ecuación, los valores de entrada, el método de resolución y la referencia analítica. El criterio de comparación será explícito: error absoluto en la fracción final, además de comprobaciones de las trayectorias. En la parte aleatoria se calcularán medias, varianzas y frecuencias de sucesos, junto con su incertidumbre de Monte Carlo. Una conclusión sobre precisión debe indicar a cuál de esas cantidades se refiere; acertar una media no demuestra que se reproduzca una distribución completa.
Una solución conocida como referencia
Sea la fracción restante en el minuto , con valor inicial uno. El modelo continuo propone una pérdida proporcional a la cantidad presente:
La tasa tiene unidades de minutos inversos. Elegimos por minuto, constante durante toda la ejecución. La solución exacta es y, a los cuatro minutos, vale aproximadamente . Esta expresión puede comprobarse derivándola y verificando la condición inicial. Proporciona una referencia independiente de los pasos con los que el programa avance en el tiempo.
El método de Euler explícito utiliza la pendiente al comienzo de cada paso. Si es su duración en minutos y la aproximación en el instante , la actualización resulta:
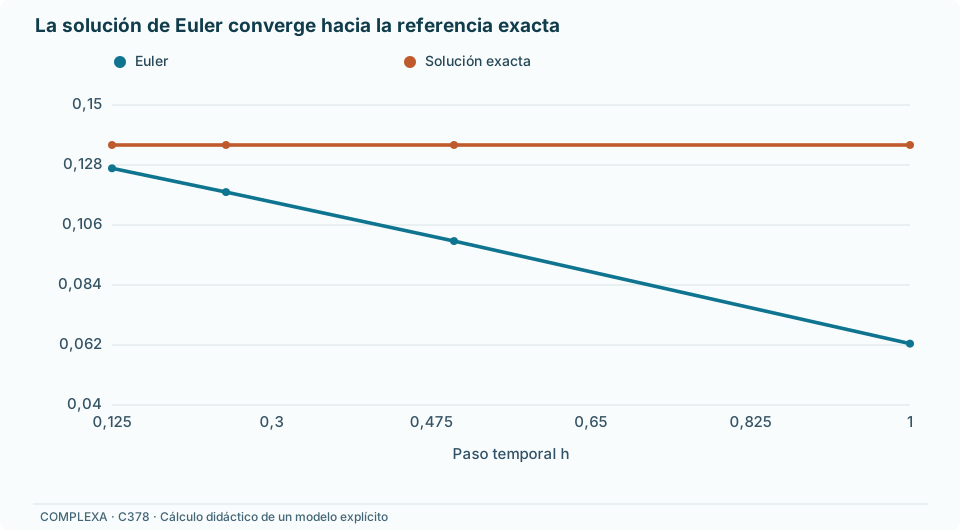
Con pasos de un minuto, cuatro actualizaciones producen . El programa puede implementar perfectamente esa regla y, aun así, entregar una aproximación deficiente a la ecuación continua: el valor queda un por debajo de la solución exacta. En este caso conocemos también la expresión cerrada de la recurrencia, . Su coincidencia con el código comprueba la implementación de Euler; la diferencia respecto a la exponencial mide otro error, introducido por la discretización.
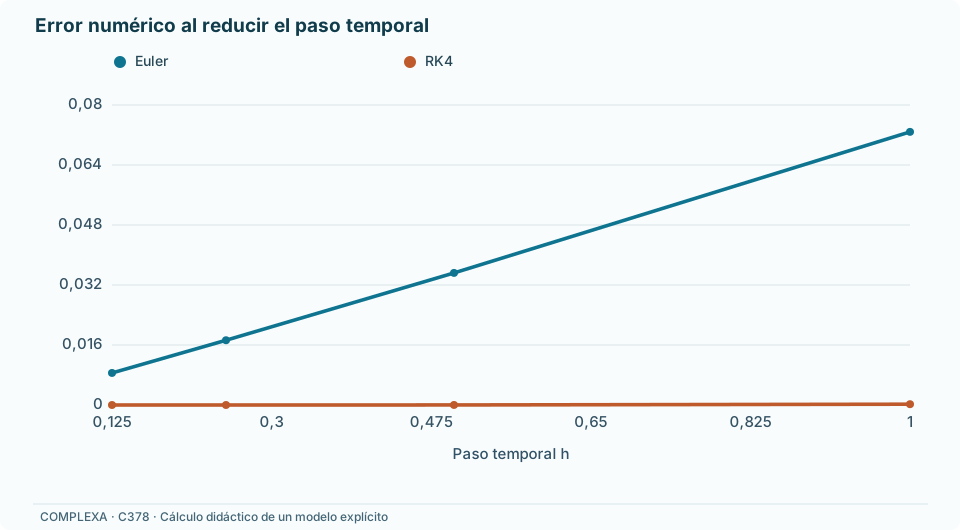
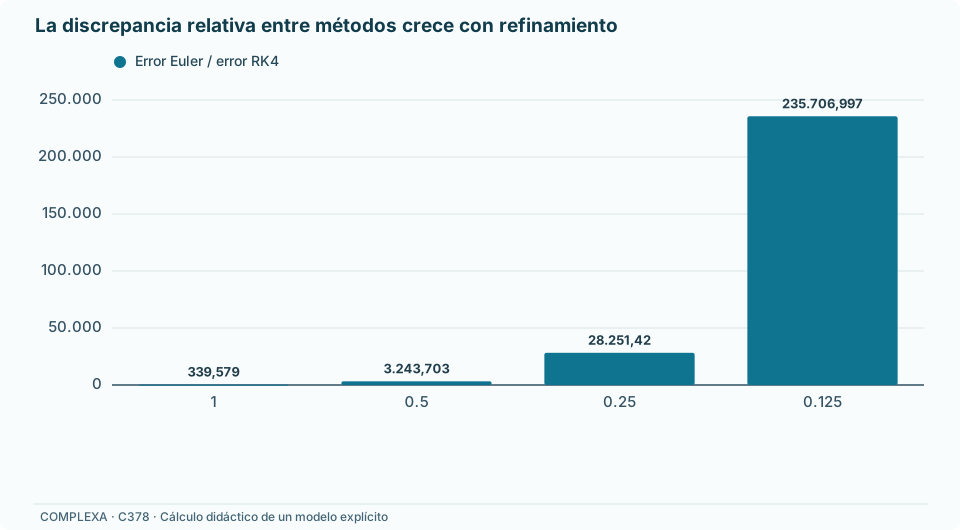
Se ejecutaron además pasos de medio minuto, un cuarto y un octavo, manteniendo el horizonte final. Como segundo método se implementó Runge–Kutta de cuarto orden, que combina cuatro evaluaciones de la pendiente en cada paso. Los resultados son:
| Paso en minutos | Euler: fracción final | Error absoluto de Euler | Runge–Kutta: error absoluto |
|---|---|---|---|
| 1 | 0,0625000000 | 0,0728353 | 0,000214487 |
| 0,5 | 0,1001129150 | 0,0352224 | 0,0000108587 |
| 0,25 | 0,1180670870 | 0,0172682 | 0,000000611233 |
| 0,125 | 0,1267887864 | 0,00854650 | 0,0000000362590 |
La referencia para todas las filas es la misma solución exponencial. El refinamiento reduce el error de Euler aproximadamente a la mitad cada vez. Para Runge–Kutta, la reducción se aproxima al factor dieciséis asociado a su orden en este problema suave. El orden observado, calculado a partir del cociente entre errores sucesivos, se acerca a uno para Euler y a cuatro para Runge–Kutta. Este patrón respalda la corrección del comportamiento numérico en las condiciones ensayadas.
La comparación también muestra por qué declarar un número de pasos resulta insuficiente. Treinta y dos pasos de Euler todavía dejan un error final de alrededor del , mientras que cuatro pasos del segundo método producen un error mucho menor. El costo tampoco se resume contando pasos: Runge–Kutta evalúa cuatro pendientes en cada uno. Para comparar eficiencia habría que elegir una tolerancia útil, medir el trabajo necesario para alcanzarla y considerar el costo de cada evaluación en el problema concreto.
El error numérico puede quedar oculto durante la calibración. Si ajustamos Euler a los valores de la exponencial exacta en una malla de un minuto, podemos elegir una tasa de aproximadamente , en lugar de la tasa original de . Su factor de actualización será entonces exactamente en aritmética ideal, y todas las fronteras de esa malla coincidirán con la referencia. El ajuste sería perfecto para esos valores construidos, aunque la tasa interpretada como parámetro de la ecuación continua fuera incorrecta. La discrepancia del método ha quedado absorbida por el parámetro.
En general, esa tasa compensadora vale . Cambia cuando cambia el paso y tiende a la tasa original cuando el paso tiende a cero. El ejemplo muestra por qué conviene comprobar la precisión de la solución antes de interpretar parámetros calibrados. Si una tasa estimada cambia al refinar la malla, parte del ajuste puede estar corrigiendo la aproximación numérica. La coincidencia con los puntos de calibración no permite decidir si se ha identificado la tasa del proceso o una compensación específica del algoritmo utilizado.
El resultado final puede ocultar desacuerdos anteriores. En Euler con paso de un minuto, el mayor error absoluto entre las fronteras calculadas es aproximadamente , superior al error final. Se comprobó la trayectoria contra la referencia en cada frontera, además del punto elegido como resultado principal. Cuando interesa un máximo, un tiempo de cruce o la duración de una exposición, una comprobación centrada exclusivamente en el último instante puede omitir el error que más afecta a esa pregunta.
Estabilidad y propiedades que una cifra final no revela
La fracción exacta permanece positiva y disminuye. La actualización de Euler conserva la no negatividad y el carácter no creciente si su factor de multiplicación está entre cero y uno. En este ejemplo, con tasa positiva, exige . La condición para que la magnitud de la aproximación decrezca es más amplia: . Esa diferencia permite que un cálculo sea estable en magnitud y produzca valores negativos incompatibles con la cantidad representada.
Con pasos de tres minutos y la misma tasa, el factor es menos un medio. La secuencia calculada comienza en uno y continúa con , , y , en intervalos de tres minutos. Las oscilaciones disminuyen, pero una fracción restante negativa no es una propiedad del modelo continuo. Con pasos de cuatro minutos, la secuencia alterna entre uno y menos uno; con pasos de cinco, su magnitud aumenta. Los tres casos se ejecutaron como pruebas deliberadas de los límites del método.
Un recurso aparentemente práctico sería sustituir cada valor negativo por cero. Esa operación modifica el algoritmo. Puede mantener una salida dentro del rango admisible sin aproximar correctamente la ecuación original. Para un paso de dos minutos, incluso Euler sin ese recorte lleva la cantidad exactamente a cero en la primera actualización y la mantiene allí, aunque la solución continua siga siendo positiva. La comprobación del rango detecta ciertos errores, pero una salida admisible todavía puede ser muy inexacta.
Las pruebas de casos simples aportan otro tipo de control. Con tasa cero, la cantidad debe permanecer constante; con estado inicial cero, debe seguir en cero. Ambas propiedades se comprobaron en los dos métodos. También se verificó que, para los pasos de la tabla, las trayectorias fueran no negativas y no crecientes. Estas comprobaciones ayudan a detectar errores de signo, índices o condiciones iniciales. Su éxito se interpreta junto con la comparación analítica, porque ninguna propiedad aislada garantiza precisión.
Cuando no existe solución cerrada, puede estudiarse la convergencia entre discretizaciones y utilizar referencias numéricas más precisas. La interpretación requiere comprobar que el cálculo ha alcanzado el régimen en el que el error cambia de la forma esperada. Dos mallas muy gruesas pueden coincidir por accidente, y un error de programación común puede persistir al refinarlas. La referencia disponible en este ejemplo evita parte de esa ambigüedad y permite aprender cómo deberían comportarse las comprobaciones antes de aplicarlas a problemas más difíciles.
Una población de unidades aleatorias
Ahora cambiamos la pregunta matemática. En lugar de tratar una fracción continua, comenzamos con cien unidades independientes. Cada una permanece durante un tiempo aleatorio exponencial con tasa por minuto y después desaparece definitivamente. No hay nacimientos, interacciones ni cambios de tasa. El número restante, , es entero y disminuye mediante saltos. Su trayectoria individual difiere de la curva suave aunque ambos modelos estén relacionados.
La probabilidad de que una unidad permanezca hasta el minuto es . Por independencia, el número restante tiene distribución binomial:
En el minuto cuatro, la media exacta es aproximadamente unidades y la varianza . La media dividida entre cien coincide con la solución de la ecuación continua. Esa identidad se deriva de este modelo lineal con unidades independientes; no autoriza a equiparar automáticamente la solución determinista y la media de cualquier modelo estocástico con interacciones o no linealidades.
Para simular se generó, para cada unidad, un número uniforme y se calculó su tiempo de permanencia como . Contar los tiempos superiores a cuatro produce una realización de . El procedimiento evita discretizar el tiempo: utiliza directamente una distribución que aquí conocemos. Su exactitud es distributiva dentro del modelo, con las limitaciones de representación numérica y generación pseudoaleatoria propias de la implementación.
Gillespie (1977) desarrolló procedimientos de simulación estocástica exacta para sistemas de reacciones bajo los supuestos del modelo químico correspondiente. La palabra «exacta» se refiere a respetar esa ley estocástica, no a demostrar que un sistema real satisfaga sus supuestos. Nuestro cálculo usa el caso sencillo de tiempos exponenciales independientes; no implementa una red general de reacciones ni necesita aproximar su evolución mediante pequeños pasos temporales.
Se ejecutaron diez mil realizaciones de cien unidades, con el generador MT19937 de Python y semilla . La primera trayectoria, observada en los minutos cero a cuatro, dejó cien, cincuenta y seis, treinta y una, dieciséis y trece unidades. La segunda dejó cien, sesenta y ocho, cuarenta y ocho, veintiocho y diecinueve. Son observaciones computacionales del generador especificado. Sus diferencias representan variación entre realizaciones, aunque todas compartan los mismos parámetros.
En las diez mil realizaciones, la media final fue y la varianza muestral . La media no coincide exactamente con el valor analítico, como cabe esperar en un promedio de tamaño finito. La comprobación relevante compara esa diferencia con la variabilidad del promedio. Se verificaron además las probabilidades binomiales para los ciento un recuentos posibles: suman uno y reproducen los momentos analíticos. Esa referencia completa permite examinar cantidades que la inspección de algunas trayectorias no resolvería.
Cuántas repeticiones informan sobre qué incertidumbre
La desviación típica entre recuentos finales es aproximadamente unidades según el modelo. El error estándar del promedio de diez mil realizaciones independientes es mucho menor: alrededor de . Una cantidad describe la dispersión entre sistemas simulados; la otra describe cuánto fluctuaría el promedio si volviéramos a ejecutar el experimento con nuevos números aleatorios. Aumentar las repeticiones reduce la segunda, mientras la primera sigue siendo una propiedad de la distribución representada.
Morris, White y Crowther (2019) recomiendan definir los objetivos, mecanismos generadores, cantidades de interés, métodos y medidas de desempeño de una simulación, además de informar sus errores de Monte Carlo. Su distinción entre observaciones por conjunto simulado y número de repeticiones resulta directa aquí: cien es el tamaño de cada población de unidades; diez mil es el número de poblaciones simuladas. Cambiar el primero modifica la distribución del recuento; cambiar el segundo modifica la precisión con que estimamos sus características.
El error estándar estimado del promedio, calculado con la varianza muestral de las diez mil realizaciones, fue . La diferencia entre la media obtenida y la referencia es aproximadamente unidades, menor que un error estándar. Esta comparación es compatible con la variación de Monte Carlo. No demuestra identidad de distribuciones ni elimina la necesidad de otras comprobaciones. En particular, un generador incorrecto podría acertar aproximadamente una media y fallar en las colas.
Las primeras mil realizaciones del mismo experimento dieron una media de , con error estándar estimado de . El valor analítico sigue siendo el mismo. Al pasar a diez mil repeticiones, el error estándar esperado disminuye por un factor cercano a la raíz de diez. La desviación observada no tiene obligación de disminuir en esa proporción ni de hacerlo de forma monótona. Una semilla concreta genera una trayectoria de promedios; la relación con el tamaño describe su distribución bajo repeticiones del procedimiento.
Una semilla permite repetir una ejecución; no transforma sus resultados en una demostración. Elegir entre muchas semillas la que produce una media especialmente próxima a la referencia introduciría una selección que ocultaría la incertidumbre real. Aquí se fijó una semilla y se conservaron tanto los resultados como el estado del generador. Las discrepancias encontradas se informan, en lugar de corregir los recuentos para forzar una media deseada. Esa corrección alteraría la distribución que se pretendía estudiar.
La misma media puede ser insuficiente para la decisión
La probabilidad de conservar al menos veinte unidades al minuto cuatro es aproximadamente , calculada sumando las probabilidades binomiales desde veinte hasta cien. En las diez mil realizaciones se observó ese suceso en , lo que produce una frecuencia de . Su error estándar de Monte Carlo estimado es aproximadamente . La diferencia respecto a la probabilidad exacta es compatible con esa precisión.
La curva determinista termina cerca de trece unidades y media si se escala por cien. Esa cifra no permite concluir que alcanzar veinte unidades sea imposible. La pregunta sobre un umbral depende de la distribución, incluso cuando la media esté calculada con gran precisión. En una aplicación, elegir entre predecir una media, una frecuencia de excedencia o un tiempo de desaparición dependería de la decisión concreta. El experimento computacional debe conservar suficiente información para responder a la cantidad elegida.
Consideremos el suceso opuesto: que no quede ninguna unidad al minuto cuatro. Su probabilidad exacta es , aproximadamente para la tasa central. No apareció en ninguna de las diez mil realizaciones. De hecho, la probabilidad de observar cero casos en un experimento de ese tamaño es aproximadamente . La ausencia observada es, por tanto, el resultado habitual de un experimento que sigue asignando al suceso una probabilidad positiva.
Para tener al menos un de probabilidad de observar ese suceso una vez, manteniendo este muestreo independiente, harían falta aproximadamente millones de repeticiones. La cantidad se obtiene resolviendo , donde es la probabilidad del suceso y el número de repeticiones. Una simulación puede ser grande para estimar una media y pequeña para estudiar un evento raro. Cuando existe una distribución exacta, utilizarla evita confundir la falta de observaciones con una propiedad imposible del modelo.
Sustituir una frecuencia nula en la fórmula habitual del error estándar de una proporción produce también un error estándar nulo. Esa cifra resulta engañosa en este extremo. Con cero sucesos en diez mil realizaciones, el límite superior unilateral binomial al nivel del es aproximadamente : se obtiene buscando la probabilidad para la que observar cero tiene probabilidad . Es un límite inferido del muestreo y mucho mayor que la probabilidad exacta del ejemplo. El cálculo analítico aporta aquí información que esa ejecución no tiene precisión suficiente para recuperar.
Comparaciones que controlan la variación computacional
Se repitió el cálculo con tasas de y por minuto. Se utilizaron los mismos números uniformes para las tres tasas, transformándolos según la distribución correspondiente. En este acoplamiento, una unidad que permanece con la tasa mayor también permanece con la menor. La comparación empareja realizaciones y permite estimar con menor ruido la diferencia entre sus recuentos, sin modificar la distribución marginal correcta de cada escenario.
Las medias exactas al minuto cuatro son aproximadamente y unidades para las tasas menor y mayor. Las medias simuladas fueron y . La diferencia observada, , puede compararse con la diferencia exacta, . El error estándar estimado de la diferencia emparejada fue unidades; el valor teórico bajo este acoplamiento es . Con simulaciones independientes de ambos escenarios y el mismo número de repeticiones, sería aproximadamente .
La ganancia depende de la relación entre los resultados emparejados. Compartir números aleatorios no garantiza una reducción de varianza para cualquier modelo o cualquier contraste. En este caso la dependencia es explícita y la diferencia de indicadores de permanencia tiene una distribución conocida, lo que permite comprobar la reducción. Para interpretar la comparación como respuesta de un sistema real a una intervención haría falta justificar, además, qué intervención cambia la tasa y qué otros aspectos mantiene. La comparación ejecutada establece una consecuencia del modelo bajo dos parámetros elegidos.
La exploración paramétrica también muestra que una gran precisión numérica puede convivir con incertidumbre sustancial sobre el resultado de interés. Si solo sabemos que la tasa está entre y , la fracción final compatible va aproximadamente de a . Ese rango supera ampliamente los errores de Runge–Kutta de la tabla. Es un intervalo condicionado a límites supuestos para la tasa, sin interpretación probabilística adicional. Para convertirlo en una distribución predictiva habría que especificar cómo se distribuye la incertidumbre del parámetro y de dónde procede esa información.
Errores que las repeticiones no corrigen
Supongamos que reemplazamos la probabilidad exponencial correcta por la supervivencia de Euler con paso de un minuto. Tras cuatro pasos, cada unidad permanecería con probabilidad y la media del recuento sería . Repetir ese generador millones de veces estimaría cada vez mejor esa media equivocada respecto al modelo continuo. El error de Monte Carlo disminuiría, pero la discrepancia introducida por la aproximación temporal permanecería. Aumentar repeticiones y reducir pasos resuelven problemas distintos.
Roy y Oberkampf (2011) sitúan el error numérico dentro de una evaluación más amplia de la incertidumbre predictiva. En el ejemplo podemos separar la precisión con que resolvemos una ecuación, la incertidumbre sobre la tasa y la adecuación de la propia ley exponencial. Un presupuesto computacional debería responder a cuál de esas fuentes limita la conclusión. Reducir un error numérico ya minúsculo aporta poco si los parámetros relevantes siguen poco restringidos o si una relación esencial del modelo no se ha contrastado.
La ley exponencial supone que la probabilidad instantánea de desaparición de una unidad presente no depende de su edad. El modelo elegido supone, además, independencia entre unidades. Si la tasa cambiara con el tiempo, la solución utilizaría la integral temporal de esa tasa; si las unidades compartieran perturbaciones, la distribución del recuento podría dejar de ser binomial. Un promedio exponencial observado no identificaría automáticamente todas esas propiedades. La variación entre realizaciones y las relaciones temporales ofrecerían otras restricciones que deberían evaluarse.
La coincidencia en un instante puede ocultar incluso una variación temporal sencilla. Una tasa de durante los primeros dos minutos y de durante los dos siguientes produce la misma fracción final que la tasa constante de : ambas acumulan una tasa integrada de dos. Sin embargo, en el minuto dos sus fracciones son aproximadamente y . El punto final no distingue esos modelos. Una medición intermedia sí aporta un contraste, si su precisión permite resolver la diferencia. Elegir tiempos de observación forma parte de la evaluación del modelo, además de la elección de un algoritmo preciso.
Kennedy y O’Hagan (2001) incorporan en la calibración de modelos computacionales una discrepancia entre la respuesta del modelo y el proceso observado, además de la incertidumbre sobre los parámetros. La idea permite reconocer que reajustar parámetros puede dejar errores sistemáticos. Aplicada conceptualmente a nuestro ejemplo, distinguiría una tasa mal estimada de una ley de desaparición insuficiente. Una función flexible de discrepancia también necesita supuestos y datos que la informen; añadirla no garantiza que pueda separarse de los parámetros ni que extrapole correctamente.
Podría ocurrir, por ejemplo, que una tasa ajustada a las primeras mediciones reprodujera bien ese tramo y fallara después. La simulación permitiría caracterizar qué implica la tasa constante, mientras la comparación con nuevas observaciones cuestionaría su alcance temporal. Ajustar otra tasa para cada instante podría mejorar la coincidencia y cambiar a la vez el contenido del modelo. La evaluación debería documentar esa modificación y volver a precisar qué resultados quedan determinados antes de observarlos.
Qué falta para una validación empírica
Nuestro experimento ha producido evidencia sobre implementaciones y consecuencias matemáticas. Una validación empírica requeriría definir qué son las unidades, cómo se observa su desaparición y qué condiciones justifican la independencia y la tasa constante. También necesitaría mediciones cuyo error se conozca suficientemente. Si el instrumento deja de detectar unidades pequeñas antes de que desaparezcan, el recuento registrado no coincide con el estado del modelo; habría que representar ese proceso de observación.
La comparación debe corresponder a la misma cantidad. Una media obtenida de muchos sistemas observados puede compararse con una media predicha, considerando su incertidumbre. Una sola trayectoria requiere una distribución de trayectorias, o resúmenes para los que exista una predicción probabilística. Elegir después la realización simulada que más se parece a la observada puede producir una coincidencia visual sin una evaluación definida. Para estudiar un umbral, habría que comparar la frecuencia predicha con evidencia suficiente sobre ese umbral, no únicamente con el promedio general.
Los datos usados para calibrar la tasa desempeñan un papel distinto de los empleados para evaluar predicciones posteriores. Reservar tiempos, condiciones o sistemas puede aportar una comprobación cuya exigencia depende de qué se mantenga compartido. La validez obtenida en un rango de tasas o de condiciones no se extiende automáticamente a otro. Especificar el dominio de comparación permite describir qué uso tiene respaldo y dónde el resultado sigue siendo una extrapolación del modelo.
En simulaciones de mecanismos complejos, además, varios modelos pueden generar patrones semejantes. Una coincidencia cualitativa demuestra que cierto conjunto de reglas puede producir un patrón, siempre que la implementación y el cálculo sean adecuados. Para defender que esas reglas explican el sistema estudiado hace falta evaluar alternativas y consecuencias que las distingan. Un contraste dentro del programa puede aislar una dependencia causal en su mundo construido; trasladarla al sistema empírico requiere justificar la correspondencia entre las intervenciones simuladas y las posibles en ese sistema.
También cambia la fuerza de la conclusión según su forma lógica. Una ejecución bien comprobada puede proporcionar un contraejemplo a la afirmación de que un algoritmo conserva siempre la positividad: basta la secuencia negativa ya calculada. En cambio, muchas ejecuciones positivas no demuestran que la propiedad se cumpla para todos los pasos y tasas. En nuestro modelo, la condición general procede del factor algebraico de actualización; las ejecuciones muestran casos y comprueban la implementación. En un modelo sin esa demostración disponible, habría que delimitar cuidadosamente la región explorada y el alcance de la evidencia computacional.
Si se exploran varios factores, cambiar uno cada vez puede omitir combinaciones problemáticas. Aquí la estabilidad depende del producto entre tasa y paso: un valor de paso tolerable para una tasa puede dejar de serlo para otra. Una colección de ejecuciones debe diseñarse alrededor de las interacciones relevantes para la pregunta. El problema pequeño permite deducirlas; en uno más complejo, la exploración sistemática podría revelarlas. La cantidad de ejecuciones por sí sola no describe qué parte del espacio de condiciones quedó examinada.
Conservar una ejecución que pueda examinarse
El registro de este experimento conserva las reglas de integración, la referencia exponencial, las probabilidades binomiales y los resultados de las realizaciones. Se guardaron la semilla y las huellas de los estados inicial y final del generador, junto con la versión de Python y las cantidades resumidas. Las comprobaciones incluyen casos límite, refinamiento temporal, propiedades de las trayectorias y momentos de la distribución. Esos elementos permiten reconstruir qué se calculó y separar una diferencia de implementación de una fluctuación de Monte Carlo.
La organización del muestreo también debe conservarse. Si se repartiera el trabajo entre varios procesos y cada uno reiniciara el mismo generador con la misma semilla, podrían producirse copias de las mismas realizaciones. Contarlas como independientes reduciría artificialmente el error estándar declarado. La ejecución realizada utilizó un único flujo secuencial y compartió los números únicamente entre escenarios emparejados, manteniendo diferentes bloques de números entre repeticiones. Esa distinción explica por qué la dependencia ayuda en un contraste y puede invalidar una fórmula si se ignora al contar repeticiones.
Dos implementaciones correctas tampoco necesitan entregar exactamente los mismos recuentos con una semilla que tenga la misma etiqueta. Pueden consumir los números aleatorios en otro orden o transformar los uniformes de otra manera. Comparar sus distribuciones requiere una evaluación estadística, mientras que repetir exactamente esta ejecución exige conservar la transformación y el orden utilizados. Para los valores deterministas, las tolerancias numéricas cumplen una función análoga: permiten reconocer diferencias de redondeo sin confundirlas con una discrepancia sustantiva del cálculo.
Una descripción reproducible necesita también conservar fallos. Si un método no converge o genera una cantidad imposible, excluir esa ejecución sin informarlo cambia el conjunto sobre el que se resume su desempeño. En nuestro estudio, las trayectorias negativas de Euler con pasos grandes forman parte del resultado: delimitan condiciones en las que el método deja de representar adecuadamente la cantidad. La comparación principal utiliza pasos especificados de antemano y la misma referencia, sin ocultar los casos que muestran la limitación.
El resultado que queda establecido es concreto. Para la ecuación elegida, el refinamiento y el método de cuarto orden redujeron el error respecto a la solución analítica; para las cien unidades independientes, las medias y frecuencias obtenidas son compatibles con la precisión esperada bajo la distribución binomial. El suceso raro no apareció, aunque su probabilidad exacta sea positiva. Si la siguiente pregunta fuera cuántas unidades reales permanecerán después de cuatro minutos, aún harían falta datos sobre su mecanismo y su observación. Los cálculos realizados indican cómo evaluar esa predicción una vez que esa correspondencia haya sido especificada.
Referencias
Gillespie, D. T. (1977). Exact stochastic simulation of coupled chemical reactions. The Journal of Physical Chemistry, 81(25), 2340–2361. https://doi.org/10.1021/j100540a008
Kennedy, M. C., y O’Hagan, A. (2001). Bayesian calibration of computer models. Journal of the Royal Statistical Society: Series B, 63(3), 425–464. https://doi.org/10.1111/1467-9868.00294
Morris, T. P., White, I. R., y Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. https://doi.org/10.1002/sim.8086
Oberkampf, W. L., y Trucano, T. G. (2002). Verification and validation in computational fluid dynamics. Progress in Aerospace Sciences, 38(3), 209–272. https://doi.org/10.1016/S0376-0421(02)00005-2
Roy, C. J., y Oberkampf, W. L. (2011). A comprehensive framework for verification, validation, and uncertainty quantification in scientific computing. Computer Methods in Applied Mechanics and Engineering, 200(25–28), 2131–2144. https://doi.org/10.1016/j.cma.2011.03.016
Sargent, R. G. (2013). Verification and validation of simulation models. Journal of Simulation, 7(1), 12–24. https://doi.org/10.1057/jos.2012.20