Un informe educativo hipotético muestra que los centros con mayor participación en un taller también presentan más finalizaciones de una tarea. Esa relación describe a los centros. Todavía falta saber si las personas participantes son quienes completan la tarea y qué condiciones explican las diferencias entre centros. Conectar ambas preguntas exige conservar quién participa, qué resultado obtiene y cómo se relacionan las características individuales con las del grupo.
El problema aparece también cuando se conectan componentes con mecanismos o registros rápidos con procesos observados durante meses. Las palabras micro y macro no especifican esa conexión. Una suma, una relación entre partes y actividad conjunta, una media temporal y una estructura administrativa establecen relaciones diferentes. Cada una conserva información distinta y admite operaciones diferentes. Para explicar un cambio hay que establecer qué relación une las descripciones y qué pregunta responde cada una.
Trabajaremos con ejemplos didácticos de depósitos y centros educativos. Las cifras permiten comprobar cuándo una explicación agregada concuerda con el detalle, cuándo deja de hacerlo y por qué sumar explicaciones de distintos niveles puede contar dos veces el mismo proceso. No representan mediciones de una instalación ni resultados de una intervención educativa.
Qué relación hace que dos descripciones estén en niveles distintos
Un nivel de composición se define mediante relaciones entre partes y un conjunto organizado. Una válvula puede integrar un circuito de circulación; ese circuito puede integrar una instalación de distribución. Su posición depende del mecanismo y de la actividad considerados. Llamar componente a una entidad exige describir cómo participa en esa actividad, además de localizarla dentro de una frontera.
Una escala espacial o temporal se refiere a la extensión o duración con la que se estudia un proceso. Observar cada segundo y observar cada hora cambia la resolución temporal, aunque se siga estudiando exactamente el mismo depósito. Cambiar de un depósito a toda la instalación modifica las unidades. Estas operaciones pueden coincidir en una investigación, pero ninguna se deduce automáticamente de la otra.
En un nivel de agregación estadística, varias observaciones se transforman mediante una operación definida. El total de agua es una suma de volúmenes; la tasa de finalización de una tarea es un cociente entre personas que la completan y personas elegibles. La población del denominador, el momento de medición y los criterios de pertenencia al grupo forman parte de la variable agregada.
Una jerarquía organizativa introduce relaciones de autoridad, responsabilidad o comunicación. Un centro puede depender de una administración sin que todas sus actividades constituyan partes de un único mecanismo causal. También puede relacionarse con familias y otras organizaciones que no encajan en ese árbol administrativo. Una representación jerárquica de responsabilidades no garantiza una jerarquía equivalente de procesos.
Potochnik y McGill (2012) cuestionan que la ciencia deba organizarse mediante niveles universales, discretos y ordenados de una sola manera. Proponen atender a procesos y escalas para construir agrupaciones pertinentes a las investigaciones. Su crítica permite distinguir una organización útil en un problema particular de una escalera general a la que deba ajustarse toda explicación.
Para conectar modelos conviene identificar primero sus unidades y variables. Si un modelo describe volúmenes y otro describe tasas, hace falta una transformación con unidades físicas coherentes. Si uno describe personas y otro centros, hay que saber qué personas pertenecen a cada centro. Una relación verbal entre lo individual y lo colectivo no sustituye esa especificación.
Tampoco todas las variables de un mismo modelo tienen que pertenecer a una única escala. Un modelo de circulación puede combinar el estado rápido de una válvula con una reserva que cambia lentamente. La elección depende de las relaciones que se quieren explicar. Introducir ambos procesos no obliga a ordenar todas las variables por tamaño ni a suponer que las más pequeñas ejercen siempre mayor influencia.
Una correspondencia exacta entre depósitos y volumen total
Consideremos dos depósitos. Sus volúmenes al comienzo de cada periodo son y , medidos en litros. En cada periodo sale de la instalación una quinta parte del contenido de cada depósito. Del contenido inicial del primero pasa una décima parte al segundo; del segundo pasa una quinta parte al primero. Las fracciones describen porciones distintas del contenido inicial, de modo que no se aplica primero una pérdida y luego otra fracción sobre lo restante.
Al final del periodo se añaden entradas externas y , también en litros. El modelo supone que no hay rebosamiento y que las fracciones permanecen constantes en el dominio considerado. Los volúmenes siguientes, indicados con una prima, son
Los coeficientes de cada columna permiten seguir el destino del contenido de un depósito. Del primero quedan siete décimas en su lugar, una décima cambia de depósito y dos décimas salen de la instalación. Del segundo quedan seis décimas, dos décimas cambian de depósito y dos décimas salen. Las transferencias internas redistribuyen el agua sin modificar por sí mismas la cantidad total.
Definamos el volumen total y la entrada total . Al sumar ambas ecuaciones obtenemos
Esta relación vale para cualquier composición no negativa de los volúmenes admitida por el modelo. La suma de los coeficientes de cada columna es ocho décimos. Esa igualdad demuestra que el siguiente total depende del total actual y de la entrada total, aunque se desconozca cómo está repartida el agua.
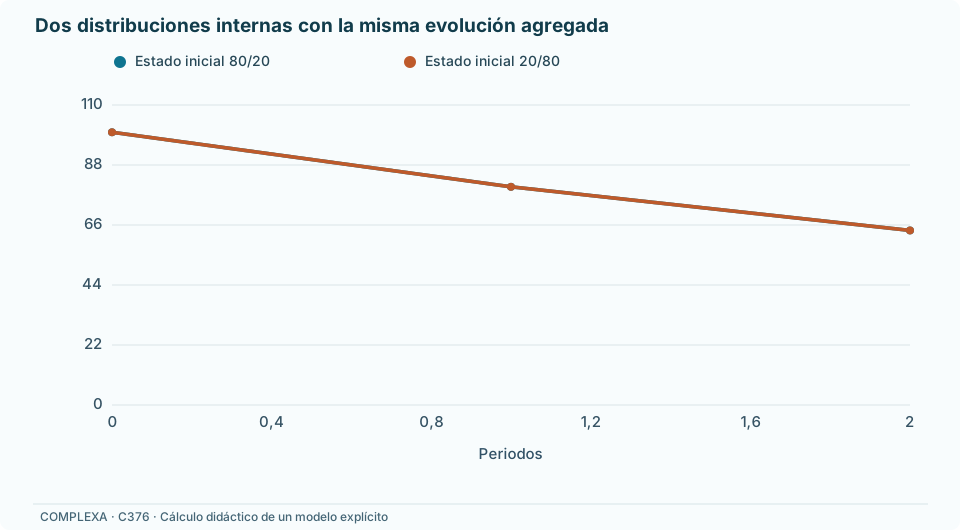
La correspondencia puede comprobarse en dos estados iniciales con cien litros:
| Estado inicial | Estado tras un periodo, sin entradas | Estado tras dos periodos, sin entradas |
|---|---|---|
| Total en ambos casos |
El modelo agregado reproduce ambos totales y pierde la diferencia entre las composiciones. Esa pérdida resulta compatible con una predicción exacta del total. Para conocer el contenido del segundo depósito, en cambio, la suma inicial no basta: después del primer periodo puede contener veinte o cincuenta litros en estas dos configuraciones.
Se dice que el modelo agregado está cerrado respecto de estas variables cuando puede actualizarse utilizando únicamente su propio estado y las entradas declaradas. Aquí el estado es el total, y su actualización no requiere reconstruir la composición. La igualdad entre agregar después de actualizar y actualizar después de agregar puede escribirse como
donde es la actualización de los dos depósitos, suma sus volúmenes, suma las entradas y . Cada símbolo representa una operación específica. La igualdad conecta las descripciones y permite comprobar que ambas responden igual a la pregunta sobre el siguiente total.
La descripción detallada explica por qué se conserva esa relación: las transferencias son internas y ambos depósitos pierden la misma proporción. La descripción agregada permite calcular rápidamente la evolución del total sin seguir transferencias que se cancelan al sumar. Ninguna convierte en inexistente la información representada por la otra.
La condición también muestra qué cambios conservan el resultado. Podrían modificarse las fracciones transferidas entre depósitos y seguir manteniéndose una pérdida de una quinta parte en cada uno, siempre que todas las fracciones sean admisibles. La ecuación del total conservaría entonces su forma. Su regularidad depende de la pérdida común y de la contabilidad del agua, no de cada detalle de la redistribución.
La correspondencia se refiere a los volúmenes del modelo. Sus mediciones pueden contener errores. Si un instrumento registra cada depósito con un error aditivo, sumar las lecturas suma también esos errores. Un desplazamiento de calibración común puede afectar a ambos instrumentos en la misma dirección. La incertidumbre de la suma no puede calcularse suponiendo independencia de errores sin justificarla.
Una medición adicional del total, obtenida por un procedimiento independiente, sí puede aportar evidencia sobre la medición. Permite comparar la suma de lecturas con otra estimación del mismo volumen. Eso difiere de calcular el total a partir de las lecturas y tratar después ese cálculo como una observación independiente que confirma ambas. La transformación de datos conserva su origen, aunque cambie el nombre de la columna.
Esta diferencia separa la redundancia entre variables ideales de la redundancia entre observaciones. Dos instrumentos pueden medir una misma cantidad y aportar información distinta sobre su valor. Dos resúmenes derivados exactamente del mismo registro no se convierten por ello en dos fuentes independientes. Para combinar evidencias sobre niveles hay que conservar cómo se obtuvieron y qué errores pueden compartir.
La ecuación agregada también permite una comprobación propia: contrastar los totales antes y después del periodo con las entradas registradas. Si el balance falla más allá de la incertidumbre de medición, alguna condición requiere revisión. El balance por sí solo no localiza la fuga, la entrada omitida o el error instrumental. Los registros de cada depósito permiten buscar dónde se produce la discrepancia.
Cuando el agregado deja de contener el estado necesario
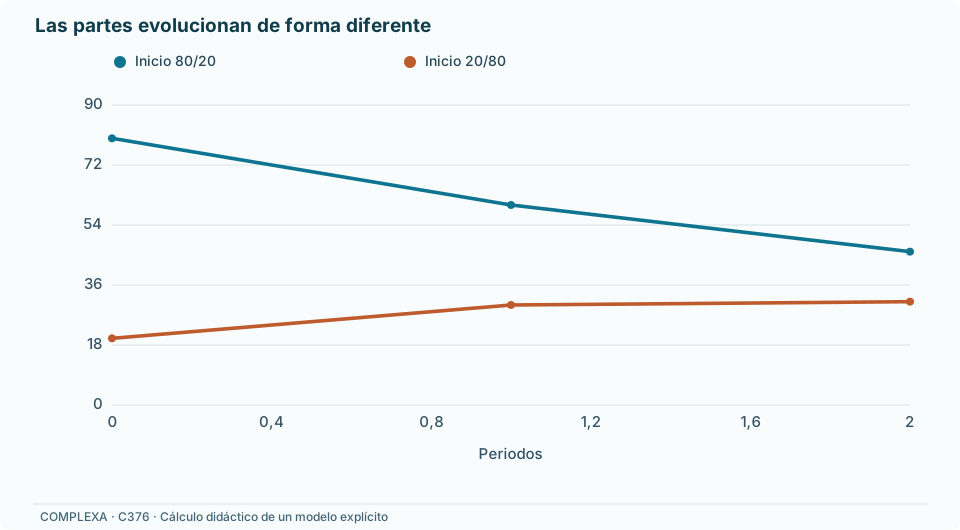
Cambiemos una sola condición: el segundo depósito pierde ahora tres décimas de su contenido por periodo. Se mantienen las transferencias de una décima del primero y dos décimas del segundo. Las ecuaciones pasan a ser
El siguiente total satisface . La composición vuelve a intervenir. Desde ochenta y veinte litros se llega a sesenta y dieciocho, con un total de setenta y ocho. Desde veinte y ochenta se llega a treinta y cuarenta y dos, con un total de setenta y dos. Ambos estados tenían cien litros; su futuro agregado es diferente.
No existe una función de actualización del total solo que reproduzca simultáneamente esos resultados para todas las composiciones admitidas, con la misma entrada. Una función tendría que asignar dos salidas distintas al mismo argumento. La dificultad se debe a la información omitida, aunque el modelo detallado sea determinista y sus parámetros se conozcan exactamente.
Es posible mantener una representación compacta añadiendo una variable de composición. Para un total positivo, sea la fracción almacenada en el segundo depósito. Entonces . Esa expresión muestra qué información faltaba. Para usarla de manera iterativa también se necesita actualizar , derivando su evolución de los volúmenes y de la distribución de las entradas.
Otra opción sería una aproximación. Si aproximadamente la mitad del agua está en cada depósito, se podría utilizar . Con cien litros y composiciones de ochenta y veinte o de veinte y ochenta, esa aproximación predice setenta y cinco litros y comete errores de tres litros, en direcciones opuestas. El ajuste puede parecer aceptable o insuficiente según la pregunta y la precisión requerida.
El error de un paso, en valor absoluto, es . Si la fracción del segundo depósito está entre cuarenta y cinco y cincuenta y cinco centésimas, el error no supera cinco milésimas del total. Para cien litros, eso equivale a medio litro. Se dispone así de una condición comprobable para la aproximación, en lugar de describirla simplemente como bastante buena.
La condición no tiene por qué persistir. Con cincuenta litros en cada depósito y sin entradas, el siguiente estado es cuarenta y cinco y treinta litros. La fracción del segundo baja a dos quintos. Tras otro periodo, el total exacto es cincuenta y siete litros; aplicar dos veces el factor aproximado produce cincuenta y seis coma veinticinco. El acuerdo inicial no garantiza que la misma aproximación conserve su error cuando la composición evoluciona.
El resultado orienta qué medir. Para anticipar el total con pérdidas diferentes puede ser más informativo observar la distribución entre depósitos que medir otra vez el total con mayor precisión. También permite decidir si conviene ampliar el estado agregado, restringir el horizonte de predicción o admitir una aproximación cuyo error esté cuantificado.
Las intervenciones también necesitan una correspondencia
Una relación entre estados no asegura que los modelos representen del mismo modo todas las intervenciones. Añadir diez litros al conjunto puede realizarse introduciéndolos en el primer depósito, en el segundo o mediante una distribución entre ambos. La descripción de una entrada total omite esas alternativas. Su equivalencia debe comprobarse respecto del resultado y del horizonte que interesan.
Con pérdidas iguales, añadir diez litros al final de un periodo incrementa el total en diez, cualquiera que sea el depósito receptor. Tras el periodo siguiente, sin nuevas entradas, el incremento respecto de la trayectoria sin esa adición es de ocho litros. El efecto sobre cada depósito sí depende del lugar de entrada. El modelo agregado conserva el efecto sobre el total, no la distribución del efecto entre componentes.
Con pérdidas diferentes, los dos procedimientos siguen aumentando el total inmediato en diez litros. Un periodo después, añadir al primero deja un incremento total de ocho; añadir al segundo deja siete. Una intervención descrita únicamente como aumentar la reserva en diez litros es insuficiente para predecir ese resultado posterior. Tiene distintas realizaciones relevantes.
Rubenstein y colaboradores (2017) formalizan la consistencia entre modelos causales mediante transformaciones que conectan estados e intervenciones. Exigen que intervenir en el modelo detallado y transformar el resultado produzca la misma distribución que la intervención correspondiente en el modelo agregado. La condición se refiere al conjunto de intervenciones especificado; no se extiende automáticamente a operaciones excluidas de ese conjunto.
En nuestro ejemplo, la suma de entradas proporciona una correspondencia válida para los totales futuros bajo pérdidas iguales. Bajo pérdidas diferentes, la misma correspondencia pierde una distinción necesaria. Podría recuperarse una política agregada precisa fijando que toda entrada se administra al primer depósito, aunque esa restricción tampoco elimina la necesidad de conocer la composición previa para predecir todas las trayectorias.
Beckers y Halpern (2019) distinguen varios requisitos de abstracción causal. Entre ellos separan las coincidencias que dependen de una distribución particular de condiciones más exigentes sobre contextos e intervenciones. Su análisis muestra que declarar una transformación exacta requiere decir para qué intervenciones y bajo qué condiciones lo es. La coincidencia observacional constituye una comprobación más limitada.
El ejemplo de los depósitos utiliza una correspondencia determinista que puede verificarse directamente. No pretende demostrar que toda relación entre modelos cumpla una definición formal de abstracción causal. Sirve para examinar las operaciones que una descripción permite representar: conservar un total, redistribuirlo, añadir agua o modificar una pérdida son acciones diferentes.
La elección de las variables debería mantener esas diferencias cuando afectan a la decisión. Si la tarea consiste en garantizar el contenido del segundo depósito, el total resulta insuficiente incluso con pérdidas iguales. Si consiste en estimar la reserva de toda la instalación después de entradas conocidas, el modelo cerrado puede ser adecuado. La suficiencia depende de la pregunta y de las operaciones previstas.
Distinguir correspondencia, mecanismo y causa evita duplicaciones
La igualdad relaciona descripciones del mismo estado. No representa un flujo adicional de agua desde los depósitos hacia una tercera entidad llamada total. Las transferencias y las salidas físicas sí describen cambios del sistema. Dibujar todas estas relaciones con flechas idénticas puede ocultar que unas son transformaciones descriptivas y otras representan procesos.
Craver y Bechtel (2007) proponen distinguir las relaciones constitutivas entre un mecanismo y sus componentes de las relaciones causales que conectan actividades. Interpretan ciertos efectos llamados descendentes o ascendentes como combinaciones de ambas relaciones, mediadas por mecanismos. Es una posición filosófica sobre cómo entender esas explicaciones, no una convención adoptada de forma unánime por todas las teorías de causalidad.
La distinción permite formular un error concreto. En el modelo con pérdidas iguales, el total siguiente sin entradas es ocho décimos del total actual. También es ocho décimos del contenido del primero más ocho décimos del contenido del segundo. Sumar esas dos explicaciones como contribuciones independientes daría ciento sesenta litros desde un total de cien, aunque el modelo produce ochenta. Se contó dos veces la misma cantidad conservada.
El problema puede quedar menos visible al ajustar una regresión. Si se incluyen simultáneamente , y su suma , sus coeficientes no se determinan por separado sin restricciones adicionales. La expresión equivale a . Atribuir a cada coeficiente una causa independiente ignora esa dependencia exacta.
Por ejemplo, ocho décimos para cada volumen y cero para el total producen la misma predicción que cero para cada volumen y ocho décimos para el total. También cuatro décimos para cada una de las tres variables producen esa predicción. Un criterio de estimación puede elegir una de estas representaciones, pero la elección no demuestra que haya descubierto tres contribuciones causales separadas.
La situación cambia cuando se describe una secuencia física. Un sensor puede medir la reserva total y activar una válvula cuando esa reserva cae por debajo de un umbral. La apertura modifica después una entrada y, con ella, el volumen futuro de un depósito. La explicación requiere el sensor, la regla de control, el actuador y el flujo. La variable agregada permite representar la condición de activación dentro de esa secuencia.
En ese sistema, cambiar el umbral del controlador es una intervención distinta de redistribuir agua entre depósitos. También difiere de aumentar el total mediante una entrada. Es posible comparar sus efectos definiendo qué operación cambia y qué mecanismos permanecen. No es posible, manteniendo la definición de suma, fijar un total distinto y conservar simultáneamente inalterados ambos volúmenes.
La frontera del sistema importa para la explicación. Si el controlador se considera externo, las entradas pueden modelarse como decisiones de otro sistema. Si se incluye, la regla que genera las entradas forma parte de la dinámica. La misma instalación puede representarse de ambas maneras para preguntas diferentes, siempre que no se cuente la decisión externa y su implementación interna como dos adiciones de agua independientes.
El cierre demostrado suponía que la entrada total estaba especificada. Si el controlador decide cuánto añadir mirando exclusivamente el contenido del segundo depósito, dos composiciones con igual total podrían recibir entradas distintas. La ecuación de balance seguiría siendo correcta, pero anticipar el sistema completo exigiría conocer esa regla y la información que utiliza. Con un controlador que decide únicamente a partir del total, puede sustituirse su regla en la ecuación agregada. El conjunto de variables necesario depende también del modo de control, además de las pérdidas y transferencias.
Los mismos grupos pueden ocultar asociaciones individuales opuestas
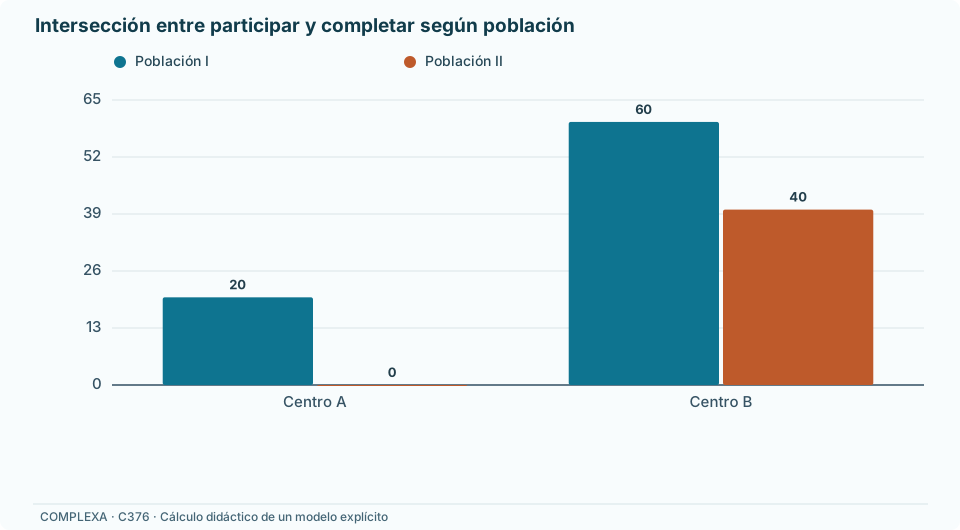
En una agregación de personas, la información que desaparece puede ser la asociación entre características dentro de los grupos. Imaginemos dos centros con cien personas cada uno. En el centro A participan veinte personas en un taller y cuarenta completan una tarea. En el centro B participan ochenta y sesenta completan la tarea. Los registros agregados no indican quiénes reúnen ambas características.
La proporción de participantes y la de personas que completan la tarea son mayores en el centro B. Esa relación entre centros es compatible con diferentes relaciones individuales. Consideremos dos poblaciones hipotéticas que conservan exactamente esos márgenes:
| Centro | Participan | Completan | Participan y completan, población I | Participan y completan, población II |
|---|---|---|---|---|
| A, cien personas | 20 | 40 | 20 | 0 |
| B, cien personas | 80 | 60 | 60 | 40 |
En la población I, ochenta de las cien personas participantes completan la tarea. Entre las cien no participantes, la completan veinte. La diferencia de proporciones es de seis décimos. En cada centro por separado, la diferencia entre participantes y no participantes es de tres cuartos: en A se comparan uno y un cuarto; en B, tres cuartos y cero.
En la población II, cuarenta de las cien participantes completan la tarea y sesenta de las cien no participantes la completan. La diferencia conjunta es de menos dos décimos. Dentro de cada centro, la diferencia es de menos un medio: en A se comparan cero y un medio; en B, un medio y uno.
Así, los mismos recuentos por centro admiten una asociación individual positiva o negativa, incluso cuando ambas poblaciones tienen cien participantes y cien personas que completan la tarea en total. El problema no se resuelve aumentando la precisión de esos márgenes: falta la correspondencia entre las dos características de cada persona.
Robinson (1950) distinguió las correlaciones entre propiedades de individuos de las correlaciones entre características agregadas de grupos. Su análisis histórico recibió una corrección metodológica posterior de te Grotenhuis y colaboradores (2011). El ejemplo construido muestra la diferencia entre agregación y asociación individual sin reutilizar esas cifras históricas. Los totales no determinan la tabla conjunta individual. Conservar los identificadores y observar conjuntamente participación y finalización aportaría la información que se perdió.
Los márgenes tampoco permiten cualquier tabla. En A, el número de personas que participan y completan puede variar entre cero y veinte. En B debe situarse entre cuarenta y sesenta: si ochenta participan y sesenta completan dentro de cien personas, al menos cuarenta pertenecen a ambos conjuntos. Esas restricciones generan cuatrocientas cuarenta y una combinaciones enteras de las dos tablas.
En todas ellas, la diferencia individual conjunta de proporciones se encuentra entre menos dos décimos y seis décimos. Estas son cotas para la asociación compatible con los márgenes declarados. No son cotas de un efecto causal del taller. Ni siquiera disponer de la tabla individual completa establecería por sí mismo ese efecto, porque la participación podría depender de características relacionadas con completar la tarea.
La comparación entre centros también puede responder a una pregunta propia. Podría interesar por qué uno reúne más participantes y más finalizaciones o cómo cambia su composición. Para explicar esos resultados habría que considerar los mecanismos pertinentes al centro y a sus integrantes. El error consiste en trasladar sin justificación una relación entre tasas a una relación individual distinta, no en utilizar variables agregadas.
Un modelo estadístico multinivel debe conservar la pregunta
Un modelo con personas agrupadas en centros puede representar diferencias dentro de cada centro y diferencias entre centros. Sea la participación de la persona en el centro , y su media en ese centro. La variable puede descomponerse como : una desviación respecto del centro y una característica compartida del grupo.
Incluir ambos términos en un modelo permite asignar coeficientes distintos a la asociación dentro de los centros y a la asociación entre sus medias. Esta separación evita imponer que ambas tengan el mismo significado o magnitud. Para estimarlas se necesitan datos que varíen en los planos correspondientes. Si solo se conservan las medias de cada centro, las desviaciones individuales desaparecen del registro.
Un intercepto específico del centro puede representar diferencias de nivel entre grupos. Un procedimiento que comparte información entre centros puede estabilizar estimaciones imprecisas, dependiendo de sus supuestos. Ninguna de estas decisiones reconstruye automáticamente una asociación individual ausente de los datos. Si el resultado depende de una restricción sobre las tablas posibles, esa restricción debe formar parte de la interpretación.
La agrupación estadística tampoco establece por sí misma qué procesos son causales. Dos personas del mismo centro pueden compartir recursos o criterios de admisión, pero también diferir en sus redes de contacto. Una estructura de dependencia útil para estimar incertidumbre no identifica necesariamente la organización del mecanismo que se quiere explicar. El término multinivel describe aquí la arquitectura del modelo estadístico.
Para evaluar una decisión del centro hay que especificar cuál es. Cambiar el horario del taller, modificar los criterios de admisión o contratar personal adicional son intervenciones diferentes. Cada una puede afectar tanto a la participación como a la composición del grupo y a la finalización. Un coeficiente de la proporción de participantes no reemplaza la descripción de esas operaciones.
El denominador puede cambiar como parte del proceso. Si un centro incorpora personas con mayores dificultades, su tasa de finalización podría disminuir aunque se mantuvieran los resultados de quienes ya estaban presentes. Para estudiar el cambio se necesita distinguir la evolución de las mismas personas de la entrada y salida de integrantes. Comparar tasas sin describir esa composición mezcla preguntas diferentes.
También hay que decidir cómo se combinan los centros. La media simple de sus tasas concede el mismo peso a cada centro. La proporción calculada reuniendo a todas las personas concede a cada centro un peso proporcional a su número de integrantes. Las dos coinciden en el ejemplo porque ambos centros tienen cien personas; no tienen por qué coincidir si sus tamaños son diferentes.
Si el interés es una persona seleccionada al azar de toda la población, la segunda operación conserva esa población de referencia. Si el interés es describir un centro seleccionado al azar, la primera puede corresponder a la pregunta. Ninguna ponderación es intrínsecamente más explicativa. Lo necesario es mantener la misma pregunta al conectar el resultado individual con el agregado y al comparar periodos o políticas.
El tiempo introduce otra correspondencia. Una tasa anual de un centro puede reunir personas que participaron en momentos distintos, mientras un registro individual sigue a la misma cohorte desde su incorporación. Para vincularlos se requiere reconstruir quién estaba expuesto a cada condición y durante cuánto tiempo. La pertenencia al grupo en la fecha de cierre puede no describir la pertenencia durante el proceso relevante.
Por ejemplo, un traslado entre centros puede cambiar la tasa de ambos sin modificar el resultado de la persona trasladada. La explicación de ese cambio agregado incluye el movimiento de integrantes. Atribuirlo automáticamente a una modificación de su conducta confundiría la evolución de las unidades con la transformación del conjunto que se está resumiendo.
Las conexiones entre registros individuales y grupales son, por tanto, operaciones de investigación. Requieren definir población, pertenencia, tiempo y variables compartidas. Cuando esas correspondencias están disponibles, el modelo puede conservar diferencias de interés entre personas y centros; cuando faltan, una presentación más compleja no elimina por sí sola la pérdida de información.
Diferentes posiciones sobre qué aporta una explicación de niveles
Las correspondencias matemáticas no resuelven todas las controversias sobre explicación. Craver y Bechtel vinculan el comportamiento del conjunto con la organización de sus componentes mediante relaciones constitutivas y procesos causales. Potochnik y McGill cuestionan la pretensión de organizar todos los procesos mediante una jerarquía universal. Sus propuestas discuten objetos y compromisos diferentes, aunque ambas exijan precisión sobre la organización estudiada.
Weinberger (2019) examina ciertas propuestas de relevancia constitutiva y sostiene que, cuando se reconstruyen como cadenas de mediación causal, todavía debe justificarse qué aporta tratarlas como una forma explicativa distinta entre niveles. Reconoce el valor de estudiar intermediarios para entender cómo se transmite un efecto y si persistiría bajo cambios. Su objeción no demuestra que toda explicación mecanicista posible carezca de valor; mantiene abierta la cuestión de su contribución distintiva.
Estas diferencias se pueden conservar sin imponer una jerarquía retórica entre explicaciones. Una descripción de componentes puede mostrar dónde modificar un mecanismo. Una relación agregada puede expresar una regularidad válida para muchas composiciones. Una descripción institucional puede especificar decisiones que se implementan mediante acciones distribuidas. Cada propuesta debe explicar sus variables, su relación con las observaciones y las operaciones para las que pretende responder.
Una derivación entre modelos tampoco obliga a eliminar uno de ellos del trabajo científico. En los depósitos, la ecuación del total se deriva de las ecuaciones detalladas, pero sigue siendo una representación útil de la reserva. La derivación aporta una razón para confiar en ella bajo las condiciones establecidas. Cuando cambian las pérdidas, esa misma conexión localiza la información que debe recuperarse.
Para operar la instalación con pérdidas diferentes, el registro final conservaría el volumen de cada depósito, la distribución de entradas y el intervalo de actualización. El informe del total se obtendría sumando esos volúmenes una sola vez. Si se decidiera trabajar con la aproximación de composición equilibrada, se comprobaría esa composición en cada periodo pertinente y se limitaría la predicción al error admitido. La explicación detallada y la agregada quedarían conectadas por una transformación verificable y por las condiciones concretas bajo las que se utilizan.
Referencias
Beckers, S., y Halpern, J. Y. (2019). Abstracting causal models. Proceedings of the AAAI Conference on Artificial Intelligence, 33(01), 2678–2685. https://doi.org/10.1609/aaai.v33i01.33012678
Craver, C. F., y Bechtel, W. (2007). Top-down causation without top-down causes. Biology & Philosophy, 22(4), 547–563. https://doi.org/10.1007/s10539-006-9028-8
Potochnik, A., y McGill, B. (2012). The limitations of hierarchical organization. Philosophy of Science, 79(1), 120–140. https://doi.org/10.1086/663237
Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
Rubenstein, P. K., Weichwald, S., Bongers, S., Mooij, J. M., Janzing, D., Grosse-Wentrup, M., y Schölkopf, B. (2017). Causal consistency of structural equation models. Proceedings of the Thirty-Third Conference on Uncertainty in Artificial Intelligence, artículo 11. https://arxiv.org/abs/1707.00819
te Grotenhuis, M., Eisinga, R., y Subramanian, S. V. (2011). Robinson's ecological correlations and the behavior of individuals: Methodological corrections. International Journal of Epidemiology, 40(4), 1123–1125. https://doi.org/10.1093/ije/dyr081
Weinberger, N. (2019). Mechanisms without mechanistic explanation. Synthese, 196(6), 2323–2340. https://doi.org/10.1007/s11229-017-1538-1