Una pantalla indica que la mitad de los dispositivos de una instalación está activa. Un equipo propone que cada dispositivo cambia con rapidez y sin memoria; otro sostiene que cada uno permanece largo tiempo en su estado. Ambos pueden explicar la proporción observada. La coincidencia no decide todavía si faltan observaciones, si se está midiendo una propiedad incapaz de separar los mecanismos o si las propuestas son dos maneras de describir la misma estructura.
La subdeterminación aparece cuando la evidencia considerada no selecciona una única explicación entre las alternativas admitidas. Su alcance depende de qué evidencia y qué alternativas se hayan especificado. La equivalencia empírica exige una afirmación más precisa: los modelos producen las mismas consecuencias observables dentro de un dominio declarado. En modelos probabilísticos, no basta con que ambos permitan el resultado ocurrido; deben asignar las mismas probabilidades a las observaciones pertinentes.
Los modelos y las cifras que siguen son construcciones didácticas. Separaremos una dificultad debida a muestras pequeñas, una equivalencia exacta respecto de cierta información y las tesis filosóficas más amplias sobre los límites del conocimiento científico. Las cuentas no pretenden demostrar por sí solas ninguna de estas últimas tesis.
Compatible con los datos no significa igualmente apoyado
Supongamos veinte ensayos independientes de una variable binaria y diez resultados positivos. En un modelo Bernoulli, cualquier probabilidad de éxito estrictamente comprendida entre cero y uno asigna probabilidad positiva a ese resultado. Por tanto, el dato no excluye lógicamente todos los valores excepto uno. Sin embargo, no los favorece por igual.
La probabilidad de obtener diez éxitos es , donde es la probabilidad postulada por el modelo. Comparar con da una razón de verosimilitudes cercana a . En esta muestra, sus ajustes son muy parecidos. Comparar con da aproximadamente . El primer resultado observado era posible bajo ambos valores, pero mucho menos probable bajo nueve décimos.
Estas distribuciones no son empíricamente equivalentes. Predicen frecuencias poblacionales distintas. La cercanía de los dos primeros valores hace difícil distinguirlos con pocos ensayos, y reunir más observaciones del mismo tipo puede aportar información. No hay aquí una igualdad estructural que vuelva inútil cualquier ampliación de la muestra.
La distinción importa al interpretar pruebas estadísticas. Que dos ajustes no resulten significativamente diferentes puede reflejar poca precisión. Tampoco el hecho de que ambos produzcan residuos pequeños demuestra igualdad de sus distribuciones completas. Una conclusión sobre equivalencia necesita establecer qué diferencias se descartaron y con qué criterio; no se obtiene únicamente de una ausencia de rechazo.
En sentido inverso, elegir el mejor ajuste de una lista no demuestra que la explicación elegida sea verdadera. La comparación ordena las alternativas examinadas según un criterio y unos datos. Si todas omiten una característica del proceso, la ganadora puede conservar esa omisión. El problema de comparar modelos y el de justificar que la lista contiene explicaciones adecuadas son diferentes.
La equivalencia siempre lleva una especificación de observación
Llamemos a la información observable y a su distribución bajo el modelo . Dos modelos son observacionalmente equivalentes para esa información si
La igualdad debe abarcar todo lo declarado observable. Si solo se igualan medias, todavía podrían diferir las varianzas o las dependencias temporales. Si se iguala una distribución conjunta completa, cualquier resumen de esas mismas variables tendrá también la misma distribución. Ningún algoritmo que utilice exclusivamente esa información puede recuperar una diferencia que los modelos no generan en ella.
El registro incluye cómo se obtienen las observaciones. Una medición por dispositivo en unidades independientes no proporciona lo mismo que varias mediciones de los mismos dispositivos. Los valores pueden tener la misma distribución marginal mientras las relaciones entre momentos sean diferentes. Perder los identificadores de las unidades puede eliminar precisamente esas relaciones.
También debe indicarse la clase de modelos. Si un modelo está definido solo para un intervalo de funcionamiento, no tiene sentido atribuirle predicciones fuera de ese intervalo sin extenderlo. Y si dos modelos coinciden dentro de una clase restringida, todavía no se ha demostrado que toda explicación posible del fenómeno comparta esa ambigüedad. La conclusión conserva las restricciones con las que se construyó.
La identificación estadística estudia si una distribución observable determina los parámetros o cantidades de una estructura. Rothenberg (1971) desarrolla este problema para modelos paramétricos y distingue la identificabilidad local dentro de un entorno de parámetros de cuestiones más amplias. La identificación no se reduce a que un programa devuelva una solución única: un procedimiento puede escoger una representación mediante restricciones añadidas aunque la distribución observada no la distinga.
Una afirmación útil sobre equivalencia puede escribirse con sus condiciones: estos dos mecanismos producen la misma distribución de estas variables, bajo este muestreo y dentro de este intervalo. Esa formulación deja abierta una pregunta concreta sobre qué información diferente podría separarlos. También permite reconocer los casos en que no se ha descrito ninguna operación observacional que corresponda a la diferencia propuesta.
La misma fotografía, dos procesos temporales
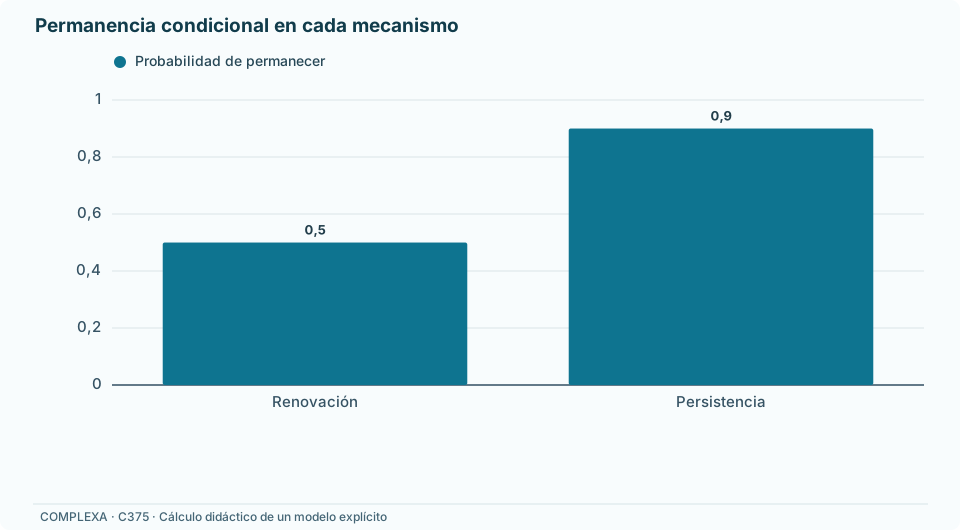
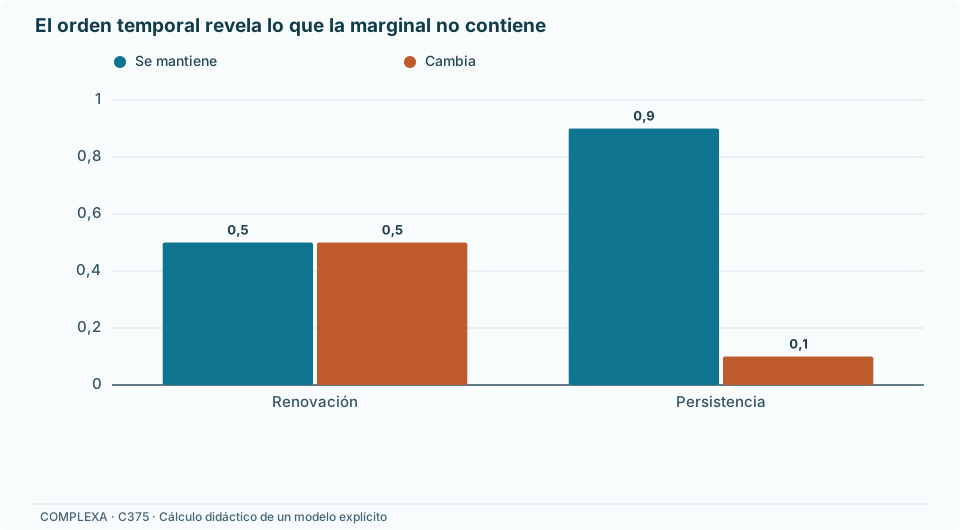
Volvamos a los dispositivos, cada uno en estado cero o uno. En el primer modelo, el estado se renueva en cada momento mediante una moneda equilibrada, de manera independiente de su estado anterior. En el segundo, el dispositivo conserva su estado con probabilidad nueve décimos y lo cambia con probabilidad un décimo. Su estado inicial se obtiene también mediante una moneda equilibrada.
Los dispositivos son independientes entre sí en ambos modelos. En el segundo, el inicio equilibrado se conserva: la probabilidad de estar activo en el momento siguiente es un medio por nueve décimos más un medio por un décimo, que vuelve a ser un medio. La distribución marginal permanece equilibrada aunque cada trayectoria conserve memoria.
Si observamos una sola vez cada dispositivo, la muestra de estados tiene exactamente la misma distribución bajo ambos mecanismos. Para cualquier conjunto de dispositivos independientes, cada secuencia específica de ceros y unos tiene probabilidad . No se igualó solamente el porcentaje medio de actividad; se igualó la distribución de todo el registro transversal declarado.
Duplicar o multiplicar por mil el número de dispositivos observados una sola vez precisará la proporción de actividad, pero no distinguirá estos dos modelos. Ambos predicen la misma incertidumbre de muestreo para ese registro. El resultado no se debe a que todavía no haya aparecido una diferencia pequeña: dentro de este diseño no existe esa diferencia.
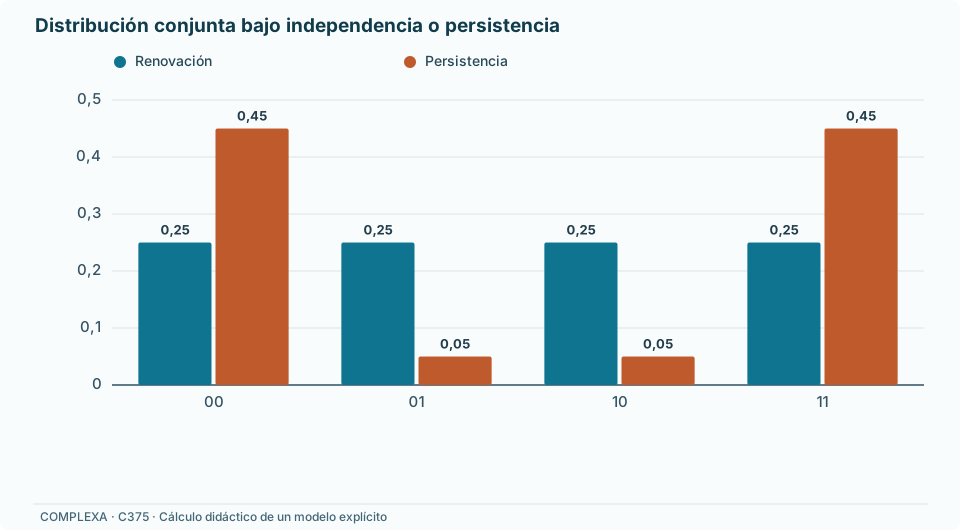
Ahora conservemos los identificadores y observemos a cada dispositivo en dos momentos consecutivos. Las distribuciones conjuntas cambian:
| Estado inicial y posterior | Renovación independiente | Persistencia |
|---|---|---|
| 00 | 0,25 | 0,45 |
| 01 | 0,25 | 0,05 |
| 10 | 0,25 | 0,05 |
| 11 | 0,25 | 0,45 |
La probabilidad de conservar el estado es un medio en el primer mecanismo y nueve décimos en el segundo. Si diez dispositivos independientes conservaran su estado, la probabilidad de ese evento sería frente a . La segunda es unas trescientas cincuenta y siete veces mayor. La nueva observación discrimina entre estas dos propuestas porque conserva una relación temporal que la fotografía transversal omitía.
Ese resultado no demostraría que el mecanismo persistente es la única explicación posible. Otros procesos podrían reproducir la distribución de dos momentos y diferir a más largo plazo. La prueba responde a una comparación definida. Para ampliar su alcance habría que especificar esas alternativas y las distribuciones de trayectoria que implican.
La diferencia entre los modelos depende también del intervalo entre mediciones. El segundo asigna nueve décimos de persistencia al paso temporal definido. Cambiar la frecuencia de observación exige calcular sus probabilidades a ese nuevo intervalo. El momento de medición forma parte de la predicción, no es un detalle que pueda alterarse manteniendo automáticamente las mismas cifras.
Puede calcularse ese efecto sin introducir otro mecanismo. En el modelo persistente, la probabilidad de conservar el estado inicial después de dos pasos es la suma de dos posibilidades: conservarlo en ambos pasos o cambiarlo dos veces. El resultado es . Después de cinco pasos la probabilidad es , y después de diez, aproximadamente . La dependencia sigue presente, pero se aproxima a la probabilidad de un medio que caracteriza la renovación independiente.
La expresión general es para un intervalo de pasos. La diferencia con el primer modelo es positiva para cualquier número finito de pasos. Por tanto, espaciar mucho las mediciones no produce una equivalencia exacta entre los dos registros longitudinales. Puede producir, sin embargo, una diferencia tan pequeña que sea difícil detectarla con los recursos disponibles. En una misma investigación reaparecen así dos problemas distintos: igualdad estructural cuando se omite toda relación temporal y discriminación estadística difícil cuando esa relación se mide a un intervalo poco informativo.
El diseño debería conservar el significado del intervalo y la identidad de cada dispositivo. Registrar muchos estados con relojes desajustados podría mezclar pasos de duraciones diferentes. Registrar dos fotografías sin poder emparejar las unidades puede impedir calcular las transiciones individuales utilizadas en la comparación. Ninguna de esas modificaciones equivale automáticamente a la observación longitudinal especificada, aunque la base de datos contenga el mismo número de filas.
Este ejemplo muestra por qué una propuesta de recoger más datos necesita indicar cuáles. Duplicar fotografías transversales independientes mantiene la equivalencia declarada. Repetir mediciones emparejadas puede romperla. Elegir un intervalo demasiado largo reduce la señal que permitirá separarlas. La cantidad de información relevante depende de la relación entre el registro y las diferencias del mecanismo; no se deduce del volumen del archivo.
La misma distribución conjunta, dos direcciones causales
El ejemplo anterior se resuelve mediante observación longitudinal. Otra equivalencia puede abarcar ya una distribución conjunta completa y requerir información de otro tipo. Consideremos dos variables continuas estandarizadas, e , y dos perturbaciones independientes y , ambas normales de media cero y varianza uno.
El primer mecanismo se define mediante
El segundo utiliza
En cada caso, las ecuaciones expresan mecanismos causales: la segunda variable depende de la primera según el orden indicado. No son solo dos maneras de calcular una regresión. Las perturbaciones representan entradas independientes que se conservan al definir las intervenciones del ejemplo.
Ambos modelos producen medias cero, varianzas uno y covarianza . Por ejemplo, en el primero la varianza de es . Como la distribución conjunta es normal en ambos, la coincidencia de medias y matriz de covarianzas determina la misma distribución conjunta completa. Esta conclusión depende de la normalidad; en general, igualar medias y covarianzas no basta.
Así, cualquier muestra independiente de pares observados tiene la misma probabilidad bajo los dos mecanismos. Ambos predicen la misma regresión de sobre , la misma regresión inversa y la misma distribución de residuos observacionales pertinente. El análisis no puede orientar la relación utilizando exclusivamente diferencias estadísticas que, por construcción, no existen.
Peters y colaboradores (2014) explican este caso lineal gaussiano dentro de los modelos con ruido aditivo. La representación en ambas direcciones es posible porque un residuo de regresión normal sin covarianza con el predictor es también independiente de él. Esa propiedad no se conserva automáticamente para otras distribuciones de ruido.
Podemos comprobar ahora una intervención definida: fijar en uno, reemplazando su ecuación y conservando las demás. En el primer modelo, el resultado pasa a ser , con media seis décimos y varianza dieciséis veinticincoavos. En el segundo, no se modifica: su media sigue siendo cero y su varianza, uno.
La intervención distingue los mecanismos aunque no los distinguiera la distribución observada de pares. Seleccionar registros con próximo a uno no realiza esa intervención. La selección conserva las relaciones que generaron el dato; reemplazar la ecuación especifica un cambio en el proceso. Confundir ambas operaciones haría desaparecer precisamente la diferencia causal que se quiere evaluar.
La demostración es condicional a que la operación propuesta pueda realizarse sin alterar los otros mecanismos. Si un procedimiento que cambia también afecta directamente a , sus resultados no corresponden a la intervención descrita. Ese problema puede estudiarse, pero exige ampliar el modelo de la manipulación. El cálculo no garantiza que exista en cualquier aplicación una intervención físicamente realizable con las propiedades supuestas.
Qué aportan las restricciones sobre los mecanismos
Una clase más restringida puede separar modelos que eran equivalentes en otra más amplia. Los resultados de Peters y colaboradores (2014) muestran que determinadas condiciones sobre forma funcional y ruido permiten identificar direcciones causales desde distribuciones observacionales. Sus resultados exigen supuestos definidos, entre ellos estructuras acíclicas y perturbaciones independientes; los casos aditivos no son todos identificables. La situación lineal gaussiana utilizada antes constituye una excepción explícita.
Esto cambia cómo debe presentarse una dirección estimada. La conclusión no procede de la distribución sola, sino de esa distribución junto con una familia de mecanismos admisibles. Si la dirección contraria solo puede reproducir los datos mediante un mecanismo excluido por razones defendibles, la exclusión aporta información. Si se la excluye simplemente porque el programa no la representa, la salida todavía necesita esa justificación.
Tampoco basta con obtener un buen ajuste dentro de la familia elegida. Una restricción puede ser compatible con los datos y seguir sin estar determinada por ellos. Para valorar su uso se puede recurrir a conocimiento del proceso, experimentos anteriores o patrones adicionales que la restricción permita explicar. Debe quedar claro cuál de esos elementos está disponible y cuál permanece como hipótesis de trabajo.
En el ejemplo gaussiano, declarar que una variable precede físicamente a la otra podría aportar una asimetría que no figuraba en la distribución de pares. Pero ese orden tendría que corresponder a las variables realmente medidas. Una variable registrada primero puede resumir un proceso que comenzó después de otro proceso no registrado. La fecha de una columna no impone por sí misma el orden causal de los fenómenos que representa.
La comparación también puede ampliarse con una medición adicional. Dos mecanismos equivalentes para podrían predecir relaciones diferentes con . Para afirmar que la nueva medición discrimina hay que derivar esas relaciones en ambos modelos. Añadir una columna sin restricciones sobre cómo la genera cada alternativa no garantiza que disminuya la ambigüedad.
Una solución computacional puede seleccionar sin identificar
Considérese una respuesta media , con ruido normal de varianza uno y un valor de entrada conocido. Los parámetros y aparecen únicamente mediante su suma. Las parejas uno y dos, dos y uno o uno coma cinco y uno coma cinco producen la misma distribución para cualquier entrada. Observar muchos valores diferentes de puede identificar la suma y seguir sin identificar sus componentes.
La dirección de cambio que aumenta y reduce en la misma cantidad deja intactas todas esas predicciones. El problema no desaparece porque se observen datos sin error sobre la pendiente total. Conocer exactamente que la suma vale tres todavía admite todas las descomposiciones permitidas por el dominio de los parámetros.
Un algoritmo podría resolver la ambigüedad minimizando entre las parejas cuya suma es tres. Elegiría uno coma cinco para cada componente: la penalización vale cuatro coma cinco, frente a cinco para las parejas uno y dos. La solución única procede del criterio de penalización. Las observaciones siguen proporcionando información sobre la suma, no una medición separada de cada componente.
Este caso también plantea qué significa que dos explicaciones sean distintas. Si y representan componentes que pueden medirse por separado, cabe diseñar otra observación. Una medida de , con su propio error especificado, distinguiría las parejas uno y dos de dos y uno cuando la entrada es uno. Pero si los parámetros son solamente una descomposición redundante de una pendiente, quizá no se hayan formulado dos mecanismos diferentes, sino dos coordenadas para representar lo mismo.
Conviene describir la transformación que preserva las observaciones antes de atribuirle consecuencias filosóficas. Una simetría de representación, una diferencia causal no identificada y una discrepancia entre entidades postuladas no son automáticamente el mismo problema. La matemática puede mostrar qué se conserva; la interpretación debe explicar qué compromiso científico se añade con cada representación.
La inferencia bayesiana tampoco convierte observaciones equivalentes en diferentes. Para los dos mecanismos gaussianos completamente especificados, la razón de verosimilitudes observacionales es uno. Las probabilidades posteriores relativas permanecen iguales a las previas. Con probabilidad previa cuatro quintos para el primer mecanismo, la media predictiva de bajo la intervención propuesta sería ; con un quinto, sería . Las observaciones de pares no decidieron entre esas predicciones de intervención.
Esos cálculos pueden expresar una inferencia legítima si las probabilidades previas representan información o juicios declarados. Lo que no puede afirmarse es que la misma distribución observacional haya proporcionado la distinción que se introdujo por esa vía. El informe debe conservar de qué información procede la preferencia.
Qué puede quedar determinado dentro de una equivalencia
La falta de identificación de una explicación completa no implica que todas sus consecuencias sean desconocidas. Una cantidad está determinada por las observaciones, dentro de la clase considerada, cuando tiene el mismo valor en todos los modelos que producen esa distribución. Esta propiedad se examina para la pregunta concreta. Dos modelos pueden coincidir sobre una cantidad y discrepar sobre otra sin que exista contradicción.
En la familia de pendientes descompuestas, la suma de los parámetros es una cantidad identificable cuando el diseño permite conocer la pendiente. La diferencia entre los componentes permanece indeterminada. Para predecir la respuesta media a una nueva entrada dentro del mismo mecanismo basta la suma; para decidir cuál componente modificar hace falta una interpretación y una información adicionales. El éxito de la primera predicción no resuelve la segunda pregunta.
En los dispositivos, los dos mecanismos determinan la misma proporción marginal de actividad. Si el objetivo fuera estimar esa proporción en una población de dispositivos independientes observada bajo las condiciones del ejemplo, la disputa sobre memoria no impediría hacerlo. Si el objetivo fuera anticipar cuáles seguirán activos después de un paso, la distribución temporal sí sería decisiva. Una propiedad relevante para una decisión puede ser irrelevante para otra.
En el ejemplo causal gaussiano, ambos modelos fijan la misma media condicional observacional de para cada valor de . Sus medias bajo intervención difieren. Si la clase admisible contuviera únicamente esos dos mecanismos completamente especificados, el conjunto de medias de intervención compatibles con ella tendría dos elementos: cero y seis décimos. No sería correcto presentar ese par como el conjunto de valores permitido por cualquier modelo imaginable. Incorporar mecanismos con otras variables o dependencias puede cambiar el conjunto.
Conservar un conjunto de respuestas exige por ello declarar cómo se construyó. Puede tratarse de dos alternativas explícitas, de una familia paramétrica completa o de una clase definida por restricciones sustantivas. Los extremos encontrados al explorar algunas configuraciones no son necesariamente cotas demostradas para toda la clase. Distinguir una exploración de una caracterización completa permite aprovechar lo que sí se conoce sin asignarle un alcance mayor que el establecido.
La identificación se refiere aquí a lo que permitiría conocer la distribución observable completa. Una investigación dispone de una muestra y debe estimar esa distribución o las características relevantes de ella. Por eso puede existir incertidumbre estadística sobre una cantidad identificada. En la familia de pendientes, la suma tiene una relación única con la respuesta media poblacional, pero su estimación puede ser imprecisa si las entradas observadas varían poco o el ruido es grande. Esa imprecisión no convierte cada descomposición de la suma en una pendiente total distinta igualmente compatible con la distribución poblacional.
Una comunicación clara conserva ambas dimensiones. Puede informar un intervalo de incertidumbre para la pendiente total y, además, reconocer que no dispone de información para repartirla entre componentes. Aumentar la muestra podría estrechar el primero mientras permanece la segunda limitación. Si se incorpora la medición separada de un componente, cambia el problema de identificación y aparece también un nuevo problema de precisión asociado a ese instrumento. La información añadida se evalúa en esos dos planos, sin suponer que distinguir mecanismos equivale a estimarlos sin error.
Las hipótesis se contrastan junto con otras hipótesis
Una predicción científica suele depender de más elementos que el mecanismo central. Intervienen condiciones iniciales, modelos de medición, supuestos sobre perturbaciones y reglas que relacionan las variables teóricas con el registro. Si el dato contradice la predicción conjunta, la contradicción no indica por sí sola qué elemento falló.
Quine (1951) defendió una concepción holista de la relación entre afirmaciones y experiencia: las afirmaciones sobre el mundo se enfrentan a la observación en conexión con otras. Esta posición filosófica amplía la discusión más allá de comparar parámetros dentro de un modelo. No constituye por sí misma una demostración matemática de que cualquier conjunto de observaciones tenga siempre dos explicaciones científicas igualmente apoyadas.
Podemos ver el papel de los supuestos auxiliares en los dispositivos. Una persistencia observada podría reflejar el estado del dispositivo o un instrumento que tarda en actualizar su lectura. Si cada mecanismo se compara con un instrumento ideal distinto del utilizado, el contraste puede estar mal planteado. Una comprobación independiente del tiempo de actualización del instrumento restringe las explicaciones disponibles sin aumentar necesariamente el número de estados observados.
La posibilidad lógica de modificar un supuesto auxiliar no implica que toda modificación tenga el mismo apoyo. Un cambio puede contradecir calibraciones independientes o exigir un comportamiento del instrumento que no se observa en otras condiciones. Conservar ese conocimiento adicional evita presentar como equivalentes dos paquetes que solo coinciden cuando se omite evidencia relevante.
También hay un riesgo en la dirección opuesta: tratar como incuestionable un supuesto auxiliar porque resulta cómodo. Si el instrumento o el muestreo pueden comportarse de otra manera compatible con lo conocido, la afirmación de identificación necesita incorporar esa posibilidad. La revisión afecta a la clase de modelos, no únicamente a la precisión de sus parámetros.
Del problema local a las tesis filosóficas
Norton (2003) cuestiona la tesis de que toda evidencia necesariamente subdetermine cualquier teoría. Su argumento no niega que existan problemas concretos sin solución identificada; discute el paso desde esas situaciones o desde una concepción limitada de la confirmación hacia una necesidad universal. Adoptar esa crítica no obliga a afirmar que cada investigación real dispone de una explicación única.
Acuña y Dieks (2014), al revisar argumentos sobre equivalencia empírica, defienden una conclusión acotada: la investigación puede disponer de recursos que permitan salir de una situación de subdeterminación, sin que por ello quede refutado de una vez todo el problema. Esa posición diferencia la existencia de vías científicas de discriminación de una garantía de que siempre estén disponibles o tengan éxito.
Stanford (2006) plantea otro desafío, el de las alternativas no concebidas. Su argumento histórico sostiene que investigadores anteriores no llegaron a formular alternativas serias que podían acomodar la evidencia disponible y que fueron desarrolladas después. La preocupación no se limita a dos modelos conocidos con una igualdad demostrada. Se refiere a la confianza que merece una comparación cuando su repertorio de alternativas puede estar incompleto.
Estas posiciones discuten cuestiones relacionadas, pero no intercambiables. Una igualdad probabilística dentro de una clase puede demostrarse mediante cálculo. La evaluación de un argumento histórico sobre alternativas desconocidas requiere otro tipo de razones. Y una tesis universal sobre toda evidencia posible lleva una exigencia que no satisface la mera construcción de dos modelos equivalentes en un ejemplo.
El ejemplo temporal muestra una subdeterminación relativa a una fotografía que se reduce con otro registro. El gaussiano muestra una equivalencia observacional compatible con una diferencia de intervención, bajo mecanismos definidos. La pendiente descompuesta muestra una redundancia que podría o no corresponder a componentes físicamente distinguibles. Ninguno determina por sí solo cómo debe resolverse el debate general entre realismo y otras posiciones sobre la aceptación de teorías.
Elegir qué información falta
Ante dos explicaciones con el mismo ajuste, el primer trabajo consiste en precisar dónde coinciden. Si solo coinciden en el promedio, puede interesar la dispersión. Si coinciden en una distribución transversal, puede interesar una trayectoria. Si coinciden en toda la distribución observacional de las variables elegidas, puede hacer falta una manipulación o una variable con relaciones teóricamente restringidas. Cada ampliación tiene que responder a una diferencia derivada de los modelos.
La factibilidad importa. Una intervención matemáticamente discriminante puede ser imposible, costosa o incompatible con las condiciones que se desean conservar. En ese caso, la evaluación puede mantener un conjunto de explicaciones y comunicar las conclusiones que todas comparten. La falta de una prueba accesible no demuestra que no exista ninguna distinción concebible; sí delimita lo que la investigación presente puede sostener.
Una prueba discriminante necesita además una predicción previa de cada alternativa. En los dispositivos, la tabla de transiciones permite formularla antes de observar la segunda medición. Si después de ver los datos se cambia la persistencia, el número de estados o la duración de un paso, se está evaluando una familia ampliada. Esa ampliación puede estar justificada, pero requiere calcular qué ajustes permite y qué restricciones conserva. La flexibilidad añadida no puede tratarse como si hubiera sido una predicción específica de la propuesta original.
El ejemplo gaussiano también permite definir el registro experimental completo. No se compararían solamente dos medias puntuales; se observaría una distribución que, según el primer mecanismo, tiene varianza reducida, mientras que el segundo conserva la varianza inicial. La coincidencia con una de las medias y la incompatibilidad con ambas varianzas señalaría una dificultad para los dos modelos. Forzar la elección entre ellos ocultaría que el experimento puede cuestionar la clase examinada.
Conviene separar esa posibilidad de la fluctuación aleatoria. Una muestra experimental finita no reproduce exactamente la media ni la varianza de su población. El contraste necesita representar su incertidumbre y establecer qué desviaciones serían esperables bajo cada alternativa. Una diferencia entre las predicciones hace posible la discriminación, pero no convierte cualquier resultado individual en una refutación lógica. El paso desde una diferencia estructural a una conclusión empírica sigue requiriendo inferencia estadística.
La calidad de la manipulación es otra parte del registro. Si se pretende reemplazar una ecuación, hay que describir el procedimiento, su cumplimiento y las condiciones que podrían afectar a otras variables. Estas observaciones auxiliares ayudan a distinguir una predicción causal fallida de una intervención que no correspondió al modelo. Cuando ambas explicaciones producen la misma distribución para el procedimiento realmente realizado, repetirlo con mayor precisión mantendrá esa equivalencia aunque otro procedimiento ideal pudiera separarlas.
También puede ser posible decidir sin resolver toda la explicación. Si varias alternativas coinciden en el resultado de una acción dentro del dominio relevante, la recomendación sobre esa acción puede ser estable aunque otras preguntas sigan abiertas. Si discrepan, como en la intervención gaussiana, esa incertidumbre debe acompañar la decisión. Que una predicción cotidiana sea compartida no garantiza que también lo sean sus respuestas a cambios del sistema.
En la instalación del comienzo, aumentar otra vez el número de dispositivos fotografiados no resolvería la disputa entre renovación y persistencia. Se conservarían sus identificadores y se programaría una segunda observación tras el intervalo definido por ambos modelos. Antes se comprobaría que el instrumento actualiza el estado dentro de ese intervalo. El informe compararía después la distribución de transiciones con las dos predicciones completas y mantendría explícito que el contraste discrimina entre esas propuestas, sin convertir su resultado en una prueba sobre toda explicación posible del funcionamiento.
Referencias
Acuña, P., y Dieks, D. (2014). Another look at empirical equivalence and underdetermination of theory choice. European Journal for Philosophy of Science, 4(2), 153–180. https://doi.org/10.1007/s13194-013-0080-3
Norton, J. D. (2003). Must evidence underdetermine theory? Manuscrito preparado para la First Notre Dame–Bielefeld Interdisciplinary Conference on Science and Values, revisado el 24 de julio de 2003. https://sites.pitt.edu/~jdnorton/teaching/1702_jnrsnr_sem/1702_jnrsnr_seminar_2005/docs/underdet_thesis.pdf
Peters, J., Mooij, J. M., Janzing, D., y Schölkopf, B. (2014). Causal discovery with continuous additive noise models. Journal of Machine Learning Research, 15(58), 2009–2053. https://jmlr.org/papers/v15/peters14a.html
Quine, W. V. (1951). Main trends in recent philosophy: Two dogmas of empiricism. The Philosophical Review, 60(1), 20–43. https://doi.org/10.2307/2181906
Rothenberg, T. J. (1971). Identification in parametric models. Econometrica, 39(3), 577–591. https://doi.org/10.2307/1913267
Stanford, P. K. (2006). Exceeding our grasp: Science, history, and the problem of unconceived alternatives. Oxford University Press. https://doi.org/10.1093/0195174089.001.0001