Dos secuencias de trabajo pueden contener exactamente los mismos minutos de actividad exigente y producir respuestas distintas al final. Una concentra la actividad al principio y deja después un descanso largo; la otra intercala actividad y descanso. Una propuesta verbal atribuiría la diferencia a una carga que persiste durante algún tiempo. Para convertir esa propuesta en una explicación evaluable hay que precisar cuánto persiste, qué añade cada episodio y cómo se reconoce su presencia en una medición. La palabra «carga» todavía permite numerosas respuestas incompatibles entre sí.
Consideraremos un ejemplo construido para examinar esas decisiones. Una persona realiza bloques de una tarea de laboratorio, separados o acompañados por períodos de descanso. Una prueba breve registra su tiempo de respuesta. Todos los números siguientes son valores didácticos calculados; no proceden de participantes ni establecen una teoría de la fatiga. La pregunta será si un mecanismo de acumulación y recuperación puede generar un patrón temporal distinguible del efecto inmediato de la actividad. Esta pregunta pequeña permite seguir el paso desde una afirmación verbal hasta sus consecuencias observables.
Precisar lo que necesita explicación
Una teoría comienza con un objeto que merece ser explicado. En nuestro ejemplo, ese objeto sería la dependencia del rendimiento respecto a la distribución temporal de la demanda. Antes de atribuirle un mecanismo habría que comprobar empíricamente que el patrón existe bajo condiciones suficientemente especificadas: misma tarea, instrucciones comparables, mediciones con resolución adecuada y un tratamiento explícito de los errores de respuesta. Una diferencia ocasional entre dos registros no define por sí misma una regularidad. Tampoco puede darse por establecida porque una simulación consiga producirla.
Borsboom y colaboradores (2021) proponen construir teorías pasando desde los fenómenos y una propuesta explicativa inicial hasta un modelo formal, para después evaluar su adecuación explicativa y general. Su distinción entre datos y fenómenos resulta útil aquí: los registros concretos aportarían evidencia sobre el patrón temporal; el modelo intentaría explicar ese patrón. Esta separación permite preguntar qué parte de un registro refleja el proceso de interés y qué parte depende del instrumento o del procedimiento. También evita ajustar una explicación nueva a cada irregularidad accidental de una serie.
La formulación verbal inicial será esta: cada bloque exigente añade una cantidad a un estado residual; durante el intervalo siguiente permanece una fracción del estado previo; cuanto mayor sea ese estado, más lenta será, en promedio, la respuesta a una prueba breve. Ya contiene compromisos que podrían revisarse por separado. Propone memoria temporal, acumulación aditiva y una relación creciente con el tiempo de respuesta. Aún deja abiertas la unidad del estado, la forma de recuperación y la posibilidad de que la práctica mejore simultáneamente el rendimiento.
El alcance debe fijarse antes de llenar esos huecos. Trataremos una tarea concreta durante una sesión corta y comenzaremos con una persona idealizada cuyos parámetros permanecen constantes. No atribuiremos al estado toda variación del rendimiento ni lo identificaremos con un diagnóstico, una sensación subjetiva o una magnitud fisiológica. El modelo intenta explicar una componente temporal bajo ciertas condiciones. Ampliarlo a aprendizaje, cambios de estrategia o diferencias entre tareas exigiría nuevas relaciones y datos capaces de distinguirlas.
Van Rooij y Baggio (2021) relacionan la construcción de teorías con la necesidad de precisar qué capacidad se explica, qué procedimiento la realiza y cómo podría implementarse. Esas preguntas delimitan niveles de explicación. En nuestro caso, una regla que prediga el tiempo de respuesta después de cierta historia de actividad todavía deja sin especificar qué proceso físico realiza esa memoria. Llamar «recuperación» a un coeficiente describe una función dentro del modelo; identificar su realización requeriría evidencia adicional.
Un reloj, un estado y una regla de observación
Dividamos la sesión en intervalos de cinco minutos. El índice entero identifica sus fronteras. La entrada representa la intensidad de demanda asignada durante el intervalo que comienza en : vale cero durante el descanso y uno durante la tarea estándar. Es una escala adimensional definida por el protocolo, no una medición universal del esfuerzo. Si se admitieran intensidades intermedias, habría que justificar que el valor asignado corresponde a una manipulación interpretable de esa tarea.
El estado representa la carga residual al comienzo del intervalo. Su unidad es una unidad latente convencional, cuya relación con la observación deberá quedar explícita. Proponemos:
El coeficiente adimensional es la fracción del estado que permanece después de cinco minutos. El parámetro añade unidades de carga por intervalo a intensidad uno. La entrada actúa sobre el estado de la frontera siguiente. Esta convención temporal impide que una actividad asignada después de una prueba explique retrospectivamente el resultado de esa misma prueba. La ecuación especifica además que el estado actual resume toda la historia relevante para su evolución posterior.
La prueba se administra en la frontera temporal, antes de comenzar la actividad siguiente. Para mantener sencillo el ejemplo, suponemos que su duración y su efecto sobre la carga son despreciables o están incorporados de forma constante en el protocolo. La observación se representa mediante:
Aquí es el tiempo de respuesta en milisegundos, el nivel basal en esa unidad y la conversión entre unidades de carga y milisegundos. El error tiene media cero bajo las condiciones especificadas. Para obtener las trayectorias numéricas calcularemos medias esperadas, sin añadir realizaciones aleatorias. Una inferencia sobre registros reales necesitaría describir también la dispersión, la dependencia temporal y la posible relación entre lentitud y errores de ejecución.
La condición inicial será . Representa un inicio sin carga residual dentro del modelo. Un descanso previo suficientemente largo podría motivar esa aproximación, pero escribirla no demuestra que se cumpla en una sesión real. Si el estado inicial fuera desconocido, su contribución aparecería en las primeras mediciones y competiría con la estimación de la recuperación. La duración del descanso previo, las actividades anteriores y las mediciones basales formarían parte del diseño que permite evaluar esa condición.
La formalización ha añadido decisiones que la frase inicial permitía eludir. La recuperación es proporcional al estado, una misma demanda añade siempre la misma cantidad y el vínculo con la media observada es lineal. Guest y Martin (2021) destacan precisamente que especificar e implementar un modelo obliga a examinar supuestos que pueden permanecer ambiguos en una teoría verbal. En este ejemplo podemos señalar cada decisión y estudiar qué predicción cambia al modificarla, sin atribuir a la ecuación más respaldo empírico del que tiene.
La regla de observación merece tanta atención como la transición del estado. Un tiempo de respuesta puede aumentar porque la persona procesa más lentamente la prueba, porque adopta un criterio más cuidadoso o porque cambia su disposición a responder. Nuestro modelo agrupa esas posibilidades en una relación única con la carga. Si el propósito fuera distinguirlas, registrar también los errores podría introducir una restricción útil: una explicación sobre la estrategia debería dar cuenta de cómo cambian conjuntamente velocidad y exactitud. Sin una regla para esa segunda observación, disponer de otra columna de datos no amplía automáticamente el contenido explicativo del modelo.
La selección de las respuestas también pertenece a la observación. Analizar únicamente ensayos correctos define una media condicionada a acertar; analizar todos los ensayos define otra cantidad. Si la intervención cambia la frecuencia de errores, ambas pueden evolucionar de forma diferente. Habría que fijar cuál representa y cómo se tratarán omisiones o respuestas fuera de plazo antes de comparar curvas. En los cálculos didácticos, representa la observación ideal especificada, sin exclusiones. Una aplicación debería concretar esa correspondencia y comprobar que el procedimiento de registro no fabrica la aparente recuperación.
El equilibrio puede ocultar mecanismos diferentes
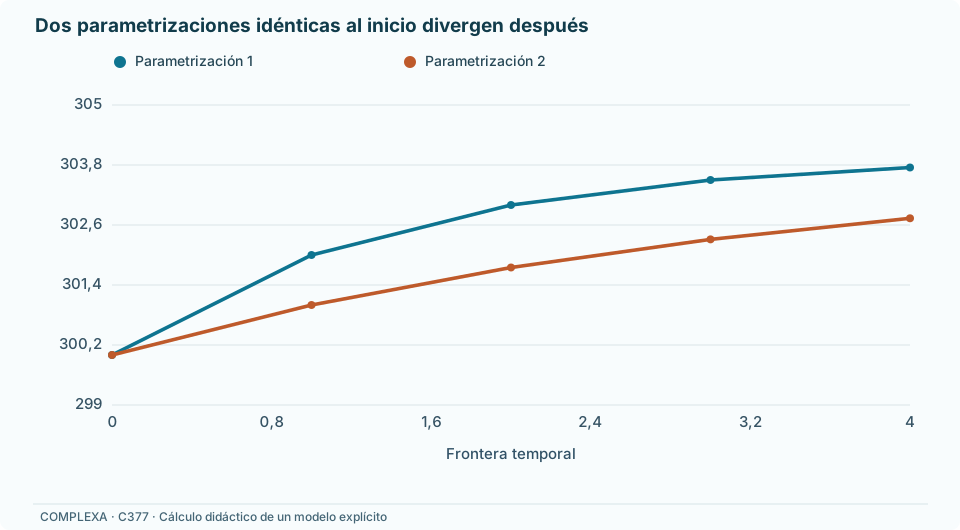
Definamos , el exceso esperado de tiempo de respuesta sobre el nivel basal, medido en milisegundos. Con el estado inicial fijado y la entrada conocida, las dos ecuaciones implican:
Esta expresión facilita la comparación observable. En un primer modelo elegimos , , y , de modo que . En otro mantenemos el mismo nivel basal, pero fijamos , y , por lo que . El segundo retiene una fracción mayor del estado y produce un incremento observado menor por cada intervalo exigente.
Ante demanda constante de intensidad uno, ambos convergen a un exceso de cuatro milisegundos, porque el equilibrio satisface . Una medición realizada únicamente después de una exposición muy prolongada no distinguiría esos dos conjuntos de parámetros. Incluso una colección de equilibrios para diferentes intensidades constantes produciría, en ambos casos, la relación . Esa coincidencia abarca toda la respuesta estacionaria del ejemplo, aunque las trayectorias transitorias sean distintas.
| Frontera temporal | Primera parametrización: media en ms | Segunda parametrización: media en ms |
|---|---|---|
| Inicio | 300 | 300 |
| Después de un intervalo | 302 | 301 |
| Después de dos intervalos | 303 | 301,75 |
| Después de tres intervalos | 303,5 | 302,3125 |
| Después de cuatro intervalos | 303,75 | 302,734375 |
Las cifras se obtienen aplicando la recurrencia a una entrada constante, desde el estado inicial nulo. También pueden comprobarse con la expresión exacta . En el primer modelo, la mitad de la distancia al equilibrio desaparece en cada intervalo; en el segundo desaparece una cuarta parte. Observar el comienzo de la exposición aporta información que se pierde cuando se conserva únicamente el resultado final.
Para comparar mecanismos, añadamos una alternativa sin retención: el exceso en la frontera siguiente depende exclusivamente de la demanda del intervalo recién terminado, . Este modelo inmediato comparte los mismos equilibrios de los modelos anteriores, pero alcanza el valor correspondiente en un solo intervalo. Tras un intervalo de descanso vuelve al nivel basal. Puede representarse como el caso límite de la recurrencia observable con retención cero e incremento cuatro. El contraste evalúa la necesidad de memoria entre intervalos, mediante candidatos que pertenecen a una familia matemática común.
Ninguna alternativa necesita ser declarada absurda para que la comparación resulte informativa. Si el proceso real cambiara mucho más deprisa que los cinco minutos del muestreo, una descripción inmediata podría ser suficiente a esa resolución. Por el contrario, una elevación persistente durante varios intervalos de descanso pondría en dificultad esa descripción. La utilidad de una teoría depende también de las escalas a las que pretende describir el fenómeno y de las mediciones disponibles para separar sus consecuencias.
La ecuación implica otras restricciones que pueden buscarse sin estimar cada estado interno. Desde un inicio nulo, la contribución de un episodio de demanda se atenúa geométricamente según su antigüedad. El exceso total es la suma de esas contribuciones. Por tanto, dentro del rango permitido de entradas, la predicción para la suma de dos historias de demanda coincide con la suma de sus excesos predichos por separado. Esta propiedad de superposición conecta varios protocolos mediante los mismos parámetros. Un ajuste independiente para cada protocolo perdería precisamente esa conexión, aunque todas las curvas resultantes parecieran razonables.
La proporcionalidad ofrece una comprobación complementaria. Reducir a la mitad todas las intensidades de una secuencia reduce a la mitad su exceso previsto, manteniendo la misma retención y el mismo inicio. Si una tarea de intensidad intermedia no puede definirse de forma reproducible, esa comparación carece de interpretación experimental. Si puede definirse y la relación observada se curva, habría que localizar la no linealidad: la intensidad podría añadir carga de modo no proporcional, la recuperación podría depender del estado o la observación podría saturarse. Una desviación de proporcionalidad identifica una restricción incumplida, pero todavía no selecciona entre esas modificaciones.
Diseñar una observación que separe las propuestas
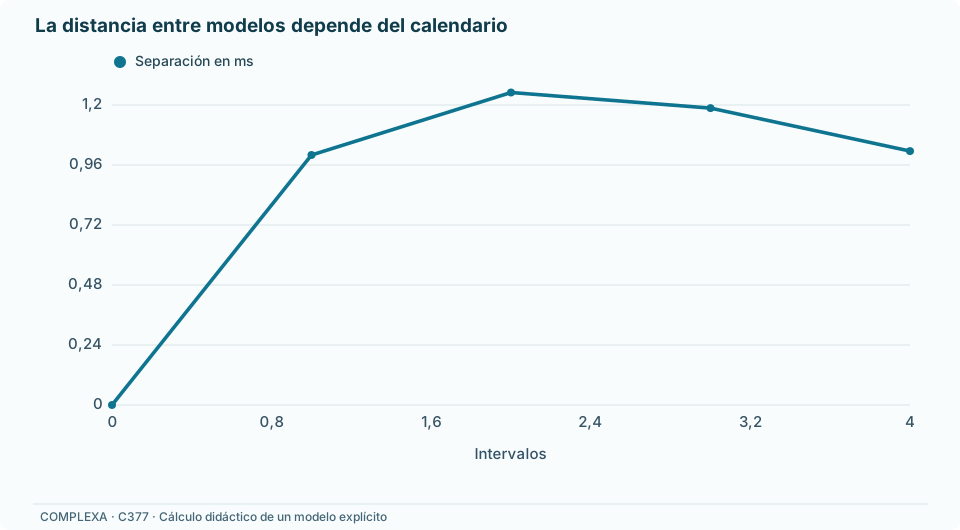
Consideremos dos secuencias de cuatro intervalos, ambas con diez minutos de actividad exigente. La primera asigna demanda, demanda, descanso y descanso; la segunda asigna demanda, descanso, demanda y descanso. Con la primera parametrización del modelo residual, los excesos esperados en las cinco fronteras son, respectivamente, cero, dos, tres, uno y medio, y tres cuartos de milisegundo. En la segunda secuencia son cero, dos, uno, dos y medio, y uno y cuarto.
La respuesta final esperada es así de milisegundos para la actividad concentrada al principio y de para la actividad intercalada. La diferencia de medio milisegundo surge porque el último episodio exigente queda más próximo a la medición final en la segunda secuencia. Ambas acumulan la misma exposición total, de modo que una explicación basada exclusivamente en esa suma omitiría el orden relevante. El modelo inmediato, por su parte, predice exactamente el nivel basal al final de las dos secuencias, porque ambas terminan con descanso.
Estos números son consecuencias de parámetros elegidos, no tamaños de efecto esperables en una población. Para proponer un estudio habría que compararlos con la precisión alcanzable y con variaciones plausibles de los parámetros. Un diseño capaz de distinguir curvas separadas por varios milisegundos podría ser insuficiente para separar las de este ejemplo. La elección de intervalos y momentos de medición debería apoyarse en esa evaluación previa, manteniendo el vínculo entre la pregunta mecanística y la señal que se pretende observar.
Asignar las secuencias al azar ayudaría a evitar que las personas con respuestas basales más lentas recibieran sistemáticamente una de ellas. Si cada persona realizara ambas, habría que considerar el orden de las sesiones y la recuperación entre ellas. La comparación presupone que las secuencias manipulan la demanda prevista y que no cambian otras condiciones de forma diferencial. Por ejemplo, anunciar de antemano descansos distintos podría modificar la estrategia durante la tarea. Esa posibilidad pide una decisión de diseño o una ampliación del modelo, no una reinterpretación automática del coeficiente de retención.
Además del contraste final, registrar la trayectoria completa permitiría comprobar dónde comienza una discrepancia. Una respuesta elevada ya al inicio sugiere revisar el nivel basal o el estado inicial. Una divergencia que aparece con la repetición de la tarea podría señalar aprendizaje, acumulación no lineal o cambios de estrategia. Cada explicación nueva tendría que traducirse en consecuencias diferentes para algún protocolo. Añadir componentes que solo absorban los residuos del registro disponible reduce la capacidad de aprender de una comparación posterior.
Una manipulación adicional podría dirigirse a la recuperación que el modelo propone. Tendría que definirse una actividad concreta durante los intervalos de descanso y justificar por qué se espera que cambie la retención. Bajo la hipótesis de que solo modifica ese parámetro, se predecirían cambios relacionados en la subida y en la bajada de la curva. Si también cambiara la manera de responder a la prueba, la interpretación sería distinta. La especificación previa de qué ecuación recibe la intervención permite reconocer esa diferencia y buscar observaciones que la resuelvan.
Esta estrategia requiere evitar una circularidad: elegir cualquier actividad que acelere la respuesta y concluir después que actúa sobre la recuperación. La hipótesis mecanística debe apoyarse en razones independientes para asignar la intervención a un componente, y la trayectoria completa ofrece restricciones adicionales para evaluarla. Dos actividades podrían producir la misma respuesta final a través de componentes distintos. Comparar únicamente ese punto dejaría sin resolver si cambió la carga acumulada, su persistencia o su expresión en la prueba.
Qué parámetros pueden conocerse
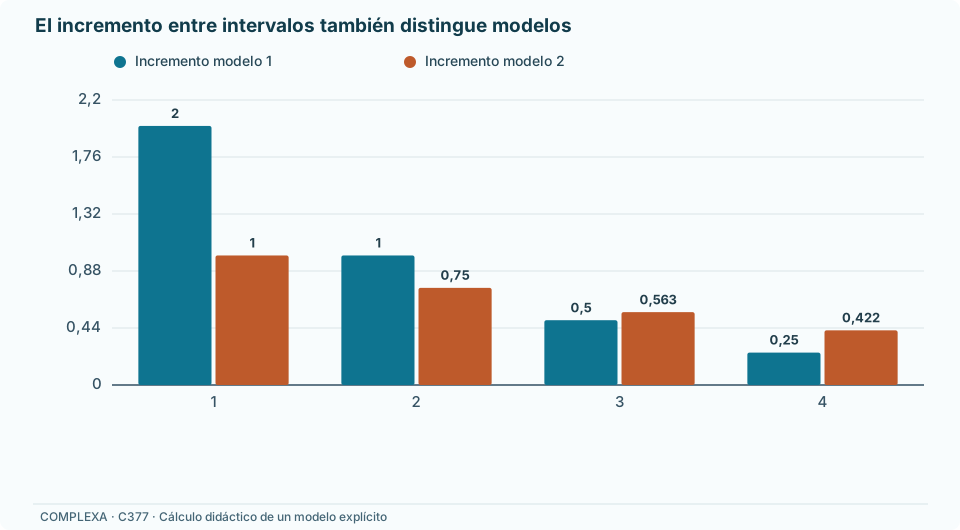
La identificabilidad pregunta si distintos valores de los parámetros pueden producir exactamente las mismas observaciones previstas, dadas las entradas y mediciones permitidas. En el modelo completo aparece una invariancia sencilla. Si multiplicamos el estado por una constante positiva , multiplicamos también por y dividimos por esa misma constante, todas las medias de respuesta permanecen iguales. El nuevo estado usa otra escala, pero su traducción a milisegundos no cambia.
Por ejemplo, con la misma retención, elegir y produce las mismas observaciones que elegir y . Esto ocurre para cualquier secuencia de demanda, manteniendo el inicio nulo, y no únicamente para los protocolos ilustrados. La equivalencia se demuestra sustituyendo la transformación en ambas ecuaciones. Ninguna cantidad adicional de mediciones del mismo tipo puede decidir cuál de esas escalas latentes es la correcta. Puede fijarse una por convenio, pero el convenio debe distinguirse de un descubrimiento sobre la magnitud física de la carga.
La situación de y depende de la información temporal. Los equilibrios solo determinan su cociente . Con un inicio nulo, nivel basal conocido y una entrada de intensidad uno, las dos primeras medias transitorias satisfacen y . Si la primera es distinta de cero, permiten recuperar exactamente y . Los valores dos y tres del primer ejemplo determinan así una retención de un medio. Una entrada que no produzca señal no proporciona esa información.
La diferencia entre ambas dificultades orienta el siguiente estudio. Para separar retención e incremento observado hacen falta transitorios informativos. Para separar la escala interna y su conversión a milisegundos hace falta una convención explícita o una observación adicional que ancle esa escala. Medir otro indicador puede ayudar si su relación con el estado está suficientemente restringida. Añadir simplemente otro coeficiente de conversión desconocido puede conservar la misma invariancia y dejar intacto el problema.
Raue y colaboradores (2009) distinguen la falta de identificabilidad debida a relaciones estructurales entre parámetros de las limitaciones prácticas de información. Su análisis mediante perfiles de verosimilitud examina cuánto puede variar un parámetro mientras los demás se reajustan. La interpretación depende del modelo, de la observación y del criterio estadístico. En nuestro ejemplo, la invariancia de escala se demuestra algebraicamente; un perfil aproximadamente plano calculado sobre una malla finita sería una indicación numérica que requeriría examinarse, no una demostración equivalente de esa identidad exacta.
Incluso los parámetros recuperables en condiciones ideales pueden quedar poco determinados con observaciones imprecisas. Supongamos, solo para ilustrarlo, que el nivel basal es conocido y que los excesos de las dos primeras medias están acotados por y . Aplicando la fórmula anterior, la retención compatible puede ir aproximadamente de a . Son límites algebraicos a partir de intervalos impuestos, no un intervalo de confianza calculado con datos. Muestran cómo una incertidumbre aparentemente pequeña en las medias puede propagarse a una incertidumbre considerable sobre la dinámica.
Calibrar y poner a prueba responden a preguntas diferentes
Calibrar consiste en ajustar valores dentro de un modelo especificado usando cierta información. Podríamos calibrar su ganancia estacionaria para reproducir un exceso hipotético de cuatro milisegundos. Ese resultado permitiría predecir otro equilibrio bajo proporcionalidad lineal, pero dejaría abiertas numerosas velocidades de adaptación. Presentar luego el mismo equilibrio como una comprobación independiente del mecanismo contaría dos veces la información empleada para elegirlo.
Una prueba más informativa reservaría un cambio de entrada que no intervino en la calibración: comienzo de la actividad, retirada de la demanda o variación del espaciado. Las predicciones deberían incluir la incertidumbre de los parámetros y de la medición. Si la calibración solo ha restringido la ganancia, el conjunto predictivo transitorio será amplio. No sería legítimo seleccionar dentro de ese conjunto la trayectoria que mejor coincide con el nuevo registro y describirla como una predicción puntual realizada de antemano.
Reservar observaciones también exige atender a su dependencia. Dividir al azar las filas de una misma sesión puede dejar en ambos grupos mediciones vecinas que comparten condiciones iniciales, características de la persona y perturbaciones no registradas. Predecir esas filas retenidas evalúa una tarea distinta de anticipar una secuencia nueva en otra sesión. La partición debería corresponder a la afirmación deseada. Para evaluar el espaciado, por ejemplo, tendría sentido ajustar con determinadas secuencias y conservar otra organización temporal completa para el contraste, documentando qué parámetros se comparten y cuáles podrían variar.
La libertad para reajustar importa tanto como la elección de observaciones. Si se permite un nivel basal nuevo en cada sesión, la predicción puede evaluarse respecto a una medición basal independiente. Si además se permite una ganancia y una retención distintas para cada secuencia, desaparece gran parte de la prueba del mecanismo común. Tales diferencias pueden ser plausibles, pero requieren una explicación de por qué cambian los parámetros y alguna restricción que conecte las condiciones. La comparación gana contenido cuando esas reglas se establecen antes de conocer el resultado que podrían acomodar.
La sensibilidad de las predicciones y la precisión de los parámetros tampoco son intercambiables. Gutenkunst y colaboradores (2007) estudiaron diecisiete modelos de biología de sistemas y encontraron sensibilidades muy desiguales a diferentes combinaciones de parámetros. En sus análisis, algunas predicciones podían quedar restringidas aunque los parámetros individuales conservaran mucha incertidumbre. Esa desigualdad de sensibilidad no equivale por sí misma a una invariancia exacta. Nuestro modelo permite ver la diferencia: el equilibrio puede conocerse con precisión mientras la respuesta a un pulso sigue siendo incierta, y la escala latente puede permanecer indeterminada aun con toda la trayectoria observable conocida.
Las comprobaciones con datos generados por el propio modelo sirven para evaluar el procedimiento de análisis. Wilson y Collins (2019) describen la recuperación de parámetros y de modelos mediante simulaciones con generadores conocidos. Esas comprobaciones permiten detectar estimaciones sesgadas, confusión entre candidatos o regiones mal informadas del espacio de parámetros. Su alcance depende de las condiciones ensayadas. Una buena recuperación dentro de un conjunto de modelos no establece que alguno represente el proceso real; esa cuestión exige confrontar las predicciones con observaciones empíricas.
En una aplicación a nuestro problema, convendría simular las secuencias previstas bajo diversas retenciones, estimarlas con el procedimiento elegido y comprobar dónde se confunden. Antes de disponer de registros reales, eso permitiría mejorar el diseño. Después, la adecuación requeriría examinar si el modelo reproduce rasgos relevantes de las respuestas observadas, incluidos los que no determinaron directamente el ajuste. Aquí se han comprobado las consecuencias algebraicas de las reglas propuestas; no se ha realizado esa validación empírica ni una estimación con participantes.
La unidad temporal y la persona promedio
Cambiar el reloj puede cambiar la interpretación de un parámetro sin cambiar el proceso que se pretende describir. Si agrupamos dos intervalos de cinco minutos y mantenemos la misma intensidad en ambos, sustituir dos veces la recurrencia da una retención de y un incremento de por intervalo de diez minutos. Para la primera parametrización, los nuevos valores son un cuarto y tres milisegundos. Su ganancia estacionaria continúa siendo cuatro.
La conversión exige que la entrada sea constante dentro del intervalo agregado. Cuando una mitad contiene actividad y la otra descanso, el orden sigue importando y una sola intensidad media pierde información. Usar el mismo valor numérico de retención para intervalos de cinco y diez minutos describiría procesos distintos. Por ello, comparar parámetros entre estudios requiere revisar la resolución temporal, el momento de observación y la forma en que se codifica la exposición, incluso si las ecuaciones escritas parecen idénticas.
También importa la unidad de análisis. Supongamos una mezcla didáctica de dos tipos de personas, en proporciones iguales, con el mismo nivel basal y el mismo exceso estacionario de cuatro milisegundos. Un tipo retiene un cuarto del estado observable por intervalo y añade tres milisegundos con cada entrada estándar; el otro retiene tres cuartos y añade uno. La retención media de los dos tipos es un medio. Sin embargo, aplicar esa media dentro de una sola recurrencia no reproduce en general la trayectoria promedio.
Al comenzar una demanda constante desde cero, la mezcla alcanza excesos medios de dos, y milisegundos en las tres primeras fronteras. El modelo homogéneo con retención un medio y ganancia cuatro produce dos, tres y . Durante el descanso desde el equilibrio, ambos predicen un exceso de dos después del primer intervalo; después del segundo, la mezcla predice y el modelo homogéneo uno. La coincidencia inicial oculta que el promedio mezcla velocidades de recuperación.
Una curva grupal podría, por tanto, sugerir una dinámica más compleja aunque cada participante siguiera una regla sencilla. Para atribuir esa complejidad a un mecanismo dentro de las personas sería necesario distinguirla de la heterogeneidad entre ellas. Registros repetidos por participante, condiciones comparables y un modelo explícito de variación individual aportarían información relevante. El ejemplo no decide qué nivel es apropiado en una aplicación; muestra qué se pierde cuando una media grupal se trata como si correspondiera directamente a un individuo representativo.
El criterio para conservar una simplificación depende de la pregunta que se quiere responder. Si solo interesa anticipar el equilibrio promedio para intensidades constantes, los modelos comparados resultan intercambiables en el ejemplo. Para decidir dónde situar un descanso, sus diferencias transitorias pasan a ser relevantes. Una descripción puede ser suficiente para la primera tarea e insuficiente para la segunda. Documentar esa dependencia permite evaluar el modelo por predicciones definidas, en vez de atribuirle una validez general que no distingue usos ni condiciones de observación.
Incluso una predicción transitoria acertada puede ser compartida por mecanismos distintos. Un estado residual podría representar acumulación de recursos consumidos, interferencia entre operaciones o un cambio persistente de estrategia, si esas propuestas se formalizaran con la misma relación de entrada y salida. Los nombres no rompen la equivalencia. Para diferenciarlos harían falta observaciones o manipulaciones sobre las que esas propuestas hagan compromisos adicionales. El éxito temporal restringiría el conjunto de explicaciones admisibles hasta ese punto, sin decidir por sí solo cuál de sus realizaciones opera.
Revisar una explicación conservando sus compromisos
Una discrepancia empírica tiene interés cuando puede localizarse. Si el exceso aumentara durante descansos repetidos bajo condiciones controladas, la recurrencia positiva con retención menor que uno no describiría esa evolución media. Habría que examinar si la entrada realmente representa descanso, si el indicador tiene un retraso propio o si falta un proceso que continúa actuando después de la tarea. Esas posibilidades implican modelos diferentes y deberían producir diferencias observables en nuevos protocolos.
El error de medición exige formular el desacuerdo a la escala adecuada. Con observaciones ruidosas, una respuesta individual mayor que la anterior puede ocurrir aunque la media disminuya. La evaluación debe considerar la distribución prevista y la repetición de patrones de residuales, además de la curva media. Si se permite modificar libremente la media del error para cada condición, desaparece la restricción que conectaba el estado con la observación. Una revisión útil explicita qué componente cambia y qué nueva regularidad obliga a ese cambio.
Hay revisiones que aportan una hipótesis sustantiva: incorporar aprendizaje que reduzca el nivel basal con la práctica, permitir que la recuperación dependa de la actividad o introducir un segundo estado con otra duración. Cada ampliación necesita datos que informen sus parámetros y una comparación con la versión más sencilla. Una mejor coincidencia en el registro utilizado para construirla puede justificar explorar la ampliación, pero su contribución explicativa se vuelve más clara cuando anticipa una diferencia que la versión previa no podía representar.
Volvamos a las dos secuencias de veinte minutos. La parametrización residual utilizada predice que el momento del último episodio de demanda modifique la respuesta final, bajo condiciones compartidas. La explicación inmediata exige el retorno al nivel basal después del último intervalo de descanso. La siguiente observación relevante queda así definida: medir la respuesta en fronteras temporales comparables, estimar su incertidumbre y comprobar la persistencia que separa ambas propuestas. Si aparece persistencia, aún habrá que distinguir velocidades, heterogeneidad y procesos alternativos que también la produzcan. La teoría evaluable termina esta etapa con una predicción concreta y con la información que falta para interpretar su resultado.
Referencias
Borsboom, D., van der Maas, H. L. J., Dalege, J., Kievit, R. A., y Haig, B. D. (2021). Theory Construction Methodology: A Practical Framework for Building Theories in Psychology. Perspectives on Psychological Science, 16(4), 756–766. https://doi.org/10.1177/1745691620969647
Guest, O., y Martin, A. E. (2021). How Computational Modeling Can Force Theory Building in Psychological Science. Perspectives on Psychological Science, 16(4), 789–802. https://doi.org/10.1177/1745691620970585
Gutenkunst, R. N., Waterfall, J. J., Casey, F. P., Brown, K. S., Myers, C. R., y Sethna, J. P. (2007). Universally Sloppy Parameter Sensitivities in Systems Biology Models. PLoS Computational Biology, 3(10), e189. https://doi.org/10.1371/journal.pcbi.0030189
Raue, A., Kreutz, C., Maiwald, T., Bachmann, J., Schilling, M., Klingmüller, U., y Timmer, J. (2009). Structural and practical identifiability analysis of partially observed dynamical models by exploiting the profile likelihood. Bioinformatics, 25(15), 1923–1929. https://doi.org/10.1093/bioinformatics/btp358
van Rooij, I., y Baggio, G. (2021). Theory Before the Test: How to Build High-Verisimilitude Explanatory Theories in Psychological Science. Perspectives on Psychological Science, 16(4), 682–697. https://doi.org/10.1177/1745691620970604
Wilson, R. C., y Collins, A. G. E. (2019). Ten simple rules for the computational modeling of behavioral data. eLife, 8, e49547. https://doi.org/10.7554/eLife.49547