Un equipo recibe los datos y el programa de una investigación, ejecuta las instrucciones y obtiene la tabla publicada. Otro realiza nuevas mediciones y encuentra una estimación cercana, aunque menos precisa. Un tercero acepta ambas tablas, pero considera que ninguna identifica el mecanismo propuesto. Las tres situaciones evalúan aspectos diferentes del trabajo. Para entender qué se ha confirmado hay que describir la operación realizada, la afirmación que estaba en juego y la incertidumbre que permanece.
La terminología tampoco resuelve por sí misma esa distinción. Goodman, Fanelli e Ioannidis (2016) señalan que el vocabulario de la reproducibilidad carece de un uso uniforme entre disciplinas. Por eso, una afirmación como «el resultado se reprodujo» necesita información adicional: quién utilizó qué datos, qué decisiones volvió a ejecutar y qué criterio empleó para juzgar la concordancia. La identidad de dos cifras puede ser una comprobación adecuada del cálculo y una comprobación insuficiente de la explicación científica.
Adoptaremos las definiciones del informe de las National Academies of Sciences, Engineering, and Medicine (2019). La reproducibilidad computacional consiste en obtener resultados consistentes utilizando los mismos datos de entrada, pasos computacionales, métodos, código y condiciones de análisis. La replicabilidad se refiere a la consistencia entre estudios que intentan responder la misma pregunta y obtienen sus propios datos. Esa consistencia se juzga considerando la incertidumbre; no exige que las estimaciones coincidan dígito por dígito. La generalización añade la cuestión de si una afirmación se sostiene en otros contextos o poblaciones.
Esta convención permite formular preguntas concretas sin suponer que todos los campos emplean las palabras del mismo modo. Una investigación puede ser computacionalmente reproducible y producir una estimación sesgada. Una réplica puede ofrecer datos informativos sin coincidir exactamente con la estimación anterior. También puede haber desacuerdo sobre la interpretación de cálculos que nadie discute. Cada situación requiere una comprobación diferente y deja una huella distinta en el conocimiento acumulado.
Qué se comprueba al volver a ejecutar un análisis
El resultado computacional depende de una cadena de transformaciones. Una tabla de entrada se filtra, algunas variables cambian de escala, se combinan registros, se estiman parámetros y se redondean salidas. El artículo suele mostrar únicamente los últimos eslabones. Para reconstruir el cálculo es necesario conocer también las decisiones que determinaron qué observaciones llegaron hasta ellos. Un programa que comienza con una tabla ya depurada puede reproducir el ajuste estadístico mientras deja sin documentar la exclusión de participantes o la resolución de registros duplicados.
Por esa razón, la unidad que conviene conservar es el análisis con su procedencia. Los datos necesitan definiciones de variables, unidades, códigos de ausencia y reglas de vinculación. El código debe indicar qué entradas consume y qué salidas produce. Las versiones de las dependencias permiten reconocer cambios de comportamiento entre instalaciones. Cuando interviene aleatoriedad computacional, las semillas y la descripción del generador ayudan a reconstruir una ejecución. Munafò et al. (2017) sitúan la apertura de datos, materiales, software y procedimientos entre las prácticas que facilitan el examen de una investigación.
La precisión de esa reconstrucción depende del método. Un cálculo determinista sobre enteros puede requerir igualdad exacta. En operaciones con números de punto flotante pueden aparecer diferencias de redondeo entre sistemas. Un algoritmo estocástico puede producir estimaciones ligeramente distintas incluso cuando se ha aplicado el mismo procedimiento científico. El criterio de concordancia debe especificar qué salidas se comparan y con qué tolerancia. Si la tolerancia es mayor que el efecto que sostiene la conclusión, conservar cifras parecidas aporta poca información sobre esa conclusión.
Una ejecución en un entorno separado ayuda a distinguir las instrucciones documentadas de las condiciones accidentales del ordenador original. Puede revelar que falta un archivo auxiliar, que una ruta depende de una carpeta personal o que el programa utiliza una tabla creada manualmente durante una sesión anterior. La reconstrucción debe comenzar desde entradas identificadas y permitir seguir el origen de cada salida. Además del resultado final, conviene comprobar propiedades intermedias con significado: cuántos registros entran en una unión de tablas, cuáles quedan sin correspondencia y cómo cambia el denominador después de una exclusión. Así puede localizarse un error aunque el total final parezca razonable.
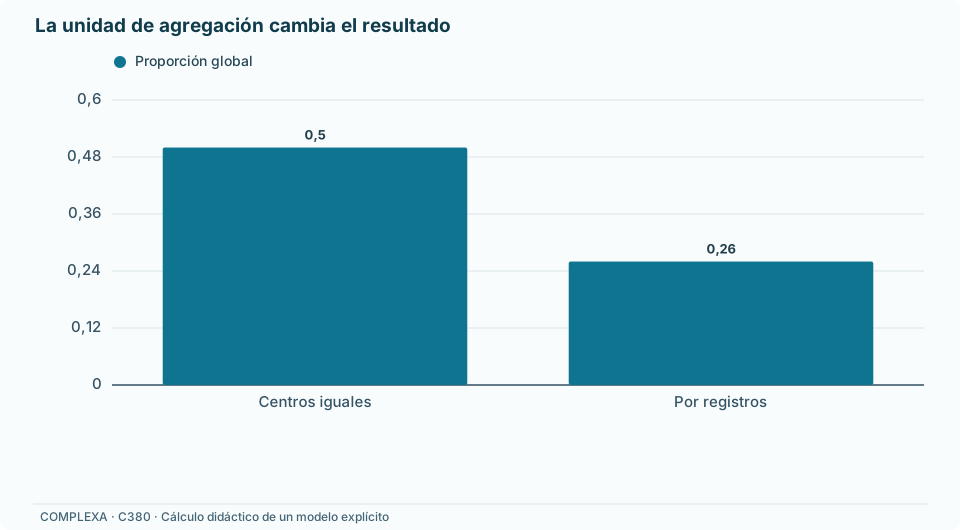
La reproducibilidad tampoco decide si se calculó la cantidad pertinente. Consideremos un ejemplo exclusivamente didáctico con dos centros ficticios. El primero contiene diez registros y ocho cumplen un criterio binario. El segundo contiene noventa registros y dieciocho cumplen ese criterio. Las proporciones por centro son, respectivamente, ochenta y veinte por ciento. Si cada centro recibe el mismo peso, su promedio es cincuenta por ciento. Si cada registro recibe el mismo peso, la proporción conjunta es veintiséis por ciento:
Ambos resultados pueden obtenerse repetidamente con programas correctos. El primero responde a la proporción entre los registros reunidos. El segundo responde al promedio de las proporciones de esos dos centros, con igual ponderación institucional. Si el objetivo declarado era describir a las personas representadas por todos los registros, presentar el promedio de centros cambia la población objetivo. Si se buscaba describir un centro escogido con igual probabilidad entre los dos, esa ponderación tendría sentido. Ninguna ejecución adicional decide cuál era la pregunta que debía responderse.
Una revisión útil reconstruiría el denominador antes de comprobar los decimales. Preguntaría qué representa una fila, si las personas pueden aparecer varias veces y por qué los centros reciben ciertos pesos. Después contrastaría la operación implementada con la definición del estimando. Reimplementar ese cálculo de forma independiente puede descubrir una discrepancia que permanece invisible al ejecutar repetidamente el mismo código. Esta comprobación del procedimiento usa todavía los datos originales; no constituye una nueva observación del fenómeno estudiado.
También conviene distinguir la identificación de los archivos de la validación de su contenido. Una huella digital permite reconocer que dos copias contienen los mismos bytes. No establece que los valores correspondan a mediciones correctas ni que las etiquetas de las variables sean apropiadas. Del mismo modo, un archivo sintético puede servir para verificar que el programa maneja correctamente fechas, duplicados y valores ausentes. Ese éxito comprueba propiedades de la implementación frente a entradas construidas, sin añadir evidencia empírica sobre una población real.
En algunos trabajos los datos originales no pueden distribuirse libremente. La documentación debe expresar qué parte del cálculo puede inspeccionarse, bajo qué condiciones existe acceso y qué resultados dependen de información restringida. Una versión sintética o un resumen agregado puede hacer visibles determinados pasos, pero conviene señalar los que no permite reconstruir. La limitación se evalúa por operación: quizá sea posible comprobar una fórmula y no la selección original de registros. Esta descripción resulta más informativa que atribuir una única condición de apertura a todo el estudio.
Fijar un plan antes de conocer los resultados
El prerregistro introduce una referencia temporal para las decisiones de investigación. Nosek et al. (2018) lo describen como el compromiso con un plan de análisis sin conocimiento previo de los resultados que podrían orientar esas decisiones. El registro conserva qué se pretendía preguntar y cómo se utilizarían los datos para responder. Su utilidad depende de que el plan sea suficientemente preciso para compararlo después con lo realizado.
Supongamos que un equipo ficticio quiere comparar dos procedimientos de coordinación en una tarea experimental. «Evaluaremos si mejora el desempeño» deja abiertas muchas elecciones: velocidad, errores, puntuación combinada, cambio desde la línea de base o resultado final. Tampoco define quién integra la comparación ni qué hacer con una sesión interrumpida. Un plan interpretable especificaría la población elegible, la asignación de procedimientos, el resultado principal, el momento de medición y la cantidad que se pretende estimar. La fórmula del modelo tendría sentido dentro de esas decisiones.
Las reglas de exclusión deben poder aplicarse sin elegir el conjunto que produce la estimación más favorable. Si una sesión se considera técnicamente inválida cuando falla el dispositivo, hace falta definir qué registro demuestra ese fallo. Si una respuesta extrema se conserva o se transforma, debe describirse el criterio. Es distinto excluir una medición imposible por razones instrumentales que eliminar una observación porque reduce la magnitud del contraste. Documentar esas reglas permite reconocer qué cambios modifican el conjunto de datos y cuáles corrigen errores verificables de captura.
El plan también necesita una regla de finalización. Recoger datos hasta alcanzar una cantidad fijada plantea una distribución de muestreo diferente de inspeccionar sucesivamente el contraste y detenerse cuando cruza un umbral. Los diseños secuenciales pueden ser válidos, pero su análisis debe incorporar las oportunidades de detenerse. Una frase que permita terminar «cuando los resultados sean suficientes» no especifica esa regla. El problema aparece al tratar una secuencia de decisiones dependientes de los resultados como si se hubiese realizado una única evaluación predeterminada.
La ausencia de datos requiere decisiones similares. Declarar que se utilizarán los casos completos describe un procedimiento, pero no justifica sus supuestos. Puede ser necesario explicar por qué las personas con mediciones disponibles representan la población objetivo bajo el modelo adoptado, o qué análisis explorará otras hipótesis sobre la ausencia. El prerregistro vuelve observable la decisión anterior a los resultados. Su calidad estadística depende además de argumentos sobre el diseño, el proceso de medición y la información que falta.
En una pregunta causal, especificar anticipadamente una regresión tampoco define por completo el contraste. Es necesario indicar qué intervención se compara, frente a qué alternativa y en qué población. Una variable medida después de la intervención puede actuar como mediadora. Ajustar por ella puede cambiar la cantidad estimada respecto del efecto total originalmente buscado, aun cuando el ajuste estuviera registrado. El examen del plan debe relacionar la lista de variables con una explicación de sus funciones temporales y causales. Si se descubre después que una variable se midió en otro momento, la corrección requiere reconsiderar esa explicación, además de modificar la fórmula del programa. La fecha del registro y la pertinencia del estimando responden a cuestiones diferentes.
Los datos existentes no excluyen automáticamente un análisis prospectivamente especificado. Nosek et al. (2018) plantean que lo relevante es qué resultados conocían quienes formularon las decisiones. Un archivo puede haber sido recolectado años antes y mantenerse oculto para el equipo que fija una hipótesis. En cambio, un plan fechado antes de abrir el archivo local puede incorporar resultados que sus integrantes ya conocían por informes previos. La descripción debe incluir ese conocimiento: resúmenes consultados, asociaciones examinadas y decisiones que pudieron verse influidas por ellos.
Considérese una secuencia hipotética: el equipo escribe el plan el lunes, recibe las tablas descriptivas el martes y registra una versión el miércoles. La fecha del miércoles acredita la existencia de ese documento, pero no demuestra que su contenido se fijara sin conocimiento de las tablas. Si el lunes quedó conservada una versión y el miércoles se añadió una regla, ambas pueden documentarse. La interpretación depende de qué cambió y de qué información estaba disponible, no de atribuir una propiedad uniforme a todas las decisiones del proyecto.
La precisión tampoco exige anticipar cada contingencia imaginable. Puede fijarse un árbol de decisiones basado en propiedades relevantes de los datos, siempre que se especifiquen sus ramas y su justificación. Por ejemplo, una regla de convergencia puede indicar qué procedimiento alternativo se aplicará si el estimador principal no alcanza una solución. Pero una rama que permita elegir retrospectivamente entre muchos resultados favorables conserva la selección que pretendía hacerse visible. El contenido del plan determina qué decisiones quedan efectivamente restringidas.
Desviaciones, exploración y selección de resultados
Un plan prospectivo puede contener un error. Un instrumento puede fallar de una forma no prevista, o una variable puede estar codificada de manera distinta a la documentada. Mantener una decisión inadecuada únicamente para conservar concordancia con el registro deterioraría el análisis. Nosek et al. (2018) admiten desviaciones y requieren que se explique qué cambió y por qué. La información temporal sigue siendo relevante: una corrección decidida antes de conocer el contraste no tiene la misma historia que una modificación motivada por su magnitud.
Una descripción verificable conserva el análisis previsto, cuando sigue siendo interpretable, y distingue el análisis revisado. Puede indicar que la variable originalmente elegida tenía una unidad incorrecta, mostrar cómo se detectó el problema y explicar la transformación aplicada. Si el procedimiento inicial carece de sentido, debe expresarse esa razón en lugar de producir una tabla engañosa por obligación formal. Lo que se necesita para interpretar el cambio es una conexión entre el problema detectado, la decisión adoptada y sus consecuencias sobre el resultado.
La exploración cumple una función distinta. Al inspeccionar los datos pueden aparecer patrones que sugieran nuevas hipótesis o variables relevantes. Su valor depende de presentarlos con la historia que realmente tuvieron. Una relación elegida después de comparar muchas alternativas ha pasado por una selección que una hipótesis fijada previamente no experimentó. Esa diferencia altera la interpretación de los cálculos de incertidumbre cuando estos ignoran el proceso que condujo a elegir la relación.
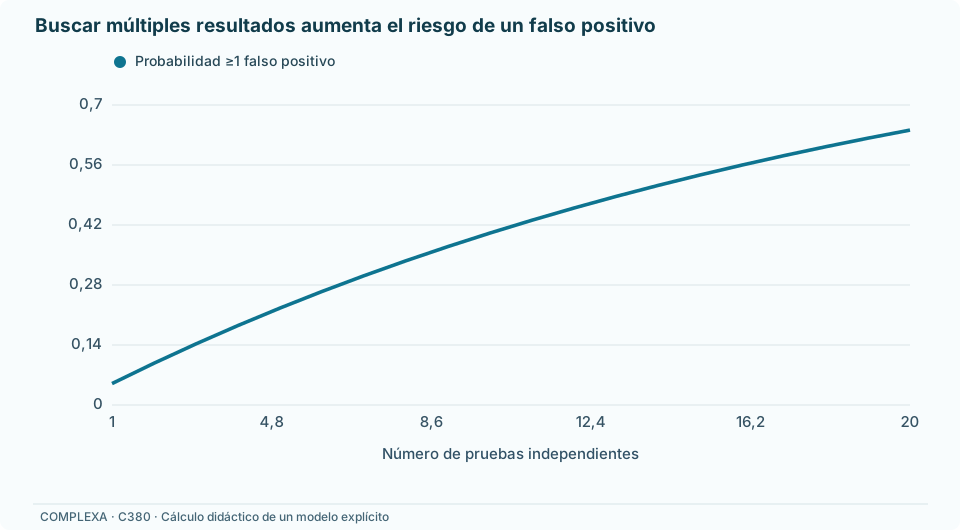
Un cálculo didáctico permite medir una parte del problema. Supongamos diez pruebas independientes, todas bajo hipótesis nulas verdaderas, cada una con probabilidad de rechazo de cinco por ciento. La probabilidad de que ninguna rechace es el producto de sus probabilidades de no rechazo. Por tanto, la probabilidad de obtener al menos un rechazo es:
En estas condiciones, el conjunto ofrece aproximadamente un cuarenta por ciento de probabilidad de producir algún resultado que cruce el umbral. La cifra depende de la independencia y del supuesto de que todas las hipótesis nulas sean verdaderas. Con pruebas dependientes, el producto anterior no es la expresión general. Tampoco representa la probabilidad de que una afirmación publicada sea falsa: para esa pregunta harían falta un modelo de las hipótesis investigadas, sus alternativas y el proceso de selección y publicación.
Si se informa únicamente la prueba que rechazó, el lector no puede reconocer las diez oportunidades de obtener ese resultado. Registrar las pruebas permite conocer el conjunto previsto, pero todavía hace falta informar qué se ejecutó y qué se obtuvo. Un registro que contiene muchos resultados y un artículo que conserva solamente el favorable mantienen una forma de selección. Munafò et al. (2017) relacionan los problemas de información selectiva con prácticas que hacen visibles los métodos y resultados completos.
Además, el plan debe distinguir una decisión sobre un resultado principal de una decisión que puede activarse ante cualquiera de varios resultados. Esa diferencia define qué conjunto de oportunidades debe considerar el control del error. Publicar todas las pruebas hace visible el problema; la regla de análisis determina cómo se aborda estadísticamente.
Las hipótesis surgidas de una exploración pueden contrastarse con datos nuevos o con una parte de los datos reservada de antemano. Esa separación exige controlar el flujo de información. Si las transformaciones, exclusiones o variables se eligieron examinando el conjunto reservado, la independencia entre generación y evaluación de la hipótesis se ha debilitado. No basta con ejecutar al final un programa sobre un archivo llamado «validación»; importa si sus resultados ya participaron en las decisiones que ahora se evalúan.
Los informes registrados incorporan revisión de la pregunta y de los métodos antes de observar los resultados, con una aceptación inicial sujeta a la ejecución acordada. Nosek et al. (2018) los presentan como una forma de reducir la dependencia editorial respecto del desenlace obtenido. Este procedimiento permite discutir de antemano si el diseño sería informativo tanto ante un resultado favorable como ante uno desfavorable. Conserva, sin embargo, la necesidad de revisar la ejecución, explicar las desviaciones y evaluar la adecuación de los supuestos.
Qué afirmación pone a prueba una réplica
Una réplica necesita una afirmación suficientemente precisa para que sus posibles resultados tengan consecuencias. Nosek y Errington (2020) proponen definirla por su capacidad de aportar evidencia diagnóstica sobre una afirmación anterior. Un resultado concordante debe aumentar la confianza en ella, y uno discordante debe poder reducirla. Esa definición obliga a explicar antes del estudio qué condiciones se consideran relevantes para esperar el fenómeno y qué diferencias harían que el nuevo estudio dejara de responder a la misma pregunta.
La repetición exacta de todas las condiciones es imposible: cambian participantes, momentos y circunstancias. Una teoría puede considerar irrelevantes algunos cambios y esenciales otros. Si se afirma que un mecanismo aparece bajo una clase amplia de condiciones, contrastarlo en otro lugar aporta información sobre ese alcance. Si, después de cada resultado discordante, se añade una condición que nunca se había especificado, la afirmación cambia y debe documentarse como tal. Los nuevos límites pueden ser científicamente productivos cuando generan predicciones que también admiten un resultado desfavorable.
Nosek y Errington (2020) señalan que toda réplica implica alguna generalización a condiciones nuevas, pero que una prueba de generalización no siempre funciona como réplica. Imaginemos que una afirmación se limita explícitamente a adultos y que un nuevo estudio trabaja con niños. Si un resultado discordante se interpretaría únicamente como un límite de edad, sin cuestionar la afirmación sobre adultos, esa prueba tiene un alcance diferente. Para que evaluara una afirmación más amplia habría que haber formulado precisamente ese alcance. La relación entre los estudios depende de la afirmación sometida a examen, además de la semejanza entre sus procedimientos.
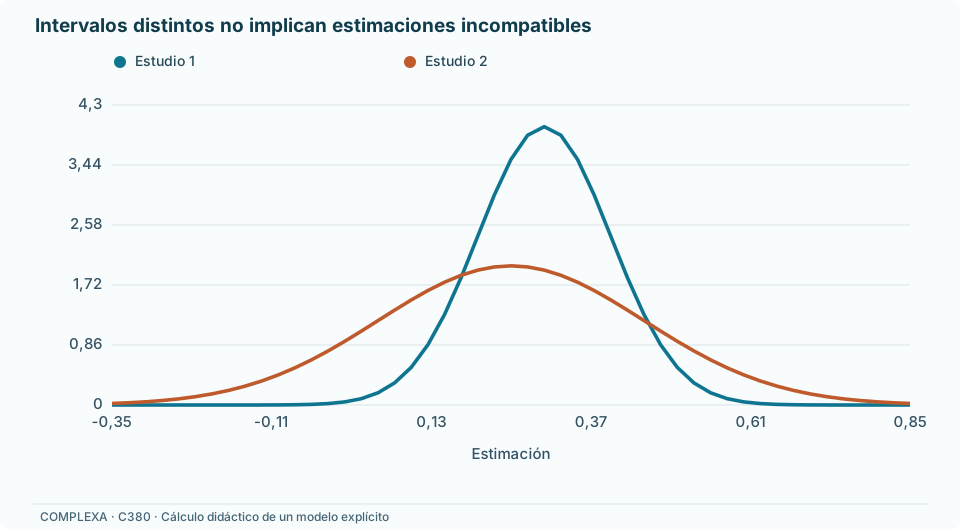
La compatibilidad entre estudios tampoco puede reducirse a comprobar si ambos cruzan el mismo umbral estadístico. Construyamos dos estimaciones independientes de una misma cantidad, en unidades abstractas, con errores normales y errores estándar conocidos. El primer estudio didáctico obtiene una estimación de 0,30 y un error estándar de 0,10. El segundo obtiene 0,25 y un error estándar de 0,20. Sus intervalos aproximados del noventa y cinco por ciento, calculados con el multiplicador 1,96, son:
El primero excluye cero y el segundo lo incluye. Las estimaciones puntuales, sin embargo, difieren solamente en 0,05. Bajo la independencia estipulada, el error estándar de su diferencia es la raíz cuadrada de la suma de las dos varianzas, aproximadamente 0,224. El intervalo correspondiente para la diferencia es aproximadamente de −0,388 a 0,488. La distinta clasificación de los dos resultados se explica aquí por una diferencia de precisión; no constituye por sí misma evidencia de que los efectos sean distintos.
El intervalo de la diferencia es amplio y tampoco demuestra equivalencia. Para evaluar si las dos cantidades son suficientemente cercanas haría falta definir una discrepancia de relevancia científica y diseñar una comparación con precisión adecuada para ese margen. La ausencia de una diferencia detectada admite efectos compatibles con una separación considerable en ambas direcciones. Por tanto, tanto declarar contradicción a partir de los dos umbrales como declarar igualdad a partir de la comparación imprecisa excedería lo que muestra el ejemplo.
El diseño de una réplica debe considerar esa capacidad diagnóstica. Si un estudio es demasiado impreciso para distinguir la afirmación original de alternativas importantes, cualquiera de sus resultados moderados podrá coexistir con varias explicaciones. Además, planificar su tamaño usando exclusivamente una estimación original seleccionada por ser llamativa puede anticipar un efecto demasiado grande. Resulta más informativo explicitar qué magnitudes serían relevantes y qué precisión permitiría distinguirlas, junto con la incertidumbre que ya rodea la primera estimación.
Una discordancia informativa exige examinar también procedimientos y mediciones. El mismo nombre de una variable puede ocultar escalas o periodos distintos. Una diferencia de implementación puede cambiar la intervención realmente recibida. Según Nosek y Errington (2020), un resultado discordante puede reflejar un falso positivo inicial, un falso negativo posterior o límites de la afirmación. Distinguir esas posibilidades requiere nuevos contrastes y especificaciones; la etiqueta de réplica fallida no determina por sí sola cuál explicación corresponde.
Acumular estimaciones que pueden representar efectos diferentes
La acumulación necesita establecer primero qué se pretende combinar. Dos estudios pueden medir resultados diferentes, estimar efectos en poblaciones distintas o utilizar horizontes temporales incompatibles. Una transformación de escala ayuda únicamente si existe una correspondencia interpretable entre las cantidades. Convertir dos puntuaciones a unidades estandarizadas no demuestra que ambas representen el mismo constructo. El criterio de inclusión en una síntesis debe vincular los estimandos de los estudios con la pregunta común.
Cuando los efectos pueden variar entre contextos, la media de una distribución de efectos y el efecto esperable en un contexto nuevo responden a preguntas diferentes. Higgins, Thompson y Spiegelhalter (2009) desarrollan esta distinción en el metaanálisis de efectos aleatorios. Una media positiva puede coexistir con una distribución amplia que incluya efectos pequeños o de signo opuesto. Para interpretar esa situación hace falta examinar la heterogeneidad, además de la precisión con que se estima el centro de la distribución.
Un ejemplo construido permite separar las cantidades sin confundirlas con resultados clínicos. Supongamos cuatro estimaciones independientes: 0; 0,5; 1,5 y 2, en una misma escala abstracta. Cada una tiene una varianza de muestreo conocida de 0,04. Estipulamos además una varianza entre los efectos verdaderos de 0,36. Este último valor forma parte del modelo didáctico: no se ha estimado a partir de las cuatro cifras. Supondremos efectos verdaderos normales e independientes y errores de muestreo normales, independientes entre estudios y respecto de esos efectos.
Como las varianzas son iguales, la estimación de la media es el promedio simple, que vale 1. La varianza de cada estimación observada alrededor de la media poblacional incorpora la variación entre efectos y el error de muestreo: 0,36 más 0,04, es decir, 0,40. La varianza del promedio de cuatro estimaciones independientes es entonces 0,10. Con las varianzas conocidas que hemos estipulado, el intervalo normal aproximado del noventa y cinco por ciento para la media va de 0,380 a 1,620.
Para predecir el efecto verdadero de un quinto contexto independiente, procedente de la misma distribución, hay que incorporar su variación respecto de la media. La varianza del error de predicción suma 0,36 y 0,10, lo que da 0,46. El intervalo predictivo correspondiente se extiende aproximadamente de −0,329 a 2,329. El intervalo para la media excluye cero, mientras que el intervalo para un efecto verdadero nuevo lo incluye. Ambos cálculos son coherentes porque se refieren a cantidades distintas.
La predicción anterior se refiere al efecto verdadero del nuevo contexto. Si se quisiera predecir una estimación observada en ese contexto, habría que añadir también su error de muestreo. Con otra varianza de muestreo de 0,04, la varianza predictiva ascendería a 0,50. La diferencia entre predecir una cantidad y predecir su medición afecta, por tanto, a la amplitud del intervalo. Especificar el objeto de la predicción evita presentar toda incertidumbre futura bajo una única etiqueta.
Un análisis que impusiera un efecto común asignaría al promedio una varianza de 0,04 dividida entre cuatro, igual a 0,01. Esa mayor precisión dependería de suponer que no existe variación entre efectos. No describiría la incertidumbre bajo el modelo heterogéneo estipulado. En aplicaciones reales la heterogeneidad suele estimarse y su propia incertidumbre puede ser importante, especialmente con pocos estudios. Higgins et al. (2009) advierten sobre esa dificultad; los cálculos normales con varianzas conocidas de este ejemplo no constituyen una receta general para cualquier metaanálisis.
Tampoco basta con añadir una varianza entre estudios cuando todos comparten un mismo sesgo. Si emplean un instrumento que desplaza sistemáticamente la medición, su promedio puede conservar ese desplazamiento. Si las publicaciones seleccionan estimaciones grandes, la distribución observada de estudios puede diferir de la distribución que se pretendía resumir. Y si varios artículos reutilizan participantes, la independencia supuesta para calcular la precisión deja de cumplirse. Identificar esas relaciones exige reconstruir la procedencia de los resultados, no contar publicaciones como observaciones independientes.
La predicción a un nuevo contexto añade otra condición: debe ser razonable tratarlo como procedente de la distribución de efectos representada por el modelo. Un cambio de intervención, población o sistema de medición puede romper esa correspondencia. La heterogeneidad estimada dentro de los estudios disponibles no cuantifica automáticamente la incertidumbre de cualquier traslado imaginable. La pregunta sobre generalización necesita describir qué cambia y por qué la evidencia acumulada permite informar ese cambio.
Conservar la historia que permite actualizar una conclusión
Una síntesis verificable vincula cada estimación con su estudio, su población y su versión. Esa relación permite detectar publicaciones de seguimiento, análisis secundarios y correcciones que reutilizan la misma evidencia. Si un resultado publicado cambia tras corregir un programa, la versión anterior debe poder identificarse para actualizar las síntesis que la incorporaron. Conservar la trayectoria del cambio evita que dos versiones de una misma estimación se conviertan, por accidente, en dos contribuciones independientes.
La información sobre resultados previstos y ejecutados ayuda también a interpretar ausencias. Puede ocurrir que una medida se recogiera y no apareciera en el informe, o que un resultado planificado no pudiera obtenerse por un fallo documentado. Esas situaciones tienen consecuencias distintas. El registro prospectivo aporta una referencia para reconocerlas, mientras que el informe final explica lo sucedido. La disponibilidad de ambos documentos permite evaluar el conjunto de evidencia que pudo haberse observado, además del conjunto que terminó publicado.
Quien prepara una síntesis también toma decisiones que pueden depender de los resultados: qué poblaciones incluir, qué momento de seguimiento elegir y cómo resolver varias estimaciones del mismo estudio. Especificar esas reglas antes de examinar los contrastes facilita reconocer cambios posteriores. Una regla de selección debe preservar la pregunta común; elegir en cada artículo el momento con mayor efecto cambiaría el conjunto que se está promediando. Si aparecen estudios con mediciones no previstas, puede justificarse una modificación y conservarse su historia. También puede resultar necesario presentar conjuntos separados cuando sus cantidades no son comparables. La acumulación admite así diferencias informativas sin forzar a cada resultado a representar una única cantidad.
En ese trabajo, una ausencia de información debe conservar su significado. Que no se haya informado un desenlace no equivale a haber observado que el desenlace no cambió. Tampoco la falta de una estimación utilizable convierte un estudio en evidencia a favor de un efecto nulo. Puede saberse que existió una medición y desconocerse su resultado. Identificar esa situación deja visible una limitación del conjunto disponible y permite actualizar la síntesis si el dato aparece más adelante, sin atribuirle antes un valor inventado.
Los incentivos afectan esa disponibilidad. Si se reconoce únicamente la novedad de un resultado, resulta menos atractivo dedicar tiempo a documentar un procedimiento, publicar un contraste impreciso o corregir una tabla. Munafò et al. (2017) proponen cambios en evaluación y difusión que apoyen prácticas abiertas, y señalan que esas propuestas requieren evaluación. En una colaboración concreta, asignar responsables de los materiales y reconocer su mantenimiento permite que la reproducibilidad tenga tareas identificables, con resultados que otros puedan examinar.
Volvamos al ejemplo de los centros. Una revisión descubre que el informe declaraba una proporción por persona y publicaba el promedio de centros. El expediente actualizado conservaría la tabla de entrada, identificaría la operación anterior y documentaría el cambio de cincuenta a veintiséis por ciento. Si un análisis posterior necesitara el promedio institucional, encontraría también esa cantidad y su definición. La corrección no obliga a borrar el primer cálculo: obliga a vincular cada número con la pregunta que efectivamente responde y a señalar qué conclusiones utilizaron la versión equivocada.
Referencias
Goodman, S. N., Fanelli, D., & Ioannidis, J. P. A. (2016). What does research reproducibility mean? Science Translational Medicine, 8(341), 341ps12. https://doi.org/10.1126/scitranslmed.aaf5027
Higgins, J. P. T., Thompson, S. G., & Spiegelhalter, D. J. (2009). A re-evaluation of random-effects meta-analysis. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(1), 137–159. https://doi.org/10.1111/j.1467-985X.2008.00552.x
Munafò, M. R., Nosek, B. A., Bishop, D. V. M., Button, K. S., Chambers, C. D., Percie du Sert, N., Simonsohn, U., Wagenmakers, E.-J., Ware, J. J., & Ioannidis, J. P. A. (2017). A manifesto for reproducible science. Nature Human Behaviour, 1, 0021. https://doi.org/10.1038/s41562-016-0021
National Academies of Sciences, Engineering, and Medicine. (2019). Reproducibility and replicability in science. The National Academies Press. https://doi.org/10.17226/25303
Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114
Nosek, B. A., & Errington, T. M. (2020). What is replication? PLOS Biology, 18(3), e3000691. https://doi.org/10.1371/journal.pbio.3000691