Un archivo con dos columnas de identificadores permite dibujar una red, pero todavía deja abiertas varias preguntas sobre lo representado. Una pareja ausente puede corresponder a una relación inexistente, a una relación que nadie observó o a un registro descartado durante el procesamiento. Una persona que no figura en ninguna fila puede estar aislada o haber quedado fuera del estudio. Esas posibilidades producen el mismo archivo de aristas y, sin embargo, sostienen descripciones distintas de la población.
La diferencia importa incluso antes de estimar un modelo. Si se eliminan del dibujo las personas sin relaciones registradas, aumentará el grado medio respecto al cálculo que las conserva en el denominador. Si una pareja no observada se codifica como cero, el análisis tratará una falta de información como evidencia de ausencia. El tamaño del archivo no permite resolver estas decisiones: hace falta conocer cómo se seleccionaron las unidades y cómo se produjeron los registros.
Handcock y Gile (2010) representan esta distinción mediante una red completa y una matriz que indica qué díadas fueron observadas. Una díada es aquí una pareja de nodos sobre la que podría existir una relación. El indicador de observación tiene un papel propio: permite separar una relación observada como ausente de una relación cuyo estado se desconoce. Esta separación sostiene tanto la descripción de la muestra como la inferencia sobre partes no observadas.
Especificar qué red se quiere conocer
Consideremos una población definida durante un intervalo concreto. Sus unidades forman un conjunto de nodos y una regla determina qué cuenta como arista. Podríamos registrar haber intercambiado al menos un mensaje, haber mantenido cierto tiempo de contacto o declarar una relación de colaboración. Las tres definiciones pueden aplicarse a las mismas personas y producir redes diferentes. La elección depende de la pregunta y debe preceder a la interpretación de las medidas estructurales.
Llamaremos red objetivo a la estructura correspondiente a esa definición. Puede ser parcialmente latente porque algunas relaciones no se observan. El término «latente» expresa aquí una limitación de observación; no obliga a suponer que existe una relación esencial independiente de cualquier definición. Una red de mensajes conserva su sentido como objeto aunque otra pregunta requiera una red de apoyo percibido. La discrepancia entre ambas puede reflejar una diferencia de relaciones, además de posibles errores de medición.
Conviene distinguir tres operaciones. Primero se delimita la población y el período. Después se seleccionan nodos, díadas o eventos para observarlos. Finalmente se transforma el registro en una representación: se resuelven identificadores, se agregan eventos y, si corresponde, se aplica un umbral. Cada operación puede alterar el conjunto de nodos o de aristas. Cambiar el período de una semana a un mes puede añadir relaciones por definición, aunque el dispositivo de registro funcione perfectamente en ambos casos.
Kossinets (2006) estudió mecanismos de ausencia asociados a la delimitación de actores o contextos, la falta de respuesta y la restricción del número de nominaciones. Su análisis permite entender por qué una proporción global de datos faltantes no describe por sí sola el problema. Omitir un contexto compartido puede retirar simultáneamente varias relaciones; limitar las nominaciones afecta de manera distinta a quienes tienen pocas o muchas conexiones. La forma de producir la ausencia interviene en sus consecuencias.
También hay que decidir qué significa observar un nodo. En una muestra inducida se registran los nodos seleccionados y las relaciones entre ellos. En una encuesta egocéntrica pueden registrarse relaciones que salen de las personas seleccionadas hacia otras que no fueron entrevistadas. Si una de estas últimas aparece nombrada, sabemos algo sobre ella, pero no necesariamente conocemos sus demás relaciones. Convertir todas las personas mencionadas en una subred supuestamente completa añadiría una afirmación que el diseño no proporciona.
Una relación dirigida exige conservar quién ocupa cada posición. Que una persona declare recibir ayuda de otra no implica que ambas hayan declarado darse ayuda mutuamente. Simetrizar el registro mediante una unión o una intersección produce objetos distintos y debe acompañarse de una definición. Algo parecido ocurre al sustituir cantidades de interacción por presencia o ausencia: dos parejas con un evento y con cien eventos pueden recibir la misma arista binaria. Esta reducción es adecuada para una pregunta sobre existencia de relación, pero ya no conserva la información necesaria para comparar intensidades. La estructura depende tanto de la cobertura como de la representación escogida.
Una misma pérdida, dos consecuencias
Construyamos una red didáctica, sin datos de personas reales. Tiene seis nodos, denominados A, B, C, D, E y F. A, B y C forman un triángulo; D, E y F forman otro. Existe además la arista CD, que une ambos grupos. Las siete aristas son AB, AC, BC, CD, DE, DF y EF. La red es simple, no dirigida y permanece fija durante todos los cálculos siguientes.
Entre seis nodos hay quince parejas posibles. La densidad de la red completa es, por tanto, siete dividido por quince. Los grados son dos para A, B, E y F, y tres para C y D. El grado medio es siete tercios. Todas las parejas están conectadas mediante algún camino, y la distancia media entre ellas es nueve quintos: se suman las longitudes de los quince caminos mínimos y se divide por quince.
Ahora supongamos que el registro omite CD. Desaparece una sola arista y la densidad baja de siete quinceavos a seis quinceavos. La consecuencia sobre el alcance es mayor: quedan dos componentes de tres nodos. Solo seis de las quince parejas continúan conectadas por algún camino. La fracción de parejas alcanzables pasa de uno a dos quintos. Ningún algoritmo que utilice exclusivamente las aristas registradas encontrará un camino entre los dos grupos.
Si, en cambio, se omite AB, también se pierde una arista y se obtiene exactamente la misma densidad. La red sigue conectada, porque A y B pueden alcanzarse a través de C. Su distancia pasa de uno a dos, mientras las otras distancias se conservan. La distancia media aumenta de veintisiete quinceavos a veintiocho quinceavos. La cantidad de errores coincide con la del caso anterior; su localización explica la diferencia de estructura.
La comparación también afecta a la interpretación del agrupamiento. Definamos una cuña como dos aristas que comparten un nodo central, sin exigir conexión entre los extremos. La transitividad global es tres veces el número de triángulos dividido por el número de cuñas. La red completa tiene dos triángulos y diez cuñas, por lo que su transitividad es tres quintos. Al perder CD quedan los dos triángulos y seis cuñas: la transitividad sube a uno, al mismo tiempo que la red se fragmenta.
Al perder AB queda un triángulo y ocho cuñas, de modo que la transitividad baja a tres octavos. Un aumento del agrupamiento observado puede acompañar una pérdida de conexiones entre grupos. Tampoco una disminución implica que todos los vínculos se hayan vuelto más débiles. En esta construcción solo hemos cambiado qué aristas aparecen en el archivo; la red objetivo permanece igual en las dos operaciones.
Las distancias requieren otra decisión de cálculo cuando hay fragmentación. Tras perder CD, las seis parejas que siguen conectadas tienen distancia uno. Si se promedian únicamente esas distancias finitas, el valor baja respecto al promedio poblacional inicial. Sería incorrecto interpretar la reducción como una mejora del acceso entre los seis nodos: nueve parejas han quedado fuera del promedio. Se puede informar conjuntamente la fracción alcanzable y la distancia entre parejas alcanzables, o elegir una medida que asigne una contribución definida a la desconexión. Lo necesario es identificar qué conjunto de parejas sostiene el resultado y mantener esa definición al comparar archivos.
La omisión de nodos combina cambios de numerador y denominador. Si desaparece C del registro, también desaparecen sus tres aristas incidentes. Entre los cinco nodos restantes quedan cuatro aristas y dos componentes: AB y el triángulo DEF. La densidad es cuatro décimos. Si desaparece A, quedan cinco aristas entre cinco nodos y la red continúa conectada; la densidad sube a cinco décimos. Ambos archivos contienen cinco personas, pero la cobertura estructural difiere.
Borgatti, Carley y Krackhardt (2006) evaluaron medidas de centralidad ante adiciones y eliminaciones aleatorias de nodos o aristas. Sus resultados corresponden a redes y errores generados bajo los diseños estudiados. Nuestro ejemplo permite aislar otra cuestión: conocer cuántos registros faltan no determina qué rutas, posiciones o componentes han quedado alterados. Para trasladar una evaluación de robustez hay que conservar el tipo de perturbación que la hace pertinente.
Enumerar el diseño de muestreo
Pasemos de pérdidas concretas a un diseño probabilístico. Seleccionaremos exactamente cuatro de los seis nodos, sin reemplazo, dando la misma probabilidad a cada conjunto de cuatro. Dentro de cada muestra observaremos sin error todas las díadas entre los seleccionados, tanto aristas como ausencias. No recogeremos relaciones que salgan hacia los dos nodos no seleccionados. Hay quince muestras posibles, y todas tienen probabilidad de un quinceavo.
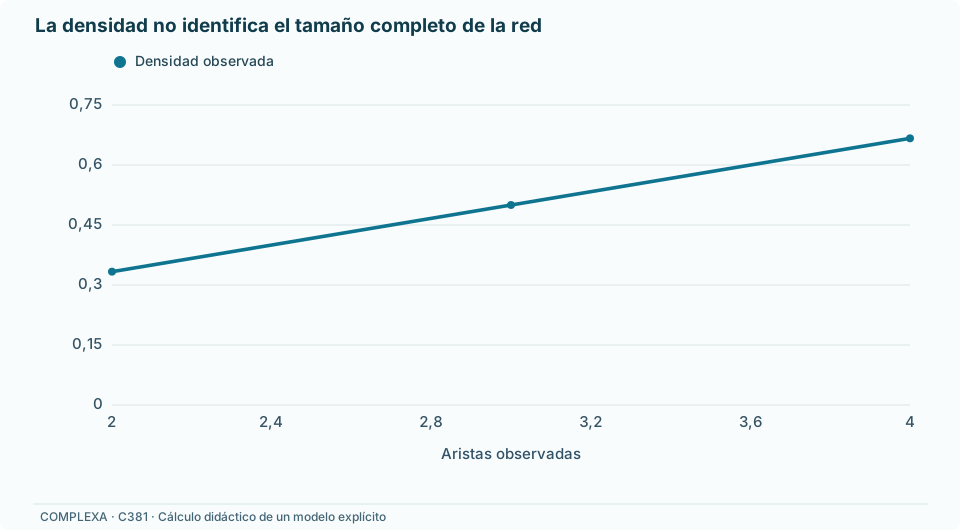
La red poblacional sigue siendo fija. La variación procede únicamente de qué muestra elegimos. Una pareja determinada queda incluida cuando aparecen sus dos extremos. Su probabilidad de inclusión es dos quintos: seis de los quince conjuntos posibles contienen a ambos. Como cada una de las siete aristas tiene esa probabilidad de aparecer, el número esperado de aristas observadas es catorce quintos, es decir, dos coma ocho.
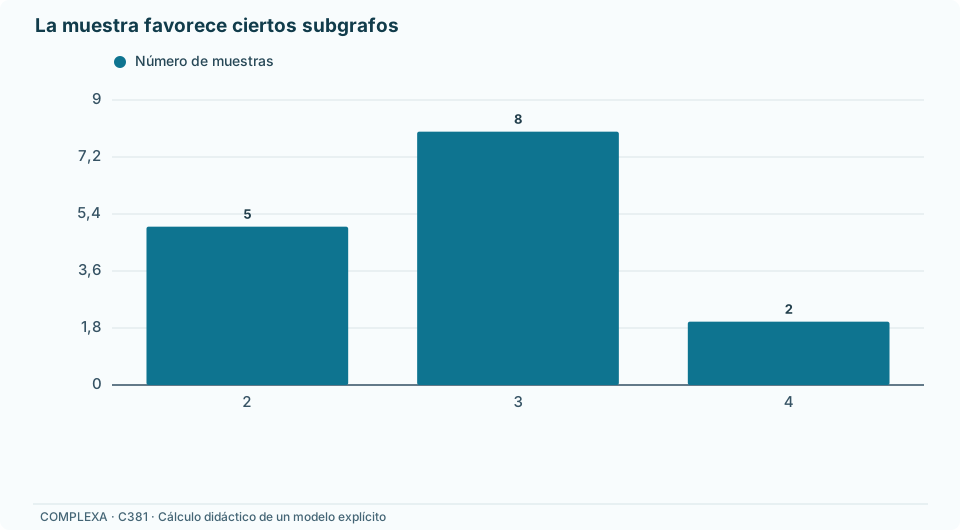
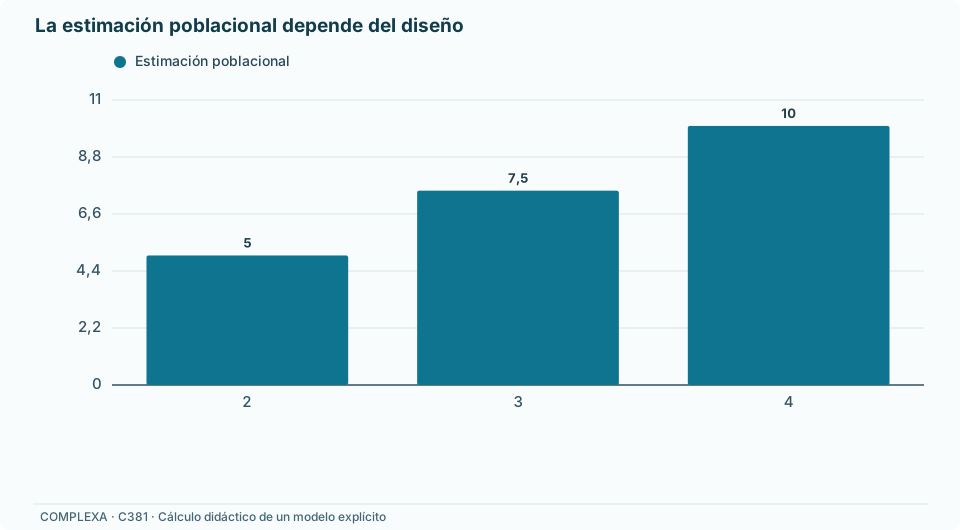
Podemos comprobar el resultado enumerando las quince muestras completas. Cinco contienen dos aristas, ocho contienen tres y dos contienen cuatro. La siguiente tabla conserva las multiplicidades del diseño, sin seleccionar únicamente subredes conectadas.
| Aristas observadas | Número de muestras | Densidad de la subred | Estimación del total poblacional |
|---|---|---|---|
| 2 | 5 | 1/3 | 5 |
| 3 | 8 | 1/2 | 15/2 |
| 4 | 2 | 2/3 | 10 |
Cada subred de cuatro nodos tiene seis díadas posibles. Su densidad se obtiene dividiendo las aristas observadas por seis. Al promediar esta densidad sobre las quince muestras se recupera siete quinceavos, la densidad poblacional. Bajo este diseño, esa medida es insesgada aunque cada muestra tenga menos aristas y menos nodos. La conclusión depende del muestreo uniforme, del tamaño fijo y de observar correctamente todas las díadas inducidas.
Un denominador diferente respondería a otra operación. Si dividimos las aristas observadas por las quince díadas de la población, obtenemos una media de catorce setentaicincoavos. El cálculo ha tratado las parejas no incluidas como si fueran ausencias observadas. Conservar los nombres de los seis nodos en una matriz no soluciona el problema si sus entradas desconocidas se rellenan con ceros. La máscara de observación debe mantenerse junto a la matriz.
Para estimar el número total de aristas puede ponderarse cada arista observada por el inverso de su probabilidad de inclusión. En este caso todas reciben peso cinco medios. Una muestra con dos aristas estima cinco; una con cuatro estima diez. El promedio de las quince estimaciones es siete. El carácter insesgado describe una propiedad del procedimiento al repetir el diseño, y no afirma que cada archivo permita recuperar el total exacto.
La misma idea puede expresarse como
donde indica la arista de la red objetivo, señala si esa díada fue observada y es su probabilidad de inclusión. La contribución de una díada no observada al estimador es cero porque no aporta un registro ponderado; eso no equivale a declarar que su arista sea inexistente. Para justificar la esperanza del estimador se requiere una probabilidad de inclusión positiva y conocida para las díadas pertinentes.
El diseño también determina la variación de la estimación. Las inclusiones de aristas que comparten un nodo no son independientes. AB y AC aparecen conjuntamente cuando se seleccionan A, B y C, con probabilidad de un quinto. Multiplicar sus probabilidades individuales daría cuatro veinticincoavos, un valor diferente. Para dos aristas sin extremos compartidos, como AB y DE, la inclusión conjunta exige seleccionar exactamente esos cuatro nodos y tiene probabilidad de un quinceavo. El tamaño fijo de la muestra impone otra dependencia.
La enumeración permite incorporar ambas situaciones sin aproximarlas. La varianza del número de aristas observado es treinta y dos setentaicincoavos, y la del estimador ponderado del total es ocho tercios. Para obtener la segunda se multiplica la primera por el cuadrado del peso cinco medios. Es una varianza respecto a las quince muestras de esta población fija. Considerar las aristas como ensayos independientes produciría otra cuenta, aunque cada probabilidad marginal estuviera bien calculada. El número de filas observadas no indica por sí solo cuántas unidades independientes aportan información sobre la red.
Triángulos, cuñas y razones
Un triángulo solo aparece completo en una subred inducida si se seleccionan sus tres nodos. En nuestro diseño la probabilidad es un quinto: de las quince muestras, tres contienen cualquier triple determinado. Como hay dos triángulos en la población, el número esperado de triángulos observados es dos quintos. Dividir el recuento observado por un quinto produce una estimación insesgada del total de triángulos.
Las cuñas también dependen de la presencia de tres nodos. Sus diez configuraciones poblacionales se observan completas con la misma probabilidad de un quinto, y el recuento esperado es dos. Ponderar cada cuña por cinco recupera diez en promedio. Este resultado utiliza la inclusión conjunta de los tres nodos. Corregir solo por la fracción de nodos observados o por la probabilidad de inclusión de una pareja emplearía una probabilidad inadecuada para el objeto contado.
La transitividad introduce una dificultad adicional porque es una razón. En cinco muestras hay dos aristas separadas y ninguna cuña. La transitividad habitual queda indefinida en esas muestras. Si el programa adopta la convención de asignarle cero, la media sobre las quince muestras es veintiséis setentaicincoavos, aproximadamente cero coma trescientos cuarenta y siete. Si descartamos las cinco indefinidas, la media entre las diez restantes es trece veinticincoavos, igual a cero coma cincuenta y dos.
Ninguna de esas dos medias coincide con los tres quintos de la población. En cambio, tres veces el número esperado de triángulos dividido por el número esperado de cuñas sí da tres quintos. La razón de esperanzas y la esperanza de una razón son operaciones distintas. Multiplicar numerador y denominador observados por el mismo factor tampoco modifica la transitividad de cada muestra, por lo que no elimina esta diferencia.
La elección de omitir los casos indefinidos cambia además el conjunto sobre el que se calcula el promedio. Una muestra formada por dos díadas desconectadas sigue siendo un resultado legítimo del diseño. Excluirla por no permitir cierto índice introduce una selección posterior. Puede ser razonable describir la transitividad condicionada a que existan cuñas, siempre que esa condición figure en la interpretación; ya no estamos promediando sobre todas las muestras previstas.
Estos cálculos distinguen tres objetivos que suelen mezclarse: estimar el total de una configuración, describir un índice de la subred observada e inferir el mismo índice para la red completa. La existencia de un estimador sencillo para el primero no entrega automáticamente una corrección para los otros. La dificultad aumenta en medidas que dependen de caminos largos, porque diferentes conjuntos de aristas pueden producir o destruir rutas alternativas.
Podemos precisar cuánto deja abierto una muestra concreta. Supongamos que se seleccionan A, B, D y E. Se observan AB y DE, mientras AD, AE, BD y BE se registran como ausencias. Conocemos el padrón de seis nodos, pero no se evaluó ninguna díada incidente en C o F. Hay nueve díadas desconocidas y, sin imponer restricciones adicionales a la red, cada una podría estar presente o ausente. Existen así quinientas doce completaciones compatibles con el registro.
El número total de aristas puede variar entre dos y once. La completación con todas las díadas desconocidas ausentes tiene cuatro componentes: AB, DE, C y F. Otra completación añade BC, CD y EF y forma el camino ABCDEF, conectado entre los seis nodos. Ambas respetan exactamente las seis díadas observadas. El estimador ponderado vale cinco en esa muestra, pero ese número no selecciona por sí mismo cuál de las completaciones ocurrió. Es posible entregar una estimación de un total sin haber identificado la estructura concreta que lo produce.
Estos límites describen lo compatible con la información disponible, no un intervalo de confianza ni una distribución de probabilidades entre redes. La selección uniforme justifica las propiedades de muestreo del estimador; no asigna automáticamente la misma probabilidad a todas las completaciones una vez visto el archivo. Para ponderarlas hace falta información adicional o un modelo. También puede resultar preferible conservar los límites cuando la decisión que interesa se resuelve para todas las estructuras compatibles, evitando introducir una reconstrucción más precisa de lo que exige la pregunta.
El grado observado depende de quién entra
Incluso al seleccionar nodos de forma uniforme, sus grados dentro de la muestra cambian. Condicionado a que un nodo haya sido incluido, quedan tres plazas entre los otros cinco nodos. Cada vecino suyo tiene probabilidad de tres quintos de ocupar una de esas plazas. El grado observado esperado es, por ello, tres quintos del grado poblacional: seis quintos para A y nueve quintos para C, por ejemplo.
La probabilidad condicional anterior no es dos quintos, que correspondía a incluir simultáneamente ambos extremos antes de saber si alguno había entrado. Confundirlas produciría una corrección equivocada. El grado de un nodo presente y el total de aristas del archivo responden a condicionamientos diferentes, aunque ambas cantidades se calculen a partir de la misma lista de relaciones.
Si cambiamos el diseño y seleccionamos cada nodo independientemente con probabilidad , el tamaño muestral pasa a ser aleatorio. Condicionado a incluir un nodo con grado poblacional , su grado en la subred inducida sigue una distribución binomial con ensayos y probabilidad . En el diseño anterior, de tamaño fijo, la distribución correspondiente es hipergeométrica. Los dos diseños reducen el grado observado, pero no generan la misma distribución de muestreo.
Stumpf, Wiuf y May (2005) examinaron la transformación de las distribuciones de grado bajo selección independiente de nodos. Mostraron que pertenecer a cierta familia de distribuciones en la red completa no garantiza conservar esa forma exacta en la subred. Su resultado sobre distribuciones de tipo ley de potencias no significa que toda cola aparente desaparezca, ni que sea imposible inferir parámetros con un modelo de observación adecuado. Cuestiona identificar sin ajuste la distribución observada con la poblacional.
Otros diseños seleccionan nodos a través de relaciones ya encontradas. En un rastreo de enlaces, una persona con muchas conexiones puede tener más oportunidades de ser alcanzada que otra con pocas. La probabilidad concreta depende de las semillas, las ondas de búsqueda y las reglas de reclutamiento. Si esas probabilidades dependen de partes aún desconocidas de la red, no basta con escribir un peso inverso: hay que poder determinarlo o justificar un modelo para estimarlo.
Handcock y Gile (2010) analizan precisamente esta dificultad y distinguen inferencia basada en el diseño de inferencia basada en un modelo de red. También establecen condiciones bajo las cuales un mecanismo adaptativo puede resultar ignorable para cierta inferencia por verosimilitud. «Ignorable» tiene allí un significado técnico: requiere condiciones sobre la dependencia del muestreo y la separación de parámetros. No autoriza a tratar cualquier muestra rastreada como si fuera una selección uniforme de nodos.
Cuando las díadas se observan con error
Hasta ahora, cada díada incluida se registraba correctamente. Introduzcamos otro experimento sobre los seis nodos completos. Todas las parejas se evalúan, pero una arista verdadera se registra como presente con sensibilidad y una ausencia verdadera genera un falso positivo con probabilidad . Estas probabilidades son supuestas y homogéneas entre díadas; no proceden de una validación empírica. La red objetivo conserva sus siete aristas.
Esperamos registrar cinco coma seis aristas verdaderas, perder una coma cuatro y añadir cero coma ocho falsas. El número esperado de aristas registradas es seis coma cuatro. Una cifra cercana al total correcto puede ocultar dos tipos de error que se compensan parcialmente. Contar aristas permite comprobar un balance, pero no muestra si se ha perdido el puente CD o se ha creado una conexión adicional entre los grupos.
Si es la densidad verdadera y la densidad observada esperada, la relación es
En nuestro ejemplo resulta . Cuando sensibilidad y tasa de falsos positivos son conocidas y diferentes, podemos invertir la expresión: . Sustituir la densidad registrada por su esperanza muestra por qué la corrección es insesgada para la densidad bajo estos supuestos. La linealidad de la esperanza basta para esta cuenta; todavía no hemos supuesto independencia entre los errores de distintas díadas.
La fórmula deja de identificar la densidad si ambas probabilidades coinciden: el registro tendría la misma propensión a señalar una relación exista o no. Cuando son próximas, pequeñas diferencias de la densidad observada se amplifican al dividir por su diferencia. Además, conocer solo la densidad registrada no permite estimar libremente la densidad verdadera y ambas tasas de error. La información sobre el instrumento debe proceder de otra parte o incorporarse mediante supuestos explícitos.
Una comprobación externa podría revisar una selección de díadas con un procedimiento de referencia y comparar ambos registros. Esa selección debe cubrir las situaciones donde varía la detección. Si solo se verifican relaciones intensas y fáciles de recordar, la sensibilidad estimada puede ser inadecuada para contactos breves. Repetir la medición también aporta información, siempre que se distinga variación de la relación y variación del registro. Dos observaciones realizadas en semanas diferentes pueden discrepar porque cambió la red objetivo. Para atribuir la diferencia al instrumento habría que mantener comparable el período o modelar ese cambio. La incertidumbre de las tasas estimadas debe propagarse a la densidad corregida; tratarlas como constantes conocidas es una propiedad del ejemplo construido, no una consecuencia automática de disponer de una muestra de validación.
Las reglas para combinar informes también modifican la detección. Supongamos dos informes por díada, independientes entre sí condicionado al estado verdadero, cada uno con las probabilidades anteriores. Aceptar la relación si cualquiera informa presencia eleva la sensibilidad a cero coma noventa y seis, pero la tasa de falsos positivos sube a cero coma diecinueve. Exigir ambos informes reduce esas cifras a cero coma sesenta y cuatro y cero coma cero uno, respectivamente.
Esos cálculos se refieren a dos mediciones de la misma relación objetivo. Si la pregunta cambia a «relación reconocida por ambos», la exigencia de reciprocidad puede formar parte de la definición y no ser un mero procedimiento de detección. También hay que distinguir una respuesta negativa de un informe no recibido. La independencia condicional permite multiplicar probabilidades en este ejemplo; informantes que comparten recuerdos, instrucciones o fuentes pueden incumplirla.
Butts (2003) desarrolla modelos bayesianos jerárquicos para inferir estructura y precisión de informantes en presencia de error y datos faltantes. La utilidad del planteamiento consiste en representar ambas incertidumbres dentro de un modelo de observación. No convierte los informes concordantes en una prueba infalible de relación ni elimina la necesidad de justificar cómo se vinculan las respuestas con la estructura que se desea conocer.
Conectividad y recuperación son otros objetivos
Para calcular una probabilidad de conectividad necesitamos especificar cómo se combinan las pérdidas. Consideremos una variante con sensibilidad de cuatro quintos, sin falsos positivos y con retención independiente de cada una de las siete aristas. Un triángulo mantiene conectados sus tres nodos si conserva las tres aristas o exactamente dos. La probabilidad correspondiente es .
La red completa observada será conectada si se conserva CD y ambos triángulos permanecen internamente conectados. Por independencia, su probabilidad es , que vale aproximadamente cero coma seiscientos cuarenta y dos. Se enumeraron las ciento veintiocho configuraciones posibles de retención y el resultado coincide. Aunque dividir el recuento observado por la sensibilidad estima siete aristas en promedio, esa ponderación no vuelve a conectar una realización fragmentada.
Recuperar exactamente todas las díadas plantea otra exigencia. En el experimento con falsos positivos, añadiendo independencia entre los quince errores, la probabilidad de clasificar correctamente las siete aristas y las ocho ausencias es , aproximadamente nueve por ciento. Una buena sensibilidad por arista y una corrección útil de densidad pueden coexistir con una probabilidad modesta de observar toda la topología sin errores. Cada conclusión debe asociarse a su objetivo.
Si se observan dos triángulos desconectados, el archivo es compatible con que realmente no exista una relación entre grupos y también con que CD haya sido omitida. Un modelo puede asignar probabilidades diferentes a esas posibilidades a partir de los datos y de información adicional. Un dibujo único que rellene la arista más plausible oculta esa distribución de posibilidades si después se utiliza como una observación completa y cierta.
Fellows y Handcock (2023) formulan la inferencia conjunta sobre relaciones y atributos cuando solo se observa parte de una población representada mediante una red, incluyendo mecanismos de muestreo no ignorables. La verosimilitud considera posibles completaciones y, cuando corresponde, el proceso que produjo la observación. Esas completaciones dependen del modelo de red y del mecanismo de muestreo; conservar varias permite reflejar incertidumbre que una sola imputación no muestra.
Una evaluación de reconstrucción debería retirar datos mediante un mecanismo relacionado con el problema real. Ocultar aristas uniformemente puede ser apropiado para estudiar pérdidas independientes, pero representa mal un sensor ausente que elimina todas las relaciones de una persona. Si faltan principalmente contactos breves, la validación que oculta por igual contactos largos y cortos tampoco reproduce el mecanismo. El procedimiento evaluado y la perturbación elegida determinan qué significa su desempeño.
Decidir qué observación falta
Volvamos al archivo con dos triángulos desconectados. Si conocemos el padrón completo de seis nodos, sabemos que CD no fue evaluada y que todas las demás díadas se evaluaron sin error, la incertidumbre está localizada en una díada. Observarla puede resolver si hay un camino entre grupos en esta construcción. Si solo contamos con una lista de aristas y desconocemos qué personas podían aparecer, comprobar CD no resolvería cuántos nodos aislados o completamente omitidos existen. Las dos carencias requieren observaciones diferentes.
El registro del estudio debería conservar el padrón, los criterios de pertenencia, el intervalo, las oportunidades de observación y las razones de ausencia. Al agregar eventos conviene mantener también la información necesaria para revisar umbrales y distinguir identificadores fusionados o duplicados. Una fusión puede crear un nodo que conecte grupos antes separados; una división artificial puede distribuir sus relaciones entre varias identidades. Ambas operaciones cambian rutas sin que haya ocurrido ningún cambio en las interacciones originales.
En la red construida podemos entregar una conclusión precisa para cada protocolo. El muestreo uniforme de cuatro nodos ofrece una densidad insesgada en promedio y una distribución de quince subredes conocida. La pérdida del puente fragmenta la observación; la pérdida de AB conserva la conectividad. Las tasas de detección conocidas permiten corregir una esperanza, mientras la recuperación de díadas concretas continúa siendo incierta. Si el objetivo inmediato es saber si los dos grupos están conectados, la siguiente observación útil recae sobre CD y sobre la fiabilidad de su registro, porque esa información distingue las dos estructuras que siguen siendo posibles.
Referencias
Borgatti, S. P., Carley, K. M., y Krackhardt, D. (2006). On the robustness of centrality measures under conditions of imperfect data. Social Networks, 28(2), 124–136. https://doi.org/10.1016/j.socnet.2005.05.001
Butts, C. T. (2003). Network inference, error, and informant (in)accuracy: a Bayesian approach. Social Networks, 25(2), 103–140. https://doi.org/10.1016/S0378-8733(02)00038-2
Fellows, I. E., y Handcock, M. S. (2023). Modeling of networked populations when data is sampled or missing. METRON, 81(1), 21–35. https://doi.org/10.1007/s40300-023-00246-3
Handcock, M. S., y Gile, K. J. (2010). Modeling social networks from sampled data. The Annals of Applied Statistics, 4(1), 5–25. https://doi.org/10.1214/08-AOAS221
Kossinets, G. (2006). Effects of missing data in social networks. Social Networks, 28(3), 247–268. https://doi.org/10.1016/j.socnet.2005.07.002
Stumpf, M. P. H., Wiuf, C., y May, R. M. (2005). Subnets of scale-free networks are not scale-free: Sampling properties of networks. Proceedings of the National Academy of Sciences, 102(12), 4221–4224. https://doi.org/10.1073/pnas.0501179102