En una matriz de datos multivariados, dos columnas pueden estar correlacionadas aunque su relación cambie al considerar una tercera. Un modelo gráfico gaussiano organiza esas asociaciones condicionadas: cada nodo representa una variable y una arista indica que su asociación con otra persiste al condicionar por todas las variables restantes del modelo. La frase final forma parte de la definición. Si cambia el conjunto de variables, puede cambiar también el significado y la presencia de las aristas.
Estos nodos no tienen por qué representar personas. En un estudio transversal, las filas pueden corresponder a participantes y las columnas a medidas tomadas en cada uno. La red conecta las columnas. Incorporar más participantes aumenta la información disponible para estimar las asociaciones, mientras incorporar otra variable cambia el conjunto sobre el que se condiciona. Confundir ambas operaciones dificulta entender por qué una red puede cambiar incluso con una muestra grande.
La utilidad del modelo consiste en representar una estructura de dependencia de una distribución conjunta. Esa estructura permite formular predicciones, simplificar modelos de covarianza y examinar qué asociaciones quedan al considerar información adicional. Para convertirla en una descripción causal hace falta especificar cómo se generan las variables y qué ocurriría bajo una intervención. Los cálculos siguientes separan estas preguntas usando distribuciones construidas, sin atribuir resultados a una población clínica.
La información que contiene la matriz de precisión
Sea un vector de variables con distribución normal multivariada, media y matriz de covarianzas . Supondremos que es definida positiva: cualquier combinación lineal no trivial tiene varianza positiva. Así evitamos relaciones deterministas exactas y podemos invertir la matriz. Su inversa, , recibe el nombre de matriz de precisión o de concentración.
Los elementos diagonales de la covarianza son varianzas; los demás describen asociaciones marginales entre pares. La matriz de precisión organiza una información diferente. En el modelo gaussiano no degenerado, un elemento fuera de la diagonal equivale a que y sean independientes condicionado al conjunto de las otras variables. Una arista se dibuja cuando ese elemento no es cero. La representación es no dirigida porque la condición de independencia es simétrica.
Puede verse el motivo directamente en la densidad. Tras centrar las variables, su parte dependiente de los valores observados es proporcional a
Si fijamos las variables distintas de y , queda una densidad normal bivariada. El término cruzado entre ambas contiene . Cuando ese coeficiente es cero, la densidad condicional se separa en un factor para cada variable y las dos son condicionalmente independientes. Cuando es distinto de cero, el término cruzado impide esa separación. La conclusión utiliza la forma de toda la densidad gaussiana, más información que la mera existencia de covarianzas.
Para expresar las aristas en una escala comparable se calcula la correlación parcial:
El subíndice indica que se consideran todas las variables excepto las dos del par. El signo menos importa: una entrada negativa de la precisión corresponde a una correlación parcial positiva. El denominador normaliza la magnitud, de manera que el resultado se encuentra entre menos uno y uno. Las entradas sin normalizar de la precisión dependen de las unidades de medida y no deben interpretarse directamente como fuerzas comparables de relación.
Epskamp y colaboradores (2018) presentan el modelo como una red de correlaciones parciales y examinan sus interpretaciones predictivas y su relación con modelos causales. Para la lectura distributiva que acabamos de definir, la ausencia de arista tiene un contenido preciso: una vez conocidas las otras variables incluidas, conocer una de las dos no modifica la distribución condicional de la otra. No dice que nunca puedan estar asociadas cuando esa información adicional se desconoce.
La referencia a valores conocidos es una afirmación sobre distribuciones condicionales. Con variables continuas, no exige reunir muchas observaciones cuyo valor de ajuste sea exactamente idéntico. El modelo permite definir una densidad condicional para cada valor pertinente y estimar sus parámetros a partir del conjunto de datos. Agrupar observaciones dentro de intervalos amplios de la variable de ajuste realiza otra operación: dentro de cada intervalo sigue habiendo variación de esa variable. Por ello, una correlación calculada entre observaciones agrupadas aproximadamente puede persistir aunque la correlación condicional exacta del modelo sea cero.
Una matriz con tres asociaciones marginales y dos aristas
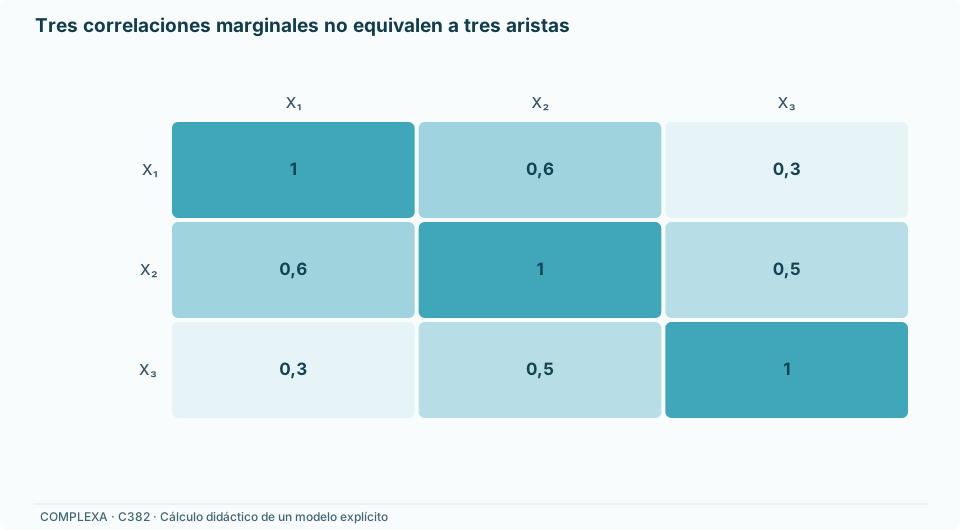
Consideremos tres variables gaussianas centradas y de varianza uno, con matriz
Es una construcción poblacional exacta, no una matriz estimada a partir de observaciones. Al tener varianzas unitarias, sus covarianzas coinciden con las correlaciones. Las tres parejas presentan asociaciones positivas: las correlaciones son , y . Los menores principales sucesivos valen , y , todos positivos, por lo que la matriz satisface el supuesto de definición positiva.
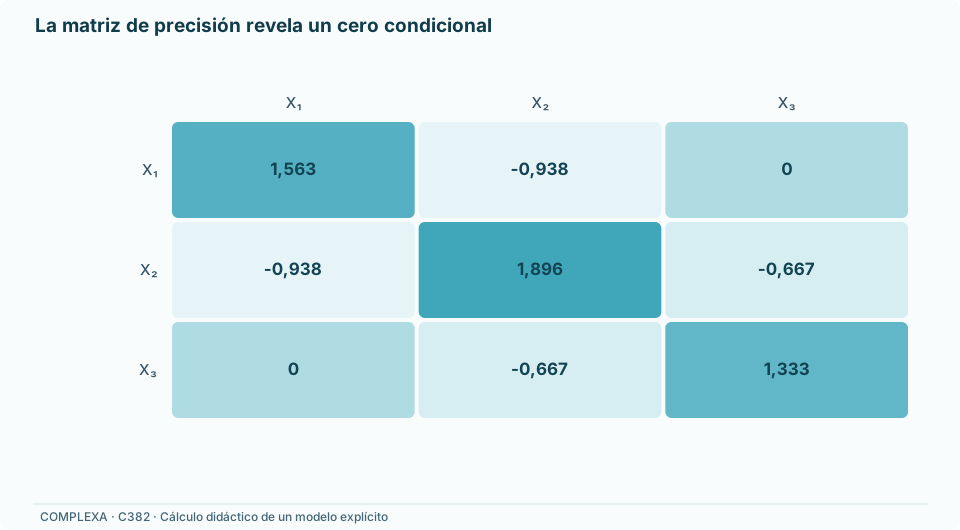
La inversa se obtiene como
La multiplicación de ambas matrices da la identidad. El elemento correspondiente a las variables primera y tercera es cero, aunque su correlación marginal era positiva. Por tanto, el grafo de asociaciones condicionales contiene las aristas entre primera y segunda y entre segunda y tercera, pero no entre primera y tercera. En este conjunto de tres variables, la segunda separa a las otras dos en el sentido de independencia condicional.
La misma cuenta puede hacerse mediante residuos. Para retirar de la primera y la tercera variables la parte lineal asociada a la segunda, construimos y . Sus varianzas son y , respectivamente. Su covarianza es . La correlación entre esos residuos es cero, de acuerdo con la entrada nula de la precisión.
Aquí los residuos se obtienen retirando de ambas variables el mismo conjunto de ajuste, que excluye a las dos que se comparan. No se está prediciendo cada una mediante todas las demás, incluida su pareja, para luego correlacionar esos residuos. Esa otra operación produciría objetos diferentes. La definición de correlación parcial exige conservar con cuidado qué variables entran en cada regresión auxiliar.
Para las otras parejas, la fórmula da aproximadamente y . Son valores diferentes de las correlaciones marginales de y . El ajuste no consiste en retirar una proporción fija de todas las asociaciones: interviene la covarianza de cada pareja con el conjunto de variables utilizado para condicionar. Tampoco implica que la segunda variable sea una causa común; esa interpretación requerirá información que la matriz aún no especifica.
La independencia condicional tiene una consecuencia predictiva concreta. Si conocemos , la distribución de es normal con media y varianza . Añadir el valor de no cambia esa distribución. En cambio, si desconocemos la segunda variable, observar la tercera sí informa sobre la primera, porque su correlación marginal es distinta de cero. La utilidad de un predictor depende de qué información ya está disponible.
Regresiones compatibles con una misma distribución
La matriz de precisión también determina las regresiones condicionales de cada nodo. En el caso centrado,
El conjunto contiene todas las variables menos la que se predice. Las medias condicionales son lineales y las varianzas condicionales no dependen de los valores observados de los predictores. Ambas propiedades proceden de la normalidad conjunta. El término «precisión» refleja que el elemento diagonal es el inverso de esa varianza residual al condicionar por todos los demás nodos.
En nuestro ejemplo, predecir la primera variable utiliza un coeficiente de para la segunda y cero para la tercera. Predecir la tercera utiliza un medio para la segunda y cero para la primera. La regresión de la segunda es distinta:
Si solo observamos la primera variable, la varianza residual al predecir la segunda es . Al añadir la tercera baja a . La diferencia, , cuantifica una mejora de predicción bajo pérdida cuadrática en esta distribución. Es una propiedad poblacional del conjunto de predictores: no es una estimación de cuánto cambiaría la segunda variable al manipular la tercera.
Aunque una arista no tiene orientación, los coeficientes de las dos regresiones asociadas a ella pueden diferir. El coeficiente de la segunda al predecir la primera es , mientras el de la primera al predecir la segunda, incluyendo la tercera, es . Cambia la variable que ocupa el lugar de resultado y cambia su varianza condicional. La simetría de la correlación parcial expresa una asociación compartida, no igualdad de pendientes ni de efectos.
Las regresiones de todos los nodos tampoco son ecuaciones causales que puedan reunirse sin más. Cada una es una descripción condicional derivada de la misma distribución conjunta. Sus errores no deben suponerse mutuamente independientes por el hecho de llamarlos residuos. La compatibilidad entre regresiones está restringida por la simetría y la definición positiva de la precisión. Estimar modelos separados y darles a todos una interpretación causal añadiría supuestos que esas regresiones no justifican.
Cambiar las unidades ayuda a apreciar esta diferencia. Multiplicar una variable por una constante positiva modifica covarianzas, elementos de precisión y pendientes de regresión. La correlación parcial conserva su valor porque la normalización compensa la escala. Invertir la codificación de una variable cambia los signos de sus asociaciones, aunque siga describiendo la misma información. Por eso una arista negativa necesita interpretarse con el contenido y la orientación de las medidas; su signo aislado no identifica inhibición ni protección.
Los pesos de las aristas deben ser compatibles con una distribución conjunta. No basta con que cada número pertenezca al intervalo permitido para una correlación. Supongamos que intentamos asignar una correlación parcial positiva de a cada una de las tres parejas. Tras normalizar la precisión para que su diagonal sea unitaria, sus tres entradas fuera de la diagonal serían . La forma cuadrática evaluada en el vector de tres unos valdría . Una matriz definida positiva no puede producir ese resultado, por lo que tales pesos no forman un modelo gaussiano válido.
Cambiar las escalas de los nodos no repara esa incompatibilidad, porque equivale a transformar la matriz mediante factores diagonales invertibles y conserva su carácter definido positivo o indefinido. Sí es posible, en cambio, que las tres correlaciones marginales sean : la matriz con diagonal unitaria y esas entradas es definida positiva. Sus correlaciones parciales son , aproximadamente , y no los pesos propuestos antes. La distinción entre matrices marginales y condicionales afecta incluso a qué combinaciones de valores son admisibles.
La comprobación de compatibilidad tiene una consecuencia práctica al construir ejemplos o resumir resultados. Dibujar una colección de asociaciones elegidas por separado no garantiza que exista una covarianza que las produzca conjuntamente. Una matriz de precisión válida impone restricciones entre todas sus entradas. En el ejemplo inicial se verificó la definición positiva antes de interpretar el dibujo, de modo que las medias, varianzas y regresiones condicionales pertenecen efectivamente a una misma distribución.
Omitir una variable y condicionarla son operaciones distintas
Supongamos que la segunda variable deja de formar parte del registro. La distribución marginal de la primera y la tercera conserva la submatriz de covarianzas
Como solo quedan dos variables, no hay otras por las que condicionar: su correlación parcial coincide con la correlación marginal de . La nueva precisión es
Ahora sí existe una arista entre ellas. No ha cambiado la distribución original ni ha aparecido una nueva interacción en el sistema construido. Ha cambiado el objeto representado, al integrar sobre los valores no observados de la segunda variable. El grafo de tres nodos y el de dos nodos contestan preguntas sobre asociaciones condicionadas a conjuntos diferentes.
Eliminar simplemente la segunda fila y columna de la precisión original daría una matriz diagonal. Esa submatriz corresponde a la precisión de la distribución condicional de la primera y la tercera, dada la segunda, y no a su distribución marginal. En el ejemplo, condicionar conserva las varianzas y y elimina su covarianza. Marginalizar conserva varianzas unitarias y la covarianza de tres décimos. Son dos cálculos legítimos con interpretaciones distintas.
En general, si separamos variables observadas, O, y variables omitidas, H, la precisión marginal observada es
La expresión es un complemento de Schur. El segundo término recoge el cambio asociado a integrar las variables omitidas y puede introducir entradas no nulas donde antes había ceros. Por eso la estructura condicional de un conjunto amplio no suele conservarse al analizar una parte. El conocimiento de la precisión marginal tampoco permite separar automáticamente sus dos términos.
Chandrasekaran, Parrilo y Willsky (2012) utilizan esa estructura para estudiar modelos gaussianos con variables latentes. Sus condiciones distinguen una parte condicional dispersa de un efecto latente de rango bajo suficientemente distribuido. El resultado de identificabilidad y recuperación depende de esas condiciones; descomponer una matriz como suma o diferencia de componentes no garantiza que cada una tenga una interpretación única. En nuestro ejemplo pequeño, la fórmula permite calcular la marginalización sin afirmar que los datos de dos variables revelen por sí solos una tercera oculta.
Una lectura de caminos también debe conservar su alcance algebraico. Jones y West (2005) descomponen covarianzas mediante caminos de un grafo no dirigido sin imponer causalidad. En nuestra cadena gráfica hay un único camino entre primera y tercera, y su contribución reconstruye la covarianza de tres décimos. Multiplicar sin más los dos pesos de correlación parcial no da esa cifra: los pesos de la descomposición incluyen otros factores matriciales. Un camino de asociación no se convierte por esa operación en una secuencia de efectos causales.
Ajustar por una medición ruidosa
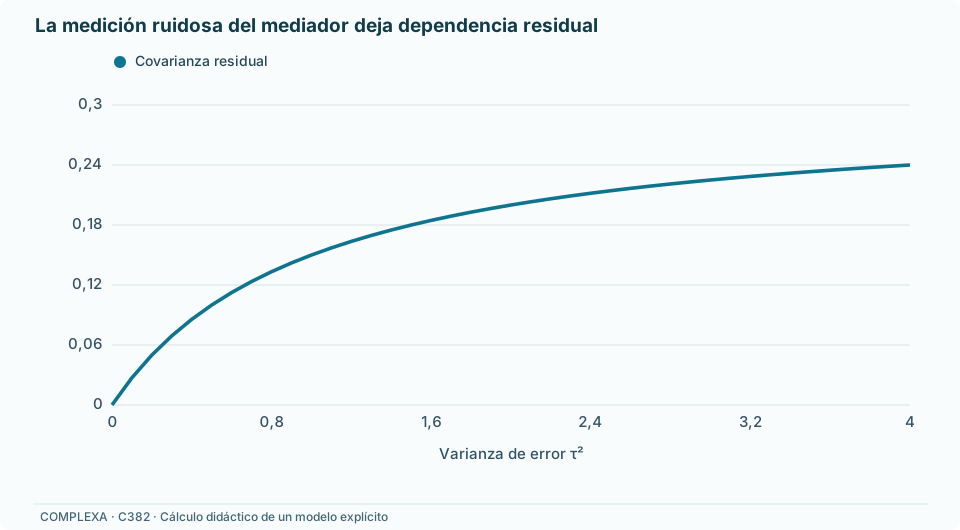
La segunda variable puede estar presente en el archivo y, sin embargo, no estar medida con exactitud. Definamos , donde es un error normal centrado, independiente de las tres variables, con varianza . El conjunto registrado es ahora . Sigue siendo conjuntamente gaussiano, pero la varianza del nodo central aumenta a ; sus covarianzas con los extremos permanecen iguales.
La covarianza de los extremos condicionada a la medición es
Cuando el error tiene varianza cero recuperamos la independencia del ejemplo inicial. Cuando su varianza es positiva, queda una covarianza condicional positiva. Ajustar por una medición imperfecta de la variable que separaba a los extremos no equivale a conocer esa variable. La información residual sobre ella puede seguir compartida entre los extremos.
Tomemos una varianza de error igual a uno. La covarianza condicional pasa a , y las varianzas condicionales de los extremos son y . Su correlación parcial resulta aproximadamente . El procedimiento de inversión puede estar calculado correctamente y la muestra puede ser muy grande; aun así, el grafo de las variables medidas contiene una arista que no estaba en el grafo de las variables originales.
Este resultado no permite corregir cualquier red asignándole una fiabilidad genérica. La cuenta supone un error aditivo, normal, independiente y de varianza especificada. Errores compartidos entre medidas, límites de respuesta o transformaciones no lineales pueden producir otros cambios. Para recuperar asociaciones entre variables no observadas exactamente se necesita un modelo de medición informado por datos pertinentes, y la incertidumbre de ese modelo debe acompañar la inferencia estructural.
La elección de variables tiene así dos aspectos. Uno es qué conceptos o cantidades se incluyen; otro es qué registro representa cada uno. Dos estudios pueden usar etiquetas parecidas y obtener grafos distintos porque difieren en población, instrumentos o conjuntos de ajuste. Comparar solamente dibujos omite esas diferencias. Una comparación interpretable debe establecer primero si las matrices pretenden describir las mismas variables bajo el mismo nivel de observación.
Dónde se necesita la normalidad conjunta
La inversión de una matriz de covarianzas y la correlación entre residuos lineales pueden calcularse fuera de la familia gaussiana, siempre que existan los momentos necesarios y la matriz sea invertible. Lo que deja de estar garantizado es la equivalencia entre un cero y una independencia condicional. Baba, Shibata y Sibuya (2004) examinan precisamente las relaciones entre correlación parcial, correlación condicional e independencia, y delimitan las condiciones bajo las cuales pueden relacionarse.
Un ejemplo construido muestra que ni siquiera basta con que cada variable marginal tenga distribución normal. Sean y normales estándar independientes. Sea además una variable independiente de ambas que toma los valores menos uno y uno con igual probabilidad. Definamos . La variable conserva una distribución normal estándar por simetría, por lo que es marginalmente normal con varianza dos.
La covarianza entre e es cero: el signo aleatorio tiene media cero y el error es independiente. Sin embargo, las variables son dependientes. Condicionado a , el segundo momento de es . Cerca de cero, la distribución condicional tiene menor dispersión que cuando el valor absoluto de es grande. Conocer informa sobre esa dispersión aunque no cambie la media condicional de , que sigue siendo cero.
Otra comprobación utiliza momentos. En esta construcción, , mientras . Si fueran independientes, esas cantidades coincidirían. Añadir una tercera variable normal independiente no cambia el argumento: la correlación parcial entre las primeras seguiría siendo cero, pero su dependencia persistiría incluso después de condicionar por la tercera. La distribución conjunta no es gaussiana, pese a que todas sus marginales lo sean.
Un histograma aproximadamente normal de cada columna no verifica, por tanto, el supuesto requerido por el grafo. También importan las relaciones conjuntas, la forma de las medias condicionales y la variación residual. Transformar cada variable mediante una función invertible conserva las independencias probabilísticas, pero puede alterar las correlaciones lineales y sacar a la distribución de la familia gaussiana. La interpretación debe seguir al modelo probabilístico utilizado, en lugar de atribuir independencia a cualquier cero producido por una matriz inversa.
La discrepancia puede darse también en sentido contrario. Sean , y normales estándar independientes, y construyamos y . Dado el valor exacto de , el término compartido queda fijado y solo varían dos errores independientes. Por tanto, y son independientes condicionado a . Esta independencia puede comprobarse directamente mediante la factorización de sus distribuciones condicionales.
Sin embargo, el ajuste lineal por no retira el término cuadrático. Las covarianzas de y con son cero por simetría, de modo que ambas pendientes lineales respecto a esa variable son nulas. Después de centrar, los dos residuos conservan . Su covarianza es dos, sus varianzas son tres y la correlación parcial lineal es dos tercios. Aquí una asociación parcial distinta de cero coexiste con independencia condicional verdadera.
Si se incorporara correctamente el término cuadrático a las funciones de predicción, los residuos serían los errores originales y desaparecería la asociación. Esa modificación cambia el modelo de ajuste, no la distribución construida. Los dos contraejemplos muestran por qué una correlación residual requiere interpretar la clase de funciones que se ha retirado. Dentro del modelo gaussiano, las medias condicionales lineales y la forma normal de los residuos hacen posible la equivalencia; fuera de él, una matriz de segundos momentos puede omitir tanto dependencias en la dispersión como relaciones no lineales entre medias.
La misma covarianza admite intervenciones diferentes
Podemos generar la matriz inicial mediante dos modelos causales distintos. En ambos, las perturbaciones indicadas a continuación son mutuamente independientes, normales y centradas. En el primero, la primera variable tiene varianza uno; la segunda se forma como , con varianza de error ; y la tercera como , con varianza de error . La estructura causal declarada es una cadena desde la primera hacia la tercera.
En el segundo modelo, la segunda variable es exógena y tiene varianza uno. Las otras se forman como y , con varianzas de error y . Ahora la segunda variable es causa común de las otras dos. Las varianzas y covarianzas resultantes coinciden exactamente con las del primer modelo.
Ambos generan, por tanto, la misma distribución normal observacional, la misma precisión y las mismas correlaciones parciales. Una cantidad arbitrariamente grande de observaciones de esa distribución no distinguiría estas dos construcciones. La dificultad no se debe a falta de potencia estadística: las distribuciones que se compararían son iguales.
Las intervenciones sí difieren. En el primer modelo, fijar externamente en uno en lugar de cero aumenta la media de en tres quintos y la de en tres décimos. En el segundo, la intervención sustituye únicamente la ecuación de ; no modifica la distribución de ni la de . El efecto medio sobre la tercera variable es cero. La correlación marginal de tres décimos es compatible con ambos resultados causales.
Pearl (2009) distingue formalmente condicionar por un valor observado de intervenir sustituyendo el mecanismo que genera una variable. En el ejemplo, observar un valor alto de la primera informa sobre la segunda en ambos modelos. Producir ese valor mediante una intervención tiene consecuencias diferentes porque las ecuaciones causales son distintas. Una flecha no puede deducirse del grosor de una arista no dirigida ni de la reducción de una correlación al ajustar.
La red condicional sigue siendo útil: resume que, en la distribución observacional, la segunda variable aporta la información necesaria para separar a los extremos. Puede orientar preguntas y contrastes posteriores. Para elegir entre las dos explicaciones causales haría falta información capaz de distinguirlas, como un diseño de intervención pertinente o restricciones de conocimiento sustantivo justificadas. La afirmación causal depende de esa evidencia y de cómo se vincule con las variables del modelo.
Una arista creada al condicionar por un efecto común
Consideremos otra construcción gaussiana. La primera y la tercera variables son normales estándar independientes, y la segunda se define como su suma más un error normal independiente de varianza uno. Su matriz de covarianzas es
Los extremos son marginalmente independientes, pero su correlación parcial condicionada a la segunda variable es menos un medio. Si conocemos aproximadamente la suma, un valor alto de un sumando hace más plausible uno bajo del otro. La estructura causal declarada contiene un efecto común, también llamado colisionador. Condicionar por él crea una dependencia entre sus causas sin que exista un efecto causal entre ellas.
El grafo de asociaciones condicionales contiene las tres aristas. Este resultado aclara por qué ese grafo no se obtiene siempre quitando las puntas de las flechas de un diagrama causal. También muestra que un grafo completo de correlaciones parciales puede coexistir con una independencia marginal. La colección de independencias expresadas por diferentes condicionamientos tiene más estructura que la mera lectura de una arista aislada.
Agregar una variable al ajuste puede eliminar, mantener o crear asociaciones según la distribución y el papel de esa variable. «Controlar todo lo disponible» describe una operación estadística, pero no garantiza aislar efectos causales directos. Para interpretar un cambio de arista hay que precisar qué pregunta se está respondiendo antes y después de ampliar el conjunto. En el colisionador, ambas matrices describen correctamente su respectiva distribución; la interpretación causal equivocada aparecería al leer la nueva asociación como influencia entre los extremos.
También puede desaparecer una arista condicional aunque exista un efecto causal directo. Consideremos , y , con errores normales estándar independientes. La segunda variable recibe un efecto directo unitario de la primera. Las tres variables tienen covarianza y precisión
La entrada entre primera y segunda es cero. Ambas son independientes condicionado a la tercera, pese a que intervenir sobre la primera modifica directamente la segunda en el mecanismo declarado. La dependencia que induce condicionar por su efecto común compensa exactamente la asociación asociada al vínculo directo. Este es un resultado de los coeficientes elegidos, no una propiedad de cualquier triángulo causal.
Puede precisarse la compensación variando el ejemplo. Si el coeficiente de la primera variable en la segunda es , y los coeficientes de ambas en la tercera son y , manteniendo errores independientes de varianza uno, la entrada de precisión correspondiente es . El cero aparece cuando esos dos términos coinciden. Cambiar ligeramente uno de ellos hace reaparecer una asociación parcial. Esta dependencia de los parámetros explica por qué deducir estructura causal a partir de independencias requiere excluir ciertas cancelaciones o justificar condiciones que las eviten.
La normalidad conjunta sí garantiza la independencia condicional que representa el cero; lo que no garantiza es su traducción a ausencia de un efecto directo. Son afirmaciones de distinto tipo. El ejemplo permite conservar la conclusión distributiva exacta y, a la vez, identificar la información adicional necesaria para una conclusión causal. Presentar ambas con el mismo significado borraría precisamente el mecanismo de compensación que las cuentas muestran.
De una matriz poblacional a una red estimada
En los ejemplos hemos conocido las matrices exactas. Con datos, normalmente estimamos una covarianza a partir de filas observadas. La variación muestral afecta a sus entradas y se propaga mediante la inversión. Incluso si un elemento de la precisión poblacional es cero, su estimación sin restricciones casi nunca será exactamente cero en una muestra continua. La ausencia de una arista en un gráfico estimado requiere conocer qué regla produjo ese cero.
Si hay observaciones y se estima la media, la covarianza muestral tiene rango como máximo . Cuando el número de variables alcanza o supera el de observaciones, esa matriz no puede invertirse de manera ordinaria. Incluso con más observaciones que variables puede haber singularidad por duplicación de columnas o relaciones deterministas. Una matriz casi singular produce otra dificultad: pequeños cambios de sus entradas pueden generar diferencias grandes en la inversa.
Una suma registrada junto a sus componentes ilustra una singularidad que aumentar la muestra no resolvería. Si dos variables independientes tienen varianza uno y la tercera es exactamente su suma, la tercera columna está determinada por las otras dos. El determinante de la covarianza es cero para la población misma. Condicionado al valor de la suma, aumentar un componente exige disminuir el otro en la misma cantidad, y la distribución condicional queda restringida a una recta. Este objeto no satisface el supuesto de densidad gaussiana no degenerada que usamos para interpretar la precisión. Sustituir la inversa por una inversa generalizada puede servir para ciertos cálculos algebraicos, pero no restablece automáticamente aquel teorema de independencia. La solución depende de la pregunta: puede redefinirse el conjunto de variables para eliminar la redundancia o utilizarse un modelo que represente explícitamente la restricción.
Friedman, Hastie y Tibshirani (2008) proponen estimar una precisión dispersa mediante una penalización, en el procedimiento conocido como graphical lasso. Esa solución incorpora un criterio de estimación que favorece ceros. El significado de un cero seleccionado debe distinguirse del cero exacto de una distribución conocida. El ajuste puede estabilizar la estimación, pero no vuelve causales las aristas ni resuelve por sí mismo errores de medición, variables omitidas o especificación distributiva.
También debe conservarse la unidad de observación. Filas repetidas de una misma persona a intervalos cortos pueden ser dependientes. Una covarianza transversal entre personas y una covarianza de variaciones dentro de una persona describen distribuciones distintas. Epskamp y colaboradores (2018) distinguen redes temporales, contemporáneas y entre personas; sus aristas corresponden a información y condicionamientos diferentes. Aumentar el número de registros sin considerar ese nivel no garantiza que se esté estimando la distribución que interesa.
Para interpretar una red concreta conviene acompañar el dibujo con la definición de las variables, las unidades observadas, la matriz o el modelo de estimación y el conjunto exacto de condicionamiento. En nuestra matriz inicial, la ausencia de la arista entre extremos queda demostrada cuando la segunda variable se conoce sin error. Al omitirla aparece una asociación de tres décimos; al observarla con el ruido especificado queda una correlación parcial cercana a . Las tres respuestas son compatibles porque corresponden a información diferente. La pregunta pendiente sobre intervenir en la primera variable sigue requiriendo distinguir los mecanismos causales que la matriz observacional deja abiertos.
Referencias
Baba, K., Shibata, R., y Sibuya, M. (2004). Partial correlation and conditional correlation as measures of conditional independence. Australian & New Zealand Journal of Statistics, 46(4), 657–664. https://doi.org/10.1111/j.1467-842X.2004.00360.x
Chandrasekaran, V., Parrilo, P. A., y Willsky, A. S. (2012). Latent variable graphical model selection via convex optimization. The Annals of Statistics, 40(4), 1935–1967. https://doi.org/10.1214/11-AOS949
Epskamp, S., Waldorp, L. J., Mõttus, R., y Borsboom, D. (2018). The Gaussian graphical model in cross-sectional and time-series data. Multivariate Behavioral Research, 53(4), 453–480. https://doi.org/10.1080/00273171.2018.1454823
Friedman, J., Hastie, T., y Tibshirani, R. (2008). Sparse inverse covariance estimation with the graphical lasso. Biostatistics, 9(3), 432–441. https://doi.org/10.1093/biostatistics/kxm045
Jones, B., y West, M. (2005). Covariance decomposition in undirected Gaussian graphical models. Biometrika, 92(4), 779–786. https://doi.org/10.1093/biomet/92.4.779
Pearl, J. (2009). Causal inference in statistics: An overview. Statistics Surveys, 3, 96–146. https://doi.org/10.1214/09-SS057