Una red estimada puede perder una arista al cambiar ligeramente los datos o al modificar la penalización. Las dos operaciones producen dibujos parecidos, pero plantean preguntas diferentes. En el primer caso se examina la sensibilidad a la información disponible. En el segundo se modifica la regla utilizada para estimar. Si una arista desaparece en ambos análisis, todavía falta averiguar qué propiedad del sistema se quería recuperar y con qué evidencia podría comprobarse.
La regularización introduce una preferencia por ciertas soluciones, como matrices con muchas entradas nulas. Puede reducir la variación de las estimaciones y facilitar cálculos que serían difíciles con pocos datos. También modifica los pesos y puede eliminar conexiones existentes. Una red menos densa no lleva incorporada una garantía de mayor fidelidad estructural. Esa fidelidad se evalúa respecto de un objetivo y unas condiciones de observación, mientras que la densidad describe cuántas conexiones contiene el resultado.
Conviene separar varias tareas. Elegir la penalización determina el compromiso utilizado para ajustar. Evaluar predicciones comprueba cómo funciona el modelo en observaciones no empleadas para ajustarlo. Estudiar estabilidad pregunta cuánto cambia una conclusión al perturbar datos o procedimientos. Replicar exige obtener evidencia nueva y comparar resultados que tengan el mismo significado. Ninguna de estas tareas sustituye automáticamente a las otras.
Un ejemplo gaussiano de cuatro variables permitirá calcular esas diferencias. Sus matrices están construidas para fines didácticos; no proceden de observaciones clínicas ni de un experimento de remuestreo. Conoceremos incluso la distribución objetivo para evaluar exactamente el riesgo predictivo. Esa información, habitualmente desconocida en una investigación, permitirá distinguir lo que hace el estimador de lo que puede averiguar quien dispone de una muestra.
Qué representa una arista estimada
Consideremos un vector de variables gaussianas centradas, con matriz de covarianzas y matriz de precisión . En este modelo, una entrada fuera de la diagonal de la precisión igual a cero representa independencia condicional entre las dos variables, dadas todas las restantes. La red es no dirigida. Su significado depende del conjunto de variables incluidas: condicionar sobre otro conjunto puede cambiar qué pares quedan asociados.
Los pesos suelen expresarse mediante correlaciones parciales,
Una entrada de precisión y una correlación parcial tienen el mismo patrón de ceros, pero distinta escala. Confundir sus magnitudes distorsiona la comparación entre redes. Tampoco una correlación parcial equivale por definición a un efecto de intervención. El modelo resume dependencias condicionales bajo supuestos gaussianos; la dirección temporal, las variables omitidas y la identificación causal requieren información adicional.
Si hay variables, existen pares posibles. El número de parámetros crece rápidamente y la matriz empírica de covarianzas puede ser difícil de invertir, especialmente cuando hay muchas variables respecto de las observaciones. Incluso cuando puede invertirse, las fluctuaciones de sus entradas se propagan al conjunto de la inversa. La dificultad no se reduce a estimar por separado una correlación para cada línea del dibujo.
Friedman, Hastie y Tibshirani (2008) desarrollaron el graphical lasso para estimar una precisión dispersa mediante penalización de norma uno. Su formulación conecta el problema con actualizaciones de regresión penalizada acopladas. Es importante precisar qué versión del objetivo se aplica: el artículo escribe una penalización que incluye la diagonal y también discute la variante que la excluye. Las convenciones afectan a las ecuaciones y al significado numérico del parámetro.
La unidad de observación debe quedar igualmente definida. Si cada fila representa una persona distinta, el modelo se refiere a diferencias entre personas bajo el diseño utilizado. Un conjunto de medidas repetidas de una persona requiere considerar su dependencia temporal. Tratar todas las filas como intercambiables puede alterar tanto la estimación como el remuestreo empleado para evaluar su incertidumbre. Una red con el mismo aspecto visual puede corresponder a objetivos estadísticos diferentes.
Una penalización cuyo efecto puede calcularse
Utilizaremos una matriz empírica estipulada , con varianzas unitarias, correlación de entre las variables primera y segunda, y de entre la tercera y la cuarta. Las covarianzas entre ambos pares son cero:
La matriz es definida positiva. Para cada , estimamos una precisión definida positiva que minimice
No penalizamos la diagonal. El factor dos equivale a sumar los elementos fuera de ella en ambas posiciones simétricas. Mantener esta convención evita que dos programas llamados graphical lasso parezcan usar la misma penalización cuando, en realidad, sus parámetros difieren por un factor constante o por incluir entradas adicionales.
El primer término y el logaritmo del determinante forman la pérdida gaussiana, salvo factores y constantes que hemos fijado al definir el objetivo. La penalización cobra por la magnitud absoluta de las entradas fuera de la diagonal. El estimador puede reducir una entrada o llevarla exactamente a cero. La condición de matriz definida positiva restringe todas las entradas de forma conjunta; no sería válido modificar arbitrariamente cada arista e ignorar si la matriz resultante sigue representando una distribución.
La estructura particular de dos bloques permite resolver el ejemplo. Para un bloque con correlación empírica positiva , sea . La covarianza ajustada del bloque y su inversa son
La correlación parcial resultante es . Los términos que conectan los dos bloques permanecen nulos. Esta solución satisface las condiciones de optimalidad del problema completo: la diagonal de coincide con la de ; para una entrada activa, equivale a multiplicado por el signo de la precisión; para una entrada nula, la diferencia absoluta no supera .
El umbral simple aparece porque el ejemplo se separa en dos bloques de dos variables. No constituye una receta para restar la penalización a cada correlación de una matriz general. En redes mayores, las entradas de la inversa están acopladas y las condiciones de optimalidad se refieren a la covarianza ajustada y a la precisión simultáneamente. Aplicar un umbral independiente a la matriz de correlaciones resolvería otro problema.
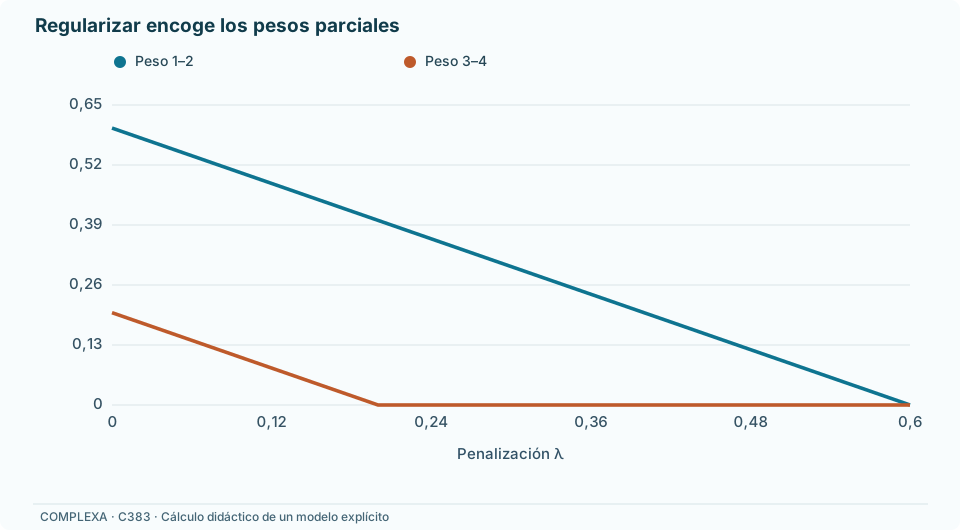
| Penalización | Peso parcial del par 1–2 | Peso parcial del par 3–4 | Aristas presentes |
|---|---|---|---|
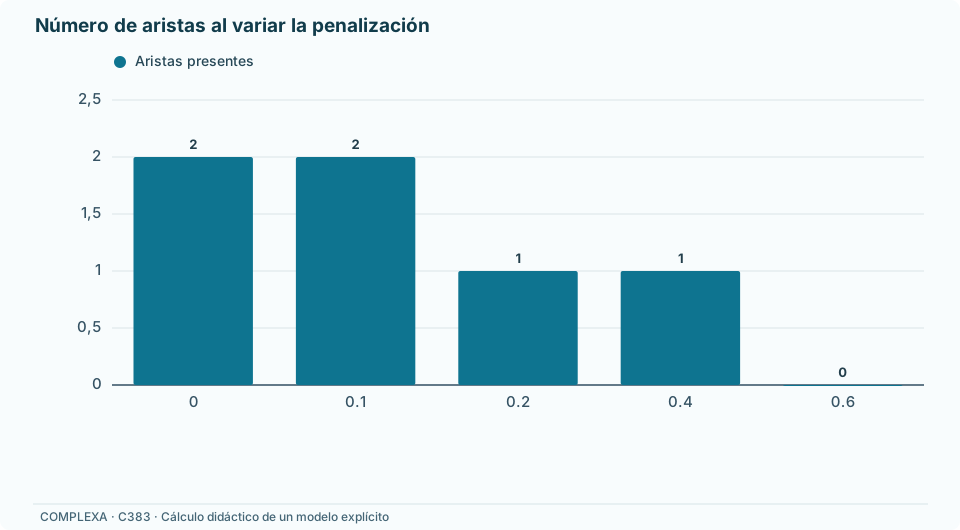
| 0 | 0,60 | 0,20 | 2 |
| 0,10 | 0,50 | 0,10 | 2 |
| 0,20 | 0,40 | 0 | 1 |
| 0,40 | 0,20 | 0 | 1 |
| 0,60 | 0 | 0 | 0 |
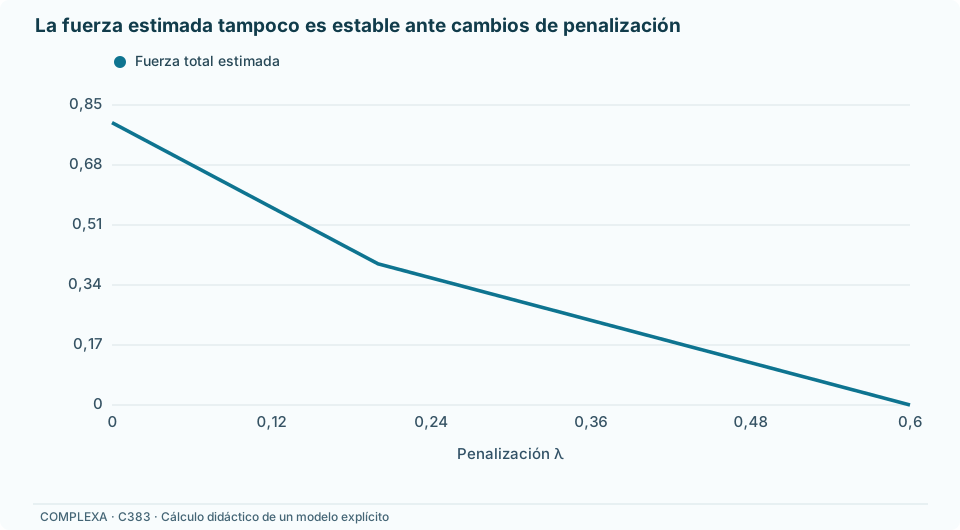
Con penalización , la entrada de precisión del primer par es , mientras que su peso parcial es . La distinción de escala ya es visible en una red pequeña. La densidad pasa de dos de los seis pares posibles a uno de seis, y finalmente a cero. La trayectoria describe qué produce cada criterio; no indica todavía cuál de esas redes debe preferirse.
Un cero regularizado es una salida de una regla de selección. Puede corresponder a una independencia de la población o a una asociación demasiado pequeña para superar la penalización con los datos disponibles. La incertidumbre no desaparece porque el resultado se imprima como cero exacto. Del mismo modo, una arista seleccionada puede reflejar una fluctuación de la muestra, además de una dependencia que persista en la población.
Hay que distinguir además el cero del estimador del cero empleado para mostrarlo. En un bloque cuya correlación empírica fuera , la penalización dejaría un peso parcial de . Redondearlo a dos decimales produce una etiqueta de cero, aunque la solución matemática conserva una arista. Un programa podría omitirla del dibujo mediante un umbral de visualización. Esa decisión añade otra regla a la estimación y debe conservarse al comparar grafos. El número de líneas dibujadas puede depender del formato, además del criterio estadístico.
Las tolerancias del algoritmo plantean una comprobación relacionada. Cerca del umbral, conviene saber si un valor pequeño satisface las condiciones de optimalidad dentro de la precisión numérica prevista o si el ajuste se detuvo demasiado pronto. Repetir el mismo cálculo con una tolerancia más exigente examina un problema computacional. No equivale a añadir observaciones ni estima variación muestral. La estabilidad frente al cálculo, frente a los datos y frente al modo de representar los resultados debe mantenerse diferenciada.
Las unidades forman parte del criterio
La penalización uniforme de entradas de precisión depende de las unidades. Si multiplicamos la primera variable por diez, su varianza empírica pasa a cien y su covarianza con la segunda pasa a seis. Las correlaciones observadas no cambian. Sin embargo, si ajustamos las nuevas covarianzas con la misma penalización numérica , la covarianza ajustada del primer par pasa a , y su correlación parcial es . Antes del cambio de unidad era .
La discrepancia procede de cómo se transforma la precisión. Al multiplicar una variable por diez, las entradas de precisión que la conectan con otra se dividen por diez en la transformación equivalente. Cobrar la misma cantidad por su valor absoluto modifica la penalización efectiva. La parte gaussiana de la comparación se transforma de manera coherente, pero una penalización uniforme expresada en las nuevas unidades no es automáticamente la misma preferencia de estimación.
Estandarizar variables antes del ajuste es una manera de fijar una escala común; también pueden definirse penalizaciones ponderadas que respeten transformaciones especificadas. En cualquiera de los casos hay que conservar la decisión al comparar muestras. Si se usan validación cruzada o datos nuevos, las transformaciones deben construirse con la información disponible en la etapa correspondiente. Estimar escalas con todo el conjunto antes de separar evaluación y ajuste puede introducir información que el procedimiento no tendría al aplicarse a casos futuros.
Una transformación de escala tampoco resuelve diferencias de contenido. Dos instrumentos que miden aspectos distintos no se vuelven equivalentes por tener media cero y varianza uno. La comparación de redes exige revisar la definición de los nodos, además de su normalización numérica. Cambiar una pregunta o su periodo de referencia puede cambiar la variable condicionada, aun cuando conserve el mismo nombre en el gráfico.
También importa la normalización de la función de ajuste respecto del tamaño de la muestra. Hemos definido una pérdida a partir de la matriz de covarianzas, sin multiplicarla por el número de observaciones. Si otro programa utiliza la logverosimilitud total, deberá transformar la penalización de manera correspondiente para representar el mismo compromiso. Copiar un valor del parámetro entre ambas convenciones puede producir redes distintas aun con datos idénticos. Y aunque se mantenga exactamente nuestra convención, disponer de la misma matriz empírica en dos muestras de tamaños diferentes no implica tener la misma precisión estadística. El ajuste determinado por esa matriz puede coincidir mientras la información disponible para evaluar su incertidumbre difiere.
Por ello, cuando se documenta una penalización elegida, conviene conservar la ecuación que la define y la información sobre el diseño, además del número utilizado. Una matriz resumida permite repetir nuestro cálculo determinista, pero no revela por sí sola cuántas unidades independientes la sustentan ni cómo se seleccionaron. Esa diferencia será relevante al pasar del ejemplo algebraico a una comparación externa.
Elegir para predecir y elegir para recuperar una estructura
Para evaluar predicción, estipulemos una población objetivo con otra matriz de covarianzas . Tiene los mismos bloques, pero sus correlaciones son y cero. La distribución es gaussiana centrada y sus varianzas son uno. Este conocimiento forma parte del ejemplo; no se obtiene a partir de . La pérdida predictiva esperada, en la convención elegida y omitiendo constantes comunes, es
Se calcula evaluando cada precisión ajustada en esa misma población. Los valores son aproximadamente , , , y cuatro para las cinco penalizaciones de la tabla. La mejor es , cuya covarianza ajustada coincide exactamente con . Aumentar la penalización inicialmente mejora el pronóstico; seguir aumentándola termina por empeorarlo.
La mejora no surge de que una penalización positiva sea siempre superior. Hemos estipulado una matriz de ajuste con asociaciones mayores que las de la población objetivo. Si la matriz usada para ajustar coincidiera ya con , reducir sus asociaciones empeoraría este riesgo. La utilidad de contraer depende de los errores que se estén compensando y del objetivo evaluado. En datos reales esa comparación requiere información que no se limita al ajuste conseguido en la muestra original.
La estructura de la población objetivo contiene una sola arista. Las penalizaciones y recuperan ese mismo conjunto, pero sus pesos son diferentes y sus pérdidas predictivas también. Por tanto, acertar qué pares son nulos y estimar bien los parámetros restantes son logros separables. Una evaluación de recuperación estructural podría contar aristas omitidas y añadidas; una evaluación predictiva asigna consecuencias según toda la distribución ajustada.
Una dependencia muy pequeña permite ver la diferencia en sentido inverso. Para un único par gaussiano de varianzas unitarias y correlación poblacional , el riesgo óptimo en nuestra convención es . La aproximación que elimina su arista tiene riesgo dos. La pérdida predictiva adicional es aproximadamente , aunque la decisión estructural sobre ese par sea incorrecta. Una evaluación que cuente aristas asigna un error completo; la pérdida probabilística registra una diferencia pequeña. Ninguna de las dos cifras sustituye a la otra.
Esto afecta a la capacidad de discriminar candidatos con una muestra de validación. Cuando sus riesgos son cercanos, la variación de la evaluación puede ser mayor que la diferencia que se intenta detectar. Seleccionar el menor promedio observado no demuestra que sea el menor riesgo poblacional, y mucho menos que su patrón de ceros sea el verdadero. Para una pregunta sobre estructura interesan también las señales mínimas que el diseño podría distinguir. La ausencia de un contraste predictivo grande no establece la ausencia de todas las dependencias débiles.
Tampoco debe elegirse la penalización comparando directamente los mínimos de obtenidos para distintos valores de . Al hacerlo cambia la función que se está midiendo. En este ejemplo, esa comparación favorecería la penalización cero. Para seleccionar hay que definir un criterio común entre candidatos, como la pérdida en datos reservados o un criterio de información aplicado de manera consistente.
En validación cruzada, cada candidato se ajusta con una parte de los datos y se evalúa con observaciones excluidas de ese ajuste. Si el objetivo es una distribución conjunta gaussiana, puede usarse su pérdida logarítmica; si se busca predecir una variable concreta, el criterio puede ser otro. La partición debe respetar personas, centros o series cuando esas unidades generan dependencia. Elegir un candidato y estimar su desempeño final sobre las mismas comparaciones también introduce selección; una evaluación externa o una partición adicional permite examinar el procedimiento elegido.
Foygel y Drton (2010) estudian un criterio bayesiano de información extendido para selección de estructuras gaussianas. A la penalización por tamaño del modelo se añade un término que depende del número de variables y de un parámetro adicional. En su definición se evalúa la verosimilitud maximizada sin penalización dentro de cada grafo candidato; la trayectoria del lasso puede generar esos candidatos. Eso difiere de confundir la verosimilitud con el objetivo penalizado. Sus resultados de consistencia requieren condiciones sobre el crecimiento dimensional, las señales y los grafos considerados; no establecen superioridad predictiva universal frente a validación cruzada.
La elección puede dejar preguntas abiertas aunque esté bien ejecutada. Un criterio estructural selecciona entre los grafos que se le ofrecen. Si la trayectoria examinada omite una estructura pertinente, el criterio no puede recuperarla. Una validación orientada a predicción puede tolerar una arista pequeña adicional si su coste predictivo es mínimo. Explicitar esas prioridades permite interpretar por qué dos procedimientos eligen redes distintas sin atribuir la discrepancia de inmediato a un fallo de cálculo.
Estabilidad bajo perturbaciones especificadas
Para estudiar la sensibilidad de la selección, construyamos diez matrices del mismo tipo que . Las correlaciones del primer bloque serán, en orden, . Las del segundo serán . Se emparejan por posición y se mantienen las demás entradas. Todas son matrices definidas positivas.
Son perturbaciones diseñadas, no resultados de bootstrap ni muestras independientes generadas por una población. Sirven para calcular qué mide una frecuencia de inclusión. Con penalización fija , el primer par aparece en las diez matrices y el segundo en cinco. Las frecuencias son uno y un medio. Los otros cuatro pares nunca aparecen porque sus covarianzas cruzadas permanecen en cero en esta construcción.
La inclusión del segundo par cambia al atravesar el umbral. Dos correlaciones empíricas muy próximas, una ligeramente inferior y otra ligeramente superior a , producen un cero y un peso positivo pequeño. El peso puede variar suavemente mientras el indicador de presencia cambia de forma abrupta. Una comparación exclusivamente binaria de grafos puede presentar como ruptura estructural una diferencia numérica diminuta. Eso no invalida la selección, pero obliga a distinguir la estabilidad del indicador de la estabilidad de la magnitud.
Si representa una frecuencia de inclusión, la cantidad resume desacuerdo entre dos selecciones independientes con esa probabilidad. Vale cero para un par siempre ausente o siempre presente y alcanza un medio cuando la inclusión es igualmente probable que la ausencia. Con nuestras frecuencias y promediando sobre los seis pares posibles, el resultado es , aproximadamente .
El promedio no debe calcularse solo sobre las aristas seleccionadas en la red original si se pretende utilizar esta definición. Su denominador contiene todos los pares candidatos. Tampoco permite afirmar que el segundo par tenga probabilidad de un medio de ser verdadero. En la construcción conocemos que la población objetivo lo tiene ausente; la frecuencia describe el comportamiento de la regla en las perturbaciones seleccionadas.
El mismo cálculo muestra por qué estabilidad y exactitud no coinciden. Sin penalización, ambos pares aparecen en las diez matrices y el desacuerdo es cero, aunque el segundo no pertenece a la estructura objetivo estipulada. Con penalización , todas las redes quedan vacías y el desacuerdo vuelve a ser cero, aunque ahora se omite la arista objetivo. Con , el primer par aparece tres veces y la inestabilidad media es . Minimizar sin más ese resumen no identifica la red deseada.
Liu, Roeder y Wasserman (2010) desarrollaron StARS mediante la estabilidad bajo submuestreo. El método recorre una trayectoria desde grafos más dispersos hacia grafos más densos, calcula una envolvente no decreciente de la inestabilidad y selecciona mediante un umbral. Esa construcción evita interpretar una caída tardía de la inestabilidad, debida a que muchas aristas aparecen siempre, como una nueva justificación para densificar. Nuestro cálculo ilustra el desacuerdo bruto; no ejecuta StARS ni reproduce su esquema de muestreo. Sus garantías estructurales adicionales requieren condiciones y no equivalen a recuperación exacta automática.
Meinshausen y Bühlmann (2010) proponen otra familia de procedimientos, la selección por estabilidad, combinando submuestreo y reglas de selección. Sus cotas de falsas selecciones dependen de cantidades controladas y supuestos sobre el comportamiento de las variables nulas y del procedimiento básico. La frecuencia de selección no es una probabilidad posterior de que una conexión exista. Tampoco basta elegir un umbral elevado de frecuencia para heredar una garantía cuyo esquema y supuestos no se han comprobado.
En una aplicación, las perturbaciones deberían corresponder a la incertidumbre que interesa. Remuestrear personas examina una variación distinta de excluir un centro, cambiar una decisión de codificación o variar el conjunto de nodos. Las dos últimas operaciones pueden modificar el objetivo estadístico, además del estimador. Es útil informar cada análisis por separado, de modo que una conclusión estable frente a una operación no se presente como resistente a todas ellas.
Por ejemplo, permutar por separado las columnas destruye las correspondencias entre variables de una misma observación. Puede servir para construir una comparación bajo determinadas hipótesis de ausencia de asociación, pero no reproduce el mecanismo del bootstrap de filas completas. Este último conserva juntas las variables observadas en una persona al volver a seleccionarla. Si los datos tienen grupos dependientes, habrá que considerar cómo preservar esa dependencia al remuestrear. La operación concreta determina qué distribución de resultados se está explorando; llamarla simplemente perturbación no informa de si representa variación de muestreo, una hipótesis nula o un cambio en la pregunta.
Incertidumbre de pesos y estabilidad de conclusiones
Epskamp, Borsboom y Fried (2018) distinguen la precisión de los pesos y la estabilidad de índices de centralidad al remuestrear observaciones. Sus procedimientos muestran cuánto depende una conclusión de la muestra y de mantener determinados casos. Advierten también sobre interpretar los intervalos bootstrap de aristas regularizadas como pruebas convencionales frente a cero. La selección y la contracción alteran el comportamiento de las estimaciones; un intervalo presentado sin indicar ese procedimiento puede recibir una interpretación injustificada.
Hay al menos dos preguntas posibles cuando se repite el ajuste. Se puede mantener fija la penalización elegida originalmente para estudiar variación condicional a esa decisión. O puede repetirse toda la selección del parámetro dentro de cada remuestra para examinar el procedimiento completo. Los resultados no responden a lo mismo. Mantener fija una decisión que en la práctica se aprende de los datos puede omitir parte de la variación que experimentaría una aplicación nueva.
La misma distinción aparece al conservar el grafo seleccionado y volver a estimar únicamente sus pesos. Esa operación trata su conjunto de aristas como dado. Puede ser adecuada para una pregunta condicional, pero no incorpora la posibilidad de que una nueva muestra seleccione otro conjunto. En el ejemplo, fijar la ausencia del segundo par después de escoger borraría de la evaluación las cinco perturbaciones donde ese par habría aparecido.
Una conclusión derivada de la red necesita su propia evaluación. Si interesa comparar dos pesos, la incertidumbre de su diferencia depende de cómo covarían sus estimaciones. Mirar dos intervalos por separado no proporciona toda esa información. Si interesa clasificar nodos por centralidad, pequeñas diferencias de pesos pueden invertir posiciones muy cercanas. Una posición destacada en el dibujo no ofrece una medida de cuánto podría cambiar esa clasificación con otros datos.
La regularización tampoco convierte esa clasificación en una recomendación de intervención. Una centralidad describe una propiedad del grafo estimado, y el grafo gaussiano describe asociaciones condicionales. Para modificar un sistema haría falta especificar qué acción se aplicará, qué relaciones cambiarían y cómo se mediría su efecto. El análisis de estabilidad puede impedir una interpretación excesivamente precisa del orden de nodos, pero no proporciona por sí mismo esa información causal.
Replicar requiere otra fuente de información
La replicación externa incorpora datos obtenidos de manera independiente. Supongamos, de nuevo solo como construcción, que otro conjunto produce correlaciones de y en los dos bloques. Con la misma penalización , la red contiene únicamente el primer par, con peso . Coincide en estructura con la red original estimada con esa penalización, cuyo peso era , pero no coincide en magnitud. Afirmar que la red replicó requiere especificar cuál de ambas propiedades se considera.
Los resúmenes globales pueden ocultar otra diferencia. Si se compara una red con los dos pares presentes frente a otra que contiene únicamente el primero, coinciden en cinco de las seis decisiones de presencia o ausencia. El acuerdo es del por ciento. Sin embargo, solo comparten una de las dos aristas que aparece en alguna de ellas: el índice de Jaccard es un medio. Ambos cálculos son correctos; ponderan de forma distinta las ausencias compartidas y las conexiones observadas.
Forbes y colaboradores (2017) examinaron redes de síntomas binarios de depresión y ansiedad en dos encuestas y en particiones de esas muestras. Encontraron que semejanzas generales podían coexistir con diferencias en aristas, pesos y centralidades. Sus modelos incluían redes de asociación, modelos de Ising regularizados y otros procedimientos; su estudio no es una prueba universal sobre todos los grafos gaussianos. El caso muestra por qué una comparación debe declarar qué detalle intenta reproducir y bajo qué diseño.
Antes de interpretar una discrepancia conviene comprobar si ambas investigaciones estiman la misma cantidad. Cambios en los nodos, en la población, en el periodo observado o en el tratamiento de valores ausentes pueden alterar las asociaciones condicionales. Una réplica que modifica esas condiciones puede ser informativa sobre transporte o heterogeneidad, pero su interpretación difiere de repetir el procedimiento sobre otra muestra de la misma población definida.
La desaparición de un nodo ofrece un ejemplo calculable. Consideremos tres variables gaussianas con correlaciones de un medio entre la primera y la segunda y entre la segunda y la tercera, y de un cuarto entre la primera y la tercera. La correlación parcial de estas últimas, dada la segunda, es cero: el numerador resta al cuarto observado el producto de los dos medios. Si se elimina la segunda variable del análisis, la red de las dos restantes contiene una correlación de un cuarto. La distribución original no cambió; cambió la información sobre la que se condiciona. Comparar ambas aristas como si midieran el mismo parámetro produciría una falsa discrepancia de replicación.
Incluso manteniendo los nodos, exigir identidad numérica entre estimaciones independientes sería un criterio inadecuado para muestras finitas. Puede interesar la compatibilidad de signos, una diferencia de magnitud dentro de un margen definido o la precisión con que se evalúa una estructura compartida. Esos criterios deben declararse antes de observar la comparación. No detectar una diferencia con datos imprecisos no demuestra equivalencia estrecha. A la inversa, una diferencia estadísticamente detectable puede ser pequeña respecto de la tolerancia pertinente al uso. La evaluación debería conservar tanto la diferencia estimada como su incertidumbre y el margen que le da significado.
También debe conservarse la regla de selección. Reutilizar la penalización numérica de la primera muestra y volver a elegirla en la segunda son procedimientos distintos. El primero evalúa una regla fijada; el segundo examina la reproducibilidad de un proceso de aprendizaje. Si se decide entre ambos después de ver qué produce mayor coincidencia, la comparación adquiere una flexibilidad que conviene reconocer. Definir de antemano el objetivo y las decisiones analíticas permite interpretar el resultado aunque sea menos favorable.
La reproducción del cálculo ocupa otro lugar. Conservar la matriz o los datos admisibles, el tratamiento de faltantes, la escala, el criterio, la trayectoria de penalizaciones y las tolerancias numéricas permite obtener de nuevo la misma red. Esa comprobación puede descubrir errores de implementación. Una reproducción exacta sobre los mismos datos no añade una muestra independiente ni demuestra que las aristas reflejen el sistema fuera de ellos.
Volvamos a los pesos parciales de y obtenidos en la comparación externa construida. Su diferencia absoluta es . Si se hubiese fijado previamente un margen admisible de , la comparación descriptiva quedaría fuera de ese margen, aunque ambas redes contengan la misma arista y conserven su signo positivo. Las matrices estipuladas bastan para calcular esa diferencia entre ajustes. No permiten construir un intervalo de incertidumbre sobre la diferencia entre parámetros poblacionales, porque no hemos especificado muestras, tamaños ni mecanismos de observación.
En una réplica real, ese paso exigiría conservar los datos y el diseño necesarios para estimar la precisión de la diferencia con un procedimiento apropiado al ajuste seleccionado. Habría que indicar además si el margen se refiere al parámetro poblacional o a la salida regularizada de una regla concreta: la contracción puede afectar a ambas muestras de manera distinta. Una diferencia estimada fuera del margen, pero acompañada de gran incertidumbre, dejaría abierta una conclusión que datos más precisos podrían resolver. El resultado informativo sería entonces la arista compartida, la diferencia de pesos y la precisión con que se puede compararla con el margen previamente elegido.
Referencias
Epskamp, S., Borsboom, D., y Fried, E. I. (2018). Estimating psychological networks and their accuracy: A tutorial paper. Behavior Research Methods, 50(1), 195–212. https://doi.org/10.3758/s13428-017-0862-1
Forbes, M. K., Wright, A. G. C., Markon, K. E., y Krueger, R. F. (2017). Evidence that psychopathology symptom networks have limited replicability. Journal of Abnormal Psychology, 126(7), 969–988. https://doi.org/10.1037/abn0000276
Foygel, R., y Drton, M. (2010). Extended Bayesian information criteria for Gaussian graphical models. Advances in Neural Information Processing Systems, 23, 604–612. https://arxiv.org/abs/1011.6640
Friedman, J., Hastie, T., y Tibshirani, R. (2008). Sparse inverse covariance estimation with the graphical lasso. Biostatistics, 9(3), 432–441. https://doi.org/10.1093/biostatistics/kxm045
Liu, H., Roeder, K., y Wasserman, L. (2010). Stability approach to regularization selection (StARS) for high dimensional graphical models. Advances in Neural Information Processing Systems, 23, 1432–1440. https://arxiv.org/abs/1006.3316
Meinshausen, N., y Bühlmann, P. (2010). Stability selection. Journal of the Royal Statistical Society, Series B (Statistical Methodology), 72(4), 417–473. https://doi.org/10.1111/j.1467-9868.2010.00740.x