Una desviación puede corregirse con rapidez a costa de aplicar una acción intensa. También puede reducirse gradualmente, aceptando que el sistema permanezca más tiempo lejos de la referencia. Para comparar esas trayectorias hace falta especificar cuánto cuesta cada consecuencia. La dinámica indica qué movimientos son posibles; el criterio de control indica cuáles se prefieren.
El regulador cuadrático lineal, habitualmente abreviado LQR, combina una dinámica lineal con un costo cuadrático de estados y acciones. Esa combinación permite calcular una política de realimentación y comprobar su optimalidad. El resultado depende de los pesos, del horizonte y del tratamiento del estado final. Cambiar esos elementos puede modificar la acción aunque el sistema físico permanezca idéntico.
Trabajaremos con un ejemplo construido, sin datos experimentales. Una variable representa la desviación respecto de una referencia constante, y una acción modifica esa desviación en cada paso. El modelo permitirá resolver exactamente tres decisiones sucesivas, variar el costo de actuar y examinar qué ocurre cuando una acción futura queda limitada.
Definir el problema antes de resolverlo
La dinámica del ejemplo es
El estado y la acción son escalares expresados en unidades normalizadas. Cada paso dura lo mismo. Una acción negativa reduce una desviación positiva. El estado se conoce exactamente antes de decidir y el modelo no contiene perturbaciones en su versión inicial. El objetivo es regular hacia cero, no seguir una trayectoria cambiante.
Usaremos tres acciones, en los instantes cero, uno y dos. El estado final es . El costo será
con y . En el caso principal ambos valen uno. No hay descuento temporal, límites sobre las acciones ni restricciones sobre los estados. Estas ausencias son parte de la formulación inicial; después introduciremos límites expresos en un problema separado.
El término penaliza la magnitud de la desviación y trata simétricamente ambos signos. El término penaliza la acción. El peso terminal determina qué importancia recibe la desviación al acabar las tres decisiones. El costo inicial es inevitable una vez fijado el estado de partida, pero se conserva en las cuentas para que todos los valores correspondan a la misma definición.
Llamar esfuerzo al cuadrado de una acción es una convención de modelado. Puede representar una aproximación al consumo de un actuador, al desgaste o a una preferencia por acciones moderadas. Su equivalencia con una energía física requiere una relación adicional entre la acción, las unidades y el dispositivo. El problema matemático no establece esa equivalencia por el nombre del término.
En varias dimensiones, la formulación habitual utiliza , con costos y un término final . Las matrices y son simétricas semidefinidas positivas, y es simétrica definida positiva. Así, los costos no son negativos y cualquier dirección no nula de acción recibe una penalización estrictamente positiva.
Una matriz puede penalizar combinaciones de estados, además de componentes individuales. Por ejemplo, valorar que dos magnitudes permanezcan próximas exige representar su diferencia. Los términos cruzados de una forma cuadrática permiten hacerlo, siempre que se respete la condición de no negatividad. En nuestro ejemplo escalar no hay esa ambigüedad: el único estado es ya la desviación que interesa reducir.
La referencia debe ser compatible con la dinámica. Para una variable física y una entrada física , un equilibrio constante satisface . Al definir desviaciones y , se recupera la ecuación lineal de regulación si el modelo original es lineal. La entrada que se envía al actuador es entonces la entrada de equilibrio más la corrección calculada. Penalizar la corrección y penalizar toda la entrada son decisiones distintas.
Por ejemplo, en , sostener la referencia requiere . Cuando la desviación vale cero, una corrección nula mantiene la referencia porque sigue aplicándose esa entrada de equilibrio. Si se interpretara la corrección nula como ausencia total de entrada, el estado siguiente sería cuatro. Este pequeño desplazamiento de coordenadas evita atribuir al regulador un objetivo que la ecuación implementada no puede mantener.
Kalman (1960) desarrolló una formulación del regulador lineal cuadrático mediante funciones de valor y una ecuación de Riccati, en tiempo continuo. Su planteamiento distingue calcular una acción a partir del estado de reconstruir ese estado mediante observaciones. Aquí supondremos que el estado se conoce exactamente y desarrollaremos la versión discreta del problema, con su condición terminal explícita.
La recursión de Riccati incorpora las consecuencias futuras
La función de valor indica el menor costo restante cuando el estado en el instante vale . En el instante final no queda ninguna acción: . Esta condición inicia el cálculo hacia atrás. No se decide primero una acción y luego se evalúa el futuro con una regla arbitraria; el futuro entra mediante su propio costo mínimo.
Si , la decisión actual resuelve
El término entre corchetes incluye tanto el esfuerzo inmediato como el efecto de la acción sobre todas las consecuencias posteriores resumidas por . Su curvatura respecto de es positiva porque . Por eso tiene un mínimo único, incluso si alguna penalización de estado es nula.
Al completar el cuadrado se obtiene
La ganancia determina la fracción de la desviación que se corrige en ese paso. El signo negativo pertenece a la acción de realimentación. Mantener esa convención evita confundir una ganancia positiva con una acción que aumentaría la desviación.
Para , el cálculo comienza con . Un paso hacia atrás da , después y finalmente . Las ganancias que se aplicarán hacia delante son , y . El orden del cálculo y el orden de aplicación son opuestos.
La ganancia cambia aunque la dinámica y los pesos de etapa sean constantes. Al principio quedan más consecuencias futuras que pueden evitarse actuando ahora. Cerca del final, la evaluación depende más directamente del peso terminal. Una ley constante no es, por ese motivo, la forma general de la solución con horizonte finito.
La misma operación en el caso vectorial produce
La matriz invertida es definida positiva bajo los supuestos fijados. El término restado representa la reducción del costo futuro que puede conseguirse mediante el control. Si una dirección de estado no puede modificarse con las entradas disponibles, el cálculo no inventa una capacidad de actuación sobre ella.
La recursión también ofrece una comprobación de optimalidad. En el ejemplo escalar, para cualquier secuencia de acciones que siga la dinámica,
Todos los términos añadidos son no negativos. La política calculada los anula y alcanza el valor . Esta identidad muestra qué se compara: trayectorias del mismo modelo, con el mismo costo y el mismo estado inicial. No certifica el desempeño de una dinámica distinta ni la pertinencia de los pesos elegidos.
La existencia de un mínimo único puede verse también sin usar Riccati. Cada estado futuro es una función afín de la secuencia completa de acciones. Sustituir esas expresiones transforma cada penalización de estado en una función convexa de esa secuencia. La suma de penalizaciones de acciones aporta curvatura estrictamente positiva en todas sus direcciones, porque el peso de actuar es positivo. Así se obtiene un problema cuadrático estrictamente convexo. El cálculo hacia atrás aprovecha su organización temporal y evita tratar todas las decisiones como incógnitas simultáneas.
El coeficiente de la función de valor tiene una interpretación diferente de la ganancia. Si se duplica el estado inicial del problema libre, la política duplica todas las acciones y todos los estados, mientras el costo mínimo se cuadruplica. El coeficiente expresa esa dependencia cuadrática del costo con respecto al estado; la ganancia transforma un estado en una acción. Ninguno de los dos es una varianza ni una medida de incertidumbre en este problema determinista. Las unidades y el papel de cada matriz ayudan a interpretar correctamente las ecuaciones aunque ambas se calculen mediante recursiones.
Una trayectoria óptima y dos componentes del costo
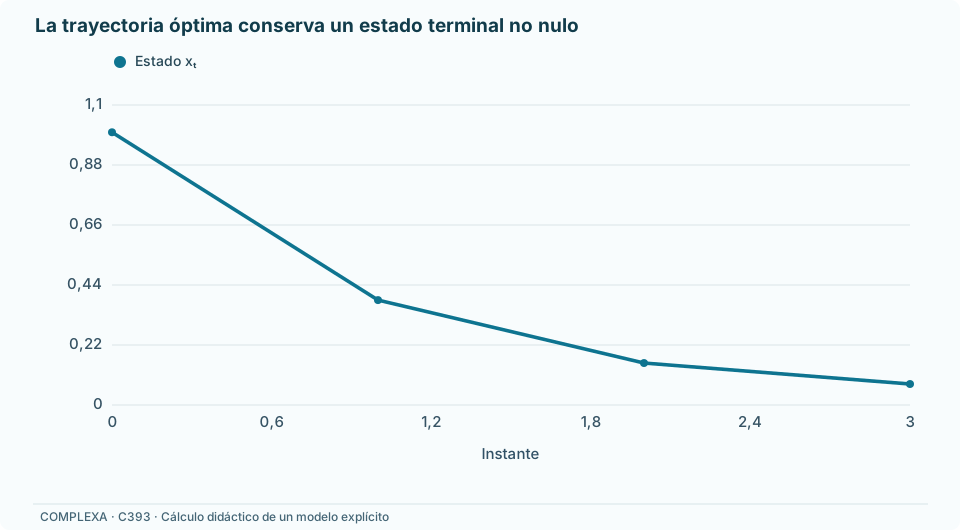
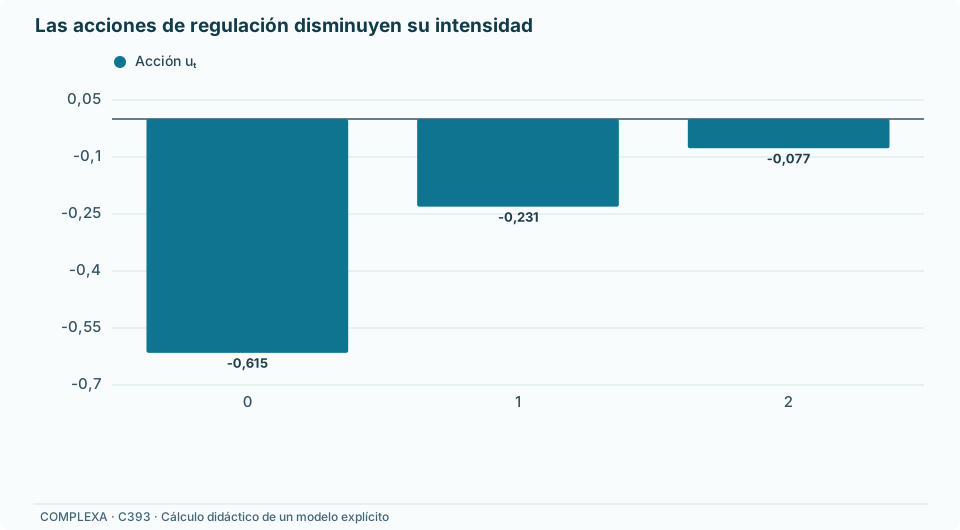
Aplicando las ganancias al estado que se alcanza en cada paso se obtiene la siguiente trayectoria:
| Instante | Estado antes de actuar | Acción óptima | Estado siguiente |
|---|---|---|---|
| 0 | |||
| 1 | |||
| 2 |
El regulador no lleva el estado exactamente a cero al terminar. La penalización terminal es finita y permite intercambiar una pequeña desviación final por una reducción del esfuerzo. Exigir sería otra formulación, con una restricción terminal, no una lectura alternativa del mismo resultado.
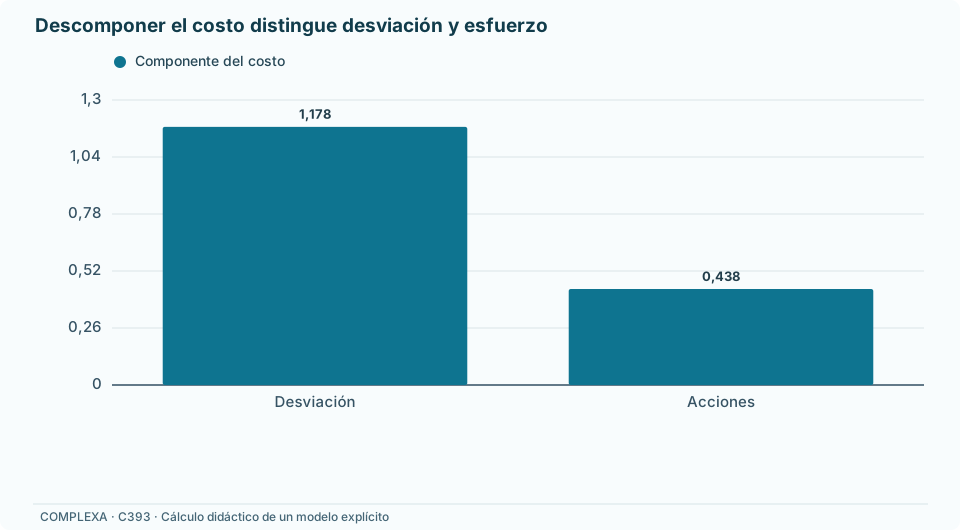
La suma de cuadrados de los cuatro estados es . La suma de cuadrados de las tres acciones es . Como ambos componentes tienen peso uno, su suma da , aproximadamente , coincidiendo con la función de valor. Mantener los componentes separados permite ver qué parte del resultado procede de permanecer lejos de la referencia y cuál de actuar.
Sin ninguna acción, el estado sería uno durante toda la ventana y el costo total sería cuatro. Anular la desviación inmediatamente con , seguido de acciones nulas, produciría costo dos. La trayectoria óptima mejora ambos resultados bajo el criterio definido, distribuyendo la corrección entre los tres pasos.
Aumentemos ahora el peso de la acción a , manteniendo , el horizonte y la dinámica. La nueva recursión da acciones y estados . La primera acción tiene magnitud aproximada , frente a en el caso anterior. La desviación final aumenta de a .
La suma de cuadrados de estados pasa a , mientras que la de acciones baja a . Aproximadamente, el componente de estados aumenta de a , y el esfuerzo cuadrático disminuye de a . Estas magnitudes permiten comparar las consecuencias en una escala común antes de multiplicarlas por los pesos.
El nuevo costo ponderado es , aproximadamente . Compararlo directamente con el valor anterior como si ambos midieran el mismo objetivo sería incorrecto: ahora cada unidad de esfuerzo recibe un peso cuatro veces mayor. El resultado expresa una preferencia más intensa por moderar la acción, junto con la desviación adicional que se acepta para hacerlo.
Ninguno de los dos pesos se obtiene de la ecuación dinámica. Ambos problemas pueden resolverse correctamente y responder a prioridades diferentes. Para elegir entre ellos hace falta justificar cuánto importa reducir la desviación y cuánto cuesta actuar, además de conocer cómo una acción modifica el estado.
Hay una propiedad adicional que sí puede deducirse sin elegir entre prioridades. Para un peso de acción estrictamente positivo, una trayectoria óptima no puede ser superada por otra trayectoria admisible que reduzca uno de los dos componentes sin aumentar el otro. Esa trayectoria alternativa tendría un costo ponderado menor y contradiría la optimalidad. Esto sitúa la solución en una frontera de compromisos entre desviación y esfuerzo, pero no selecciona por sí mismo el punto apropiado de esa frontera.
También puede comprobarse la dirección del cambio al aumentar el peso. Las dos condiciones de optimalidad, cada una evaluando ambas trayectorias bajo su propio criterio, implican que la suma cuadrática de acciones no aumenta cuando su peso aumenta. La suma cuadrática de estados, incluido el terminal con peso fijo, no disminuye. Esta comparación requiere mantener iguales el conjunto admisible, la dinámica y los demás pesos. No afirma que cada acción individual disminuya ni que cada estado sea mayor en cualquier sistema multidimensional; el resultado se refiere a los componentes totales del costo.
El estado final modifica las decisiones anteriores
El costo terminal determina qué consecuencias quedan representadas después de la última acción. Si establecemos , manteniendo , el estado deja de aparecer en el criterio. La última acción solo añade su propio costo y no puede mejorar ningún estado que todavía se evalúe. Por ello, su valor óptimo es cero.
La nueva secuencia es , y los estados son . El costo mínimo vale . La corrección es menor desde el primer paso, porque desapareció una parte de la consecuencia futura que motivaba actuar. El cambio terminal se propaga hacia atrás mediante la recursión.
Ese comportamiento es coherente con el problema planteado. Si se esperaba que el sistema siguiera funcionando después del instante tres, excluir por completo el estado final puede representar mal esa intención. Si realmente termina allí una tarea y su desviación residual carece de consecuencias, la misma decisión puede estar bien justificada. La evaluación depende de qué ocurre al acabar el horizonte.
Una penalización terminal tampoco es idéntica a exigir una condición final exacta. Un costo grande puede favorecer estados finales pequeños, pero una restricción puede declarar inaceptable cualquier desviación distinta de cero. Además, la restricción puede ser imposible de satisfacer. Con tres acciones cuya magnitud no supere , el integrador no puede eliminar una desviación inicial de uno: la corrección total máxima es .
Si el funcionamiento continúa, una posibilidad es representar el costo óptimo de la continuación mediante el término terminal. Cuando ese costo se conoce, el problema finito incorpora el resto de la tarea sin enumerar todas sus decisiones. Si se utiliza una aproximación, su alcance debe comprobarse; elegir cualquier matriz final positiva no la convierte en el valor exacto de la continuación.
Mayne y colaboradores (2000) examinan el papel de costos y condiciones terminales en el control con horizonte móvil. Su artículo debe consultarse junto con la corrección de Mayne y Rawlings (2001). La distinción pertinente aquí es que resolver óptimamente un problema finito y mantener un comportamiento estable al repetir decisiones son cuestiones diferentes. El modo de terminar cada predicción afecta a esa relación. Nuestro cálculo inicial tiene un final fijo y no presupone una repetición indefinida del horizonte.
La política responde al estado observado
En el sistema determinista, aplicar la secuencia calculada y aplicar la realimentación producen la misma trayectoria si todo ocurre como se predijo. La diferencia aparece cuando el estado alcanzado cambia. Una secuencia fijada desde el inicio conserva sus acciones; una política utiliza el estado que se conoce al decidir.
Supongamos que, después de la primera acción del caso principal, una perturbación puntual añade al estado. En el instante uno se observa exactamente , en lugar de . No atribuimos una distribución probabilística a esa perturbación: analizamos la continuación desde el nuevo estado conocido.
Quedan dos acciones y se mantienen el plazo final y los pesos. La realimentación prescribe ; después, el estado vale , la última acción es y el estado final queda en . El costo restante desde el instante uno es .
Si se conservan las acciones nominales y , el estado final es y el costo restante vale . La diferencia de costos es , a favor de volver a utilizar el estado observado. Esta comparación evalúa únicamente la continuación, por lo que los costos ya incurridos antes de conocer la perturbación no intervienen.
El resultado no implica que cualquier realimentación mejore cualquier plan. La política utilizada es la óptima para el modelo y el tiempo restante, y recibe el estado correcto. Una medida errónea, una demora o una acción aplicada de forma distinta pueden cambiar la comparación. En ese caso habría que modelar la información disponible y el proceso real de actuación.
La dependencia temporal de la ganancia también debe conservarse. En el instante uno se utiliza , porque quedan dos decisiones. Volver a usar la ganancia inicial como si siempre quedasen tres decisiones definiría una política de horizonte móvil. Puede ser una elección útil, pero necesitaría su propia evaluación y no sería la continuación del problema de final fijo que acabamos de resolver.
Respetar límites exige resolver el problema limitado
Introduzcamos un caso separado con dos acciones y el mismo integrador. El costo incluye los tres estados y ambas acciones con peso uno. Ahora imponemos y . El límite más estrecho del segundo paso se conoce desde el principio, como podría ocurrir si la disponibilidad futura del actuador disminuyese.
Sin esos límites, el óptimo sería . La segunda acción viola la restricción. Una modificación inmediata consiste en conservar la primera y recortar la segunda a . La trayectoria resultante es factible: sus estados son , y su costo total vale .
Sin embargo, el límite futuro también cambia cuánto conviene corregir ahora. Al sustituir los estados por sus expresiones en función de las dos acciones, el costo es
En el borde , minimizar respecto de la primera acción da , que respeta su límite. Los estados posteriores son y , y el costo alcanza , aproximadamente .
La forma cuadrática es estrictamente convexa. La primera derivada respecto de la acción libre se anula y la derivada respecto de la segunda acción es positiva en su límite inferior, de modo que aumentarla eleva el costo a primer orden. Estas condiciones verifican el mínimo global sobre el rectángulo admisible; también puede comprobarse enumerando los puntos estacionarios factibles de sus caras y vértices.
El recorte excede ese mínimo en . La diferencia numérica es pequeña en este ejemplo, pero identifica un fallo del procedimiento general: modificar únicamente la acción que viola un límite no reconsidera las consecuencias que ese límite tiene sobre decisiones anteriores. El óptimo actúa un poco más en el primer paso porque sabe que podrá actuar menos en el segundo.
Bemporad y colaboradores (2002) estudian el regulador cuadrático lineal con restricciones mediante programación cuadrática paramétrica. Bajo sus condiciones, la política puede describirse mediante expresiones afines en diferentes regiones del estado. Las regiones corresponden a cambios en las restricciones activas. La ley resultante no tiene por qué ser una única ganancia lineal válida para todos los estados.
El ejemplo limitado sigue siendo un problema cuadrático convexo porque la dinámica es lineal y los límites forman un conjunto convexo. No todos los problemas de actuación conservan esa estructura. Decidir entre dispositivos discretos, imponer zonas prohibidas separadas o utilizar una dinámica no lineal puede producir un problema distinto. La denominación cuadrático lineal no elimina las restricciones que se hayan añadido.
Horizonte infinito y estabilidad
Para un funcionamiento indefinido puede considerarse el costo
En el integrador del ejemplo, la solución estacionaria de Riccati satisface . La raíz positiva es , aproximadamente . La ganancia es , aproximadamente .
La dinámica bajo esa política es , con factor aproximado . El estado converge geométricamente a cero. Sustituyendo la trayectoria en la suma infinita se obtiene , lo que comprueba directamente el valor calculado por Riccati.
El valor del problema de tres pasos con peso terminal uno era ligeramente menor, . La diferencia se debe al horizonte y al tratamiento de la continuación. Si utilizáramos , el término terminal representaría exactamente el costo óptimo restante y la recursión conservaría esa misma solución estacionaria en todos los pasos.
En varias dimensiones, condiciones suficientes habituales para la solución estabilizante incluyen estabilizabilidad de , detectabilidad de , semidefinida positiva y definida positiva. La primera exige poder controlar los modos que no son estables. La segunda impide que un modo no estable permanezca invisible para la penalización del estado. No basta con que exista alguna entrada de control en la ecuación.
La distinción entre horizonte finito e infinito importa aquí. En un número finito de pasos puede calcularse un costo finito incluso cuando el estado crece. Para un horizonte infinito, ese crecimiento puede hacer divergir la suma. Resolver la recursión durante tres pasos no prueba que repetir una acción o prolongar la política produzca estabilidad asintótica.
La penalización del estado también puede dejar de expresar esa intención. Consideremos , con costo formado únicamente por , sin penalización terminal ni requisito adicional de estabilidad. La política tiene costo cero, el mínimo posible, aunque el estado se duplique en cada paso.
En este último problema se ha perdido la detectabilidad respecto de : el criterio no ve el modo inestable. No hay una contradicción entre crecimiento y optimalidad, porque el objetivo solo cobra por actuar. Añadir una exigencia de estabilidad o una penalización pertinente al estado cambiaría el problema que debe resolverse.
La solución del integrador permite comprobar estabilidad mediante una función de Lyapunov. Con , la política estacionaria satisface . La disminución es estricta fuera del origen. Boyd y colaboradores (1994) desarrollan métodos matriciales que relacionan funciones de Lyapunov con estabilidad y cotas de desempeño. Una comprobación de ese tipo debe aplicarse a la dinámica realmente considerada.
Qué significa elegir un costo
Los pesos tienen que acompañar a las unidades. Si la desviación se expresa mediante , la dinámica pasa a . Para representar el mismo costo, las penalizaciones cuadráticas de y del estado terminal deben dividirse entre cien. La ganancia respecto de se divide entre diez y las acciones físicas resultantes permanecen iguales.
Cambiar la unidad y conservar numéricamente todos los pesos define otra preferencia. El estado reescalado recibiría una penalización cien veces mayor para la misma desviación física. Una comparación entre controladores necesita fijar las unidades y las normalizaciones antes de atribuir diferencias a la calidad del método.
La duración del paso exige un cuidado parecido. Supongamos ahora que la variable procede de un integrador continuo cuya velocidad es una entrada , mantenida constante durante un intervalo de duración . El incremento discreto es . Si el costo físico de actuación es la integral del cuadrado de la velocidad, su valor durante ese intervalo es . Usar el incremento como acción y reducir la duración del paso sin ajustar su peso cambia el significado del esfuerzo penalizado.
Para el estado, una aproximación rectangular de la integral de su cuadrado daría , evaluando la desviación al principio del intervalo. Con velocidad constante, sin embargo, el estado describe una rampa. La integración exacta de esa rampa produce
Por tanto, una discretización exacta puede introducir un término cruzado entre estado y acción que no figuraba en el costo discreto inicial. Ese problema sigue siendo cuadrático, pero requiere incluir el término cruzado al resolverlo. Las fórmulas anteriores corresponden a la versión declarada sin ese término; no deben trasladarse automáticamente a cualquier costo que proceda de una integral continua.
Si el estado inicial vale uno, la duración es una unidad y el incremento es menos una unidad, el estado recorre linealmente el trayecto hasta cero. La integral de su cuadrado vale un tercio, frente a uno con la aproximación rectangular. El esfuerzo integrado vale uno en ambos cálculos. Así, el costo continuo de ese intervalo vale cuatro tercios y el costo rectangular vale dos. Los dos números describen evaluaciones diferentes de la misma rampa, no dos soluciones contradictorias de una ecuación de Riccati.
En nuestro caso de tres decisiones, los costos de estado se definieron directamente en los instantes discretos; por eso las cuentas siguen siendo exactas para ese problema. Si se quisiera interpretar la suma como una aproximación a un costo acumulado de forma continua, habría que declarar la regla de integración y comprobar su precisión. Además, conservar tres decisiones al cambiar la duración del paso modifica el tiempo físico disponible. Conservar el tiempo físico exige cambiar el número de decisiones. La frecuencia de actuación forma parte del diseño que se está comparando.
Multiplicar todos los pesos por una misma constante positiva deja la política óptima igual: se multiplica cada costo por esa constante sin alterar su orden. Por tanto, los pesos absolutos no son identificables de manera única a partir de la política observada. Kalman (1964) formuló el problema inverso de determinar criterios para los que una ley de control dada resulta óptima; la pregunta ya presupone que optimalidad debe referirse a una familia de objetivos.
La elección de cuadrados también impone una forma de valorar desviaciones. Duplicar una acción cuadruplica su penalización, y los signos opuestos cuestan lo mismo. Si las consecuencias reales son asimétricas, contienen umbrales o se acumulan de otro modo, conviene examinar si la aproximación cuadrática sigue representándolas en el intervalo de operación relevante.
Penalizar acciones intensas y penalizar cambios bruscos de acción tampoco produce el mismo problema. Si interesa limitar la variación de una orden enviada a un dispositivo, puede incluirse el cuadrado de . Ese término necesita conocer la acción anterior. En la trayectoria principal, tomando como acción previa cero, los incrementos de acción son . Su suma de cuadrados vale , diferente del esfuerzo cuadrático . Una secuencia moderada puede contener cambios importantes, y una acción constante puede tener costo de mantenimiento aunque ya no cambie.
La dependencia de la acción previa puede incorporarse ampliando el estado. El nuevo estado contiene tanto la desviación física como la última orden. Si la decisión es el incremento de orden, la orden actual se obtiene sumando ese incremento a la anterior, y la dinámica ampliada sigue siendo lineal. El costo debe escribirse en esas nuevas variables. Esto permite representar el desgaste asociado a variaciones sin fingir que ya estaba incluido en el cuadrado de la acción original. El peso de esa variación expresa una preferencia adicional y requiere recalcular la política.
Las restricciones también alteran las simetrías del problema. La duplicación de estados y acciones que conserva la forma de la solución libre puede violar un límite físico fijo. Dentro de una región donde permanecen activas las mismas restricciones, una expresión afín puede describir la política; al cruzar una frontera, puede cambiar la expresión pertinente. La proporcionalidad global de la realimentación libre deja entonces de ser una regla suficiente para extrapolar el diseño a desviaciones mayores.
Esta diferencia afecta a la verificación práctica. Probar un controlador únicamente cerca del origen puede dejar sin examinar las regiones donde el actuador alcanza sus límites. Para una familia de estados iniciales declarada, interesa comprobar qué secuencias son factibles, qué límites se activan y qué desviaciones finales quedan. En el problema libre esa familia se relaciona mediante un simple cambio de escala; en el limitado hay que resolver las regiones que el cambio de escala atraviesa.
En torno a una referencia, una dinámica lineal y un costo cuadrático pueden ser aproximaciones locales. El resultado calculado será pertinente mientras esa aproximación describa las trayectorias que el controlador produce. Si el regulador desplaza el sistema hacia una región donde cambian sus relaciones, verificar la ecuación de Riccati no valida automáticamente el modelo fuera de su rango.
También importa qué variables se optimizan al calcular una solución. Con horizonte finito y modelo conocido, sustituir la dinámica produce un programa cuadrático convexo en la secuencia de acciones. Optimizar directamente una ganancia estacionaria que se utilizará indefinidamente plantea otra superficie de costo. Fazel y colaboradores (2018) estudian métodos de gradiente para esa segunda tarea; sus garantías requieren condiciones sobre la política inicial y la información aportada por los estados, y no se extienden a cualquier punto de partida.
En una aplicación, la evaluación debería conservar las trayectorias de estado, las acciones y las restricciones, además del costo agregado. Un peso alto puede reducir un componente a costa de otro; una suma única puede ocultar cuál cambió. Los dos diseños de tres pasos lo muestran: aumentar disminuye el esfuerzo cuadrático, pero permite una desviación final considerablemente mayor.
Para la tarea de dos pasos con el límite futuro conocido, esa información conduce a una decisión concreta. La acción inicial deja para el último paso; la máxima corrección posterior permitida, , deja . El costo de esa trayectoria es menor que el de recortar el plan libre. Su justificación conserva tanto el precio de actuar como la capacidad efectiva de hacerlo en cada instante.
Referencias
Bemporad, A., Morari, M., Dua, V., y Pistikopoulos, E. N. (2002). The explicit linear quadratic regulator for constrained systems. Automatica, 38(1), 3–20. https://doi.org/10.1016/S0005-1098(01)00174-1
Boyd, S., El Ghaoui, L., Feron, E., y Balakrishnan, V. (1994). Linear matrix inequalities in system and control theory. SIAM. https://doi.org/10.1137/1.9781611970777
Fazel, M., Ge, R., Kakade, S. M., y Mesbahi, M. (2018). Global convergence of policy gradient methods for the linear quadratic regulator. Proceedings of Machine Learning Research, 80, 1467–1476. https://proceedings.mlr.press/v80/fazel18a.html
Kalman, R. E. (1960). Contributions to the theory of optimal control. Boletín de la Sociedad Matemática Mexicana, 5, 102–119. https://www.boletin.math.org.mx/pdf/2/5/BSMM(2).5.102-119.pdf
Kalman, R. E. (1964). When is a linear control system optimal? Journal of Basic Engineering, 86(1), 51–60. https://doi.org/10.1115/1.3653115
Mayne, D. Q., Rawlings, J. B., Rao, C. V., y Scokaert, P. O. M. (2000). Constrained model predictive control: Stability and optimality. Automatica, 36(6), 789–814. https://doi.org/10.1016/S0005-1098(99)00214-9
Mayne, D. Q., y Rawlings, J. B. (2001). Correction to “Constrained model predictive control: Stability and optimality”. Automatica, 37(3), 483. https://doi.org/10.1016/S0005-1098(00)00173-4