Dos mediciones de posición pueden informar sobre una velocidad que nunca se midió directamente. Para interpretarlas hay que conocer cuánto tiempo las separa y qué fuerzas actuaron durante ese intervalo. Si la aceleración es conocida, su efecto puede descontarse. Si es desconocida, el mismo desplazamiento puede atribuirse a combinaciones diferentes de velocidad inicial y aceleración. La cantidad de sensores, por sí sola, no determina qué puede reconstruirse.
La observabilidad estudia si estados distintos generan observaciones distinguibles bajo una dinámica y un procedimiento de medición especificados. Su pregunta ideal se formula sin error de medida: si se conociera exactamente la salida pertinente, ¿quedaría determinado el estado? La estimación bajo ruido plantea otra pregunta: con lecturas imprecisas y una cantidad limitada de datos, ¿qué error tendrá la reconstrucción? Un sistema puede ser observable y proporcionar estimaciones muy sensibles.
El análisis mediante estados distingue lo que existe en el modelo de lo que aparece directamente en la medición. Kalman (1963) mostró que pueden existir componentes internas que no se reflejan en las salidas. Esa distinción permite identificar pérdidas de información, pero también reconocer cuándo la evolución transporta información de variables ocultas hacia un sensor disponible.
Qué debe mantenerse fijo al comparar estados
Consideremos el sistema continuo construido:
El estado x=(q,v)ᵀ reúne posición y velocidad; u es una aceleración externa conocida y y es la posición observada. Tiempo y variables utilizan unidades normalizadas. El modelo no incluye rozamiento ni perturbaciones no declaradas. A diferencia de un problema de control que parte de un estado conocido, aquí se intenta reconstruir el estado inicial a partir de mediciones posteriores.
Durante el primer ejemplo, el horizonte es [0,2] y la entrada es u(t)=1 en todo el intervalo. El estado inicial se mantiene fijo, aunque sea desconocido para quien estima. Para poder verificar los cálculos, construiremos las observaciones con q(0)=1/5 y v(0)=−1/10. Estos valores son la verdad del ejemplo didáctico; no se introducen como información disponible para resolver la estimación.
Dos candidatos al estado inicial deben compararse bajo la misma entrada conocida. Permitir que cada candidato utilice una fuerza desconocida diferente transforma el problema. También deben mantenerse fijos los parámetros dinámicos y la función de medición. De lo contrario, una discrepancia podría atribuirse indistintamente al estado, al sensor o a la dinámica.
En un sistema lineal con matrices constantes, la salida es:
Las matrices A, B y C representan, respectivamente, dinámica interna, acción de la entrada y selección de la salida. Si la entrada es conocida, el segundo término puede calcularse y restarse. La diferencia entre las salidas de dos estados iniciales depende entonces de la diferencia entre esos estados a través del primer término. Esta es la razón de que la observabilidad lineal ideal dependa del par A,C, mientras que la controlabilidad depende de A,B.
Conocer una entrada exige conocer la acción efectivamente aplicada, no únicamente una orden nominal. Una saturación del actuador o un error de calibración podría volver incorrecta la contribución que se resta. El cálculo matemático seguiría siendo coherente con las ecuaciones utilizadas, pero esas ecuaciones dejarían de representar el experimento real. La observabilidad se refiere a un modelo de información, incluida esa información sobre las entradas.
La dinámica puede hacer visible una coordenada oculta
Para el doble integrador:
El sensor no observa v directamente. Sin embargo, la derivada ideal de la salida es v. La posición y su evolución inmediata contienen dos clases de información. El criterio lineal las organiza mediante la matriz de observabilidad:
El sistema de dimensión n es observable cuando esa matriz tiene rango n. La interpretación mediante derivadas presupone mediciones ideales y contribuciones conocidas de la entrada; no prescribe diferenciar numéricamente un registro ruidoso. El criterio puede aplicarse sin ejecutar esa operación sobre los datos (Kalman, 1963).
Aquí las dos filas son (1,0) y (0,1), de modo que el rango es dos. Si en cambio el sensor registrara únicamente velocidad, C=(0,1), la siguiente fila sería cero. Dos estados con igual velocidad y posiciones iniciales diferentes producirían exactamente la misma velocidad observada bajo la misma entrada. La posición inicial sería inobservable, aunque se conservara un registro perfecto durante mucho tiempo.
La pérdida no significa que el sensor sea inútil. Permite conocer la velocidad y, con ella, los cambios de posición respecto del comienzo. Lo que falta es el nivel inicial absoluto. Si ese nivel se conoce por otro procedimiento, la información adicional resuelve la ambigüedad. La observabilidad completa y la reconstrucción de una parte del estado son objetivos diferentes.
Más generalmente, los estados cuya diferencia pertenece al núcleo de la matriz de observabilidad no pueden distinguirse por esas salidas. El núcleo reúne las direcciones que el modelo de medición deja ocultas. En el ejemplo del velocímetro, cualquier desplazamiento inicial de la forma (a,0) conserva todas las observaciones. No es necesario que las dos trayectorias internas coincidan para que sus registros sean idénticos.
Una cantidad concreta del estado puede identificarse aunque el estado completo no lo haga. Para una cantidad lineal, la condición es que no cambie al sumar cualquiera de las diferencias invisibles. Equivale a que pueda expresarse mediante combinaciones de las filas del mapa de observación. El velocímetro satisface esa condición para la velocidad y para el desplazamiento relativo que se obtiene al integrarla, pero no para la posición absoluta. Esta comprobación evita pedir una reconstrucción completa cuando la pregunta necesita menos información. También permite detectar el caso opuesto: una estimación muy precisa de la parte visible puede resultar insuficiente si la decisión depende precisamente de una coordenada oculta.
La dualidad con la controlabilidad es algebraica. Transponer A y convertir C en una matriz de entrada produce un sistema cuyo rango de controlabilidad coincide con el rango de observabilidad original. Esa correspondencia permite trasladar herramientas matemáticas. No convierte un sensor en un actuador físico ni establece que medir una variable permita modificarla.
Reconstrucción exacta con dos instantes
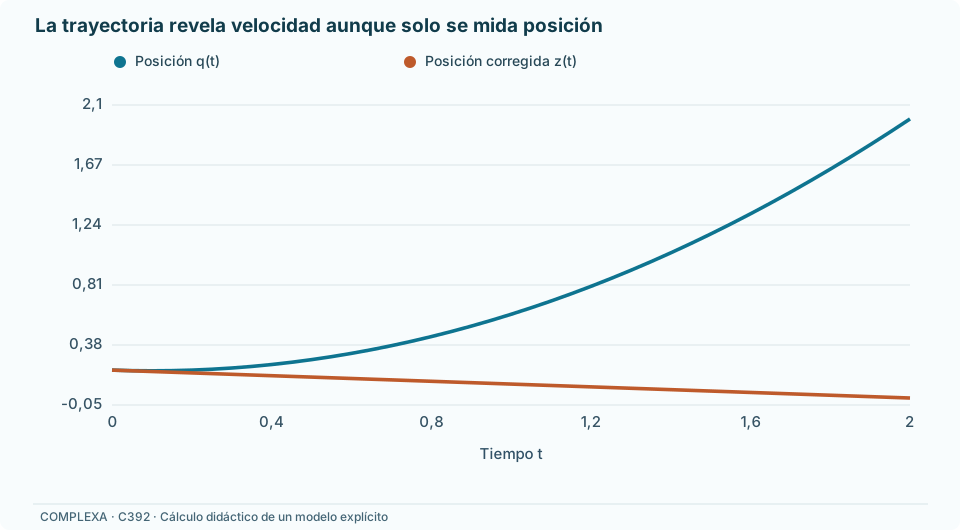
Con la entrada constante elegida, la posición satisface:
donde q₀ y v₀ son los valores iniciales desconocidos. La contribución conocida de la aceleración es t²/2. Al restarla de la salida definimos z(t)=y(t)−t²/2. En ausencia de ruido, z es una recta cuyo intercepto y pendiente son precisamente los dos componentes que buscamos.
Las posiciones construidas en t=0,1,2 son 1/5, 3/5 y 2. Después de descontar la entrada, quedan 1/5, 1/10 y cero. Las dos observaciones extremas bastan: la posición inicial es 1/5 y la velocidad inicial es la diferencia entre cero y 1/5 dividida por dos, es decir, −1/10. Conocer la aceleración evita atribuirle a la velocidad inicial todo el desplazamiento observado.
Para dos mediciones en los tiempos cero y T, con T positivo, el mapa de observación es:
Su determinante es T. Dos instantes distintos permiten invertir el mapa; repetir únicamente el mismo instante no aporta esa segunda dirección. Las fórmulas de reconstrucción son q₀=z(0) y v₀=[z(T)−z(0)]/T. No se ha supuesto que la velocidad sea constante durante el movimiento: lo es la pendiente del registro después de descontar correctamente la aceleración.
La reconstrucción se refiere al estado inicial. Una vez obtenido, puede propagarse con la dinámica conocida para calcular el estado en cualquier otro instante del intervalo. Eso exige conservar la misma hipótesis sobre la entrada. Un cambio no registrado de aceleración después de la última lectura impediría trasladar sin más la reconstrucción hacia el futuro.
También importa cuándo estará disponible la respuesta. Usar la lectura en T para reconstruir lo que ocurrió en cero es una tarea retrospectiva. No produce esa información en el instante inicial. En una aplicación que necesite decidir mientras el sistema evoluciona, solo pueden utilizarse las mediciones ya recibidas. El horizonte de observación y el tiempo de decisión forman parte del problema.
Separación de señales y sensibilidad
El gramiano de observabilidad cuantifica cuánto se separan las salidas ideales de estados iniciales diferentes durante un intervalo. Para una salida escalar y el intervalo [0,T] se define:
Si dos estados difieren en un vector d y reciben la misma entrada, la integral del cuadrado de su diferencia de salida es dᵀWₒd. Un vector que produce valor cero queda oculto durante todo el intervalo. Cuando el gramiano es positivo definido, todas las direcciones generan alguna separación, aunque esa separación pueda ser pequeña.
En el ejemplo:
Su determinante vuelve a ser T⁴/12. La velocidad inicial influye en la posición mediante un factor temporal: al observar durante muy poco tiempo, estados con velocidades diferentes pueden producir posiciones casi iguales. Si se permite compensar parcialmente esa diferencia ajustando la posición inicial, la separación integrada mínima para una diferencia unitaria de velocidad es T³/12. Basta escoger una diferencia de posición inicial igual a −T/2 para centrar el contraste temporal.
El gramiano describe esa geometría en el modelo continuo ideal. No es por sí mismo una matriz universal de incertidumbre estadística. Para convertir separación de señales en precisión de estimación hay que especificar cómo se muestrea, qué ruido afecta a cada lectura y qué criterio usa el estimador. Una observación continua ideal no equivale a disponer de infinitas muestras independientes con la misma varianza.
También aquí las unidades importan. Reescalar la velocidad cambia los valores numéricos que describen la sensibilidad. Una comparación entre sensores o variables debe usar escalas y costes de error declarados. El rango se conserva bajo cambios invertibles de coordenadas; una clasificación numérica de «buena observabilidad» puede depender de esas elecciones.
Lo que cambia cuando las lecturas contienen ruido
Añadamos a cada medición de posición un error de media cero y varianza σ². Suponemos errores independientes entre instantes y ningún ruido de proceso. La dinámica y la entrada continúan siendo exactas. El estado inicial sigue siendo un valor fijo desconocido; la distribución del estimador describe repeticiones del experimento con nuevos errores de medida. No se está introduciendo una distribución previa sobre ese estado.
Restar la contribución conocida de u no elimina el error del sensor. Al aplicar las fórmulas de dos instantes a los registros ruidosos, el error en la velocidad es la diferencia de los dos errores dividida por T. La matriz de covarianza del estimador es:
La covarianza negativa tiene una causa concreta. Una lectura inicial demasiado alta aumenta la posición estimada y reduce la pendiente calculada respecto de la lectura final. Los errores de las dos coordenadas estimadas no son independientes, aunque los errores de los sensores sí lo sean.
Con σ=1/50, equivalente a 0,02, y T=2, la desviación estándar del error de velocidad es aproximadamente 0,0141. Si los instantes están separados solamente por una décima de unidad, asciende aproximadamente a 0,2828. Ambos mapas tienen rango completo. La precisión cambia porque dividir una diferencia ruidosa por un intervalo pequeño amplifica la incertidumbre.
Una realización construida hace visible la operación. Supongamos un error de 0,01 en la primera lectura y de −0,02 en la última. Las posiciones registradas son 0,21 y 1,98. Después de restar la contribución de la entrada, quedan 0,21 y −0,02. La estimación es entonces posición inicial 0,21 y velocidad inicial −0,115. La inversión sigue siendo única, pero ya no coincide exactamente con los valores que generaron los datos.
Para estas medias y covarianzas no hace falta suponer ruido gaussiano; bastan los momentos y la independencia declarados. La gaussianidad permitiría añadir una distribución concreta al error y construir intervalos conforme a ella. La teoría de filtrado de Kalman (1960) separa la estimación lineal basada en segundos momentos de las conclusiones adicionales asociadas a supuestos distribucionales. Una afirmación de optimalidad debe indicar la clase de estimadores y el criterio de pérdida al que se refiere.
La calibración del sensor puede crear una dificultad similar. Si la salida fuera y=εq con una ganancia conocida y pequeña, el rango se conservaría para ε distinto de cero. Sin embargo, con el mismo ruido aditivo en la salida, recuperar la posición exigiría dividir por ε. La covarianza del estimador se multiplicaría por la inversa de ε². No se ha perdido unicidad ideal; se ha reducido la separación útil de señales respecto del ruido.
Cuándo una medición adicional aporta información diferente
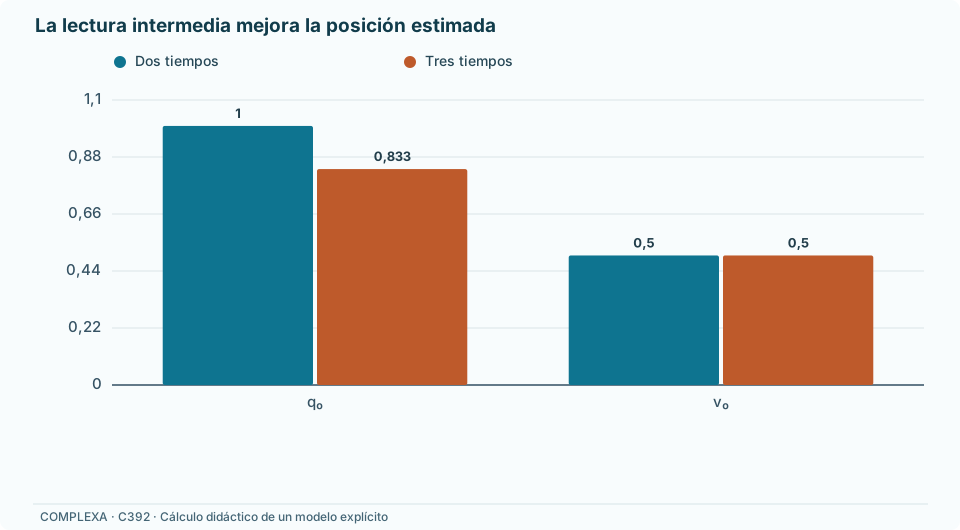
Volvamos al horizonte de dos unidades y añadamos la lectura central en t=1. Tras descontar la entrada, la matriz de diseño tiene filas (1,0), (1,1) y (1,2). El estimador de mínimos cuadrados combina las tres lecturas. Con errores independientes de igual varianza, su covarianza es σ² multiplicada por:
La varianza de la posición inicial pasa de σ² a 5σ²/6. La de la velocidad permanece en σ²/2, exactamente como con los dos extremos. La muestra central mejora una dirección de estimación y deja otra sin cambio. El resultado no contradice que se haya añadido información: esa información tiene una orientación concreta dentro del espacio de estados.
Puede verse directamente en las ponderaciones. La velocidad estimada sigue siendo [z(2)−z(0)]/2; la observación central recibe peso cero en esa pendiente. La posición estimada es [5z(0)+2z(1)−z(2)]/6. La lectura central ayuda a estimar el nivel medio de la recta, pero está situada en el centro temporal y no amplía el contraste entre sus extremos.
La reducción de varianza tampoco garantiza mejorar cada realización individual. Si el error de la nueva lectura es 0,03, junto a los dos errores anteriores, la posición estimada resulta 133/600, aproximadamente 0,2217. Queda más lejos de la verdad 0,2 que el valor 0,21 obtenido con dos lecturas. La mejora estadística se refiere al promedio de errores cuadrados sobre repeticiones compatibles con el modelo de ruido, no a una promesa para cada conjunto de datos.
Esta comparación supone que obtener una lectura adicional no reduce la calidad de las existentes y que su error es independiente. Un sensor con deriva compartida puede producir muchas observaciones afectadas por el mismo desplazamiento. Repetirlas no equivale a repetir ruido independiente. Si además el desplazamiento de calibración es desconocido y constante, puede confundirse con la posición inicial absoluta. La matriz de covarianza y, en ocasiones, el propio modelo del estado deben reflejarlo.
Una solución numérica única tampoco demuestra que los datos identifiquen todas las coordenadas. En el ejemplo que observa solo velocidad, supongamos entrada cero y una lectura ideal de valor dos. Todas las posiciones iniciales son compatibles con esa lectura. Si un algoritmo minimiza el error cuadrático de velocidad más una penalización positiva del cuadrado de la posición inicial, seleccionará posición cero y velocidad dos. La minimización tiene una respuesta única, pero la elección de posición procede enteramente de la penalización. Otro centro de penalización seleccionaría otra posición con la misma concordancia observacional.
Regularizar puede ser útil para estabilizar una estimación, siempre que se conserve el origen de la información añadida. Una distribución previa, una restricción física y una penalización matemática no son intercambiables sin justificación. Si se conoce que el objeto comenzó en una referencia concreta, esa es información externa legítima. Si simplemente se favorecen posiciones pequeñas para resolver una ambigüedad, el resultado debe interpretarse según esa preferencia. Conviene separar la unicidad que aporta el registro de la que introduce el procedimiento elegido para completarlo.
Los tiempos de medición son, por tanto, parte del diseño del sensor. Dos aparatos en el mismo lugar y momento pueden reducir ruido mediante repetición, pero no generan necesariamente la información temporal que faltaba. Una sola serie bien situada en el tiempo puede identificar varias coordenadas; numerosas lecturas redundantes pueden conservar una dirección oculta.
Una entrada desconocida cambia lo que se intenta reconstruir
La reconstrucción anterior atribuye toda aceleración a u=1. Supongamos ahora que existe además un sesgo constante b desconocido: v̇=u+b. El estado aumentado es (q,v,b), con ḃ=0. Después de descontar la entrada conocida, la posición satisface z(t)=q₀+v₀t+bt²/2. La información necesaria ya no corresponde a dos incógnitas.
Dos observaciones extremas no separan velocidad inicial y sesgo. Por ejemplo, aumentar la velocidad inicial en una unidad y cambiar el sesgo en −2/T deja inalterado el desplazamiento adicional en T, porque sus contribuciones se cancelan. Ambos candidatos también coinciden en el instante inicial si conservan q₀. Entre los extremos pueden describir movimientos diferentes que esas dos lecturas no distinguen.
Tres instantes distintos permiten resolver el caso de sesgo constante. En cero, uno y dos, la matriz aumentada tiene filas (1,0,0), (1,1,1/2) y (1,2,2), y su rango es tres. La estimación del sesgo utiliza z(2)−2z(1)+z(0). Es una segunda diferencia: detectar una curvatura requiere información distinta de la pendiente y del intercepto.
Bajo el mismo ruido independiente, la varianza de ese estimador es 6σ². La varianza de la velocidad inicial pasa a 13σ²/2, mayor que cuando b era conocido como cero. El modelo aumentado puede distinguir más componentes en condiciones ideales, pero debe repartir la información disponible entre más incógnitas. La observabilidad del estado aumentado no elimina ese coste de precisión.
La hipótesis de constancia es decisiva. Tres lecturas no identifican una función de aceleración desconocida arbitraria entre ellas. Muchas funciones pueden compartir las mismas integrales y producir los mismos puntos de posición. Convertir una perturbación en un estado exige especificar su dinámica, como se hizo con ḃ=0. Sin esa restricción se estaría afirmando más información de la que los datos contienen.
La observabilidad de estados también debe distinguirse de identificar parámetros de la dinámica. Un parámetro puede tratarse como una coordenada constante para estudiar un modelo aumentado, pero entonces hay que comprobar el rango y las posibles simetrías de ese nuevo problema. Suponer conocido un parámetro en el análisis y estimarlo después con los mismos datos no conserva automáticamente la conclusión original.
Un observador sigue la trayectoria mientras llegan datos
Una alternativa a invertir un bloque de observaciones es construir otro sistema dinámico que actualice una estimación. Luenberger (1964) formuló observadores lineales para reconstruir el estado a partir de entradas y salidas disponibles. La estimación tiene su propia condición inicial y utiliza la discrepancia entre la salida predicha y la medida para corregirse.
Para nuestro sistema puede emplearse:
El vector L determina cuánto influye la discrepancia de posición en cada componente estimada. Si la medición y el modelo son exactos, el error e=x−x̂ satisface ė=(A−LC)e. En este caso:
Su polinomio característico es λ²+3λ+2, con raíces −1 y −2. El error inicial decae con esos modos. No hace falta conocerlo para aplicar el observador. Sin embargo, decaer hacia cero no significa desaparecer exactamente después de un plazo finito cualquiera. La convergencia asintótica y la inversión exacta de observaciones ideales describen procedimientos diferentes.
El observador obtiene información sobre la velocidad sin diferenciar directamente las lecturas de posición. Las ecuaciones relacionan el cambio estimado con la entrada y con la corrección de salida. Esta organización puede ser útil cuando diferenciar el registro amplificaría sus errores, pero no suprime el efecto del ruido.
Si la lectura contiene un error η, la ecuación del error incorpora el término −Lη. Por tanto, aumentar la ganancia de corrección también cambia la forma en que el ruido entra en la estimación. Escoger velocidades de convergencia no resuelve por sí solo el compromiso entre respuesta rápida y precisión. Hace falta el modelo de perturbaciones correspondiente.
El filtro de Kalman calcula correcciones utilizando covarianzas y un criterio estadístico de error, en lugar de basarse solamente en colocar polos de convergencia. Su formulación distingue la evolución del estado, la información observada y la incertidumbre de la predicción (Kalman, 1960). No transforma automáticamente un modelo equivocado en uno correcto: las covarianzas especificadas y las ecuaciones utilizadas siguen condicionando su interpretación.
La falta de observabilidad completa tampoco impide siempre aproximar el estado actual a largo plazo. Considérense dos variables con ż₁=−z₁ y ż₂=−2z₂, observando únicamente la primera. Ningún registro revela el valor inicial de la segunda. Sin embargo, una estimación que fija esa segunda coordenada en cero tiene un error igual a su valor inicial multiplicado por . Ese error tiende a cero porque la propia dinámica elimina la influencia inicial oculta.
El argumento no reconstruye retrospectivamente la condición inicial. Solo muestra convergencia del error sobre el estado actual bajo esa dinámica estable y sin perturbaciones. Si la ecuación oculta fuese ż₂=2z₂, la misma falta de información permanecería y el error crecería. Las dos situaciones tienen el mismo rango de observabilidad, pero diferentes consecuencias para seguir el estado en el tiempo. Un criterio de reconstrucción exacta del pasado y uno de convergencia asintótica de un observador no deben confundirse. En presencia de perturbaciones continuas sobre la coordenada oculta, tampoco bastaría con confiar en que desaparezca la incertidumbre inicial.
Un calendario de muestreo puede ocultar un movimiento
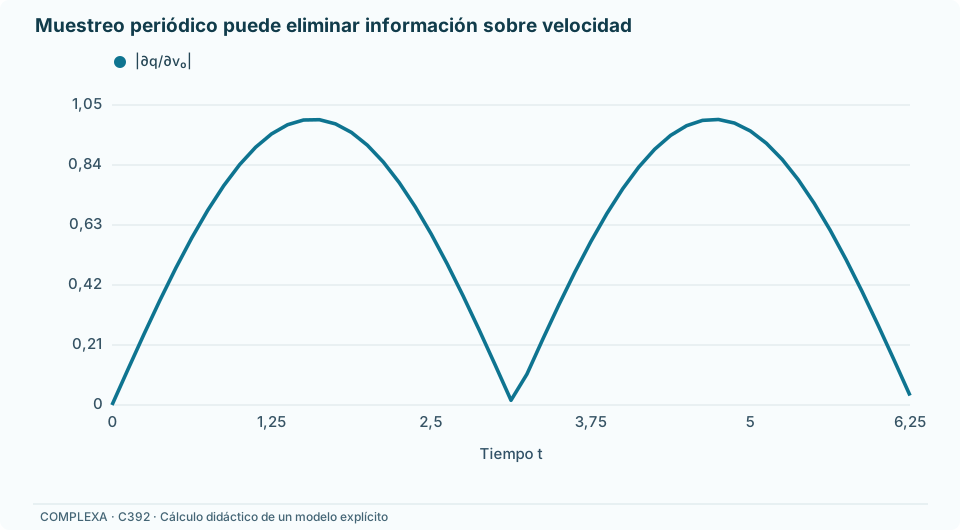
La observabilidad continua no garantiza que cualquier selección de instantes la conserve. Consideremos un oscilador construido, sin entrada, con q̇=v y v̇=−q, observado únicamente mediante q. Su salida es q(t)=q₀cos(t)+v₀sin(t). La posición y su derivada contienen información sobre ambos componentes, de modo que el sistema continuo es observable.
Si solo se mide en múltiplos enteros de π, el término asociado a la velocidad inicial desaparece en todas las lecturas. Se registra alternativamente q₀ y −q₀. Ninguna cantidad de muestras tomadas en ese mismo calendario revela v₀. En particular, los estados iniciales (0,1) y (0,−1) producen lecturas siempre iguales a cero, aunque entre las mediciones sus posiciones tengan signos opuestos.
Una medición en π/2 cambia la situación: allí la salida es v₀. Junto con la lectura inicial permite recuperar las dos coordenadas. El problema anterior no era falta de sensibilidad física del sensor, sino una sincronización del muestreo que ocultaba sistemáticamente parte de la dinámica. Kalman (1963) examinó la pérdida de propiedades de sistemas continuos al introducir muestreo.
Añadir únicamente más duración al mismo calendario fallido no resuelve esa ambigüedad. Añadir instantes que aportan otra combinación del estado sí puede hacerlo. En una situación con frecuencia desconocida, el diseño debería considerar también esa incertidumbre; el cálculo anterior mantiene la frecuencia exactamente igual a uno.
Alejarse ligeramente de la sincronización exacta recupera el rango, pero no necesariamente una precisión útil. Con mediciones en cero y h, la velocidad inicial se calcula restando a la segunda posición la primera multiplicada por cos(h), y dividiendo por sin(h). Si los dos errores son independientes y tienen varianza σ², la varianza resultante es σ²[1+cos²(h)]/sin²(h). Cerca de un múltiplo de π, el denominador es pequeño y amplifica ambas contribuciones de ruido.
Por ejemplo, con la misma desviación del sensor de 0,02 y h=π+0,01, la desviación estándar de la velocidad estimada es aproximadamente 2,83. En h=π/2 es 0,02. La pérdida exacta ocurre en la resonancia; una vecindad de ella ya produce dificultades cuantitativas aunque la matriz sea invertible. El ejemplo permite evaluar conjuntamente el calendario, el nivel de ruido y la escala de error tolerable, en lugar de decidir sobre el diseño a partir del rango únicamente.
Un rango local no garantiza una respuesta global única
Las salidas no lineales introducen otras ambigüedades. Volvamos a q̇=v y v̇=0, ahora como evolución autónoma sin entrada, pero supongamos que el sensor mide y=q². La salida es el cuadrado de q₀+v₀t. Los estados (q₀,v₀) y (−q₀,−v₀) producen toda la misma trayectoria observada. El sensor ha perdido una información de signo que el tiempo no recupera en este modelo.
Sin embargo, la función que reúne la salida y su primera derivada es (q²,2qv). Su jacobiano respecto del estado es:
cuyo determinante es 4q². Cuando q es distinto de cero, el mapa puede invertirse localmente. Cerca de un estado cuyo signo de posición ya se ha delimitado, las pequeñas variaciones pueden distinguirse. Eso no elimina el candidato de signo contrario situado fuera de esa vecindad. Los estados (1,2) y (−1,−2), por ejemplo, siguen generando exactamente el mismo registro completo.
Hermann y Krener (1977) distinguen observabilidad, variantes locales y condiciones de rango para sistemas no lineales. Su condición de rango proporciona una suficiencia local bajo las hipótesis correspondientes; no debe sustituirse por una afirmación general de unicidad global. La ausencia de rango completo en un punto tampoco permite concluir, sin examinar el modelo y otras derivadas, que toda reconstrucción sea imposible.
Whalen et al. (2015) analizan cómo las simetrías de ecuaciones y mediciones pueden ocultar direcciones del estado. La conclusión depende de la salida elegida y de los parámetros que conservan la simetría. Una simetría del dibujo de la red no constituye por sí sola una prueba universal de inobservabilidad. En nuestro ejemplo, conocer de antemano el signo o incorporar una medición que lo distinga cambiaría la ambigüedad que acaba de demostrarse.
Seleccionar sensores exige conservar el modelo de información
En una red grande, escoger qué variables medir puede reducirse a problemas estructurales útiles, pero hace falta distinguir condiciones necesarias de garantías suficientes. Liu et al. (2013) construyen diagramas de inferencia a partir de ecuaciones dinámicas y estudian conjuntos de sensores. Su propuesta identifica necesidades estructurales y verifica suficiencia en clases y ejemplos concretos; no demuestra que cualquier grafo de dependencias proporcione por sí solo recuperación exacta de un sistema no lineal arbitrario.
La distinción ya aparece en una red mínima. Dos variables que decaen con la misma tasa y se observan mediante su suma dejan oculta su diferencia. Cambiar una de las tasas puede hacer distinguibles sus contribuciones temporales sin cambiar el patrón de conexiones. Medir ambas por separado también cambia la información disponible. Dinámica, parámetros y salida participan conjuntamente en el resultado.
La finalidad de la reconstrucción puede reducir la exigencia. Si solo interesa la suma y esa suma se mide directamente, distinguir sus dos componentes quizá no sea necesario. En cambio, una decisión que dependa de cuál componente cambió no puede apoyarse únicamente en la misma lectura agregada. Definir las variables de interés permite comprobar si la parte inobservable afecta realmente a la pregunta.
En aplicaciones con mediciones psicológicas o fisiológicas parciales, declarar un estado latente también compromete una dinámica y una relación de medición. El buen ajuste de las salidas no demuestra por sí solo que esa representación interna sea única. Antes de interpretar una coordenada reconstruida como un proceso específico, conviene examinar qué alternativas producen los mismos registros y qué observaciones las distinguirían.
Para decidir qué lectura falta en el caso del sesgo constante, supongamos que solo se conservan las posiciones ideales 0,2 y 2 en los extremos del intervalo. Son compatibles con velocidad inicial −0,1 y sesgo cero. También lo son con velocidad inicial 0,9 y sesgo −1, manteniendo la misma entrada conocida igual a uno. La primera explicación atribuye parte del desplazamiento a la aceleración; en la segunda, el sesgo cancela esa entrada y el movimiento conserva velocidad constante. Ambas pasan exactamente por los puntos disponibles.
Una lectura en el instante intermedio distingue estas dos trayectorias: la primera predice posición 0,6 y la segunda predice 1,1. El registro construido contiene 0,6. Esa observación aporta la información sobre curvatura que los extremos habían perdido y permite resolver las tres incógnitas bajo la hipótesis de sesgo constante. Repetir únicamente la lectura final reduciría ruido independiente, pero conservaría la ambigüedad entre esas dos explicaciones. La elección del nuevo instante se justifica por la diferencia concreta entre las trayectorias que quedan por distinguir.
Referencias
Hermann, R., & Krener, A. J. (1977). Nonlinear controllability and observability. IEEE Transactions on Automatic Control, 22(5), 728–740. https://doi.org/10.1109/TAC.1977.1101601
Kalman, R. E. (1960). A new approach to linear filtering and prediction problems. Journal of Basic Engineering, 82(1), 35–45. https://doi.org/10.1115/1.3662552
Kalman, R. E. (1963). Mathematical description of linear dynamical systems. Journal of the Society for Industrial and Applied Mathematics, Series A: Control, 1(2), 152–192. https://doi.org/10.1137/0301010
Liu, Y.-Y., Slotine, J.-J., & Barabási, A.-L. (2013). Observability of complex systems. Proceedings of the National Academy of Sciences, 110(7), 2460–2465. https://doi.org/10.1073/pnas.1215508110
Luenberger, D. G. (1964). Observing the state of a linear system. IEEE Transactions on Military Electronics, 8(2), 74–80. https://doi.org/10.1109/TME.1964.4323124
Whalen, A. J., Brennan, S. N., Sauer, T. D., & Schiff, S. J. (2015). Observability and controllability of nonlinear networks: The role of symmetry. Physical Review X, 5(1), 011005. https://doi.org/10.1103/PhysRevX.5.011005