Una máquina puede disponer hoy de suficiente capacidad para corregir una desviación y perderla después de dos decisiones demasiado cómodas. El problema aparece incluso cuando el modelo es exacto y cada decisión resuelve perfectamente su optimización. Si el cálculo termina antes de que se manifieste la consecuencia de una acción, una trayectoria barata dentro de la ventana puede dejar una situación difícil fuera de ella. El control predictivo organiza la decisión alrededor de esas trayectorias futuras, pero requiere precisar qué se exige al final del cálculo.
En el control predictivo basado en modelos, habitualmente abreviado MPC, se calcula una secuencia de acciones a partir del estado actual. Se aplica la primera, se obtiene nueva información sobre el sistema y se vuelve a optimizar. La ventana avanza con cada decisión y conserva, en la formulación más habitual, el mismo número de pasos. Esta implementación introduce realimentación: la acción siguiente depende del estado entonces disponible. Mayne y colaboradores (2000) describen esta combinación de optimización finita, restricciones y aplicación sucesiva del primer control.
Conviene distinguir la secuencia que se calcula de la ley que finalmente gobierna la máquina. La secuencia contiene decisiones previstas bajo unas condiciones iniciales y un modelo. La ley de control es el procedimiento que asigna una primera acción a cada estado donde el problema tiene solución. Cambiar el horizonte, el costo o la condición terminal modifica esa ley, aunque el modelo físico permanezca igual. Tampoco ejecutar toda la secuencia calculada una sola vez equivale a repetir el procedimiento: las acciones posteriores pueden cambiar incluso sin perturbaciones, porque la ventana vuelve a extenderse.
La capacidad para incorporar límites de actuadores y variables fue una motivación importante del desarrollo industrial del MPC. La encuesta de Qin y Badgwell (2003), basada principalmente en información de proveedores, documentó diferentes soluciones para esas tareas en las tecnologías disponibles alrededor del cambio de siglo. Esa diversidad importa conceptualmente: MPC designa una familia de diseños. El nombre compartido permite identificar un principio de cálculo, mientras que las propiedades de cada controlador dependen de su formulación y de cómo se ejecuta.
Qué termina al cerrar la ventana
Consideremos un ejemplo didáctico, sin identificación con un proceso clínico o industrial observado. El estado escalar representa una desviación respecto de un equilibrio, la acción puede tener ambos signos y el intervalo de muestreo se toma como unidad. La dinámica y los límites son
Sin control, la desviación se duplica a cada paso. El actuador solo puede compensarla parcialmente cuando el estado es grande. Supondremos inicialmente que el estado se conoce exactamente, el modelo describe la evolución real y la acción calculada se aplica sin retraso. Estas condiciones permiten examinar el efecto del horizonte sin mezclarlo con errores de estimación o de identificación.
En el instante de decisión se fija el estado inicial predicho y se eligen acciones. Los subíndices de esta predicción cuentan posiciones dentro de la ventana; no son nuevas mediciones. El problema consiste en minimizar
Los controles satisfacen su límite para todas las etapas y los estados satisfacen desde el inicial hasta el terminal, incluido . Más adelante añadiremos una condición terminal específica. Por ahora hacemos . La notación obliga a observar un detalle: el último estado está restringido, pero su magnitud no aparece en el costo cuando la penalización terminal es nula.
Con horizonte uno, el costo es . Para un estado inicial igual a un medio, la acción cero es admisible y minimiza el gasto. El sistema llega a uno. Al repetir el mismo cálculo desde uno, la acción cero vuelve a ser óptima porque la llegada a dos todavía cumple la restricción terminal. Desde dos ya no existe una acción admisible: incluso usando la máxima corrección negativa, el estado siguiente sería tres. Dos optimizaciones correctas han conducido a un tercer problema sin solución.
El fallo no procede de una tolerancia numérica ni de una perturbación inesperada. La primera ventana admitía una llegada para la cual no comprobaba la posibilidad de continuar. Llamamos factibilidad a la existencia de una secuencia que satisface las restricciones del problema considerado. La factibilidad recursiva exige además que, después de aplicar la primera acción, el siguiente problema vuelva a ser factible. La trayectoria anterior muestra por qué estas propiedades necesitan argumentos diferentes.
También hay estados con factibilidad momentánea que nunca podrán conservar indefinidamente los límites. Desde , el horizonte uno elige , llega a dos y alcanza un costo de . Para cualquier estado mayor que uno, aun usando siempre , la diferencia respecto de uno se duplica. Por tanto, tarde o temprano se supera el límite de dos. Ninguna mejora del optimizador puede crear autoridad de control que el actuador no tiene.
Tres horizontes para el mismo estado
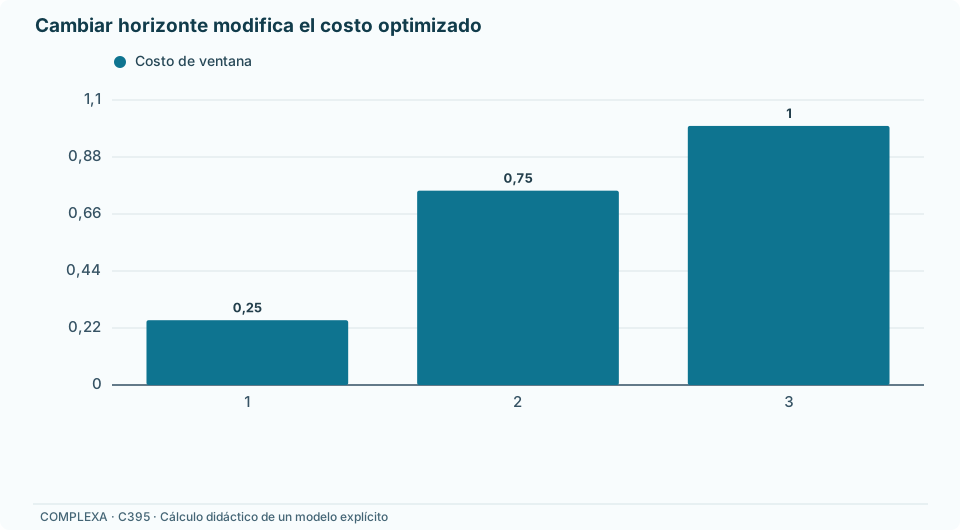
Ampliemos ahora la ventana, manteniendo el estado inicial en un medio y la penalización terminal nula. Los problemas son cuadráticos estrictamente convexos con restricciones lineales; cada solución factible tiene un minimizador único. Las siguientes secuencias se obtienen resolviendo el problema continuo completo, sin restringir las acciones a una cuadrícula.
| Horizonte | Acciones previstas | Estados previstos, incluido el inicial | Costo de la ventana |
|---|---|---|---|
| Uno | |||
| Dos | |||
| Tres |
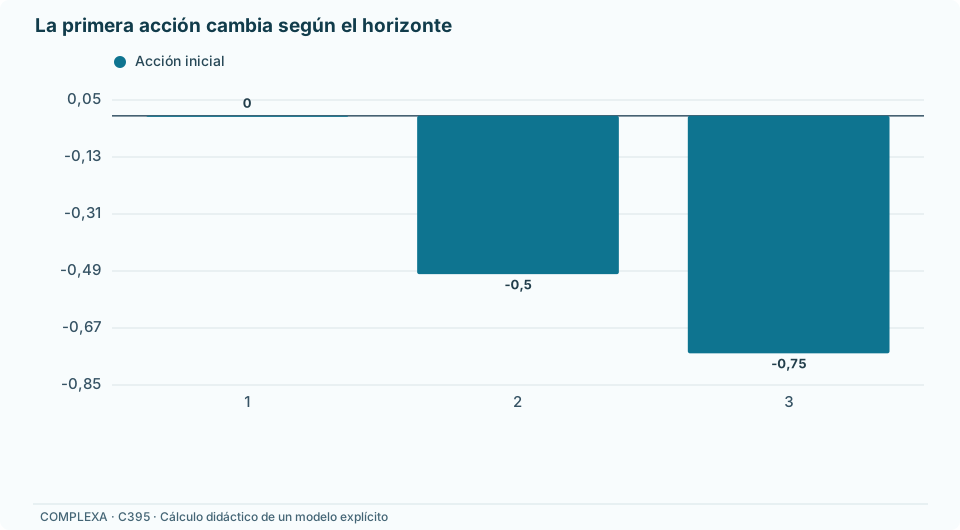
En la ventana de dos pasos, la primera acción ya afecta a un estado incluido en el costo. Cuando las restricciones no se activan, el último control sigue siendo cero y basta minimizar . La solución es , de modo que el siguiente estado vuelve a ser . Desde un medio, la reoptimización repite indefinidamente la misma acción negativa y conserva la misma desviación. Todas las ventanas son factibles, pero la regulación hacia cero no ocurre.
Este comportamiento distingue factibilidad recursiva de convergencia. En el ejemplo de dos pasos, el controlador gasta esfuerzo de control para compensar exactamente la expansión natural y permanecer donde está. Su decisión es óptima para la ventana que se le ha dado. La optimización permite que el costo de seguir manteniendo ese estado quede desplazado hacia ventanas posteriores. Una solución constante distinta de cero basta para descartar estabilidad asintótica del origen dentro de un dominio que la contenga.
Con tres pasos, el cálculo interior atribuye más peso al estado que deja la primera acción. En la región sin saturación, la primera acción es y el siguiente estado vale . Partiendo de un medio, la secuencia realmente aplicada comienza con , después y después . Las desviaciones se reducen sucesivamente a un cuarto, un octavo y un dieciseisavo. Esta evolución permanece en la región donde se dedujo la ley.
La segunda acción aplicada merece atención. En el plan original era , pero la reoptimización desde un cuarto produce . Ambas decisiones corresponden a problemas diferentes: el plan original reservaba solo dos etapas pendientes, mientras que el nuevo cálculo vuelve a considerar tres. La discrepancia aparece con un modelo exacto. Reoptimizar tampoco significa que cada nuevo plan deba conservar las decisiones aún no ejecutadas del anterior.
Los costos de la última columna no permiten ordenar directamente los controladores. El primero parece más barato porque contabiliza menos etapas y no penaliza el estado final. Para comparar desempeño debemos utilizar un criterio común sobre las trayectorias efectivamente ejecutadas. El horizonte dos acumula un costo positivo constante y su suma infinita diverge. El horizonte tres, en esta región, produce una serie geométrica finita. Resolver mejor una ventana y comportarse mejor durante una operación prolongada son preguntas distintas.
Tampoco hemos demostrado que tres pasos estabilicen cualquier estado inicialmente admisible. Fuera de la región calculada pueden activarse restricciones y cambiar la ley. Los estados mayores que uno ya mostraron una limitación física insalvable. Una simulación favorable desde un medio identifica un comportamiento concreto; un dominio de garantía requiere comprobar los demás estados que se incluyen en la afirmación.
Una continuación admisible después del último estado
Una manera de dar significado al final de la predicción consiste en exigir que el estado terminal pertenezca a una región desde la cual conocemos una continuación admisible. Para nuestro sistema elegimos
La función es un controlador local utilizado para construir la garantía. En ese intervalo respeta el límite del actuador y transforma el estado en , que permanece dentro del mismo intervalo. Por ello la región es invariante bajo esa ley: comenzar en ella permite continuar sin salir. El controlador predictivo puede escoger otra acción, porque la ley local sirve como continuación disponible y como comparación para el costo.
La penalización terminal también tiene una función verificable. Bajo el controlador local, el costo de una etapa es y el estado se reduce a la mitad. La suma de todas las etapas futuras vale . Nuestra elección de es una cota superior de esa continuación. No hemos adivinado el costo óptimo infinito; hemos utilizado una continuación concreta cuyo costo sabemos acotar.
La cuenta puede expresarse mediante una desigualdad de descenso. Para todo estado del intervalo terminal,
Esta identidad reúne el ahorro de costo terminal y el costo de aplicar el controlador local. La construcción de una región terminal y una penalización asociada aparece, con supuestos específicos, en formulaciones estabilizantes de MPC. Chen y Allgöwer (1998) desarrollaron una formulación no lineal en tiempo continuo que utiliza una penalización cuadrática y una región terminal. Aquí las condiciones se comprueban directamente para una planta discreta, por lo que la demostración no depende de trasladar aquel resultado entre dos tipos de tiempo.
Para establecer factibilidad recursiva, tomemos una secuencia óptima de longitud . Después de aplicar su primera acción, el estado real coincide con el segundo estado de la predicción bajo nuestros supuestos nominales. Podemos construir un nuevo plan conservando las acciones pendientes y añadiendo al final la acción . Los controles conservados ya eran admisibles. La acción añadida también lo es, y deja el nuevo estado final en la región terminal. Existe así una secuencia factible para la siguiente optimización.
El argumento usa una secuencia candidata, sin afirmar que continúe siendo óptima. Esa diferencia permite demostrar descenso del valor óptimo. Si denota el mínimo de la ventana con los ingredientes terminales, el nuevo mínimo no supera el costo del candidato construido. Al comparar ambos costos se cancelan las etapas compartidas; la desigualdad terminal controla lo añadido. El resultado es
En el modelo nominal, sumar estas desigualdades limita la suma de los estados al cuadrado por un valor inicial finito. De ahí se obtiene que el estado converge a cero. Para completar una afirmación de estabilidad también necesitamos que estados inicialmente pequeños produzcan valores pequeños de la función y permanezcan cerca del origen. En nuestro ejemplo, la ley local proporciona una cota cuadrática superior cerca de cero, mientras que el costo contiene como cota inferior. Estas cotas y el descenso dan la estabilidad correspondiente.
Rawlings, Mayne y Diehl (2026, segunda edición, sexta impresión) presentan las condiciones generales que organizan este tipo de prueba. La corrección de Mayne y Rawlings (2001) al artículo de 2000 también resulta pertinente: reemplaza una igualdad por una desigualdad en un paso de comparación entre valores óptimos. Al utilizar una solución candidata debemos conservar la desigualdad; el hecho de que sea admisible no la convierte en el nuevo minimizador.
Qué estados admite cada diseño
La región terminal restringe los planes iniciales, pero permite ampliar de manera ordenada el dominio de operación al aumentar el horizonte. Para calcularlo en el ejemplo, partamos de un intervalo objetivo simétrico de radio . Existe una acción con módulo a lo sumo uno que lleva un estado al intervalo si y solo si el módulo del estado no supera , siempre respetando además el límite físico. Esta operación calcula los predecesores admisibles del intervalo.
Podemos aislar el papel de cada ingrediente suprimiendo uno de ellos. Si mantenemos el intervalo terminal de dos tercios, pero volvemos a una penalización final nula, el horizonte uno conserva una continuación admisible. Sin embargo, desde un medio elige la corrección mínima necesaria, , y llega a dos tercios. Desde allí elige y permanece en el mismo estado. La región terminal sigue permitiendo una secuencia desplazada factible, pero el costo ha perdido la condición de descenso que necesitábamos para demostrar regulación.
La variante inversa también aporta información. Mantengamos la penalización y suprimamos la región terminal, conservando únicamente el límite físico de dos. Con horizonte uno, desde , el optimizador aplica y llega a . La siguiente decisión vuelve a saturar y llega a , desde donde ya no existe una llegada admisible. La penalización favorece una corrección intensa, pero no convierte en recuperable un estado situado fuera de la capacidad física de regulación.
Estas pruebas por eliminación explican por qué verificamos conjuntamente el costo y el conjunto terminal. También muestran que nuestra garantía es suficiente y puede ser conservadora. La variante con penalización y sin región terminal sí regula desde nueve décimos: aplica inicialmente la saturación y atraviesa ocho décimos, seis décimos y dos décimos antes de entrar en la contracción central. Ese estado inicial quedaba fuera del dominio certificado de una etapa con la región terminal. Ampliar una garantía requiere analizar esa ley adicional; el éxito de esta trayectoria concreta no demuestra que todo su dominio inicialmente factible sea seguro.
Aplicando repetidamente la operación de predecesores al radio terminal de dos tercios obtenemos el dominio
Para horizontes de uno, dos y tres pasos, sus radios son , y . Cada paso adicional permite comenzar un poco más lejos de cero y todavía alcanzar la región terminal. Estos intervalos son dominios de factibilidad del problema completo. La construcción anterior garantiza que, al aplicar el MPC correspondiente desde ellos, la siguiente optimización sigue siendo factible y el estado converge.
El crecimiento tiene un límite físico. La unión de esos dominios es el intervalo abierto entre menos uno y uno. En los extremos, la máxima corrección puede mantener el estado constante, pero no reducir su magnitud: desde uno, cualquier acción admisible deja un estado al menos igual a uno. Por eso los extremos pertenecen al conjunto de estados que pueden conservar indefinidamente las restricciones, aunque no pertenecen al conjunto de estados que alcanzan nuestra región terminal en un número finito de pasos.
Comparemos este resultado con imponer directamente . El radio admisible pasa a ser . Con una sola etapa se reduce a un medio, frente a cinco sextos con la región terminal. Exigir llegada exacta al equilibrio puede descartar estados que admiten una buena continuación y que convergerían bajo una ley local. La región terminal permite reconocer esa continuación sin enumerar en línea todas sus etapas.
Si suprimimos la condición terminal específica y únicamente exigimos el límite físico en todos los estados predichos, los radios factibles son . Ahora el dominio disminuye al prolongar la ventana. El cálculo más largo descubre violaciones que antes quedaban fuera de la predicción. No hay contradicción con el crecimiento anterior: un problema comprueba supervivencia durante más tiempo, mientras que el otro concede más tiempo para alcanzar una región de continuación conocida.
Esta comparación ayuda a interpretar expresiones como «aumentar el horizonte mejora la factibilidad». La dirección del cambio depende de qué permanece fijo al ampliar el problema. También depende de si se mantienen todas las acciones como variables independientes. Si se obliga a repetir una acción durante varios intervalos para reducir el cómputo, se modifica el conjunto de trayectorias disponibles. El razonamiento de desplazar un plan puede dejar de funcionar si la secuencia desplazada no respeta esa nueva estructura.
Un horizonte corto con una cola bien definida
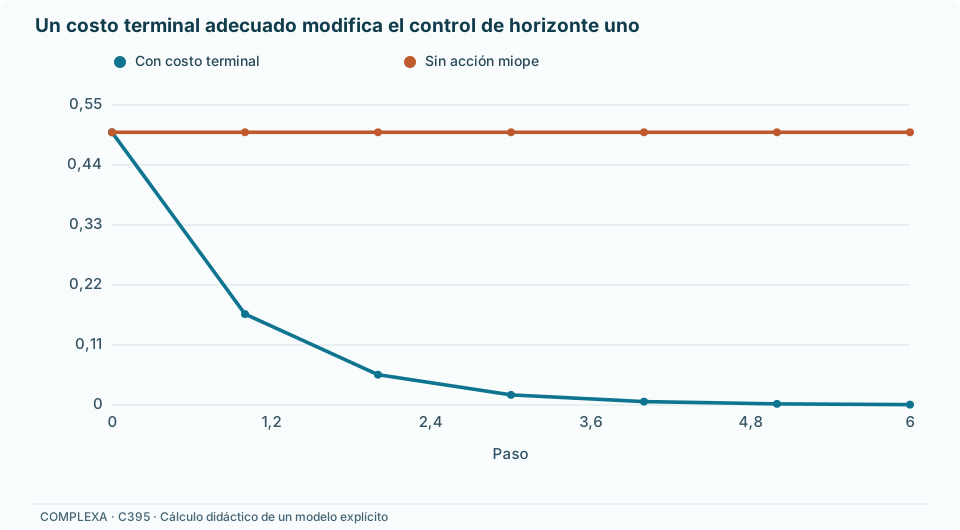
Podemos resolver explícitamente el diseño terminal con una sola etapa. El costo es . Sin saturación, su derivada respecto de la acción se anula en , que deja el estado en . La restricción del actuador se activa cuando el módulo del estado supera tres quintos. En todo el dominio de radio cinco sextos, la ley queda determinada por esa expresión central y por la saturación a la acción de signo contrario.
Desde un medio, la acción es , el estado siguiente es y el costo de la ventana es . El proceso continúa con estados divididos por tres. El horizonte uno que antes perdía factibilidad produce ahora una regulación estable porque el final del cálculo tiene otro significado. No se ha aumentado el número de controles que el optimizador debe elegir.
El costo realmente acumulado también puede calcularse. Con el horizonte tres sin penalización terminal, desde un medio, la suma infinita de los costos de etapa es . Con el horizonte uno y los ingredientes terminales propuestos, es . Ambos valores utilizan las mismas unidades, los mismos pesos y las trayectorias ejecutadas. La diferencia favorece aquí al segundo diseño, aunque su ventana sea más corta.
El costo de una ventana terminal tampoco coincide automáticamente con esa suma real. En el segundo diseño, el valor inicial incluye la penalización , que representa una cota de continuación, mientras que el MPC reoptimiza después y consigue otro costo efectivo. El papel de una penalización terminal puede ser garantizar descenso y facilitar la optimización sin representar exactamente todo lo que se pagará en el futuro.
En este caso pequeño podemos calcular además una referencia de optimalidad infinita. Si buscamos un valor cuadrático sin restricciones, la comparación entre actuar ahora y continuar óptimamente exige . La solución positiva es , y la acción correspondiente tiene ganancia , con signo contrario al estado. Desde un medio, su primera acción tiene módulo aproximado de ocho décimos; las siguientes disminuyen. Por tanto, esta trayectoria también respeta los límites originales y proporciona el óptimo infinito restringido para ese estado inicial.
Su costo es aproximadamente , ligeramente inferior a , el costo real del horizonte uno con nuestra penalización terminal. La diferencia permite una lectura precisa: hemos demostrado estabilidad y obtenido un desempeño cercano al óptimo, pero esos dos hechos no convierten la ley propuesta en la solución óptima infinita. La elección de cinco como peso terminal simplifica una garantía verificable y deja una pequeña diferencia de desempeño.
Si el estado inicial aumenta, la solución cuadrática sin restricciones puede pedir una acción excesiva. En esa situación ya no basta utilizar su valor como certificado del problema restringido. El optimizador debe resolver las etapas con saturación y comprobar cómo enlazan con la región donde vuelve a ser admisible la continuación calculada. La referencia analítica conserva su utilidad, con un dominio de aplicación expresamente delimitado.
Los pesos del costo tienen una interpretación similar. Dar más peso a la acción puede reducir movimientos en una ventana, pero también dejar desviaciones que exijan correcciones posteriores. Si las variables poseen unidades diferentes, deben normalizarse o ponderarse de forma coherente. Un número pequeño del objetivo puede reflejar una escala elegida convenientemente. Para evaluar una modificación conviene conservar un conjunto común de magnitudes: desviación, esfuerzo, cumplimiento de restricciones y tiempo de recuperación.
El horizonte físico es el producto del número de pasos por el intervalo de muestreo. Duplicar los pasos y reducir a la mitad ese intervalo mantiene la duración anticipada, pero cambia el problema numérico y el modelo discreto. En nuestro ejemplo, el factor dos pertenece a un intervalo ya fijado. Mantenerlo después de cambiar el muestreo describiría otra planta. La rapidez de actualización, la duración de la anticipación y el número de variables son decisiones relacionadas, pero distintas.
La distancia hasta el final de la ventana adquiere otro significado si existe una demora conocida en la actuación. Supongamos que una orden emitida ahora solo afecta al estado después de dos intervalos. Un cálculo que termina antes de ese efecto no puede valorar su consecuencia mediante los estados de la ventana. Una representación coherente debe incluir las órdenes pendientes como parte del estado y utilizar un horizonte o una continuación terminal que alcance su efecto. Compensar el problema cambiando únicamente un peso no corrige la cronología del modelo.
La misma precaución aparece cuando se penalizan incrementos de control. Un costo sobre necesita conocer la acción previa, además del estado físico. Si imponemos también una velocidad máxima de cambio, dos situaciones con el mismo estado y distinta acción anterior pueden admitir primeras decisiones diferentes. El estado que inicializa el problema debe contener esa memoria. La factibilidad recursiva se analiza entonces en el espacio ampliado de estado físico y acción previa; un intervalo del estado físico puede ocultar combinaciones incompatibles con la rampa del actuador.
Estos cambios afectan a qué significa disponer de margen. Un actuador capaz de alcanzar una intensidad suficiente puede tardar demasiado en llegar a ella. Predecir permite anticipar esa limitación si está expresada en las transiciones y restricciones. En cambio, una optimización que solo impone un límite de amplitud atribuye a la máquina la capacidad de cambiar instantáneamente entre sus extremos en cada intervalo. La discrepancia puede aparecer antes de que se alcance cualquier límite estatal.
Estado disponible, objetivo alcanzable
Hasta ahora hemos conocido el estado y regulado hacia cero. Cuando se dispone de mediciones parciales, la inicialización de la predicción utiliza un estado estimado. El plan desplazado de la demostración solo encaja exactamente con el nuevo problema si su estado inicial coincide con el previsto. Un error de estimación cambia ese punto de partida. Repetir la optimización permite responder a nueva información, pero no conserva por sí mismo una prueba nominal de cumplimiento de restricciones.
También hay que comprobar que la referencia solicitada corresponde a un equilibrio admisible. Para mantener un estado constante en nuestra planta se necesita . Una referencia de cabe dentro del límite estatal, pero exige una acción estacionaria de módulo mayor que uno. El controlador puede acercarse temporalmente o resolver una alternativa penalizada; no puede sostener ese equilibrio con el actuador declarado.
Para una referencia alcanzable se pueden formular desviaciones respecto del par estacionario y trasladar los límites correspondientes. Las restricciones dejan de ser simétricas alrededor del nuevo origen si el equilibrio utiliza parte de la capacidad disponible. La selección del objetivo y la regulación de las desviaciones deben ser compatibles. Optimizar una trayectoria hacia una referencia impuesta externamente no demuestra que esa referencia pueda mantenerse una vez alcanzada.
Si se conoce una modificación futura de demanda, referencia o capacidad, puede introducirse en las distintas posiciones de la ventana. La primera acción podrá cambiar antes de que cambie la demanda, porque el modelo anticipa que esperar hará costosa o inviable una respuesta posterior. Esa anticipación tiene una fuente de información identificable: un calendario o una previsión disponible al decidir. No debemos introducir retrospectivamente en la simulación valores futuros que el controlador real habría desconocido.
Las garantías también deben seguir ese calendario. Un conjunto terminal construido para una capacidad permanente deja de proporcionar una continuación válida si el actuador perderá capacidad justo después de la ventana. Del mismo modo, desplazar el plan anterior conserva su factibilidad solo si las restricciones de cada fecha se trasladan de manera compatible. Para sistemas que cambian con el tiempo se necesitan condiciones terminales y candidatos adaptados a esa evolución.
Cuando una previsión se actualiza entre dos decisiones, conviene guardar tanto el pronóstico anterior como el nuevo. Una llegada distinta de la anticipada puede deberse a una revisión legítima de información externa, a error del modelo o a una acción mal ejecutada. Esas causas conducen a modificaciones diferentes del controlador. La capacidad de recalcular facilita incorporarlas, pero la prueba nominal con un modelo y unas restricciones fijas no permite confundirlas.
Una perturbación constante ilustra otra diferencia. Supongamos, solo para este cálculo adicional, que la planta real incorpora a cada actualización, mientras el controlador conserva la ley central nominal . La evolución real es , cuyo equilibrio es . La realimentación reduce el error, pero deja una desviación permanente. En ese equilibrio la acción permanece dentro de sus límites, por lo que la saturación no explica el residuo.
Pannocchia y Rawlings (2003) estudiaron condiciones para eliminar errores estacionarios mediante modelos aumentados de perturbación. Su análisis distingue la cantidad de variables medidas, manipuladas y controladas; añadir estados integradores sin atender a esa estructura no basta. Para nuestro caso sencillo, reconocer la perturbación exige también calcular una acción estacionaria compensadora. El objetivo, el modelo de perturbación y el estimador forman parte del diseño que determina qué significa alcanzar la referencia.
La optimización dentro del intervalo de control
El cálculo debe terminar a tiempo para que la acción utilizada corresponda al estado con el que se formuló el problema. En el ejemplo lineal, sustituir las ecuaciones de predicción en el costo produce una función cuadrática de las acciones y un conjunto de desigualdades lineales. La penalización de los controles hace positiva definida su parte cuadrática. Las condiciones de optimalidad permiten verificar una solución mediante factibilidad, multiplicadores no negativos y anulación del gradiente con las restricciones activas.
Estas propiedades explican por qué podemos comprobar exactamente las pequeñas ventanas empleadas. Se examinan las posibles caras del conjunto admisible y se resuelven sus ecuaciones con aritmética racional. No se eligen unas pocas acciones candidatas para luego declararlas óptimas. En problemas grandes se utilizan métodos especializados que aprovechan la estructura temporal y la proximidad entre dos optimizaciones consecutivas.
La secuencia desplazada puede proporcionar una inicialización y, bajo las condiciones nominales establecidas, un plan de respaldo factible. Aceptar una nueva secuencia únicamente cuando mejora el costo de ese candidato preserva el argumento de descenso correspondiente. Una secuencia incompleta entregada por un algoritmo cualquiera no tiene esas propiedades automáticamente. Hay que comprobar su factibilidad y la comparación de costos que utiliza la prueba del controlador efectivamente implementado.
Diehl, Bock y Schlöder (2005) desarrollaron una iteración de tipo Newton para aproximar soluciones durante la operación y estudiaron su contractividad y pérdida de optimalidad bajo condiciones específicas. Su análisis presentado de convergencia deja fuera las desigualdades de trayectoria, aunque estas se incorporen en implementaciones prácticas. Ese alcance impide usar el artículo como garantía general de que interrumpir cualquier optimizador mantiene todas las restricciones.
También conviene separar límites físicos de preferencias flexibilizadas. Una holgura que permita exceder el límite del actuador no crea una acción físicamente realizable. Si flexibilizamos una restricción estatal y penalizamos su violación, el problema puede recuperar una solución numérica, pero el significado de la garantía ha cambiado. La magnitud de la holgura debe quedar registrada y evaluarse según la restricción que se decidió relajar.
Desde , nuestro controlador terminal de una etapa ofrece una ejecución concreta de estas verificaciones. La acción óptima es ; la llegada prevista es , dentro de la región terminal. El costo vale . Tras medir esa llegada exacta, la nueva optimización vuelve a elegir y lleva el estado a . A partir de ahí se utiliza la rama sin saturación y las desviaciones se dividen por tres.
Si la medida siguiente a la primera acción difiere de tres quintos, el registro permite identificar qué comparación dejó de corresponder al modelo: estado previsto, estado recibido, acción realmente aplicada o momento de aplicación. El nuevo cálculo parte de esa medida y debe comprobar nuevamente su admisibilidad. La secuencia nominal conserva entonces su utilidad como referencia verificable de lo que se había supuesto al decidir.
Referencias
Chen, H., y Allgöwer, F. (1998). A quasi-infinite horizon nonlinear model predictive control scheme with guaranteed stability. Automatica, 34(10), 1205–1217. https://doi.org/10.1016/S0005-1098(98)00073-9
Diehl, M., Bock, H. G., y Schlöder, J. P. (2005). A real-time iteration scheme for nonlinear optimization in optimal feedback control. SIAM Journal on Control and Optimization, 43(5), 1714–1736. https://doi.org/10.1137/S0363012902400713
Mayne, D. Q., Rawlings, J. B., Rao, C. V., y Scokaert, P. O. M. (2000). Constrained model predictive control: Stability and optimality. Automatica, 36(6), 789–814. https://doi.org/10.1016/S0005-1098(99)00214-9
Mayne, D. Q., y Rawlings, J. B. (2001). Correction to “Constrained model predictive control: Stability and optimality”. Automatica, 37(3), 483. https://doi.org/10.1016/S0005-1098(00)00173-4
Pannocchia, G., y Rawlings, J. B. (2003). Disturbance models for offset-free model-predictive control. AIChE Journal, 49(2), 426–437. https://doi.org/10.1002/aic.690490213
Qin, S. J., y Badgwell, T. A. (2003). A survey of industrial model predictive control technology. Control Engineering Practice, 11(7), 733–764. https://doi.org/10.1016/S0967-0661(02)00186-7
Rawlings, J. B., Mayne, D. Q., y Diehl, M. M. (2026). Model predictive control: Theory, computation, and design (2.ª ed., 6.ª impresión). Nob Hill Publishing. https://sites.engineering.ucsb.edu/~jbraw/mpc/MPC-book-2nd-edition-6th-printing.pdf