Cinco pares de valores bastan para recuperar exactamente una función cuadrática dentro de una biblioteca polinómica pequeña, aunque esos mismos datos admiten una descripción con tres términos si cambiamos las funciones de referencia. La curva no ha cambiado. Ha cambiado la manera de escribirla y, con ella, lo que contamos como un término.
Consideremos la relación didáctica
La variable y la respuesta son adimensionales y los valores se construyen a partir de esta fórmula, sin atribuirlos a ningún fenómeno observado. El registro inicial contiene cinco puntos.
| −2 | −6 |
| −1 | −2,5 |
| 0 | 0 |
| 1 | 1,5 |
| 2 | 2 |
El objetivo es encontrar qué funciones de una colección propuesta contribuyen a esa relación y con qué coeficientes, sabiendo de antemano la fórmula que genera el ejemplo para poder comprobar el resultado. En una investigación esa fórmula sería precisamente lo que buscamos y las decisiones sobre la colección de candidatos formarían parte de la inferencia.
De funciones a columnas
Una biblioteca es una colección de funciones que se pueden evaluar en las variables disponibles. Para empezar elegimos . Cada observación produce una fila y cada función una columna de una matriz, que denotaremos por ; la fila correspondiente al valor menos dos, por ejemplo, contiene uno, menos dos, cuatro y menos ocho.
El vector de respuestas, , puede escribirse como
donde contiene los coeficientes y es la discrepancia, que en el registro exacto se anula con coeficientes cero, dos, menos un medio y cero. Como las cuatro columnas tienen rango completo, esa solución es única dentro de la biblioteca y un ajuste ordinario ya recupera los ceros ideales. La utilidad de promover una solución dispersa aparece cuando ampliamos la colección, introducimos error o necesitamos regularizar una estimación inestable.
La relación es no lineal respecto de la variable observada, pero lineal respecto de los coeficientes desconocidos. Esta distinción explica por qué podemos usar herramientas de regresión lineal para combinar funciones no lineales. Si en cambio quisiéramos estimar la frecuencia dentro de un seno, esa frecuencia entraría de forma no lineal. Una alternativa sería proponer de antemano varios senos con frecuencias fijas, si bien entonces estaríamos resolviendo una selección entre candidatos discretos.
Se llama soporte al conjunto de posiciones con coeficiente distinto de cero. En nuestra biblioteca de monomios, el soporte contiene las columnas lineal y cuadrática. Una representación dispersa usa pocas columnas en comparación con las disponibles. Ese número depende de cómo definamos una columna y no es una medida independiente de la representación.
Chen, Donoho y Saunders (1998) estudiaron la descomposición de señales en diccionarios que pueden contener elementos redundantes. Su principio de búsqueda de base, conocido como basis pursuit, selecciona entre representaciones exactas mediante la suma de valores absolutos de los coeficientes. La biblioteca no tiene por qué ser una base en el sentido algebraico, ya que puede contener más funciones que observaciones o funciones que produzcan columnas dependientes.
Tampoco basta comparar el número de filas con el de columnas, porque varias filas pueden repetir el mismo estado o explorar una región donde funciones diferentes tienen valores casi proporcionales. La matriz incorpora tanto la colección elegida como los lugares donde se observa, de modo que añadir una función y añadir una observación cambian aspectos distintos del problema.
Qué merece entrar en la colección
Una biblioteca polinómica es un comienzo sencillo, pero su tamaño crece con el número de variables. Con tres variables y todos los monomios de grado total hasta tres, incluida la constante, aparecen veinte términos; con diez variables y el mismo grado, doscientos ochenta y seis. Las interacciones multiplican los candidatos incluso cuando el grado máximo parece modesto.
El crecimiento también dificulta la interpretación. Un producto entre dos variables puede corresponder a una interacción prevista por un mecanismo, a una aproximación local de una función más compleja o a un término que compensa una variable omitida. Su selección numérica no decide entre esas explicaciones. La definición y la procedencia de las variables determinan qué interpretaciones tiene sentido examinar.
Las unidades permiten descartar algunas combinaciones mal planteadas. Si una variable es una longitud y la respuesta una fuerza, los coeficientes del término lineal y del cuadrático tienen unidades diferentes y no sería correcto compararlos directamente por su tamaño numérico. Una función trigonométrica requiere un argumento adimensional, así que escribir el seno de una longitud exige especificar una longitud de referencia o un parámetro con unidades inversas.
En este ejemplo evitamos esas conversiones declarando adimensionales ambas cantidades, pero en una aplicación habría que conservar las referencias usadas para obtenerlas. Si se divide una velocidad por una velocidad característica, el coeficiente estimado describe esa elección. Recuperar una ecuación en unidades físicas requiere transformar los coeficientes y las variables conjuntamente.
El dominio también importa. Un logaritmo real exige argumentos positivos y un recíproco introduce una singularidad en cero. Aunque los datos de entrenamiento no alcancen esa región, la función elegida puede resultar inadecuada para las condiciones en que se usará el modelo. La biblioteca debe poder evaluarse en ese dominio y representar allí una relación plausible.
Una simetría conocida puede orientar la selección antes de ajustar. Si un mecanismo exige que invertir el signo de una variable invierta exactamente el signo de la respuesta, una biblioteca de funciones impares preserva esa propiedad. Nuestra función didáctica, que contiene un término cuadrático, no cumple esa simetría. Imponerla eliminaría una parte real del generador y obligaría al ajuste a compensar su ausencia.
Brunton, Proctor y Kutz (2016) trasladaron la selección dispersa de funciones a la identificación de ecuaciones dinámicas, con un planteamiento que depende de que las coordenadas y la biblioteca admitan una descripción dispersa y de que las observaciones expongan los términos relevantes. La colección puede incluir polinomios, funciones trigonométricas y términos motivados por el sistema. Aquí mantenemos una relación estática para examinar esas elecciones sin añadir todavía el problema de estimar derivadas.
Una lista extensa no asegura que contenga la función adecuada, porque puede acumular muchas variantes casi equivalentes y omitir, al mismo tiempo, una saturación o una dependencia de otra variable. La amplitud de la colección debe responder al tipo de relación que se intenta describir y a las observaciones disponibles para distinguir sus componentes.
Una penalización también compara escalas
Antes de promover ceros conviene revisar qué significa el tamaño de un coeficiente. Construyamos una biblioteca deliberadamente redundante con las funciones y y pidamos representar la respuesta . Asignar un coeficiente dos a la primera función y cero a la segunda reproduce la respuesta, igual que asignar cero a la primera y dos centésimas a la segunda.
La suma de valores absolutos es dos en la primera representación y dos centésimas en la segunda, así que, si minimizamos esa suma bajo ajuste exacto, la función multiplicada por cien recibe toda la contribución. La preferencia surge de la escala elegida para escribir la columna. No hemos añadido un candidato con mayor capacidad explicativa.
Una normalización frecuente divide cada columna no nula por su norma euclídea calculada en el entrenamiento. Si esa norma es , definimos
El producto que predice la respuesta se conserva () y, al terminar el ajuste, los coeficientes originales se recuperan dividiendo por las mismas normas. En el caso redundante las dos columnas normalizadas se vuelven idénticas, de manera que la normalización elimina la ventaja artificial de multiplicar una función por cien, aunque la redundancia persiste.
Con columnas idénticas hay muchas maneras de repartir una contribución positiva entre los dos coeficientes, todas con la misma predicción y la misma suma de valores absolutos. Un programa devolverá una de ellas según sus reglas internas; interpretar el nombre de la columna elegida como un descubrimiento ignoraría que la otra expresa exactamente lo mismo.
La penalización de coeficientes normalizados equivale, en las coordenadas originales, a una penalización ponderada por las normas de las columnas. Por eso hay que declarar qué escala se usa (norma euclídea, desviación estándar, valor cuadrático medio u otra) y si se divide el error cuadrático por el número de observaciones, porque el mismo valor numérico del parámetro de penalización cambia de significado según estas convenciones.
Normalizar no exige centrar cada función. Restar su media cambia una columna como por una función distinta, aunque su contribución pueda recuperarse con un término constante. Cuando ese término es un intercepto libre, suele dejarse fuera de la penalización. Si se sabe físicamente que la respuesta debe ser cero en cierto estado, esa decisión merece un tratamiento explícito, porque un intercepto libre podría romper la restricción.
Las escalas aprendidas deben conservarse para predecir, ya que volver a normalizar las columnas con los datos de evaluación cambiaría la relación entre coeficientes y funciones. El modelo que se evalúa tiene que usar las transformaciones fijadas durante el entrenamiento, junto con cualquier conversión que las devuelva a las unidades de interés.
Si las respuestas tienen precisiones conocidas diferentes, el criterio puede ponderar cada residuo por el inverso de su desviación estándar. Esa operación modifica también la geometría relevante de la biblioteca, puesto que las filas más precisas reciben más peso al comparar funciones. Las normas y los productos internos que se usen para estudiar el problema ponderado deben corresponder a esa transformación. Calcular la coherencia sobre una matriz y resolver la regresión con otra podría ocultar la semejanza que realmente encuentra el estimador.
La ponderación requiere justificar de dónde provienen las precisiones, ya que una fila no debería recibir más peso solo porque el modelo elegido la ajusta bien. Tampoco basta contar cuántas veces aparece una región, porque muchas mediciones casi repetidas pueden dominar un error promedio aunque el uso previsto exija predecir en otro intervalo. Puede interesar un criterio que refleje la distribución futura de las observaciones o uno que valore por igual distintas regiones. Son objetivos diferentes y pueden seleccionar intensidades de penalización distintas.
Cómo aparecen los ceros
Tibshirani (1996) formuló el lasso como un ajuste por mínimos cuadrados sujeto a una restricción sobre la suma de valores absolutos de los coeficientes. En una formulación penalizada podemos escribir
Usamos la mitad de la suma de cuadrados, sin dividir por el número de filas, con columnas de de norma uno y todo el ejemplo adimensional. Estas convenciones fijan el significado de los valores de que emplearemos.
La suma de valores absolutos no cuenta directamente cuántos términos quedan. Penaliza su magnitud y tiene un punto angular en cero. Esa geometría puede dejar un coeficiente exactamente nulo cuando la mejora del ajuste al introducirlo no compensa la penalización. Contar los coeficientes no nulos daría otro criterio, generalmente con una búsqueda combinatoria distinta.
Podemos resolver el ejemplo sin recurrir a una rutina compleja si restringimos por un momento la biblioteca a y , sin intercepto porque el generador conocido pasa por el origen. Sobre los cinco valores simétricos la suma de los cubos es cero, así que esas columnas son ortogonales, con normas y .
Tras normalizarlas, los coeficientes exactos son y . La ortogonalidad separa el criterio en dos problemas unidimensionales. Para cada columna, el ajuste reduce el valor absoluto del coeficiente en y lo lleva a cero si esa reducción agota su magnitud. Esta operación se conoce como umbral suave.
Con los dos términos permanecen activos y, al volver a la biblioteca original, obtenemos aproximadamente
Como los datos eran exactos, toda la suma de errores cuadrados sobre las cinco observaciones, que vale , procede de la penalización. El procedimiento ha contraído también coeficientes que pertenecen al generador. Si aumentamos el parámetro a tres, el término cuadrático desaparece y el coeficiente lineal queda en aproximadamente 1,05132. La desaparición significa que, bajo ese criterio y esa intensidad de penalización, conservar el término ya no compensa su coste. No es evidencia de que la curvatura física sea exactamente cero.
Después de seleccionar un soporte puede reajustarse solo con sus columnas y sin la penalización anterior, lo que en nuestro registro exacto recupera dos y menos un medio cuando ambos términos siguen activos. Si solo queda la columna lineal, su coeficiente vuelve a ser dos y la contribución cuadrática sigue sin representarse. El reajuste corrige aquí la contracción de los términos conservados, pero no restaura una función que ya se ha excluido.
Con datos ruidosos, ese paso adicional tiene consecuencias estadísticas. Un soporte elegido porque se adaptó bien al ruido no se vuelve correcto al reajustarlo y sus coeficientes pueden cambiar mucho si las columnas conservadas son casi dependientes. La decisión de reajustar debe evaluarse como parte del procedimiento completo, incluida la selección previa.
La fórmula de umbral suave que hemos usado depende de la ortogonalidad. En una biblioteca general, cambiar un coeficiente modifica los residuos con los que se evalúan los demás, de manera que aplicar el mismo umbral a coeficientes ordinarios calculados una sola vez no resuelve, en general, el problema del lasso.
En este registro, el término cuadrático llega a cero cuando la penalización alcanza aproximadamente 2,91548 y el lineal permanece hasta aproximadamente 6,32456. Entre esos valores existe todo un intervalo de soluciones con un solo término, cuyo coeficiente sigue variando. Mostrar esa trayectoria permite ver qué parte del resultado depende de elegir un valor concreto del parámetro. La permanencia de una columna a lo largo de un intervalo no es una probabilidad de selección correcta, como muestra la columna cuadrática, que forma parte del generador aunque quede excluida durante una región amplia de penalizaciones. La trayectoria describe la respuesta del criterio a su ajuste.
Funciones distintas que se parecen en el registro
La semejanza relevante depende de las columnas evaluadas, que pueden parecerse pese a que los nombres de las funciones sean distintos. Para columnas normalizadas, una medida es la coherencia mutua
Aquí usamos productos internos sin restar medias, por lo que la coherencia no coincide automáticamente con una correlación de Pearson entre variables centradas. Una biblioteca que incluya una constante puede tener coherencia elevada con una función positiva cuyo nivel cambia poco en el registro. En la biblioteca de cuatro monomios evaluada entre menos dos y dos, la coherencia es aproximadamente 0,94299 y el máximo corresponde a las columnas lineal y cúbica, que se parecen bastante en esos cinco puntos aunque sean distintas y el rango sea completo.
Donoho y Elad (2003) establecieron una condición suficiente para diccionarios con columnas de norma euclídea uno. En el problema exacto y sin ruido, una representación con términos que cumple
es la representación más dispersa única y coincide con la solución única de mínima suma de valores absolutos de los coeficientes. La desigualdad es estricta y supone ; un diccionario de columnas ortogonales se trata directamente. La condición da una garantía suficiente. Cuando no se cumple, la minimización de la suma de valores absolutos todavía puede encontrar la representación más dispersa.
Nuestro umbral es aproximadamente 1,03023, así que la representación de dos términos no satisface esa garantía. Sin embargo, ya comprobamos que las cuatro columnas tienen rango completo, por lo que la solución exacta es única. Este contraste muestra cuánto puede perder una cota que resume toda la matriz mediante su pareja de columnas más parecida.
La dependencia puede llegar a ser exacta si cambiamos dónde observamos. Con muestras solo en menos uno, cero y uno, las columnas y son idénticas y el registro identifica su contribución combinada, pero no cuánto corresponde a cada coeficiente. Repetir esas tres posiciones con mayor precisión no cambia esa igualdad. Una observación en dos separa las columnas, que allí valen dos y ocho.
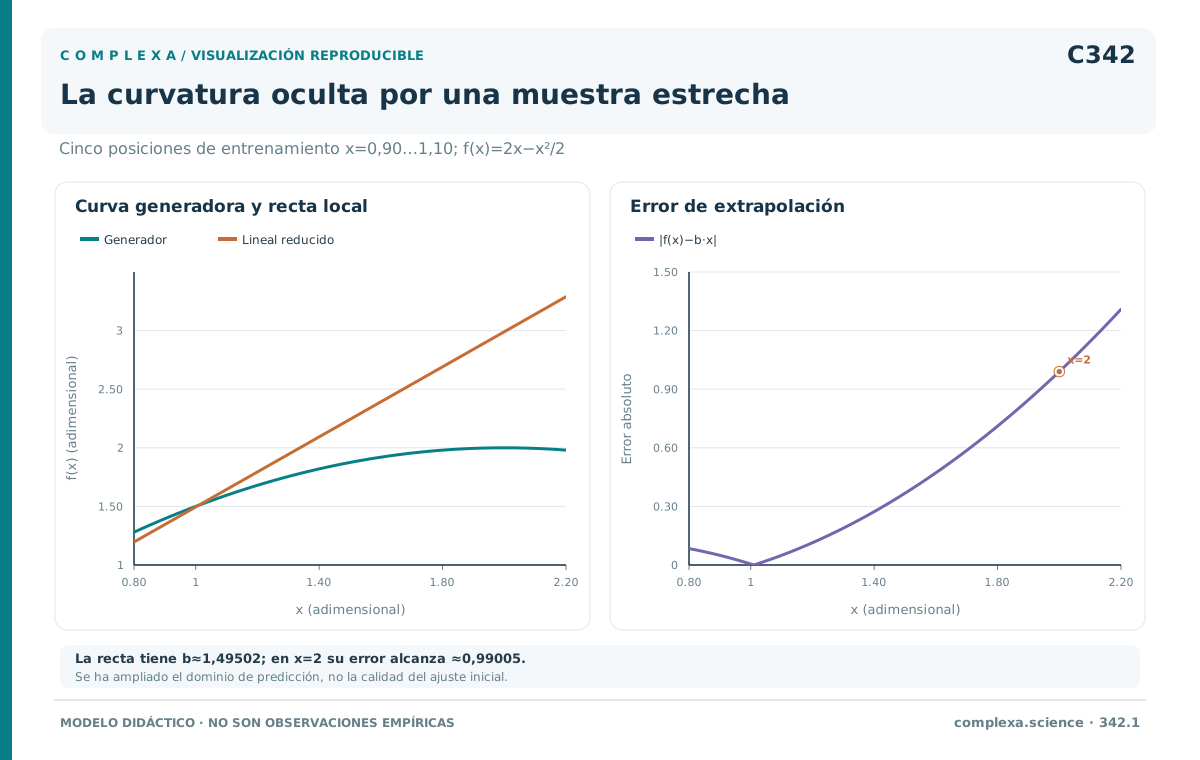
También podemos conservar el rango y dificultar mucho la separación. Tomemos cinco posiciones entre 0,9 y 1,1, espaciadas en incrementos de 0,05, sobre las cuales la coherencia de las columnas y asciende a aproximadamente 0,99760. Ambas son positivas y cambian de forma muy parecida.
Si ajustamos únicamente la función lineal a ese registro estrecho, obtenemos un coeficiente de aproximadamente 1,49502 con una raíz del error cuadrático medio de solo 0,03515. El modelo de dos términos reproduce exactamente el generador, pero el modelo reducido puede parecer aceptable cuando la precisión observacional es limitada. El error admisible y el dominio donde se desea predecir pasan a formar parte de la decisión.
La coherencia describe aquí una dificultad propia de ese diseño. Ampliar el intervalo observado puede separar sus comportamientos, pero normalizar otra vez las mismas columnas estrechas no crea esa información. Una biblioteca se evalúa junto con los datos que permiten distinguirla.
La expansión alrededor del centro ayuda a entender esa semejanza. Escribiendo , la columna cuadrática toma la forma , cuyo término cuadrático tiene menor magnitud que el lineal para desplazamientos pequeños y no nulos. Una combinación de constante y pendiente puede aproximar esa columna con un error cuadrático en el desplazamiento. Distinguir la curvatura exige observar esa contribución pequeña con suficiente precisión.
Una región estrecha no siempre es un defecto experimental, pues puede ser precisamente aquella en la que se usará el modelo. En tal caso una aproximación local sencilla puede cumplir el objetivo predictivo, aunque sería un problema interpretar la ausencia de curvatura seleccionada como una conclusión válida fuera de ese intervalo. Para decidir cuánto detalle conservar hay que relacionar el error tolerable con la variación real que los datos exponen.
El ruido de la variable explicativa añade otra dificultad. Si se mide , la columna cuadrática se evalúa como , cuyo término final no tiene media cero aunque el error sí la tenga. Su esperanza es la varianza del error. Por tanto, el error de las funciones evaluadas no se comporta como una perturbación independiente que solo afecta a la respuesta.
En esta identidad la amplificación depende del valor de la variable y de la función, por lo que las columnas de orden mayor pueden tener distribuciones de error distintas incluso si proceden del mismo sensor. Normalizarlas por su magnitud observada no corrige automáticamente ese problema. Si su incertidumbre es relevante, habrá que representarla en el modelo de medición o comprobar cómo afecta a la selección. Nuestros cálculos mantienen las posiciones exactas para aislar las decisiones sobre la biblioteca y la penalización.
Cambiar de base cambia lo que parece escaso
La normalización multiplica columnas por constantes, mientras que un cambio de base más general puede mezclarlas. En el registro simétrico podemos sustituir los cuatro monomios por
Estas cuatro columnas son ortogonales sobre los cinco puntos iniciales, lo que facilita el cálculo al poder separarse cada dirección de las demás. Sin embargo, la misma función generadora se escribe ahora como
Hay tres coeficientes no nulos, uno más que con los monomios. La constante adicional compensa el desplazamiento introducido en la función cuadrática y no corresponde a ningún mecanismo nuevo que haya aparecido al mejorar el condicionamiento de la matriz.
Una regresión ordinaria sobre una base completa y sobre su transformación invertible produce las mismas predicciones cuando se hace la conversión correcta, pero una penalización que favorece pocos coeficientes no suele conservarse bajo esa mezcla. Ser disperso en monomios y ser disperso en polinomios ortogonales son preferencias diferentes.
Esto importa cuando se transforman variables antes de construir la biblioteca, como ocurre con la coordenada , en la que la relación queda . La traslación introduce un término constante y modifica el coeficiente lineal. Si se comparan únicamente los soportes parecería que el modelo ha ganado un componente, cuando en realidad la función representada sigue siendo idéntica.
Las coordenadas pueden elegirse por razones físicas, por estabilidad numérica o por una representación conveniente de las observaciones. Conviene conservar esas razones junto con la transformación inversa. Un conjunto de componentes abstractos puede ser útil para predecir y, al mismo tiempo, requerir más trabajo para atribuir significado a cada término de su ecuación.
Incluso la comparación entre bibliotecas necesita una regla sobre su complejidad, porque una función compuesta puede reunir en una sola columna una expresión que otra biblioteca descompone en varias. Contar columnas sin describirlas premiaría a quien empaquete más operaciones dentro de cada candidato. Para valorar la sencillez de una ecuación hace falta examinar la expresión y sus parámetros, además del número de coeficientes.
Cuando falta el término necesario
Eliminemos ahora la columna cuadrática de la biblioteca inicial y conservemos la constante, el término lineal y el cúbico. El mejor ajuste ordinario a las cinco observaciones es , con el coeficiente cúbico en cero, una suma de errores cuadrados de 3,5 y una raíz del error cuadrático medio de aproximadamente 0,83666.
El patrón residual resulta informativo. Vale menos uno en los extremos, medio en las posiciones interiores no nulas y uno en el origen. Ese patrón es la parte de la curvatura que la colección elegida no ha podido representar. Cambiar el algoritmo que selecciona entre esas mismas columnas no añade la función ausente.
La constante absorbe la media de la contribución cuadrática, pero no su variación. Los términos impares cambian de signo entre posiciones simétricas, mientras la parte cuadrática conserva el mismo valor, por lo que añadir únicamente otros términos impares no resuelve esta discrepancia sobre el diseño simétrico. La estructura de la biblioteca limita qué forma puede tener la predicción.
En datos reales, un patrón residual no identifica automáticamente la función que falta, porque una curvatura aparente podría proceder de una transformación instrumental, una variable no registrada o una relación que cambia entre condiciones. Incorporar un candidato cuadrático da una hipótesis comprobable, pero para elegir entre explicaciones hacen falta observaciones que las distingan.
Una colección muy flexible puede interpolar un conjunto finito sin representar bien la relación fuera de él, porque reducir el error de entrenamiento hasta cero no decide si la complejidad añadida se mantiene en otras posiciones. En nuestro ejemplo sabemos qué función generó los puntos, pero en una aplicación esa comparación exacta no está disponible y el criterio necesita datos reservados o nuevas mediciones.
Hay restricciones que pueden imponerse conjuntamente a varias respuestas. Supongamos que dos cantidades medidas deben sumar cero bajo una relación física conocida y que ambas se expresan con la misma biblioteca. Una manera suficiente de conservar esa identidad en todas las posiciones es exigir que sus coeficientes correspondientes sumen cero, mientras que ajustarlas por separado podría producir errores pequeños en cada una e incumplir, a la vez, la identidad.
Si esa relación física está justificada, incorporarla reduce las combinaciones permitidas, pero si es una aproximación, imponerla exactamente puede trasladar su error a los coeficientes restantes. Además, la restricción debe escribirse en las mismas unidades y coordenadas en que se declara el balance, porque dos respuestas normalizadas con escalas diferentes no conservan necesariamente la forma de una suma simple. Recuperar las unidades antes de interpretar el resultado permite comprobar qué relación satisface la ecuación final.
Seleccionar funciones y evaluar el procedimiento
La intensidad de penalización suele elegirse comparando predicciones en datos que no participaron en el ajuste de los coeficientes. Esa comparación debe incluir todas las decisiones que se quieren evaluar, porque si se prueban varias bibliotecas, grados máximos y transformaciones, esas elecciones también usan información y requieren una separación respecto de la evaluación final.
Las normas de las columnas se calculan dentro de cada conjunto de entrenamiento y los datos reservados se transforman con esas normas. Si una función es constante o nula en el entrenamiento, su tratamiento debe quedar definido antes de observar la evaluación, porque dividir por una norma casi nula puede amplificar el efecto del error de medición sin resolver la falta de información de la columna.
Una buena predicción no garantiza haber seleccionado el soporte del generador. En el intervalo estrecho la recta y la cuadrática predicen valores cercanos, así que un criterio orientado a reducir el error puede tolerar que se seleccione una u otra, sobre todo si la diferencia es menor que el ruido. Una pregunta sobre qué términos intervienen exige examinar esa incertidumbre de selección.
Zhao y Yu (2006) estudiaron condiciones para que el lasso seleccione consistentemente el modelo en distintos regímenes asintóticos. La estructura de dependencia entre columnas y los signos de los coeficientes forman parte de esas condiciones, junto con las hipótesis sobre diseño, ruido y penalización. Sus resultados distinguen entre la recuperación del soporte y el buen comportamiento predictivo; aumentar el tamaño muestral no convierte cualquier biblioteca correlacionada en una selección fiable.
También hay que definir qué significa una nueva observación. Si varias filas proceden de la misma realización o de mediciones muy próximas, separarlas al azar puede reservar puntos que contienen casi la misma información que los usados para ajustar. En una relación estática, reservar posiciones distintas prueba cierta interpolación y observar una región nueva prueba una extensión diferente; el diseño de evaluación debe corresponder al uso previsto.
Repetir el ajuste con pequeñas modificaciones de los datos ayuda a describir la estabilidad del soporte. Si dos funciones casi equivalentes se alternan, puede ser más informativo mostrar esa sustitución que presentar una sola expresión como definitiva. La frecuencia de selección obtenida mediante un procedimiento de remuestreo describe ese procedimiento y no se transforma automáticamente en la probabilidad de que cada término sea verdadero.
Cuando el propósito es interpretar, merece atención la contribución completa de cada término sobre el dominio, porque un coeficiente pequeño puede multiplicar una función grande y uno grande puede acompañar una columna casi nula. Examinar productos de coeficientes por funciones y sus efectos sobre las predicciones evita equiparar el tamaño aislado del parámetro con la importancia de un mecanismo.
Repartir una contribución entre candidatos parecidos
La penalización elastic net combina la suma de valores absolutos y la suma de cuadrados de los coeficientes; Zou y Hastie (2005) analizaron cómo esta combinación favorece un comportamiento agrupado entre predictores correlacionados. Para columnas exactamente idénticas, una componente cuadrática positiva favorece repartir por igual una contribución que el ajuste observa solo a través de su suma.
El efecto puede verse sin un algoritmo. Si dos coeficientes suman una cantidad fija, la suma de sus cuadrados es mínima cuando ambos valen la mitad. El ajuste y la contribución total permanecen iguales, pero cambia la preferencia entre repartos y la regularización puede dar una solución única allí donde la parte observacional no separa los coeficientes.
Esa unicidad pertenece al criterio completo, sin que de ella se siga que ambas funciones correspondan a dos efectos físicos del mismo tamaño. Si las columnas duplicadas proceden de dos escrituras de la misma función, repartirlas puede ser conveniente para calcular, aunque sea preferible eliminar la duplicación al presentar la ecuación. Si proceden de variables diferentes que el diseño no logró separar, la interpretación necesita conservar esa limitación.
La convención exacta también debe indicarse. El trabajo original distingue el criterio con ambas penalizaciones de un estimador posterior reescalado para reducir la contracción; aquí usamos solo la propiedad del reparto cuadrático, sin comparar numéricamente esas variantes. El addendum de los autores corrige una atribución histórica sobre las trayectorias de soluciones del lasso y se incluye junto con el artículo.
Volvamos al ajuste lineal del intervalo estrecho, cuya expresión parecía cercana al generador entre 0,9 y 1,1. Una observación nueva en , reservada para contrastar esa extensión, separaría las predicciones, porque el modelo reducido anticipa aproximadamente 2,99005 y la relación cuadrática anticipa dos.
Si el nuevo valor construido es dos, el error de la recta asciende a aproximadamente 0,99005, frente a la discrepancia nula del modelo cuadrático exacto. La medición examina una diferencia que el intervalo estrecho mostraba débilmente. Permite reconsiderar la exclusión del término cuadrático dentro de las bibliotecas propuestas y fija dónde dejó de resultar adecuada aquella aproximación lineal.
Referencias
Brunton, S. L., Proctor, J. L., & Kutz, J. N. (2016). Discovering governing equations from data by sparse identification of nonlinear dynamical systems. Proceedings of the National Academy of Sciences, 113(15), 3932–3937. https://doi.org/10.1073/pnas.1517384113
Chen, S. S., Donoho, D. L., & Saunders, M. A. (1998). Atomic decomposition by basis pursuit. SIAM Journal on Scientific Computing, 20(1), 33–61. https://doi.org/10.1137/S1064827596304010
Donoho, D. L., & Elad, M. (2003). Optimally sparse representation in general (nonorthogonal) dictionaries via ℓ¹ minimization. Proceedings of the National Academy of Sciences, 100(5), 2197–2202. https://doi.org/10.1073/pnas.0437847100
Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
Zhao, P., & Yu, B. (2006). On model selection consistency of Lasso. Journal of Machine Learning Research, 7, 2541–2563. https://jmlr.org/papers/v7/zhao06a.html
Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x Addendum, 67(5), 768: https://doi.org/10.1111/j.1467-9868.2005.00527.x