Una masa unida a un resorte puede regresar hacia el equilibrio con una fuerza que aumenta más deprisa que el desplazamiento y, si además pierde energía por rozamiento, sus oscilaciones reducen la amplitud mientras cambia su frecuencia. Quien observa la posición y la velocidad dispone de una curva bastante informativa, pero todavía debe decidir qué funciones describen la aceleración. Un término proporcional al desplazamiento, otro cúbico y otro proporcional a la velocidad producen efectos diferentes. Solo pueden recuperarse si los datos permiten distinguirlos.
Trabajaremos con un experimento enteramente simulado. Conocemos la ecuación que genera las observaciones y podemos comparar con ella el resultado de SINDy, la identificación dispersa de dinámicas no lineales presentada por Brunton, Proctor y Kutz (2016). Gracias a esa ventaja podemos separar un error del procedimiento de una discrepancia del modelo físico. Ninguna medición de laboratorio interviene en los números siguientes. El sistema, las condiciones iniciales y el protocolo de evaluación se fijan expresamente para que el cálculo pueda repetirse.
El ajuste recibirá registros de posición y velocidad, una biblioteca de funciones candidatas y derivadas calculadas a partir de esos registros, pero no la lista de términos verdaderos. Después integraremos la ecuación estimada desde condiciones iniciales que quedaron fuera del entrenamiento. Esta segunda operación es exigente, porque pequeños errores locales de aceleración pueden acumularse, alterar el desfase de las oscilaciones o cambiar su pérdida de amplitud. Comparar columnas de coeficientes ayuda, pero observar la trayectoria reconstruida añade información sobre sus consecuencias dinámicas.
El sistema que genera los datos
Consideremos una posición física en milímetros y un tiempo en segundos. La ecuación del ejemplo es
La masa está absorbida en los coeficientes de fuerza por unidad de masa. El coeficiente cúbico positivo endurece el resorte, de forma que la fuerza restauradora crece más que proporcionalmente cuando aumenta el desplazamiento. Sin fuerza externa ni fluctuación aleatoria, se trata de una variante amortiguada del oscilador de Duffing, elegida aquí por su estructura polinómica sencilla.
Para la regresión usamos las escalas explícitas milímetro y segundo, con las que definimos , y . Tanto el estado como el tiempo de cálculo son adimensionales y la prima indicará derivación respecto de , de modo que
Esta transformación permite comparar coeficientes y errores sin sumar directamente una posición en milímetros con una velocidad en milímetros por segundo. También fija el significado de los umbrales que aparecerán después. Si otra persona expresa la posición física en centímetros, el coeficiente cúbico físico pasa a valer cincuenta en las unidades correspondientes, aunque el movimiento sea el mismo y solo cambie su representación numérica. Mantener las mismas escalas físicas para construir las variables adimensionales evita interpretar ese cambio de unidades como una modificación del mecanismo.
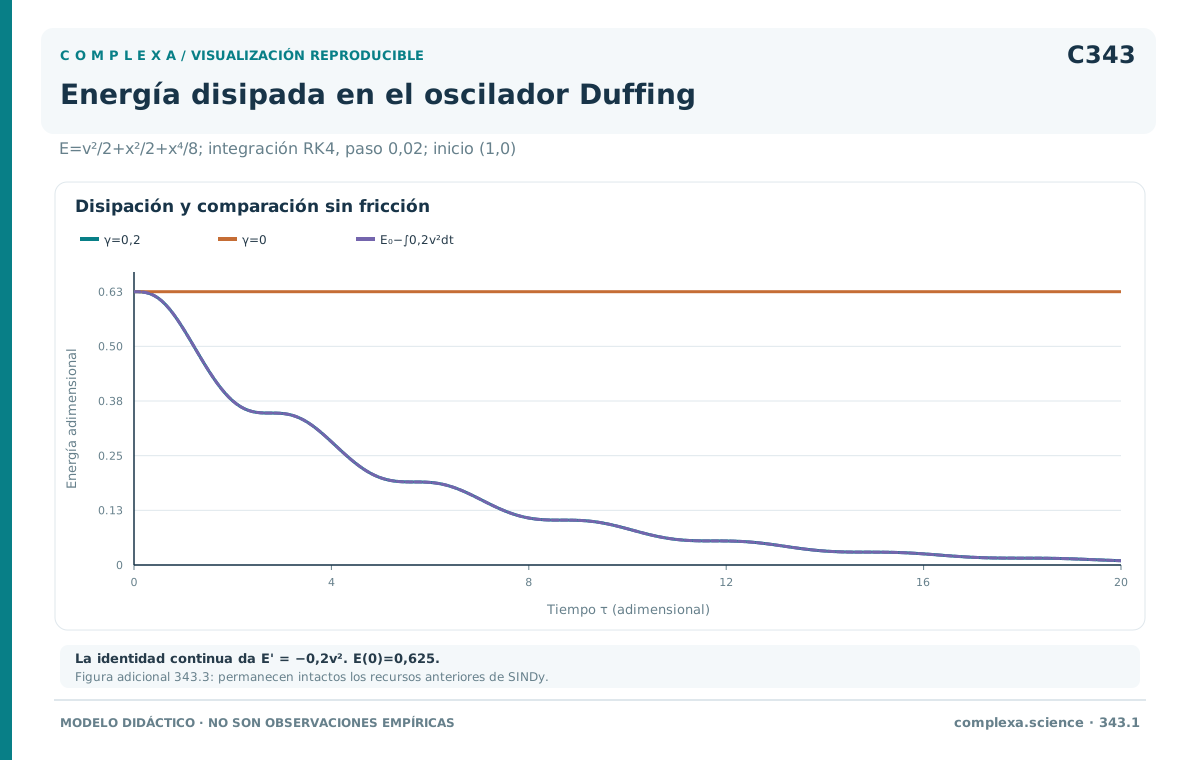
Podemos anticipar el comportamiento del sistema mediante la energía adimensional
Al derivarla a lo largo de una solución, la contribución de la fuerza restauradora se cancela con el cambio de energía potencial y queda . La energía disminuye siempre que la velocidad sea distinta de cero; en un extremo de la oscilación la pérdida instantánea es nula, aunque la aceleración haga que el movimiento continúe. Esta identidad da una comprobación física adicional, porque una ecuación estimada sin amortiguamiento puede reproducir algunos desplazamientos iniciales y mantener, aun así, una energía que el sistema verdadero disipa.
El equilibrio está en el origen. Para amplitudes pequeñas el término cúbico pierde peso y domina un oscilador lineal amortiguado, pero a amplitudes mayores cambia la relación entre desplazamiento y aceleración. Precisamente esa variación permitirá estimar la contribución cúbica, por lo que registrar solo el final del movimiento, cuando la masa casi ha regresado al equilibrio, reduciría mucho la información disponible sobre el endurecimiento del resorte.
Construir registros antes de construir la regresión
Generamos dos trayectorias de entrenamiento con estados iniciales y . Cada una se integra desde el tiempo cero hasta veinte con salidas separadas por un intervalo de , lo que da mil una observaciones por trayectoria. El integrador empleado es DOP853, con tolerancia relativa de y absoluta de . Estas tolerancias controlan el cálculo numérico y no expresan ninguna precisión experimental ni distribución de incertidumbre.
Las trayectorias empiezan con distintas combinaciones de posición y velocidad. En la primera se libera el resorte desde un desplazamiento y en la segunda se imprime una velocidad inicial al pasar por el equilibrio, pero ambas recorren un transitorio amortiguado. Las filas que finalmente entran en la regresión abarcan posiciones entre aproximadamente y y velocidades entre y . Esos intervalos describen la cobertura marginal de los datos. El rectángulo formado por sus extremos contiene estados que ninguna trayectoria visitó, por lo que no equivale a una región enteramente observada.
Aunque conocemos la ecuación generadora, para el ajuste principal estimamos las derivadas a partir de los valores muestreados, aplicando a cada componente del estado la fórmula centrada de cinco puntos
La fórmula tiene error de truncamiento de orden cuatro para funciones suficientemente suaves. Descartamos las dos primeras y las dos últimas observaciones de cada trayectoria, que no tienen todos los vecinos necesarios, con lo que quedan novecientas noventa y siete filas por registro y mil novecientas noventa y cuatro en total. Cada derivada se calcula dentro de su trayectoria antes de juntar las filas. Aplicar la fórmula de diferencias al archivo concatenado crearía diferencias artificiales entre el final del primer movimiento y el inicio del segundo.
La comparación con las derivadas exactas del campo se usa únicamente para comprobar el experimento. El máximo error absoluto de la derivada estimada es aproximadamente para la posición y para la velocidad. Corresponden a datos suaves sin ruido añadido y no anticipan la precisión que tendría la misma fórmula aplicada a un sensor, porque una perturbación pequeña en cada muestra puede amplificarse al dividir las diferencias por un intervalo corto.
Apartamos además una trayectoria de validación que parte de y , así como una trayectoria de prueba que parte de y , ambas con las mismas duraciones y tiempos de salida. La validación interviene en la elección del umbral y la prueba se usa después de fijarlo. Una división aleatoria de filas del primer registro habría dejado puntos casi vecinos a ambos lados de la separación, así que aquí reservamos movimientos completos para evaluar la ecuación en condiciones iniciales distintas.
Observar ambas componentes del estado es una decisión del experimento. Si solo se registrara la posición, una posibilidad sería estimar también la velocidad mediante diferenciación, pero entonces los errores de esa variable reconstruida entrarían en la biblioteca y compartirían observaciones con la aceleración estimada. Habría que rehacer la evaluación del ruido para ese procedimiento, porque la exactitud conseguida con posición y velocidad simuladas no se traslada automáticamente a una reconstrucción basada en un solo sensor.
Podríamos imponer desde el principio la identidad cinemática que iguala la derivada de la posición con la velocidad, lo que reduciría el número de ecuaciones que hay que identificar y sería razonable cuando conocemos la definición y la calibración de las variables. Aquí estimamos también esa relación para comprobar el funcionamiento del procedimiento en ambas columnas de derivadas, porque su recuperación ayuda a detectar errores de orden de columnas, de escalas o de tiempos. Eso no supone haber descubierto experimentalmente una relación cuya definición ya usamos al construir el estado.
La distribución temporal de las muestras también fija qué estados pesan más en la regresión. Con intervalos uniformes, una región donde el movimiento permanece mucho tiempo aporta más filas que otra atravesada deprisa, de manera que no estamos haciendo una cuadratura uniforme del plano de posición y velocidad. Los coeficientes de una aproximación incompleta dependen de esa ponderación; por ello, dos experimentos con amplitudes diferentes pueden producir distintas aproximaciones lineales de un mismo resorte no lineal.
Prolongar mucho la observación introduce otro efecto. En este sistema amortiguado el estado acaba cerca del origen y las contribuciones de las fuerzas tienden a cero. Si extendemos el registro sin agregar nuevos transitorios, la suma de cuadrados de una columna dinámica puede crecer muy poco mientras sigue aumentando el número de filas con que se calcula su media. Su raíz cuadrática media disminuye. Un umbral fijo sobre los coeficientes normalizados puede entonces eliminar contribuciones que antes retenía, así que la duración del registro forma parte de la definición operativa del ajuste, incluso cuando el intervalo de muestreo se mantiene.
Para comparar protocolos conviene tratar por separado cuánto dura cada ensayo, con qué frecuencia se observa y cuántos estados iniciales se ensayan. Reducir el intervalo ayuda a aproximar una derivada suave; añadir otra condición inicial puede revelar combinaciones de funciones que estaban confundidas. Las filas adicionales procedentes de una observación más densa no equivalen automáticamente a nuevas realizaciones independientes. En este experimento determinista los mínimos cuadrados se usan como proyección algebraica, sin atribuir a sus residuos una independencia estadística que no hemos supuesto.
Qué contiene una fila de SINDy
Para cada estado observado evaluamos, en este orden, todos los monomios de dos variables hasta grado tres,
El símbolo designará también la matriz obtenida al apilar esas filas, cuyas diez columnas corresponden a funciones candidatas, sin que hayamos eliminado ninguna por conocer la respuesta. La matriz de derivadas tiene dos columnas, una por componente. Buscamos una matriz de coeficientes tal que . Cada ecuación tiene su propia selección de términos; también el coeficiente de la velocidad en la ecuación de posición debe estimarse, aunque físicamente conozcamos la relación cinemática.
La regresión es lineal en los coeficientes, lo que permite usar mínimos cuadrados aunque la dinámica sea no lineal en el estado. La columna cúbica se evalúa con los desplazamientos observados antes de resolver el sistema algebraico. Si después se integran las ecuaciones recuperadas, esa función vuelve a evaluarse en cada estado que produce el integrador y deja de ser una columna fija de números para participar en la evolución del modelo.
Normalizamos cada columna de la biblioteca por su raíz cuadrática media en el entrenamiento. Si esa escala es , la columna usada para ajustar es ; en la biblioteca actual todas las escalas son positivas. Los coeficientes estimados en esta representación, llamados , se convierten después a los originales mediante , sin que hayamos centrado las columnas ni normalizado las derivadas objetivo.
La razón de esta operación se aprecia en las magnitudes. La raíz cuadrática media de la posición es aproximadamente , la de la velocidad y la de la posición al cubo . Un mismo coeficiente numérico produce, por tanto, contribuciones diferentes según la columna que multiplique. En las columnas normalizadas, el valor absoluto de cada coeficiente expresa la raíz cuadrática media de su contribución individual sobre los estados de entrenamiento. La suma de contribuciones puede presentar cancelaciones, así que esta interpretación no convierte el umbral en una medida independiente de importancia causal.
La matriz tiene rango diez y su número de condición, medido como la razón entre valores singulares extremos, es aproximadamente sin normalizar y tras esta normalización. Los datos no contienen una dependencia lineal exacta entre las diez columnas y, dentro de esta biblioteca y para estas filas, los mínimos cuadrados tienen una solución única. Esa afirmación algebraica atañe a la representación elegida y no declara que hayamos examinado todas las ecuaciones posibles.
En una implementación general, una columna idénticamente nula requeriría otro tratamiento, porque no se puede dividir por su escala ni estimar su coeficiente a partir de esos registros. Guardar las escalas también es necesario para usar el modelo. Reconstruir la biblioteca de una trayectoria nueva con escalas recalculadas cambiaría el significado de los coeficientes ya ajustados. Las escalas del entrenamiento acompañan al modelo hasta que se devuelven todos los coeficientes a sus unidades originales.
Aun con rango completo, los coeficientes pueden tener sensibilidades muy diferentes. Con la matriz de regresores fija, una perturbación de las derivadas se transmite a los coeficientes mediante la pseudoinversa de esa matriz. Una dirección asociada a un valor singular pequeño amplifica más ciertas perturbaciones. El número de condición resume la relación entre las direcciones extremas, pero no indica por sí solo la magnitud absoluta del error de los datos. Dos registros con igual condicionamiento pueden tener precisiones muy distintas si uno contiene un ruido mucho mayor.
En nuestro caso la biblioteca se calcula a partir de estados prácticamente exactos. Una medición ruidosa modificaría a la vez sus potencias y las derivadas estimadas, con lo que la interpretación de mínimos cuadrados como un problema con regresores fijos dejaría de describir todo el error. Esta es una razón para conservar los registros originales y la transformación aplicada a cada columna, porque la evaluación posterior de la incertidumbre debe poder reconstruir ambos lados del ajuste, tanto la biblioteca como las derivadas estimadas.
Umbrales que conservan o destruyen el movimiento
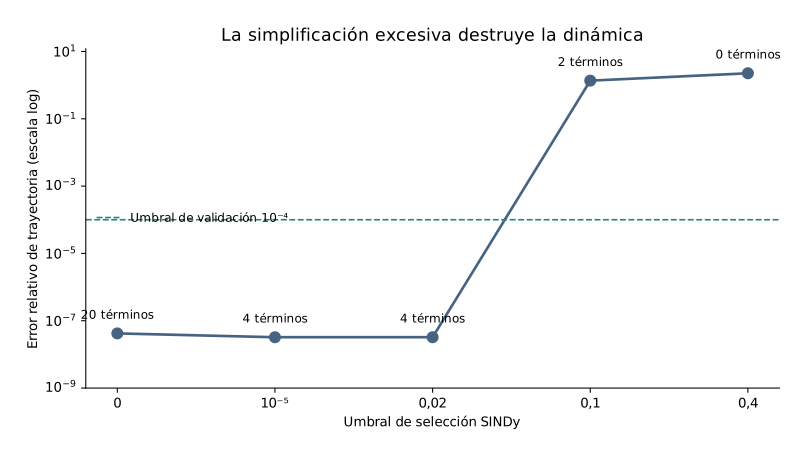
Empleamos el procedimiento de mínimos cuadrados con umbral secuencial. Para cada ecuación ajustamos primero las diez columnas normalizadas, eliminamos los coeficientes cuyo valor absoluto es menor que un umbral y repetimos los mínimos cuadrados con las columnas que permanecen. Continuamos hasta que el conjunto de columnas retenidas deja de cambiar. Un término eliminado no vuelve a entrar en esa ejecución y, si no queda ninguno, la derivada estimada para esa componente es cero.
Esta regla hace que los conjuntos de términos estén anidados. Con diez candidatos, solo puede haber un número finito de eliminaciones antes de estabilizarse. El proceso puede estabilizarse en una selección incorrecta, porque un umbral excesivo puede eliminar un término verdadero en la primera pasada y mantenerlo excluido después. Zhang y Schaeffer (2019) analizaron la convergencia de esta familia de algoritmos y sus relaciones con objetivos penalizados por el número de términos. Sus resultados de optimalidad local requieren las condiciones de rango y normalización especificadas en su análisis; la normalización de columnas que usamos aquí es distinta de la normalización espectral de algunos de esos teoremas.
Evaluamos los umbrales cero; ; ; y . El primero equivale a conservar la solución completa de mínimos cuadrados. Antes de comparar los resultados fijamos una regla didáctica. Se admiten los modelos cuyo error relativo de trayectoria en validación no exceda y, entre ellos, se elige el de menor número de coeficientes no nulos o, si quedan empatados, el mayor umbral probado. Esta tolerancia es una exigencia numérica para el ejemplo sin ruido, ajena a cualquier nivel de significación estadística.
El error de trayectoria se calcula con ambas componentes adimensionales como
La suma incluye todas las salidas del intervalo de evaluación. Las trayectorias estimadas empiezan en el mismo estado que la referencia, pero después evolucionan sin corregirse con las observaciones. La tabla siguiente recoge el resultado.
| Umbral | Coeficientes no nulos en ambas ecuaciones | Error relativo de validación |
|---|---|---|
| 20 | ||
| 4 | ||
| 4 | ||
| 2 | ||
| 0 |
El ajuste sin umbral conserva muchos coeficientes diminutos asociados al error de diferenciación y a la aritmética numérica. Su residuo de derivadas es algo menor que el del modelo disperso, pero esa mejora no se traduce en una mejor trayectoria de validación. Los umbrales intermedios retienen la misma estructura de cuatro términos y la regla fijada selecciona el valor .
Al elevar el umbral a una décima desaparecen tanto el amortiguamiento como la contribución cúbica. El reajuste aproxima la aceleración mediante y produce un oscilador aproximadamente armónico que sigue oscilando sin la pérdida de amplitud del original. La regresión ha usado el término lineal para absorber parte de la fuerza omitida, sin recuperar una rigidez física distinta. Con el umbral todavía mayor, todas las derivadas quedan anuladas y el estado se mantiene en su valor inicial. La tabla deja ver qué comportamiento corresponde a cada simplificación.
Recuperación y prueba con mayor amplitud
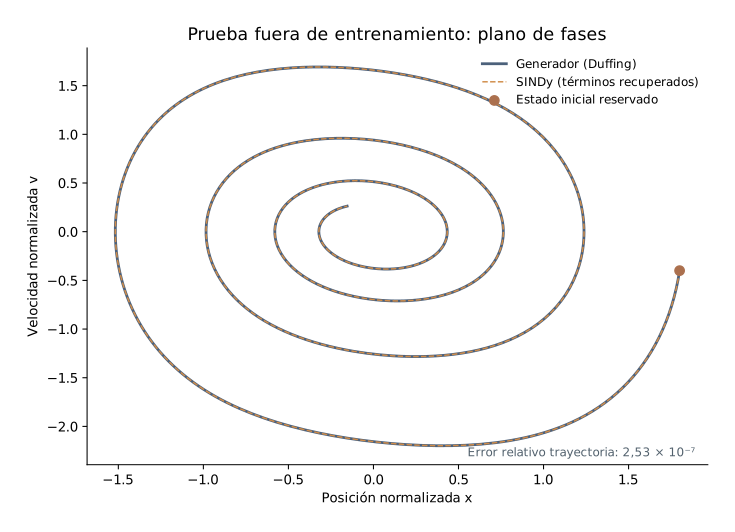
Al devolver los coeficientes seleccionados a la biblioteca original obtenemos
Los cuatro términos coinciden con la estructura generadora. Las cifras adicionales muestran el tamaño del error de cálculo y, para describir el mecanismo, basta redondear los coeficientes a uno, dos décimas y media unidad. Las integraciones de evaluación usan los coeficientes estimados completos, porque redondearlos deliberadamente a la ecuación verdadera y evaluar después esa versión ocultaría una parte del error que queremos medir.
La trayectoria de prueba parte de una posición mayor que cualquiera de las usadas para ajustar y alcanza durante su evolución velocidades entre aproximadamente y , también fuera del intervalo de entrenamiento. El error relativo de ambas componentes a lo largo del intervalo de veinte unidades de tiempo es , con máximos errores absolutos de aproximadamente en posición y en velocidad. La biblioteca contiene aquí la ecuación verdadera y los registros tienen una precisión numérica muy alta. Ambas circunstancias explican buena parte de ese resultado.
Mangan y colaboradores (2017) combinaron la generación de candidatos mediante SINDy con su comparación en trayectorias de validación y desarrollaron también criterios de información para ordenar modelos. En nuestro cálculo bastan el error de trayectoria declarado y la regla de selección anterior, porque convertir una colección de errores temporales en una puntuación de verosimilitud requeriría definir qué observaciones se consideran independientes y cómo se distribuyen los residuos. La tabla no necesita esa interpretación estadística para mostrar la diferencia entre los candidatos.
Hicimos dos comprobaciones del origen de las pequeñas discrepancias. Primero repetimos la simulación de entrenamiento con el integrador implícito Radau, conservando tiempos de salida y tolerancias; la máxima diferencia entre estados es aproximadamente , muy inferior al error de las derivadas estimadas. Después redujimos a la mitad el intervalo de muestreo y repetimos la diferenciación y el ajuste. El mayor error absoluto de coeficiente pasó de a , una mejora cercana al factor dieciséis esperado para una aproximación de cuarto orden en este régimen.
En otra comprobación auxiliar entregamos al ajuste las derivadas exactas evaluadas en los estados simulados y la recuperación de coeficientes llega aproximadamente a la precisión de la máquina. Esto identifica la diferenciación como la fuente dominante del pequeño error del ajuste principal. Esa ventaja no se usa para elegir el umbral ni para producir la trayectoria de prueba. En un experimento real faltaría precisamente esa derivada de referencia y habría que estudiar la sensibilidad a distintas aproximaciones con otros procedimientos.
Del error de aceleración al error de trayectoria
El residuo de la regresión compara dos vectores evaluados en los mismos estados observados, mientras que durante la integración el modelo estimado visita sus propios estados. Si su posición se desvía un poco, la fuerza restauradora se evalúa en otra posición y modifica la aceleración siguiente. Esa realimentación explica por qué una tabla de coeficientes o un error pequeño de derivadas no sustituye a la prueba dinámica.
Escribamos la diferencia entre una trayectoria estimada y la verdadera como . Si ambas permanecen próximas y el campo es diferenciable, una aproximación local de su evolución contiene dos contribuciones, el jacobiano del campo verdadero multiplicado por la desviación y el error del campo estimado evaluado sobre la trayectoria de referencia. La primera propaga la desviación ya acumulada y la segunda introduce una discrepancia nueva. La utilidad de esta aproximación depende de que la separación sea suficientemente pequeña durante el intervalo considerado.
Para nuestro oscilador, la derivada de la aceleración respecto de la posición es y la respuesta local cambia con la amplitud. Además, un error del coeficiente cúbico se multiplica por el cubo de la posición, de forma que en una posición de magnitud 1,8 su contribución es casi seis veces la que produce en una posición de magnitud uno. La prueba de mayor amplitud aumenta así la exigencia sobre el término cúbico, aunque la ecuación estimada conserve exactamente el mismo conjunto de funciones.
La fase añade otra dificultad. Dos oscilaciones pueden tener amplitudes muy parecidas y una pequeña diferencia de frecuencia que, con el tiempo, hace que sus máximos dejen de coincidir. Un error punto a punto puede crecer por ese desfase sin que el movimiento se vuelva inestable. En sentido contrario, una buena coincidencia durante una fracción breve del primer ciclo puede ocultar un amortiguamiento incorrecto. Por eso mantenemos un intervalo común de evaluación que incluye varias oscilaciones y su reducción de amplitud.
La condición inicial exacta de las simulaciones elimina otra fuente de separación. En una aplicación con sensores, iniciar ambos modelos en un valor estimado introduciría error antes de integrar. La incertidumbre del estado inicial y la de los coeficientes podrían evaluarse por separado o propagarse conjuntamente si su estimación las correlaciona. El número obtenido aquí corresponde a la comparación controlada que hemos definido, con el mismo estado inicial, la misma escala de error y una evolución libre durante todo el intervalo.
La biblioteca equivocada también produce coeficientes
Para observar un fallo de especificación repetimos los mínimos cuadrados con los mismos datos y derivadas, pero usando únicamente una constante, la posición y la velocidad. La aceleración cúbica ya no puede representarse exactamente y el ajuste completo de esta biblioteca lineal produce aproximadamente
La constante aparece porque la proyección se hace sobre las filas concretas del entrenamiento, que no forman una distribución perfectamente simétrica. No indica que el generador contenga una fuerza constante. La rigidez estimada aumenta respecto del valor verdadero porque intenta absorber parte del endurecimiento cúbico, mientras el amortiguamiento se modifica por las correlaciones entre las columnas observadas. Son coeficientes de una aproximación sobre un conjunto de estados, con una interpretación diferente de la que tendrían en una ecuación correctamente especificada.
El error relativo de la trayectoria de validación alcanza aproximadamente y en la trayectoria de mayor amplitud llega a . Esta degradación es coherente con el mecanismo omitido, dado que la fuerza cúbica crece deprisa cuando aumenta el desplazamiento. Un modelo lineal ajustado sobre amplitudes moderadas puede imitar cierta frecuencia media, pero no dispone de un término que modifique la rigidez al recorrer amplitudes distintas. Añadir más filas sobre la misma trayectoria no crea ese término ausente.
La forma de medir el estado también puede alterar la biblioteca adecuada. Si un sensor devuelve una transformación no lineal de la posición, la regla de la cadena modifica las ecuaciones en esas coordenadas y una dinámica polinómica breve en posición y velocidad puede requerir otras funciones después de la transformación. Champion y colaboradores (2019) trataron precisamente el aprendizaje conjunto de coordenadas y ecuaciones. Para el experimento presente hemos supuesto que las coordenadas físicas están disponibles y calibradas; extender el mismo ajuste a observaciones transformadas cambiaría el problema.
Incluso con la biblioteca correcta, la amplitud del movimiento afecta a la selección. Al repetir las dos condiciones iniciales con amplitud diez veces menor, la raíz cuadrática media de la columna cúbica se reduce a aproximadamente . La contribución verdadera de ese término a la aceleración tiene una magnitud cuadrática media cercana a . El umbral de dos centésimas usado antes resulta enorme en comparación y supera también la contribución del amortiguamiento, de aproximadamente siete milésimas. Ese mismo procedimiento elimina ambos términos aunque los datos sigan siendo numéricamente precisos.
Podríamos bajar el umbral y recuperar esas contribuciones en el experimento sin ruido, aunque con ruido instrumental habría que comprobar también si la pequeña fuerza cúbica queda separada del error de observación. La normalización evita que una columna sea penalizada solo por su escala, pero no inventa señal física. Esta dependencia del rango de amplitudes explica por qué registrar un transitorio suficientemente amplio puede ser más útil que prolongar durante mucho tiempo una oscilación casi extinguida.
Una órbita puede ocultar otras ecuaciones
La recuperación anterior se obtuvo dentro de una biblioteca fijada y con varias condiciones iniciales. Para ver lo que puede perderse sobre una sola órbita consideremos ahora un sistema distinto, el oscilador armónico , observado únicamente sobre el círculo de radio uno. Allí se cumple exactamente y podemos sustituir su aceleración por
con una constante cualquiera, porque el término añadido se anula en todos los estados de esa órbita. Por ello no cambia ninguna de sus derivadas ni su trayectoria, aunque sí modifica el campo fuera del círculo. Todos los términos de esta familia caben en la misma biblioteca cúbica usada antes, así que la ambigüedad no requiere ninguna función exótica ni un grado polinómico muy alto.
Si evaluamos las diez columnas en sesenta y cuatro puntos igualmente espaciados del círculo, la matriz tiene rango siete. La relación es una dependencia explícita entre columnas y existen otras dos que proceden de multiplicar, o no, la identidad circular por la segunda coordenada. Repetir indefinidamente el mismo ciclo aporta más filas que siguen cumpliendo esas relaciones, sin recuperar los grados de libertad perdidos.
En este ejemplo una penalización dispersa puede acertar al preferir la ecuación armónica, que tiene menos términos, pero esa preferencia introduce un criterio de selección. Los datos del círculo no excluyen por sí solos las otras ecuaciones. Al comenzar desde y la contribución añadida vale , así que una perturbación radial permite observar de inmediato una diferencia de aceleración que era invisible en toda la órbita anterior.
En el caso amortiguado, el rango completo de la matriz descarta esta clase de dependencia exacta dentro de nuestra biblioteca, aunque solo establece una unicidad condicionada a las funciones candidatas y a la información disponible sobre las derivadas. Una función que se anule en todos los estados observados y cambie fuera de ellos puede pertenecer a una biblioteca más amplia. La prueba de mayor amplitud examina un conjunto adicional de estados y su éxito amplía el respaldo empírico, sin convertir un número finito de trayectorias en una demostración universal sobre el campo.
Qué guardar junto a la ecuación recuperada
El resultado reproducible incluye las condiciones iniciales, las escalas físicas, los tiempos de observación y la regla de diferenciación, además del orden de las columnas, sus factores de normalización y el criterio de umbral. Cambiar cualquiera de esas decisiones puede alterar qué términos se conservan. Paquetes como PySINDy organizan estos componentes en una implementación reutilizable (de Silva et al., 2020), pero citar el paquete no especifica la configuración empleada.
La variación de los datos da otra forma de estudiar la estabilidad del resultado. Fasel y colaboradores (2022) desarrollaron conjuntos de ajustes mediante remuestreo de datos y de bibliotecas, en los que la frecuencia con que aparece un término informa sobre su estabilidad frente al procedimiento de remuestreo elegido. Interpretar esa frecuencia como la probabilidad de que una ley física sea verdadera exigiría supuestos adicionales. Además, los puntos próximos de una trayectoria no son réplicas experimentales independientes. Para estudiar variaciones entre ensayos conviene conservar la identidad de cada trayectoria, lo que permite remuestrear al nivel adecuado y distinguir esas variaciones de las que produce la simple selección de filas.
En este cálculo no hemos generado experimentos ruidosos ni intervalos de confianza, por lo que los decimales de los coeficientes describen un error numérico comprobado. Esta distinción afecta a la siguiente decisión experimental, porque si interesa medir una pequeña corrección cúbica habrá que elegir amplitudes donde su contribución sea observable y repetir el registro en condiciones comparables. Una colección de coeficientes muy estable cerca del equilibrio podría seguir omitiendo esa corrección por falta de excitación suficiente.
Volvamos a una predicción concreta del resorte simulado en el estado adimensional , donde la energía verdadera es y su derivada es . El modelo recuperado conserva, salvo el pequeño error de coeficientes calculado, esa pérdida instantánea de energía. El candidato obtenido con el umbral de una décima no tiene amortiguamiento y su movimiento se mantiene sobre las curvas de energía de su propio oscilador lineal. Para distinguirlos basta seguir la disminución de amplitud desde ese estado, ya que el coeficiente eliminado tiene una consecuencia medible en la siguiente oscilación.
Referencias
Brunton, S. L., Proctor, J. L., & Kutz, J. N. (2016). Discovering governing equations from data by sparse identification of nonlinear dynamical systems. Proceedings of the National Academy of Sciences, 113(15), 3932–3937. https://doi.org/10.1073/pnas.1517384113
Champion, K., Lusch, B., Kutz, J. N., & Brunton, S. L. (2019). Data-driven discovery of coordinates and governing equations. Proceedings of the National Academy of Sciences, 116(45), 22445–22451. https://doi.org/10.1073/pnas.1906995116
de Silva, B. M., Champion, K., Quade, M., Loiseau, J.-C., Kutz, J. N., & Brunton, S. L. (2020). PySINDy: A Python package for the sparse identification of nonlinear dynamical systems from data. Journal of Open Source Software, 5(49), 2104. https://doi.org/10.21105/joss.02104
Fasel, U., Kutz, J. N., Brunton, B. W., & Brunton, S. L. (2022). Ensemble-SINDy: Robust sparse model discovery in the low-data, high-noise limit, with active learning and control. Proceedings of the Royal Society A, 478(2260), 20210904. https://doi.org/10.1098/rspa.2021.0904
Mangan, N. M., Kutz, J. N., Brunton, S. L., & Proctor, J. L. (2017). Model selection for dynamical systems via sparse regression and information criteria. Proceedings of the Royal Society A, 473(2204), 20170009. https://doi.org/10.1098/rspa.2017.0009
Zhang, L., & Schaeffer, H. (2019). On the convergence of the SINDy algorithm. Multiscale Modeling & Simulation, 17(3), 948–972. https://doi.org/10.1137/18M1189828