Una curva medida puede parecer suave y producir una derivada casi ilegible, porque la resta entre observaciones próximas conserva sus pequeños errores y luego los divide por un intervalo temporal corto. Cuando esa derivada se usa para identificar una ecuación, la dificultad continúa dentro de la regresión, ya que las mismas observaciones ruidosas aparecen en las funciones candidatas que intentan explicarla. Limpiar la columna de derivadas resuelve solo una parte del problema.
Hay dos caminos habituales para trabajar con esa información. Uno consiste en estimar derivadas mediante una regularización que controle su variabilidad y el otro transforma la ecuación para comparar integrales de las observaciones. La forma débil pertenece al segundo grupo, porque, tras multiplicar por una función de prueba e integrar por partes, la derivada actúa sobre una función conocida que podemos calcular exactamente. Así se evitan ciertas diferencias entre mediciones ruidosas, aunque siguen existiendo errores en las integrales, en los regresores y en la elección de la ecuación.
Usaremos señales y experimentos simulados para seguir esos errores por separado, con un estado y un tiempo adimensionales en todos los cálculos numéricos. Si una unidad temporal corresponde a un segundo, una tasa estimada de menos uno equivale a un decaimiento con tasa de un segundo inverso. El ejemplo principal será la ecuación , cuya solución con condición inicial unitaria es . Conocerla permite calcular tanto las derivadas verdaderas como las integrales de referencia.
El precio de dividir por un intervalo pequeño
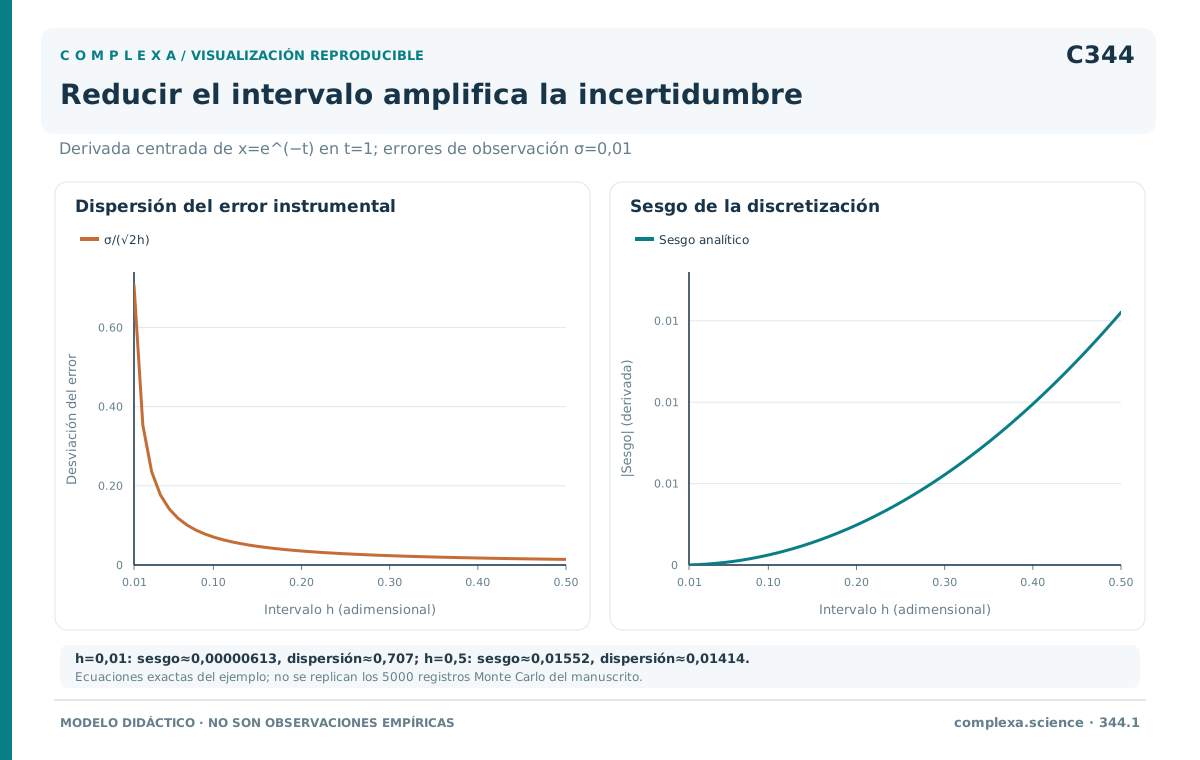
Supongamos observaciones tomadas en tiempos uniformes separados por , con errores de media cero y varianza , independientes entre muestras. La diferencia centrada estima la derivada mediante
Su parte aleatoria es y, bajo esas condiciones, tiene varianza , así que reducir el intervalo a la mitad multiplica esa varianza por cuatro. El resultado presupone que la precisión de cada muestra permanece igual al cambiar la frecuencia de observación. Un instrumento que promedia durante la exposición, o cuyos errores están correlacionados, requiere otro modelo de medición.
La señal también introduce un error, incluso sin ruido. Para la exponencial del ejemplo, la media de la diferencia centrada en un instante es , mientras que la derivada verdadera es , de modo que el sesgo de truncamiento es . Su magnitud disminuye al acortar el intervalo, justo cuando aumenta la dispersión debida al ruido; el error cuadrático medio es la suma de la varianza y el cuadrado de ese sesgo.
Evaluemos la derivada en el tiempo uno, con desviación típica de observación y derivada verdadera de aproximadamente . La tabla siguiente recoge los resultados calculados con las expresiones anteriores.
| Intervalo | Sesgo de truncamiento | Desviación típica del ruido en la derivada |
|---|---|---|
La primera fila aproxima muy bien la derivada de la señal sin ruido, pero la variabilidad de una estimación individual supera la magnitud de la derivada buscada. El intervalo más ancho reduce esa variabilidad a costa de promediar el cambio sobre una región mayor. La tabla describe una señal, un instante y un modelo de error concretos, de los que no se deduce ningún intervalo óptimo universal. Una transición rápida podría quedar seriamente deformada por la misma separación temporal que aquí funciona razonablemente.
La diferenciación también modifica la dependencia temporal del ruido. Dos diferencias centradas separadas por dos pasos comparten una observación con signos opuestos, por lo que su covarianza es y su correlación, menos un medio. Aunque los errores originales sean independientes, los de las derivadas calculadas dejan de serlo. Tratarlas como observaciones independientes con la misma precisión puede distorsionar una evaluación de incertidumbre posterior.
Suavizar implica elegir qué variaciones conservar
Una regresión polinómica local usa varias muestras para estimar la pendiente, ajustando un polinomio en una ventana y derivándolo en el centro, sin limitarse a conectar dos puntos. El procedimiento de Savitzky y Golay (1964) organizó este tipo de cálculo mediante coeficientes de filtrado. El grado del polinomio y la anchura temporal de la ventana determinan qué formas locales se reproducen exactamente y qué detalles se atenúan.
Podemos obtener unos pesos sencillos sin recurrir a tablas publicadas si ajustamos por mínimos cuadrados un polinomio cuadrático a cinco muestras en los tiempos relativos . Por simetría, la estimación de la pendiente central es
La expresión reproduce exactamente la derivada central de cualquier polinomio cuadrático y, con errores independientes de varianza común, su varianza es , cinco veces menor que la de la diferencia centrada de tres puntos. Esa reducción se consigue usando una ventana más extensa y una aproximación local particular. Si la señal contiene una contribución cúbica apreciable en esa ventana, la pendiente adquiere un sesgo. El orden de exactitud polinómica y la precisión frente al ruido son propiedades diferentes.
Una ventana expresada solo como número de muestras queda incompleta. Cinco observaciones a cien por segundo abarcan una duración distinta de cinco observaciones a diez por segundo. Para comparar filtros hay que registrar ambas magnitudes. Cerca del comienzo y del final del registro faltan vecinos a uno de los lados; un ajuste unilateral tiene otros pesos y otras propiedades de error, así que copiar el comportamiento del filtro central a los extremos introduce una suposición que debe verificarse.
La regularización por variación total es otra forma de controlar una derivada estimada. Penaliza sus cambios a lo largo del registro y puede admitir saltos en la derivada, como desarrolla Chartrand (2011). Esa propiedad resulta pertinente cuando la señal tiene esquinas o cambios de pendiente que un suavizado excesivo borraría. La intensidad de la penalización sigue siendo una decisión, porque una solución casi constante puede ser muy estable y perder, al mismo tiempo, la aceleración que se intenta medir.
Van Breugel, Kutz y Brunton (2020) propusieron un marco para comparar fidelidad y suavidad en distintos procedimientos de diferenciación. Cuando no se conoce la derivada verdadera, el marco usa criterios indirectos, entre ellos comparar las observaciones con la integral de la derivada estimada. Esa comparación comprueba cierta coherencia con la señal, pero no da por sí sola el error real de la derivada. En identificación dinámica interesa además observar cómo cambian la ecuación ajustada y su capacidad de reproducir trayectorias al variar razonablemente el suavizado.
El ruido también cambia las funciones candidatas
Imaginemos que hemos obtenido una derivada aceptable y queremos ajustar una ecuación que contiene una potencia del estado, con una biblioteca evaluada en las mediciones disponibles. Para un error gaussiano aditivo de media cero y varianza conocida, condicionado al estado verdadero, se cumple
El ruido centrado de la observación produce así un desplazamiento sistemático en las columnas cuadrática y cúbica que no desaparece al integrarlas a lo largo del tiempo. En una ecuación con una fuerza cúbica, la contaminación puede introducir una contribución con la forma de un término lineal, precisamente una de las funciones que la regresión intenta distinguir.
Con un estado de valor y una desviación típica de ruido de , el cuadrado verdadero vale y la esperanza del cuadrado observado, , mientras que el cubo verdadero vale y la esperanza del cubo observado llega a . La discrepancia relativa resulta mayor en la potencia cúbica. Una apariencia visual razonable del registro original no basta para juzgar la precisión de todas las columnas no lineales que se construirán con él.
Cuando se conocen las condiciones de ese modelo de ruido, las expresiones e tienen esperanzas condicionales iguales al cuadrado y al cubo verdaderos. La corrección depende de la varianza y de los momentos supuestos; aun aplicándola, permanecen fluctuaciones en las columnas y dependencia con el otro lado de la ecuación. Que una función transformada sea insesgada no implica que lo sea el coeficiente obtenido al resolver una regresión con ella.
El problema aparece incluso en una relación lineal. Consideremos, como cálculo separado, estados latentes independientes, centrados y con varianza uno. El objetivo limpio es igual a menos el estado; el regresor medido suma un error independiente, centrado y de varianza un cuarto. La pendiente de la regresión poblacional del objetivo sobre ese regresor es menos uno dividido entre uno más un cuarto, es decir, , aunque el valor verdadero era . Aumentar la cantidad de observaciones solo aproxima mejor esa pendiente poblacional sesgada.
Ese ejemplo de atenuación supone independencia entre el error del regresor y el del objetivo. Al construir una derivada con los mismos datos usados en la biblioteca puede aparecer dependencia entre ambos errores. El sesgo ya no tiene por qué seguir aquella fórmula ni dirigirse siempre hacia cero, por lo que el análisis debe considerar la transformación completa del registro. El marco de errores en variables que emplean Bortz, Messenger y Dukic (2023) en WENDy parte precisamente de reconocer esa contaminación simultánea.
Integrar una ecuación y conservar sus bordes
Una forma directa de evitar derivadas puntuales consiste en integrar la ecuación entre dos tiempos. Si , entonces
Schaeffer y McCalla (2017) desarrollaron la selección dispersa de modelos mediante términos integrales, con una regresión construida sobre funciones candidatas integradas. El lado izquierdo conserva una diferencia entre valores de los extremos y, con observaciones ruidosas, contiene el error del extremo final menos el del inicial. Si varios intervalos parten del mismo instante, el error inicial compartido contribuye a correlacionar sus objetivos.
La formulación débil admite elegir una ponderación temporal. Multiplicamos la ecuación por una función de prueba y aplicamos integración por partes, con lo que obtenemos
La identidad vale, por ejemplo, para una trayectoria y una función de prueba absolutamente continuas cuando los productos e integrales implicados están bien definidos. La derivada de la trayectoria ha pasado a una función elegida por quien analiza y, si sus valores en ambos extremos son cero, la contribución de borde desaparece. La trayectoria no tiene que anularse allí, pues la condición recae sobre la función de prueba.
En una biblioteca , cada función de prueba genera una ecuación lineal para los coeficientes. Suponiendo bordes nulos se calculan y , de modo que las filas corresponden ahora a integrales ponderadas y el problema algebraico es . Messenger y Bortz (2021) desarrollaron esta construcción para recuperar ecuaciones ordinarias mediante WSINDy, con decisiones específicas sobre funciones de prueba, cuadratura y tratamiento de covarianzas.
La palabra débil alude al uso de identidades integrales frente a funciones de prueba y no significa que el ajuste sea menos exigente ni que se permita ignorar la ecuación. Una familia suficientemente rica de pruebas puede caracterizar una ecuación en un sentido matemático preciso. En el cálculo con datos usamos una cantidad finita de esas funciones y solo comprobamos las proyecciones representadas por sus filas, de manera que una discrepancia que se cancele en todas ellas puede pasar inadvertida.
El orden de las operaciones en la biblioteca merece atención. Primero evaluamos cada función candidata sobre el estado y después la integramos, porque elevar al cuadrado el estado ya promediado produce otro resultado. Para una función de prueba no negativa y de integral unitaria, la integral del cuadrado del estado es el cuadrado de su media ponderada más su varianza ponderada, así que ambas operaciones solo coinciden cuando esa variación desaparece dentro de la ventana.
Con la función polinómica que usaremos enseguida, sobre el intervalo unitario, consideremos por un momento una señal sin ruido que aumenta linealmente desde cero hasta uno. Su media ponderada es un medio y el cuadrado de esa media vale un cuarto, mientras que la integral ponderada de la señal al cuadrado vale dos séptimos. La diferencia, un veintiochoavo, procede únicamente del movimiento dentro de la ventana. Una implementación que suavice primero el estado y luego construya sus potencias puede alterar las ecuaciones integrales incluso con datos exactos.
Esta distinción ayuda también a localizar el efecto del ruido. Los términos de esperanza que aparecían al elevar una observación a una potencia entran en cada evaluación de la biblioteca antes de sumar. Una cuadratura más precisa integra mejor tanto la contribución verdadera como ese desplazamiento sistemático. El refinamiento temporal y la corrección de un modelo de observación resuelven problemas diferentes.
Un término de borde que cambia la tasa estimada
Retomemos en el intervalo de cero a uno y elijamos deliberadamente , que vale cero al inicio y uno al final. La integral que multiplica a la tasa desconocida de la ecuación es aproximadamente y la integral negativa de vale . Si se omite el término de borde, el cociente entre ambas cantidades da una tasa de aproximadamente .
El término que falta es . Al sumarlo, el lado izquierdo pasa a y la tasa recuperada es exactamente menos uno, salvo el error numérico de evaluación. El fallo no procede del ruido ni de una biblioteca insuficiente. Se ha usado una identidad distinta de la que satisface la trayectoria. Disponer de más puntos de esa curva solo permitiría calcular con más precisión el cociente equivocado.
Para los cálculos siguientes elegimos funciones que evitan esa diferencia explícita de extremos y, en un intervalo que comienza en y tiene anchura , definimos
y hacemos la función igual a cero fuera del intervalo. Su integral es uno y tanto ella como su primera derivada se anulan en ambos extremos. Es continua con primera derivada continua al prolongarla por cero y su forma polinómica permite calcular analíticamente las derivadas que necesitaremos. Para transferir una primera derivada bastaba que se anulara la propia función, pero la condición adicional será útil al considerar una segunda derivada.
Con anchura unitaria e inicio cero, la integral vale aproximadamente y vale su opuesto, con lo que la identidad continua recupera la tasa verdadera. Al pasar a muestras discretas ambas integrales deben aproximarse y esa igualdad deja de ser exacta. Elegir una función de prueba válida resuelve la cuestión del borde, pero todavía hay que estudiar la precisión de la cuadratura.
Cuánto ruido acumula una integral ponderada
Si aproximamos una integral mediante una suma con pesos , la contribución aleatoria es y, para errores independientes de varianza común, su varianza exacta es . La cancelación de errores positivos y negativos ocurre de manera probabilística. Un registro particular puede conservar una desviación; la fórmula cuantifica la dispersión entre registros repetidos bajo el modelo de observación.
Para el lado de nuestra identidad débil, los pesos interiores de una cuadratura uniforme son aproximadamente . Cuando la malla resuelve bien la función, la varianza se aproxima por . En la familia de pruebas elegida, esa integral vale . La dependencia con el tamaño de ventana es fuerte, porque una prueba más estrecha tiene una derivada más intensa y amplifica más el ruido, aunque evite diferenciar directamente las observaciones.
El lado de los regresores también fluctúa. Para la biblioteca lineal del ejemplo, la integral tiene una varianza aproximada de , donde esta última integral vale . Las dos expresiones corresponden a funcionales distintos. Dividir sus desviaciones típicas no da automáticamente la incertidumbre de una tasa estimada, porque el coeficiente usa conjuntamente todas las filas y sus dependencias.
La reducción de varianza con una malla más fina supone errores nuevos e independientes, de la misma varianza por muestra. Bajo ese supuesto, más observaciones dentro de una ventana física fija permiten promediar más información, pero si el ruido tiene una componente lenta compartida la ganancia puede ser mucho menor. En general hay que reemplazar la suma de cuadrados por , donde es la covarianza de los errores de observación.
Podemos comprobar cuánto cambia el resultado con una alternativa concreta. Para una ventana unitaria, un intervalo de muestreo de una centésima y una desviación típica de observación de dos centésimas, la varianza del lado es aproximadamente con errores independientes. Si conservamos esa varianza marginal pero fijamos correlaciones entre muestras iguales a , la varianza de la misma integral alcanza aproximadamente , casi quince veces mayor. La transformación débil es la misma y lo que ha cambiado es la información que aportan las observaciones correlacionadas.
La anchura de la prueba debe elegirse también según la dinámica. Una ventana extensa puede combinar episodios con parámetros diferentes o cancelar una oscilación de alta frecuencia y, aunque disminuya el ruido, reducir la capacidad de distinguir dos funciones candidatas. La selección de ventanas afecta a la matriz del problema y a su resolución temporal, además de controlar la variabilidad de cada integral.
Cuando los tiempos de observación son irregulares, los pesos de cuadratura deben reflejar los intervalos reales. Reutilizar una separación media puede dar demasiado peso a un grupo de mediciones cercanas y demasiado poco a una región con huecos. La fórmula general de varianza mediante los pesos sigue siendo válida bajo el modelo de error correspondiente, aunque cambian cada peso y, con él, la precisión de la integral. Una ventana amplia que cruza un intervalo sin observaciones necesita además una aproximación de lo ocurrido en ese hueco.
Un experimento reproducible con cinco mil registros
Generamos la trayectoria entre cero y cuatro con intervalo , lo que da cuatrocientas una muestras. A cada una añadimos ruido gaussiano independiente de media cero y desviación típica y repetimos el registro completo cinco mil veces. Usamos el generador PCG64 de NumPy con semilla trescientos cuarenta y cuatro, generando una matriz de ruido de cinco mil filas y cuatrocientas una columnas en ese orden. Los dos procedimientos que vamos a comparar reciben exactamente las mismas realizaciones.
El primer estimador calcula diferencias centradas en los trescientos noventa y nueve puntos interiores y ajusta por mínimos cuadrados sin intercepto, sin suavizar previamente la señal. El segundo emplea siete funciones de prueba de anchura uno, cuyos puntos de inicio van de cero a tres en pasos de un medio. Integra mediante la regla compuesta del trapecio y estima una única tasa minimizando la suma de cuadrados de , también sin intercepto ni ponderación por covarianzas.
Antes de introducir ruido comprobamos la cuadratura. Con el intervalo de una centésima el estimador débil da y al reducir el intervalo a media centésima da , con un error que disminuye aproximadamente por un factor cuatro, coherente con un comportamiento de segundo orden en esta configuración. La identidad continua era exacta, así que es la integración numérica la que ha introducido una discrepancia que no debe atribuirse a la medición ni al mecanismo.
En los cinco mil registros ruidosos obtenemos los resultados de la tabla siguiente, donde la raíz del error cuadrático medio se calcula respecto de la tasa verdadera de menos uno y la desviación típica describe la dispersión empírica de las tasas estimadas.
| Procedimiento | Media de la tasa estimada | Desviación típica | Raíz del error cuadrático medio |
|---|---|---|---|
| Diferencias centradas y ajuste lineal | |||
| Siete identidades débiles y ajuste lineal |
El ajuste débil reduce la dispersión en esta comparación. La proximidad de su media al valor obtenido sin ruido muestra que el error de cuadratura sigue siendo visible a esa resolución. Las medias de una simulación finita no son identidades exactas de esperanza y pueden variar con la semilla. Tampoco se ha comparado aquí con todas las formas posibles de regularizar una derivada, ni con un estimador óptimo de la exponencial. El cálculo aísla el efecto de dos transformaciones concretas de los mismos datos.
El número de filas del sistema débil es mucho menor que el de la regresión puntual. Las demás observaciones siguen presentes, porque cada fila integra muchos puntos y varias ventanas comparten muestras. Las primeras ventanas contienen una señal más intensa y al final la exponencial se acerca al nivel del ruido. En el ajuste sin intercepto, el tamaño de cada integral del estado contribuye al peso con que esa fila determina la tasa. Una evaluación de incertidumbre debe respetar esa estructura y el solapamiento entre ventanas.
Las funciones de prueba también pueden ocultar una discrepancia local. Si usamos una sola función que se anula en los extremos, un residuo temporal proporcional a su derivada tiene integral ponderada cero, porque la integral de es la diferencia de los cuadrados de los valores extremos dividida entre dos. Ese residuo puede ser distinto de cero dentro de la ventana y no afectar, aun así, a aquella ecuación débil. La identidad muestra qué tipo de cancelación es posible sin atribuirla a ningún conjunto de datos particular.
Añadir pruebas desplazadas o de otras anchuras permite examinar otras proyecciones del residuo, aunque duplicar una función de prueba produce una fila redundante. En una biblioteca extensa conviene inspeccionar la matriz de términos integrados, ya que la integración puede acercar columnas que eran diferentes en su forma puntual. Un sistema con siete filas no determina sin restricciones diez coeficientes libres de una misma ecuación. Una hipótesis de dispersión puede reducir el conjunto de soluciones consideradas, pero ese supuesto debe formar parte de la interpretación.
En el experimento solo hay un coeficiente y siete ecuaciones, por lo que esta dificultad estructural queda limitada. La comparación se diseñó para estudiar ruido y cuadratura sin mezclar esos efectos con la selección entre muchas funciones. Al volver a una biblioteca amplia, recuperar el soporte de una ecuación requiere una evaluación adicional, porque una mejora en la precisión de las integrales no demuestra automáticamente que esas integrales basten para separar todos los mecanismos candidatos.
Ventanas compartidas y covarianza del residuo
Denotemos por la matriz que transforma el registro observado en las integrales del estado y por la que produce las integrales negativas contra las derivadas de las pruebas. En el ejemplo lineal, y . El residuo para una tasa propuesta es y, si el ruido de observación tiene covarianza , la covarianza exacta de la parte aleatoria de este residuo es
La tasa aparece dentro de la covarianza porque multiplica a un regresor que también contiene error; usar únicamente la covarianza de omitiría esa contribución. En el problema escalar lineal la expresión es exacta para cualquier amplitud de ruido, pero una biblioteca no lineal exige considerar términos adicionales o aproximar cómo cambian sus funciones ante perturbaciones del estado.
El solapamiento puede producir incluso correlación negativa. En las ventanas consecutivas de nuestro experimento, la correlación entre los ruidos de sus valores de es aproximadamente , porque en la zona compartida las derivadas de las funciones de prueba asignan a muchas observaciones signos opuestos. Al incluir también el error de los regresores y evaluar el residuo en la tasa verdadera, la correlación entre filas consecutivas pasa a aproximadamente . Contar siete ecuaciones como siete mediciones independientes ignoraría esa relación.
WENDy desarrolla una aproximación del error de ambas partes de la regresión y usa mínimos cuadrados reponderados de manera iterativa (Bortz, Messenger y Dukic, 2023). En modelos no lineales, la covarianza se construye a partir de una expansión del efecto del ruido sobre las funciones candidatas y su precisión depende del régimen de ruido y de la no linealidad. Cambiar los pesos puede mejorar el ajuste bajo esas condiciones, pero no elimina automáticamente el sesgo de orden superior que ilustraban las potencias del estado.
La regla de comparar trayectorias nuevas sigue siendo pertinente, porque una tasa puede ajustar bien las integrales elegidas y producir una curva incorrecta en otro intervalo o desde otra condición inicial. También conviene variar moderadamente anchuras y posiciones de las funciones de prueba. Si la ecuación cambia por completo al desplazar una ventana pequeña, la selección puede depender de detalles del ruido, de la cuadratura o de una región poco informativa del registro.
Transferir una segunda derivada
Cuando solo se observa la posición, la misma construcción se aplica a una ecuación de segundo orden. Integrar dos veces por partes da
Para eliminar todos los términos de borde hay que anular tanto como en ambos extremos. La función polinómica del experimento cumple esas condiciones. Si solo se anula la primera, queda una contribución que multiplica los valores de posición en los extremos. Esa contribución debe conservarse aunque no se hayan medido velocidades.
En una ecuación , las condiciones anteriores producen
Todas las integrales contienen la posición o una potencia de ella. El signo del término de amortiguamiento procede de la primera integración por partes. Esta forma permitiría identificar coeficientes sin calcular directamente una velocidad y una aceleración en cada muestra, siempre que las integrales correspondientes aporten información suficiente para distinguirlos.
Transferir derivadas de orden mayor aumenta las exigencias sobre la función de prueba y su resolución. Para nuestra familia, la integral del cuadrado de la segunda derivada vale , de manera que, bajo el mismo esquema de ruido independiente y cuadratura bien resuelta, la varianza de la integral contra esa segunda derivada se aproxima por . Una ventana demasiado estrecha vuelve a producir una amplificación considerable, porque la ausencia de una diferencia puntual no hace desaparecer la dependencia del orden de derivación.
También cambia el tratamiento de los extremos del registro. Una función apoyada enteramente dentro del intervalo observado puede cumplir las condiciones anteriores por construcción, pero una ventana recortada porque faltan datos al comienzo o al final deja de ser la misma función. Hay que reconstruirla con el nuevo soporte o conservar los términos de borde pertinentes. Extender artificialmente la señal con ceros introduce, por su parte, un supuesto sobre lo que ocurrió fuera del registro.
Qué clase de ruido se está modelando
Hasta aquí la trayectoria subyacente satisface una ecuación diferencial ordinaria y el ruido aparece al observarla, pero una perturbación que actúe sobre la propia evolución plantea otro problema. En un modelo con incrementos brownianos, por ejemplo, la varianza de un incremento aleatorio del estado es proporcional al intervalo transcurrido, así que dividirlo por ese intervalo genera una tasa cuya varianza crece inversamente con la duración. Esa variación no puede interpretarse simplemente como una medición imperfecta de una derivada ordinaria suave.
Una identidad integrada puede seguir siendo útil en un modelo estocástico, pero la contribución aleatoria de la evolución permanece en ella y no basta con reutilizar la covarianza de errores independientes del sensor para describirla. También habría que precisar qué se quiere estimar, sea una deriva condicional, una intensidad de fluctuaciones o una ecuación efectiva bajo cierta escala de observación. Esos objetivos exigen un modelo estadístico de la dinámica.
La distinción puede comprobarse experimentalmente con réplicas y calibraciones cuando están disponibles. Repetir lecturas de un estado mantenido fijo informa sobre el instrumento; repetir la evolución desde condiciones comparables informa además sobre la variabilidad del proceso. Sin esa separación, una técnica que reduzca la variabilidad de las pendientes podría estar borrando fluctuaciones dinámicas relevantes o corrigiendo principalmente el ruido de medida. Los ejemplos calculados aquí usan estados deterministas con errores añadidos al registro.
Un error de calibración que la integración conserva
Consideremos finalmente una modificación sin ruido aleatorio, en la que el sensor registra porque su cero está desplazado. Conservamos la malla y las siete ventanas del experimento anterior. El término constante desaparece del lado integrado contra , puesto que la integral de esa derivada es cero, pero permanece en las integrales del estado, ya que cada función de prueba tiene integral unitaria.
Al ajustar únicamente , el procedimiento débil obtiene una tasa de aproximadamente , con una diferencia mucho mayor que el pequeño error de cuadratura. La señal observada obedece en realidad . Si incluimos una constante en la biblioteca y ajustamos ambas columnas, recuperamos aproximadamente para el coeficiente del estado y para la constante. Ambas cifras se aproximan a los valores esperados al refinar la cuadratura.
La ecuación observada predice que el registro se acerca a una décima y la variable física corregida, a cero. Esa diferencia puede examinarse comprobando el nivel del sensor cuando el sistema ha terminado de decaer. Un promedio temporal más largo reduciría las fluctuaciones aleatorias, pero conservaría el desplazamiento de calibración que produjo la columna constante.
Referencias
Bortz, D. M., Messenger, D. A., & Dukic, V. (2023). Direct estimation of parameters in ODE models using WENDy: Weak-form estimation of nonlinear dynamics. Bulletin of Mathematical Biology, 85, 110. https://doi.org/10.1007/s11538-023-01208-6
Chartrand, R. (2011). Numerical differentiation of noisy, nonsmooth data. ISRN Applied Mathematics, 2011, 164564. https://doi.org/10.5402/2011/164564
Messenger, D. A., & Bortz, D. M. (2021). Weak SINDy: Galerkin-based data-driven model selection. Multiscale Modeling & Simulation, 19(3), 1474–1497. https://doi.org/10.1137/20M1343166
Savitzky, A., & Golay, M. J. E. (1964). Smoothing and differentiation of data by simplified least squares procedures. Analytical Chemistry, 36(8), 1627–1639. https://doi.org/10.1021/ac60214a047
Schaeffer, H., & McCalla, S. G. (2017). Sparse model selection via integral terms. Physical Review E, 96, 023302. https://doi.org/10.1103/PhysRevE.96.023302
van Breugel, F., Kutz, J. N., & Brunton, B. W. (2020). Numerical differentiation of noisy data: A unifying multi-objective optimization framework. IEEE Access, 8, 196865–196877. https://doi.org/10.1109/ACCESS.2020.3034077