Una secuencia de imágenes de un campo puede contener millones de valores y mostrar, aun así, unas pocas oscilaciones reconocibles. Para describirlas interesa saber qué patrón espacial cambia de amplitud, cuánto tarda en completar un ciclo y cómo se combina con los demás. La descomposición en modos dinámicos, conocida habitualmente como DMD, construye esa descripción ajustando un mapa lineal entre observaciones.
El mapa es una aproximación a la evolución de las variables registradas y sus modos son direcciones asociadas a sus autovalores. Esta construcción enlaza una tarea de regresión con otra espectral. Primero se decide qué transformación explica los pares de datos y después se examina cómo actúa repetidamente esa transformación. Las decisiones de la primera etapa afectan a la interpretación de la segunda.
Schmid (2010) introdujo una formulación de gran influencia para datos numéricos y experimentales de fluidos. Tu y colaboradores (2014) desarrollaron un marco que distingue variantes del algoritmo y admite pares que no forman una única serie consecutiva. Esa distinción será útil para separar la información observada de las propiedades atribuidas al operador ajustado.
Organizar observaciones que correspondan al mismo paso
Llamaremos instantánea al vector que contiene todas las mediciones de un instante y que puede reunir posiciones de una rejilla, lecturas de varios sensores o componentes de un estado calculado. Con la convención de que cada instantánea ocupa una columna, escribimos
Las matrices tienen el mismo número de filas y de columnas. Cada columna de la segunda corresponde al futuro de la misma columna de la primera, tras un intervalo común . El orden espacial de las entradas y las unidades deben mantenerse, porque cambiar la correspondencia entre píxeles o mezclar intervalos temporales convierte el ajuste en otro problema.
También podemos reunir pares de experimentos distintos, siempre que correspondan al mismo mecanismo y al mismo intervalo. En ese caso no es necesario que la salida de un par coincida con la entrada del siguiente, pues lo relevante es saber qué observación corresponde a cuál. Así puede excitarse una dirección del sistema en un ensayo y otra dirección en otro.
El ajuste lineal ordinario busca minimizar , donde la norma de Frobenius suma los cuadrados de todas las entradas del residuo. Entre las soluciones que alcanzan el mínimo, la de menor norma de Frobenius es
donde es la pseudoinversa de Moore-Penrose. El símbolo no indica invertir una matriz cuadrada cualquiera. La pseudoinversa resuelve el problema aunque haya más sensores que observaciones o las columnas sean dependientes.
Cuando los datos no abarcan todo el espacio de medición, la acción del operador fuera del espacio explorado queda indeterminada. Si es la proyección ortogonal sobre las columnas de , cualquier operador de la forma produce el mismo ajuste sobre esas columnas, porque la matriz arbitraria modifica únicamente direcciones que no se observaron como entradas. La elección de norma mínima asigna una extensión particular que los datos no verifican.
Puede faltar incluso un mapa lineal que reproduzca exactamente los pares. Supongamos dos entradas escalares iguales a uno con salidas dos y tres, que ningún multiplicador único puede producir a partir de la misma entrada. El ajuste por mínimos cuadrados da , con residuos de magnitud y suma de cuadrados .
Tu y colaboradores (2014) expresan la condición de consistencia lineal como . Toda combinación de columnas que desaparece en las entradas debe desaparecer también en sus salidas para que un mapa lineal las reproduzca. En el ejemplo, restar las entradas da cero y restar las salidas no. La discrepancia podría proceder de ruido, de variables no observadas o de una dinámica que no se cierra linealmente en esas coordenadas.
Tener muchas columnas no resuelve automáticamente esa discrepancia, aunque puede mejorar la estimación de la aproximación que minimiza el error y hacer más visible que el mismo mapa no describe todos los pares. La interpretación de sus autovalores debe conservar ese carácter de ajuste.
La reducción mediante valores singulares
En aplicaciones con muchas mediciones sería costoso formar y diagonalizar una matriz cuadrada con tantas filas como sensores. La descomposición en valores singulares reduce el trabajo a un espacio menor. Escribimos , donde el asterisco indica transposición conjugada, las columnas de son direcciones ortonormales en el espacio de observación y los valores de la diagonal de indican cuánto contribuyen a representar las instantáneas.
Si retenemos direcciones, reunidas en , y y con todos sus valores singulares positivos, definimos
La última matriz tiene tamaño por y describe la evolución ajustada después de proyectarla sobre el espacio retenido. Si conservamos todas las direcciones singulares no nulas, , pero si descartamos alguna hemos cambiado el operador. La identidad con la pseudoinversa completa no debe mantenerse como si la truncación no hubiera ocurrido.
Schmid (2010) usa esta reducción para tratar el rango y obtener una representación numéricamente manejable. Las direcciones singulares pertenecen a la descomposición de las observaciones, también relacionada con POD. Son ortogonales y ordenan la variación registrada según la norma elegida. Los modos dinámicos surgirán de otra descomposición, la de autovalores de .
La diferencia entre ambas bases se ve en una oscilación. Una dirección singular puede describir dónde aparece la mayor variación, pero una rotación necesita dos direcciones reales para representar su fase. Escoger solo la de mayor energía puede conservar gran parte de la amplitud observada y destruir la posibilidad de girar. El criterio de compresión de datos y el de descripción dinámica persiguen objetivos distintos.
Los valores singulares pequeños plantean un problema adicional porque aparecen invertidos, de manera que un error en una dirección apenas observada puede amplificarse mucho al construir el mapa. La truncación limita esa amplificación a costa de eliminar parte de la representación. El rango debe interpretarse junto con la resolución, el ruido y la tarea predictiva; no equivale automáticamente al número de procesos físicos del sistema.
La norma tampoco es ajena a la medición. Cambiar las unidades de un sensor modifica su peso en la suma de cuadrados y puede alterar las direcciones retenidas; en una rejilla de celdas desiguales, la norma euclídea sin ponderar cuenta cada celda por igual aunque abarque un volumen diferente. Una ponderación por volumen o por precisión instrumental responde a una elección concreta que conviene mantener durante la comparación de modelos.
Consideremos dos pares independientes en dos coordenadas, con entradas y y salidas y , de forma que el mapa completo reduce a la mitad la primera coordenada y duplica la segunda. Los valores singulares de las entradas son diez y uno. La aproximación de rango uno conserva la primera dirección, responsable de algo más del noventa y nueve por ciento de la norma cuadrática, con un único autovalor no nulo de un medio.
Multipliquemos ahora por cien los valores numéricos del segundo sensor, tanto en las entradas como en las salidas. Las entradas pasan a ser y , el segundo valor singular domina y la reducción de rango uno conserva el autovalor dos. Hemos pasado de una descripción de contracción a otra de expansión sin modificar el sistema ni recoger nuevas observaciones, mientras el mapa de rango completo mantiene ambos multiplicadores.
Podemos recuperar la comparación original ponderando la segunda coordenada transformada por el inverso de cien antes de calcular la norma, lo que expresa qué significaba la distancia entre mediciones antes del cambio de unidades. Otra ponderación podría ser adecuada si el objetivo fuera medir energía física o minimizar errores en sensores de precisiones diferentes. Elegirla requiere saber qué miden las coordenadas, ya que el algoritmo no deduce esa interpretación a partir de sus magnitudes.
El ejemplo explica también por qué un umbral fijo de variación retenida necesita acompañarse de la definición de la norma. El porcentaje es una propiedad de la matriz y de su escala. Para decidir si la componente descartada importa al pronóstico podemos evaluar su salida futura en las unidades de interés, incluido el error que ocasiona eliminarla. Esa evaluación relaciona una decisión de compresión con una pérdida concreta para la tarea.
Modos proyectados y modos exactos
Sea un autovector de la matriz reducida, con autovalor no nulo . El modo proyectado, , vive dentro del espacio retenido, mientras que un modo exacto correspondiente puede escribirse como
La división fija una normalización conveniente, con la cual la proyección de sobre el espacio retenido coincide con . Otras implementaciones omiten ese factor y producen el mismo autovector multiplicado por una constante, por lo que la forma espacial y su amplitud deben interpretarse con una normalización coherente.
La distinción se verifica algebraicamente. El modo exacto satisface y el proyectado es un autovector del operador cuya salida se proyecta sobre el espacio retenido. Si la evolución ajustada permanece en ese espacio, ambos coinciden con la normalización anterior; si parte de la salida lo abandona, el modo exacto conserva esa componente.
Un ejemplo de tres coordenadas permite verlo sin depender de una imagen. Tomemos dos pares independientes en los que la entrada produce la salida y la entrada produce , con lo que el operador de norma mínima es
Las entradas ocupan el plano formado por las dos primeras coordenadas y el operador reducido sobre ese plano tiene autovalores dos y tres. El modo proyectado asociado a dos es , pero aplicarle el operador completo genera una tercera componente y el resultado no es simplemente dos veces ese vector.
El modo exacto correspondiente es , que multiplicado por la matriz da , exactamente dos veces el modo. Para el autovalor tres, el vector es a la vez modo exacto y proyectado, de modo que la diferencia entre las variantes se establece dirección por dirección.
La palabra «exacto» alude aquí al autovector del operador ajustado y no significa que sea un modo físico conocido con exactitud ni que el modelo reproduzca todas las observaciones sin residuo. El ejemplo usó datos sin ruido para aislar una diferencia algebraica que también existe en aplicaciones ruidosas.
Los autovalores cero requieren atención aparte. En esta matriz, es un autovector de autovalor cero y la entrada se descompone como el modo exacto de autovalor dos menos la mitad de ese vector. Esa componente, asociada al autovalor cero, desaparece tras un paso. Los dos modos no nulos no reproducen por sí solos esa entrada, aunque describan su continuación posterior.
Por ello, una expansión modal exige saber qué espacio abarcan los modos conservados. Si faltan direcciones o el operador no tiene una base completa de autovectores, sumar exponenciales independientes no describe toda su acción; en el segundo caso pueden aparecer factores polinomiales en el tiempo que multiplican a las potencias de los autovalores.
Una oscilación observada por tres sensores
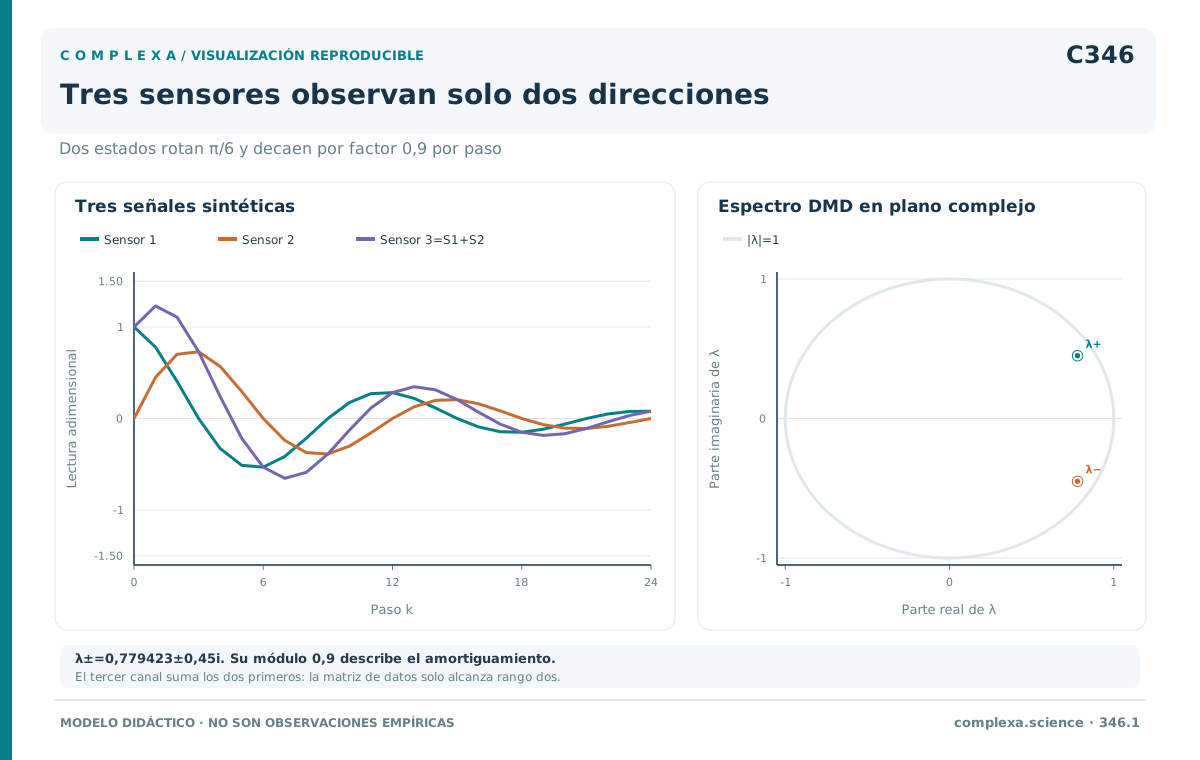
Construyamos ahora una serie completa a partir de dos variables latentes cuyo vector gira treinta grados en cada paso mientras su amplitud se multiplica por ,
Comenzamos en y los sensores entregan . La tercera lectura combina las otras dos, así que tres números por instante abarcan solo dos direcciones independientes. Elegimos un sistema sintético, de mecanismo conocido, para poder comprobar el ajuste.
Usamos veinticinco instantáneas, que forman veinticuatro pares. Los valores singulares de son aproximadamente y cero. Retener rango dos permite recuperar los autovalores
La reconstrucción modal reproduce las veinticinco observaciones dentro del redondeo numérico. Como en este ejemplo tanto las entradas como las salidas pertenecen al mismo plano, los modos exactos y proyectados coinciden tras ajustar su normalización.
Podemos escribir un modo como y el otro como su conjugado. Con amplitud inicial de un medio para cada uno, su suma produce una señal real. La primera coordenada es un coseno amortiguado, la segunda un seno amortiguado y la tercera la suma de ambos. Las componentes imaginarias permiten representar desfases y no implican que los sensores hayan registrado cantidades imaginarias.
Los modos conjugados deben conservarse juntos si queremos esa reconstrucción real, porque eliminar uno y tomar después la parte real sin ajustar amplitudes cambia la señal. En un registro con errores numéricos las parejas pueden no aparecer exactamente conjugadas. Esa diferencia también debe examinarse al reconstruir.
El rango uno conserva aproximadamente el ochenta y uno por ciento de la norma cuadrática de las entradas, pero produce un único autovalor real de aproximadamente y convierte la rotación en una contracción sobre una dirección. Su residuo relativo de predicción a un paso, calculado con la norma de Frobenius, es aproximadamente . La cantidad de variación retenida no compensa la pérdida de la fase.
El mismo ejemplo muestra también una indeterminación fuera del plano medido. La dirección es perpendicular a todas las instantáneas y el operador de norma mínima la envía a cero, pero podríamos construir otro operador que la multiplicara por cinco y reprodujera exactamente los mismos veinticuatro pares. Ninguna lectura del ensayo permite decidir entre ambas extensiones.
Si conserváramos únicamente la lectura del primer sensor, la observación sería un coseno amortiguado. Un mapa escalar homogéneo no puede representar su fase completa, porque el cociente entre dos lecturas consecutivas cambia durante el ciclo. El sistema latente sigue siendo lineal, pero su proyección sobre una sola coordenada no forma un estado suficiente para esa evolución de primer orden.
En este caso conocido podemos conservar dos lecturas sucesivas, porque la señal satisface
El vector formado por la lectura actual y la anterior evoluciona mediante una matriz de dos dimensiones cuyos coeficientes, aproximadamente y , producen de nuevo como autovalores los multiplicadores complejos de la rotación. Agregar historia recupera aquí la información de fase que faltaba. La cuenta se apoya en el modelo explícito del ejemplo; otras señales escalares pueden requerir más lecturas o no cerrarse de forma lineal.
Convertir un multiplicador en una tasa
Un autovalor DMD indica lo que ocurre durante el paso entre columnas, con un módulo que expresa el factor de amplitud y un argumento que expresa el avance de fase. Para convertirlo en una tasa continua se escribe
La parte real es una tasa de crecimiento o decaimiento y la parte imaginaria, una frecuencia angular, calculadas con logaritmos naturales. En la oscilación anterior, si cada paso dura segundos, la tasa real es aproximadamente por segundo y la frecuencia angular es radianes por segundo, con una frecuencia ordinaria de ciclos por segundo y un período de segundos.
El logaritmo complejo tiene varias ramas, pues podemos añadir cualquier múltiplo entero de al argumento del autovalor y obtener el mismo multiplicador discreto. Las frecuencias continuas correspondientes difieren en múltiplos de la frecuencia de muestreo. Para este intervalo, una rotación de ciclos por segundo genera en los instantes observados la misma fase que una de .
La rama principal se elige por convención y su elección no descarta las demás. Resolver esa ambigüedad exige información sobre el rango de frecuencias o un muestreo apropiado. Un autovalor negativo corresponde a un cambio de signo por paso y también requiere interpretar su fase, mientras que un autovalor cero no tiene un logaritmo finito y puede reflejar una dirección eliminada por el mapa ajustado.
Si observamos cada dos pasos del sistema conocido, los multiplicadores se elevan al cuadrado y el intervalo se duplica, pero la tasa física permanece igual si se conserva la rama pertinente. El ajuste realizado sobre menos instantáneas puede cambiar además por pérdida de información o por ruido. Esas diferencias no deben confundirse con el cambio puramente algebraico de unidad temporal.
Con observaciones irregulares, un único mapa entre instantáneas consecutivas mezcla duraciones distintas. Askham y Kutz (2018) estudian una DMD optimizada que ajusta exponenciales directamente en los tiempos de observación. Para tasas dadas, los coeficientes espaciales se resuelven linealmente y la proyección variable reduce el problema a una optimización no lineal de las tasas. Este planteamiento admite intervalos desiguales, aunque conserva decisiones de rango e inicialización y puede converger a un mínimo local.
El centro de la señal también cambia el problema
Una dinámica con término constante no se convierte automáticamente en un mapa homogéneo entre las variables originales. Consideremos con . La secuencia se aproxima al equilibrio dos y sus primeras lecturas son cero; uno; y .
Si ajustamos un multiplicador sin término constante a los ocho pares que terminan en la novena instantánea, obtenemos aproximadamente . Parecería existir crecimiento multiplicativo, aunque las desviaciones respecto del equilibrio se reducen a la mitad en cada paso. El ajuste intenta representar la aproximación a un nivel no nulo mediante una recta que pasa por el origen.
Restar el equilibrio dos recupera exactamente el multiplicador . Restar la media de esas nueve observaciones, aproximadamente , produce otra serie con un término constante de . Su ajuste homogéneo da aproximadamente . La media finita no coincide con el punto fijo.
Chen, Tu y Rowley (2012) analizan cómo las decisiones de centrado modifican DMD y distinguen la sustracción de una media de la de un equilibrio. En la aplicación conviene justificar qué centro se usa o ajustar explícitamente una transformación afín. En nuestro ejemplo, una regresión con entrada y constante recupera los coeficientes y uno.
El centrado afecta también al tratamiento espacial de las condiciones de frontera, porque un campo de referencia puede satisfacer una condición impuesta y dejar fluctuaciones con condiciones homogéneas. Sustraer una media calculada en otro régimen puede mezclar esa elección física con un cambio temporal. La señal eliminada debe conservarse si se pretende reconstruir la medición original.
Una operación distinta es estandarizar cada sensor por su desviación. Para un operador lineal conocido, un cambio invertible de coordenadas lo transforma por semejanza y conserva sus autovalores, pero con truncación la norma modificada puede retener otras direcciones y cambiar el espectro calculado. La invariancia algebraica completa no se traslada sin condiciones a una aproximación de rango reducido.
El término constante tampoco es la única entrada externa posible. Si una variable obedece , la secuencia de entradas contribuye a los pares ajustados. En experimentos donde siempre se impone la relación observada es . Una DMD autónoma devuelve el multiplicador uno y describe correctamente ese protocolo.
Al retirar la entrada externa, la misma variable se contrae con multiplicador . La primera estimación era aritméticamente correcta e incorporaba al mapa ajustado la relación entre estado e intervención. Si se dispone de las entradas puede plantearse un modelo que estime sus contribuciones por separado, siempre que los experimentos tengan variación que distinga sus efectos de los del estado. Llamar a un modo «propio del sistema» exige especificar qué forzamientos estaban presentes al observarlo.
Errores en las dos matrices
El ruido de medición aparece tanto en las entradas como en las salidas y el ajuste ordinario minimiza el residuo en tratando como si fuera exacta. Dawson y colaboradores (2016) muestran cómo esa asimetría introduce sesgo en DMD y estudian correcciones bajo modelos declarados de ruido.
Un cálculo poblacional sencillo muestra el mecanismo. Supongamos pares independientes de experimentos con relación verdadera , donde tiene media cero y varianza uno, medidos ambos con errores de media cero y desviación estándar , independientes entre sí y del estado. La covarianza entre entrada y salida observadas sigue siendo , pero la varianza de la entrada aumenta a .
El coeficiente que minimiza el error cuadrático esperado es entonces y no se acerca a al observar más pares, porque más datos solo aproximan el coeficiente poblacional sesgado de ese procedimiento. Si lo iteramos diez veces, el factor es aproximadamente , frente a de la dinámica verdadera.
En este ejemplo los errores de ambos ejes tienen la misma varianza y la matriz de covarianza conjunta es la covarianza de la recta verdadera más veces la identidad. Su dirección principal conserva la pendiente . Esa geometría explica por qué una formulación de mínimos cuadrados totales puede recuperar el coeficiente poblacional bajo estas condiciones.
Hemati y colaboradores (2017) construyen una proyección basada en la matriz aumentada que reúne e . Al ajustar ambas conjuntamente, el procedimiento aborda el error en las dos partes del par. Su comportamiento depende del modelo de ruido y del rango, porque una norma no ponderada no corresponde a cualquier combinación de errores correlacionados o con varianzas distintas.
Las perturbaciones dinámicas plantean otra pregunta. Un impulso físico nuevo entre dos mediciones forma parte de la evolución observada pese a que no pueda predecirse a partir de la entrada. Corregirlo como si fuera solo error del sensor puede eliminar variación del proceso. Distinguir estas contribuciones requiere réplicas, calibración o un modelo adicional de la observación y de la dinámica.
La DMD optimizada de Askham y Kutz (2018) ajusta el registro completo mediante exponenciales y mejora el ajuste ordinario en sus ejemplos ruidosos, aunque ese objetivo difiere del de minimizar errores entre pares consecutivos. La mejora no implica que cualquier registro admita una representación exponencial adecuada ni que la optimización encuentre siempre la misma solución.
Reconstrucción del registro y predicción fuera de él
Una curva reconstruida con todas las observaciones indica si los modos describen ese archivo, mientras que una predicción exige fijar el operador y sus parámetros con la información disponible antes del horizonte evaluado. Si las tasas se optimizaron sobre todo el intervalo, la coincidencia con su parte final es un ajuste retrospectivo, aunque la curva tenga aspecto de pronóstico.
Para una prueba temporal puede reservarse una continuación y estimar las tasas, el rango y el centro únicamente con el tramo inicial. También debe fijarse cómo se obtiene el estado de partida, porque usar la última medición, una estimación filtrada o una amplitud ajustada a todo el pasado produce incertidumbres diferentes. En el oscilador exacto todas esas operaciones compatibles con la ecuación recuperan la continuación, pero con error instrumental dejan de ser equivalentes.
El residuo a un paso y el error acumulado dan información complementaria. Reiniciar la predicción desde una medición verdadera en cada paso limita la acumulación; iterar libremente desde un único estado inicial permite observarla. Un pequeño error del operador puede multiplicarse repetidamente y un error de frecuencia produce un desfase creciente incluso cuando las amplitudes parecen correctas.
La oscilación sintética da una cuenta concreta. Si estimáramos un módulo de en vez de , la razón entre amplitud predicha y verdadera después de treinta pasos sería , aproximadamente . Un error adicional de radianes en el ángulo por paso acumularía radianes de desfase, unos diecisiete grados. El primer error modifica la envolvente y el segundo desplaza los máximos y los cruces por cero.
Comparar solo el promedio del error puede ocultar esas diferencias. La localización espacial del residuo ayuda a detectar una región que no comparte el comportamiento dominante. Su evolución temporal muestra si aparece al cambiar un régimen o una condición externa. Estas comprobaciones se hacen sobre datos que no participaron en elegir la representación, para que la selección de modos no absorba precisamente las discrepancias que se pretendía evaluar.
Lo que conserva una predicción modal
Para un operador diagonalizable y un estado que los modos retenidos puedan reproducir, la evolución se expresa como . Los coeficientes pueden ajustarse a la primera instantánea o al conjunto del registro; en el segundo caso se busca un compromiso entre tiempos y el resultado no tiene por qué reproducir exactamente la primera observación.
Los modos pueden ser no ortogonales y sus contribuciones interfieren en la norma de la señal, de modo que sumar «energías modales» independientes puede no tener la interpretación que sí tiene la descomposición singular. Además, multiplicar un modo por una constante y dividir su amplitud por ella no cambia la reconstrucción. Por eso, ordenar únicamente amplitudes sin fijar la normalización puede producir una jerarquía arbitraria.
Para obtener las amplitudes desde una instantánea se reúnen los modos como columnas de una matriz y se resuelve . Si dos columnas son casi paralelas pueden aparecer coeficientes grandes que se compensan al sumarse. Una pequeña perturbación de la medición cambia entonces mucho cada coeficiente y poco la señal reconstruida. El residuo inicial indica cuánto quedó sin representar y el condicionamiento de esa matriz, cuánto depende la descomposición de errores pequeños en la observación.
También existe libertad al elegir una base dentro de un subespacio con autovalor repetido. Para el operador que multiplica cualquier vector bidimensional por , cada dirección es un autovector y rotar los dos modos elegidos no cambia ninguna predicción, así que dos cálculos pueden mostrar patrones distintos y describir el mismo operador. En esa situación tiene más sentido comparar el subespacio generado por los modos que atribuir una identidad física invariable a cada vector de la base.
Hay sistemas en los que faltan autovectores independientes. La matriz con en ambas posiciones diagonales, uno encima de la diagonal y cero debajo tiene un único autovector independiente y su quinta potencia contiene un término fuera de la diagonal de . Un autovalor dentro del círculo unidad es compatible con ese crecimiento transitorio, que una suma de dos modos independientes con la misma tasa no puede representar.
Ese ejemplo muestra también la sensibilidad del espectro. Si sustituimos el cero situado debajo de la diagonal por , los autovalores pasan a y , ya que la ecuación característica es . Una modificación pequeña de una entrada ha producido una separación espectral mucho mayor que esa modificación. Los dos modos casi paralelos que aparecen no son automáticamente dos procesos físicos bien separados.
Una comparación entre ventanas o realizaciones ruidosas puede mostrar cambios amplios de los autovectores cerca de esa situación, aunque el operador reconstruido y sus predicciones sean más estables que la asignación individual de modos. Examinar ambas cosas evita basar la interpretación únicamente en puntos aislados del plano complejo. La precisión con que un programa diagonaliza la matriz estimada no mide la precisión con que los datos determinaron esa matriz.
La interpretación mediante Koopman exige condiciones adicionales sobre las funciones observadas y su evolución, porque una DMD finita ajusta un mapa en las coordenadas suministradas. Para relacionar sus modos con un espacio de observables que se mantenga cerrado bajo la evolución hay que justificar esa propiedad y el alcance de los datos. La correspondencia que discuten Tu y colaboradores (2014) no convierte cualquier autovalor calculado en un elemento identificado del espectro de Koopman.
La duración del registro también influye en qué componentes parecen relevantes. Consideremos una señal sintética de dos coordenadas. La primera comienza en uno y se multiplica por en cada paso; la segunda comienza en y se multiplica por . En las primeras veintiuna instantáneas, la dirección singular dominante de las veinte entradas conserva aproximadamente el de la norma cuadrática.
La DMD de rango uno tiene un residuo relativo a un paso de apenas y un multiplicador próximo a . Ha descartado casi toda la componente creciente. El ajuste de rango dos, con estos datos exactos, recupera ambos multiplicadores, aunque con observaciones ruidosas la segunda dirección necesitaría además suficiente precisión para distinguirse del error.
Después de cuarenta y ocho pasos, la componente que empezó mil veces más pequeña supera a la primera. En el paso sesenta los valores verdaderos son aproximadamente y y el modelo de rango uno predice y . La observación decisiva para esa extrapolación es la evolución de la componente pequeña durante el ajuste, porque su escasa contribución a la norma inicial no anticipaba cuánto pesaría al prolongar la predicción.
Referencias
Askham, T., & Kutz, J. N. (2018). Variable projection methods for an optimized dynamic mode decomposition. SIAM Journal on Applied Dynamical Systems, 17(1), 380–416. https://doi.org/10.1137/M1124176
Chen, K. K., Tu, J. H., & Rowley, C. W. (2012). Variants of dynamic mode decomposition: Boundary condition, Koopman, and Fourier analyses. Journal of Nonlinear Science, 22(6), 887–915. https://doi.org/10.1007/s00332-012-9130-9
Dawson, S. T. M., Hemati, M. S., Williams, M. O., & Rowley, C. W. (2016). Characterizing and correcting for the effect of sensor noise in the dynamic mode decomposition. Experiments in Fluids, 57, 42. https://doi.org/10.1007/s00348-016-2127-7
Hemati, M. S., Rowley, C. W., Deem, E. A., & Cattafesta, L. N. (2017). De-biasing the dynamic mode decomposition for applied Koopman spectral analysis of noisy datasets. Theoretical and Computational Fluid Dynamics, 31(4), 349–368. https://doi.org/10.1007/s00162-017-0432-2
Schmid, P. J. (2010). Dynamic mode decomposition of numerical and experimental data. Journal of Fluid Mechanics, 656, 5–28. https://doi.org/10.1017/S0022112010001217
Tu, J. H., Rowley, C. W., Luchtenburg, D. M., Brunton, S. L., & Kutz, J. N. (2014). On dynamic mode decomposition: Theory and applications. Journal of Computational Dynamics, 1(2), 391–421. https://doi.org/10.3934/jcd.2014.1.391