Una matriz puede reproducir todos los datos disponibles y atribuirles una dinámica equivocada. El problema aparece incluso con una variable, tres observaciones y ninguna perturbación aleatoria. Supongamos que el sistema eleva al cuadrado su estado en cada paso. Si solo observamos los valores iniciales menos uno, cero y uno, las funciones cuadrado y cuarta potencia coinciden en toda la muestra; un procedimiento que deba aprender cómo evoluciona el cuadrado podrá confundirlas sin cometer un solo error de entrenamiento. La diferencia se descubre al observar un estado intermedio.
A partir de esta situación examinaremos la descomposición modal dinámica extendida, conocida como EDMD por sus iniciales en inglés. El método aproxima la evolución de un conjunto elegido de funciones del estado, llamado diccionario de observables, que puede incluir coordenadas originales, productos, funciones localizadas o transformaciones aprendidas. Al añadir esas funciones, una regresión lineal adquiere capacidad para representar relaciones no lineales entre estados, aunque el conjunto elegido también determina qué relaciones quedarán fuera de la aproximación.
Williams, Kevrekidis y Rowley (2015a) formularon EDMD mediante pares de estados y un diccionario y relacionaron su límite de muchos datos con una aproximación de Galerkin. Esa relación identifica el objeto estimado como la acción del operador de Koopman seguida de una proyección sobre las funciones disponibles. El cierre exacto del diccionario es un caso especial. En el caso general queda un residuo funcional, por mucha precisión con que se calcule la matriz ajustada.
La elección de observables afecta, por tanto, a algo más que el tamaño del problema numérico, porque decide qué cantidades se intenta predecir conjuntamente y qué errores se consideran pequeños. Si se incluyen la temperatura de una habitación y su cuadrado, el ajuste debe representar ambas evoluciones. Si se incorpora únicamente una etiqueta constante, su evolución será perfecta y no contendrá información alguna sobre la temperatura. La utilidad de la representación depende de las preguntas que deba responder.
Qué matriz se está ajustando
Consideremos un sistema determinista autónomo , observado a un intervalo fijo, del que tenemos pares . Los estados iniciales pueden proceder de distintas trayectorias, sin necesidad de formar una única secuencia. Elegimos funciones reales y reunimos sus valores en la columna
Las matrices y tienen dimensiones , con una columna por estado y una fila por observable. Buscamos una matriz que aproxime los valores futuros mediante y, con pesos iguales, el criterio es
La norma de Frobenius suma los cuadrados de todos los residuos de la matriz. Aquí dividimos por el número de pares, sin dividir además por el número de funciones. Una solución de norma mínima es , donde el símbolo de daga denota la pseudoinversa de Moore-Penrose. Esta expresión conserva la convención de estados como columnas utilizada para DMD.
Definamos las matrices de momentos
Entonces . La primera es la matriz de Gram de los observables evaluados en la muestra y la segunda contiene productos entre funciones futuras y presentes. Aunque a menudo se habla de covarianzas, estas expresiones no restan las medias. La diferencia importa especialmente cuando el diccionario incluye la función constante, porque centrar todas las filas puede eliminarla y modificar el problema que se pretendía resolver.
La orientación se comprueba siguiendo un observable escalar. Si , su evolución aproximada es
En esta convención real, la matriz que transforma los coeficientes de las funciones es ; por eso una función propia aproximada se construye con un vector propio de la transpuesta. El artículo original escribe las evaluaciones del diccionario como filas y hace actuar su matriz sobre los coeficientes. Sus fórmulas y las anteriores describen la misma regresión con las orientaciones correspondientes, así que copiar una fórmula sin comprobar qué contienen sus filas cambia el cálculo.
El intervalo temporal asociado a cada par debe quedar identificado antes del ajuste. Una matriz estimada con pares separados por un segundo aproxima una evolución distinta de la estimada con pares separados por diez segundos; reunir ambos tipos de pares en la misma regresión sin distinguirlos obliga a una sola matriz a representar dos mapas. Si los intervalos varían, se necesita un procedimiento que incorpore esa variación, por ejemplo mediante un modelo temporal compatible, porque cambiar únicamente la etiqueta de los autovalores después del ajuste deja intacta la mezcla. De forma análoga, los pares obtenidos bajo entradas externas diferentes no corresponden automáticamente a un único mapa autónomo del estado medido, así que la entrada debe fijarse, incluirse en el estado pertinente o modelarse explícitamente.
Los pesos también forman parte de la definición. Si se sustituyen los promedios uniformes por pesos positivos que suman uno, las matrices de momentos y la pérdida deben usar esos mismos pesos. Una muestra deliberadamente abundante en una región del estado concentra allí la precisión del ajuste. Reponderarla puede perseguir otra distribución de interés, siempre que los datos cubran las regiones a las que se asigna peso. Ninguna ponderación revela una transición nunca observada sin introducir información adicional.
Para calcular la solución suele ser preferible trabajar directamente con una descomposición de valores singulares o una factorización adecuada de la matriz de datos. Formar la matriz de Gram eleva al cuadrado el número de condición, cuando se comparan las direcciones no nulas en la norma euclídea. La fórmula con Gram muestra bien la interpretación estadística, sin obligar a usar las ecuaciones normales como algoritmo numérico.
Un ajuste perfecto en tres puntos
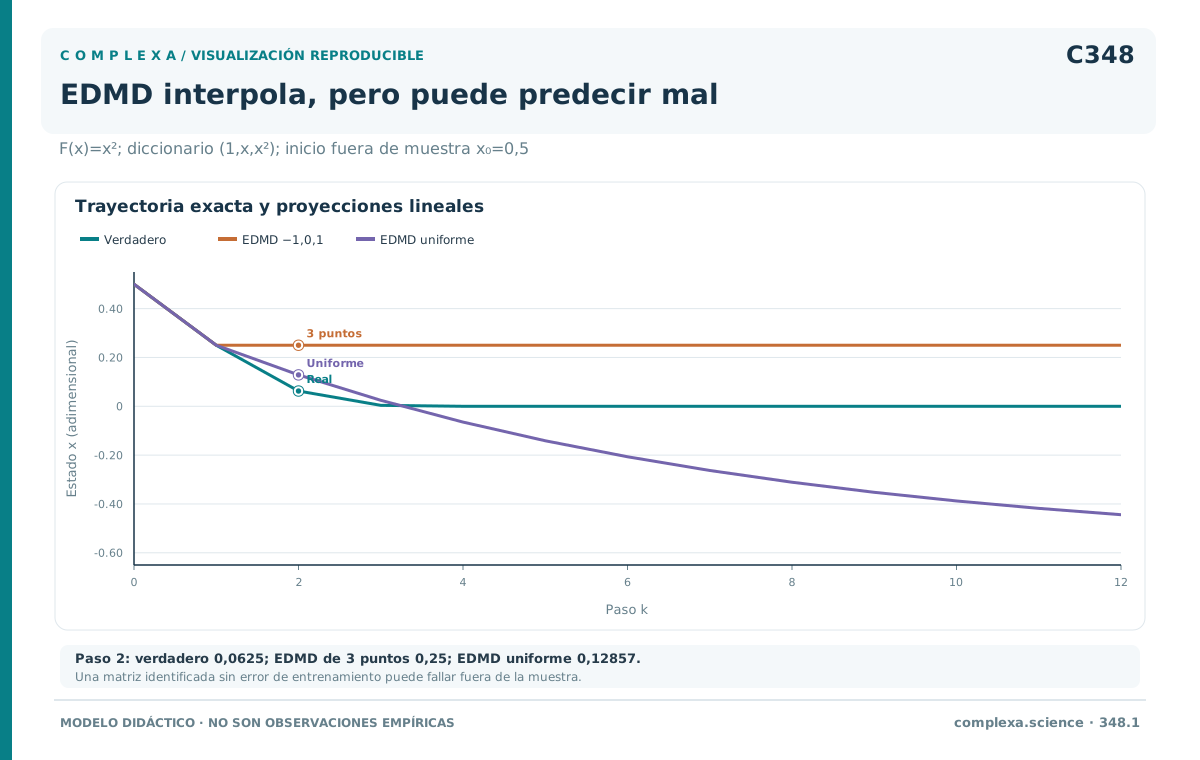
Volvamos al sistema didáctico
Tomemos tres pares de igual peso, con estados iniciales y estados siguientes . El primer diccionario, , contiene la constante y la coordenada. Sus matrices son
La predicción del estado siguiente es siempre dos tercios. El ajuste no encuentra una pendiente porque la muestra es simétrica y los extremos opuestos tienen el mismo resultado. El error cuadrático medio de esa predicción es y, como la constante se reproduce exactamente, ese valor coincide con el promedio de la suma de errores cuadrados de todas las funciones.
Ampliemos el diccionario a . La matriz ajustada resulta
El residuo de entrenamiento desaparece. La segunda fila expresa correctamente que el siguiente estado es el cuadrado del actual, mientras la tercera hace evolucionar el cuadrado mediante el mismo cuadrado. Esa relación solo es correcta en los tres puntos elegidos, donde la cuarta potencia coincide con la segunda. La matriz de Gram es invertible, por lo que el problema no se explica por una solución indeterminada. La muestra identifica una matriz única y, aun así, insuficiente fuera de esos puntos.
Un estado inicial basta para comprobarlo. Sus valores observables son y, después de aplicar la matriz, obtenemos . La predicción de la coordenada es correcta en ese paso, pero el tercer componente debería valer . El vector predicho ha dejado de contener los valores simultáneos de las tres funciones en un estado real.
Al aplicar otra vez la matriz, el tercer componente incorrecto alimenta la predicción de la coordenada. El valor predicho continúa siendo un cuarto cuando el sistema ya se encuentra en un dieciseisavo. El error que parecía circunscrito a una función auxiliar se ha convertido en un error sobre la variable que interesaba predecir.
| Paso | Estado verdadero desde | Predicción iterando |
|---|---|---|
| 0 | ||
| 1 | ||
| 2 | ||
| 3 |
Se podría corregir el tercer componente calculando de nuevo el cuadrado de la coordenada predicha después de cada paso; en este ejemplo, esa operación recuperaría la trayectoria exacta. Sin embargo, así se definiría otro predictor, que alterna una aplicación matricial con una transformación no lineal encargada de restablecer la relación entre observables. Su trayectoria ya no estaría descrita por las potencias de una sola matriz. Esa distinción debe mantenerse cuando se comparan predicciones y cuando se interpretan sus autovalores.
La distribución de estados cambia la proyección
Conservar el diccionario y añadir datos modifica la estimación, pero no introduce las funciones que faltan. Para separar ambos efectos, supongamos ahora que los estados iniciales cubren uniformemente el intervalo y que disponemos de sus momentos exactos, que corresponden al límite ideal de muestreo uniforme independiente para estas funciones. La distribución de partida no es invariante, porque después de elevar al cuadrado, los valores se concentran en la mitad no negativa del intervalo.
Los momentos impares se anulan y los pares satisfacen . Con ellos,
y la proyección produce
La constante y la evolución de la coordenada siguen siendo exactas, mientras la cuarta potencia se aproxima mediante . El término lineal no contribuye porque la función que se aproxima es par y la distribución es simétrica. El residuo es
Su producto medio con cada función del diccionario es cero. Esta es la propiedad de proyección ortogonal, según la cual ninguna corrección dentro del mismo espacio reduce la pérdida cuadrática. Eso no significa que el residuo desaparezca. En este caso , con raíz cuadrática media , aproximadamente . Ese número no contiene ruido de medición ni error de muestreo, ya que procede enteramente de aproximar una función de cuarto grado con el diccionario elegido.
Desde el estado inicial de un medio, la primera predicción de la coordenada vuelve a ser un cuarto. En el segundo paso pasa a , aproximadamente , frente al valor verdadero . Las dos distribuciones de entrenamiento han producido matrices diferentes y ambas muestran un error de cierre que la primera predicción de la coordenada no revelaba.
El comportamiento lejano resulta aún más informativo. El tercer componente predicho satisface una recurrencia afín con pendiente y término constante , por lo que converge a y arrastra a la coordenada predicha hacia el mismo valor. El sistema verdadero, iniciado en un medio, converge a cero a través de valores positivos. Una matriz con autovalores puede, así, dar una evolución acotada pero físicamente inadecuada; el autovalor uno corresponde aquí a la constante y no señala por sí mismo una inestabilidad.
El ejemplo separa el error por cobertura insuficiente de estados del error por insuficiencia del diccionario. Los tres puntos hacían indistinguibles dos funciones diferentes. Los momentos uniformes eliminan esa confusión muestral, aunque la cuarta potencia continúa fuera del espacio disponible. Aumentar el número de pares puede limitarse a estimar con mayor precisión la proyección equivocada para un horizonte o una salida determinados.
Esta dependencia de la medida aparece en la interpretación de EDMD como método de Galerkin y en sus relaciones con otras aproximaciones de operadores (Klus, Koltai & Schütte, 2016). Una medida que concentra casi toda la masa cerca de un equilibrio valora especialmente los errores de esa región. Si el objetivo incluye una transición poco frecuente hacia otro régimen, la pérdida promedio puede dedicarle poca atención aunque sus consecuencias sean relevantes para el análisis.
Una trayectoria muy larga no equivale necesariamente a un experimento que cubra uniformemente el espacio. Para el mapa cuadrático, una trayectoria iniciada entre cero y uno dedica sus observaciones tardías a estados cada vez más próximos a cero, de modo que duplicar su duración añade sobre todo información de esa región. En cambio, reiniciar el sistema en numerosos estados iniciales distribuidos por el intervalo permite observar transiciones de otras regiones. Ambos diseños pueden generar muchos pares y tener finalidades distintas; la independencia de los pares afecta a la incertidumbre de los promedios y su distribución, al objeto proyectado. Por eso, además del número total de observaciones, hay que describir cómo se obtuvieron los estados iniciales y qué parte del dominio se pretende representar.
Redundancia, escala y contenido del diccionario
Dos diccionarios de igual tamaño pueden tener capacidades muy distintas. En todo el dominio, las funciones contienen solo dos direcciones independientes y ningún dato adicional elimina esa redundancia. Las funciones y , en cambio, son diferentes en el intervalo y solo coincidían en la muestra de tres puntos. La primera situación es una dependencia funcional y la segunda, una falta de información del diseño.
La pseudoinversa da una solución en ambos tipos de problemas algebraicos, con interpretaciones distintas. Con funciones globalmente redundantes, distintos coeficientes pueden describir la misma función. Con direcciones indistinguibles únicamente en la muestra, esas mismas elecciones de coeficientes pueden predecir valores distintos fuera de ella. El criterio de norma mínima decide una representación a partir de la geometría numérica adoptada, sin establecer cuál extrapolación describe el sistema.
Las escalas alteran esa geometría. Si un observable se multiplica por mil, su error pesa un millón de veces más en la pérdida sin ponderar. Cuando cada salida dispone de sus propios coeficientes y la matriz de diseño tiene rango suficiente, un cambio invertible de base conserva el espacio de proyección ideal, aunque afecta al condicionamiento y puede modificar el resultado de una regularización o de una selección basada en valores singulares. Estandarizar requiere precisar qué magnitudes se pretende comparar y estimar las escalas con los datos de entrenamiento.
En el ejemplo uniforme se puede reemplazar el cuadrado por una función proporcional a , ortogonal a la constante y a la coordenada. Tras normalizar las tres funciones se obtiene una matriz de Gram identidad. Esto facilita el cálculo y permite comparar coeficientes sin la correlación entre la constante y el cuadrado, aunque el espacio de funciones sigue siendo exactamente el mismo. La cuarta potencia continúa fuera de él y la proyección conserva el mismo residuo funcional cuando se expresa de nuevo en las variables originales. La ortogonalización corrige una dificultad de representación numérica, mientras que añadir una función independiente cambia la capacidad del modelo; por eso una mejora del número de condición no debe contarse como evidencia de que el diccionario ya está cerrado.
Una regularización cuadrática ilustra el punto. Si al criterio medio anterior se añade , con , la solución es
El parámetro tiene sentido junto con la normalización de la pérdida, porque, si se usa una suma sin dividir por el número de pares, la misma penalización numérica expresa un compromiso diferente. Penalizar todas las entradas puede impedir, además, que la función constante se reproduzca exactamente. Cuando conservarla es una condición del modelo, puede imponerse la fila correspondiente o excluir sus coeficientes de la penalización, ajustando después la solución al problema realmente planteado.
Agregar monomios hace posible representar productos y curvaturas, a costa de exigir a veces grados cada vez mayores. Para el mapa cuadrático, incorporar la cuarta potencia corrige su representación inmediata, pero a continuación aparece la octava. Las funciones localizadas distribuyen el esfuerzo de otra manera, ya que resuelven regiones concretas del dominio y necesitan datos suficientes alrededor de sus centros. Una representación mediante funciones periódicas puede ser adecuada para una fase angular y poco natural para una variable con fronteras no periódicas.
El conocimiento del sistema ayuda a elegir. Si una cantidad se conserva, incluirla aporta una relación temporal contrastable. Si el interés se concentra en una salida observable, hay que asegurar que esa salida pueda recuperarse desde las funciones elegidas. Un diccionario construido para aproximar una energía puede ser útil sin reconstruir cada coordenada del estado. Esa decisión debe figurar en el objetivo de validación, porque la utilidad de un diccionario no se juzga únicamente por cuántas funciones contiene.
También es posible aprender las funciones a partir de datos. Li, Dietrich, Bollt y Kevrekidis (2017) propusieron alternar el ajuste de la matriz con el de un diccionario representado por una red neuronal, con un criterio basado en el residuo de evolución a un paso y en una regularización. Para evitar la solución trivial en que todas las funciones aprendidas son cero, incluyen funciones fijas, entre ellas la constante y las proyecciones de las coordenadas, con las que se reconstruye el estado.
La dificultad puede verse sin una red neuronal. El diccionario compuesto únicamente por la constante admite evolución exacta para cualquier sistema, así que un criterio que premie solo la facilidad de evolución podría preferirlo aunque haya descartado la información que se necesitaba. Incorporar coordenadas o una tarea de reconstrucción fija parte del contenido que debe conservarse. Después sigue siendo necesario comprobar las trayectorias, porque reducir una pérdida a un paso no impone por sí mismo relaciones funcionales exactas entre todas las salidas.
Los métodos basados en núcleos dan otra representación. Williams, Rowley y Kevrekidis (2015b) muestran cómo trabajar con productos internos de funciones definidas implícitamente mediante un núcleo, sin enumerar un diccionario explícito muy grande. La elección se traslada al núcleo y a sus parámetros; un núcleo polinómico y uno gaussiano expresan preferencias distintas sobre las funciones que se pueden representar. El coste puede desplazarse hacia matrices cuyo tamaño depende del número de muestras. Desaparece entonces la enumeración directa de funciones, pero siguen presentes las decisiones sobre rango y regularización.
Lo que permiten afirmar los resultados de convergencia
El crecimiento de la muestra y el del diccionario plantean preguntas distintas. Para un conjunto fijo de funciones, los promedios empíricos pueden converger a los momentos de una medida. Para ello se requieren integrabilidad y un mecanismo de muestreo que justifique esos promedios, por ejemplo muestras independientes o una trayectoria con las propiedades ergódicas pertinentes. Bajo las condiciones de no degeneración empleadas en el resultado, se obtiene la matriz de la proyección correspondiente a ese espacio finito.
Korda y Mezić (2018) estudiaron además una sucesión creciente de diccionarios. En su resultado de convergencia fuerte, el operador actúa de forma acotada sobre el espacio de funciones cuadrado integrables y las funciones se toman de una base ortonormal completa. La aproximación converge al actuar sobre cada observable fijo, lo que da convergencia de predicciones sobre cualquier conjunto finito de horizontes bajo esas hipótesis. La garantía no es uniforme para todos los tiempos ni cubre cualquier crecimiento simultáneo de muestras y funciones.
Las condiciones sobre el espacio tienen consecuencias concretas. En nuestro ejemplo cuadrático se han proyectado funciones polinómicas, cuyos momentos existen. Sin embargo, la composición con el cuadrado no define un operador acotado sobre todo el espacio de funciones cuadrado integrables respecto a la medida uniforme. La función , definida arbitrariamente en cero, tiene cuadrado integrable, mientras que al componerla con el cuadrado de la función resultante deja de ser integrable cerca de cero. Por eso los cálculos polinómicos anteriores no autorizan a aplicar directamente ese teorema a todo aquel espacio.
También la convergencia espectral requiere su propio argumento. En el resultado de Korda y Mezić, la identificación de un límite de autovalores con una función propia exige que el límite débil de las funciones propias normalizadas no sea cero. La convergencia fuerte de operadores no basta para que cada autovalor de cada aproximación finita corresponda a un modo auténtico. Una matriz puede aproximar bien ciertas predicciones y producir candidatos espectrales que necesiten comprobaciones adicionales.
Comprobar una función propia fuera de la matriz
La matriz uniforme del ejemplo tiene un candidato especialmente sencillo,
La relación matricial es exacta. Sin embargo, la función verdadera evoluciona como , de modo que
El mismo residuo que faltaba en el cierre reaparece al comprobar la supuesta función propia, con una norma relativa, respecto a la medida uniforme, igual a
Diagonalizar la matriz con más precisión deja este número intacto. El residuo matricial mide la exactitud del cálculo dentro del espacio proyectado, mientras el residuo funcional examina la relación que se quiere atribuir al sistema.
Colbrook, Ayton y Szőke (2023) desarrollan esta distinción mediante ResDMD. Además de los momentos de funciones presentes y de los productos entre presentes y futuras, utilizan los momentos entre funciones futuras, en los que queda registrada la parte de la evolución que puede haber salido del diccionario. Con nuestra orientación y para un candidato real , definamos
El residuo relativo cuadrático calculado en la muestra es
si el denominador es positivo. También se obtiene evaluando directamente la función en cada par y sumando los residuos cuadrados, pero la matriz adicional hace posible repetir el cálculo para numerosos candidatos sin rehacer toda la operación.
En una muestra interpolada, incluso este residuo puede anularse sin que la relación sea válida en el dominio de interés. La función cuadrado de nuestro ajuste de tres puntos pasa exactamente esa comprobación sobre los mismos tres puntos, aunque su residuo frente al autovalor uno, evaluado uniformemente en el intervalo, tiene cuadrado medio . Separar los datos utilizados para construir o elegir el diccionario de los empleados para comprobarlo deja al descubierto esta confusión.
Un residuo pequeño establece una relación aproximada bajo la medida evaluada. Los resultados de control espectral de ResDMD requieren que la cuadratura o los promedios de datos aproximen los productos internos pertinentes. Su interpretación mediante el pseudoespectro autoriza a hablar de relaciones propias aproximadas, sin convertir cualquier residuo pequeño en prueba de una función propia exacta. Por otra parte, una medida que apenas cubre una región puede asignar poco peso a errores grandes localizados allí.
Normalizar por la magnitud de la función evita otra confusión. Si multiplicamos una función candidata por una constante muy pequeña, su residuo absoluto también se vuelve pequeño sin mejorar la relación dinámica, mientras el cociente de normas permanece igual. En la muestra, el denominador debe además distinguir la función de cero, porque una combinación de observables que casi se anula en todos los estados evaluados puede producir un cociente muy sensible a pequeños errores. Examinar dónde toma valores la función ayuda a interpretar el resultado. Una relación bien comprobada en una región amplia tiene un respaldo diferente de otra sostenida por unos pocos estados con valores extremos, incluso si ambas arrojan el mismo residuo promedio.
Elegir observables para el horizonte que interesa
La validación debe incluir la salida final y el modo concreto de hacer predicciones. Si se promete iterar una matriz durante veinte pasos, se evalúan esas veinte iteraciones desde condiciones iniciales reservadas. Corregir las funciones después de cada paso o reintroducir observaciones intermedias cambia el procedimiento. Ambos usos pueden tener sentido, aunque necesitan resultados separados porque emplean información y restricciones diferentes.
La cercanía a una frontera de estabilidad muestra por qué un error inmediato pequeño puede ser engañoso. Consideremos, como comparación didáctica de dos modelos ya especificados, la dinámica verdadera y una aproximación con coeficiente . Desde , la diferencia en el primer paso es solo . Tras mil pasos, los valores son aproximadamente y ; tras cinco mil la aproximación alcanza , mientras el sistema verdadero se encuentra cerca de .
Estos coeficientes no se presentan como el resultado inevitable de una regresión, ya que con datos exactos suficientes de la relación lineal el ajuste recuperaría el coeficiente correcto. El cálculo muestra qué consecuencias tendría una pequeña discrepancia de estimación, medición o especificación. A su vez, la proyección uniforme del mapa cuadrático mostró el caso complementario, en el que una evolución matricial acotada también puede conducir a un resultado incorrecto.
La propagación puede describirse siguiendo el residuo sobre la trayectoria verdadera. Sea y escribamos , donde es el error de cierre y ajuste en ese estado. Si la predicción comienza con el vector correcto y después itera la matriz, la diferencia tras pasos es
Cada discrepancia entra con una potencia distinta de la matriz, de modo que controlar el error final exige información sobre esas potencias y sobre los residuos en los estados realmente visitados. La pérdida de entrenamiento es un promedio sobre sus propios pares, que puede no describir los estados posteriores. Incluso cuando los autovalores están dentro del círculo unidad, las potencias pueden amplificar temporalmente determinadas direcciones antes de decrecer. La fórmula ayuda a localizar qué función introduce el error y cómo llega a la salida, en lugar de atribuir todo desacuerdo a un único indicador espectral.
Cuando se seleccionan funciones, centros de núcleos o penalizaciones, todas esas decisiones utilizan información. Una división de entrenamiento y prueba pierde su función si las variables se estandarizan con el conjunto completo o si se escoge el diccionario tras consultar repetidamente los errores de prueba. Con series temporales se conserva el orden de disponibilidad; con trayectorias independientes puede reservarse un grupo completo de condiciones iniciales. La división apropiada reproduce el uso posterior y evita que pares casi duplicados den una impresión exagerada de generalización.
Comparar diccionarios exige, además, mantener una tarea común. La suma de errores sobre todas sus funciones deja de ser directamente comparable cuando cambia el número de funciones o sus unidades. Un diccionario puede añadir una cantidad difícil de predecir y aumentar esa suma, mientras mejora la predicción de la coordenada principal; otro puede descartar esa cantidad y aparentar una mejora por haber reducido la tarea. Para escoger entre ellos se fijan una salida, una escala de error y un conjunto de horizontes que permanezcan iguales. Los residuos sobre funciones auxiliares ayudan a explicar el resultado y a detectar errores de cierre, sin reemplazar ese criterio compartido.
También puede compararse la salida con una referencia sencilla, como mantener el último valor o ajustar una evolución lineal sobre las coordenadas, usando los mismos estados reservados y el mismo horizonte. Así se distingue la mejora que aporta el diccionario de una precisión que ya estaba disponible con una representación más pequeña. Si las funciones aprendidas cambian en cada partición de entrenamiento, se comparan sus predicciones sobre esa salida común. Sus coeficientes o modos no tienen por qué admitir una correspondencia directa entre ajustes, especialmente cuando varias funciones apuntan casi a la misma dirección.
Resulta útil registrar por separado el error sobre las funciones y el error sobre la salida de interés. En el ejemplo de tres puntos, evaluar únicamente la coordenada a un paso habría aprobado la predicción desde un medio; en cambio, el error en la función cuadrado habría señalado inmediatamente el problema. Si una salida importante se obtiene mediante un decodificador adicional, su ajuste y su error deben incluirse en la evaluación del procedimiento completo.
Las magnitudes se pueden precisar para esa observación reservada. La matriz de tres puntos comete un error de en el cuadrado futuro, con un error nulo sobre la coordenada futura. La matriz obtenida con momentos uniformes reduce ese error a , también con una predicción exacta de la coordenada en el primer paso. Al segundo paso, ambas discrepancias pasan directamente a la coordenada, porque su actualización utiliza el tercer componente. Este desglose informa de una mejora concreta y de la limitación que permanece, mientras que comparar solo la suma de residuos de entrenamiento habría favorecido el primer ajuste, cuyo cero se debía a la coincidencia especial de funciones en los puntos observados.
La incertidumbre de medición también atraviesa las transformaciones. Si una lectura es , con error condicional de media cero y varianza , entonces . Elevar al cuadrado una lectura introduce, por tanto, un desplazamiento medio aunque el sensor sea insesgado para la coordenada. Incorporar potencias a un diccionario puede amplificar o transformar el error original. Un proceso estocástico del estado y un sensor imperfecto requieren interpretaciones distintas de los pares empleados para ajustar el operador.
Para decidir entre los dos diccionarios del ejemplo bastaría una comprobación diseñada con un estado interior, sin inventar una trayectoria extensa. Se reserva y se mide su siguiente estado, . La matriz de tres puntos devuelve correctamente la coordenada, pero asigna a su cuadrado el valor en lugar de . Si el propósito es iterar la matriz, esa discrepancia ya identifica la entrada que contaminará la siguiente predicción, porque la segunda fila tomará el cuadrado erróneo y devolverá otra vez un cuarto.
Referencias
Colbrook, M. J., Ayton, L. J., & Szőke, M. (2023). Residual dynamic mode decomposition: robust and verified Koopmanism. Journal of Fluid Mechanics, 955, A21. https://doi.org/10.1017/jfm.2022.1052
Klus, S., Koltai, P., & Schütte, C. (2016). On the numerical approximation of the Perron-Frobenius and Koopman operator. Journal of Computational Dynamics, 3(1), 51–79. https://doi.org/10.3934/jcd.2016003
Korda, M., & Mezić, I. (2018). On convergence of extended dynamic mode decomposition to the Koopman operator. Journal of Nonlinear Science, 28, 687–710. https://doi.org/10.1007/s00332-017-9423-0
Li, Q., Dietrich, F., Bollt, E. M., & Kevrekidis, I. G. (2017). Extended dynamic mode decomposition with dictionary learning: A data-driven adaptive spectral decomposition of the Koopman operator. Chaos, 27, 103111. https://doi.org/10.1063/1.4993854
Williams, M. O., Kevrekidis, I. G., & Rowley, C. W. (2015a). A data-driven approximation of the Koopman operator: Extending dynamic mode decomposition. Journal of Nonlinear Science, 25(6), 1307–1346. https://doi.org/10.1007/s00332-015-9258-5
Williams, M. O., Rowley, C. W., & Kevrekidis, I. G. (2015b). A kernel-based method for data-driven Koopman spectral analysis. Journal of Computational Dynamics, 2(2), 247–265. https://doi.org/10.3934/jcd.2015005