Un modelo de reacción puede reproducir las concentraciones medidas y crear materia al prolongar la simulación. También puede conservar la cantidad total y asignar una concentración negativa a una sustancia. Son fallos diferentes, porque el primero afecta al balance y el segundo al dominio admisible de los estados. Corregir uno no asegura haber corregido el otro.
En muchos problemas se conoce bastante sobre esos límites, aunque se desconozca la ley que determina la velocidad del proceso. Se sabe qué sustancias entran y salen de una reacción, pero no cómo cambia su tasa con la temperatura. Se conoce el balance energético de un cuerpo, pero falta una relación fiable para el intercambio con un medio irregular. La parte desconocida puede describirse mediante una red neuronal sin abandonar las ecuaciones que organizan el balance.
Esta combinación tiene una historia anterior a las arquitecturas actuales. Psichogios y Ungar (1992) propusieron un modelo que incorporaba conocimiento del proceso y utilizaba una red para estimar parámetros no observados de un biorreactor. La idea asigna a cada componente una tarea distinta; las ecuaciones conocidas establecen relaciones que se quieren conservar, mientras la función aprendida recoge una dependencia sobre la que deben informar los datos.
Llamaremos híbrido a ese acoplamiento entre estructura mecanística y componentes aprendidos. En teoría de sistemas, «híbrido» también designa modelos con evolución continua y cambios discretos de modo. Ambos usos pueden coincidir en una aplicación, aunque una ecuación que combina un balance con una red no contiene necesariamente conmutaciones ni saltos.
Para examinar estas decisiones usaremos ejemplos analíticos didácticos, cuyos valores numéricos no proceden de un experimento ni describen el rendimiento de una red entrenada. Con ellos seguiremos por separado la representación del proceso, la función que se optimiza y el procedimiento numérico que obtiene las trayectorias. Esas tres elecciones intervienen en el resultado final, incluso cuando el programa las presenta bajo una sola operación de ajuste.
Dónde se coloca la función aprendida
Una escritura habitual del modelo es
Aquí reúne los estados, las entradas externas, los parámetros del componente mecanístico y los de la función aprendida. El término adicional tiene las mismas unidades que una derivada del estado. Si corresponde a una fuente térmica, una transformación química o una fuerza, su interpretación debe ser compatible con la ecuación en la que se inserta.
La suma es solo una de las posibilidades. Una red puede estimar una conductividad que después entra en una ley de flujo, o una tasa que multiplica la cantidad disponible de un reactivo. Esta posición interna restringe los efectos posibles de la red, que dispone de más libertad cuando entrega directamente todas las derivadas que cuando solo modifica una tasa dentro de un balance ya fijado.
El marco de las ecuaciones diferenciales universales de Rackauckas y colaboradores (2020) formaliza esa inserción de aproximadores entrenables en ecuaciones científicas. El término «universal» alude a la capacidad de representación de ciertas familias de funciones y no convierte el aprendizaje en una recuperación garantizada de la ley verdadera. Una función puede pertenecer a la familia representable y seguir sin estar determinada por los registros disponibles.
La ubicación del componente aprendido afecta también a la interpretación de los parámetros conocidos. Consideremos que el exceso de temperatura respecto de un ambiente fijo evoluciona según
Si se estiman a la vez el coeficiente de enfriamiento y un residuo capaz de contener términos lineales, ambos pueden compensarse. Tomando el tiempo en una unidad fijada, el par con produce el mismo campo que con , porque en ambos casos queda .
Ni siquiera observar perfectamente todas las trayectorias de ese campo separaría las dos descomposiciones. Para interpretar el coeficiente como una propiedad física haría falta información adicional, como una medición independiente, una restricción justificada sobre el residuo o un experimento que aporte algo que la compensación no pueda reproducir. La preferencia por residuos pequeños, impuesta mediante una penalización, selecciona una descomposición y debe reconocerse como parte del modelo.
En una ecuación neuronal ordinaria, la red parametriza directamente el campo de velocidades y el estado posterior se obtiene integrando ese campo desde una condición inicial. Chen y colaboradores (2018) desarrollaron este planteamiento junto con métodos para entrenarlo a través de la solución diferencial. La salida inmediata de la red es una derivada; la trayectoria depende además del estado inicial y del método que resuelve la ecuación.
Si las observaciones son , tomadas en tiempos conocidos, puede utilizarse un modelo de medición , donde la función determina qué parte del estado se observa y es el error de medición. Ajustar trayectorias evita tener que estimar previamente cada derivada a partir de datos ruidosos, a cambio de introducir una integración dentro de la optimización. La incertidumbre del estado inicial o de la observación sigue formando parte del problema.
La elección del estado supone que este contiene la información necesaria para determinar la evolución bajo las entradas especificadas. Una concentración aislada puede tener velocidades diferentes según una temperatura que no se registra. En ese caso, una ecuación autónoma para la concentración carece de información suficiente para asignar una única derivada a cada valor observado; aumentar el tamaño de la red no incorpora automáticamente la temperatura que falta.
Se puede ampliar el estado, introducir la temperatura como entrada cuando se mide o incluir estados latentes cuya evolución también se ajuste. Cada opción modifica el problema. Una variable latente puede ayudar a predecir, si bien su interpretación física requiere observaciones independientes. Añadir el tiempo como entrada distingue momentos de un registro, pero una dependencia del calendario aprendida durante ese registro podría fallar si el mismo proceso comienza en otro momento o recibe una perturbación distinta.
La elección se evalúa con trayectorias que obliguen al modelo a distinguir esas situaciones. Si dos registros alcanzan la misma concentración bajo temperaturas diferentes, sus velocidades informan sobre la insuficiencia del estado reducido y la discrepancia deja de parecer un simple error aleatorio alrededor de una única función.
Una red informada por ecuaciones físicas puede ocupar otra posición. En la formulación continua de Raissi, Perdikaris y Karniadakis (2019), la red aproxima la solución en función de las coordenadas; sus derivadas permiten calcular el residuo de la ecuación. El entrenamiento combina discrepancias con datos y residuos evaluados en puntos seleccionados. Allí se aprende una representación de la solución, mientras que en una ecuación neuronal se aprende el campo que un integrador debe recorrer.
Las dos construcciones admiten combinaciones, como un modelo que aproxima una trayectoria y aprende al mismo tiempo una ley constitutiva desconocida dentro de su residuo. Para saber qué se está identificando hay que escribir explícitamente qué produce cada red, porque dos programas que utilizan la misma etiqueta pueden estar resolviendo problemas inversos distintos.
También pueden combinarse condiciones exactas y términos penalizados dentro de un mismo ajuste. Si una red aproxima una trayectoria temporal y se conoce exactamente su valor inicial, la parametrización cumple para cualquier elección de parámetros. El entrenamiento puede seguir penalizando el residuo de la ecuación en otros tiempos, con lo que la condición inicial y la dinámica reciben tratamientos diferentes.
Esa parametrización no conserva automáticamente una cantidad total ni asegura positividad. Tampoco sería apropiado fijar el valor inicial como exacto si procede de una medición incierta. En ese caso podría estimarse junto con la trayectoria mediante el modelo de observación. Una restricción útil se define por la información que incorpora; imponer más igualdades no siempre describe mejor lo que se sabe.
Al examinar un resultado hay que separar el error sobre las observaciones, el residuo diferencial y el incumplimiento de condiciones iniciales o de frontera, ya que una pérdida total pequeña puede ocultar que uno de esos componentes sigue siendo grande en su escala relevante.
Penalizar o imponer una igualdad
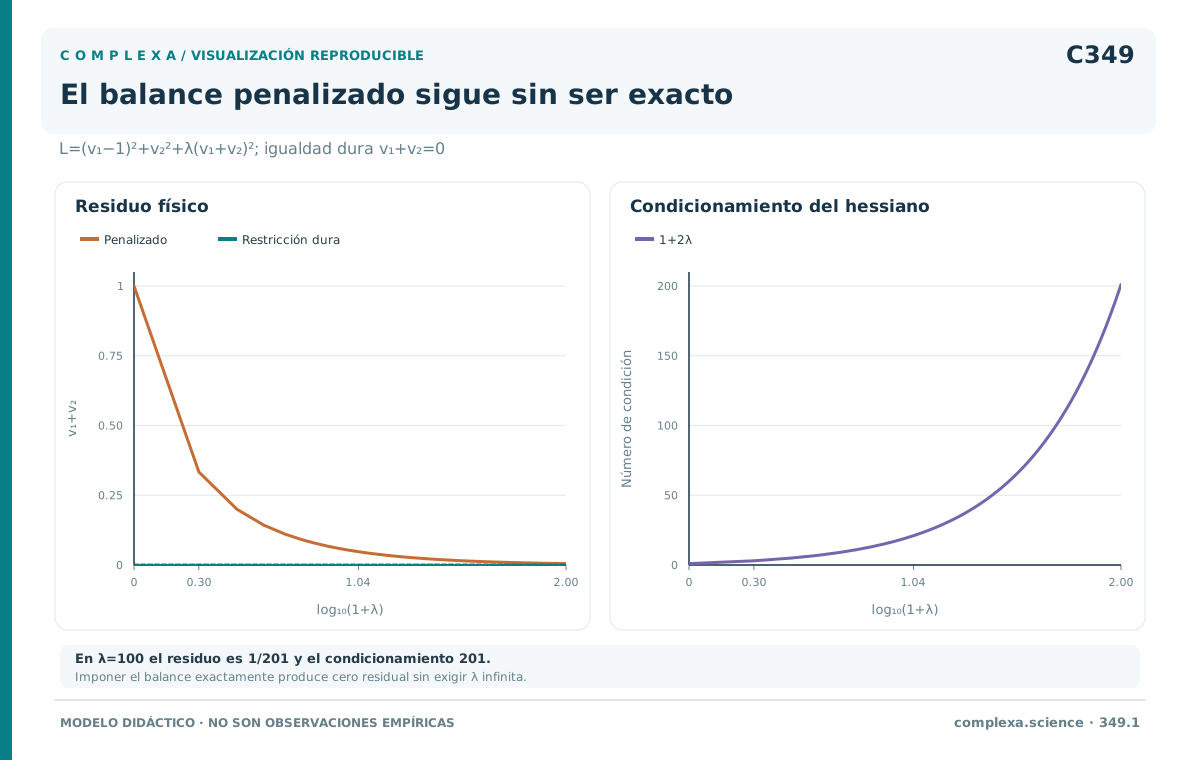
Supongamos que un ajuste local propone dos componentes de velocidad próximas a uno y cero, mientras el balance exige que sumen cero. Utilizaremos cantidades adimensionales para aislar el efecto de la penalización. La función objetivo es
Los dos primeros términos buscan aproximar el valor propuesto por los datos y el tercero penaliza la violación del balance. Al igualar a cero las derivadas del objetivo se obtiene
La solución es única porque la función es estrictamente convexa. Sin embargo, la suma no se anula para ningún peso finito. En este ejemplo el optimizador puede trabajar perfectamente y devolver, de forma correcta, una solución que incumple la igualdad.
| Peso de la penalización | Primera componente | Segunda componente | Residuo del balance |
|---|---|---|---|
| 0 | |||
| 1 | |||
| 10 | |||
| 100 |
Si la igualdad se impone como restricción exacta, la búsqueda se limita a la recta , sobre la cual el mejor ajuste es , . La suma vale cero por construcción, sin depender de que el algoritmo haya decidido intercambiar una pequeña violación física por una mejora del ajuste.
Aumentar mucho el peso aproxima la solución restringida en este problema, pero cambia la geometría de la optimización. Los autovalores de su matriz hessiana son dos y dos más cuatro veces el peso; su cociente es uno más dos veces el peso y alcanza doscientos uno con el mayor valor de la tabla. La dirección que cambia la suma se vuelve mucho más rígida que la que conserva el balance.
Esa diferencia de escalas puede dificultar el avance de un método de optimización. No toda penalización grande fracasa, ya que aquí todavía podría resolverse el sistema exactamente. Aun así, aumentar un coeficiente tiene consecuencias propias y difiere de formular la restricción que se pretende cumplir.
En problemas físicos, los pesos incluyen además una elección de escala. Un error de concentración al cuadrado y un residuo de velocidad al cuadrado tienen unidades distintas, así que antes de sumarlos hay que normalizarlos o introducir factores con las unidades correspondientes. Cambiar de segundos a horas sin transformar esos factores puede modificar la importancia relativa de los términos, aunque el proceso observado siga siendo el mismo.
Las penalizaciones son útiles cuando la relación se considera aproximada o cuando se desea tolerar discrepancias controladas. Si un balance omite una entrada pequeña pero real, imponer conservación cerrada de manera exacta puede obligar al resto del modelo a compensar una hipótesis incorrecta. La elección entre igualdad y penalización depende de qué conocimiento se tiene sobre el sistema y de qué magnitud se tolera incumplir.
También importa dónde se mide el residuo. Un valor pequeño en los puntos usados para entrenar no da por sí solo una cota entre ellos, ya que puede haber regiones poco cubiertas donde la solución aproximada cambie rápidamente. Evaluar el residuo en puntos nuevos comprueba una propiedad diferente de la que se obtiene al volver a calcular la pérdida sobre los puntos originales.
El efecto acumulado requiere otra comprobación. Si el total que debía conservarse es y el campo aprendido produce , su cambio durante la simulación es la integral del residuo. Una cota uniforme , válida a lo largo de toda la trayectoria, implica , con lo que la duración entra explícitamente en el error posible.
Por ejemplo, un residuo constante de una centésima de unidad de concentración por hora genera una décima de cambio en diez horas. Una cifra local pequeña puede así tener un efecto acumulado que importe para el balance. En otras trayectorias, residuos de signos opuestos podrían compensarse, aunque esa compensación tendría que comprobarse mediante el cálculo.
La cota uniforme del ejemplo es información más fuerte que una media cuadrática pequeña en unos puntos de entrenamiento; para utilizarla habría que justificar su validez en los estados que recorre la solución. Por esta diferencia, vigilar el balance durante una simulación larga aporta información que la pérdida final de entrenamiento no resume.
Construir balances mediante flujos
Consideremos tres sustancias que se transforman en cadena, A en B y B en C, dentro de un recipiente cerrado de volumen constante. Supondremos una estequiometría de una unidad por unidad. Las concentraciones se expresan en una misma escala molar, de manera que su suma es la cantidad conservada por unidad de volumen. Este balance concreto no se aplicaría sin cambios a una reacción con otros coeficientes estequiométricos.
Si y son las velocidades de las dos transformaciones, las ecuaciones tienen la forma
Al sumarlas, cada flujo aparece una vez con signo positivo y otra con signo negativo, por lo que la derivada del total es cero para cualquier valor de los flujos. Una red puede cambiar cuánto se transforma por unidad de tiempo, pero la estructura impide que ese cambio cree concentración total.
Esta propiedad puede conservarse durante el aprendizaje sin añadir una penalización del balance; en notación matricial, las columnas de la matriz que convierte flujos en derivadas suman cero. Aprender los flujos dentro de esa estructura reduce, en virtud de una hipótesis física explícita, las funciones que el modelo puede expresar.
Conservar la suma todavía admite flujos que conduzcan fuera del dominio de concentraciones no negativas. Para evitarlo en el sistema continuo podemos escribir y , con tasas aprendidas no negativas que se obtienen mediante una transformación positiva de la salida de la red; una escala de referencia les asigna unidades de tiempo inverso.
Cuando A se agota, su flujo saliente se anula; cuando B vale cero, solo puede recibir el flujo procedente de A, mientras C recibe siempre un flujo no negativo. Bajo regularidad suficiente para que exista una solución única, el campo respeta las fronteras del dominio admisible. La prueba utiliza los signos de las derivadas en esas fronteras, sin depender de que los datos de entrenamiento hayan incluido exactamente un estado de agotamiento.
Podría intentarse otro procedimiento, que consiste en aprender un campo libre y proyectarlo sobre el plano de suma cero. Esa proyección garantiza el balance, pero deja sin controlar la dirección del campo en las fronteras. En el estado adimensional , consideremos el campo propuesto . Restar a cada componente la media de sus componentes lo transforma en
La suma es cero y, sin embargo, la primera concentración, que ya estaba en cero, tiene una derivada negativa. Si ese campo se aplica allí, la trayectoria abandona inmediatamente el dominio físico, lo que muestra que proyectar una igualdad y garantizar una desigualdad son problemas diferentes.
La estructura de flujos también puede ser incorrecta. Si la sustancia A entra desde fuera, la suma debe aumentar de acuerdo con esa entrada. Si una especie no observada almacena parte de la materia, conservar solo la suma de las especies medidas puede ser una restricción falsa. Antes de atribuir un residuo a la red hay que precisar qué atraviesa la frontera del sistema modelado.
Una restricción puede servir, por tanto, como compromiso contrastable. Si ninguna elección razonable de tasas reproduce los registros dentro del error de medición, habrá que revisar las observaciones, las entradas conocidas o la estructura de reacción. Una arquitectura restringida vuelve visibles ciertos desacuerdos, aunque no basta para decidir cuál de esas explicaciones es la correcta.
Cantidades conservadas y coordenadas
Las redes hamiltonianas de Greydanus, Dzamba y Yosinski (2019) son otro ejemplo de estructura impuesta. Aprenden una función escalar y definen el campo mediante una matriz antisimétrica ,
Esta escritura corresponde, en coordenadas canónicas, a las ecuaciones de Hamilton y, para una función sin dependencia explícita del tiempo, da
La identidad vale porque una forma cuadrática construida con una matriz antisimétrica se anula. El campo continuo conserva la cantidad aprendida aunque sus parámetros todavía no reproduzcan bien los datos, mientras el entrenamiento elige cuál de esos campos estructurados se aproxima a las observaciones.
Esa identidad no garantiza que la función aprendida sea la energía física verdadera. Añadir una constante a deja intactas sus derivadas y, por tanto, el campo. Multiplicarla por una constante, en cambio, modifica la velocidad del movimiento cuando las coordenadas y la unidad de tiempo están fijadas. La indeterminación aditiva no debe confundirse con libertad para alterar la escala temporal.
Las coordenadas también importan, porque una transformación arbitraria de las variables observadas no conserva necesariamente la matriz canónica. Si una red infiere estados latentes a partir de imágenes, la relación entre esos estados y las variables mecánicas forma parte del aprendizaje. Que una trayectoria latente conserve alguna función no basta para identificarla como energía medida en unidades físicas.
La restricción hamiltoniana descrita corresponde a un sistema autónomo con una cantidad conservada, mientras que una disipación real requiere términos que den cuenta de la pérdida correspondiente. Agregar una componente disipativa puede producir un modelo híbrido más apropiado, siempre que su signo y su efecto sobre la energía se formulen.
Incluso con el campo correctamente estructurado, una trayectoria calculada paso a paso puede presentar errores en la cantidad conservada, porque la identidad diferencial atañe a la solución continua. Un integrador debe evaluarse por las propiedades que conserva en su actualización discreta. Algunas identidades lineales se mantienen con facilidad, mientras que una energía no lineal exige un análisis diferente.
El integrador también interviene en el ajuste
Tomemos ahora una construcción escalar con solución conocida,
El parámetro verdadero del ejemplo es menos uno por unidad de tiempo; la única observación posterior se toma en el tiempo uno y vale , aproximadamente , sin ruido añadido. Si se usa la solución analítica, ese dato identifica el parámetro dentro de esta familia real.
Supongamos que el ajuste utiliza Euler explícito con un solo paso hasta la observación. La predicción de ese paso es . Para reproducir el dato exactamente, el ajuste elegirá , aproximadamente menos . La pérdida numérica es cero y, sin embargo, el parámetro difiere del que generó el dato.
Si después se integra con precisión la ecuación que contiene ese parámetro aprendido, la predicción en el tiempo uno pasa a ser aproximadamente . El ajuste anterior había compensado el error del integrador y un procedimiento más preciso revela esa compensación sin alterar la observación original.
Con pasos iguales de Euler y un factor positivo en cada paso, el valor ajustado satisface
La condición sobre el factor excluye las ramas de signo alternante que podrían reproducir el extremo con un número par de pasos. Así se mantiene una aproximación de decaimiento positivo, coherente con la solución que se pretende describir.
| Pasos de Euler hasta el tiempo uno | Parámetro ajustado | Extremo al integrar exactamente el parámetro ajustado |
|---|---|---|
| 1 | ||
| 2 | ||
| 4 | ||
| 10 |
Aunque todos esos valores reproducen la observación con su correspondiente cálculo de Euler, el parámetro solo se aproxima a menos uno a medida que se reduce el paso. El ejemplo separa el error de ajuste del error en la ecuación inferida. Una cifra pequeña para el primero puede ocultar el segundo.
En una ecuación neuronal, la función aprendida dispone de muchas más formas de compensación, ya que puede modificar localmente el campo para que un integrador concreto atraviese los puntos observados. Por eso la evaluación incluye volver a integrar el modelo fijado con tolerancias más estrictas o con otro método apropiado, para comprobar si la predicción depende del campo aprendido o de detalles del procedimiento utilizado al entrenarlo.
La tolerancia de un integrador adaptativo no es una medida de incertidumbre científica. Controla errores numéricos según sus estimadores y criterios, pero una tolerancia pequeña no indica si la familia de ecuaciones es correcta o si el ruido de observación se ha modelado bien. Su función es reducir una fuente concreta de error para examinar las restantes.
Qué gradiente se está calculando
El entrenamiento requiere saber cómo cambia la pérdida cuando varía un parámetro. Puede diferenciarse la secuencia de operaciones del integrador, o bien derivarse primero una ecuación continua para las sensibilidades y discretizarla después. La correspondencia entre ambas rutas depende de la discretización y de su precisión. El análisis de Gholami, Keutzer y Biros (2019) muestra problemas de consistencia y reconstrucción en determinadas implementaciones de ecuaciones neuronales.
Para precisar el cálculo continuo, consideremos un campo diferenciable y una pérdida que depende solo del estado final, , con estado inicial independiente de los parámetros. El vector adjunto indica cuánto cambia esa pérdida ante una pequeña perturbación del estado en cada tiempo. Su condición final es el gradiente de la pérdida respecto del estado final y se propaga mediante
Las matrices y contienen las derivadas del campo respecto del estado y de los parámetros. El producto dentro de la integral reúne cuánto cambia localmente la velocidad al variar un parámetro con cuánto importa ese cambio para la pérdida final. El adjunto acumula esa contribución sin integrar una trayectoria de sensibilidad independiente por cada parámetro.
Si la pérdida incluye observaciones intermedias, sus contribuciones se incorporan en los tiempos correspondientes. Si el estado inicial también se aprende, aparece una contribución adicional desde la condición inicial. Omitir esas dependencias produciría el gradiente de otro objetivo, por precisa que fuera numéricamente la integración del adjunto.
El ejemplo escalar basta para distinguir los objetivos sin recurrir a una red grande. Utilicemos la mitad del error cuadrático en el extremo y evaluemos el gradiente en el parámetro verdadero, menos uno. Para la solución continua, el extremo coincide con el dato y el gradiente es cero. Para dos pasos de Euler, el extremo vale un cuarto y su derivada respecto del parámetro vale un medio, de modo que el gradiente del objetivo discreto es
Ambas derivadas son correctas para sus respectivos objetivos y el conflicto aparece si se utiliza una como si fuera la otra sin controlar el error de aproximación. Una comprobación por diferencias finitas del programa discreto recupera el segundo valor sin necesidad de conocer de antemano la ecuación adjunta.
El método adjunto continuo propaga hacia atrás la sensibilidad de la pérdida respecto del estado y acumula la contribución de los parámetros. Es una herramienta para calcular derivadas y no decide si los parámetros son identificables. Si la pérdida apenas cambia en una dirección de parámetros, un gradiente calculado con gran precisión seguirá reflejando esa escasa información.
Algunas implementaciones reconstruyen hacia atrás estados de la trayectoria para reducir la memoria utilizada durante el entrenamiento. Chen y colaboradores (2018) describen esa estrategia y su relación con el coste de almacenar pasos intermedios. El ahorro atañe a esos estados almacenados, sin eliminar el coste de representar la red ni garantizar una reconstrucción numéricamente estable.
Consideremos . Reconstruir el estado inicial a partir del final multiplica por , así que, si el producto de tasa y duración vale veinte, un error absoluto de en el extremo se amplifica hasta aproximadamente en el inicio. La solución matemática es reversible en este intervalo, pero el cálculo inverso amplifica errores.
Guardar estados intermedios y recalcular segmentos desde ellos evita depender exclusivamente de una larga reconstrucción hacia atrás, a costa de un intercambio entre memoria y cálculo. La elección adecuada depende de la dinámica, de la duración y de las escalas que el integrador necesita resolver.
Restricciones, información e incertidumbre
Una arquitectura física reduce el conjunto de explicaciones posibles. Si todas las trayectorias admisibles conservan una suma, quedan excluidas las que la modifican sin una entrada declarada, aunque muchas distribuciones internas de flujos pueden respetar ese balance. La conservación informa sobre qué movimientos son posibles; los registros deben informar sobre cuáles de ellos ocurren y a qué velocidad.
La distinción se vuelve visible al comparar una trayectoria observada con el resto del espacio de estados. Durante el ajuste, la pérdida recibe información principalmente de los estados visitados y de su entorno numérico, de forma que dos campos pueden coincidir allí y diferir lejos de ese recorrido. Las restricciones comunes limitan esas diferencias sin eliminarlas necesariamente.
Que un conjunto de redes produzca predicciones parecidas no garantiza que la incertidumbre sea pequeña. Todas pueden compartir una arquitectura que excluya la alternativa relevante, las mismas entradas omitidas o una región de entrenamiento insuficiente. La dispersión entre entrenamientos describe variación dentro del procedimiento utilizado y, para interpretarla como probabilidad de error, hacen falta un modelo de incertidumbre y una evaluación de su comportamiento.
La incertidumbre sobre los parámetros es distinta de la asociada a la estructura, a los estados iniciales y a las observaciones. Un intervalo condicionado a una reacción concreta no cubre automáticamente la posibilidad de que exista otra vía química, igual que un modelo de ruido de medición no incluye por sí solo las fluctuaciones intrínsecas de la dinámica. Estas decisiones determinan qué variabilidad puede expresar la distribución predictiva.
Las pruebas con condiciones iniciales nuevas o entradas externas distintas son especialmente informativas cuando las alternativas coincidían en el régimen observado. Deben conservar la misma información disponible para todos los candidatos, porque un modelo que recibe una variable adicional no puede atribuir toda su mejora a una restricción física más acertada.
La extrapolación también tiene varias direcciones. Prolongar una trayectoria dentro de un dominio ya recorrido difiere de aumentar una entrada hasta una región nunca observada. Una ley de conservación puede seguir siendo válida en ambas situaciones, mientras una tasa aprendida cambia de forma imprevisible en la segunda.
Una concentración negativa al final de un paso
Volvamos a la reacción cerrada para completar la separación entre estructura y cálculo. Fijemos tasas constantes de dos y uno por hora para las transformaciones de A y B, respectivamente, con concentraciones iniciales de uno, dos décimas y tres décimas en la unidad molar elegida. El total vale una unidad y media y el caso pertenece a la arquitectura de flujos positivos.
En ese estado, las derivadas son y . Un paso de Euler de seis décimas de hora produce las concentraciones y , cuya suma sigue siendo una unidad y media. El balance se ha conservado y, pese a ello, A resulta negativa.
La solución continua de este caso se obtiene analíticamente. Al mismo tiempo final, las concentraciones son aproximadamente y , todas positivas y con el mismo total. La discrepancia procede del paso numérico, que sustrae de A más cantidad de la que tiene disponible.
Para estas tasas constantes, la actualización de A multiplica su concentración por uno menos dos veces el paso medido en horas. La de B combina su cantidad anterior, multiplicada por uno menos el paso, con la cantidad recibida desde A. Un paso de hasta media hora mantiene no negativos ambos coeficientes y, con ello, las concentraciones cuando el estado anterior era admisible. El paso de seis décimas excede ese límite. Esta condición pertenece al esquema y a las tasas concretas, sin extenderse como garantía general a cualquier flujo aprendido.
Si se utilizan dos pasos de tres décimas de hora, se obtienen y . Seis pasos de una décima dan y . La positividad se recupera en ambos cálculos, aunque el primero todavía se aleja de forma apreciable de la solución exacta.
La revisión de este resultado puede hacerse sin cambiar las tasas ni volver a entrenar un modelo. Se conserva la ecuación, se reduce el paso y se compara con la solución analítica, con lo que la concentración negativa desaparece y el error disminuye. La corrección afecta al procedimiento que recorría el campo, mientras el balance de la reacción y las tasas que lo definían permanecen fijados durante la comprobación.
Referencias
Chen, R. T. Q., Rubanova, Y., Bettencourt, J., & Duvenaud, D. K. (2018). Neural ordinary differential equations. Advances in Neural Information Processing Systems, 31. https://papers.nips.cc/paper/2018/hash/69386f6bb1dfed68692a24c8686939b9-Abstract.html
Gholami, A., Keutzer, K., & Biros, G. (2019). ANODE: Unconditionally accurate memory-efficient gradients for neural ODEs. En Proceedings of the Twenty-Eighth International Joint Conference on Artificial Intelligence (pp. 730–736). https://doi.org/10.24963/ijcai.2019/103
Greydanus, S., Dzamba, M., & Yosinski, J. (2019). Hamiltonian neural networks. Advances in Neural Information Processing Systems, 32. https://papers.nips.cc/paper_files/paper/2019/hash/26cd8ecadce0d4efd6cc8a8725cbd1f8-Abstract.html
Psichogios, D. C., & Ungar, L. H. (1992). A hybrid neural network-first principles approach to process modeling. AIChE Journal, 38(10), 1499–1511. https://doi.org/10.1002/aic.690381003
Rackauckas, C., Ma, Y., Martensen, J., Warner, C., Zubov, K., Supekar, R., Skinner, D., Ramadhan, A., & Edelman, A. (2020). Universal differential equations for scientific machine learning [Prepublicación, versión 1]. Research Square. https://doi.org/10.21203/rs.3.rs-55125/v1
Raissi, M., Perdikaris, P., & Karniadakis, G. E. (2019). Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations. Journal of Computational Physics, 378, 686–707. https://doi.org/10.1016/j.jcp.2018.10.045