Dos analistas reciben cinco lecturas de una señal que disminuye con el tiempo, ajustan la misma ecuación exponencial y obtienen tasas diferentes. Ninguno ha cometido un error de programación. El primero minimiza las distancias entre las lecturas y la curva en la escala original. El segundo transforma las lecturas mediante logaritmos antes de ajustar. Aunque ambos describan su trabajo como «ajustar una exponencial», han resuelto problemas de estimación distintos.
Calibrar un modelo es determinar valores de sus parámetros para que concuerde con unas observaciones según un criterio especificado. Ese criterio, que decide qué discrepancias pesan más y qué información se atribuye a cada observación, forma parte del problema científico. En el resultado intervienen además la ecuación que relaciona los estados con las mediciones, los parámetros que permanecen fijos y las restricciones del procedimiento, de modo que un vector de números sin esas condiciones describe la calibración de manera incompleta.
Lo que se espera de los parámetros cambia de una investigación a otra. A veces se buscan valores que predigan una salida en un intervalo concreto. Otras veces se quiere estimar una propiedad física, como una tasa de eliminación, para compararla entre condiciones. Una combinación que predice bien puede compensar errores del modelo y ser inadecuada para esta segunda tarea, por lo que antes de interpretar el número hay que establecer qué propiedad se supone que representa y qué observaciones podrían comprobarlo.
Del estado del sistema a la lectura del instrumento
Trabajaremos con una señal enteramente ficticia, medida cada minuto en unidades arbitrarias. Supondremos en principio que procede de un estado que satisface con condición inicial , donde el parámetro , positivo, tiene las unidades de la señal y se mide en minutos inversos. La solución es . En esta primera formulación la lectura esperada coincide con el estado, es decir, .
Esa última igualdad contiene una hipótesis de observación. Cuando el instrumento amplifica la señal, le añade un fondo o registra una combinación de estados, la salida que debe compararse con los datos cambia. Si la conversión de estado a lectura está mal especificada, el modelo completo es erróneo aunque sus ecuaciones internas estén bien estimadas. En modelos con variables no observadas, separar ambas partes evita que un parámetro dinámico absorba una discrepancia procedente del instrumento.
Las cinco lecturas de la tabla, construidas para el ejercicio, forman el conjunto de calibración. El tiempo se considera conocido sin error y durante el ajuste inicial no se usará ninguna otra observación.
| Tiempo, minutos | Señal observada |
|---|---|
| 0 | 11,0 |
| 1 | 7,1 |
| 2 | 4,6 |
| 3 | 3,4 |
| 4 | 2,3 |
Los parámetros se buscarán dentro de y , límites didácticos explícitos, no deducidos de ningún experimento real y lo bastante amplios para los resultados que se comparan. Declarar el dominio deja claro qué soluciones admite el procedimiento. Si se estrecha hasta excluir valores plausibles, la estimación queda condicionada por esa decisión.
La condición inicial merece atención porque también se estima. La lectura en tiempo cero es once, pero no imponemos , pues esa lectura puede contener error como las demás. Fijar A a partir de ella equivaldría a tratar una observación particular como exacta. En otros problemas la condición inicial se conoce por diseño y está justificado fijarla, decisión que cambia la información disponible para estimar la tasa.
Algo semejante ocurre cuando se resta de todas las lecturas una referencia estimada. Un error común en la referencia se transmite a cada dato corregido y crea dependencia entre ellos. La resta simplifica la ecuación de observación, aunque el valor restado conserva la incertidumbre con que se estimó, que puede mantenerse mediante un parámetro de referencia o incorporarse a la covarianza de las lecturas. El tratamiento elegido tiene que corresponder a la manera en que se obtuvo la referencia, sobre todo cuando se comparan señales pequeñas con un fondo de magnitud semejante.
En un modelo más general, la dinámica se escribiría y la observación , donde representa entradas conocidas y reúne los parámetros desconocidos. Toda calibración debe declarar ambas funciones junto con las condiciones iniciales y las entradas utilizadas. El protocolo de Villaverde y colaboradores (2022) ordena estas decisiones antes de la optimización, porque la función que se ajusta depende de toda esa especificación.
Si el experimento se repite con distintas cantidades iniciales, puede plantearse una tasa k compartida y una amplitud A propia de cada ensayo, especificación que afirma que la cantidad inicial cambia mientras la dinámica de pérdida se conserva. Ajustar una tasa independiente en cada ensayo suprime esa restricción y puede mejorar la concordancia, a costa de dejar sin comprobar la constancia postulada. Los parámetros comunes y las cantidades que el propio diseño deja variar tienen que distinguirse, por tanto, antes de reunir los datos.
Elegir qué significa una discrepancia pequeña
Definido el residuo de la observación como , los mínimos cuadrados ordinarios buscan el parámetro que minimiza . Un residuo de dos unidades contribuye cuatro veces más que uno de una unidad y los errores positivos y negativos reciben el mismo tratamiento. Puede ser una elección razonable, siempre que se haga explícito el modelo de medición que la respalda.
Si los errores son independientes y normales, con media cero y desviación típica conocida , el negativo del logaritmo de la verosimilitud es
Cuando todas las desviaciones son iguales y no dependen de los parámetros, minimizar esta expresión equivale a minimizar Q. Si son distintas, se llega a mínimos cuadrados ponderados, con peso para cada observación. Ambas equivalencias descansan en las hipótesis sobre el error y solo bajo ellas una suma de cuadrados es una verosimilitud apropiada.
Con errores correlacionados, la forma cuadrática es , con la matriz de covarianzas, supuesta invertible. Dos mediciones próximas pueden contener información en parte compartida. Tratarlas como réplicas independientes altera la incertidumbre atribuida al ajuste y puede cambiar su peso efectivo, por lo que una fuente de correlación debe incorporarse al modelo de observación cuando afecte a la inferencia que se pretende realizar.
Los términos de normalización tampoco pueden eliminarse siempre. Si se estima la desviación del error, o esta depende de la señal predicha, los logaritmos de las varianzas cambian con los parámetros. Un criterio que conservara únicamente los residuos divididos por una varianza ajustable podría reducirse de forma artificial aumentando esa varianza. En el modelo normal, el término logarítmico es el que hace costoso declarar errores enormes.
La pérdida puede elegirse también con una finalidad distinta de describir probabilidades de medición. Quien penaliza mucho más las subestimaciones que las sobreestimaciones, porque sus consecuencias son diferentes, está definiendo una función de coste. Es una decisión legítima en una tarea de predicción o de control. El parámetro resultante optimiza ese coste y debería presentarse como tal, separado de la estimación que daría un modelo de error simétrico.
Existen además pérdidas menos sensibles a los residuos extremos, cuyo uso exige decidir qué se considera una desviación excepcional y por qué. Una lectura discordante puede deberse a un fallo del instrumento o a una condición experimental omitida, o indicar que la dinámica propuesta es insuficiente. Reducir su peso antes de investigar esas posibilidades puede ocultar justamente la observación que distingue entre explicaciones.
Los dos ajustes de la misma exponencial
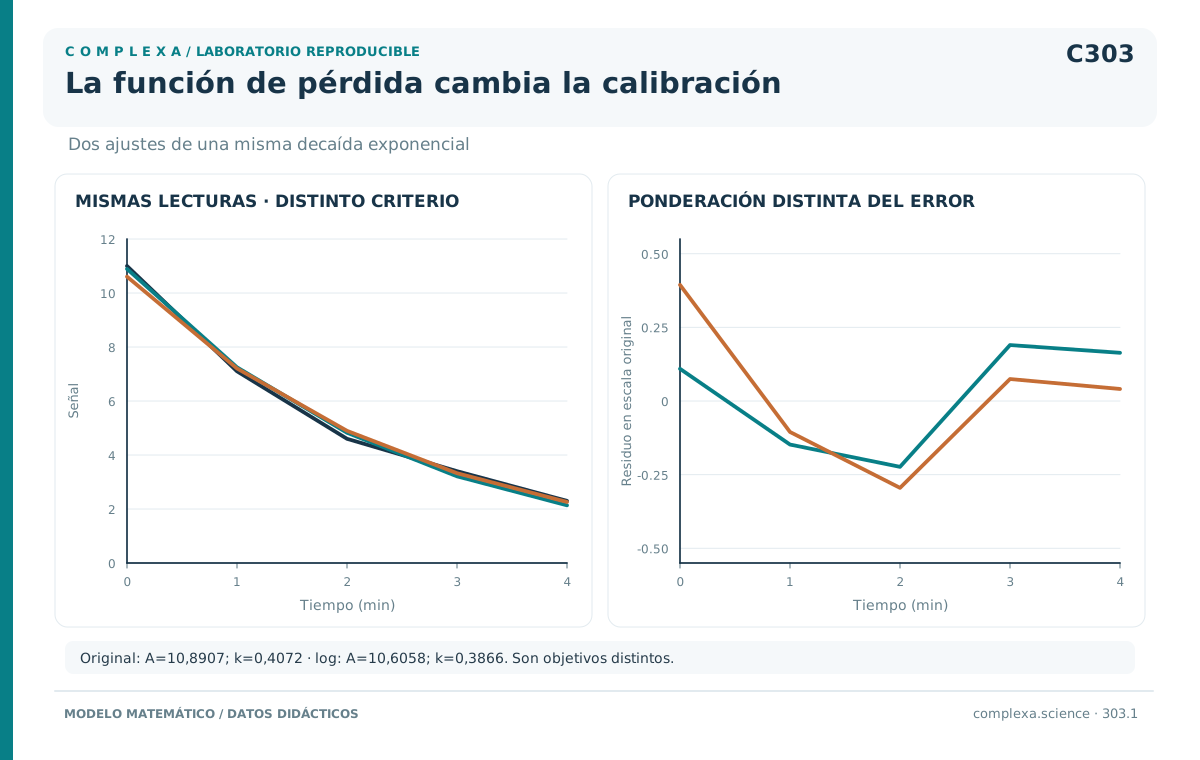
La minimización de los cuadrados en la escala original, con las cinco lecturas, da aproximadamente y , con una suma de cuadrados residual de 0,1466 unidades de señal al cuadrado. Las predicciones en los tiempos cero a cuatro son, respectivamente, 10,8907; 7,2478; 4,8235; 3,2101 y 2,1363. La curva sigue de cerca las cinco observaciones, aunque ninguna regla la obliga a pasar exactamente por una de ellas.
El otro analista minimiza
Como todos los datos son positivos, la transformación está definida y el problema es una regresión lineal de sobre el tiempo, con intercepto y pendiente . El resultado es y . En la escala original su suma de cuadrados vale 0,2605, más que la del primer ajuste, como era de esperar en un procedimiento que no minimizaba esa cantidad.
Para discrepancias pequeñas, es aproximadamente , así que el ajuste en logaritmos da más peso a los errores relativos. Una desviación de media unidad sobre una señal de dos unidades pesa más que la misma desviación sobre una señal de diez, mientras que en la escala original, con pesos iguales, ambas contribuyen lo mismo a Q. De ese reparto del peso procede la diferencia entre las tasas estimadas.
El segundo criterio es compatible con el modelo probabilístico , en el que los son normales independientes con media cero y varianza constante . Bajo ese modelo, f es la mediana condicional de la lectura. La media es . Por eso, deshecho el logaritmo, la curva ajustada sigue siendo en la escala original una estimación de la mediana. Usarla para predecir la media exige incluir ese factor.
Los ceros y las lecturas negativas, posibles cuando se resta un fondo o hay ruido instrumental, requieren otro tratamiento. Sumar una constante para poder tomar logaritmos cambia la transformación junto con el peso relativo de los errores, de modo que la tasa estimada puede depender de la constante elegida. Cuando hay censura por un límite de detección, la observación informa de un intervalo o evento de detección. Reemplazarla por un número arbitrario introduce una información que el instrumento no dio.
El protocolo de Villaverde y colaboradores (2022) distingue precisamente entre errores normales, lognormales y otras distribuciones de observación. La elección entre ellas depende de cómo se producen los datos. Que una curva parezca más recta después de una transformación ayuda a describirla, pero es un indicio débil sobre el modelo adecuado del ruido.
Las unidades no deberían decidir los parámetros
En un segundo ejemplo didáctico, muy pequeño, un parámetro adimensional determina dos salidas mediante y . Se observan y , con desviación típica uno en la unidad original de cada canal. La suma de cuadrados estandarizada, , alcanza su mínimo en .
Si el segundo canal pasa a registrarse en una unidad mil veces menor, su lectura se escribe 4000 y su predicción . Al sumar los residuos brutos sin modificar los pesos, el criterio se convierte en , cuyo mínimo se aproxima a 1,99999975. Ninguna medición física ha cambiado. El procedimiento ha concedido al segundo canal un peso mucho mayor solo por su representación numérica.
La desviación típica del segundo canal también debe expresarse en la nueva unidad, en la que vale mil. Al dividir su residuo por mil se recupera exactamente el criterio original y la estimación 1,8. Esa invariancia sirve para detectar errores de implementación, dado que una conversión de unidades coherente transforma a la vez observaciones, predicciones, incertidumbres y límites de parámetros relacionados con esas unidades.
Con la señal exponencial puede examinarse una ponderación alternativa sin cambiar de unidades. Supongamos ahora, como hipótesis didáctica distinta sobre la precisión de las lecturas, que las desviaciones conocidas fueran 1, 1, 0,3, 0,3 y 0,3 en los cinco tiempos. El ajuste ponderado da entonces aproximadamente y , con más peso en las tres últimas observaciones y una discrepancia mayor en la inicial.
Esas desviaciones tienen que proceder de una justificación de medición o de un modelo de error. Elegirlas después de mirar los residuos, para obtener la curva deseada, mezcla la definición del criterio con el resultado que se busca. Estimar las varianzas a partir de réplicas puede ser razonable, aunque introduce una incertidumbre propia, sobre todo cuando hay pocas réplicas. La variación de una lectura individual, por otra parte, es distinta del error estándar de una media.
Una decisión semejante aparece al ponderar experimentos entre sí. Si uno contiene cien puntos y otro diez, sumar todos los residuos supone que cada punto contribuye según su modelo de observación. Promediar primero el error dentro de cada experimento les concede otra importancia relativa. La elección entre ambas reglas exige considerar la dependencia entre puntos, la precisión y el propósito de la calibración. Registrada la decisión, después podrá reconstruirse qué experimentos dominan la solución.
Comprobar qué ha resuelto el optimizador
Una vez fijado el criterio comienza un problema numérico, en el que un algoritmo busca valores que lo reduzcan dentro del dominio permitido. Su mensaje de convergencia indica que se cumplieron ciertos criterios de parada, como un gradiente pequeño o cambios reducidos entre iteraciones. Queda por comprobar si encontró una buena solución del problema planteado y si la evaluación de ese problema es lo bastante precisa.
En nuestra exponencial, el ajuste original se reduce a una búsqueda en una sola dimensión, porque, para un k fijo, Q es cuadrático respecto de A y su mínimo sin restricciones es
Si ese valor quedara fuera de los límites admisibles, se impondría el extremo correspondiente. Al sustituirlo en Q se obtiene un perfil numérico sobre el intervalo de k, en el que, para los datos del ejemplo, la solución interior obtenida antes tiene un criterio menor que los extremos. El examen de los puntos estacionarios de esta función reducida añade una verificación al resultado de una llamada al optimizador.
En este caso la diferencia es amplia. Con la mejor amplitud es la media de las lecturas, 5,68, con la que Q vale 48,108. Con la mejor amplitud es aproximadamente 11,3372 y Q vale 80,5696. El punto interior, con Q igual a 0,1466, domina a ambos. Como los tiempos son enteros, el cambio convierte la búsqueda de puntos estacionarios en el cálculo de las raíces de un polinomio. En el intervalo admisible hay uno solo.
Esa comprobación vale para este ejemplo y su dominio declarado. En modelos más complejos la reducción puede no existir y distintos puntos iniciales pueden conducir a mínimos locales diferentes. Repetir la búsqueda desde varios puntos muestra si la mejor solución aparece de manera reproducible y si otras regiones del espacio contienen ajustes competitivos. Obtener repetidamente el mismo valor aumenta la confianza en la búsqueda, aunque en un problema no convexo no demuestra que el óptimo sea global. Raue y colaboradores (2013) compararon estrategias de optimización en modelado dinámico y mostraron que estos problemas numéricos deben tenerse en cuenta.
La escala de los parámetros también afecta al cálculo, ya que un parámetro del orden de una millonésima y otro del orden de mil pueden producir pasos numéricos mal equilibrados. Para parámetros estrictamente positivos, las coordenadas logarítmicas ayudan a recorrer cambios relativos. Un cambio de coordenadas de este tipo, con la misma función objetivo y un dominio equivalente, conserva el problema de ajuste. Transformar los datos, como se hizo antes con las lecturas, altera el criterio, salvo que su modelo probabilístico se transforme también de manera coherente.
Cuando la dinámica requiere integración numérica, cada evaluación de Q incorpora una aproximación de la trayectoria. Si el error de integración es comparable con las discrepancias que separan a los candidatos, el algoritmo puede acabar optimizando irregularidades numéricas. Conviene entonces reevaluar las soluciones relevantes con una precisión mayor y comprobar que los parámetros y las predicciones no cambian de forma sustantiva. La tolerancia adecuada depende de las escalas de cada problema y no hay un valor universal válido para todos los modelos.
Una solución situada en un límite exige el mismo cuidado. Puede reflejar una restricción física real o bien un límite elegido por conveniencia que corta una región preferida por el ajuste. Ampliar ese límite sin justificación tampoco resuelve necesariamente el problema. El informe debe recoger el valor alcanzado, las restricciones activas y su fundamento, para que nadie lo tome por una estimación interior bien determinada.
Cuando el simulador es estocástico, dos ejecuciones con los mismos parámetros pueden producir salidas diferentes y la comparación de una única realización con los datos suma la variación de simulación a la del problema observado. Hace falta definir qué se compara (distribuciones, medias simuladas u otra cantidad) y controlar el error de Monte Carlo asociado. Esa variación es computacional. No indica la existencia de varios mecanismos posibles y sigue formando parte de la incertidumbre por muchas veces que se repita el optimizador.
El resumen elegido puede ocultar diferencias observables. Un simulador que produce siempre uno y otro que produce cero o dos con igual probabilidad tienen la misma media, de manera que, si se calibra únicamente esa media, ambos coinciden con un promedio observado de uno. Sus varianzas, en cambio, son cero y uno respectivamente. Medir la variabilidad entre realizaciones serviría para contrastar esa diferencia, que la calibración de la media no recoge porque solo obliga al modelo a reproducir el resumen incluido en el criterio.
El procedimiento también puede comprobarse con datos generados a partir de parámetros conocidos. Sin ruido, el ajuste debería recuperar las salidas y, cuando estén determinados por ellas, los parámetros utilizados. Con ruido simulado, las repeticiones sirven para estudiar sesgos o cobertura bajo las hipótesis elegidas. Es una prueba útil de la implementación y del método de estimación, aunque, al generarse y ajustarse los datos con la misma ecuación, deja fuera las discrepancias que esa ecuación pueda tener con el fenómeno observado.
Un parámetro puede absorber lo que falta en la ecuación
La curva original se ajusta bien en los cinco tiempos. Existen, sin embargo, dos lecturas ficticias reservadas, 1,5 a los seis minutos y 1,2 a los ocho, que no se utilizaron para obtener A ni k. Para esos tiempos la exponencial ajustada en la escala original predice aproximadamente 0,9462 y 0,4191. La suma de cuadrados de esos dos errores es 0,9166, bastante mayor que la correspondiente a los cinco puntos de calibración.
La comparación entre ambas sumas, calculadas sobre dos y cinco puntos, ilustra aquí el tamaño de las discrepancias y carece del valor de un contraste estadístico. Más informativas son la dirección de esas discrepancias y su relación con el tiempo. Las dos nuevas lecturas quedan por encima de la curva y la más tardía conserva una señal que el modelo acerca a cero, porque la función ajustada no incluye ningún mecanismo capaz de mantener un fondo positivo.
Las lecturas del ejercicio se construyeron, con pequeñas desviaciones, alrededor de la señal , cuyo término constante uno faltaba en el modelo inicial. La tasa estimada, de aproximadamente 0,407, compensa en parte esa omisión al hacer que la curva disminuya más despacio. La diferencia respecto de 0,5 se debe, al menos en parte, a una causa ajena al ruido y al algoritmo, pues se está calibrando una función que no contiene la forma utilizada para construir los datos.
White (1982) estudió las consecuencias de estimar por máxima verosimilitud modelos mal especificados. Bajo sus condiciones, el estimador puede converger a un límite bien definido sin ser consistente para la propiedad que interesa, de manera que al aumentar el número de observaciones puede precisarse cada vez más una aproximación equivocada. Una estimación numéricamente estable entre repeticiones puede, aun así, haber perdido la interpretación física que se había asignado al parámetro.
El problema puede expresarse con la descomposición , en la que representa el error de observación y una discrepancia sistemática entre la salida del simulador y el proceso que se observa. La calibración de modelos computacionales de Kennedy y O’Hagan (2001) incorporó explícitamente esta clase de discrepancia. Separarla da cabida a una incertidumbre que no desaparece al ajustar mejor los parámetros de la función f.
Una discrepancia flexible plantea a su vez un problema de identificación de los parámetros físicos. Un cambio de puede compensarse con un cambio de y dar predicciones parecidas. Brynjarsdóttir y O’Hagan (2014) examinan esta dificultad y muestran que omitir la discrepancia puede producir sesgo y exceso de confianza, aunque identificar los parámetros cuando se la incorpora requiere restricciones informativas sobre ella. En nuestro ejemplo, averiguar si existe un fondo instrumental da una información que no se obtiene admitiendo una función correctora arbitraria.
El mismo razonamiento vale para las entradas conocidas de forma imperfecta. Si el modelo supone una intensidad de estímulo fija cuando en realidad varía entre ensayos, una tasa interna puede absorber parte de esa variación. Antes de atribuir las diferencias de parámetros a diferencias del sistema hay que comprobar, entonces, qué condiciones se mantuvieron realmente constantes y cuáles se estimaron junto con ellos.
Incertidumbre del ajuste y alcance de la validación
Los valores calibrados dependen de las observaciones disponibles. Según el modelo y el diseño, esa dependencia puede describirse con perfiles del criterio, aproximaciones locales o procedimientos de remuestreo, que indican cuánto pueden variar los parámetros sin que cambie sustancialmente la concordancia con los datos. Un único valor óptimo deja abierta esa pregunta, que es distinta de la de si el algoritmo consiguió reducir Q.
Los residuos contienen información que la suma total descarta. Una secuencia de errores positivos al comienzo y negativos después puede sugerir una forma temporal insuficiente, mientras que errores mayores cuando la señal es grande pueden poner en duda una varianza constante. Al examinarlos debe recordarse que los parámetros se estimaron con esos mismos datos, por lo que los residuos ajustados carecen de la independencia de una observación nueva. Con pocas lecturas, un patrón en los residuos orienta una comprobación adicional, que es la que puede identificar el mecanismo que falta.
La incertidumbre calculada está condicionada también por lo que se mantuvo fijo. Cuando la escala del instrumento, las condiciones iniciales de otros estados o una entrada se tratan como conocidas, los intervalos resultantes excluyen sus posibles errores y una predicción puede parecer precisa solo porque parte de la incertidumbre quedó fuera antes del cálculo. Lo prudente es identificar esas cantidades y propagar rangos o distribuciones cuando su variación sea relevante para la pregunta planteada.
El remuestreo debe respetar cómo se obtuvieron los datos. Reextraer puntos temporales como si fueran independientes puede destruir dependencias del experimento. Reextraer sujetos o ensayos completos corresponde a otra estructura de variación. Con cinco observaciones aisladas es poco realista esperar que un procedimiento automático reconstruya de forma fiable todos los componentes de la incertidumbre, ya que el tamaño de la muestra y la repetición del diseño acotan lo que puede aprenderse sobre el ruido.
La validación examina consecuencias que no se utilizaron para seleccionar el ajuste y su forma depende del uso previsto. Si se quiere interpolar entre condiciones parecidas, son pertinentes ciertas observaciones, pero si se pretende anticipar el comportamiento tras un cambio de entrada hace falta evaluar ese cambio. Una partición aleatoria de puntos de una misma trayectoria puede dejar información temporal muy próxima a ambos lados del corte, con lo que la comprobación difiere de predecir un experimento nuevo.
Cuando los datos reservados revelan un problema y se usan para modificar las ecuaciones, pasan a formar parte del desarrollo del modelo. Siguen siendo informativos, pero han dejado de ser una evaluación independiente de la nueva versión. Ese historial debe conservarse, porque presentar las sucesivas revisiones como si todas hubieran anticipado las mismas observaciones convierte una exploración útil en una prueba aparente de generalización.
Es útil, además, fijar de antemano qué error sería aceptable para la aplicación. Una diferencia pequeña en unidades de señal podría cambiar mucho un tiempo calculado de cruce de umbral o apenas afectar a una media temporal, consecuencias que la sola evaluación de Q deja sin examinar. El parámetro puede calibrarse con un criterio estadístico y la utilidad de la predicción comprobarse sobre la cantidad que finalmente se usará.
Del buen ajuste a una explicación contrastable
Shmueli (2010) distingue los objetivos de descripción, predicción y explicación causal, una diferencia que atraviesa la elección de variables, el ajuste y la evaluación. Una curva que resume bien unas observaciones puede ser compatible con distintos procesos generadores. Sostener una explicación exige relacionar los términos del modelo con mecanismos y examinar consecuencias que los diferencien de las alternativas pertinentes.
La exponencial es un ejemplo limitado de esa distinción. Una disminución observada puede surgir de la pérdida del componente medido, de un cambio en su visibilidad para el instrumento o de una combinación de procesos. La tasa efectiva describe cómo cae la señal dentro del modelo. Atribuirla a uno de esos procesos requiere saber cómo se genera y se registra la señal, información que procede de observaciones ajenas al ajuste.
Comparar muchas ecuaciones y quedarse con la de menor residuo resuelve solo una parte de la incertidumbre de una explicación, porque una ecuación más flexible dispone de más maneras de acomodar las lecturas. Su interés científico depende de que sus términos correspondan a componentes medibles y de que sus restricciones produzcan consecuencias contrastables. Los métodos de comparación y regularización ayudan a controlar la flexibilidad. La relación entre medición y mecanismo, en cambio, tiene que establecerse por otra vía.
Volvamos al ejercicio con una medición independiente, también ficticia, del dispositivo con la fuente de señal retirada. El instrumento sigue marcando un fondo de una unidad, con una incertidumbre pequeña frente a las diferencias tardías observadas. Esa prueba da fundamento al término constante de observación. El estado dinámico conserva la forma y la lectura pasa a ser , con el fondo fijado por la medición independiente.
Al recalibrar A y k con las cinco lecturas originales y el fondo fijado en uno se obtiene aproximadamente y , con predicciones de 1,5067 y 1,1875 para los seis y los ocho minutos. La revisión separa así una contribución instrumental constante de la caída de la señal. Como los datos tardíos ayudaron a detectar el problema, su concordancia posterior se registra como parte de la revisión y no se presenta como una nueva validación independiente.
La interpretación cambia también al calcular un tiempo de reducción a la mitad. Con el modelo revisado, el componente dinámico tarda , aproximadamente 1,3945 minutos, en reducirse a la mitad, momento en que el instrumento marca unas seis unidades, una de fondo y unas cinco del componente. Esa lectura todavía supera la mitad de la lectura inicial total, que es aproximadamente 5,4991. Con los mismos parámetros, confundir ambas definiciones daría un tiempo diferente, por lo que el tiempo informado debe corresponder a la cantidad que el modelo distingue y que el experimento pretende medir.
El registro final conserva las dos versiones, la primera con una tasa efectiva de 0,4072 ajustada con fondo cero y la segunda con el fondo medido y una tasa estimada de 0,4971, junto con la prueba realizada con la fuente retirada. Con ese registro puede comprobarse por qué cambió el número, ya que la nueva calibración responde a una ecuación de observación distinta, sustentada por una medición que el ajuste inicial no incluía.
Referencias
Brynjarsdóttir, J., y O’Hagan, A. (2014). Learning about physical parameters: The importance of model discrepancy. Inverse Problems, 30(11), 114007. https://doi.org/10.1088/0266-5611/30/11/114007
Kennedy, M. C., y O’Hagan, A. (2001). Bayesian calibration of computer models. Journal of the Royal Statistical Society: Series B, 63(3), 425–464. https://doi.org/10.1111/1467-9868.00294
Raue, A., Schilling, M., Bachmann, J., Matteson, A., Schelker, M., Kaschek, D., Hug, S., Kreutz, C., Harms, B. D., Theis, F. J., Klingmüller, U., y Timmer, J. (2013). Lessons learned from quantitative dynamical modeling in systems biology. PLOS ONE, 8(9), e74335. https://doi.org/10.1371/journal.pone.0074335. Corrección de autoría y ecuación 7: https://doi.org/10.1371/annotation/ea0193d8-1f7f-492a-b0b7-d877629fdcee
Shmueli, G. (2010). To explain or to predict? Statistical Science, 25(3), 289–310. https://doi.org/10.1214/10-STS330
Villaverde, A. F., Pathirana, D., Fröhlich, F., Hasenauer, J., y Banga, J. R. (2022). A protocol for dynamic model calibration. Briefings in Bioinformatics, 23(1), bbab387. https://doi.org/10.1093/bib/bbab387
White, H. (1982). Maximum likelihood estimation of misspecified models. Econometrica, 50(1), 1–25. https://doi.org/10.2307/1912526