La curva atraviesa los puntos y el algoritmo termina sin dificultades. Ahora bien, uno de los parámetros puede multiplicarse por diez sin que apenas cambien las predicciones, siempre que otro lo compense. Repetir el ajuste con más cifras decimales no decide cuál de esas combinaciones describe el sistema. Falta saber si los datos las distinguen y con qué precisión.
La identificabilidad estudia esa relación entre parámetros y observaciones. Un problema puede carecer de solución única incluso con mediciones ideales, o bien tener una solución única que los datos disponibles apenas delimitan. Las dos dificultades producen incertidumbre, pero se tratan de manera distinta. La primera solo se corrige modificando alguna condición informativa del problema. Para la segunda puede bastar un mejor diseño o una mayor precisión, aunque no cualquier observación adicional sirve.
Bellman y Åström (1970) formularon el problema de la identificabilidad estructural en el análisis de sistemas. Su objeto es la posibilidad de recuperar los parámetros a partir del comportamiento observable que el modelo puede producir. Como esa posibilidad depende de las salidas medidas y de los experimentos admitidos, una ecuación escrita sin función de observación ni condiciones experimentales deja incompleta la pregunta.
Una respuesta de saturación con dos parámetros positivos admite, con datos ideales, una solución algebraica única. Si las entradas se concentran en una zona poco informativa de la curva, sin embargo, los datos pueden dejar uno de esos parámetros prácticamente sin límite superior. Los números del ejemplo son didácticos y no corresponden a estimaciones de parámetros biológicos ni a resultados de un experimento real.
La igualdad que define el problema
Sea un vector de parámetros dentro de un dominio y sea el resultado observable predicho bajo un diseño , que incluye qué se mide, qué entradas se aplican y cuándo se observa. En un modelo dinámico deben declararse también las condiciones iniciales y cuáles de ellas se desconocen. La igualdad
pregunta si dos combinaciones producen exactamente las mismas observaciones ideales. Si esa igualdad obliga a en el dominio considerado, la correspondencia es globalmente identificable. Cuando la unicidad solo se establece en un entorno de una combinación, la conclusión es local. Los resultados formulados de manera genérica pueden excluir valores excepcionales, por ejemplo condiciones iniciales que impidan activar una dinámica.
En los modelos probabilísticos se comparan distribuciones observables. Dos parámetros que producen la misma media con varianzas diferentes pueden distinguirse si se observa información suficiente sobre la distribución, información que se pierde en parte cuando solo se conserva la media de los datos. Nuestro ejemplo usa errores normales con varianza conocida y fija, de modo que las diferencias entre las medias predichas distinguen también las distribuciones de observación.
Frente a la identificabilidad estructural, que plantea una igualdad exacta bajo condiciones ideales, la identificabilidad práctica examina qué valores pueden distinguirse con una cantidad finita de observaciones afectadas por incertidumbre. Wieland y colaboradores (2021) desarrollan esta distinción y analizan el uso de regiones de confianza o perfiles para estudiar el segundo problema. Un límite práctico solo tiene sentido si se declaran el criterio y el nivel de precisión utilizados, ya que sin ellos la afirmación «los datos determinan el parámetro» carece de un significado numérico único.
También puede identificarse una función de los parámetros aunque sus componentes individuales no se distingan. Si todas las combinaciones compatibles comparten un producto o una razón, esa cantidad puede ser estimable. La tarea científica debe precisar si interesa cada parámetro, una combinación o cierta predicción, puesto que una indeterminación relevante para explicar un mecanismo puede pesar menos en una predicción restringida al intervalo observado.
Una curva de saturación con solución ideal única
El ejemplo central es la curva
donde S, medida en unidades de concentración, es una entrada controlada y v es una tasa de respuesta. V tiene unidades de tasa y es el límite de la curva cuando S aumenta indefinidamente. K, con las mismas unidades que S, sitúa la entrada a la que la respuesta alcanza V/2. Suponemos que S se conoce sin error y que la ecuación es válida en los valores utilizados.
Con una sola entrada positiva , una lectura ideal deja indeterminados los dos parámetros. La igualdad describe una combinación admisible para cada K positivo. Repetir indefinidamente esa lectura puede eliminar el ruido de medición, pero deja una sola relación entre dos incógnitas. Ningún optimizador corrige esa carencia, que procede del diseño con una única entrada.
Con dos entradas positivas y distintas la situación cambia. Para datos ideales puede escribirse
Los dos puntos determinan una recta en las coordenadas y , con ordenada en el origen y pendiente , de donde se obtienen y . Dentro del dominio positivo, cualquier curva generada por el modelo produce valores coherentes con esas relaciones, así que se recupera una única pareja y la unicidad es global.
La transformación recíproca se usa aquí únicamente como prueba algebraica y no se recomienda para estimar parámetros con errores aditivos, porque un pequeño error en una respuesta cercana a cero se amplifica al invertirla y cambia la distribución del ruido. Con datos reales, el criterio de estimación debe conservar un modelo de observación apropiado, una exigencia estadística ajena a la unicidad ideal de la solución.
Los requisitos de la prueba delimitan también sus excepciones, motivo por el cual el dominio y las entradas se declaran explícitamente, para no extender una conclusión genérica a situaciones que no satisfacen sus hipótesis. Una entrada S igual a cero produce respuesta cero cualesquiera que sean V y K. Dos mediciones a esa entrada no añaden ninguna ecuación que los separe. Si V fuera cero, caso excluido de nuestro dominio, todas las respuestas serían cero y K quedaría oculto.
Cuando la escala del instrumento es desconocida
Modifiquemos una sola condición. Si el instrumento registra , con una ganancia positiva g también desconocida, la salida pasa a ser
Para cualquier constante positiva c, las transformaciones y dejan la salida exactamente igual en todas las entradas S. Como la igualdad es exacta y procede de una invariancia algebraica del modelo, ninguna mejora de precisión ni ampliación del rango de S separará g y V bajo esta función de observación.
Dado que c puede escogerse tan próximo a uno como se quiera, hay combinaciones equivalentes arbitrariamente cerca de la original y la falta de unicidad alcanza también a la identificación local de g y V. Esta familia continua difiere de una ambigüedad formada por dos soluciones aisladas. Al interpretar una búsqueda numérica, encontrar una segunda solución distante y recorrer una dirección continua de compensación son resultados distintos.
El producto y K sí pueden recuperarse con la prueba anterior si se observan dos entradas positivas distintas. Parametrizar el modelo con P y K expresa las cantidades observables sin imponer una separación que los datos no sostienen. P es, sin embargo, una tasa multiplicada por la ganancia instrumental. Interpretarlo como la tasa física V equivaldría a suponer que g se conoce y vale uno.
Fijar g en uno puede adoptarse como convención de escala, siempre que se declare. Para atribuir a V un significado físico independiente hace falta, en cambio, información adicional sobre g, por ejemplo una calibración del instrumento con una referencia conocida. La diferencia es verificable, puesto que la convención escoge una representación entre varias equivalentes mientras que la calibración incorpora una observación que rompe la equivalencia.
La invariancia vale para el modelo de observación completo que hemos supuesto, en el que la distribución del error en unidades de lectura no depende de g de otra manera. Si un mecanismo de ruido físicamente justificado diera información independiente sobre la ganancia, habría que incorporarlo y repetir el análisis de identificabilidad. Cuando las varianzas o las dependencias de un modelo probabilístico también cambian con los parámetros, la equivalencia entre modelos tiene que demostrarse comparando distribuciones completas, ya que la coincidencia de las medias deja fuera esas diferencias.
Una escala incierta en la entrada produce otra combinación. Si la concentración real fuera , con h positivo y desconocido, la respuesta sería y las lecturas identificarían solo el cociente K/h. Multiplicar simultáneamente h y K por una misma constante dejaría intacta la curva registrada. En este caso lo pertinente sería calibrar la concentración aplicada. Medir únicamente la ganancia de salida no resolvería la indeterminación, ya que la preparación de la entrada y la lectura de la respuesta son condiciones informativas diferentes.
Unicidad cercana y unicidad en todo el dominio
La distinción entre identificación local y global puede verse sin resolver ninguna dinámica. Si la salida ideal es y puede tomar cualquier valor real, una observación positiva determina dos valores, y . Cada uno de ellos, por no ser nulo, tiene un entorno suficientemente pequeño que excluye al otro. La solución es, por tanto, localmente única y globalmente ambigua en el dominio declarado.
Si una condición física establece que , la ambigüedad desaparece. Esa restricción es información y forma parte del enunciado, por lo que corresponde fijarla antes del ajuste y no introducirla después solo para seleccionar el signo preferido. Ejecutar un algoritmo desde valores iniciales positivos tampoco resuelve la cuestión. Que el procedimiento visite solo una parte del dominio no elimina las soluciones situadas fuera de ella.
Una matriz local bien condicionada puede describir con precisión el entorno de una de esas soluciones y pasar por alto la otra. Los diagnósticos basados en derivadas locales dejan abierta, por consiguiente, la unicidad global, cuya comprobación puede requerir buscar otras soluciones, resolver relaciones algebraicas o estudiar simetrías incluso cuando el ajuste alrededor del valor encontrado parece estable.
La implicación inversa también requiere cuidado. La función es estrictamente creciente en toda la recta y determina un único a partir de cualquier salida ideal, pese a que su derivada vale cero en . Si se observa cero y se utiliza el criterio cuadrático , la segunda derivada de Q también se anula en el mínimo, que es único aunque su aproximación cuadrática carezca de curvatura.
Con un error normal de varianza conocida , la información de Fisher de una observación de media es y se anula en cero. Aun así, dos valores diferentes de producen medias diferentes y, por tanto, distribuciones diferentes. Rothenberg (1971) relaciona la identificación local con la información bajo condiciones de regularidad. El ejemplo muestra por qué esas condiciones y los puntos excepcionales deben examinarse antes de convertir una matriz singular en un diagnóstico universal de no identificabilidad.
Cerca de cero, sin embargo, la inversión es sensible, porque la respuesta del inverso sigue una raíz cúbica, que carece de una aproximación lineal con pendiente finita en el origen. Si la salida pasa de cero a 0,001, el parámetro pasa de cero a 0,1; si pasa a −0,001, el parámetro pasa a −0,1. Cada salida tiene una solución única, pero pequeños errores observacionales pueden producir cambios relevantes del parámetro. De ahí que unicidad y estabilidad de la inversión deban evaluarse por separado.
Los cálculos numéricos introducen otra distinción. Un autovalor muy pequeño puede reflejar una dirección débil, una mala escala de los parámetros o una precisión insuficiente en las derivadas. Cuando un umbral informático lo declara exactamente cero se obtiene una clasificación numérica, dependiente del umbral elegido, que debería contrastarse con el comportamiento del modelo al variar los parámetros antes de leerla como una igualdad algebraica.
Datos distintos que apenas separan los parámetros
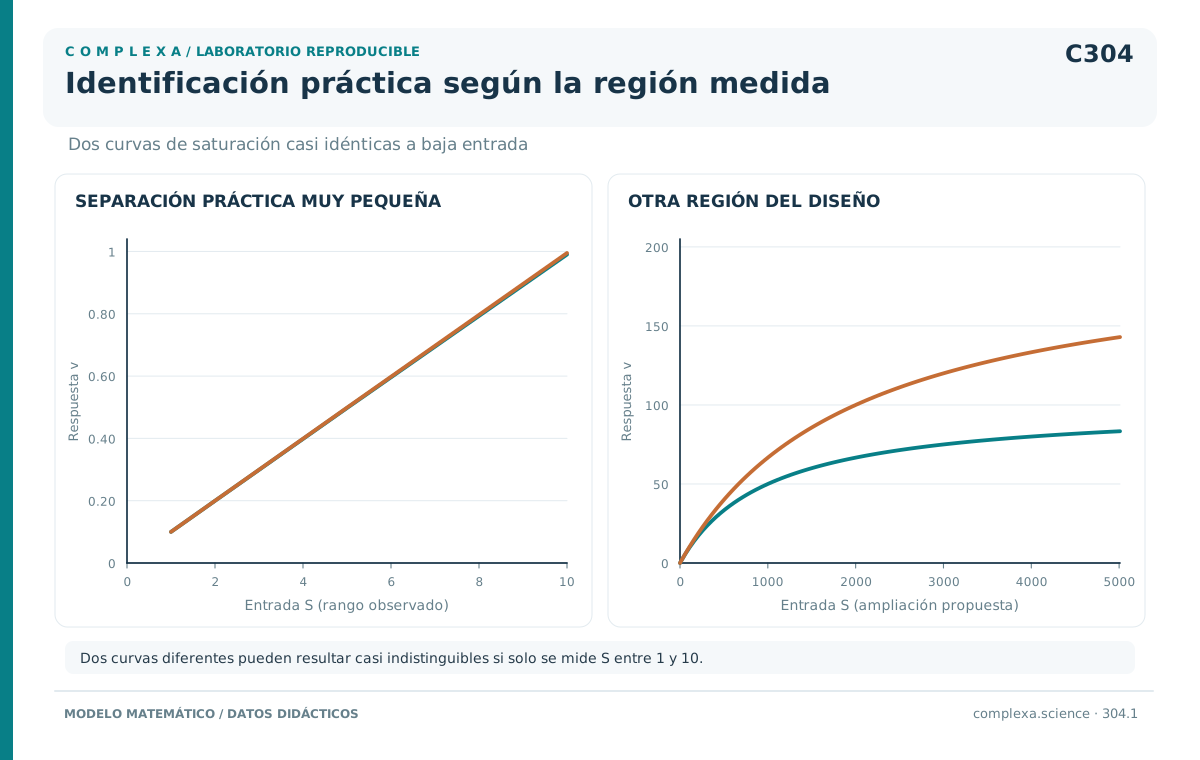
Volvamos a la curva de saturación sin ganancia desconocida, con los valores de referencia y y observaciones en las entradas 1, 2, 5 y 10. Las respuestas de la tabla siguiente se sitúan exactamente sobre la curva de referencia, sin sortear ninguna realización de ruido. Para analizar su resolución estadística se suponen después errores normales independientes, con desviación típica conocida unidades de respuesta en cada lectura.
| Entrada S | Respuesta de referencia | Respuesta con V=200, K=2000 |
|---|---|---|
| 1 | 0,099900 | 0,099950 |
| 2 | 0,199601 | 0,199800 |
| 5 | 0,497512 | 0,498753 |
| 10 | 0,990099 | 0,995025 |
Las cifras de la tabla están redondeadas, pero los cálculos emplean los valores exactos de la función de referencia en cada entrada.
La segunda pareja duplica ambos parámetros y conserva su razón V/K. Sus respuestas difieren de las de referencia en todas las entradas positivas, de manera que no hay equivalencia exacta, pero la mayor diferencia de la tabla, de aproximadamente 0,00493, es menor que la décima parte de la desviación típica asumida. Con estas observaciones, la curvatura que separa las dos parejas es pequeña frente a la incertidumbre de medición.
El motivo se aprecia al reescribir la función como . Cuando S es pequeño respecto de K, el denominador está próximo a uno y la curva se aproxima a una recta de pendiente V/K, sobre la que informan principalmente las cuatro observaciones. Para determinar V y K por separado habría que detectar la pequeña desviación respecto de esa recta que produce el término S/K.
Se trata, con todo, de una aproximación. Para cualquier K finito y dos entradas positivas distintas, la prueba algebraica anterior sigue siendo válida con mediciones ideales. La estructura del modelo admite la separación, pero el experimento elegido la hace difícil. Como las diferencias de salida son pequeñas, distinguir parámetros muy diferentes requiere una precisión considerable.
El criterio cuadrático estandarizado será
La referencia alcanza Q igual a cero por construcción y la pareja da aproximadamente 0,01034. Este número compara discrepancias con la precisión declarada en datos sin ruido; en un experimento real, incluso la referencia tendría residuos no nulos. En cuanto a la pareja alternativa, todavía podemos cambiar V para mejorar su concordancia, así que no es el mejor ajuste posible con K igual a 2000.
Dejar que los otros parámetros compensen
El perfil de K se construye fijando K y volviendo a estimar V, de manera que para cada valor se busca el mejor ajuste disponible cuando K está obligado a tomarlo. Raue y colaboradores (2009) desarrollaron este procedimiento para analizar la identificabilidad estructural y práctica en modelos dinámicos parcialmente observados. Al reoptimizar los demás parámetros en cada punto, el perfil sigue sus compensaciones.
En nuestro ejemplo, el modelo es lineal respecto de V y los pesos son iguales. Si se define , el óptimo condicionado a K es
Como todos los datos y coeficientes son positivos, la solución respeta V positivo. No imponemos límites superiores artificiales a V ni a K. La tabla reúne varias combinaciones obtenidas con esa regla completa.
| K fijado | Mejor V para ese K | Q del perfil |
|---|---|---|
| 100 | 10,7679 | 0,214370 |
| 1000 | 100,0000 | 0 |
| 2000 | 199,1364 | 0,000726 |
| 10000 | 992,2232 | 0,002362 |
El mínimo está en la referencia, pero el perfil apenas aumenta hacia valores grandes. Para precisar el diagnóstico fijaremos un criterio didáctico de compatibilidad, que acepta los valores cuyo incremento de Q respecto del mínimo no supera uno. Su único propósito es comparar diseños bajo una tolerancia definida, por lo que no lo presentaremos como un intervalo con cobertura del 95 % ni como un umbral universal de identificabilidad.
Con ese criterio, K tiene un límite inferior cercano a 46,515 y carece de límite superior finito. Para comprobarlo no hace falta detener la búsqueda en un número arbitrariamente grande. Cuando K aumenta indefinidamente y V se reestima, la curva se aproxima a una recta con pendiente , aproximadamente 0,099136. El criterio del perfil tiende entonces a 0,002919, todavía muy por debajo de uno.
La función conserva un mínimo único en K igual a 1000 sin que exista una cota superior compatible. Es una forma concreta de dificultad práctica. El procedimiento puede entregar una estimación puntual de apariencia precisa aunque los datos y el criterio admitan un conjunto que llega a parámetros arbitrariamente grandes, del que el valor impreso por el optimizador es solo un punto.
Si hubiéramos variado K con V fijo en cien, habríamos calculado una sección del criterio. La sección impide que V compense y puede crecer rápidamente. El perfil, en cambio, minimiza sobre un conjunto que incluye el valor fijado y por eso, en general, no supera el criterio de esa sección. Confundir ambas operaciones da una impresión exagerada de cuánto delimitan los datos a K.
Qué puede y qué no puede demostrar un diagnóstico
Con los perfiles de verosimilitud se construyen intervalos a partir de incrementos del criterio ligados a razones de verosimilitud, cuya calibración requiere hipótesis sobre el modelo y sobre la distribución del estadístico. Los umbrales usuales basados en una distribución ji cuadrado son aproximaciones que dependen de condiciones de regularidad y cuya cobertura puede no ser exacta en muestras pequeñas, fronteras de parámetros o problemas singulares. Por esa razón hemos separado nuestro umbral ilustrativo de toda afirmación de confianza probabilística.
Un perfil numéricamente plano admite otras explicaciones además de una invariancia estructural. Puede parecer plano porque el rango recorrido es corto, porque las diferencias son menores que la precisión numérica o porque las observaciones disponibles informan poco. En el caso de la ganancia desconocida, la demostración fue la transformación algebraica que conserva exactamente la salida. En la saturación observada a entradas pequeñas, por el contrario, conocemos diferencias no nulas y una prueba de unicidad ideal.
El algoritmo que construye un perfil debe resolver el problema condicionado en cada punto. Si encuentra mínimos locales de distinta calidad, la curva resultante puede presentar saltos o pendientes artificiales, dificultad que en nuestro ejemplo evita la fórmula explícita de . En problemas generales conviene comprobar soluciones alternativas, la continuidad cuando corresponda y la sensibilidad a las tolerancias antes de atribuir a los datos la forma del perfil.
Los métodos estructurales utilizan otra clase de información y pueden estudiar simetrías, eliminar estados de las ecuaciones o relacionar derivadas ideales de las salidas con los parámetros. Chis, Banga y Balsa-Canto (2011) compararon varios de ellos y mostraron diferencias en sus supuestos, en las clases de modelos que admiten y en su alcance local o global. Si una herramienta no logra completar un cálculo simbólico, la identificabilidad del modelo queda sin decidir.
Villaverde, Barreiro y Papachristodoulou (2016) desarrollan un enfoque que trata los parámetros constantes como estados adicionales con derivada temporal cero. El estudio de la observabilidad del sistema ampliado examina entonces si las salidas y sus derivadas ideales distinguen estados y parámetros próximos. Cuando la matriz correspondiente tiene rango completo se obtiene una conclusión local, válida bajo las hipótesis del método, que deja pendientes ambigüedades globales como la del signo en .
Todo informe debe indicar la escala y las restricciones utilizadas. Un intervalo que termina exactamente en el límite máximo impuesto al optimizador puede estar truncado por la búsqueda. Si el límite tiene una justificación física, esa justificación es información adicional válida y tiene que constar en el informe. Si el límite responde solo a la comodidad del cálculo, conviene comprobar si la región compatible sigue creciendo al ampliarlo, en cuyo caso la anchura resultante puede depender de una decisión del analista y apenas de las observaciones.
Cambiar el experimento que aporta la información
Añadamos ahora una observación en S igual a 1000, con respuesta sintética cincuenta y la misma desviación típica conocida de 0,05. Esta lectura cae en una zona donde la referencia muestra una saturación apreciable y donde la pareja , casi indistinguible en las cuatro entradas pequeñas, predice aproximadamente 66,67. El nuevo diseño hace observable una diferencia que el anterior apenas mostraba.
Si se recalcula el perfil con las cinco lecturas, reestimando V para cada K y conservando exactamente el criterio de compatibilidad de incremento de Q no superior a uno, la región de K queda aproximadamente entre 917,332 y 1098,870. El límite del perfil cuando K crece indefinidamente ronda ahora 125,532, por encima del umbral. El cambio se debe por entero a la observación añadida y a su ubicación, sin que se haya impuesto al parámetro ninguna cota superior nueva.
Estos límites se obtienen examinando la función en todo su recorrido, también entre los puntos de la tabla. En este ejemplo el perfil es una función racional de K con denominador positivo para K positivo, por lo que la ecuación puede transformarse en una ecuación polinómica sin introducir raíces positivas espurias. Esa ecuación tiene una raíz positiva con las cuatro lecturas y dos con la lectura adicional. La comprobación de esas raíces y del comportamiento en los extremos determina los intervalos descritos, con independencia del tamaño elegido para una rejilla numérica.
Otra forma de mejorar la información sería aumentar mucho la precisión de las cuatro lecturas originales. Si su desviación típica pasara de 0,05 a 0,001 sin que cambiaran los valores centrales de esta construcción, todos los valores de Q se multiplicarían por 2500 y el límite, antes igual a 0,002919, pasaría a aproximadamente 7,2975, con lo que dejaría de satisfacer el criterio. Con esas mismas entradas la curvatura era detectable desde el principio, dentro de lo que el ruido declarado dejaba resolver.
Repetir una única entrada y mejorar varias entradas distintas tienen consecuencias diferentes, que se confunden al contar observaciones sin considerar dónde se obtienen. En el diseño con solo , ni siquiera una precisión ilimitada rompe la relación continua entre V y K. En el diseño con cuatro entradas distintas, una precisión suficientemente alta puede detectar sus diferencias de curvatura.
Todo diseño se propone a partir de información incompleta sobre los propios parámetros. En una aplicación real no se sabe de antemano que K vale mil, de modo que puede ser necesario explorar un rango de entradas y ampliar después la zona en que las predicciones compatibles divergen. La ecuación, además, debe seguir siendo válida en esa zona. Si concentraciones mayores activan otro proceso omitido, el nuevo dato puede revelar una insuficiencia del modelo cuando lo que se buscaba era limitar con precisión sus parámetros originales.
Si hubiéramos mantenido desconocida la ganancia, la nueva observación de saturación tampoco separaría V y g, pues la transformación que conserva su producto actúa en todas las entradas. A diferencia de la falta de precisión, esa simetría estructural solo cede ante una medida independiente de la escala o ante otra observación que cambie la función informativa.
Salidas agregadas y parámetros de una dinámica
La elección de qué medir puede ocultar por completo una dinámica interna. Supongamos dos compartimentos con cantidades x y z que intercambian material según y , con tasas a y b positivas. Si solo se observa el total , entonces y, con un total inicial conocido, todas las tasas producen la misma salida constante. La rapidez del intercambio queda oculta por mucho que se prolongue o se afine la medición.
Medir un compartimento por separado puede dar información, pero el resultado depende también de la preparación inicial. Un sistema preparado exactamente en equilibrio no muestra relajación temporal alguna, mientras que en una distribución inicial fuera de equilibrio esa relajación puede observarse. El análisis debe declarar, por tanto, si las cantidades iniciales se conocen y si pueden manipularse. Villaverde y colaboradores (2016) y Chis y colaboradores (2011) advierten que condiciones iniciales particulares pueden cambiar la conclusión de un análisis genérico.
Con observación ideal de x y un sistema preparado en y , donde M es positivo y conocido, la pendiente inicial es y determina a. En el equilibrio, la fracción de material en el primer compartimento es . Como ambas tasas son positivas, q está entre cero y uno y de ella se despeja . Pendiente inicial y fracción de equilibrio contienen, así, información diferente sobre las tasas.
Esta reconstrucción ideal deja de lado la dificultad de derivar datos ruidosos. Con mediciones finitas habrá que estimar la pendiente y comprobar si el experimento llega a la región próxima al equilibrio. Si solo se dispone de una fase temporal corta, la segunda relación puede quedar mal delimitada; si se observa únicamente el equilibrio, se conoce una razón entre tasas pero falta su escala temporal. El ejemplo identifica qué parte del registro contiene cada ecuación, paso previo a decidir cómo estimarla.
Observar estados e identificar parámetros son problemas relacionados, aunque distintos. Una salida puede determinar un parámetro combinado y dejar ambiguos los estados internos, o bien bastar para reconstruir una trayectoria sin separar todos sus coeficientes. Tratar los parámetros como estados constantes facilita algunos análisis, pero el resultado debe indicar qué cantidades se recuperan, porque un dictamen único de «modelo identificable» puede ocultar diferencias relevantes entre parámetros individuales.
Qué se informa cuando una combinación sigue abierta
En el diseño de entradas pequeñas, V puede crecer sin límite compatible mientras la razón V/K permanece mucho más delimitada. Las combinaciones de la tabla dan razones de aproximadamente 0,10768, 0,1, 0,09957 y 0,09922. Informar de esa razón describe mejor lo que se sabe sobre la pendiente inicial que presentar una gran capacidad máxima V como si se hubiera medido directamente. La reparametrización hace visible la combinación aprendida sin crear observaciones nuevas.
Las predicciones deben examinarse en el rango en que se utilizarán. Las curvas compatibles se parecen en las entradas pequeñas, pero en S igual a mil las combinaciones con K igual a cien y diez mil predicen aproximadamente 9,789 y 90,202, respectivamente. Un ajuste próximo en el intervalo observado admite así extrapolaciones muy diferentes, porque la incertidumbre de los parámetros, poco visible en algunas salidas, puede ser decisiva en otras.
Una distribución previa o una penalización puede reducir la región explorada al favorecer determinadas combinaciones, con lo cual incorpora a la estimación información o preferencias adicionales. Para saber qué parte del resultado se debe a los datos conviene compararlo con el criterio basado solo en las observaciones. Ante una invariancia que deja intacta la distribución de las mediciones, una región posterior estrecha refleja la información previa o la penalización.
El resultado del ejemplo ampliado puede registrarse declarando todas esas condiciones, es decir, el modelo positivo , la escala de lectura conocida, las entradas 1, 2, 5, 10 y 1000, los errores independientes con desviación 0,05 y la compatibilidad definida por un incremento de Q de hasta uno. Bajo esas condiciones, la referencia es la solución ideal única y el perfil delimita K por ambos lados. Si se elimina la lectura cincuenta en S igual a mil, el mismo cálculo vuelve a dejar abierto el extremo superior, porque es esa fila adicional del diseño la que impide que una recta casi indistinguible en las entradas pequeñas siga sustituyendo a una curva de saturación determinada.
Referencias
Bellman, R., y Åström, K. J. (1970). On structural identifiability. Mathematical Biosciences, 7(3–4), 329–339. https://doi.org/10.1016/0025-5564(70)90132-X
Chis, O.-T., Banga, J. R., y Balsa-Canto, E. (2011). Structural identifiability of systems biology models: A critical comparison of methods. PLOS ONE, 6(11), e27755. https://doi.org/10.1371/journal.pone.0027755
Raue, A., Kreutz, C., Maiwald, T., Bachmann, J., Schilling, M., Klingmüller, U., y Timmer, J. (2009). Structural and practical identifiability analysis of partially observed dynamical models by exploiting the profile likelihood. Bioinformatics, 25(15), 1923–1929. https://doi.org/10.1093/bioinformatics/btp358
Rothenberg, T. J. (1971). Identification in parametric models. Econometrica, 39(3), 577–591. https://doi.org/10.2307/1913267
Villaverde, A. F., Barreiro, A., y Papachristodoulou, A. (2016). Structural identifiability of dynamic systems biology models. PLOS Computational Biology, 12(10), e1005153. https://doi.org/10.1371/journal.pcbi.1005153
Wieland, F.-G., Hauber, A. L., Rosenblatt, M., Tönsing, C., y Timmer, J. (2021). On structural and practical identifiability. Current Opinion in Systems Biology, 25, 60–69. https://doi.org/10.1016/j.coisb.2021.03.005