Cuatro equipos estiman una misma clase de magnitud en contextos diferentes y obtienen 12, 18, 3 y 11 unidades. Si solo se miran esos números, el segundo equipo parece alejarse mucho del resto y el tercero se sitúa en el extremo contrario. Los errores estándar respectivos, sin embargo, son 1, 4, 3 y 2 unidades. Las estimaciones más llamativas son también las menos precisas.
Puede analizarse cada grupo por separado, aceptando toda la dispersión de sus estimaciones, o bien imponerse un único valor común y atribuir las diferencias al error de muestreo. Una tercera posibilidad admite diferencias entre grupos y utiliza a la vez información compartida para estimar cada uno. Esta combinación parcial modifica sobre todo las estimaciones que tienen más incertidumbre.
Los números son didácticos y no corresponden a equipos observados ni sirven para clasificarlos por calidad. Con ellos se examina una operación estadística, la de decidir cuánto peso dar a un resultado local cuando existe una estructura común plausible. La respuesta requiere un modelo de las diferencias entre grupos y una representación de la precisión con que se ha observado cada uno.
La regularización aborda un problema relacionado. Una estimación que sigue muy de cerca los datos disponibles puede cambiar mucho cuando se modifican unas pocas observaciones. Restringirla o penalizar determinados valores puede reducir esa variabilidad mediante preferencias explícitas sobre las soluciones. La utilidad del procedimiento depende de cómo se relacionen esas preferencias con el problema que se intenta resolver.
Aceptar sesgo para reducir el error
Sea una estimación de un parámetro fijo , con distribución normal de media y varianza cuatro. La estimación directa es insesgada, es decir, al repetir el muestreo su media coincide con . Su error cuadrático medio es cuatro porque toda su desviación respecto del parámetro procede de la varianza.
La regla acerca cada resultado a cero. Su varianza se reduce a uno y su media es , por lo que el sesgo es . El error cuadrático medio queda
La fórmula procede de descomponer el error en varianza y sesgo al cuadrado. Cuando , el error es 1,25, menor que cuatro. Con , en cambio, sube a cinco y supera el de la estimación directa.
En este ejemplo la regla reduce siempre la varianza, pero su efecto sobre el error total depende de la distancia del parámetro al centro de contracción. En una aplicación es desconocido y el resultado obtenido después de simular no sirve para elegir la intensidad. La regularización necesita una justificación que pueda formularse antes de conocer ese valor.
Para una contracción general , con , la varianza es y el sesgo . Si se conociera , el error cuadrático sería mínimo con , expresión que muestra por qué una señal grande respecto del ruido admite menos contracción. Que ese óptimo dependa de la cantidad desconocida explica el interés de estimar estructuras compartidas a partir de varios parámetros.
Efron y Morris (1973) estudiaron la estimación simultánea de medias desde una perspectiva bayesiana empírica, con resultados que valen para problemas y criterios de riesgo especificados. La mejora que describen se refiere al error agregado del conjunto de estimaciones, así que una estimación local puede alejarse de su valor verdadero en una muestra concreta aunque el conjunto reduzca el error esperado.
La clase de estabilidad que interesa conservar depende también del criterio de pérdida, que varía según el uso. Un procedimiento útil para predecir una combinación de variables puede estimar mal coeficientes individuales poco identificados. Cuando dos predictores son casi equivalentes, sus coeficientes pueden compensarse sin alterar mucho la predicción.
Añadir una penalización al ajuste
Escribamos una regresión lineal como , donde contiene las observaciones, los predictores y sus coeficientes. Supondremos al principio errores independientes de media cero y varianza común, con las variables centradas y el intercepto tratado por separado para simplificar las expresiones.
Los mínimos cuadrados ordinarios minimizan y, si es invertible, su solución es . Cuando algunas columnas se parecen mucho, ciertas direcciones paramétricas quedan débilmente determinadas. Los valores muy pequeños que corresponden a esas direcciones amplifican, al invertirse, los cambios producidos por el ruido.
La regresión ridge, estudiada por Hoerl y Kennard (1970), añade una penalización cuadrática. Con la convención que se adopta aquí, el criterio que se minimiza es
El primer término mide la discrepancia respecto de las observaciones y el segundo aumenta a medida que los coeficientes se alejan de cero. Al derivar respecto de e igualar a cero se obtiene
Aquí es la identidad de tamaño igual al número de coeficientes penalizados. Añadir hace invertible la matriz incluso cuando las columnas de son linealmente dependientes. En ese caso la solución numérica única procede del problema penalizado y nada dice sobre si los datos, considerados sin la penalización, separan los efectos de esos predictores.
El efecto se ve en las direcciones propias de . Si una de ellas tiene valor propio , ridge multiplica la estimación ordinaria en esa dirección por . Con y valores propios 100 y 1, los factores son aproximadamente 0,9174 y 0,10, de modo que la dirección mejor informada cambia poco mientras la débilmente informada se contrae mucho.
Las direcciones propias son combinaciones de coeficientes, por lo que ridge no multiplica en general todos los coeficientes originales por un mismo número. La correlación entre predictores determina qué combinaciones se estabilizan, hasta el punto de que dos coeficientes pueden cambiar considerablemente aunque la suma que gobierna las predicciones permanezca cercana a su estimación inicial.
La penalización puede centrarse también en valores distintos de cero. Sustituir por expresa una preferencia por , de modo que el centro de la restricción contiene información sobre la clase de soluciones que se considera plausible. Otras penalizaciones pueden actuar sobre las diferencias entre coeficientes vecinos, con una geometría que favorece variaciones suaves sin reducir necesariamente su nivel común.
Las unidades forman parte de la penalización
Imaginemos un predictor medido en metros con coeficiente . Si se expresa en centímetros, su valor se multiplica por cien y el coeficiente equivalente pasa a . Las predicciones no cambian. Una penalización numérica aplicada sin modificación sería, en cambio, diez mil veces menor sobre el coeficiente en centímetros.
Para conservar exactamente el mismo problema penalizado al cambiar la unidad, la intensidad correspondiente a ese coeficiente debería multiplicarse por diez mil, un ajuste que procede de cómo se mide la distancia al origen en el espacio de parámetros, sin relación con información nueva. Si se mantiene la misma cifra de después de cambiar unidades, el problema expresa otra preferencia.
Es frecuente centrar los predictores y dividirlos por sus desviaciones estándar antes de aplicar una penalización común. Cada coeficiente transformado mide entonces el cambio que corresponde a una desviación estándar del predictor. La convención facilita las comparaciones entre magnitudes con unidades diferentes, aunque deja en manos del analista la decisión sustantiva sobre qué diferencias merecen igual contracción.
Los indicadores binarios, los términos de interacción y las variables con distribuciones muy asimétricas pueden requerir atención propia. Cuando una desviación estándar pequeña refleja que una categoría aparece pocas veces, dar a su coeficiente la misma escala que a una variable continua modifica la penalización de una manera concreta. Para interpretar el resultado hay que conservar la transformación realizada y poder volver a las unidades originales.
La intensidad depende también de la escala de la función de ajuste. Con la mitad de la suma de cuadrados, como arriba, se compara con una suma sobre todas las observaciones. Si esa suma se divide por , mantener la misma intensidad relativa requiere dividir también la penalización por . Por eso dos programas que usen estas convenciones pueden asignar cifras distintas a un ajuste equivalente.
El intercepto suele dejarse sin penalización cuando corresponde al nivel general y la contracción pretende actuar sobre las desviaciones respecto de él. Penalizarlo hacia cero introduciría una preferencia por un nivel de respuesta específico y, si ese cero procede de una escala arbitraria, la estimación cambiaría al trasladar el origen de la medida. Al separar intercepto y coeficientes queda declarado qué cantidad se está regularizando.
Una penalización que puede producir ceros
La penalización lasso utiliza los valores absolutos de los coeficientes y da el criterio
Tibshirani (1996) propuso este procedimiento para combinar contracción y selección de coeficientes. Al pasar de una función cuadrática a otra con una esquina en cero cambia el tipo de solución y algunos coeficientes pueden quedar exactamente en cero.
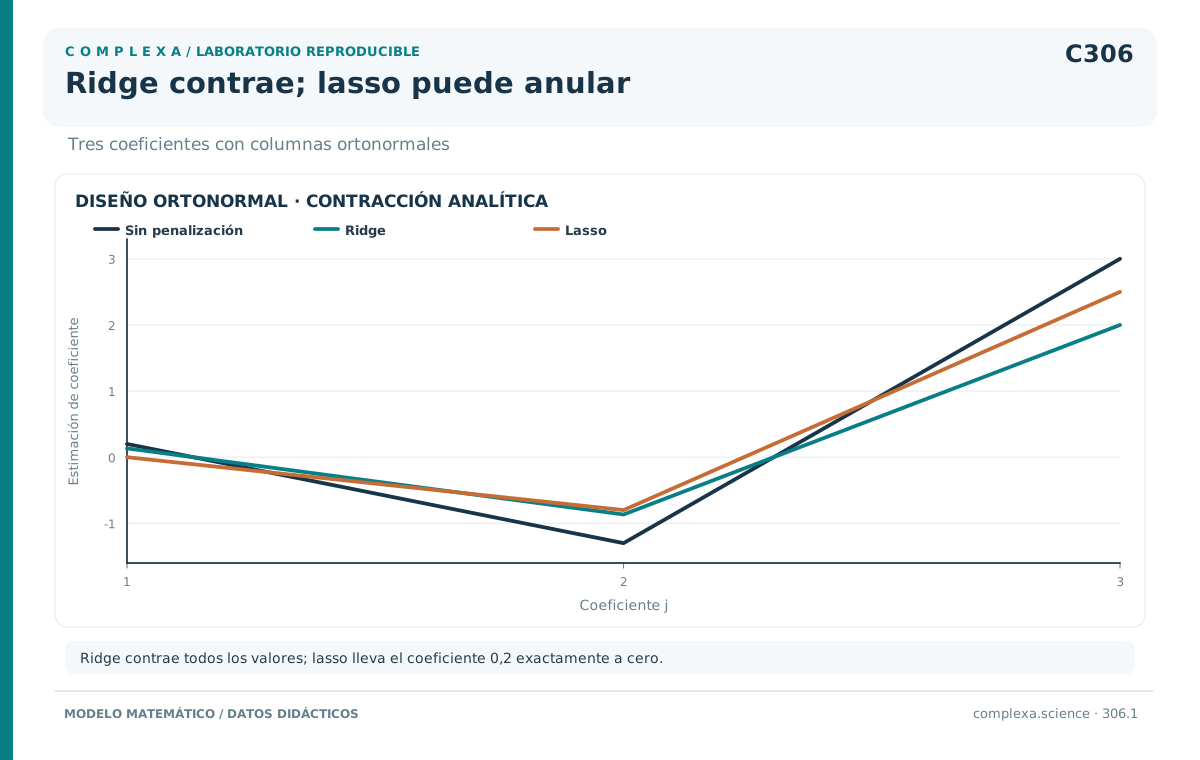
La diferencia se calcula fácilmente cuando las columnas son ortonormales, . Si es la estimación ordinaria del coeficiente , con la convención anterior ridge produce y lasso produce
Todo coeficiente con magnitud menor o igual que se elimina y los restantes se acercan a cero en una cantidad igual a .
Para estimaciones ordinarias e intensidad 0,5, ridge da aproximadamente y lasso da . La misma cifra de intensidad se usa aquí solo para ilustrar las fórmulas. Las dos penalizaciones tienen geometrías diferentes y compartir ese número no les da un grado de restricción idéntico.
Con predictores correlacionados la selección puede ser sensible a pequeñas modificaciones de los datos. Si dos columnas contienen información semejante, una solución dispersa puede apoyarse en una u otra. Un cero estimado describe lo que el criterio penalizado produce con esa muestra y esa intensidad, sin expresar una probabilidad de que un efecto físico sea exactamente nulo.
Ridge y lasso tampoco agotan la regularización. Restringir la suavidad de una función, limitar el rango de una matriz o imponer signos conocidos son otras formas de reducir el espacio de soluciones, cuya interpretación depende del objeto restringido. Una función suave puede tener muchos parámetros y una función con pocos parámetros puede mostrar cambios bruscos. El número de parámetros describe, pues, solo una parte de la estructura regularizadora.
Cuándo aparece una interpretación bayesiana
Bajo errores normales con varianza conocida , la parte de la logverosimilitud negativa que depende de los coeficientes es . Si se asignan previas independientes , la logdensidad previa negativa añade .
Multiplicados ambos términos por , la moda posterior coincide con la solución ridge definida antes si se toma , una equivalencia que depende de estos supuestos y de esta parametrización. En este modelo gaussiano, con escalas conocidas y previa normal, la posterior es normal y su media coincide con su moda.
Una previa Laplace independiente, con densidad proporcional a y escala , da una moda posterior lasso con , si bien en este caso la media posterior puede diferir de la moda. Como la previa es continua, la posterior habitual asigna masa nula al valor exacto cero incluso cuando su moda tiene componentes iguales a cero.
Para una penalización general , escribir formalmente una previa proporcional a exige comprobar que define una distribución propia. En algunas direcciones puede faltar la normalización. Cuando la intensidad se estima, además, la constante de normalización de la previa puede depender de ella y formar parte de la inferencia. Omitirla cambia el problema si se optimiza también el parámetro de regularización.
Otros procedimientos regularizadores modifican el algoritmo, como ocurre al detener una iteración antes de su convergencia. Sus efectos pueden relacionarse con penalizaciones bajo condiciones concretas, pero esa relación, igual que cualquier correspondencia con una previa independiente o con una posterior completa, tiene que derivarse en cada caso.
Obtener un punto penalizado o una distribución tiene consecuencias distintas al comunicar la incertidumbre. Una matriz de curvatura alrededor de la solución puede describir una aproximación local, pero deja fuera la elección de la intensidad y la incertidumbre de los parámetros omitidos salvo que se incorporen expresamente. Cuando hay selección, también las variables incluidas dependen de la muestra y la interpretación de un intervalo necesita indicar qué partes del procedimiento se han mantenido fijas.
Estimar grupos sin imponer que sean iguales
Volvamos a los cuatro grupos. Denotemos por la estimación observada de su media verdadera y por su error estándar, que aquí se trata como conocido. Un modelo normal jerárquico sencillo es
Las estimaciones locales son independientes condicionadas a sus parámetros, cuya variación alrededor de una media común , con desviación entre grupos , queda descrita por la segunda distribución.
En ausencia de combinación, cada grupo se estima sin recurrir a una distribución común informativa. La combinación completa impone para todos, mientras que la parcial permite variación y la describe con la escala . Gelman et al. (2012) desarrollan esta perspectiva y muestran cómo la contracción depende de la incertidumbre local frente a la variación entre grupos.
Para exponer el mecanismo, fijemos provisionalmente y , dos condiciones declaradas para el cálculo que no se han estimado a partir de los cuatro resultados. Condicionada a ellas, la posterior de cada es normal y tiene media
El coeficiente es el peso de la estimación local, que disminuye cuanto mayor es su error estándar. Si la variación real entre grupos es amplia, aumenta y la información local conserva más influencia.
La varianza posterior condicionada es
Su origen puede verse sumando precisiones, . La media posterior combina cada valor con pesos proporcionales a esas precisiones. En el límite la distribución común impone igualdad. En el extremo opuesto, cuando crece mucho respecto de , la estimación se aproxima al resultado independiente.
| Grupo | Estimación | Error estándar | Peso local | Media posterior | Desviación posterior |
|---|---|---|---|---|---|
| A | 12 | 1 | 0,8000 | 11,6000 | 0,8944 |
| B | 18 | 4 | 0,2000 | 11,6000 | 1,7889 |
| C | 3 | 3 | 0,3077 | 7,8462 | 1,6641 |
| D | 11 | 2 | 0,5000 | 10,5000 | 1,4142 |
A y B terminan con la misma media posterior por motivos distintos. A conserva el 80 por ciento de su desviación respecto de diez y B solo el 20 por ciento. Sus incertidumbres siguen siendo diferentes, como muestran los intervalos centrales condicionados del 95 por ciento, aproximadamente 9,847–13,353 para A y 8,094–15,106 para B.
Como y se fijaron de antemano, la tabla todavía no ha utilizado los datos de A para aprender sobre B y muestra solo la contracción condicional que forma parte del modelo. La combinación de información entre grupos aparece cuando sus observaciones informan conjuntamente los parámetros comunes, que a su vez participan en la estimación de cada .
Muchas observaciones dentro de un grupo mejoran la precisión de su media, pero la variación entre grupos se aprende a partir de cuántos grupos se han observado y de cómo se distribuyen sus resultados una vez descontado el error local. Con pocos grupos puede quedar mucha incertidumbre sobre , aunque cada media local esté medida con precisión.
Cuando la información local es un recuento
Con medias normales la derivación es sencilla, aunque la combinación parcial también puede formularse en modelos para proporciones. Supongamos que el grupo produce resultados favorables en intentos con una probabilidad de éxito específica. Condicionadas a esa probabilidad, las observaciones siguen una distribución binomial. Para relacionar los grupos podemos utilizar , donde es la media común y controla la concentración.
Fijemos de nuevo, como condiciones didácticas conocidas, y , con lo cual la distribución común es . Un grupo con ocho resultados favorables en diez intentos obtiene una posterior , de media 0,60. Otro con ochenta en cien obtiene , de media aproximadamente 0,7636. Ambos tienen proporción observada 0,80 y sus estimaciones posteriores se separan porque la información local tiene tamaños diferentes.
La media posterior puede escribirse como
para grupos con . El grupo pequeño concede la mitad del peso a la información común y el grande aproximadamente el nueve por ciento. La fórmula hace visible qué cantidad se comparte y cuánto peso recibe sin exigir que los grupos tengan la misma probabilidad verdadera.
Aquí una mayor significa más concentración de los parámetros alrededor de y, por tanto, más combinación, al contrario que en el modelo normal, donde una mayor significaba más dispersión entre grupos y menos combinación. Para comparar intensidades entre modelos hay que comprobar si el parámetro mide una dispersión o una concentración. En esta distribución beta, la varianza entre probabilidades es .
Un grupo sin observaciones conservaría la distribución común . La expresión mediante la proporción no puede aplicarse a , pero la actualización de los parámetros beta sigue estando definida. Su media sería 0,4 y su incertidumbre reflejaría la variación que el modelo permite entre grupos. Es una inferencia basada enteramente en la distribución común, sin evidencia local.
Si y se aprenden a partir de varios grupos, la posterior local integra también su incertidumbre. Observar muchos intentos en un único grupo informa bien su , mientras que observar grupos diferentes ayuda a conocer la distribución de probabilidades. Para distinguir ambas fuentes es necesario conservar el número de grupos y el tamaño de cada uno, porque la intensidad de combinación apropiada depende de cómo se reparten los intentos entre grupos, algo que el total agregado oculta.
Aprender la media común y conservar su incertidumbre
Mantengamos , pero tratemos ahora como desconocida, con una previa normal de media diez y varianza 25. Al integrar cada , la distribución de condicionada a tiene varianza , una suma cuyos dos términos corresponden a la dispersión verdadera de los grupos y al error de sus estimaciones.
La posterior de es normal. Su precisión es la suma de la precisión previa y las cuatro precisiones . Con los datos de la tabla, la media posterior es aproximadamente 10,7858 y la varianza 2,03284. La estimación común se desplaza porque incorpora los cuatro resultados con pesos que tienen en cuenta sus distintas incertidumbres.
Condicionada a un valor de , la media de cada grupo sigue siendo . Al integrar la distribución posterior de , la media marginal sustituye por su media posterior y vale aproximadamente 12,2286 para B, un valor en el que los otros grupos influyen a través de la distribución común, aprendida ahora conjuntamente.
La varianza necesita un paso adicional. En este caso la ley de la varianza total da
El primer término es la incertidumbre local condicionada a la media común y el segundo recoge la incertidumbre de esa media, transmitida según el grado de combinación. Para B, la varianza aumenta de 3,2 a aproximadamente 4,5010 y la desviación de 1,7889 a 2,1216.
Si se sustituye por 10,7858 y se trata como conocido, la media de B es la misma pero su varianza se queda en 3,2. En este cálculo exacto, la diferencia identifica la incertidumbre que se pierde al fijar un parámetro estimado, una pérdida mayor en los grupos menos precisos, que son los que más se contraen hacia la media común.
La incertidumbre compartida genera además dependencia posterior entre grupos. Con conocida, la covarianza entre dos parámetros distintos incluye . Si el nivel común es mayor de lo esperado, ambas estimaciones tienden a desplazarse juntas. Para inferir una diferencia entre grupos debe utilizarse esa covarianza, ya que sumar mecánicamente sus varianzas marginales equivaldría a tratar los parámetros como si siguieran siendo independientes.
Bayes empírico y el modelo jerárquico completo
Una estrategia bayesiana empírica estima los parámetros de la distribución común a partir de los datos y después los utiliza en las estimaciones locales. En el modelo normal, y pueden estimarse maximizando la verosimilitud marginal de los . Morris (1983) desarrolla este enfoque y examina también la estimación de errores y la construcción de intervalos.
Fijar esos parámetros en sus estimaciones es un procedimiento práctico, pero los intervalos condicionales ingenuos dejan fuera su incertidumbre de estimación. El propio enfoque bayesiano empírico puede incorporarla mediante correcciones analíticas o procedimientos de remuestreo, por lo que debe distinguirse de una implementación que sustituye parámetros y se detiene ahí.
En un análisis bayesiano jerárquico completo se especifican distribuciones previas para los parámetros comunes y se integra su posterior conjunta. Cuando también es desconocida cambian a la vez el centro y la intensidad de contracción. La varianza marginal de un grupo contiene entonces la media de sus varianzas condicionadas y la variación de sus medias condicionadas a través de esa posterior.
La contribución adicional de incertidumbre es no negativa en la descomposición de la varianza total. Aun así, un intervalo del análisis completo puede ser más estrecho que otro obtenido por sustitución, puesto que el punto elegido para sustituir puede tener una varianza condicional mayor o menor que su promedio posterior y las medias pueden desplazarse. La comparación numérica requiere especificar ambos procedimientos.
La previa elegida para influye especialmente cuando hay pocos grupos. Gelman (2006) mostró problemas con algunas previas inversa-gamma presentadas como no informativas y estudió alternativas sobre la desviación estándar jerárquica. Una escala débilmente informativa debe interpretarse en las unidades de los efectos entre grupos, porque un número tomado de otra aplicación puede imponer una contracción muy distinta.
Una estimación puntual de situada en la frontera puede producir combinación completa, aunque el hecho de que un algoritmo devuelva ese valor deja sin demostrar que todos los efectos sean iguales. Con una previa continua sobre , en cambio, la posterior puede concentrarse cerca de cero sin asignar probabilidad positiva a la igualdad exacta. Las dos descripciones tienen consecuencias diferentes para la incertidumbre de las diferencias entre grupos.
Decidir qué información es compartible
La distribución común supone que los grupos pueden relacionarse de una manera determinada. En el modelo más sencillo sus parámetros son intercambiables condicionados a y , es decir, cambiar las etiquetas de los grupos deja intacta la distribución conjunta. La intercambiabilidad expresa una simetría de la información disponible y es compatible con que los valores reales de los grupos difieran.
Si se conoce una característica que diferencia sistemáticamente los grupos, puede incorporarse a una media específica, por ejemplo . La combinación parcial ocurre entonces alrededor de lo esperado para cada valor de , de modo que un grupo situado lejos del promedio global podría estar cerca de la predicción correspondiente a sus características.
En un análisis de servicios, comparar centros con distintas poblaciones atendidas exige distinguir la variación de sus resultados de la composición de sus usuarios. Si el objetivo es estimar efectos de una intervención, la comparación necesita además supuestos sobre asignación y factores de confusión, ya que una estructura jerárquica no convierte una asociación en un efecto causal y la contracción solo regula estimaciones dentro de ese planteamiento.
Las medidas también deben ser comparables. Combinar puntuaciones obtenidas mediante instrumentos diferentes requiere que se refieran a cantidades compatibles o que el modelo represente su relación. Una media común de números con significados distintos puede ser precisa como cálculo y difícil de interpretar como estimación científica.
Suponer una distribución normal de efectos es otra decisión. Un conjunto con subpoblaciones separadas, colas largas o una estructura temporal puede necesitar una distribución diferente o parámetros adicionales. Aumentar amplía la variación global, pero siempre alrededor de un único centro. El patrón de combinación depende de la estructura con la que se representa esa heterogeneidad.
Gelman et al. (2012) utilizan modelos multinivel para reducir comparaciones poco fiables cuando las estimaciones son ruidosas y la variación real es moderada. El mecanismo desplaza las estimaciones hacia una estructura compartida y cambia también su incertidumbre. Su utilidad presupone que esa estructura corresponde al fenómeno, ya que reunir todos los resultados disponibles en una sola distribución intercambiable puede borrar diferencias conocidas que deberían modelarse.
Leer una estimación después de la contracción
Una estimación regularizada combina los datos con una estructura adicional. Para entenderla conviene conservar la estimación local, su precisión y el centro hacia el que se ha contraído, porque presentar únicamente la cifra final ocultaría por qué A y B quedaron ambos en 11,6 en la tabla pese a haber partido de resultados distintos.
Las clasificaciones de grupos son especialmente sensibles a la incertidumbre local. Un grupo con pocas observaciones puede aparecer en un extremo por variación de muestreo. La combinación parcial puede modificar su posición, pero una clasificación de medias posteriores sigue siendo una clasificación de resúmenes. Las probabilidades de diferencias y de ordenación, que las posiciones de esos puntos dejan sin determinar, se calculan a partir de las distribuciones conjuntas.
El valor de la intensidad tampoco tiene significado aislado, puesto que en ridge depende de la escala de los predictores y de la convención de suma de errores. En el modelo jerárquico la contracción local depende de la relación entre y . Si esa relación se informa, el lector puede reconstruir el peso que recibió cada fuente. Una intensidad elegida mediante un procedimiento con datos añade otra etapa de estimación que debe documentarse.
Para completar el ejemplo, conservemos como parámetros conocidos y cambiemos únicamente la precisión de B, suponiendo que una medición más extensa mantiene su estimación en 18 pero reduce el error estándar de cuatro a uno. El peso local pasa de 0,20 a 0,80, la media posterior de 11,6 a 16,4 y la varianza condicionada de 3,2 a 0,8.
El intervalo central del 95 por ciento para B queda aproximadamente en 14,647–18,153, frente a 8,094–15,106 con el error estándar anterior. El centro común y la variación permitida entre grupos son los mismos en ambos cálculos, así que el cambio se debe solo a la nueva precisión, con la que el resultado local de B conserva una parte mayor de su diferencia respecto de diez.
Referencias
Efron, B., y Morris, C. (1973). Stein's estimation rule and its competitors—An empirical Bayes approach. Journal of the American Statistical Association, 68(341), 117–130. https://doi.org/10.1080/01621459.1973.10481350
Gelman, A. (2006). Prior distributions for variance parameters in hierarchical models (comment on article by Browne and Draper). Bayesian Analysis, 1(3), 515–534. https://doi.org/10.1214/06-BA117A
Gelman, A., Hill, J., y Yajima, M. (2012). Why we (usually) don't have to worry about multiple comparisons. Journal of Research on Educational Effectiveness, 5(2), 189–211. https://doi.org/10.1080/19345747.2011.618213
Hoerl, A. E., y Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
Morris, C. N. (1983). Parametric empirical Bayes inference: Theory and applications. Journal of the American Statistical Association, 78(381), 47–55. https://doi.org/10.1080/01621459.1983.10477920
Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x