Una serie de diez recuentos contiene cinco ceros seguidos de cinco valores iguales a cuatro. Su media es dos. Un modelo de Poisson con una tasa cercana a dos puede reproducir esa media y, al mismo tiempo, generar series bastante distintas, con menos ceros, valores intermedios frecuentes y sin la separación en dos bloques tan definidos. El ajuste de una característica deja abiertas las preguntas sobre las demás. Plantearlas exige observar qué datos produciría el modelo si se utilizara como mecanismo generador.
Los diez recuentos son un ejemplo didáctico. Podrían corresponder a llegadas de solicitudes en periodos de igual duración, pero no proceden de ninguna organización real. Su sencillez deja ver por separado tres dificultades, que son reproducir el nivel medio, la distribución de los valores y su orden temporal. Una comprobación dirigida únicamente a la primera dejaría sin examinar las otras dos.
Una comprobación predictiva convierte una formulación estadística en un conjunto de resultados observables y compara después alguna propiedad de esos resultados con la misma propiedad calculada en los datos. Lo que mide el contraste depende de qué se simula, qué se mantiene fijo y qué discrepancia se considera relevante. Esas decisiones forman parte del procedimiento, porque una colección de simulaciones que no las especifica puede responder a una pregunta distinta de la que motivó el análisis.
Qué cuenta como una réplica
Sea el conjunto observado, el diseño o las covariables que vamos a mantener fijas y los parámetros. Bajo el modelo, una réplica es otro conjunto de resultados generado mediante , con tantas observaciones como si se conserva el tamaño de muestra y con los mismos intervalos si lo que se conserva es un calendario irregular.
Una vez observados los datos, la incertidumbre sobre los parámetros queda integrada en la distribución predictiva posterior
Para simularla se extrae un valor de de la distribución posterior y, condicionado en ese valor, se genera una réplica completa. La operación se repite muchas veces. Cuando el modelo supone una tasa común para los recuentos, todas las observaciones de una misma réplica comparten la tasa extraída, ya que obtener una tasa independiente para cada observación introduciría una heterogeneidad que el modelo original no contiene.
Si el modelo afirma , cada observación replicada es un valor Poisson generado con esa tasa. Sustituirla por eliminaría la variación del proceso y daría series artificialmente regulares, frente a las cuales unos datos ruidosos harían parecer inadecuado incluso a un modelo generador correcto.
Puede ser necesario simular también el proceso de observación. Un modelo de abundancia ecológica distingue los animales presentes de los detectados, de modo que una réplica de los datos tiene que pasar por la etapa de detección. Un instrumento con redondeo, saturación o error de clasificación añade otra transformación. Lo que se compara es el resultado posterior a todas esas operaciones, porque una discrepancia puede originarse en el proceso estudiado, en la medición o en ambos.
Supongamos una señal latente normal de media tres y desviación típica dos, medida con un instrumento que sustituye cualquier valor negativo por cero. La variable registrada es , donde representa la señal. Aunque la distribución latente sea continua, aproximadamente el 6,68 % de los registros serán exactamente cero. Para replicar el registro se genera primero y se le aplica después la misma transformación.
Si los datos se comparan con señales latentes sin transformar, aparecerán valores negativos simulados que el instrumento nunca puede registrar, una discrepancia debida a la etapa omitida en la comparación y compatible con una distribución latente correcta. En sentido inverso, incorporar la transformación puede explicar los ceros sin introducir en el proceso un estado especial de inactividad. Para elegir entre esas dos explicaciones habría que inspeccionar cómo se obtuvo el registro.
Los datos faltantes exigen una decisión semejante. Si se conserva el patrón de ausencias observado, las réplicas generan valores en las mismas posiciones disponibles y la comprobación recae sobre ellos. Si también se simulan las ausencias, pueden examinarse su frecuencia y su distribución, siempre que exista un modelo para ellas. La primera opción condiciona en el patrón y la segunda le asigna una probabilidad. Como cada una responde a preguntas distintas, la descripción de las réplicas debe indicar cuál se utilizó.
Gelman, Meng y Stern (1996) formularon la evaluación predictiva posterior de manera que pudiera utilizar características dependientes de parámetros desconocidos. Con esa formulación se comprueban supuestos de modelos complejos sin reducir toda la incertidumbre a una sola estimación. Para interpretar el resultado sigue siendo necesario describir si se replican las observaciones, ciertos componentes latentes o una población nueva.
Las implicaciones de la distribución previa antes del ajuste
Si en la integral anterior se sustituye por , se obtiene la distribución predictiva previa
Con ella se estudian las consecuencias conjuntas de la previa y del mecanismo de observación antes de utilizar los resultados que se pretenden analizar. Una previa que parece amplia y moderada cuando se examina un coeficiente aislado puede producir datos extremos después de atravesar una transformación exponencial o de combinarse con otros parámetros.
En otro ejercicio de recuentos, la tasa satisface y, condicionado en ella, cada recuento sigue una distribución de Poisson. Con la mediana de la tasa es dos y su media, aproximadamente 3,30. Con la mediana sigue siendo dos, pero la media sube a unas 180 unidades, una gran diferencia en la cola derecha que la igualdad de las medianas oculta.
El cálculo de la probabilidad previa de observar más de cien eventos en un periodo integra también el muestreo Poisson y recoge así tanto la incertidumbre sobre la tasa como la variación de los recuentos. Esa probabilidad es aproximadamente 0,0000486 para y 0,0960 para . Cuando el conocimiento del problema hace muy poco plausibles los periodos con cientos de eventos, estas simulaciones localizan una consecuencia concreta de la previa amplia.
Decidir si esa cola es aceptable requiere contexto. Un proceso con episodios excepcionales intensos podría justificar una cola que sería absurda en otra aplicación. Se trata de expresar esas expectativas en la escala observable y de comprobar su coherencia. Gabry y colaboradores (2019) muestran cómo la visualización de datos simulados ayuda a descubrir implicaciones poco evidentes de las previas. Recomiendan examinar conjuntos completos y conservar los valores extremos plausibles, sin ajustar las distribuciones previas hasta que reproduzcan únicamente la muestra ya observada.
Cuando una previa se modifica después de estudiar los datos, ese paso pertenece al desarrollo del modelo y debe quedar registrado, ya que puede tratarse de una corrección sensata de unidades o de escala tanto como de una adaptación del modelo a peculiaridades de la muestra. Lo aprendido se evaluará con predicciones sobre datos reservados o recogidos después, sin reutilizar indefinidamente la misma evidencia.
Una media compatible y demasiados ceros
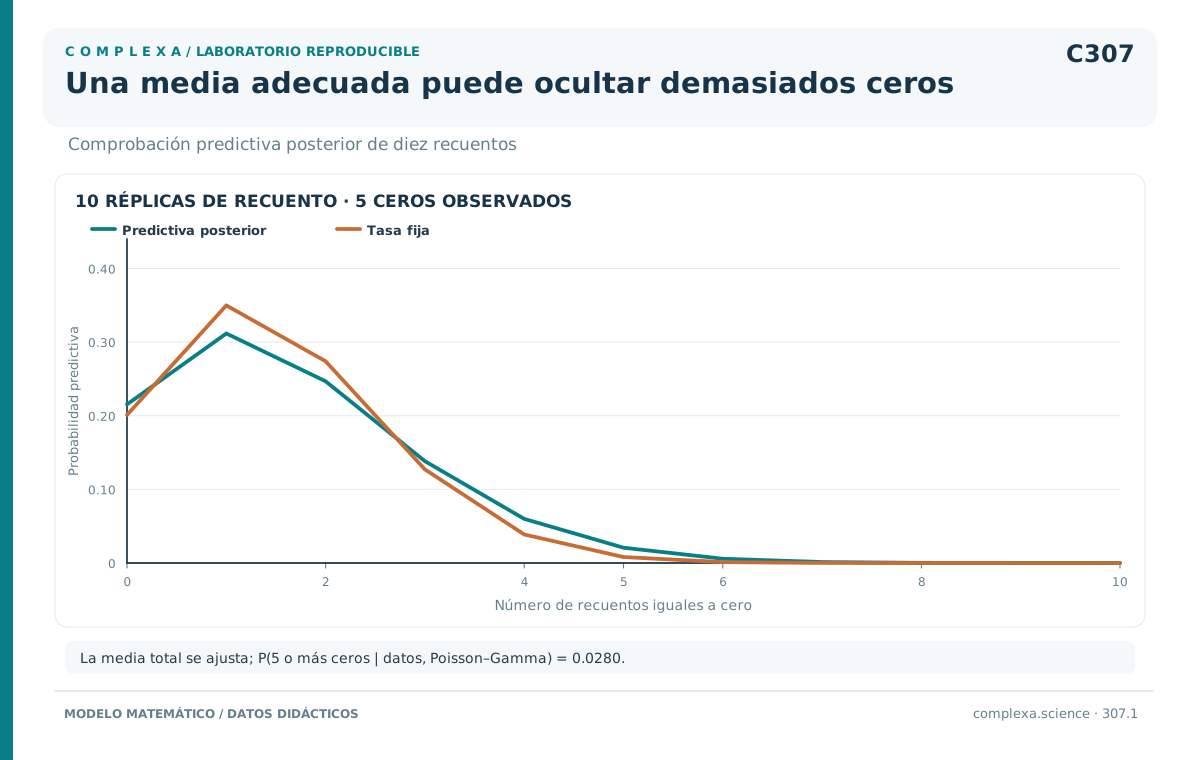
Retomemos la serie de cinco ceros y cinco cuatros como recuentos condicionalmente independientes con una tasa común , a la que se asigna una previa gamma de forma uno y tasa uno. En la parametrización de forma y tasa que usamos, la media de la gamma es el cociente entre ambos parámetros. Tras observar diez recuentos que suman veinte, la distribución posterior de es gamma de forma 21 y tasa 11.
La tasa posterior media vale , aproximadamente 1,91, que es también el valor esperado de la media de una réplica de diez observaciones. La varianza predictiva de esa media es aproximadamente 0,3645 y reúne una contribución de 0,1909 debida a la variación Poisson media y otra de 0,1736 debida a la incertidumbre posterior de la tasa. Si todas las réplicas se simularan con la tasa fijada en 1,91, la segunda contribución desaparecería.
Como estadísticos pueden elegirse la suma de los recuentos, el número de ceros y la varianza muestral calculada con divisor , cuyos valores observados son, respectivamente, veinte, cinco y . Las réplicas posteriores dan a cada estadístico su propia distribución.
| Propiedad comprobada | Valor observado | Probabilidad predictiva posterior de igualarlo o superarlo |
|---|---|---|
| Suma de diez recuentos | 20 | 0,4422 |
| Número de ceros | 5 | 0,0280 |
| Varianza muestral | 4,4444 | Aproximadamente 0,0331 |
Las dos primeras probabilidades se calcularon con la distribución predictiva correspondiente y una integración numérica. La tercera se estimó con un millón de réplicas independientes y tiene un error estándar de Monte Carlo de aproximadamente 0,00018. Todas son resultados calculados para el ejercicio. En las probabilidades de cola se incluyeron los empates, una decisión que tiene consecuencias cuando los estadísticos son discretos.
Ese error de Monte Carlo mide únicamente la precisión numérica del cálculo. Con diez mil réplicas sería aproximadamente diez veces mayor. Al aumentar las simulaciones se estima mejor la probabilidad definida, que sigue apoyándose en las mismas observaciones reales y en la misma discrepancia. Si las muestras posteriores están correlacionadas, el número efectivo de simulaciones puede ser menor que el de iteraciones guardadas.
Inspeccionar algunas réplicas completas también es útil. Si todos los periodos de cada réplica contienen el mismo recuento, quizá se haya repetido una misma extracción por un error de programación. Cuando la suma simulada es correcta pero las posiciones nunca varían, puede haberse conservado inadvertidamente parte de la serie observada. Estas verificaciones del generador complementan el cálculo agregado de las probabilidades y ayudan a reconstruir qué procedimiento produjo la tabla.
La suma observada ocupa una posición corriente en su distribución predictiva, mientras que pocas réplicas presentan al menos cinco ceros o una dispersión tan elevada (el número esperado de ceros bajo la predictiva posterior es aproximadamente 1,61). El modelo puede acomodar el volumen total de eventos y reproducir mal su reparto entre periodos.
Estas discrepancias sugieren varias hipótesis. Puede haber periodos con tasas distintas, dependencia temporal o una diferencia entre periodos en que el proceso está activo y periodos en que está inactivo. También puede existir un mecanismo de registro que produzca ceros. La tabla es compatible con todas ellas. Para distinguirlas servirían covariables, información sobre la observación y patrones temporales que todavía no se han utilizado.
Estadísticos que conservan el problema de interés
Una discrepancia resume un aspecto observable que el modelo debería reproducir para su uso previsto, de modo que su elección tiene que ligar esa característica con una consecuencia del modelo. Si interesa la saturación de un servicio, el máximo de una serie o la duración de los episodios intensos puede ser más informativo que la media. Si interesa la desigualdad entre grupos, una distribución global puede ocultar el patrón decisivo.
Los estadísticos pueden depender también de los parámetros, como ocurre con esta discrepancia para recuentos Poisson,
En cada iteración predictiva se calculan y con el mismo valor posterior de la tasa en ambos miembros, de manera que los datos y su réplica se comparan frente a una realización común del parámetro. Evaluar cada miembro con una tasa diferente añadiría una diferencia ajena al contraste definido.
Esta discrepancia acumula desviaciones estandarizadas y puede señalar un exceso de variación, pero al sumar se pierden la localización y el orden. Dos series con el mismo conjunto de valores tienen la misma discrepancia aunque una alterne continuamente y la otra forme bloques largos, por lo que la reducción a un número debe acompañarse de una inspección que conserve las estructuras relevantes.
En datos continuos, la comparación de cuantiles puede indicar si falla el centro, la asimetría o las colas. En una serie temporal lo razonable es conservar los tiempos y comprobar autocorrelaciones o duraciones. En un modelo espacial, el promedio global puede ser correcto y coexistir con errores agrupados en determinadas zonas. Unas pocas comprobaciones ligadas a supuestos sustantivos son preferibles a una larga lista de índices intercambiables.
La discrepancia necesita además una escala interpretable. Con una muestra enorme puede detectarse una desviación diminuta que carece de consecuencias para la tarea, mientras que otra, difícil de detectar con pocos datos, puede ser grave si afecta a un evento costoso. Por eso la probabilidad de cola, que sitúa lo observado dentro de una referencia, se acompaña de la magnitud del error, que informa de sus consecuencias.
Cuando se examinan muchos estadísticos después de observar la muestra, alguno puede salir extremo por azar. Esa exploración puede servir para descubrir una estructura omitida, pero el hallazgo requiere después una comprobación dirigida, una simulación del proceso de selección o datos adicionales, según el tipo de afirmación que se quiera sostener. Si se registra qué motivó cada comprobación, más tarde podrá distinguirse el descubrimiento de su confirmación.
Qué significa una probabilidad predictiva posterior
Para una discrepancia , una definición habitual es
Esta probabilidad se calcula bajo el modelo, con parámetros extraídos de su distribución posterior y réplicas generadas con ellos. No es la probabilidad de que el modelo sea verdadero. Tampoco coincide por definición con la proporción de estudios en los que se rechazaría un modelo correcto con un umbral determinado, una interpretación que exige estudiar la distribución del propio bajo un mecanismo de repetición.
Meng (1994) analizó las propiedades de estos valores predictivos y mostró por qué la referencia uniforme habitual de ciertos contrastes clásicos no se les aplica automáticamente. Como los datos intervienen tanto en la distribución posterior como en la discrepancia observada, el comportamiento resultante depende del modelo, de la previa y del estadístico. En muchos casos los valores se concentran hacia el centro, pero su distribución tiene que analizarse en cada problema concreto.
Un ejemplo extremo hace visible la diferencia. Supongamos observaciones normales independientes con media desconocida y varianza conocida . Con una previa plana para , entendida como referencia impropia, la posterior es propia, con media y varianza . Si se replica una muestra del mismo tamaño, su media predictiva posterior sigue
La probabilidad de que la media replicada sea al menos la observada es exactamente 0,5, cualquiera que sea la muestra, porque el parámetro de localización ya acomodó la característica que se vuelve a examinar. Esa comprobación es insensible a cualquier discrepancia en la forma de la distribución o en el orden de las observaciones. Con una previa propia cada vez más amplia el comportamiento se aproxima a este, aunque la igualdad exacta corresponde a la formulación declarada.
El ejemplo separa además dos requisitos. Una posterior propia puede dar lugar a una predictiva posterior bien definida mientras la predictiva previa que corresponde a la previa plana carece de normalización. Cada operación necesita, por tanto, su propia distribución de referencia y la misma previa impropia no sirve para simular indiscriminadamente todos los procedimientos mencionados.
Hjort, Dahl y Steinbakk (2006) desarrollaron una calibración que compara el valor predictivo observado con la distribución de esos valores bajo el mecanismo predictivo previo, una referencia que integra parámetros y datos según la previa y el modelo. La uniformidad que se obtiene, bajo continuidad, es marginal respecto de ese mecanismo y puede fallar para un valor fijo del parámetro. Esta diferencia interviene en la interpretación de las tasas de error y explica que calibrar pueda requerir una simulación dentro de otra.
Condicionar cambia lo que se está comprobando
El orden de la serie inicial puede examinarse conservando exactamente sus valores. Bajo intercambiabilidad, una vez fijado que hay cinco ceros y cinco cuatros, todas las posiciones posibles de los cinco ceros entre los diez lugares son equiprobables. Existen ordenaciones distintas y solo dos de ellas, la que coloca todos los ceros antes de todos los cuatros y la inversa, tienen una única transición entre valores.
Si el estadístico es el número de cambios entre observaciones consecutivas, la probabilidad condicionada de obtener uno o menos es , aproximadamente 0,00794. La serie didáctica presenta precisamente un cambio. Este cálculo examina una estructura que la media, la varianza y el número de ceros no conservan.
La referencia es ahora una distribución de permutaciones condicionada en el conjunto de valores, distinta de la predictiva posterior Poisson de la tabla. Al condicionar se eliminan de la comparación la abundancia de ceros y la dispersión, con lo cual el contraste puede localizar una discrepancia temporal pero ya no sirve para evaluar si cinco ceros eran plausibles, puesto que esa propiedad queda fija en todas las réplicas.
Interpretar este resultado exige justificar la intercambiabilidad. Si las observaciones pertenecen a días laborables y festivos, permutarlas libremente puede destruir una diferencia conocida que debía incorporarse al diseño. Con intervalos de distinta duración cambian además las oportunidades de registrar eventos. Una simulación condicionada puede conservar calendarios, exposiciones o bloques, siempre que se declare qué hipótesis justifica intercambiar los restantes componentes.
Condicionar es una manera de dirigir la pregunta. Al diseñar la réplica se decide qué variación pertenece al objeto de estudio y cuál es contexto. En una comparación entre centros, conservar los tamaños muestrales evita confundir la variación del resultado con la variación en la cantidad de observaciones. Conservar los totales de cada centro, en cambio, impediría detectar un fallo que afectara precisamente a esos totales.
Replicar personas conocidas o grupos nuevos
En un modelo jerárquico aparecen varias capas de variación. Un centro puede tener un efecto propio, las personas del centro pueden diferir entre sí y sus mediciones pueden fluctuar con el tiempo. Una comprobación que vuelva a generar observaciones para los mismos centros puede conservar, para cada centro, el efecto extraído de la posterior. Para un centro nuevo, en cambio, debe generarse un efecto nuevo a partir de la distribución poblacional estimada.
La primera comprobación pregunta si el modelo describe las observaciones de unidades que ya conoce y la segunda evalúa sus implicaciones sobre unidades que no contribuyeron con datos propios. Ambas integran incertidumbre, pero con información distinta. Un efecto muy flexible puede acomodar bien las particularidades de cada centro existente mientras una distribución poblacional inadecuada produce malas predicciones para centros nuevos.
Predecir nuevas mediciones de personas conocidas es una situación intermedia. La historia previa de cada persona informa sobre su efecto individual. Cuando se predice a alguien recién incorporado, esa historia no está disponible. Si la evaluación mezcla ambas tareas, puede atribuir a la capacidad de generalización una ventaja que procede de haber observado antes al individuo.
Las comprobaciones por grupos también pueden localizar fallos que se compensan al agregar. Gabry y colaboradores (2019) comparan características predictivas dentro de regiones además de examinar la distribución conjunta. Una mediana global correcta puede coexistir con medianas demasiado altas en unos grupos y demasiado bajas en otros. Separar los grupos conserva la dirección de los errores y ayuda a investigar si falta una covariable o si la combinación parcial es insuficiente.
El proceso de selección merece la misma atención. Si solo se observa a las personas que continúan participando, una réplica limitada a sus registros puede reproducir bien sus resultados y omitir la pérdida de seguimiento. Cuando el abandono depende del estado no observado, una comprobación restringida a los datos disponibles deja sin examinar esa dependencia. Para estudiarla se necesita representar el mecanismo de observación o contrastarlo con información externa, ya que un buen ajuste de los valores registrados es compatible con mecanismos de selección muy distintos.
Distribuciones individuales correctas y combinaciones equivocadas
Comprobar cada variable por separado deja abierta la dependencia entre ellas. En un ejemplo normal con dos resultados futuros, ambos de media cero y varianza uno, el modelo los trata como independientes. El proceso que genera los datos tiene esas mismas distribuciones individuales, pero una correlación de 0,90. Para aislar el efecto de especificar mal la dependencia se suponen conocidos los parámetros.
La predicción marginal de cualquiera de los resultados es correcta y, si cada observación se transforma mediante su función de distribución predictiva, los valores obtenidos son uniformes en cada margen. Sin embargo, el modelo asigna a la suma una varianza de dos, cuando en el proceso generador es . Esa diferencia solo la descubre una comprobación dirigida al total, porque las dos distribuciones individuales no contienen esa información.
Bajo independencia, el intervalo central aproximado del 95 % para la suma va de −2,772 a 2,772, pero en el proceso correlacionado su cobertura es aproximadamente el 84,5 %. Los intervalos marginales conservan su cobertura nominal y el del total es demasiado estrecho. El error afecta directamente a cualquier uso que dependa de la carga conjunta o de la coincidencia de dos resultados.
Para investigarlo se necesitan réplicas de parejas completas. Generar cada componente por separado a partir de una distribución marginal correcta reproduciría precisamente la independencia que se pretende examinar. La simulación del modelo debe conservar su estructura conjunta. El estadístico puede ser la suma, la diferencia o la frecuencia de episodios simultáneos. Comparando varias de estas funciones de las parejas puede localizarse el tipo de dependencia omitida.
Gabry y colaboradores (2019) señalan una limitación relacionada de las comprobaciones basadas en transformaciones predictivas univariadas, que examinan las distribuciones marginales y dejan sin evaluar buena parte de la distribución conjunta. La forma del histograma puede revelar problemas de localización o dispersión marginal y ser a la vez poco informativa sobre las relaciones entre observaciones. En series temporales, una distribución de recuentos bien reproducida puede coexistir con duraciones de episodios mal representadas.
Con una dependencia negativa, dos componentes pueden compensarse y producir un total menos variable que el previsto bajo independencia. Un modelo que ensancha todas las distribuciones individuales para acomodar un total demasiado variable podría corregir la suma a costa de empeorar cada margen. Por eso las comprobaciones deben mostrar qué cambió en el total y en cada margen, información que se pierde si la mejora se resume con un único intervalo.
Verificar el cálculo es otra tarea
Antes de interpretar una discrepancia conviene comprobar que las simulaciones corresponden realmente al modelo escrito. Un error de parametrización, como confundir la tasa y la escala de una gamma, cambia la distribución generada. También pueden surgir errores al ordenar las observaciones, al aplicar una transformación inversa o al simular el proceso de medición. Las réplicas dan ocasión de detectar esos fallos, aunque no siempre es posible distinguirlos de una especificación sustantiva inadecuada.
Los diagnósticos de cadenas de Monte Carlo se refieren a la exploración de la distribución posterior. Si una cadena no recorre regiones relevantes, sus réplicas pueden recoger solo una parte de la incertidumbre aunque la gráfica predictiva tenga un aspecto razonable. De manera recíproca, unas cadenas bien comportadas pueden calcular con precisión la posterior de un modelo que no reproduce los datos.
La calibración basada en simulación, desarrollada por Talts y colaboradores (2018), separa estas cuestiones mediante un experimento repetido en el que se extrae un parámetro de la previa, se generan datos con él, se ejecuta el algoritmo de inferencia sobre esos datos y se ubica después el parámetro generador entre las muestras posteriores obtenidas. Con muestras posteriores exactas e independientes y sin empates, el rango así obtenido sigue una distribución uniforme discreta.
El procedimiento conoce la verdad simulada porque la produjo al inicio, de modo que sus desviaciones pueden señalar problemas del cálculo o diferencias entre el código generador y el de inferencia. La dependencia entre muestras posteriores y los empates requieren un tratamiento propio. Un histograma aparentemente uniforme para algunos parámetros es compatible con errores en otras funciones de la posterior, ya que la capacidad de detectar fallos depende de lo que se examine y del número de repeticiones.
Todo este ejercicio transcurre dentro del modelo generador. Si el modelo omite una dependencia que existe en el mundo, los datos simulados también la omitirán y la calibración computacional puede ser satisfactoria. Comprobar esa dependencia exige volver a las observaciones reales o a información sustantiva externa, que es la vía propia de la adecuación empírica, complementaria de la que verifica el cálculo.
Comprobación interna y predicción sobre datos reservados
Una comprobación predictiva posterior usa el conjunto observado para ajustar la distribución desde la que genera las réplicas, algo útil para localizar formas concretas de falta de ajuste. Cuando la pregunta es cómo se comportará el procedimiento ante datos que no contribuyeron al ajuste, lo indicado es reservar observaciones o usar una validación que reproduzca esa situación.
En una partición de entrenamiento y evaluación, la posterior se calcula con el primer conjunto y los estadísticos del segundo se comparan con réplicas generadas a partir de esa posterior. La simulación debe representar el tamaño, el diseño y la dependencia de las observaciones reservadas. Predecir diez observaciones y compararlas con un estadístico calculado sobre cien modifica su variabilidad y puede producir una discrepancia artificial.
Li y Huggins (2026) desarrollaron comprobaciones predictivas con particiones y establecieron resultados de calibración asintótica bajo condiciones explícitas. Su procedimiento conserva la comparación con datos simulados y separa el ajuste de la evaluación. Las garantías de uniformidad de los valores de contraste dependen de propiedades del modelo, del estadístico y del modo en que crecen las particiones, condiciones que exigen bastante más que dividir la muestra en dos.
La forma de reservar datos define el alcance de la predicción y depende de la estructura del problema, que determina qué información puede utilizarse. Separar observaciones al azar puede ser razonable para unidades intercambiables. Cuando se predicen periodos futuros, entrenar con observaciones posteriores al periodo evaluado suministra información que no existiría al emitir la predicción. Para evaluar centros nuevos deben reservarse centros completos.
El conjunto de evaluación también tiene que preservarse durante el desarrollo. Si se inspecciona repetidamente para elegir variables, previas o discrepancias, termina influyendo en el modelo aunque nunca aparezca directamente en la verosimilitud de entrenamiento. Puede seguir siendo útil para diagnosticar, pero su resultado deja de ser una evaluación independiente del proceso completo y la comparación de modelos tendrá que contabilizar esa adaptación.
De la discrepancia a una observación que distinga explicaciones
La serie inicial sugiere al menos dos modificaciones del modelo. Admitir heterogeneidad entre periodos aumenta la dispersión de los recuentos y puede reproducir la abundancia de ceros y de valores altos, aunque sin explicar por qué aparecen en bloques. Un cambio de régimen entre los cinco primeros periodos y los cinco últimos incorpora directamente esa estructura temporal.
Para evaluarlas, a las comprobaciones de suma, ceros y varianza se añadiría la duración de las secuencias o el número de cambios. Como un modelo podría mejorar unos estadísticos y empeorar otros, cada modificación se juzgaría según las propiedades que exija la aplicación, ya sea estimar el volumen total, anticipar episodios de inactividad o predecir cuándo llegará una concentración de eventos.
Haría falta además información capaz de separar las explicaciones. Con un registro de horarios, interrupciones del sensor o cambios de procedimiento podrían atribuirse algunos bloques a condiciones observadas. Otra secuencia completa mostraría si la persistencia temporal reaparece. Si los nuevos datos presentan periodos mezclados y dispersos, el supuesto de un cambio permanente perdería apoyo; si repiten bloques prolongados, una réplica que solo añada variación independiente seguiría dejando fuera la característica que motivó la revisión.
Referencias
Gabry, J., Simpson, D., Vehtari, A., Betancourt, M., y Gelman, A. (2019). Visualization in Bayesian workflow. Journal of the Royal Statistical Society: Series A, 182(2), 389–402. https://doi.org/10.1111/rssa.12378
Gelman, A., Meng, X.-L., y Stern, H. (1996). Posterior predictive assessment of model fitness via realized discrepancies. Statistica Sinica, 6, 733–807, con discusión. https://sites.stat.columbia.edu/gelman/research/published/A6n41.pdf
Hjort, N. L., Dahl, F. A., y Steinbakk, G. H. (2006). Post-processing posterior predictive p values. Journal of the American Statistical Association, 101(475), 1157–1174. https://doi.org/10.1198/016214505000001393
Li, J., y Huggins, J. H. (2026). Calibrated model criticism using split predictive checks. Journal of the American Statistical Association, publicación anticipada en línea, 1–12. https://doi.org/10.1080/01621459.2026.2649585
Meng, X.-L. (1994). Posterior predictive p-values. The Annals of Statistics, 22(3), 1142–1160. https://doi.org/10.1214/aos/1176325622
Talts, S., Betancourt, M., Simpson, D., Vehtari, A., y Gelman, A. (2018). Validating Bayesian inference algorithms with simulation-based calibration. arXiv, prepublicación. https://doi.org/10.48550/arXiv.1804.06788