Una columna titulada «atención» contiene números enteros. Quien recibe el archivo puede calcular su media, relacionarla con otras columnas y describir sus cambios sin que ninguna de esas operaciones revele cómo se produjeron los números, que quizá cuenten respuestas omitidas, quizá sumen afirmaciones de un cuestionario o quizá registren el tiempo hasta pulsar una tecla. El nombre de la columna propone una interpretación cuya base observacional todavía está por reconstruir.
Consideremos un estudio ficticio sobre la dificultad para sostener la atención durante diez minutos de lectura. El equipo prepara un texto con veinte ocasiones en las que debe marcarse una señal y cuenta las marcas omitidas, de manera que una puntuación alta significará más omisiones. También pregunta por la experiencia de distracción. El dispositivo, las puntuaciones y todos los cálculos que siguen son didácticos y no describen una prueba validada ni fijan criterios diagnósticos.
Contar las omisiones parece una operación sencilla. Interpretarlas como dificultad atencional, en cambio, añade una afirmación causal y conceptual, porque una persona puede omitir marcas por no haber entendido la instrucción, por no reconocer la señal o porque decidió dar preferencia a la comprensión del texto. Otra puede marcar todas las señales y apenas recordar lo leído. Para saber qué representa la puntuación hay que examinar cómo deja la tarea que el fenómeno de interés influya en la respuesta.
Del fenómeno a una operación observable
El constructo es la característica que una teoría pretende describir o explicar. En este ejemplo necesitamos especificar qué entenderemos por sostener la atención, durante qué actividad y en qué condiciones. Si el interés se limita a detectar señales durante una lectura breve, la tarea guarda una relación relativamente próxima con la afirmación. La distancia aumenta si se quiere inferir el funcionamiento cotidiano de una persona en el trabajo, pues entonces hacen falta razones para generalizar desde esa situación particular.
La operación de medida concreta el procedimiento. Incluye el texto presentado, el formato de las señales, las instrucciones y el tiempo disponible, junto con la regla que transforma una conducta en un dato, es decir, qué se cuenta como marca válida, cómo se trata una respuesta tardía y qué ocurre si la persona interrumpe la actividad. Una omisión, por tanto, solo queda definida cuando hay una oportunidad de respuesta claramente identificada.
La puntuación es el resultado de aplicar esa regla. Veinte oportunidades con cinco omisiones producen un recuento de cinco, que dividido por veinte da una proporción de 0,25. Ambas expresiones describen el mismo registro de oportunidades sin marca en esta tarea, algo distinto de que la persona posea una cuarta parte de una supuesta cantidad máxima de desatención. Del mismo modo, el cero del recuento indica ausencia de omisiones en esa tarea y es compatible con otras dificultades atencionales.
La interpretación puede formularse como una afirmación contrastable según la cual, bajo estas condiciones y si los demás procesos que afectan a la respuesta se mantienen comparables, un aumento de la dificultad para detectar las señales debería producir más omisiones, formulación que obliga a considerar explicaciones alternativas. Si empeora la visibilidad de las señales y aumentan las omisiones, el resultado no separa un cambio de atención de uno de percepción visual, una diferencia que el diseño debe resolver con información adicional.
Cronbach y Meehl (1955) ligaron la validación de constructos al examen de las afirmaciones que se hacen sobre las puntuaciones y a la red teórica que las relaciona con otros fenómenos. En su planteamiento, asignar un nombre a una suma es solo el punto de partida, porque la interpretación debe producir expectativas que puedan confrontarse con evidencia. Un resultado inesperado puede cuestionar la teoría, la operación elegida o algún supuesto auxiliar del estudio.
Los indicadores pueden representar su objeto de maneras distintas. Un índice formado por tiempo de viaje, número de transbordos y coste del trayecto puede definir una combinación de barreras de acceso sin necesidad de que sus componentes sean efectos intercambiables de una causa latente común. Un modelo que trata varias respuestas como manifestaciones de una misma capacidad, en cambio, sí establece relaciones esperadas entre ellas. Elegir un modelo reflectivo para cualquier suma de variables impone, por eso, supuestos que van más allá de la mera existencia del índice.
Esta distinción cambia cómo se interpreta retirar un componente. Si eliminamos el coste económico de un índice de barreras, podemos modificar el contenido de lo que se está describiendo aunque aumente la correlación entre los componentes restantes. Retirar un ítem redundante de una escala reflectiva, por el contrario, tal vez conserve el atributo buscado con menos preguntas. Para decidirlo hay que volver a la definición y al mecanismo de respuesta, además de inspeccionar los coeficientes estadísticos.
Qué afirmación se está validando
Kane (2013) propone explicitar el argumento que conecta respuestas, puntuaciones e interpretaciones y usos, ya que cada paso incorpora supuestos que requieren respaldo. Justificar que una puntuación resume el desempeño en una tarea es distinto de justificar su uso para decidir una intervención, un segundo uso con consecuencias y exigencias que la primera interpretación puede no cubrir, de modo que la evidencia necesaria depende de lo que se pretende hacer con el resultado.
En nuestro estudio pueden distinguirse varios pasos. Primero debe verificarse que el programa cuenta correctamente las respuestas y después que el resultado no varía de manera arbitraria con detalles irrelevantes de la administración. Hablar de dificultad atencional obliga a examinar si la tarea y las respuestas recogen ese fenómeno y qué otras causas pueden producirlas. Para comparar momentos o grupos será necesario comprobar también que la relación entre fenómeno y puntuación siga siendo comparable.
Cada uno de estos pasos puede fallar por separado. Un programa puede contar las omisiones sin errores y registrar, aun así, un comportamiento poco informativo sobre el constructo. Una tarea conceptualmente adecuada puede administrarse de manera tan variable que impida distinguir diferencias pequeñas. Una puntuación útil para comparar promedios de grupos, por último, puede ser demasiado imprecisa para decidir sobre una persona.
La teoría de la validez contiene desacuerdos reales. Borsboom, Mellenbergh y van Heerden (2004) defienden una concepción centrada en que el atributo exista y en que sus variaciones causen variaciones en los resultados de medida. Ese énfasis en el mecanismo causal la separa del enfoque basado en argumentos sobre interpretaciones y usos, una diferencia que se perdería si ambos planteamientos se reunieran en una definición única aceptada sin discusión.
Ambas perspectivas obligan a concretar el ejemplo. Si una interrupción cambia el número de omisiones, necesitamos averiguar por qué, ya que pudo afectar al proceso atencional que se quería medir, al tiempo efectivo disponible o a la comprensión de las instrucciones. Calificar de «válido» al instrumento deja intacta esa pregunta, que solo puede responderse con evidencia capaz de discriminar entre explicaciones que llevarían a conclusiones distintas.
La adecuación de contenido se examina antes y durante la recogida de datos. Personas familiarizadas con el fenómeno pueden revisar si las situaciones propuestas cubren la definición. Los participantes del grupo de interés, por su parte, pueden explicar cómo interpretan las instrucciones. En el ejemplo, preguntar a alguien por qué dejó una marca sin hacer puede revelar que la consideró incompatible con una lectura cuidadosa, respuesta que obliga a revisar el procedimiento antes de atribuir toda omisión a una dificultad personal.
El proceso de respuesta interviene también en los cuestionarios. Dos personas pueden elegir «a menudo» con periodos de referencia distintos, una comparándose con su propia semana anterior y otra con lo que considera habitual entre sus compañeros, de modo que un formulario idéntico puede dar lugar a operaciones psicológicas diferentes. Si la interpretación depende de una frecuencia durante un periodo concreto, las instrucciones y las categorías deben facilitar esa lectura.
Asignar números a categorías ordenadas introduce otra decisión. Si las respuestas van de «nunca» a «siempre» y se codifican de cero a tres, su orden está definido y la igualdad entre los pasos queda sin demostrar. Sumarlas puede ser una convención útil, pero interpretar cada punto adicional como la misma cantidad del atributo necesita más evidencia, ya que una transformación estrictamente creciente conserva el orden de cada ítem y puede cambiar el orden de sus sumas.
Por ejemplo, una persona responde tres y cero en dos ítems y otra responde dos y dos, con sumas originales de tres y cuatro. Si recodificamos cada categoría mediante su cuadrado, sin cambiar el orden dentro de ningún ítem, las sumas pasan a nueve y ocho. La comparación se invierte. Las puntuaciones sumadas siguen siendo utilizables, pero su interpretación incorpora una regla de escala que va más allá del orden de las categorías. Un modelo de respuesta puede dar otra representación, cuyos supuestos también deberán contrastarse.
Repetir una medida y observar diferencias
La teoría clásica de los tests expresa una puntuación observada como , donde es la puntuación esperada de una persona a través de repeticiones definidas del procedimiento y es la desviación de una realización respecto a esa expectativa. En la expresión «puntuación verdadera» el adjetivo tiene este significado técnico, de manera que sigue siendo una expectativa distinta de cualquier observación directa del fenómeno y puede contener componentes sistemáticos ajenos al constructo.
La elección de las repeticiones forma parte de la definición. Repetir exactamente el mismo texto puede introducir recuerdo, mientras que utilizar otro texto pretende generalizar a una familia de formas y exige que esa familia mantenga las condiciones relevantes. Repetir un mes después añade posibles cambios de la persona. Una discrepancia entre ocasiones puede reflejar entonces error de medida, cambio real o ambas cosas, que el calendario no separa automáticamente.
Bajo los supuestos clásicos de error con media cero y sin correlación con , la varianza observada se descompone como y la fiabilidad poblacional correspondiente es
En una escala numérica didáctica en la que la varianza entre puntuaciones esperadas es 16 y la varianza del error es cuatro, la varianza observada vale veinte y la fiabilidad es 0,8. Esa cifra expresa una proporción de varianza bajo el modelo y en esa población, sin indicar que cada puntuación individual sea correcta en un 80 % ni que el instrumento mida un 80 % del constructo.
El error típico de medida de este modelo es dos unidades, la raíz cuadrada de cuatro. Si dos ocasiones tienen errores independientes de esa misma varianza y la puntuación esperada permanece igual, la diferencia entre observaciones tiene varianza ocho y desviación típica aproximada de 2,83, con lo cual una variación observada de tres unidades puede aparecer sin cambio de . Para cuantificar cuán excepcional sería, necesitamos además una distribución de errores y comprobar que la independencia sea razonable.
Con errores normales de esos parámetros, aproximadamente el 95 % de las diferencias debidas únicamente al error queda entre −5,54 y 5,54, aunque la aproximación normal puede ser inadecuada cerca de los límites de una escala o cuando los errores son muy asimétricos. Ese intervalo, consecuencia del modelo, describe la precisión con que puede detectarse una diferencia. La importancia funcional de esa diferencia es otra pregunta, que requiere un criterio propio.
La misma precisión puede dar otra fiabilidad en una población más homogénea. Si la varianza entre puntuaciones esperadas baja de 16 a uno y la del error se mantiene en cuatro, la fiabilidad baja a 0,2 con un error típico que sigue siendo dos. La caída a la cuarta parte se debe a que cambió la relación entre la variación que queríamos distinguir y la debida al error, sin que el procedimiento cometa errores cuatro veces mayores.
Promediar repeticiones puede ayudar cuando los errores son independientes y el atributo se mantiene estable. Cuatro mediciones con varianza de error cuatro dejan una varianza de error de uno en el promedio, cuya fiabilidad, con varianza verdadera 16, sería , aproximadamente 0,941. Si los errores comparten una correlación de 0,5 entre ocasiones, la varianza de error del promedio es 2,5 y la fiabilidad queda cerca de 0,865, porque la parte del error que se repite en cada ocasión, sea sesgo o interferencia, persiste en el promedio.
La precisión de un promedio de personas plantea un problema distinto. Si cien puntuaciones contienen errores independientes de varianza cuatro, el componente de error de la media tiene varianza 0,04 y desviación típica 0,2. En una comparación de dos grupos así medidos, este componente daría por sí solo una desviación típica de la diferencia cercana a 0,283. El cálculo aísla exclusivamente el error de medición supuesto y deja fuera la incertidumbre de muestreo de las personas y otras fuentes de variación.
Un desplazamiento sistemático de tres unidades en el programa de un grupo permanecería completo en su promedio por muchas personas que incorporáramos y podríamos estimar con gran precisión una diferencia producida por el procedimiento. Una muestra grande reduce ciertos componentes de incertidumbre y deja intactas tanto una interpretación equivocada como una comparación sesgada. Al planificar la recogida hace falta saber qué componente limita la inferencia, ya que aumentar participantes, repetir medidas y revisar el instrumento responden a problemas diferentes.
Fiabilidad alta sin un único fenómeno
Un coeficiente de consistencia interna resume relaciones entre ítems y deja sin inspeccionar el proceso que generó las respuestas. Sijtsma (2009) analiza las limitaciones de interpretar el alfa de Cronbach como prueba de estructura interna o de exactitud individual. Bajo supuestos de error apropiados, alfa puede tomarse como una cota inferior de la fiabilidad, a la que solo iguala cuando se cumplen condiciones adicionales de equivalencia entre las puntuaciones verdaderas de los ítems.
Que el número calculado no demuestre la validez del constructo puede verse con un modelo algebraico construido para la ocasión. Tomemos veinte ítems continuos, diez de los cuales dependen de un factor y diez de otro factor , dos atributos distintos con varianza uno e independientes entre sí. Cada ítem suma a su factor un error de varianza 0,25, independiente de los factores y de los demás errores.
Cada ítem tiene varianza 1,25. Dos ítems del mismo grupo tienen covarianza uno y dos de grupos diferentes, covarianza cero. La varianza de la suma de los veinte, 205, reúne los veinticinco que proceden de sumar sus varianzas y los 180 que se obtienen al contar dos veces las noventa covarianzas internas distintas. El alfa de una suma de ítems se calcula mediante
Con se obtiene , un valor alto en un modelo que contiene, por construcción, dos factores independientes. Un alfa elevado es así compatible con una estructura bidimensional y nada dice sobre si o corresponden al fenómeno que un investigador deseaba medir.
El ejemplo deja en pie las puntuaciones multidimensionales, ya que una suma puede estar justificada como índice de un dominio amplio si su significado y su regla de composición están claros. Lo que descarta es usar alfa para suplir esa justificación, pues el mismo coeficiente puede acompañar estructuras que requieren interpretaciones distintas.
Examinar la estructura interna implica proponer un modelo de relaciones entre ítems y confrontarlo con los datos. En un modelo factorial, las cargas describen cómo se relaciona cada indicador con los factores postulados y los residuos recogen la variación que esos factores no explican. Un ajuste adecuado respalda ciertas relaciones estadísticas bajo los supuestos del modelo, pero nombrar el factor y atribuirle un mecanismo psicológico requiere conectar esas relaciones con el contenido y con evidencia externa.
Distinguir personas o cambios requiere también que exista variación observable. Si la tarea es tan fácil que todos registran cero omisiones, dos aplicaciones pueden coincidir perfectamente sin ninguna capacidad para ordenar desempeños. Con varianza observada cero se anulan los denominadores de la correlación y de la proporción clásica de fiabilidad, que quedan indefinidas por perfecta que sea la coincidencia entre aplicaciones. La igualdad de las respuestas puede deberse a que el instrumento alcanzó su límite inferior.
En veinte oportunidades, una sola omisión equivale a cinco puntos porcentuales. Aumentar las oportunidades mejora la resolución del recuento, pero puede cambiar el fenómeno si prolonga la tarea y añade fatiga. Bajo un modelo puramente ilustrativo de oportunidades independientes con probabilidad de omisión constante de 0,1, la desviación típica de la proporción es aproximadamente 0,067 con veinte oportunidades y 0,034 con ochenta. Esa mejora calculada presupone que ampliar la tarea conserva la probabilidad y la independencia, condición que debe comprobarse antes de trasladarla a una actividad en la que la concentración cambia con el tiempo.
Eliminar ítems hasta que aumente alfa puede estrechar el contenido y seleccionar preguntas casi repetidas, con el riesgo de dejar fuera una parte relevante si el constructo incluía aspectos diferentes. Flake y Fried (2020) señalan que la falta de transparencia sobre definición, elección de instrumentos, modificaciones y puntuación impide evaluar las inferencias de un estudio. Si se documentan los ítems eliminados y sus razones, cualquier lector puede comprobar qué cambió realmente en la medida.
Dos métodos pueden correlacionar y discrepar siempre
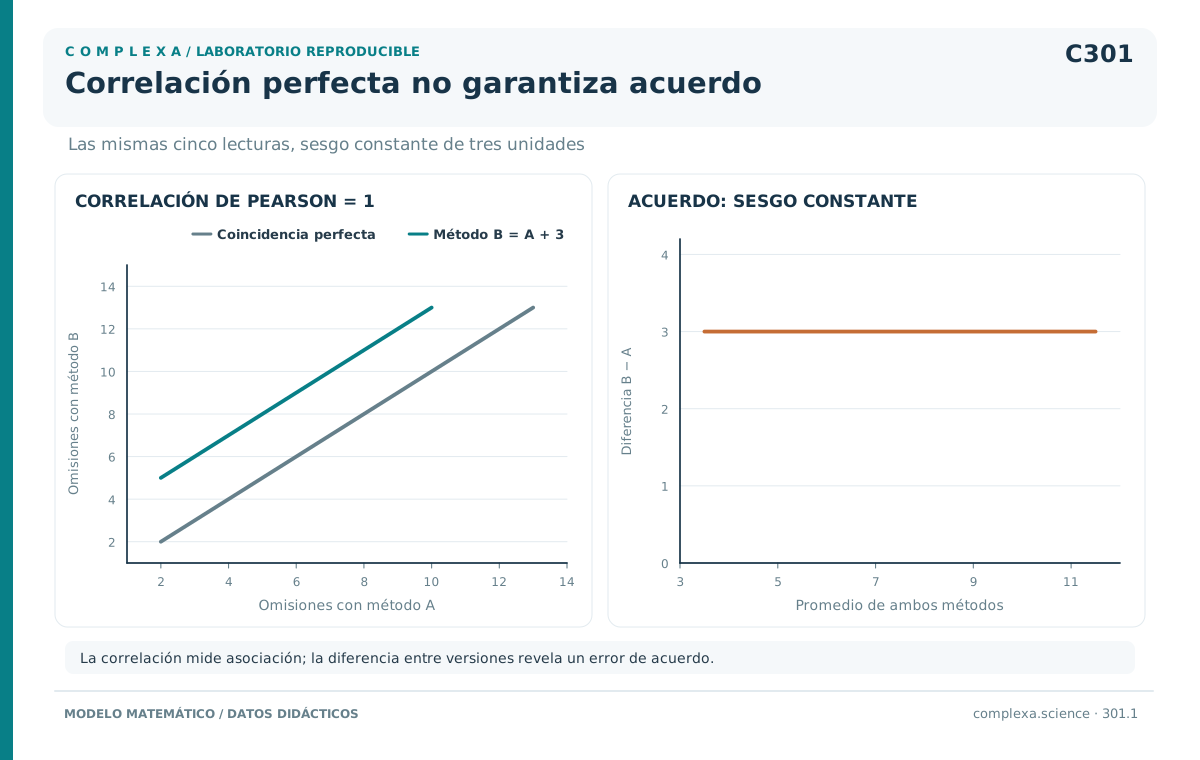
El equipo del estudio ficticio cambia de programa para contar las omisiones y procesa los mismos cinco registros con ambas versiones, A y B, letras que aquí no designan grupos de participantes. La tabla recoge los recuentos.
| Registro | Versión A | Versión B | Diferencia B−A |
|---|---|---|---|
| 1 | 2 | 5 | 3 |
| 2 | 4 | 7 | 3 |
| 3 | 6 | 9 | 3 |
| 4 | 8 | 11 | 3 |
| 5 | 10 | 13 | 3 |
La correlación de Pearson entre ambas columnas es uno, porque las versiones ordenan los registros exactamente igual y mantienen una relación lineal perfecta. Sin embargo, B añade tres omisiones en cada caso. Si las primeras sesiones se procesaron con B y las posteriores con A, el cambio de versión produciría una reducción aparente de tres unidades sin que hubiera cambiado ninguna respuesta.
Bland y Altman (1986) mostraron por qué la correlación entre dos métodos, por alta que sea, mide mal el acuerdo necesario para intercambiarlos, que debe juzgarse por sus diferencias y por la precisión requerida por el uso. En nuestra tabla la diferencia sistemática es evidente, pero en datos reales podrían variar también la dispersión de las diferencias y su relación con el tamaño de la medida.
La repetibilidad podría pasar por alto este problema. Si cada programa reproduce siempre su propio resultado, ambos son perfectamente repetibles sobre esos archivos y el sesgo constante forma parte de su puntuación esperada. Para descubrir cuál de las operaciones está contando algo distinto es más informativa una auditoría del código o una puntuación manual independiente.
Comparar con un método establecido exige saber qué valor tiene como referencia. Si el método antiguo también contiene un sesgo, la coincidencia con él es compatible con que ambos sean inexactos. En algunas magnitudes existen patrones de referencia que admiten contrastes directos, mientras que en los constructos psicológicos suele ser necesario reunir evidencia mediante procedimientos con limitaciones diferentes e interpretar la relación entre dos instrumentos a la luz de esas limitaciones, compartidas o independientes.
Relaciones externas y explicaciones rivales
Supongamos que las omisiones se relacionan con un cuestionario de dificultades de concentración. Esa asociación es compatible con la interpretación propuesta, aunque también puede reflejar condiciones compartidas. Una instrucción que sugiera al participante que ha rendido mal, por ejemplo, podría afectar a su evaluación posterior de la tarea. Cuando los dos registros dependen del mismo proceso ajeno al constructo, su correlación puede ser elevada y no respaldar la interpretación.
Un ejemplo numérico separa esas posibilidades. Sean y dos atributos independientes de varianza uno y sea un efecto de método, independiente de ambos y también de varianza uno, que entra en las dos observaciones como y . Ambas observaciones tienen entonces varianza dos y covarianza uno, de modo que la correlación observada vale 0,5 aunque los atributos de interés no estén relacionados.
En sentido inverso, una relación teórica real puede manifestarse como una correlación débil. Con errores independientes entre medidas y respecto a los atributos, la correlación observada se atenúa según las fiabilidades. En otro cálculo didáctico, si la correlación entre puntuaciones verdaderas fuese 0,5 y las fiabilidades 0,8 y 0,5, la correlación esperada entre observaciones sería aproximadamente 0,316. Corregir una correlación mediante esa fórmula exige comprobar los supuestos que la justifican. Si el modelo causal está equivocado, la medida seguirá siendo inválida después de la corrección.
La evidencia convergente es más informativa cuando procedimientos diferentes deberían relacionarse por razones especificadas previamente. La evidencia discriminante examina distinciones que la teoría necesita conservar. En el caso de la lectura, la pregunta es si las omisiones se explican enteramente por la velocidad de lectura o por dificultades para ver las señales, algo que el equipo puede examinar comparando medidas de esos procesos para delimitar qué interpretación queda respaldada.
También pueden utilizarse manipulaciones que produzcan predicciones distintas. Un cambio en la legibilidad de la señal que deja intacto el texto pone a prueba una vía perceptiva, mientras que una interrupción controlada altera otras condiciones de la tarea. La interpretación depende de si la manipulación afecta solo al proceso pretendido o también a alternativas. Un resultado experimental informa sobre el mecanismo en esas condiciones y deja por validar cada uso futuro de la puntuación.
Una asociación con un resultado posterior puede apoyar un uso predictivo y dejar abierta la explicación. Si un recuento anticipa dificultades en otra tarea, puede ser útil para investigar quién necesita más tiempo aunque no se haya demostrado que mida exclusivamente atención sostenida. Capacidad predictiva, identidad de constructo y causalidad tienen requisitos distintos, por mucho que a veces se atribuyan a la misma correlación.
La escala de comparación también delimita la afirmación. Que las personas con más omisiones informen, en promedio, de más distracción es un resultado entre personas. Que un aumento de distracción dentro de una misma persona produzca el mismo incremento de omisiones es otra afirmación, dado que las diferencias entre personas pueden incluir hábitos de lectura o condiciones persistentes del entorno. Para estudiar cambios individuales se necesitan observaciones repetidas y un modelo que distinga esas fuentes de variación, aun cuando ambos análisis usen el mismo nombre de variable.
Comparar grupos y momentos
El problema de la comparabilidad puede ilustrarse con un indicador continuo y un atributo latente relacionados mediante , donde el error tiene media cero. El intercepto fija el nivel esperado cuando y la carga , cuánto cambia el indicador por una unidad del atributo. Se trata de un modelo ilustrativo, cuya validez para los recuentos de lectura está por demostrar.
Con intercepto diez y carga dos, una media latente de cero produce media observada diez y una media latente de uno produce doce. Una media observada de doce puede aparecer también con media latente cero e intercepto doce, de modo que una diferencia de dos puntos entre grupos es compatible tanto con una diferencia en el atributo como con otra en el funcionamiento del indicador.
En un cuestionario, un cambio en el significado de una expresión puede modificar el nivel de respuesta sin que cambie el atributo, del mismo modo que en una tarea un dispositivo distinto puede alterar los tiempos registrados. Aun con buena fiabilidad dentro de cada grupo, comparar directamente las medias requiere investigar si el procedimiento mantiene la relación pertinente entre indicador y constructo.
Putnick y Bornstein (2016) describen niveles de invariancia en modelos factoriales entre grupos o momentos. La invariancia configural mantiene el patrón de indicadores y factores, la métrica añade la igualdad de cargas y la escalar, en indicadores continuos, la igualdad de interceptos. Con un modelo adecuado y una identificación apropiada, estas condiciones respaldan comparaciones de medias latentes. La invariancia estricta añade igualdad de varianzas residuales, una exigencia que va más allá de lo necesario para esa comparación.
El traslado de estos niveles a otros tipos de datos exige ajustes. En indicadores ordinales se modelan umbrales de respuesta y cambian algunos requisitos de identificación. Nuestro recuento limitado de omisiones puede necesitar un modelo que respete su distribución. Un modelo continuo elegido por comodidad puede dar índices aceptables y dejar sin resolver las propiedades del registro original.
Cuando falla la invariancia, algunas comparaciones pueden seguir siendo posibles si hay indicadores comparables con los que anclar la escala mientras otros parámetros varían. La decisión exige examinar qué contenido conserva ese conjunto y cuánto dependen las conclusiones de las restricciones adoptadas. Liberar parámetros hasta alcanzar un ajuste conveniente, sin explicar qué representan, puede ocultar precisamente las diferencias que el análisis debía investigar.
En una comparación temporal, además, la tarea puede enseñar a responder. La persona puede aprender a reconocer las señales o desarrollar una estrategia que reduzca omisiones. Si el constructo de interés incluye ese aprendizaje, el cambio puede ser pertinente. Si lo que se pretende medir mediante formas equivalentes es otra capacidad estable, la práctica introduce una explicación adicional. La pregunta por el cambio necesita así, además de dos fechas y una resta, una teoría del procedimiento y del fenómeno.
Una documentación que permita reconstruir la inferencia
El informe del estudio debería conservar la definición utilizada, la versión de la tarea, la regla de puntuación y las condiciones de administración. Si un recuento se transforma en una escala de cero a cien, la transformación debe quedar disponible. Cuando una observación se excluye por interrupción, debe saberse qué criterio se aplicó y cuándo se decidió, porque de todo ello depende qué significa cada fila del archivo.
Los datos ausentes necesitan un tratamiento explícito. Asignar cero tanto a una tarea abandonada como a una terminada sin omisiones confundiría la ausencia de registro con el mejor resultado posible. Si el abandono se relaciona con la dificultad, la regla de inclusión pasa a formar parte de la interpretación de la variable, porque analizar únicamente las tareas completas puede describir un subconjunto distinto de la población que se quería estudiar.
Por eso conviene registrar por separado cuántas oportunidades llegaron a presentarse y cuántas respuestas faltaron entre ellas. Cuatro omisiones en veinte oportunidades y dos en diez producen recuentos diferentes y la misma proporción de 0,2. Si el segundo registro corresponde a una interrupción a mitad de la tarea, describirlo como una mejora de dos puntos confundiría desempeño con exposición. La proporción aclara parte de esa diferencia, pero deja sin recuperar lo que habría ocurrido en la mitad ausente, que podría ser distinto si la interrupción depende de la propia dificultad o si las oportunidades finales son más exigentes. Si el archivo conserva ambos datos, el análisis puede distinguir una tarea más corta de un cambio en la conducta observada.
Los puntos de corte requieren una justificación propia, ya que dividir una puntuación continua en «alta» y «baja» supone decidir qué errores se toleran y con qué consecuencias. Un corte que separa bien los grupos de una muestra puede comportarse de otra forma si cambian sus distribuciones o la población destinataria. Como en el estudio ficticio no se ha reunido evidencia para convertir el recuento en un diagnóstico, el registro debe mantenerlo como resultado de la tarea especificada.
El equipo vuelve entonces a los cinco archivos procesados con los dos programas. La inspección detecta que la versión B cuenta como oportunidades de respuesta tres separadores vacíos, que nunca contenían una señal que hubiera que marcar. Se corrige la regla, se vuelven a procesar los archivos y la nueva versión reproduce los recuentos de A (dos, cuatro, seis, ocho y diez).
La tabla conserva las columnas originales, la versión corregida y la causa de la diferencia. La reducción de tres puntos deja de interpretarse como mejora de los participantes y se atribuye al cambio de puntuación. Para las sesiones posteriores se fija el conjunto de veinte oportunidades reales y se comprueba manualmente una selección de registros antes de compararlos con las sesiones anteriores.
Referencias
Bland, J. M., y Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/S0140-6736(86)90837-8
Borsboom, D., Mellenbergh, G. J., y van Heerden, J. (2004). The concept of validity. Psychological Review, 111(4), 1061–1071. https://doi.org/10.1037/0033-295X.111.4.1061
Cronbach, L. J., y Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281–302. https://doi.org/10.1037/h0040957
Flake, J. K., y Fried, E. I. (2020). Measurement schmeasurement: Questionable measurement practices and how to avoid them. Advances in Methods and Practices in Psychological Science, 3(4), 456–465. https://doi.org/10.1177/2515245920952393
Kane, M. T. (2013). Validating the interpretations and uses of test scores. Journal of Educational Measurement, 50(1), 1–73. https://doi.org/10.1111/jedm.12000
Putnick, D. L., y Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004
Sijtsma, K. (2009). On the use, the misuse, and the very limited usefulness of Cronbach’s alpha. Psychometrika, 74(1), 107–120. https://doi.org/10.1007/s11336-008-9101-0