El taller abre los sábados y presta conjuntos de herramientas para realizar pequeñas reparaciones. Antes de abrir, una persona debe revisar las piezas, preparar las cajas y dejar constancia de que están completas. Preparar demasiadas ocupa horas que podrían dedicarse a otras tareas, mientras que preparar pocas obliga a rechazar solicitudes. Durante años se han dejado listas seis cajas en cada sesión. La regla es fácil de aplicar, pero los responsables quieren saber si pueden ajustarla a la demanda sin convertir cada sábado en una improvisación.
Este taller es ficticio. Sus cantidades, sus costes y la secuencia de solicitudes se han elegido con fines didácticos, para poder seguir en él una decisión desde la observación hasta su revisión y calcular el efecto de cada cambio. El objeto que aprenderá es un procedimiento de preparación que conserva información, produce una previsión y utiliza esa previsión para escoger una acción. Su diseño incluye también el registro con el que se comprobará si las decisiones son útiles.
Preparar cajas antes de conocer las solicitudes
Para comenzar, la demanda de una sesión solo puede tomar dos valores, dos o seis cajas. El taller dispone físicamente de seis y su organización admite dos modalidades de preparación, de dos o de seis cajas. Más adelante se estudiará qué ocurre al añadir una modalidad intermedia, pero por ahora las únicas acciones son y , donde es el número de cajas preparadas antes de abrir. Cada preparación cuesta una unidad de trabajo.
Cada solicitud que no puede atenderse genera una pérdida valorada en tres unidades. Esta valoración, que combina el perjuicio del rechazo con el tiempo dedicado a gestionar la incidencia, es una preferencia estipulada para el ejercicio y carece de respaldo empírico. Las solicitudes no atendidas se pierden en esa sesión sin pasar a la siguiente como una cola automática. Las cajas vuelven a estar disponibles antes del próximo sábado y su preparación se repite en cada sesión, así que la acción actual no modifica el inventario futuro.
Si es la demanda, la pérdida de una sesión es
Con dos solicitudes, preparar dos cuesta dos y preparar seis cuesta seis. Con seis solicitudes, preparar seis sigue costando seis, en tanto que preparar dos cuesta catorce, dos por la preparación y doce por las cuatro solicitudes rechazadas. La función separa explícitamente el coste de sobrar del de faltar. Un criterio que solo contase cuántas veces se acierta la demanda trataría ambos errores de manera simétrica y estaría resolviendo otro problema.
Si cada sesión tiene probabilidad de demanda alta, preparar dos tiene un coste esperado de y preparar seis cuesta seis con cualquier demanda. La modalidad grande es preferible cuando , o sea, cuando . En caso de empate se prepararán dos. La convención queda establecida desde ahora, antes de calcular ninguna trayectoria, porque aparecerán varias probabilidades exactamente iguales a un tercio.
Con esto la regla de decisión queda completa para cualquier , pero su valor sigue siendo desconocido y el umbral nada dice sobre él. Una persona puede estar convencida de que las sesiones concurridas son raras y otra recordar sobre todo las solicitudes rechazadas. Revisar la decisión exige convertir la evidencia en una estimación que ambas puedan reconstruir. También exige registrar toda la demanda, incluidas las solicitudes que no acabaron en un préstamo.
La memoria que utiliza la decisión
Una sesión de demanda alta se representará mediante y una de demanda baja mediante . El modelo inicial considera que las sesiones son independientes una vez conocido un valor estable de y, antes de observar datos, asigna a ese valor una distribución uniforme entre cero y uno, equivalente a una beta con parámetros uno y uno. Esa distribución inicial tiene media un medio y expresa una incertidumbre repartida entre todos los valores posibles, sin suponer que el taller sepa que la demanda alta ocurre la mitad de las veces.
Si se han observado sesiones y de ellas tuvieron demanda alta, la verosimilitud es proporcional a . Al multiplicarla por la densidad uniforme se obtiene una distribución beta con parámetros y , cuya probabilidad predictiva de demanda alta en la próxima sesión es
Los dos sumandos iniciales, cuya influencia disminuye al acumularse observaciones, impiden que una única sesión haga saltar la previsión a cero o a uno. Tras cuatro sesiones de demanda baja la estimación es y tras cuatro altas es , valores que siguen dejando probabilidad para un resultado distinto del recién observado.
El uso de probabilidades actualizadas para orientar acciones tiene antecedentes en el trabajo de Thompson (1933), en cuyo planteamiento la incertidumbre comparativa podía dirigir la asignación entre alternativas. Aquí se utiliza una regla determinista, que prepara seis cajas cuando la probabilidad predictiva supera un tercio y dos en el resto de los casos. Aunque comparte la distribución beta con el muestreo de Thompson, se trata de otro algoritmo.
El orden temporal queda fijado. Antes de abrir se calcula la previsión utilizando únicamente las sesiones ya terminadas y se decide cuántas cajas preparar. Después se observa la demanda completa, se anota el coste y se actualizan los recuentos (una sesión alta aumenta y en uno, una baja aumenta solo ). El sábado siguiente utiliza la memoria actualizada. Si se guarda la previsión emitida antes del resultado, podrá evaluarse después lo que el procedimiento sabía cuando tuvo que actuar.
Como el coste esperado es lineal en , integrar sobre la distribución posterior equivale aquí a utilizar su media predictiva. La acción, además, deja intactos tanto la información que se obtendrá como los recursos de las sesiones posteriores. Bajo estos supuestos, minimizar el coste esperado de cada sesión minimiza también el coste esperado acumulado según el modelo bayesiano, porque la decisión actual no puede mejorar ninguna consecuencia futura que dependa de ella. Esta propiedad desaparecería si las cajas se deteriorasen con el uso o si los rechazos alterasen la demanda siguiente.
La memoria tiene dos dimensiones distintas. El valor medio orienta la decisión inmediata y la cantidad de observaciones indica cuánto se ha concentrado la distribución sobre , de manera que dos historiales pueden producir la misma media con distinta incertidumbre. La regla actual decide igual en ambos porque así lo exige su función de coste. Otra que limitase la probabilidad de una pérdida acumulada grande durante varias sesiones futuras podría necesitar más información que esa media.
La distribución inicial también deja una huella comprobable. Con una beta de parámetros cinco y cinco, la media inicial seguiría siendo un medio, pero la distribución estaría más concentrada alrededor de ese valor. Después de cuatro demandas bajas la previsión sería y, como seguiría por encima de un tercio, se prepararían seis cajas. Con los parámetros uno y uno, esas mismas observaciones llevan a y a preparar dos, una diferencia que quedaría oculta si se informara únicamente la media inicial.
Una memoria inicial más concentrada puede reflejar información previa pertinente, para lo cual necesita una procedencia, como otros periodos comparables, otros talleres suficientemente semejantes o un juicio previo documentado. Si se escoge después de mirar las doce sesiones para obtener un buen coste y luego se evalúa con esas mismas sesiones, el resultado habrá servido para diseñar su supuesto punto de partida. Esa operación puede ser útil para desarrollar una propuesta cuyo rendimiento habrá de comprobarse después con evidencia que no haya participado en la elección.
Doce sesiones que permiten revisar cada paso
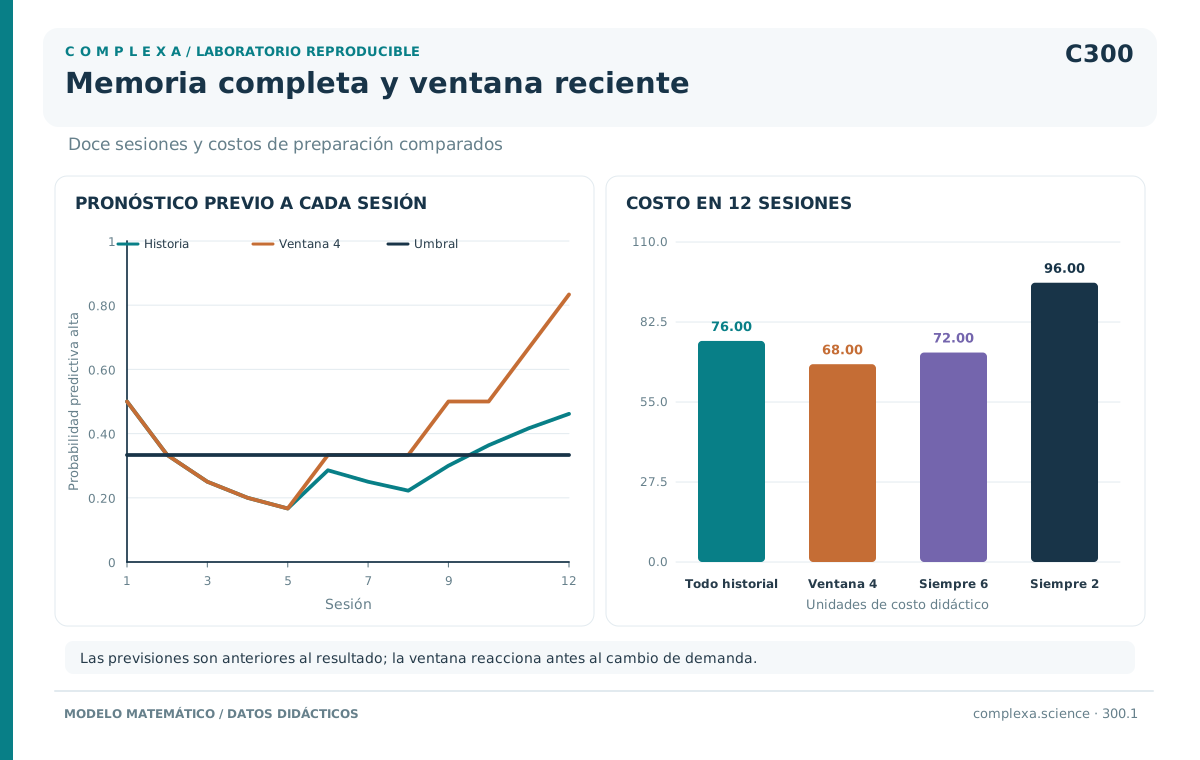
La secuencia didáctica será baja, baja, baja, baja, alta, baja, baja, alta, alta, alta, alta y alta. Se construyó con una primera parte poco concurrida y una concentración de demanda alta al final para comparar procedimientos completamente especificados, sin proceder de una muestra aleatoria de un taller ni probar por sí misma un cambio de régimen.
Junto a la memoria que conserva todos los datos se considerará una segunda que utiliza solo las cuatro sesiones anteriores, o todas las disponibles cuando todavía no hay cuatro. Calcula la misma fracción , pero ahora y corresponden exclusivamente a esa ventana, de la que sale la observación más antigua cada vez que entra una nueva y ya había cuatro. La longitud de cuatro es una elección didáctica fija, que no se ajustará después para mejorar su resultado en esta secuencia.
| Sesión | Demanda | Probabilidad con toda la historia | Cajas con toda la historia | Cajas con ventana de cuatro |
|---|---|---|---|---|
| 1 | 2 | 6 | 6 | |
| 2 | 2 | 2 | 2 | |
| 3 | 2 | 2 | 2 | |
| 4 | 2 | 2 | 2 | |
| 5 | 6 | 2 | 2 | |
| 6 | 2 | 2 | 2 | |
| 7 | 2 | 2 | 2 | |
| 8 | 6 | 2 | 2 | |
| 9 | 6 | 2 | 6 | |
| 10 | 6 | 6 | 6 | |
| 11 | 6 | 6 | 6 | |
| 12 | 6 | 6 | 6 |
La primera decisión prepara seis porque la probabilidad inicial es un medio, pero la demanda es baja y quedan cuatro preparaciones sin utilizar. Antes de la segunda sesión, el dato observado reduce la probabilidad a un tercio y el empate activa la modalidad pequeña, que las siguientes sesiones bajas refuerzan. Cuando en la quinta llegan seis solicitudes, el taller rechaza cuatro y registra una pérdida de catorce.
En la novena sesión, las memorias divergen. La historia completa contiene dos sesiones altas entre ocho y produce , todavía por debajo del umbral. La ventana, en cambio, conserva las sesiones quinta a octava (alta, baja, baja y alta), cuyas dos altas entre cuatro producen . Por eso prepara seis y el coste de esa sesión baja de catorce a seis.
Sumados los doce costes, la memoria completa acumula 76 unidades y la ventana 68, frente a los 72 que habría costado la regla antigua de preparar siempre seis y los 96 de preparar siempre dos. En esta secuencia, por tanto, una modalidad de aprendizaje mejora la regla antigua y la otra empeora su resultado, aunque ambas actualizaron correctamente sus estimaciones según las operaciones que tenían asignadas. El desacuerdo procede del pasado que cada una conservó para predecir.
Las sumas pueden desglosarse. La memoria completa prepara cuarenta cajas y deja doce solicitudes sin atender, de donde sale . La ventana prepara 44 y deja ocho sin atender, con coste . La regla de seis prepara 72 y atiende las 48 solicitudes de la secuencia. La ventana ahorra preparación a costa de aceptar rechazos, mientras que la regla constante dedica más trabajo a evitar todos los rechazos de este ejemplo.
Ambas memorias dejan sin utilizar cuatro preparaciones, las de la primera sesión. Su diferencia posterior se debe a que la ventana prepara cuatro cajas adicionales justo cuando se solicitan. Esas mismas cuatro preparaciones en un sábado de demanda baja habrían aumentado el coste sin mejorar el servicio, por lo que la mejora pasa inadvertida si solo se examina el total de trabajo realizado, separado de las fechas y de la demanda.
Con las acciones de esta trayectoria fijas, puede comprobarse cuánto depende su valoración de la penalización. Si cada rechazo se valorase en unidades, la ventana costaría , frente a 72 de preparar siempre seis, con lo que es preferible para , empata en 3,5 y pierde por encima. Esta comparación revalora decisiones ya tomadas. Recalcular las acciones que habría elegido una regla con otra penalización es una operación distinta, que se realizará al revisar el criterio.
Una persona que conociera la demanda antes de preparar elegiría dos en las seis sesiones bajas y seis en las seis altas, con coste total 48. Esa cifra es una cota inferior informativa para la trayectoria, propia de una política que el taller no podría haber implementado, pues utiliza el resultado antes de que estuviera disponible. Su distancia a 68 localiza el coste de decidir con incertidumbre y deja abierto si alguna política realizable podría alcanzar 48.
Cuándo conviene dejar de acumular
La memoria completa parte de la hipótesis de un estable y, cuantos más datos recibe, menos cambia su estimación ante una observación individual. Esa resistencia es útil cuando una racha excepcional aparece dentro de una distribución estable, pero se vuelve una demora si la frecuencia de demanda alta ha aumentado de forma persistente. La ventana responde más deprisa porque descarta evidencia antigua, a costa de basar cada decisión en pocos datos.
Descartar datos modifica el modelo de aprendizaje. La fórmula de la ventana puede entenderse como una estimación local suavizada que conserva el formato de la fracción, pero ya no es la posterior acumulativa del modelo de un único estable definido antes y su interpretación cambia. Esa diferencia debe quedar escrita cuando se sustituye una versión del procedimiento por otra.
Bifet y Gavaldà (2007) desarrollaron ADWIN para modificar la longitud de la ventana según la evidencia de cambio en los datos, con una memoria que puede crecer durante periodos estables y reducirse cuando se detectan diferencias. El procedimiento del taller mantiene siempre cuatro observaciones como máximo y carece de ese mecanismo estadístico de detección. La comparación deja pendiente una decisión de diseño entre elegir una escala fija o pagar el coste de detectar cuándo los datos antiguos han dejado de ser pertinentes.
El taller necesita observar qué cambios podrían haber alterado la demanda. Un nuevo horario, un curso de reparación cercano o una campaña de difusión dan información distinta de una sucesión de sábados concurridos. Cuando se conoce el momento de una modificación importante puede tener sentido estudiar por separado las sesiones posteriores. Si, por el contrario, se inventa una explicación después de cada racha, la memoria termina ajustándose al ruido. El registro de contexto tiene que acompañar a los resultados y conservar las fechas en que esa información estuvo disponible.
También puede cambiar la forma de la demanda. Si empiezan a llegar cuatro solicitudes con frecuencia, el modelo binario deja de describir los resultados posibles. Habría que ampliar entonces la distribución de demanda y volver a obtener los costes esperados de las acciones, una tarea que va más allá de recalcular . Una excepción observada fuera del soporte del modelo tiene consecuencias diferentes de las de una observación poco probable dentro de él.
Una sola trayectoria de doce sesiones es insuficiente para elegir una longitud de ventana válida en el mundo real, pero puede investigarse el comportamiento completo del algoritmo dentro de otros mundos didácticos enumerando las secuencias binarias posibles. Si la probabilidad alta es constante e igual a , una secuencia con sesiones altas recibe peso . Cada regla se ejecuta desde su estado inicial en cada secuencia y sus costes se promedian con esos pesos.
| Probabilidad alta constante | Siempre dos | Siempre seis | Memoria completa | Ventana de cuatro |
|---|---|---|---|---|
| 52,800 | 72,000 | 58,770 | 58,391 | |
| 96,000 | 72,000 | 76,461 | 78,750 | |
| 139,200 | 72,000 | 73,629 | 74,607 |
Son expectativas exactas, obtenidas por enumeración y redondeadas a tres decimales, sin el error de muestreo propio de una simulación. En las tres filas la mejor regla constante cuesta menos que los procedimientos que empiezan ignorando , aunque la regla constante favorable cambia de una fila a otra. Quien supiera de antemano cuál corresponde a su taller tendría la información que el procedimiento adaptativo intenta adquirir.
La ventana supera ligeramente a la memoria completa en la primera fila y pierde frente a ella en las otras dos, de modo que el orden que sugería el resultado de 68 en la trayectoria inicial cambia según el entorno. La evaluación ha identificado condiciones concretas bajo las cuales es preferible cada memoria. Para decidir una prueba de campo, el taller tendría que formular qué entornos considera plausibles y cuánto le preocupa responder tarde a un cambio.
El orden de las observaciones deja además un efecto que el promedio final oculta. Al recorrer las 924 secuencias distintas con exactamente seis sesiones altas y seis bajas, la memoria completa acumula costes entre 72 y 96 y la ventana entre sesenta y 104. Al terminar, ambas conocen la misma proporción global después de haber tenido historias distintas. En la ventana, incluso la memoria final depende de cuáles fueron las últimas cuatro sesiones.
Estos intervalos son los extremos del coste sobre un conjunto finito y especificado de secuencias, sin el sentido estadístico de un intervalo de confianza. Muestran que dos informes con idéntico número de solicitudes altas pueden ocultar experiencias operativas diferentes. Si los seis sábados altos aparecen al principio y los seis bajos después, la ventana alcanza sesenta unidades al comenzar preparando seis y reducir la preparación durante la segunda parte. Otras alternancias la hacen reaccionar repetidamente cuando el patrón acaba de cambiar y elevan su coste.
Evaluar una previsión antes de evaluar su uso
La pérdida operativa informa sobre las cajas preparadas y las solicitudes rechazadas, pero deja sin evaluar la calidad de las probabilidades emitidas, ya que dos previsiones situadas a un mismo lado de un tercio producen la misma acción y, por tanto, el mismo coste. Si se guarda únicamente la decisión, se pierde la oportunidad de estudiar cómo se estaba representando la incertidumbre.
Para una previsión y un resultado binario , una medida posible es el error cuadrático , conocido en este contexto como puntuación de Brier. Si la verdadera probabilidad es , su valor esperado es , suma de un primer término que se minimiza declarando y de un segundo que recoge la variación que permanece incluso con la probabilidad correcta. Esta propiedad justifica evaluar probabilidades con reglas de puntuación propias, como las estudiadas por Gneiting y Raftery (2007), en vez de premiar únicamente afirmaciones categóricas acertadas.
En la secuencia trabajada, el promedio del error cuadrático es aproximadamente 0,2860 para la memoria completa y 0,2053 para la ventana, frente al 0,25 que obtiene una previsión constante de un medio en cualquier secuencia binaria. Durante este recorrido, la memoria completa prevé peor que esa referencia pese a incorporar más datos. Es otro coste del desajuste temporal, puesto que la primera parte de la historia sigue pesando cuando la demanda alta se concentra al final.
Estas puntuaciones evalúan la secuencia emitida, pero doce casos son muy pocos para estudiar la calibración. Para ello harían falta muchas ocasiones comparables, en las que pudiera comprobarse si, entre las sesiones a las que se asigna una probabilidad cercana a un valor, la frecuencia observada se aproxima a ese valor. Una única predicción de 0,8 seguida de demanda baja es compatible con una probabilidad de 0,8. Las pérdidas probabilísticas acumulan evidencia a lo largo de las previsiones sin convertir cada sorpresa en una acusación de error absoluto.
La evaluación debe respetar el momento de predicción. Recalcular las probabilidades usando las doce sesiones y asignarlas después a sábados anteriores produciría una impresión engañosa de conocimiento. El enfoque prequential de Dawid (1984) organiza precisamente la evaluación alrededor de previsiones sucesivas y resultados observados. En el taller, cada fila necesita conservar la probabilidad original, la acción autorizada y el resultado que llegó después, sin que ninguna corrección retrospectiva de la memoria la sobrescriba.
La calidad probabilística y la utilidad de una decisión pueden separarse incluso con diferencias pequeñas. Si el verdadero fuese 0,2, estimarlo como 0,32 mantendría la preparación de dos y estimarlo como 0,34 activaría seis, con 1,6 unidades de coste esperado por sesión por encima de la acción adecuada para ese . Mejorar una estimación de 0,30 a 0,21, en cambio, conserva la acción, porque el umbral solo convierte en cambios operativos los errores de predicción que lo atraviesan.
Cuando la decisión impide observar
Hasta ahora el taller cuenta todas las solicitudes, incluso las rechazadas. Si su programa registrara únicamente los préstamos completados, lo observado pasaría a ser . Cuando se preparan dos cajas, vale siempre dos, tanto si llegaron dos solicitudes como si llegaron seis, de modo que bajo esa acción dos mundos con demandas muy distintas producen el mismo registro.
Si el procedimiento interpreta esos dos préstamos como prueba de demanda baja, reducirá su estimación y seguirá preparando dos, con lo cual la propia decisión mantiene la falta de información que parece justificarla. Añadir más semanas de registros deja intacta la confusión, porque se acumulan observaciones de una variable que no distingue los estados relevantes. La primera modificación del sistema tendría que ser el registro de solicitudes no atendidas o alguna otra forma de medir la demanda más allá del límite impuesto por la preparación.
Si esa medición no fuera posible, preparar seis en algunas sesiones daría acceso a la demanda completa y la acción adquiriría un valor informativo además de su coste inmediato. Esa prueba cuesta cuatro preparaciones adicionales en una sesión de demanda baja y evita cuatro rechazos en una alta. Su valor para las decisiones futuras depende de cuánto tiempo quede, de la incertidumbre actual y de si la demanda se mantiene estable, así que la elección deja de resolverse comparando únicamente los dos costes de la próxima sesión.
Robbins (1952) estudió diseños secuenciales en los que las observaciones orientan qué población se muestrea después. En los problemas de bandido analizados por Auer, Cesa-Bianchi y Fischer (2002) se observa la recompensa de la alternativa elegida, de manera que actuar determina también qué información se obtiene. Esa estructura explica la tensión entre explorar y explotar lo aprendido. En la versión inicial del taller, con toda la demanda observada bajo cualquier acción, se aprendía sin pagar ese coste de exploración, mientras que la versión que solo registra préstamos necesita otro tratamiento.
Introducir variación aleatoria en la preparación para aparentar sofisticación carecería de sentido. Primero se comprobaría si una casilla de «solicitud no atendida» da la información faltante de forma más directa. Si se utilizasen sesiones de prueba, deberían quedar identificadas con su regla de asignación y analizarse según esa regla. También sería necesario comprobar si anunciar seis cajas disponibles atrae a más personas. En ese caso, la preparación afectaría a la demanda y habría que estimar resultados condicionados a la acción.
Aprender datos y revisar el criterio
La cifra tres asignada a cada solicitud perdida es independiente del recuento de sesiones altas. Si el taller concluye que esos rechazos son más costosos y cambia la valoración a cinco, preparar dos pasa a tener coste esperado y el umbral baja a . La misma evidencia provoca ahora más preparación porque ha cambiado la preferencia operativa. Registrar esa modificación evita atribuir a una mejora predictiva lo que fue una decisión sobre qué pérdida aceptar.
La valoración puede discutirse con quienes preparan las cajas y con quienes solicitan el servicio, ya que la solicitud de una persona sin otra alternativa puede tener consecuencias diferentes de las de otra fácilmente aplazable. Si esas diferencias son relevantes para la función del taller, habrá que representarlas mediante categorías justificadas o restricciones de atención. El algoritmo es incapaz de deducir una prioridad legítima a partir de la frecuencia de uso o de compensar ilimitadamente perjuicios distintos por el solo hecho de que se hayan expresado en una misma unidad contable.
Revisar las acciones es otra operación. Supongamos que, tras una reorganización, el taller puede preparar cuatro cajas con el mismo coste unitario y la misma penalización de tres. Su coste esperado es . Con el criterio de pérdida esperada y un conocido, la modalidad intermedia nunca mejora estrictamente las dos anteriores, porque las tres rectas coinciden cuando y fuera de ese punto siempre es mejor uno de los extremos.
Bajo el objetivo original la modalidad intermedia es prescindible, aunque puede ser útil con otro criterio de incertidumbre. Consideremos, como nuevo supuesto didáctico, que solo se acepta situar entre 0,2 y 0,5, sin asignar probabilidades dentro de ese intervalo, que se fija por hipótesis y nada tiene que ver con un intervalo de confianza calculado con las doce sesiones. Se desea minimizar el mayor exceso de coste respecto a la mejor acción para cada valor posible de , exceso que recibe el nombre de arrepentimiento de la decisión.
Preparar dos tiene su peor exceso en , donde cuesta ocho frente a seis, de modo que su arrepentimiento máximo es dos. Preparar seis lo tiene en , donde cuesta seis frente a 4,4, con exceso 1,6. Preparar cuatro cuesta 5,2 en el primer extremo del intervalo y siete en el segundo, con excesos de 0,8 y uno. Como entre ambos extremos las funciones son lineales por tramos, su máximo es uno y, con ese nuevo criterio, cuatro es la mejor de las tres acciones.
Llegar a esa conclusión ha requerido ampliar una posibilidad material y declarar cómo se trata la incertidumbre, dos pasos que ningún aumento en la cantidad de datos habría producido. Si el taller adopta esta modalidad, su registro tendrá que indicar que dejó de minimizar una expectativa posterior y pasó a limitar el peor arrepentimiento dentro de un intervalo. De lo contrario, dos decisiones distintas parecerían discrepancias de un algoritmo que en realidad estaba resolviendo problemas diferentes.
La siguiente sesión queda definida antes de abrir
Después de las doce sesiones, la memoria completa contiene seis demandas altas y seis bajas y da una próxima probabilidad de . La ventana conserva cuatro altas y produce . Ambas preparan seis con el criterio original pese a asignar probabilidades predictivas distintas a la demanda alta. El taller puede conservar las dos previsiones para evaluarlas y ejecutar solo la acción que corresponde al procedimiento vigente.
La fila de la sesión siguiente ha de empezar con esos valores antes de que lleguen solicitudes e indicar también qué versión decide, cuántas cajas se prepararon realmente y si alguna limitación impidió cumplir la recomendación. Si faltó personal y solo se prepararon dos, el coste observado corresponde a una acción distinta de la recomendada de seis. Mantener esa diferencia permite saber si falló la previsión, si la regla era inadecuada o si la organización no pudo ejecutarla.
La adopción de una memoria nueva puede comenzar manteniendo sus propuestas en paralelo con las decisiones vigentes. En el modelo de demanda exógena y plenamente observada, los costes de ambas acciones se reconstruyen a partir de cada demanda y de la fórmula declarada, por lo que la propuesta puede evaluarse sin ejecutarla. Esa posibilidad depende de los supuestos ya examinados, ya que si la disponibilidad anunciada cambiara las solicitudes, el registro de una política dejaría de dar directamente el resultado de la otra.
Si en la decimotercera sesión llegan dos solicitudes, ambas modalidades habrán preparado seis y soportarán un coste de seis. La memoria completa pasará a estimar y la ventana, que entonces conserva tres altas y una baja, pasará a . Ambas seguirán preparando seis para la sesión posterior. El resultado nuevo habrá cambiado las previsiones sin alterar todavía la acción, una diferencia que quedará en el registro para confrontarla con las solicitudes del siguiente sábado.
Referencias
Auer, P., Cesa-Bianchi, N., y Fischer, P. (2002). Finite-time analysis of the multiarmed bandit problem. Machine Learning, 47, 235–256. https://doi.org/10.1023/A:1013689704352
Bifet, A., y Gavaldà, R. (2007). Learning from time-changing data with adaptive windowing. En Proceedings of the 2007 SIAM International Conference on Data Mining (pp. 443–448). https://doi.org/10.1137/1.9781611972771.42
Dawid, A. P. (1984). Present position and potential developments: Some personal views. Statistical theory: The prequential approach. Journal of the Royal Statistical Society. Series A (General), 147(2), 278–292. https://doi.org/10.2307/2981683
Gneiting, T., y Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359–378. https://doi.org/10.1198/016214506000001437
Robbins, H. (1952). Some aspects of the sequential design of experiments. Bulletin of the American Mathematical Society, 58(5), 527–535. https://doi.org/10.1090/S0002-9904-1952-09620-8
Thompson, W. R. (1933). On the likelihood that one unknown probability exceeds another in view of the evidence of two samples. Biometrika, 25(3–4), 285–294. https://doi.org/10.1093/biomet/25.3-4.285