Cuatro personas estiman una cantidad cuyo valor verdadero es cien. Sus respuestas iniciales son 80, 90, 110 y 120 y, después de intercambiar información, las revisan y responden 103, 104, 105 y 108. Todas se acercaron al valor correcto. El desacuerdo también se redujo mucho. La media del grupo, sin embargo, pasó de cien a ciento cinco y la estimación colectiva empeoró. Este ejemplo inventado contiene una dificultad que debe resolverse antes de atribuir inteligencia a una multitud, puesto que la mejora de sus integrantes, la convergencia de sus opiniones y la exactitud de su resultado agregado pueden cambiar en direcciones diferentes.
Una evaluación necesita definir qué produce el colectivo, sea una estimación numérica, una decisión entre alternativas o una solución que requiere coordinar actividades complementarias. En el primer caso quizá interese minimizar el error medio. En el segundo será preciso especificar el coste de cada equivocación. En el tercero el resultado depende también de la distribución del trabajo y de que las contribuciones sean compatibles, cuestiones que quedan fuera del alcance de una regla de agregación pensada para cantidades numéricas, por eficaz que sea.
Hace falta, además, un criterio externo de desempeño. La unanimidad puede medirse incluso cuando se desconoce la respuesta correcta, pero la exactitud solo se comprueba frente a ella. En problemas que incluyen preferencias o conflictos de objetivos puede no existir siquiera una única respuesta verdadera con la que medir el error en el mismo sentido. La investigación sobre sabiduría de las multitudes suele elegir tareas con resultados verificables precisamente para separar esas cuestiones.
Qué se cancela al promediar
Sean las estimaciones de personas, su media y el valor verdadero. El error cuadrático individual medio se descompone en dos términos según la identidad
En el lado derecho, el primer término es el error cuadrático de la media y el segundo mide la dispersión de las estimaciones alrededor de ella. Para obtener la igualdad basta escribir , elevar al cuadrado y sumar. El término cruzado desaparece porque las desviaciones respecto de la media suman cero. Es una identidad algebraica, válida para ese conjunto de respuestas sin suponer independencia ni una distribución normal.
En el ejemplo inicial, el error individual medio es 250 y la dispersión también es 250, con lo cual el error de la media es cero. Tras la revisión, el error individual medio baja a 28,5, la dispersión cae a 3,5 y el error de la media aumenta a 25. La igualdad se sigue cumpliendo, pues 28,5 es la suma de 25 y 3,5. Cada participante mejoró, pero se perdieron las compensaciones entre errores situados a ambos lados del valor verdadero.
La ventaja del promedio aparece cuando las diferencias entre estimaciones contienen errores que se compensan, o información complementaria que una regla adecuada puede incorporar. Añadir respuestas arbitrarias muy alejadas de la verdad para ganar dispersión, en cambio, eleva también el error individual. La diversidad de respuestas es una propiedad observable cuya contribución al resultado depende de cómo se relacione con la precisión.
La regla de agregación tiene que corresponder, además, a la escala de la pregunta. Una estimación de cien frente a un valor de cincuenta tiene el mismo error absoluto que una de mil cincuenta frente a mil, aunque su error proporcional sea muy distinto. Con cantidades positivas y errores multiplicativos, trabajar con logaritmos y agregar mediante una media geométrica puede responder mejor al criterio elegido. La mediana reduce la influencia de los valores extremos a costa de dejar sin uso parte de la información sobre magnitudes. La elección ha de fijarse antes de saber qué procedimiento favorece los resultados obtenidos.
Por qué cien respuestas pueden contener poca información independiente
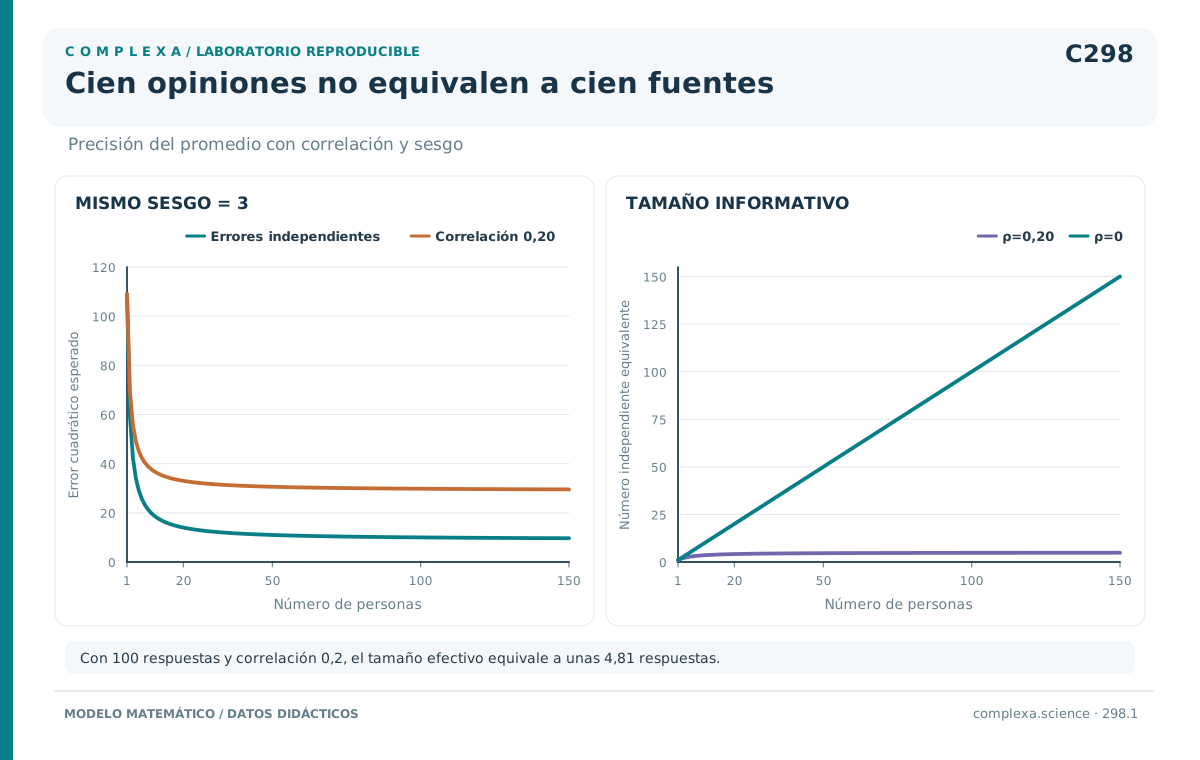
Lo que ocurre al ampliar un grupo puede estudiarse con un modelo didáctico de errores repetidos en el que cada estimación tiene la forma . Aquí es un sesgo compartido, tiene media cero y varianza y la correlación entre los errores de cualquier pareja distinta es . Por ahora se supone la misma varianza y la misma correlación para todos. Entonces
y el error cuadrático esperado de la media es
La derivación suma las varianzas individuales y las covarianzas entre estimaciones antes de dividir el resultado entre . Si , la parte variable disminuye como . Si la correlación es positiva y se mantiene al crecer el grupo, queda un término que el tamaño no elimina. El sesgo compartido, por su parte, persiste aunque se añadan más personas con el mismo sesgo.
Los valores de la tabla siguiente provienen exclusivamente del modelo, con , y , todos referidos a la escala numérica de la tarea.
| Número de estimaciones | Varianza de la media | Error cuadrático esperado | Tamaño independiente equivalente |
|---|---|---|---|
| 5 | 36,0 | 45,0 | 2,78 |
| 20 | 24,0 | 33,0 | 4,17 |
| 100 | 20,8 | 29,8 | 4,81 |
El tamaño independiente equivalente, , indica cuántas estimaciones independientes con la misma varianza individual producirían esa varianza de la media. Es una medida de varianza, ajena al sesgo y a las demás capacidades del grupo. En este ejemplo, pasar de veinte a cien participantes reduce algo el error, pero el límite del error cuadrático esperado es 29 y la parte compartida domina el resultado.
La correlación puede proceder de un informe común, de un instrumento de medición mal calibrado o de una misma forma de interpretar la pregunta. Puede surgir también después de la comunicación, cuando dos participantes que eran parcialmente independientes incorporan el mismo argumento y terminan reproduciendo una sola fuente, un origen común que queda oculto si solo se registran sus respuestas finales.
En datos reales habrá varianzas diferentes y una matriz de covarianzas que ocupa el lugar del único del modelo. La expresión general de la varianza para una media ponderada con pesos es , donde contiene esas covarianzas. Con ella puede comprobarse si los nuevos participantes traen información que compense errores existentes. Reclutar personas distintas por nombre o procedencia puede ampliar la cobertura, pero esa diversidad solo reduce una dependencia concreta si cambia también las fuentes o los procesos que la producen.
Contar fuentes además de contar personas
Pensemos en diez analistas que consultan el mismo documento y en otros dos que utilizan registros obtenidos de manera independiente. Si los diez primeros coinciden, hay evidencia de que el documento produce una interpretación reproducible, pero como respaldo independiente de su exactitud esa coincidencia vale menos que diez votos separados. Por eso es útil registrar qué fuente sostiene cada afirmación, de forma que varias reformulaciones de un dato no se cuenten como observaciones nuevas.
En el cálculo interviene la dependencia entre los errores cometidos en la tarea pertinente, que puede ser baja incluso entre personas que no están completamente aisladas. Dos personas pueden compartir antecedentes generales y diferir en una medición decisiva, mientras otras pueden trabajar sin comunicarse y utilizar el mismo supuesto erróneo. Esa dependencia se estima mejor sobre una serie de problemas con respuestas verificables que a partir del desacuerdo observado en una sola pregunta.
Sobre la estructura de la información pueden diseñarse comparaciones, formando grupos con documentos repetidos y otros con documentos complementarios, de tamaño y tiempo disponible parecidos. Si el segundo diseño mejora el resultado, interesa saber si aumentó la cobertura o disminuyó un error común. Un resultado más variable entre grupos podría coexistir con una reducción del sesgo medio, una distribución que quedaría oculta si solo se eligiera el grupo ganador.
Otra fuente de error común es el desconocimiento compartido. Un grupo puede discrepar sobre valores que ya fueron medidos y coincidir en omitir una variable que nadie recibió, ausencia que puede pasar inadvertida en la conversación. Una intervención dirigida a ampliar la información disponible ha de evaluarse de manera distinta de otra dirigida a mejorar cómo se combina la información existente. Las dos pueden producir respuestas finales más exactas, cada una por un mecanismo diferente.
Votar y ponderar responden a problemas distintos
En una decisión binaria con una única alternativa correcta, supongamos cinco personas que aciertan cada una con probabilidad y cuyos errores son independientes. La mayoría acierta cuando lo hacen al menos tres personas, cosa que ocurre con probabilidad
Con el resultado es 0,68256, superior al acierto individual. Con baja a 0,31744. La misma regla amplifica en ambos casos la orientación predominante de los juicios. Sobre una mayoría humana concreta, los dos cálculos solo informan si se cumplen sus supuestos de independencia y de competencia respecto de la respuesta que se considera correcta. Si todos responden a una señal común engañosa, las cinco respuestas dejan de equivaler a cinco ensayos independientes.
Votar descarta las diferencias de intensidad y de precisión entre juicios. Si en una estimación numérica tres observadores insesgados e independientes tienen varianzas conocidas de 4, 9 y 16, la combinación lineal de mínima varianza con pesos que suman uno asigna a cada uno un peso proporcional al inverso de su varianza. Esos pesos son aproximadamente 0,590; 0,262 y 0,148 y dan una varianza de 2,361, frente a 3,222 con pesos iguales.
La mejora depende de conocer las precisiones relevantes. Estimarlas con pocos casos puede producir pesos inestables; estimarlas en otra tarea puede favorecer a quien dominaba un problema distinto. La evaluación necesita separar los casos con que se aprenden los pesos de aquellos en que se mide su rendimiento. Quien elige a la persona aparentemente más exacta después de ver las respuestas correctas de la misma prueba incorpora información de la que no dispondrá al decidir en el futuro.
El coste de las equivocaciones también modifica la regla adecuada. Una decisión con consecuencias asimétricas puede requerir un umbral distinto de la mayoría simple, cuya justificación exige declarar qué errores se consideran costosos y cómo se estiman sus probabilidades. Un grupo puede alcanzar más aciertos totales y, aun así, cometer con mayor frecuencia el tipo de error que la tarea pretende evitar, por lo que la definición del desempeño ha de conservar esa diferencia.
Lo que cambia cuando se muestran las respuestas ajenas
Lorenz y colaboradores (2011) estudiaron revisiones de estimaciones numéricas bajo distintas condiciones de información social, en las que los participantes podían ver una media grupal, información sobre las estimaciones de los demás o únicamente su propia respuesta anterior. La exposición a respuestas ajenas redujo la diversidad y elevó la confianza sin una mejora comparable de la exactitud colectiva, para la cual el estudio tampoco mostró un empeoramiento general y significativo.
El experimento, por otra parte, no incluía una deliberación libre entre participantes. Quien ve números puede aproximarse a ellos sin recibir necesariamente los argumentos que los produjeron. Esa diferencia ayuda a separar dos funciones de la conversación, la de transmitir la posición final de otra persona y la de comunicar información con la que revisar el propio razonamiento. Una interfaz que solo muestra el promedio estudia sobre todo la primera.
La confianza puede responder al acuerdo, que parece una señal de confirmación. Cuando las respuestas convergieron por influencia mutua, sin embargo, parte de esa confirmación reutiliza la información inicial. Una cadena de revisiones puede devolver a un participante, a través de otras personas, una versión de su propia estimación, un retorno que parecerá apoyo externo si no se registra la procedencia.
El rango de respuestas también puede estrecharse alrededor de un valor incorrecto, con lo que quien consulta al grupo recibe una impresión de precisión mayor que la justificada por su exactitud. La amplitud observada entre personas solo podría tratarse como un intervalo de incertidumbre sobre la verdad si se demostrara que su cobertura es adecuada en muchas tareas comparables.
La consecuencia práctica para un experimento es conservar las respuestas individuales antes y después de la exposición, con las que pueden separarse el movimiento de la media, la reducción de la dispersión y el cambio de confianza. Sin la medición inicial, un conjunto compacto de respuestas finales puede provenir de conocimiento compartido correcto, de un error común previo o de convergencia durante la interacción.
La comunicación puede mejorar el agregado
Becker, Brackbill y Centola (2017) observaron mejoras de exactitud en redes descentralizadas donde los participantes revisaban estimaciones tras recibir información de sus vecinos. La dispersión disminuyó, pero esta vez la media también mejoró. Quienes eran inicialmente más exactos tendían a revisar menos sus respuestas y daban así mayor persistencia a su información. Como el estudio midió revisiones, la confianza aparece allí como una explicación inferida de esa persistencia, sin una medición directa en cada participante.
Una regla lineal aclara el mecanismo. Si el vector de estimaciones es , una revisión puede representarse mediante , donde cada fila de contiene pesos no negativos que suman uno. Cada persona combina así su estimación con las de otras. Cuando también todas las columnas suman uno, la media aritmética permanece constante y el desacuerdo puede disminuir sin que cambie esa estimación colectiva. Para explicar una mejora de la media hace falta, por tanto, alguna asimetría de influencia, información nueva u otra operación que modifique su valor.
Cuando una red fija converge a un consenso bajo las condiciones apropiadas de conectividad y ausencia de oscilaciones persistentes, ese consenso es una media ponderada de las estimaciones iniciales cuyos pesos dependen de las rutas de influencia. Hablar una vez o figurar una vez en una lista dice poco del peso final de una persona, porque sus ideas pueden circular repetidamente y alcanzar a muchos otros participantes.
En las redes centralizadas del estudio, el efecto dependía de dónde se situaba la estimación de la persona central respecto del valor verdadero y del agregado inicial, ya que su influencia podía acercar o alejar al grupo. Una opinión situada al otro lado de la verdad puede corregir parcialmente un sesgo aunque, considerada por separado, tampoco sea muy exacta, una geometría de la combinación que pasaría inadvertida si solo se comparara quién tenía el menor error individual.
Almaatouq y colaboradores (2022) mostraron, mediante un modelo y un reanálisis de cuatro conjuntos de datos experimentales, que la distribución inicial de las estimaciones modifica el efecto de la centralización, de modo que hace falta conocer tanto la información inicial como la manera de combinarla. Las colas extremas, en particular, pueden perjudicar una media simple de manera distinta de lo que ocurre con distribuciones más concentradas. Su comparación empírica usó las estimaciones previas y posteriores como aproximaciones a distintos patrones de influencia, sin medir todas las redes efectivas.
La regla de evaluación vuelve a ser decisiva. Un procedimiento puede mejorar el error típico y empeorar a la vez algunos casos extremos, de modo que antes de elegir entre media, mediana o ponderación hay que examinar qué errores aparecen en las colas y qué consecuencias tienen. Una arquitectura útil para estimaciones de magnitud positiva y muy asimétricas necesita una validación propia antes de aplicarse a tareas perceptivas, decisiones binarias o generación de soluciones nuevas.
Debatir en grupos pequeños y combinar después
Navajas y colaboradores (2018) organizaron una multitud en grupos de cinco para responder preguntas de conocimiento general. Los participantes dieron estimaciones individuales, deliberaron y produjeron respuestas consensuadas, tras lo cual volvieron a responder individualmente. La agregación de respuestas procedentes de debates separados fue más exacta que la de las respuestas iniciales. En ese diseño la interacción actuaba dentro de cada grupo sin borrar las diferencias entre grupos.
Con este procedimiento se separan intercambio e independencia. La deliberación local puede corregir unidades, recuperar conocimientos o descartar una interpretación equivocada de la pregunta. Después, la agregación combina resultados que no han pasado todos por una única discusión. Si se forzara un consenso general antes de agregarlos, ya no podría observarse qué errores corrigió cada debate y cuáles permanecieron.
El número de grupos y el de personas dentro de cada uno influyen de manera distinta en el resultado. Añadir integrantes a un debate puede ampliar la información disponible, pero también puede alterar los turnos de participación y la concentración de influencia. Crear otro grupo, en cambio, añade una realización del proceso de deliberación. Cuando existen errores compartidos dentro de cada grupo, varias unidades de discusión relativamente independientes pueden dar más variación informativa que una sola reunión ampliada.
Esa diferencia puede calcularse con un modelo sencillo de grupos de personas, todos del mismo tamaño, en el que cada respuesta contiene un error compartido por el grupo y un error individual . Ambos tipos de error tienen media cero, con varianza los grupales y los individuales. Se supone independencia entre grupos y entre todos los componentes individuales, así como entre los individuales y los grupales. La varianza del promedio de las respuestas es entonces
Con veinte personas, y , reunirlas en un solo grupo da una varianza de 16,45. Repartirlas en cuatro grupos de cinco la reduce a 4,45 y formar diez grupos de dos la deja en 2,05. Con el mismo número total de personas, lo que cambia es cuántas realizaciones independientes hay del error compartido. Son cálculos ilustrativos, ajenos a los datos del experimento de Navajas.
La comparación mantiene constantes las dos varianzas, mientras que en una tarea real un grupo demasiado pequeño puede perder conocimientos y aumentar su error individual o su sesgo. Pueden existir también errores comunes a todos los grupos, por ejemplo cuando reciben el mismo informe defectuoso, un componente global que permanecería al subdividir la reunión. El modelo indica qué parámetros habría que medir para decidir un tamaño en cada caso.
Hay asimismo un coste de integración. Las respuestas de grupos distintos pueden utilizar unidades, definiciones o supuestos incompatibles, por lo que antes de agregarlas se necesita un formato común para la cantidad que se estima y un registro de esas diferencias. Normalizar el formato mantiene abierta la posibilidad de combinar resultados, en tanto que imponer de antemano una misma interpretación sustantiva puede eliminar parte de la variación informativa que se intentaba obtener.
El estudio trabajó con preguntas verificables y una secuencia concreta. Trasladar el procedimiento a otra tarea exige un comparador justo, con igual tiempo, acceso semejante a fuentes y una regla de agregación fijada de antemano. Si los grupos que deliberan disponen además de más tiempo o información, la mejora conjunta mezcla el efecto de la discusión con el de esas ventajas. El mecanismo puede investigarse registrando qué razones aparecieron y qué revisiones provocaron.
La información disponible puede no llegar a la mesa
Stasser y Titus (1985) estudiaron grupos cuyos miembros recibían descripciones parciales de candidatos. Con la información distribuida entre todos podía formarse una evaluación más completa, pero las discusiones tendían a favorecer la información compartida previamente y compatible con las preferencias iniciales. Los grupos podían terminar eligiendo al candidato que al comienzo apoyaban más participantes, aunque la combinación de los datos disponibles favoreciera a otro.
El problema se aprecia en una situación hipotética de selección de un proveedor. Todos conocen dos ventajas de A. Tres personas poseen, cada una, un dato distinto que revela costes importantes de A, si bien ninguno, por separado, parece suficiente para descartarlo. Si la reunión empieza pidiendo preferencias, A puede recibir apoyo mayoritario. La reiteración de sus ventajas consume tiempo y hace parecer confirmada la preferencia mientras los tres costes siguen repartidos.
Pedir que se enumere primero la evidencia no compartida cambia la tarea conversacional. Cada participante tiene que presentar algo que los demás quizá no conozcan y el grupo puede verificar después si esos datos son independientes o describen el mismo problema. Así se vuelve examinable información que una discusión centrada en preferencias podría dejar fuera, aunque un dato exclusivo también puede ser falso.
La evaluación puede registrar qué proporción de hechos relevantes aparece, cuánto tiempo pasa hasta que se mencionan y si se tienen en cuenta al revisar la decisión. Una reunión donde todos hablaron el mismo número de minutos puede seguir omitiendo la información decisiva, porque la igualdad de participación y la cobertura informativa son magnitudes distintas, medibles ambas y posiblemente relacionadas.
Competencia, confianza y coordinación
Bahrami y colaboradores (2010) estudiaron decisiones perceptivas tomadas por parejas. Cuando las capacidades de discriminación visual eran semejantes y había comunicación, las decisiones conjuntas podían superar al mejor observador. Con capacidades muy desiguales esa ventaja podía desaparecer y la pareja rendir peor que su integrante más sensible. La comparación de modelos respaldó una explicación basada en compartir la confianza, que sin embargo no se registró como informe separado en cada ensayo.
El resultado pone una condición concreta al uso de la seguridad expresada, que solo ayuda cuando guarda una relación utilizable con la precisión en esa tarea. Una persona puede hablar con firmeza por familiaridad con el vocabulario o por su posición en el grupo, rasgos ajenos a una estimación calibrada de la probabilidad de acertar. La calibración se comprueba comparando grados de confianza con resultados a lo largo de muchos casos.
Supongamos que un equipo asigna una probabilidad de 0,80 a diez pronósticos binarios y que ocho de los acontecimientos ocurren y dos no. En este pequeño conjunto la frecuencia coincide con la probabilidad anunciada. La puntuación de Brier se define como la media de , donde es la probabilidad y vale uno si ocurre el acontecimiento y cero en caso contrario. Para los diez pronósticos del ejemplo es 0,16. Si el equipo hubiera anunciado 0,95 en los mismos diez casos, la puntuación habría sido 0,1825, peor según ese criterio.
Si se clasifican como positivos todos los casos con probabilidad superior a 0,5, la proporción de aciertos es de ocho de diez en ambas versiones. La diferencia aparece al evaluar las probabilidades, porque la puntuación penaliza la seguridad con que se anunciaron los dos fallos. Diez observaciones son pocas para establecer una calibración estable, pero sirven para ver por qué contar únicamente decisiones correctas oculta cambios en la calidad de la incertidumbre expresada.
Un grupo que aprende puede mejorar esa calibración sin cambiar de inmediato muchas decisiones, por ejemplo al reconocer que ciertas fuentes producen más errores de los esperados y reducir la confianza cuando depende de ellas. Esa corrección solo será visible si las probabilidades se guardan antes de conocer los resultados y se evalúan después, conservando también los casos donde el equipo prefirió expresar duda.
La especialización añade otra dificultad. Quien detecta bien un error de cálculo puede no ser quien mejor interpreta la calidad de una fuente. Asignar a cada persona un peso fijo para todos los problemas desperdicia esa variación. Una organización puede mejorar si identifica qué parte del juicio corresponde a cada competencia y conserva vías para que una observación inesperada modifique la decisión.
En las tareas complementarias el grupo tiene que producir, además, algo que ninguno podría entregar solo. Una revisión técnica, por ejemplo, puede requerir cálculo, comprobación documental y evaluación de supuestos. El rendimiento depende entonces de cómo se enlazan esas operaciones y de si una señal de error llega a tiempo a quien puede corregirla, una coordinación que habría que medir junto con los aciertos individuales.
Qué representa un factor de inteligencia colectiva
Woolley y colaboradores (2010) encontraron que el desempeño de grupos pequeños en distintas tareas compartía una estructura estadística y propusieron un factor de inteligencia colectiva correlacionado, entre otras variables, con la sensibilidad social y la distribución de turnos conversacionales. Un factor resume la covariación por la cual los grupos que rinden bien en ciertas tareas tienden también a rendir bien en otras. Su existencia estadística deja abierto qué mecanismo, o qué combinación de mecanismos, produce esas ventajas.
Riedl y colaboradores (2021) ampliaron el análisis a 22 estudios, con 5.279 participantes distribuidos en 1.356 grupos. Encontraron evidencia de un componente común y capacidad predictiva para tareas omitidas al calcular la puntuación. La corrección publicada en 2022 aclaró estadísticas de ajuste y revisó la varianza media extraída del análisis factorial, que pasó del 44 % al 19,6 %. Según la cifra corregida, el factor común recoge en promedio una fracción limitada de la varianza de los indicadores incluidos.
En esos análisis, las relaciones con los procesos de colaboración o con la composición del grupo siguen siendo asociaciones. Saber si cambiar la distribución de turnos mejora una tarea exige manipularla o identificar otra comparación causal defendible, además de medir si el cambio facilita que aparezca información nueva, si mejora la coordinación o si simplemente prolonga la actividad. Una puntuación global puede ayudar a predecir sin distinguir esas rutas.
La comparación con capacidades individuales ha de respetar lo que exige cada tarea. Algunas dependen mucho de habilidades que ya poseen los integrantes y otras requieren combinar aportaciones o evitar interferencias. Para explicar el rendimiento colectivo hay que observar cómo se usan esas capacidades. Un grupo puede incluir a alguien capaz de resolver el problema y fracasar igualmente, porque su propuesta nunca se examina o porque nadie consigue integrarla con las demás partes de la solución.
Una prueba que permita localizar el error compartido
Imaginemos una organización que quiere mejorar sus previsiones mensuales de demanda. Antes de reunir al equipo, cada integrante registra una estimación, un intervalo de incertidumbre y las fuentes utilizadas. Las previsiones se guardan con fecha para compararlas después con la demanda observada. La evaluación se centra en el error de la previsión y en la cobertura de sus intervalos, junto con el tiempo invertido en producirla.
Durante una serie suficiente de casos se comparan la agregación de las estimaciones iniciales, la discusión en un único grupo y la deliberación en grupos pequeños seguida de la agregación de sus respuestas. Los procedimientos se asignan de forma que ninguno reciba sistemáticamente los meses fáciles. Las ponderaciones y los criterios de error se fijan con datos anteriores, así que cada caso nuevo sirve para evaluar el procedimiento sin que la regla se modifique retrospectivamente a su favor.
Cuando varios pronósticos fallan juntos se reconstruyen sus fuentes. Quizá todos extrapolaron la misma temporada excepcional, o varios documentos reprodujeron una sola previsión original. En otros casos, una observación discrepante estaba disponible y desapareció durante la discusión. El primer tipo de fallo pide ampliar o revisar la base informativa y el segundo, examinar la distribución de influencia. Una reunión repetida con más personas dejaría ambas posibilidades sin distinguir.
La próxima comparación puede entonces ser precisa, ya sea manteniendo el tamaño del grupo y sustituyendo una fuente repetida por una medición independiente, ya sea manteniendo las fuentes y cambiando el orden en que se presentan las razones. Si el error compartido cae sin pérdida de exactitud individual, la media debería beneficiarse más del aumento de participantes. Si solo se estrechan los intervalos mientras su cobertura empeora, el equipo habrá aprendido a coincidir con más seguridad y quedará identificado el resultado que el nuevo procedimiento necesita corregir.
Referencias
Almaatouq, A., Rahimian, M. A., Burton, J. W., y Alhajri, A. J. (2022). The distribution of initial estimates moderates the effect of social influence on the wisdom of the crowd. Scientific Reports, 12, 16546. https://doi.org/10.1038/s41598-022-20551-7
Bahrami, B., Olsen, K., Latham, P. E., Roepstorff, A., Rees, G., y Frith, C. D. (2010). Optimally interacting minds. Science, 329(5995), 1081–1085. https://doi.org/10.1126/science.1185718
Becker, J., Brackbill, D., y Centola, D. (2017). Network dynamics of social influence in the wisdom of crowds. Proceedings of the National Academy of Sciences, 114(26), E5070–E5076. https://doi.org/10.1073/pnas.1615978114
Lorenz, J., Rauhut, H., Schweitzer, F., y Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. https://doi.org/10.1073/pnas.1008636108
Navajas, J., Niella, T., Garbulsky, G., Bahrami, B., y Sigman, M. (2018). Aggregated knowledge from a small number of debates outperforms the wisdom of large crowds. Nature Human Behaviour, 2(2), 126–132. https://doi.org/10.1038/s41562-017-0273-4
Riedl, C., Kim, Y. J., Gupta, P., Malone, T. W., y Woolley, A. W. (2021). Quantifying collective intelligence in human groups. Proceedings of the National Academy of Sciences, 118(21), e2005737118. https://doi.org/10.1073/pnas.2005737118
Correction for Riedl et al., Quantifying collective intelligence in human groups. (2022). Proceedings of the National Academy of Sciences, 119(19), e2204380119. https://doi.org/10.1073/pnas.2204380119
Stasser, G., y Titus, W. (1985). Pooling of unshared information in group decision making: Biased information sampling during discussion. Journal of Personality and Social Psychology, 48(6), 1467–1478. https://doi.org/10.1037/0022-3514.48.6.1467
Woolley, A. W., Chabris, C. F., Pentland, A., Hashmi, N., y Malone, T. W. (2010). Evidence for a collective intelligence factor in the performance of human groups. Science, 330(6004), 686–688. https://doi.org/10.1126/science.1193147