Dos depósitos contienen, en conjunto, diez litros de una solución. Una medición del volumen total asigna el mismo estado a dos preparaciones distintas, la que coloca los diez litros en el primer depósito y la que los coloca en el segundo. Los depósitos, sin embargo, tienen conductos de salida diferentes. Si el primero pierde cada hora una décima parte de su contenido y el segundo tres décimas, las tasas iniciales de salida serán un litro y tres litros por hora, respectivamente. El volumen total es el mismo, pero su evolución inmediata difiere. Quien pretenda predecir esa evolución con una sola variable tendrá que explicar qué ocurrió con la información sobre el reparto.
La dificultad aparece cada vez que se agrupan componentes. Una población de cien individuos puede distribuirse entre edades de muchas maneras, dos redes con igual número de conexiones pueden tener rutas muy distintas y un departamento puede cumplir una cuota de actividad concentrándola en pocas personas o repartiéndola ampliamente. En todos estos casos agregar supone eliminar diferencias que quizá sean irrelevantes para una pregunta y decisivas para otra, una elección que el nombre de nivel superior deja sin resolver.
Una explicación entre niveles identifica las relaciones por las que se pasa de una descripción a otra y determina qué predicciones sobreviven al cambio. Debe precisar también cómo intervienen las restricciones, de las cuales algunas delimitan estados posibles, otras mantienen conexiones o condiciones de contorno y otras son reglas que los componentes perciben y utilizan. Estas funciones pueden coincidir en un mismo sistema, aunque cada una exige una demostración diferente.
Qué relación organiza la jerarquía
Simon (1962) empleó el término jerarquía para describir sistemas compuestos por subsistemas que contienen, a su vez, otros subsistemas. Su definición incluía estructuras sin relaciones de autoridad. Una célula pertenece a un tejido en un sentido distinto de aquel en que una persona responde ante una dirección. Separar ambos sentidos evita trasladar al mundo físico la imagen de una oficina que recibe órdenes desde arriba, porque el esquema de partes dentro de partes expresa composición y deja abierta la cuestión de quién modifica a quién.
Esa jerarquía de composición se distingue de una ordenación por tamaño espacial, de una separación de escalas temporales y de una organización de control, tres criterios cuya coincidencia debe investigarse en cada caso. Una estructura extensa puede cambiar rápidamente. Una molécula situada dentro de una célula, en cambio, puede mantener durante bastante tiempo un estado que condicione procesos celulares breves. Una autoridad administrativa, por su parte, puede recibir información con retraso y actuar más lentamente que los equipos que supervisa.
Incluso las divisiones espaciales admiten alternativas. Un conjunto de personas puede agruparse por lugar de trabajo, por profesión o por vínculos de comunicación, particiones que responden a preguntas distintas y que pueden cruzarse. Si la propagación de una práctica sigue relaciones profesionales que atraviesan edificios, dividir por edificios ocultará interacciones relevantes. Un árbol de pertenencias es cómodo de dibujar, pero una estructura con pertenencias superpuestas necesita una representación que las conserve.
La elección del elemento básico también depende del problema. Para estudiar el tiempo que tarda un paquete en atravesar una red quizá baste tratar cada centro de distribución como una unidad con capacidad y demora. Si se quiere explicar por qué uno de esos centros se atasca, será necesario abrirlo y representar sus procesos internos, de manera que la unidad que era un componente pasa a ser el sistema estudiado. La operación es legítima si se explicitan las condiciones bajo las cuales su descripción anterior seguía siendo adecuada.
Para proponer esa división pueden compararse los flujos internos de cada centro con los flujos entre centros. Una agrupación con intercambio interno intenso y pocas transferencias externas es un candidato razonable a subsistema, aunque solo una prueba dinámica determina qué variables bastan para tratarla como unidad. Dos centros con igual carga total, por ejemplo, deberían producir distribuciones de demora semejantes bajo condiciones comparables. Si uno de ellos concentra paquetes en una etapa bloqueada, la carga total ya no predice su demora.
Hablar de niveles compromete, por tanto, a especificar una relación, que puede ser la pertenencia de unas partes a un conjunto, la equivalencia entre estados detallados que producen la misma medición o la dependencia entre procesos que cambian a ritmos diferentes. Dos investigaciones pueden utilizar la palabra nivel con significados distintos y obtener resultados compatibles. La confusión empieza cuando una propiedad demostrada para una de esas relaciones se atribuye automáticamente a las demás.
Agrupar estados exige una regla de evolución
Sea el estado detallado de un sistema en el instante y sea una descripción agregada, en la que la función reúne distintos estados detallados bajo un mismo valor (en los depósitos, ). Si la dinámica detallada es , una dinámica agregada autónoma tendría la forma . Para que ambas descripciones sean compatibles debe cumplirse
para todos los estados incluidos en el dominio de la afirmación. La igualdad dice que evolucionar y después agregar produce el mismo resultado que agregar y aplicar luego la regla correspondiente al agregado. Butterfield (2012) analiza esta compatibilidad entre dinámicas como una condición de cierre de la descripción macroscópica.
La prueba puede expresarse sin símbolos. Se buscan dos estados detallados que la medición agregada considere iguales y se comprueba si sus sucesores siguen siendo iguales para esa medición. Si alguno de esos pares diverge, el agregado actual no contiene toda la información necesaria para predecir su siguiente valor. El ejemplo de los depósitos falla precisamente por esa razón, ya que el volumen total no informa sobre cuánto líquido está expuesto a cada conducto de salida.
El fracaso admite varias respuestas. Se puede conservar una segunda variable que describa el reparto, restringir la predicción a preparaciones donde el reparto esté fijado o aceptar una aproximación cuya precisión se mida. También puede incorporarse memoria, pues la historia reciente del total quizá revele algo sobre la distribución oculta. Cada una de estas soluciones cambia el modelo, ya que una ecuación con memoria y otra que depende solo del estado presente tienen capacidades predictivas diferentes.
La autonomía obtenida siempre se refiere a una familia de preguntas. Un modelo de volumen total puede predecir bien el tiempo de vaciado y ser inútil para estimar la concentración junto a una válvula, cuya evolución depende de información que el total descarta. El ajuste de una curva a una trayectoria observada es, además, una prueba débil, puesto que una preparación particular puede recorrer una región donde la aproximación funciona mientras otra preparación con el mismo agregado inicial revela su insuficiencia.
Esta exigencia da contenido verificable a la idea de que una descripción superior tiene regularidades propias, que aparecen cuando muchas diferencias detalladas pueden variar sin alterar la relación que interesa explicar. La independencia respecto del detalle se demuestra comparando realizaciones alternativas, una prueba más exigente que mostrar que una ecuación con pocas variables ajusta los datos disponibles.
Una cadena de cuatro estados que permite cerrar el agregado
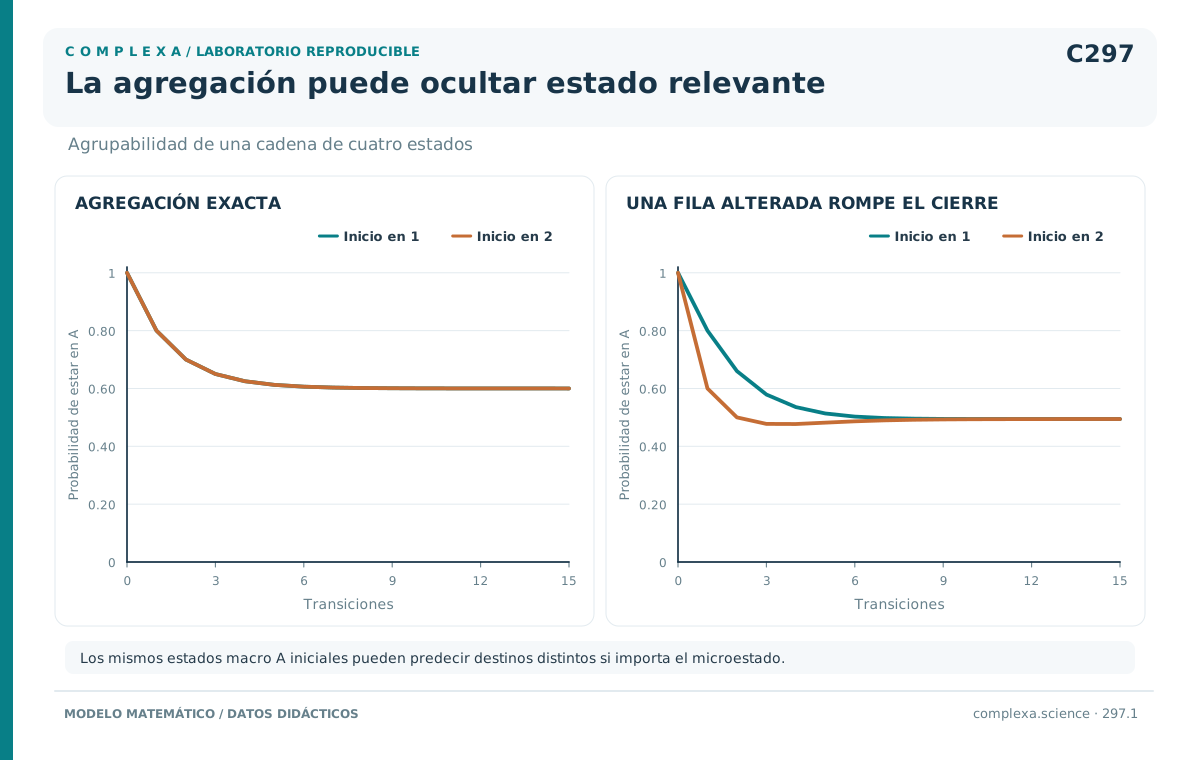
En sistemas probabilísticos la condición se formula sobre distribuciones de transición. Consideremos un ejemplo didáctico con cuatro estados, numerados del 1 al 4, en el que cada fila de la tabla indica las probabilidades de pasar desde el estado de esa fila a los cuatro estados de la siguiente observación. Todas las filas suman uno.
| Estado actual | Estado 1 | Estado 2 | Estado 3 | Estado 4 |
|---|---|---|---|---|
| 1 | 0,60 | 0,20 | 0,10 | 0,10 |
| 2 | 0,10 | 0,70 | 0,15 | 0,05 |
| 3 | 0,05 | 0,25 | 0,40 | 0,30 |
| 4 | 0,20 | 0,10 | 0,10 | 0,60 |
Agrupemos los estados 1 y 2 en la categoría A y los estados 3 y 4 en la categoría B. Desde cualquiera de los dos estados de A la probabilidad de permanecer en A es 0,80, mientras que desde cualquiera de los dos estados de B la probabilidad de pasar a A es 0,30. Las diferencias entre las filas siguen existiendo, pero desaparecen al sumar las columnas dentro de cada categoría.
Si es la probabilidad de estar en A, la dinámica agregada queda exactamente definida por
Desde , los cinco valores siguientes son 0,40; 0,50; 0,55; 0,575 y 0,5875. El equilibrio satisface , de donde . Ninguno de estos cálculos requiere conocer el reparto entre los estados 1 y 2. La condición empleada, según la cual todos los estados detallados de una categoría tienen la misma probabilidad total de alcanzar cada categoría de destino, suele denominarse agrupabilidad fuerte.
Cambiemos ahora únicamente la segunda fila por . La probabilidad de permanecer en A desde el estado 2 pasa a ser 0,60, mientras que desde el estado 1 continúa siendo 0,80. Una preparación concentrada en el estado 1 y otra concentrada en el estado 2 tienen ambas , pero producen y , respectivamente. Ya no existe una única transición de A a A válida para cualquier reparto interno.
Asignarles el promedio 0,70 introduce la hipótesis adicional de que, al preparar A, los dos estados detallados tengan igual probabilidad. Esa hipótesis puede corresponder a un procedimiento experimental concreto. Como la distribución interna puede cambiar después de una transición, reutilizar el promedio en todos los pasos exige justificar por qué el reparto vuelve a ser el mismo. El historial de entradas en A puede dejar una memoria que la etiqueta A oculta.
Esta pequeña modificación muestra qué debe verificarse cuando se propone que varios estados forman una unidad funcional. Para cerrar una dinámica, la agrupación tiene que conservar las probabilidades pertinentes, una condición que pueden incumplir estados visualmente semejantes o pertenecientes a una misma estructura anatómica. El ejemplo muestra también por qué una descripción puede ser exacta bajo ciertos protocolos de preparación y fallar cuando se interviene de otra manera sobre sus componentes.
Con datos finitos las probabilidades de la tabla se estiman y casi nunca coinciden exactamente, de manera que puede compararse cuánto difieren las probabilidades de destino entre estados de una misma categoría y cuánto error produce tratarlas como iguales. La tolerancia dependerá del uso, porque una diferencia pequeña en una predicción de un paso puede acumularse durante una simulación prolongada. Ambos horizontes deben evaluarse con preparaciones que no se hayan utilizado para ajustar la matriz.
El reparto interno puede examinarse también de forma indirecta. Si, conocida la categoría actual, añadir la categoría anterior mejora sistemáticamente la predicción del siguiente paso, hay información que el estado agregado presente no conserva. Eso orienta la búsqueda de memoria o de variables omitidas. La comparación debe controlar el tamaño de muestra y la complejidad del predictor, dado que un modelo más flexible puede ajustar mejor por disponer de más parámetros. Su ventaja relevante es la que permanece en datos nuevos y se reproduce al cambiar la preparación inicial.
La separación de tiempos puede recuperar una aproximación
Volvamos a los depósitos e introduzcamos intercambio de líquido entre ellos mediante un modelo lineal didáctico con cantidades y , medidas en litros. El parámetro , en horas inversas, mide la rapidez del intercambio, que tiende a igualar las cantidades. Con tasas de pérdida hacia el exterior y , también en horas inversas, el sistema es
Si se definen el total y la diferencia , al sumar y restar las ecuaciones se obtiene
El intercambio se cancela en la ecuación del total porque traslada líquido dentro del sistema. Su efecto persiste a través de la diferencia entre depósitos. Con , y , las ecuaciones se convierten en y , en las que la diferencia cambia rápidamente comparada con el total.
Una aproximación cuasiestacionaria supone que se ajusta con rapidez al valor que anula su derivada para el total presente. Entonces y la ecuación reducida es . La solución del sistema completo contiene dos modos exponenciales, con tasas aproximadas de −2,20499 y −0,19501 por hora. El primero decae pronto. El segundo domina después y su tasa exacta difiere de la aproximación en alrededor de un 0,23 %.
La precisión se pierde al estrechar el conducto de intercambio. Con los mismos valores de y , pero con , las tasas exactas son −0,32198 y −0,11802 por hora. Para el modo lento, la aproximación anterior, calculada ahora con el nuevo , predice −0,15833, con un error relativo cercano al 34 %. Los dos ritmos ya no están lo bastante separados para eliminar la diferencia con la misma confianza.
La reducción describe mal, por otra parte, el instante que sigue a ciertas preparaciones. Si todo el líquido empieza en el segundo depósito, la salida inicial sigue siendo mayor que con el reparto inverso. Como el modo rápido conserva durante un tiempo información sobre ese desequilibrio, antes de utilizar una ecuación reducida hay que fijar desde cuándo se la considera válida y cómo se determina su condición inicial una vez pasado el transitorio.
Simon y Ando (1961) desarrollaron el análisis de sistemas casi descomponibles, en los cuales ciertas interacciones permiten distinguir subsistemas y describir su comportamiento agregado. Esos agrupamientos valen para una escala temporal determinada, porque una interacción débil por unidad de tiempo puede acumular efectos considerables. Weinberger (2020) examina cómo cambian las representaciones causales al elegir escalas de observación diferentes. Un factor tratado como constante en un experimento breve, por ejemplo, puede convertirse en variable endógena en un seguimiento prolongado.
En una investigación real la separación de tiempos debe estimarse y someterse a perturbaciones. Dos promedios que varían lentamente son compatibles con un componente oculto de memoria prolongada, así que la rapidez con que se relajan los detalles internos requiere una prueba propia. La predicción pertinente es que preparaciones internas distintas converjan hacia una relación común entre y antes de que cambie mucho la cantidad total que se pretende describir.
Qué hace una restricción
Una restricción puede reducir el conjunto de estados accesibles sin determinar por completo la trayectoria. El extremo de un péndulo ideal de longitud fija , con coordenadas y respecto del punto de suspensión, satisface , condición que excluye las posiciones fuera de la circunferencia. Para calcular el movimiento todavía hacen falta fuerzas, condiciones iniciales y, cuando corresponda, disipación, con lo cual la geometría da una parte de la explicación y deja abiertas las demás decisiones.
La restricción, además, debe mantenerse físicamente. La cuerda ejerce tensión, el soporte recibe fuerzas y cualquier modificación de longitud exige un mecanismo que la produzca. Describir la circunferencia ahorra esos detalles sin introducir una entidad adicional que empuje al péndulo. Cuando la cuerda se rompe desaparece el mecanismo que mantenía esa relación y cambia el conjunto de movimientos posibles, por lo que la comparación entre el antes y el después muestra el papel de la restricción.
En los depósitos, la pared y los conductos delimitan por dónde puede circular el líquido. Cambiar una válvula modifica una tasa de transferencia aunque la cantidad inicial permanezca igual. La configuración tiene relevancia explicativa porque interviene en las ecuaciones que relacionan estados y cambios. Sin ella, las propiedades del líquido dejarían indeterminado el problema de circulación que se trata de resolver.
Algo semejante ocurre con las reglas organizativas, aunque su implementación sea distinta. Un horario compartido puede impedir ciertos encuentros y facilitar otros. Explicar su efecto exige describir cómo llega a las personas, qué recursos pueden reservarse con él y qué consecuencias tiene incumplirlo. Como la regla escrita y la conducta efectiva pueden separarse, un cambio del documento que deje iguales las reservas, los incentivos y las expectativas quizá no haya modificado la restricción que operaba en la práctica.
El diseño de una prueba adecuada depende de qué posibilidades desaparecen bajo una restricción y mediante qué proceso, dos preguntas cuyas respuestas separan tipos de influencia muy distintos. Un límite de capacidad excluye ciertas cargas simultáneas. Una norma puede dejarlas físicamente posibles, pero costosas o improbables. Un promedio descriptivo, por último, puede no excluir ninguna trayectoria.
Las restricciones difieren también en su duración. Algunas se mantienen durante el proceso estudiado y pueden representarse mediante parámetros. Otras son alteradas por ese mismo proceso, como sucede cuando un conducto se obstruye, una regla pierde cumplimiento o una conexión se refuerza con el uso. En ese caso hace falta una ecuación para su cambio o una secuencia explícita de regímenes, puesto que al ampliar el intervalo de observación la frontera entre variable y condición de contorno puede desplazarse.
Composición, mecanismo e intervención
Una relación constitutiva indica de qué depende la descripción de un conjunto en términos de sus componentes. Si , cambiar manteniendo fijos a la vez ambos valores es imposible dentro del modelo por la propia definición del agregado. Una intervención sobre el volumen total conserva pleno sentido, a condición de que se explique cómo se realiza mediante cambios compatibles en los depósitos.
Craver y Bechtel (2007) proponen analizar muchos efectos descritos como ascendentes o descendentes mediante combinaciones de relaciones causales y constitutivas. Su posición invita a reconstruir el mecanismo y a distinguir una interacción que transcurre en el tiempo de la relación por la que unas partes constituyen un sistema. Se trata de una propuesta filosófica específica. El lenguaje de causalidad entre niveles recibe otros tratamientos, como el de Butterfield, todos los cuales comparten la tarea empírica de identificar cambios realizables y sus consecuencias.
Supongamos que se pide aumentar el total de diez a doce litros. Una implementación añade dos litros al primer depósito y otra los añade al segundo, con contribuciones iniciales a la salida de 0,20 y 0,60 litros por hora según las tasas originales. La instrucción agregada deja indeterminado el efecto inmediato, aunque la diferencia entre ambas implementaciones puede disminuir después si el intercambio interno es rápido. El significado causal del cambio agregado depende, por tanto, del procedimiento y del horizonte temporal en que se mide el resultado.
Una intervención macroscópica bien especificada incluye una regla para distribuirla entre realizaciones detalladas o bien evidencia de que distintas realizaciones pertinentes producen resultados equivalentes. En el primer caso se estudia el efecto de un protocolo concreto y en el segundo se establece una invariancia más amplia, dos investigaciones que pueden ser útiles aunque respondan a preguntas diferentes y admitan distinta generalización.
El mismo problema aparece en las comparaciones entre organizaciones. Aumentar la dotación de un equipo puede significar incorporar experiencia escasa, sumar personal en un turno saturado o reforzar un horario con poca demanda. Una variable que solo registre el número de integrantes agrupa esas intervenciones heterogéneas, que siguen siéndolo aunque se las describa como cambios de nivel institucional. Si sus efectos divergen, el análisis debe conservar las características que explican esa divergencia.
La comprobación puede organizarse con dos manipulaciones separadas. Primero se cambia el agregado mediante varias realizaciones internas y después se redistribuyen los componentes manteniendo fijo el agregado. Si la segunda manipulación altera de forma apreciable el resultado, queda demostrada una dependencia del detalle que el modelo reducido omitía. Esa dependencia puede limitarse a ciertos resultados o intervalos temporales, razón por la cual deben medirse ambos.
Diferencias entre grupos y cambios dentro de ellos
Los niveles también aparecen en el diseño estadístico, cuando varias observaciones pertenecen a una persona, varias personas a un equipo o varios equipos a una organización. Esa estructura puede ayudar a separar fuentes de variación e indica qué comparaciones están disponibles. La explicación del mecanismo, en cambio, depende de cómo se produjeron las diferencias observadas.
Tomemos cuatro observaciones inventadas sobre experiencia laboral y minutos necesarios para resolver una solicitud. En el equipo A, dos trabajadores con dos y cuatro años de experiencia tardan ocho y cuatro minutos, respectivamente. En el equipo B las experiencias son de seis y ocho años, con tiempos de veinte y dieciséis minutos. Dentro de ambos equipos, dos años adicionales se asocian con cuatro minutos menos, es decir, con una pendiente interna de −2 minutos por año de experiencia.
La comparación entre equipos produce otra relación. Las medias de experiencia son tres y siete años y las de tiempo, seis y dieciocho minutos. Entre esas medias, cuatro años adicionales se asocian con doce minutos más y la pendiente es +3. Si se mezclan los cuatro puntos y se ajusta una sola recta, su pendiente es +2, un valor que no reproduce ninguna de las dos relaciones separadas inicialmente. Las tres operaciones son aritméticamente correctas y responden a comparaciones diferentes.
Una representación que conserva la distinción es
donde identifica trabajadores, equipos, es la experiencia, su media en el equipo y el tiempo de resolución. El coeficiente describe la asociación interna y la asociación entre medias, en tanto que recoge la variación no representada. Los cuatro datos didácticos satisfacen exactamente esta ecuación con , , y residuos nulos. Con tan pocas observaciones el ejemplo ilustra la descomposición, pero una estimación empírica fiable exigiría muchos más datos.
Podría ocurrir que el equipo con más experiencia recibiera las solicitudes difíciles. Esa asignación explicaría de manera plausible la diferencia entre equipos, pero los cuatro números no la verifican y habría que medir la dificultad y el proceso de asignación. La pendiente interna tampoco identifica automáticamente el efecto causal de adquirir experiencia, ya que los trabajadores pueden diferir en formación, herramientas o tareas. La descomposición localiza así una pregunta que el promedio mezclaba, cuya respuesta queda por investigar.
Curran y Bauer (2011) estudian una distinción análoga entre las diferencias entre personas y las variaciones dentro de una misma persona a lo largo del tiempo. Que quienes presentan valores medios mayores de una variable también presenten valores medios mayores de otra deja abierto cómo cambia la segunda cuando la primera varía en una persona concreta. La evidencia necesaria para responderlo procede de las fluctuaciones individuales y de sus condiciones de observación.
En los seguimientos longitudinales surge una complicación adicional. Restar la media personal deja intacta cualquier tendencia temporal, así que una desviación respecto de esa media puede reflejar simplemente que la observación se realizó al principio o al final del estudio. Curran y Bauer analizan este problema y las limitaciones de distintos procedimientos de separación. Para investigar, por ejemplo, la relación entre cambios cotidianos de carga y rendimiento habría que distinguir las fluctuaciones breves de un aprendizaje gradual común a ambas series, con lo cual la escala temporal elegida vuelve a intervenir en lo que se interpreta como relación dentro de un nivel.
Cuando el propio sistema utiliza un agregado
El investigador puede calcular un promedio que ningún componente percibe. En otras situaciones son los propios componentes los que reúnen información y actúan según una estimación colectiva. Flack (2017) distingue estas dos operaciones y propone estudiar la segunda como una vía concreta para analizar influencias entre niveles. La pregunta se amplía entonces. Además de examinar si el agregado predice, hay que averiguar si alguna parte del sistema lo estima y lo utiliza.
En un ejemplo organizativo hipotético, cada equipo decide cuántas solicitudes nuevas aceptar según un indicador semanal de carga conjunta. El indicador resume expedientes distribuidos entre varias unidades y regresa después a ellas mediante una pantalla o un informe. El circuito incluye un procedimiento de cálculo, un canal de comunicación y una regla de decisión. Suprimir el indicador, retrasarlo o modificar qué casos cuenta son intervenciones diferentes sobre ese mecanismo.
El promedio real y la estimación disponible pueden divergir. Si los datos llegan con retraso, las decisiones responden a una carga pasada. Si algunas unidades registran casos con mayor diligencia, su contribución al indicador puede quedar sobrerrepresentada. El agregado con que el analista evalúa la situación quizá no coincida con el que utiliza el equipo. Con el registro de ambos pueden distinguirse los cambios en el entorno de los cambios en la representación compartida.
Flack desarrolla su propuesta con ejemplos biológicos y sociales, entre ellos señales que resumen historias de interacción en macacos. El artículo formula criterios y mecanismos candidatos, sin presentar un experimento controlado que establezca de manera general una causalidad descendente. Su utilidad aquí está en volver examinable una afirmación que, de otro modo, quedaría en la expresión vaga de que el grupo influye sobre sus miembros.
En el caso hipotético, una prueba informativa mantendría la carga real y alteraría la disponibilidad o el retraso del indicador. Si las decisiones cambiaran en el sentido previsto, quedaría identificada una vía mediada por información. Habría que comprobar también qué personas consultaron el indicador y si el cambio afectó a los recursos disponibles, ya que una perturbación que altere a la vez información y capacidad confunde sus contribuciones.
Comparar explicaciones sin cambiar inadvertidamente la pregunta
Hoel, Albantakis y Tononi (2013) propusieron comparar escalas mediante información efectiva, una medida definida sobre perturbaciones de un sistema y sus efectos. En su procedimiento, que considera equiprobables los estados intervenidos en cada escala, determinadas agrupaciones pueden producir un valor mayor que la descripción detallada. Ese resultado, relativo a una medida y a un diseño de intervenciones especificados, es mucho más restringido que la tesis de que cualquier resumen contenga más información que los datos de partida.
La distribución de intervenciones ayuda a entenderlo. Imaginemos ocho estados detallados agrupados en dos categorías, una con dos estados y otra con seis. Intervenir uniformemente sobre los ocho estados asigna a las categorías probabilidades de un cuarto y tres cuartos, mientras que intervenir uniformemente sobre las dos categorías les asigna una mitad a cada una. Si después se elige uniformemente dentro de cada categoría, cada estado de la primera recibe probabilidad un cuarto y cada estado de la segunda, un doceavo.
Ambos procedimientos son coherentes, pero ponderan de manera diferente las situaciones del sistema. La comparación de información efectiva incorpora ese cambio de repertorio de intervenciones y es, por eso, compatible con la desigualdad de procesamiento de datos, que limita la información obtenible mediante transformaciones bajo una distribución conjunta fijada. Su cálculo descansa sobre la preparación experimental de los estados, una operación distinta de la observación frecuente de un estado, por lo que la medida no convierte una asociación observacional entre promedios en una estimación causal.
En una explicación aplicada, la elección puede depender de qué cambios sean realizables. Quizá sea imposible fijar cada configuración microscópica y sí pueda controlarse una cantidad agregada, o puede ocurrir que una intervención detallada sea precisa en el laboratorio y pierda estabilidad fuera de él. La escala útil se evalúa atendiendo a los resultados que predice, a la gama de situaciones donde conserva precisión y a las intervenciones que representa adecuadamente.
En los depósitos, esa evaluación admite un protocolo directo. Se prepara repetidamente el mismo volumen total con diferentes repartos, se mide la salida desde el inicio y se repite la prueba con dos valores del intercambio. Con , la ecuación reducida debería describir razonablemente la fase posterior al ajuste rápido. Con , conservar el reparto interno debería mejorar de forma apreciable la predicción. Si las diferencias persisten cuando el modelo espera que hayan desaparecido, será necesario medir una variable omitida o revisar la ley de intercambio. El resultado decidirá en qué intervalo puede tratarse el volumen total como un estado suficiente.
Referencias
Butterfield, J. (2012). Laws, causation and dynamics at different levels. Interface Focus, 2(1), 101–114. https://doi.org/10.1098/rsfs.2011.0052
Craver, C. F., y Bechtel, W. (2007). Top-down causation without top-down causes. Biology & Philosophy, 22(4), 547–563. https://doi.org/10.1007/s10539-006-9028-8
Curran, P. J., y Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62, 583–619. https://doi.org/10.1146/annurev.psych.093008.100356
Flack, J. C. (2017). Coarse-graining as a downward causation mechanism. Philosophical Transactions of the Royal Society A, 375(2109), 20160338. https://doi.org/10.1098/rsta.2016.0338
Hoel, E. P., Albantakis, L., y Tononi, G. (2013). Quantifying causal emergence shows that macro can beat micro. Proceedings of the National Academy of Sciences, 110(49), 19790–19795. https://doi.org/10.1073/pnas.1314922110
Simon, H. A. (1962). The architecture of complexity. Proceedings of the American Philosophical Society, 106(6), 467–482. https://www.jstor.org/stable/985254
Simon, H. A., y Ando, A. (1961). Aggregation of variables in dynamic systems. Econometrica, 29(2), 111–138. https://doi.org/10.2307/1909285
Weinberger, N. (2020). Near-decomposability and the timescale relativity of causal representations. Philosophy of Science, 87(5), 841–856. https://doi.org/10.1086/710760