Un detector responde a ocho de diez señales de prueba. Dos técnicos habían propuesto tasas de detección distintas. Uno esperaba que respondiera a la mitad de las señales y el otro, al ochenta por ciento. Como las diez pruebas ya se hicieron, para comparar sus propuestas podemos calcular con qué probabilidad habría aparecido ese resultado bajo cada una. La comparación exige precisar que las señales estaban presentes en todos los ensayos, que la respuesta se codificó siempre de la misma manera y que las pruebas se suponen independientes, con una probabilidad de detección constante. Los números del caso son inventados para desarrollar el cálculo.
Con esas condiciones, ocho detecciones en diez intentos tienen una probabilidad aproximada de 0,044 si la tasa es 0,5 y de 0,302 si es 0,8, de modo que el segundo valor es unas 6,87 veces el primero. Hemos comparado dos explicaciones estadísticas del mismo registro. Calcular la probabilidad de que cada técnico tenga razón o comprobar que el detector mantiene una tasa constante son tareas que requieren otros elementos.
La verosimilitud organiza esta comparación con una notación que separa lo observado de lo propuesto. Su utilidad depende de esa separación tanto como de la distribución elegida, pues una fórmula binomial puede estar perfectamente calculada y describir mal el procedimiento que produjo la tabla.
Los datos permanecen fijos
Sea el número de detecciones en diez ensayos y la probabilidad de detección en cada uno. Antes de observar las pruebas, la distribución binomial asigna a los once resultados posibles, de cero a diez, probabilidades que suman uno para cada valor fijo de . Una vez observado , podemos conservar ese ocho y recorrer los valores posibles de con la función
La letra designa la función de verosimilitud. La expresión de la derecha sigue siendo una probabilidad del resultado observado bajo el parámetro indicado, mientras que la función de la izquierda ordena esas evaluaciones sobre el eje de los parámetros sin invertir el condicionamiento que daría . Fisher (1922) formuló esta distinción entre probabilidad y verosimilitud, que sigue siendo el punto de partida de exposiciones actuales como la de Etz (2018).
El coeficiente binomial vale 45 y cuenta las maneras de situar las dos ausencias de respuesta entre las diez pruebas. Cada orden concreto con ocho detecciones tiene probabilidad . Los 45 órdenes son mutuamente excluyentes y la distribución del recuento los reúne en un solo término, porque el dato que entra en este cálculo es el total de detecciones.
| Probabilidad propuesta | Verosimilitud del recuento observado |
|---|---|
| 0,20 | 0,000073728 |
| 0,50 | 0,043945313 |
| 0,80 | 0,301989888 |
| 0,95 | 0,074634799 |
La tabla corrige también la lectura apresurada según la cual un recuento alto como ocho favorecería por igual a cualquier probabilidad alta. Una tasa de 0,95 hace menos habituales las dos ausencias de respuesta y por eso su verosimilitud queda por debajo de la correspondiente a 0,8. En los extremos, una tasa de uno atribuye probabilidad cero a esos dos fallos y una tasa de cero tampoco puede producir las ocho detecciones.
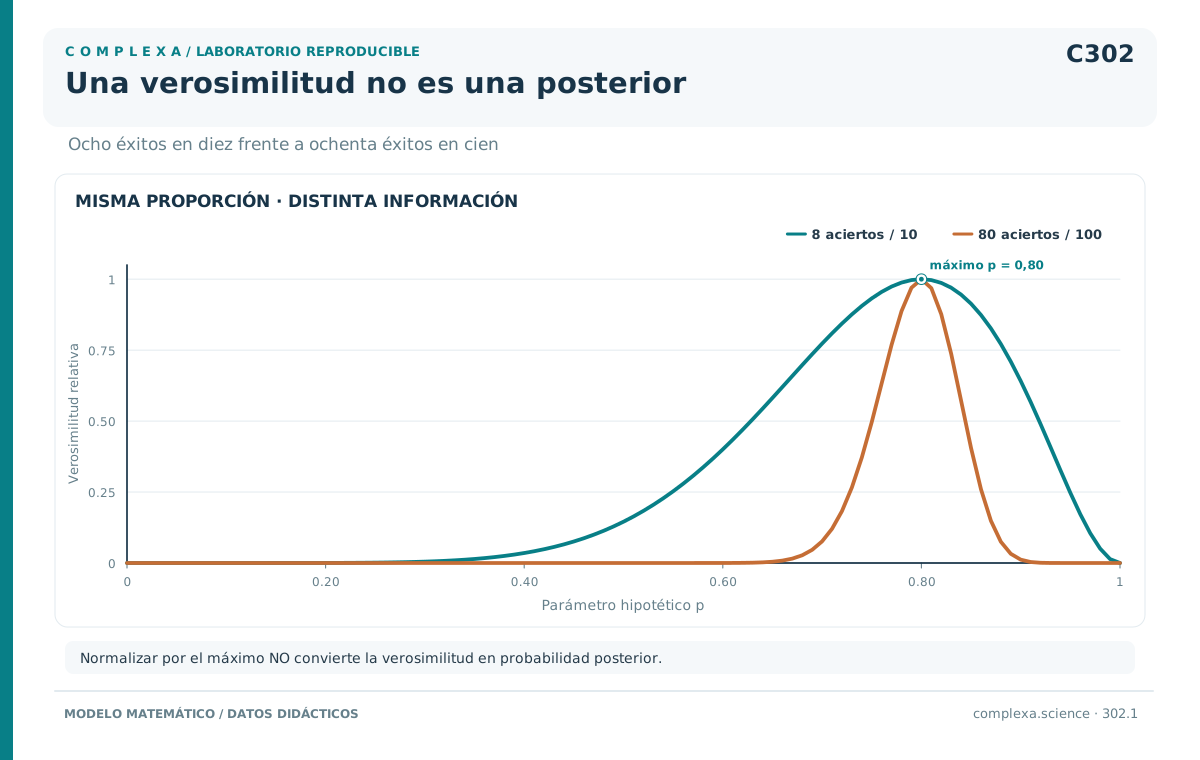
El valor 0,8 maximiza esta función y marca la cima de la curva, aunque para interpretar la evidencia interesa mirar también otros puntos. Los valores 0,95 y 0,8 son compatibles con el registro, pero le asignan pesos cuya razón es aproximadamente 0,247. Aquí basta con evaluar esas propuestas. Encontrar parámetros en modelos con muchas dimensiones añade un problema de estimación que es preferible mantener separado de la construcción de la función.
Si conservamos el orden completo de las pruebas, la verosimilitud de una secuencia específica con ocho unos y dos ceros es 45 veces menor que la del recuento. Todas las razones entre valores de coinciden, sin embargo, en ambas representaciones, dado que el factor 45 no depende de ese parámetro. Bajo el modelo binomial, una vez conocido el total, saber dónde quedaron los dos ceros no añade información sobre . Esta conclusión descansa en la independencia y en la tasa constante. Dejaría de valer si el orden contuviera información sobre persistencia o aprendizaje.
El tamaño del conjunto observado cambia la comparación aunque la proporción se mantenga. Si otro ensayo independiente, con la misma regla de registro y las mismas condiciones del modelo, produce ochenta detecciones en cien pruebas, la razón entre 0,8 y 0,5 es la décima potencia de 6,87, aproximadamente 235 millones. Dentro de la razón se cancela en cada ensayo el factor combinatorio y quedan los exponentes, que con ochenta detecciones y veinte ausencias son diez veces los del caso inicial. Esa multiplicación de la evidencia presupone que las cien pruebas son las contribuciones independientes que declara el modelo, condición que se pierde al copiar o agrupar observaciones dependientes.
Por la misma razón, una proporción aislada es insuficiente para reconstruir la verosimilitud. Los registros «80 % de detecciones» pueden proceder de diez, cien o mil ensayos, cada uno con su propia curva, así que el número de oportunidades de observación debe acompañar al resultado. Hace falta también conservar qué se contó como oportunidad. Si se excluyen los intentos en que el dispositivo estuvo desconectado, la probabilidad se refiere a la detección durante su funcionamiento. Si en cambio se incluyen como fallos, describe el rendimiento del sistema completo bajo esa regla. Ambas definiciones pueden responder a preguntas razonables, pero etiquetan parámetros diferentes.
En las pruebas originales sabíamos que cada señal estaba presente. En el uso cotidiano quizá solo se observe si el detector responde, sin saber si había una señal, con lo cual cambia el parámetro del recuento. Supongamos que la proporción de ocasiones con señal es π, que el aparato responde al noventa por ciento de las señales y que produce una respuesta falsa en el diez por ciento de las ocasiones sin señal. La probabilidad observada de respuesta es entonces 0,9π más 0,1 por uno menos π, es decir, 0,1 más 0,8π.
Con una proporción de señales de 0,875, la probabilidad de respuesta sería 0,8. El modelo binomial podría seguir describiendo el recuento bajo las condiciones de independencia correspondientes, pero su parámetro de respuesta ya no sería directamente la frecuencia de señales. Para evaluar π hay que introducir esa relación en la verosimilitud y justificar las tasas de detección y de falsa respuesta utilizadas. La variable registrada y el fenómeno de interés quedan así conectados mediante un modelo de observación explícito.
Comparar valores sin asignarles probabilidades
La razón de verosimilitudes entre dos propuestas concretas expresa cuánto más peso da una al dato observado que la otra. En el detector vale
Decir que el registro favorece 0,8 frente a 0,5 en esa razón describe una comparación dentro de los supuestos declarados. La frase «hay una probabilidad de 6,87 a uno de que 0,8 sea el valor verdadero» plantea una pregunta distinta, ya que asignar probabilidades posteriores a hipótesis exige especificar para ellas un modelo probabilístico con sus probabilidades previas. La probabilidad de equivocación a largo plazo es una tercera cantidad, que se obtiene estudiando cómo se comportaría una regla de decisión en repeticiones del procedimiento.
La normalización puede producir confusión. Dividir cada valor de la curva por su máximo da una verosimilitud relativa cuya altura máxima es uno. Esa escala facilita dibujar y comparar valores, pero sus áreas siguen sin ser probabilidades. Si dividimos por el área total respecto de , obtenemos otra función, normalizada respecto de una medida concreta sobre ese parámetro. Elegir esa medida añade información que la razón original no contenía.
Podemos verlo al expresar la misma probabilidad mediante el logaritmo de sus oportunidades, . En esa escala el valor corresponde a , aproximadamente 1,386. Para escribir la verosimilitud como función de basta sustituir por , sin ningún factor jacobiano, porque solo cambian el nombre y la escala del parámetro que etiqueta la misma distribución de datos. Cada propuesta conserva exactamente su verosimilitud.
Una densidad de probabilidad sobre , en cambio, requiere un jacobiano al transformarse en una densidad sobre . Normalizar la curva respecto de y normalizarla respecto de son, por tanto, operaciones diferentes. De ahí que una curva de verosimilitud no traiga incorporada una distribución de probabilidad sobre sus parámetros. El desarrollo bayesiano parte de la misma verosimilitud y le añade una distribución previa explícita.
Las razones requieren además un denominador claro. El resultado 6,87 compara 0,8 con 0,5, que es solo una de las alternativas posibles a 0,8. Una hipótesis compuesta como «la tasa supera 0,7» contiene muchos valores y compararla exige decidir cómo tratar esa multiplicidad. Esa decisión, que puede consistir en tomar un máximo, integrar con una distribución previa o construir una prueba, depende de criterios ajenos al número calculado para dos puntos.
Una probabilidad de cola responde a otra pregunta y usa otro conjunto de resultados. Bajo la tasa 0,5, la probabilidad de exactamente ocho detecciones es 0,043945 y la de ocho o más, que suma también los resultados nueve y diez, es 0,054688. Mientras la primera evalúa el recuento registrado, la segunda puede utilizarse en una regla que considera relevantes todos los resultados al menos tan altos como ocho. Para interpretar una cifra pequeña hay que saber qué sucesos se sumaron y con qué propósito, ya que ninguna operación automática la transforma en la probabilidad del parámetro.
De una razón grande tampoco se deduce una explicación causal. Un detector que cambia con la temperatura y otro con una tasa estable pueden asignar probabilidades similares a un recuento corto. La verosimilitud evalúa la distribución especificada del registro, de manera que dos mecanismos que generan esa misma distribución para las observaciones disponibles reciben la misma evaluación aunque sus procesos internos sean diferentes. Para separarlos harían falta observaciones en las que sus predicciones divergieran, por ejemplo registros bajo temperaturas controladas, junto con un modelo que utilizara esa información.
Densidades y unidades de medida
Los datos continuos requieren otro cuidado. Supongamos que un aparato produce una duración medida en segundos, para la que usamos una distribución normal con media y desviación típica conocida de 0,1 segundos. Una lectura observada de 0,5 segundos tiene entonces densidad
Si , el valor es aproximadamente 3,989 por segundo. Que supere uno no es un error. Una densidad mide probabilidad por unidad de la variable y las probabilidades se obtienen integrándola sobre intervalos. En una distribución continua la probabilidad de cualquier punto exacto, incluido 0,5, es cero. Si sustituyéramos la densidad por esa probabilidad puntual, todas las propuestas quedarían con cero y la comparación desaparecería.
La densidad resume cómo se distribuye la probabilidad cerca del valor observado. Para el intervalo de 0,495 a 0,505 segundos, la integral da la probabilidad exacta bajo , que es aproximadamente 0,039878. Multiplicar la densidad central por la anchura, 0,01 segundos, da 0,039894, una aproximación cercana porque la curva cambia poco dentro de ese intervalo.
Si el aparato redondea a centésimas, el registro «0,50» corresponde a un intervalo de valores determinado por su regla de redondeo y su contribución exacta es una probabilidad de intervalo. Cuando la resolución es fina en relación con la variabilidad, esa probabilidad suele aproximarse mediante la densidad central multiplicada por la anchura. Con intervalos de anchura común que no dependen de los parámetros, la anchura se cancela en las razones. Con un redondeo grueso la aproximación puede alterar la forma de la verosimilitud y lo indicado es integrar.
Escribamos ahora el mismo dato en milisegundos. La observación es 500, la media propuesta 500 y la desviación típica 100, con lo que la densidad pasa a 0,003989 por milisegundo. Aunque la lectura, su precisión física y el modelo son los mismos, la altura numérica se ha dividido por mil porque cada unidad horizontal equivale ahora a una milésima de segundo. La probabilidad del intervalo de diez milisegundos sigue siendo 0,039878.
Al comparar con segundos, ambas con desviación típica 0,1, las densidades son 3,989 y 2,420, con una razón aproximada de 1,649 que permanece idéntica en milisegundos, donde ambas se dividen por mil. En general, una transformación invertible de los datos, fijada sin depender de los parámetros, multiplica sus densidades por un jacobiano común a las propuestas comparadas, factor que modifica las alturas absolutas y se cancela en las razones.
Por eso un valor aislado de verosimilitud continua carece de una escala universal de «buen ajuste», ya que su magnitud depende de la unidad elegida, de la concentración de la distribución y del número de observaciones. Comparar densidades calculadas en escalas diferentes sin la transformación correspondiente da un resultado arbitrario. Una comparación válida mantiene para todos los modelos el mismo registro observado, la misma representación y la misma medida de referencia.
La distribución normal de este ejemplo es una aproximación didáctica. Las duraciones físicas no pueden ser negativas. Con media 0,5 y desviación 0,1 la región negativa queda muy lejos del centro, pero un modelo destinado a describir también las colas o los tiempos extremadamente breves tendría que considerar ese soporte. Elegir entre una normal, una distribución positiva y una distribución de datos redondeados es parte de la definición del modelo de observación.
El producto depende de la relación entre observaciones
Para un vector de datos , la verosimilitud procede de su distribución conjunta. Si las observaciones son independientes dado , esa distribución se factoriza y podemos escribir
La independencia admite que cada observación tenga una distribución distinta. Señales de distintas intensidades, por ejemplo, pueden tener probabilidades de detección relacionadas con parámetros comunes mediante una función especificada. La hipótesis de una única probabilidad constante añade una restricción que va más allá de la independencia. Myung (2003) explicita la independencia al construir el producto.
Sin independencia, la regla general usa probabilidades condicionadas a la historia y la distribución conjunta se escribe
La factorización sigue siendo un producto, pero cada factor puede cambiar con lo ocurrido antes. Una cadena de Markov de primer orden reduce la historia al estado inmediatamente anterior, simplificación que también es un supuesto y requiere una justificación propia, distinta de haber ordenado una hoja de cálculo según la fecha.
Consideremos dos modelos completamente especificados para una secuencia binaria de diez posiciones. En el modelo I las posiciones son independientes y cada una toma el valor uno con probabilidad 0,5. En el modelo P el primer valor también es uno con probabilidad 0,5, pero después se repite el valor anterior con probabilidad 0,9 y se cambia con probabilidad 0,1. Por la simetría de esta regla para ceros y unos, junto con la distribución inicial elegida, cada posición tiene en ambos modelos probabilidad marginal 0,5 de ser uno.
La secuencia 1111100000 tiene ocho repeticiones y un cambio entre posiciones consecutivas. Su probabilidad en I es , aproximadamente 0,000977. En P vale , aproximadamente 0,021523. La razón P frente a I, 22,04, refleja una agrupación de la secuencia que P contempla de forma explícita.
La secuencia 1010101010 contiene los mismos cinco unos, pero presenta nueve cambios. Su probabilidad en P es , es decir, 0,0000000005, frente a los 0,000977 que sigue teniendo en I, con lo que la razón P frente a I cae a 0,000000512. Reducir ambas secuencias al recuento de unos habría eliminado precisamente la característica que las separa. Bajo P, además, el recuento tiene una distribución distinta de la binomial usada por I. Para obtenerla habría que sumar las probabilidades de todas las secuencias con cada total.
La repetición de registros es otra forma de dependencia. Imaginemos que un fallo del programa copia cien veces una única respuesta positiva. Con esa única observación, la comparación entre las tasas 0,8 y 0,5 da una razón de 1,6. Si las copias se tratan como cien respuestas independientes, un archivo que solo se ha alargado, sin ninguna observación nueva, da la razón , alrededor de .
El caso extremo ayuda a reconocer el problema en situaciones menos evidentes, como las mediciones de una misma persona, que pueden compartir condiciones, o las muestras de una misma unidad experimental, que pueden compartir exposición. El análisis de la pseudorreplicación de Hurlbert (1984) distingue la repetición de mediciones de la replicación experimental pertinente para una inferencia. Ese análisis deja abierta la distribución conjunta de cada estudio, que debe representar las dependencias relevantes del diseño concreto.
Un efecto individual latente es una explicación posible de esa dependencia. Dado el efecto, las respuestas de una persona podrían modelarse como independientes, pero al desconocerlo e integrarlo pueden quedar dependientes en la distribución marginal. En general, el producto de las probabilidades marginales difiere de la integral del producto condicionado al efecto compartido. El orden entre la integral y el producto distingue aquí dos modelos diferentes, aunque ambos utilicen las mismas distribuciones individuales.
Logaritmos, constantes y dispersión
Multiplicar muchas probabilidades pequeñas puede dar valores tan próximos a cero que un ordenador pierda precisión o los represente como cero. La logverosimilitud evita ese problema al convertir los productos en sumas. Para el recuento del detector,
Como el logaritmo es creciente, conserva el orden entre propuestas. La diferencia vale aproximadamente 1,927 y al exponenciarla se recupera la razón 6,87. La escala logarítmica facilita la acumulación de contribuciones, cuyo resultado sigue siendo una comparación de verosimilitudes, distinta de una probabilidad posterior.
El término puede omitirse para comparar valores de en ese mismo recuento. Una constante respecto de un parámetro puede, sin embargo, depender de otro que también se quiere comparar, por lo que los factores de normalización de una densidad deben inspeccionarse antes de eliminarlos. La conocida expresión «ignoramos las constantes» se refiere a constantes respecto de todos los parámetros que varían en la comparación, con los datos y su representación fijados.
Tomemos tres lecturas independientes de una magnitud continua, 0,4, 0,5 y 0,6 segundos, con una media fija de 0,5, para comparar desviaciones típicas de 0,1 y 0,2. Bajo un modelo normal, la logverosimilitud completa es
La suma de cuadrados respecto de 0,5 es 0,02. Al aumentar el último término se hace menos negativo, porque los residuos parecen menos extraordinarios en una distribución más dispersa. A cambio, la masa debe repartirse sobre una región más amplia, efecto que recoge el término . Con las logverosimilitudes completas, aproximadamente 3,151 para 0,1 y 1,821 para 0,2, la razón favorece a la primera desviación en un factor de 3,779.
Si se conservara únicamente el término de los residuos divididos por la varianza, aumentar la dispersión parecería siempre ventajoso, pues se habría perdido precisamente el factor que normaliza la densidad. La misma atención es necesaria cuando un modelo describe varianzas distintas según la condición o según el tiempo. Una verosimilitud queda definida cuando, además de la curva media, se especifica la distribución de las desviaciones respecto de ella.
Los valores nulos requieren una decisión explícita. Si un parámetro atribuye probabilidad cero a un resultado discreto observado, su logverosimilitud es menos infinito. Sumar una pequeña cantidad para evitar ese infinito cambia el modelo, salvo que sea solo una técnica numérica que preserve el cálculo original. Una tasa exactamente igual a uno y otra muy cercana a uno hacen afirmaciones diferentes sobre la posibilidad de un fallo, diferencia que debe tenerse presente antes de introducir cualquier suavizado.
El soporte de una distribución también forma parte de la función. Supongamos, solo como ejercicio, que las tres lecturas anteriores proceden de una distribución uniforme entre cero y un límite desconocido θ mayor que cero. La densidad conjunta vale θ elevado a menos tres si θ alcanza al menos la lectura máxima, 0,6. Para cualquier límite inferior a 0,6 vale cero. Una propuesta como θ igual a 0,3, por ejemplo, no puede haber generado una lectura de 0,6. Si se eliminara la condición sobre el soporte, la expresión restante asignaría valores cada vez mayores a límites más pequeños, precisamente donde los datos son imposibles.
En este caso la condición que activa o anula la densidad depende del parámetro aunque aparezca escrita fuera del término principal, de modo que debe conservarse igual que el factor de dispersión de la normal. Una descripción verbal del tipo «el valor es uniforme dentro de cierto rango» necesita especificar ambos extremos y su relación con los parámetros. Un programa que omite esa condición puede evaluar correctamente una potencia y, aun así, implementar una distribución incompleta.
Qué se condiciona y qué se deja fuera
En una regresión suele evaluarse la distribución de la respuesta dados los valores observados de los predictores. Escribir indica que se ha condicionado en , una elección directa cuando los valores de fueron fijados por diseño. Si se observaron junto con la respuesta, el condicionamiento puede dar igualmente una inferencia útil sobre la distribución condicionada, aunque deje sin describir cómo se distribuyen los predictores. Cuando estos se miden con error, tratarlos como valores exactos añade una aproximación que puede modificar el significado de los parámetros.
Condicionar puede además eliminar un parámetro que no interesa. Pensemos en dos contadores independientes observados durante una misma unidad de tiempo, cuyos recuentos y siguen distribuciones de Poisson con medias y . La distribución conjunta contiene información tanto sobre el total esperado como sobre la proporción que corresponde al primer contador. Si condicionamos en el total observado , la distribución del primer recuento es binomial con probabilidad
Las propuestas y producen la misma probabilidad condicionada, 0,6. Con un total de diez eventos, ocho de ellos en el primer contador, ambas dan la probabilidad 0,120932 para esa distribución del reparto. La distribución del total sí las distingue, puesto que sus medias totales son cinco y diez. Al condicionar se ha eliminado esa parte de la comparación. Es apropiado hacerlo si el objetivo y el procedimiento de inferencia se refieren al reparto, pero sería incorrecto utilizar después esa misma función para afirmar que se ha evaluado la intensidad total.
Las verosimilitudes condicionadas, marginales y parciales responden a construcciones específicas. Cox (1975) desarrolló la verosimilitud parcial para ciertos problemas con parámetros adicionales, incluidos procesos y tiempos hasta un evento. Su construcción utiliza factores seleccionados de una distribución conjunta y puede prescindir de parte de la información según reglas que el propio método establece, muy distintas de la supresión de cualquier factor difícil de calcular. Quien emplee una de estas funciones debe declarar cuál usa y qué información conserva acerca del parámetro de interés.
La regla para terminar la recogida de datos merece quedar escrita incluso cuando sus consecuencias son sencillas. En el ensayo inicial se fijaron diez pruebas y se contaron ocho detecciones. Imaginemos otro diseño, que continúa hasta conseguir la octava detección y registra cuántas pruebas necesitó. Si termina en la décima, la última respuesta tuvo que ser positiva y las nueve anteriores contienen siete detecciones. La probabilidad de ese resultado es 36 veces la octava potencia de p por la segunda potencia de uno menos p, con un coeficiente 36 que cuenta las posiciones posibles de los dos fallos entre las nueve primeras pruebas.
Respecto del diseño con diez intentos fijados, que usaba el coeficiente 45, solo cambia la constante. Las dos funciones son proporcionales y, bajo las hipótesis comunes de ensayos independientes y tasa estable, dan las mismas razones entre valores de p para esos resultados observados. No obstante, las distribuciones de los demás resultados posibles pertenecen a espacios distintos. En un diseño varía el número de detecciones y en el otro el número de intentos. Por eso pueden diferir sus propiedades de repetición y ciertas reglas de prueba, motivo suficiente para documentar el diseño incluso cuando estas razones particulares coinciden, sobre todo si la regla real incluye límites adicionales o decisiones basadas en variables omitidas.
Una serie temporal muestra el mismo punto desde otra dirección. Podemos condicionar en su primer valor y evaluar solo las transiciones posteriores, decisión que deja fuera la contribución de la distribución inicial cuando esta depende de parámetros relevantes. En el ejemplo de persistencia ambos modelos asignaban 0,5 al primer estado, por lo que el factor inicial se cancelaba al compararlos. Con otras distribuciones iniciales la cancelación dejaría de estar justificada y los primeros registros, que también forman parte del diseño de observación, tendrían que entrar en la comparación.
Cuando el registro es incompleto
El dato disponible puede ser una versión parcial de lo ocurrido. Como una omisión, un intervalo de redondeo o un tiempo límite describen informaciones distintas, la verosimilitud debe asignar probabilidad o densidad al registro que se conserva. Completar cada casilla con un número convencional puede ocultar esa diferencia y producir una función correspondiente a otro experimento.
Para los datos ausentes, Rubin (1976) formuló condiciones bajo las cuales el mecanismo de ausencia puede omitirse al realizar inferencia por verosimilitud. Una condición habitual es que, dados los valores observados, la probabilidad de ausencia no dependa adicionalmente de los valores que faltan; otra exige separar adecuadamente los parámetros del mecanismo de ausencia de los parámetros del modelo de datos. Cuando se cumplen, puede trabajarse con la distribución de los datos observados, integrando sobre lo no observado. Se trata de condiciones distintas de la suposición de que cualquier lista de respuestas disponibles es una muestra completa obtenida al azar.
Si una persona deja sin responder un registro precisamente cuando el valor no observado es alto, los datos presentes pueden describir de manera sesgada su distribución y la propia ausencia pasa a ser informativa bajo un modelo del mecanismo. En una aplicación a salud mental, donde la presencia de tal mecanismo en una población concreta es una posibilidad metodológica por comprobar, sería necesario estudiar el procedimiento de respuesta antes de atribuir el patrón exclusivamente al fenómeno medido.
Con la censura puede desarrollarse un caso más preciso sin completar valores desconocidos. Supongamos cinco solicitudes independientes a un sistema, todas iniciadas en el instante cero, cuyo tiempo hasta la finalización sigue, por hipótesis, una distribución exponencial de tasa , expresada en eventos por segundo. Cada solicitud se observa hasta que termina o hasta un límite fijo de dos segundos, establecido antes de conocer los tiempos. Tres terminan a los 0,5, 1 y 1,5 segundos y las otras dos siguen pendientes al llegar al límite. Los datos son didácticos.
Una solicitud terminada en contribuye con la densidad . De una solicitud pendiente a los dos segundos solo sabemos que su duración supera dos. Su contribución es entonces la probabilidad . El producto de ambas clases de contribuciones es
El exponente acumula siete segundos de observación entre las cinco solicitudes y la potencia tres cuenta las finalizaciones observadas. Los dos tiempos censurados contribuyen con su exposición y con el hecho de seguir pendientes, sin sumar finalizaciones al recuento. Como el límite estaba fijado de antemano, estos factores pueden escribirse sin modelar una decisión de interrupción que dependa del tiempo todavía desconocido.
Para dos tasas previamente especificadas, 0,4 y 1 por segundo, las verosimilitudes son aproximadamente 0,003892 y 0,000912, respectivamente, expresadas en las mismas unidades. La razón es 4,268 a favor de 0,4. Si alguien reemplazara las dos solicitudes pendientes por finalizaciones exactamente a los dos segundos, escribiría . Con ese archivo alterado, la razón entre las mismas propuestas sería 0,683 y favorecería la tasa de uno.
La hoja de datos debe conservar dos columnas, una con el tiempo observado y otra con un indicador de finalización. Sus cinco filas contienen los tiempos 0,5; 1; 1,5; 2; 2 y los indicadores 1; 1; 1; 0; 0, con los que el programa suma siete segundos y cuenta tres finalizaciones al construir la función. Las dos filas con un cero registran exactamente lo que se sabía al cerrar la observación, esto es, que a los dos segundos esas solicitudes aún no habían terminado.
Referencias
Cox, D. R. (1975). Partial likelihood. Biometrika, 62(2), 269–276. https://doi.org/10.1093/biomet/62.2.269
Etz, A. (2018). Introduction to the concept of likelihood and its applications. Advances in Methods and Practices in Psychological Science, 1(1), 60–69. https://doi.org/10.1177/2515245917744314
Fisher, R. A. (1922). On the mathematical foundations of theoretical statistics. Philosophical Transactions of the Royal Society of London. Series A, 222, 309–368. https://doi.org/10.1098/rsta.1922.0009
Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
Myung, I. J. (2003). Tutorial on maximum likelihood estimation. Journal of Mathematical Psychology, 47(1), 90–100. https://doi.org/10.1016/S0022-2496(02)00028-7
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581