En una serie de veinte intentos, un procedimiento produce el resultado previsto catorce veces, una proporción observada de 0,70. Estimar a partir de ahí la probabilidad de éxito del proceso exige expresar la incertidumbre que dejan esos veinte intentos y decidir cómo incorporar la información anterior procedente de situaciones comparables.
Los recuentos se han construido para el ejercicio y el modelo supone que los veinte intentos son independientes una vez fijada una probabilidad desconocida , común a todos ellos. Si varios intentos pertenecieran al mismo episodio, o si la probabilidad cambiara durante la serie, las catorce observaciones favorables tendrían otro significado estadístico.
La inferencia bayesiana cuantifica la incertidumbre sobre mediante una distribución que se modifica al incorporar las observaciones. La distribución posterior se obtiene al combinar una distribución previa, que expresa información y restricciones anteriores al conjunto de datos utilizado, con la verosimilitud de esos datos, que describe cómo dependen del parámetro.
La posterior conserva esa doble procedencia. Una probabilidad posterior elevada puede deberse a observaciones muy informativas, a una previa concentrada o a ambas cosas, de modo que para interpretarla hace falta saber qué parte del parámetro queda restringida por los datos y qué parte refleja sobre todo las suposiciones iniciales. Gelman et al. (2017) desarrollaron esta relación entre previa y verosimilitud y mostraron que el efecto de una distribución previa depende del modelo de observación con el que se combina.
La misma expresión, dos preguntas distintas
Sea el número de resultados favorables en intentos. Bajo el modelo binomial,
Con fijo, esta expresión asigna a los posibles recuentos probabilidades cuya suma sobre todos los valores de es uno. Fijando , por ejemplo, puede calcularse la probabilidad de obtener exactamente catorce resultados favorables en veinte intentos.
Una vez observado , la verosimilitud es esa misma expresión considerada como función de . Lo que ahora se compara es qué valores del parámetro hacen más o menos probable el recuento que efectivamente ocurrió. La verosimilitud alcanza su máximo en y aun así no es una distribución de probabilidad sobre , puesto que su integral respecto del parámetro no tiene por qué valer uno.
El coeficiente combinatorio es constante al variar y puede omitirse cuando solo se necesita la forma de la posterior para un modelo fijo, siempre que se normalice después. Para calcular la probabilidad del recuento bajo la distribución previa, en cambio, hay que conservarlo. Su presencia depende también de qué se registra. La probabilidad de una secuencia ordenada concreta carece de ese coeficiente, mientras que la del recuento suma todas las secuencias que contienen catorce resultados favorables.
Si escribimos para la densidad previa, la regla de Bayes da
La letra es una variable de integración que recorre el mismo espacio de posibles parámetros. El denominador, probabilidad marginal de los datos en el caso discreto y densidad marginal en un modelo continuo, es en esta ecuación la constante de normalización que hace que la densidad posterior integre uno.
La notación abreviada oculta ese denominador, que sigue siendo necesario. Para que la expresión defina una distribución, la integral ha de ser estrictamente positiva y finita, condición que debe comprobarse aunque la curva pueda dibujarse o evaluarse en muchos puntos.
Con cualquiera de las previas beta propias usadas aquí el denominador es positivo y finito, porque la verosimilitud binomial está acotada y es positiva en todo el interior de cero y uno. Hecha esa comprobación, la posterior puede normalizarse con independencia del algoritmo elegido para calcularla.
En un parámetro continuo, la probabilidad de un valor exacto suele ser cero aunque su densidad sea alta. Las probabilidades se obtienen integrando sobre intervalos o regiones. Comparar alturas de densidades puede ayudar a describir su forma, pero la probabilidad de que esté entre 0,60 y 0,80 depende del área comprendida en ese intervalo. La altura de una densidad cambia, además, con la escala en que se expresa el parámetro.
Una señal y dos posibles estados
La actualización puede verse también sin densidades. Imaginemos una pieza cuyo estado interno es A o B, a la que antes de examinarla asignamos probabilidad 0,20 de estar en A y 0,80 de estar en B. Una prueba emite una señal con probabilidad 0,80 cuando la pieza está en A y con probabilidad 0,10 cuando está en B. Los valores son inventados para el cálculo y se supone que las características de la prueba se conocen.
Observar la señal favorece A. La probabilidad conjunta de A y señal es y la de B y señal es , con lo que la probabilidad total de la señal es 0,24. Al dividir se obtiene una probabilidad posterior de A igual a . Como la señal puede aparecer bajo ambos estados, observarla deja a los dos con probabilidad positiva.
La probabilidad 0,80 de señal dado A responde a una pregunta distinta de la que interesa aquí, la probabilidad de A dada la señal, que depende también de cuánto peso recibía B y de cuántas señales puede producir. El cálculo puede repetirse con frecuencias esperadas. Entre mil piezas con esas proporciones se esperarían 160 señales procedentes de A y 80 de B, así que dos tercios de las 240 señales esperadas corresponderían a A.
Las razones de probabilidades separan ambas contribuciones. La razón previa entre A y B es y la razón de verosimilitudes de la señal es . Su producto, dos, deja las posibilidades posteriores de A frente a B en proporción de dos a uno. La evidencia multiplica la razón previa y la normalización convierte después esa razón en probabilidades que suman uno.
En una población distinta, con una probabilidad previa de A igual a 0,02 y las mismas características de la prueba, la posterior sería . La señal tendría el mismo factor de verosimilitud ocho, pero partiría de una razón previa diferente. Por eso transportar el comportamiento de una prueba y transportar la frecuencia del estado que se quiere inferir son operaciones separadas.
De veinte intentos a una distribución beta
Para describir una probabilidad entre cero y uno utilizaremos una distribución beta, con parámetros y , cuya densidad es
donde es la integral del numerador entre cero y uno. La media previa es . El total controla la concentración alrededor de esa media, aunque la forma depende también de cómo se reparta ese total entre ambos parámetros.
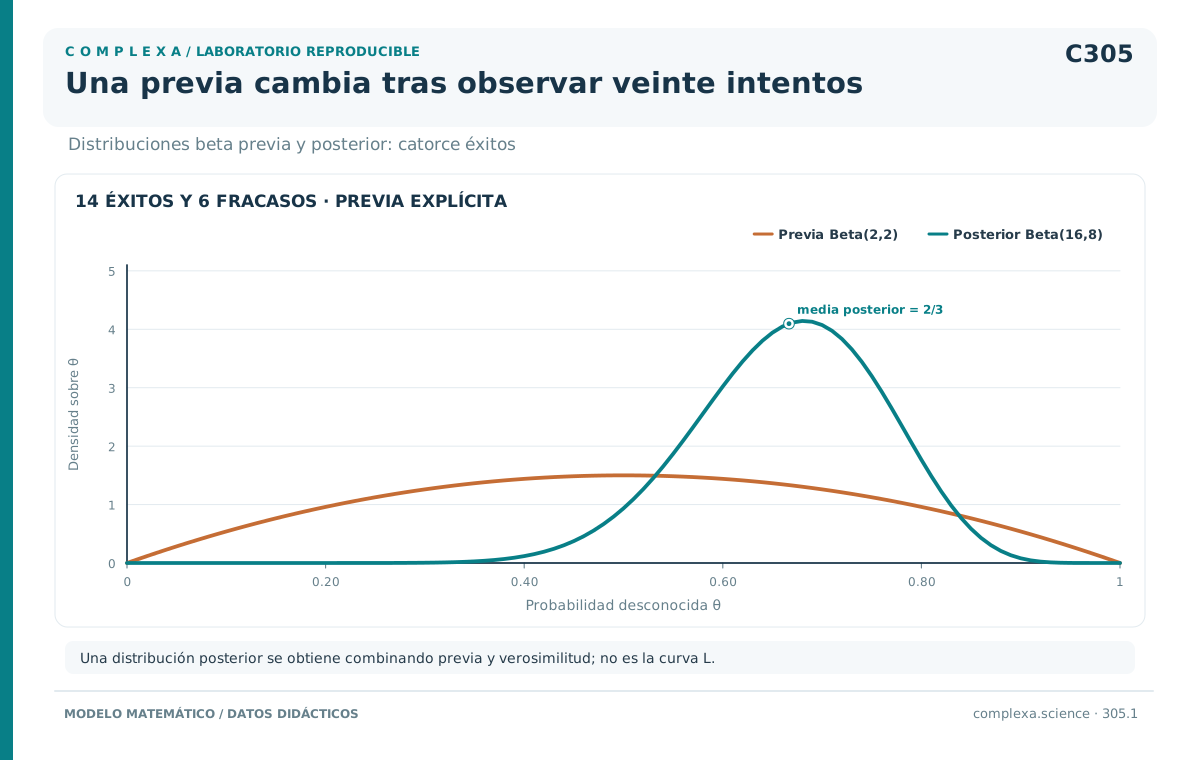
Elijamos inicialmente . La previa tiene entonces media 0,5 y una densidad, , que no es uniforme y favorece los valores intermedios frente a las probabilidades muy próximas a cero o uno. Describe una posición moderada en este ejercicio, que tendría que justificarse si se usara para un proceso observado.
Al multiplicarla por la verosimilitud de catorce resultados favorables y seis desfavorables, los exponentes se suman y queda
La posterior es, por tanto, . La familia beta se denomina conjugada para este modelo porque la actualización conserva la familia de distribuciones y modifica solo sus parámetros. Esa comodidad algebraica hace comprobable todo el cálculo, sin que de ella se siga que el conocimiento previo de un problema real deba adoptar forma beta.
La normalización puede realizarse de forma exacta, ya que la probabilidad marginal de observar el recuento catorce entre veinte es
Al dividir el producto de previa y verosimilitud por esta cantidad se obtiene la densidad beta normalizada. El valor 0,05929 es la probabilidad del recuento concreto promediada sobre la previa, una cantidad distinta de la probabilidad de que el parámetro sea correcto y de cualquier porcentaje de confianza en el modelo.
La media posterior vale , aproximadamente 0,6667, cantidad que puede escribirse como el promedio ponderado
En este caso la media previa recibe un peso y la proporción observada un peso , con lo cual la estimación se desplaza desde 0,5 hacia 0,70 sin llegar exactamente a la proporción de la muestra.
Esta identidad lleva a interpretar , para el cálculo concreto de la media, como una cantidad de información comparable a un número de intentos. Se trata de una analogía, ya que y son parámetros de la previa y conservan ese carácter aunque se lean como recuentos. Como distintas convenciones de estimación usan y como exponentes o pseudorrecuentos, conviene declarar la distribución y la operación que se emplean para evitar ambigüedades.
La actualización cambia también la dispersión. Para una beta con parámetros la varianza es , de modo que con la desviación posterior es aproximadamente 0,09428. La información incorporada concentra la distribución respecto de la previa, aunque sigue quedando una variedad considerable de probabilidades compatibles con el análisis.
Qué resumen responde a cada pregunta
Cuando se elige un único número para representar , la media posterior minimiza la pérdida cuadrática esperada, la mediana minimiza una pérdida absoluta y la moda localiza la mayor densidad. Responden a criterios distintos y pueden no coincidir. En la posterior la moda es , aproximadamente 0,6818, frente a una media de 0,6667.
La moda depende de la parametrización, porque la densidad cambia con el jacobiano de una transformación, mientras que la probabilidad calculada para una región conserva su significado si esa región se transforma correctamente. Resumir toda la inferencia mediante el punto de mayor densidad puede ocultar, por ello, tanto la dispersión como la dependencia del resumen respecto de la escala.
Los cuantiles 0,025 y 0,975 de la posterior delimitan un intervalo creíble central del 95 por ciento, que para va aproximadamente de 0,4708 a 0,8362. Condicionado al modelo, a la previa y a los datos incorporados, ese intervalo contiene una probabilidad posterior de 0,95 y su amplitud refleja la incertidumbre que el análisis mantiene sobre el parámetro.
Otros intervalos contienen la misma probabilidad posterior. El de máxima densidad reúne los valores con densidad más alta y puede diferir del central cuando la distribución es asimétrica. Si la posterior tiene varios modos separados, la región de alta densidad puede incluso estar formada por varios intervalos, caso en el que forzar una única media y un intervalo simétrico puede situar el resumen en una zona poco representativa.
La probabilidad posterior de que es aproximadamente 0,95343, cifra que responde a una pregunta distinta de si el intervalo central del 95 por ciento queda por encima de 0,5. Aquí el intervalo incluye ese valor porque deja 0,025 de probabilidad en cada cola y la cola inferior hasta 0,5 acumula aproximadamente 0,04657. Ambos resultados son, por tanto, compatibles.
La cobertura frecuentista plantea otra pregunta, la de cuántos intervalos incluirían un valor fijo del parámetro si se repitiera el muestreo. Que un intervalo creíble del 95 por ciento tenga esa cobertura para cada valor del parámetro es una propiedad adicional del procedimiento, que puede cumplirse de forma aproximada bajo ciertas condiciones. Gustafson (2012) muestra diferencias especialmente claras en modelos parcialmente identificados, donde la amplitud posterior puede persistir aun con muestras arbitrariamente grandes.
La posterior tampoco recoge toda la incertidumbre imaginable, ya que las cifras anteriores están condicionadas a la independencia de los intentos y a su probabilidad común. Si hay dependencia temporal, variación entre individuos o errores de registro, puede ser necesario ampliar el modelo con extensiones que cambian la verosimilitud y, con ella, el significado de la distribución posterior. La incertidumbre sobre cómo describir el proceso queda fuera de la integración que cuantifica la incertidumbre sobre un parámetro dentro de un modelo.
Elegir una previa implica elegir una escala
Una previa uniforme para asigna igual probabilidad a intervalos de la misma longitud dentro de cero y uno, pero esa uniformidad se refiere a una descripción concreta del parámetro y desaparece al pasar a otra, como la que define la transformación logit
La variable recorre toda la recta real y sus incrementos corresponden a cambios multiplicativos en las posibilidades relativas de resultado favorable y desfavorable.
Si es uniforme, la densidad inducida en , que se obtiene multiplicando la densidad original por el valor absoluto de , es
Esta densidad se concentra alrededor de cero y disminuye hacia ambos extremos, de manera que una previa uniforme sobre probabilidades induce una previa no uniforme sobre logits.
A la inversa, una densidad constante sobre toda la recta para , elección que en principio puede parecer carente de preferencias, es una previa impropia, no normalizable. Transformada a , es proporcional a , que diverge al aproximarse a cualquiera de los dos extremos.
Una previa impropia puede producir una posterior propia, algo que debe verificarse para los datos y el modelo utilizados. Con esa expresión y el recuento binomial, la posterior formal es proporcional a y se normaliza exactamente cuando . Si no se observa ningún resultado favorable la integral diverge cerca de cero; si todos lo son, diverge cerca de uno. En esos casos la posterior no existe.
Berger (2006) examina estos problemas al discutir los procedimientos bayesianos objetivos. Una distribución por defecto debe evaluarse dentro de un marco estadístico concreto, puesto que llamarla plana u objetiva deja sin resolver su normalización. Un algoritmo puede devolver valores numéricos aun cuando la expresión que recibe no define una posterior propia, de manera que la existencia matemática de la distribución ha de establecerse antes de interpretar sus resúmenes computacionales.
Jeffreys (1946) propuso una regla invariante frente a transformaciones de parámetros que, en el problema binomial, conduce a una previa proporcional a , es decir, . Esta previa es propia. Asigna más densidad cerca de los extremos que la uniforme. La invariancia significa que aplicar la regla y transformar correctamente el parámetro conduce a descripciones compatibles de la misma medida.
Bernardo (1979) desarrolló las distribuciones de referencia a partir de criterios de información. Estas propuestas son procedimientos explícitos para construir previas con objetivos determinados. Cuando hay varios parámetros, la elección del parámetro de interés y el tratamiento de los restantes pueden influir en la construcción, decisiones que siguen siendo necesarias aunque la previa se presente como expresión de ignorancia.
En una aplicación concreta también puede ser más apropiado representar conocimiento sustantivo. Para la diferencia entre dos medidas, una desviación previa de cinco significa cosas distintas según las unidades sean milisegundos, segundos o una puntuación tipificada, por lo que la escala debe acompañar siempre a los números. Una previa suficientemente amplia para una magnitud puede ser extremadamente concentrada para otra, aunque se utilice la misma familia normal.
La información anterior debe ser transportable al proceso actual. Los datos de un instrumento diferente o de una población seleccionada pueden informar una previa siempre que tengan una conexión explícita con el parámetro que se estima. Cuando se confunde la precisión histórica con la comparabilidad, la previa puede concentrarse alrededor de una cantidad distinta. En estudios de salud mental, por ejemplo, un promedio previo puede mantenerse estable y cambiar, sin embargo, de significado cuando se modifica el procedimiento de medida.
Un límite que la actualización conserva
La amplitud de una previa y su soporte desempeñan papeles distintos. Si se asigna probabilidad cero a todos los valores mediante una distribución uniforme restringida al intervalo entre cero y un medio, esos valores seguirán teniendo densidad posterior cero tras multiplicar por cualquier verosimilitud finita. Los catorce resultados favorables de veinte no pueden devolverles el peso que la previa excluyó.
Esos datos son posibles con probabilidades inferiores a un medio, aunque menos esperables que con valores próximos a 0,70, de modo que la posterior restringida puede normalizarse y concentrarse cerca de su frontera superior. Su probabilidad de que seguirá siendo, con todo, exactamente cero.
Restringir el soporte es, por tanto, una afirmación más fuerte que asignar a esa región una probabilidad pequeña, con consecuencias distintas al codificar conocimiento físico y al representar dudas. Cuando la exclusión procede de la propia definición del parámetro, puede formar parte legítimamente de la delimitación del espacio de valores. Cuando expresa una expectativa incierta sobre el proceso, un peso pequeño deja que la evidencia la modifique, algo que el cero exacto impide mientras se conserve el modelo. La inspección de los límites implementados distingue ambos tipos de afirmación.
Incorporar una observación una sola vez
La actualización puede hacerse por bloques. Si los primeros diez intentos contienen ocho resultados favorables y los diez siguientes seis, el primer bloque transforma la previa en . Al usar esa posterior como previa para el segundo bloque se obtiene , exactamente la misma distribución que al incorporar los veinte intentos juntos.
La equivalencia se debe a la factorización de la verosimilitud condicionada a . Bajo independencia, el producto de las contribuciones de cada bloque es el mismo sea cual sea el orden en que se multipliquen. En un modelo temporal, una factorización cuyos factores condicionales incluyan la dependencia correspondiente evita atribuir al orden de cálculo un efecto que pertenece a la estructura del proceso.
El término previa es relativo al conjunto de información que falta incorporar. Una distribución construida después de un estudio anterior puede ser previa para otro sin necesidad de reflejar lo que alguien creía antes de toda experiencia. Lo que debe quedar claro es qué información contiene y qué observaciones se le incorporarán después.
Si la posterior se multiplicara de nuevo por la misma verosimilitud de los veinte intentos, se obtendría , cuya desviación estándar bajaría de 0,09428 a aproximadamente 0,06943. Esa ganancia de precisión, obtenida sin ninguna observación nueva, procede de contar dos veces el mismo conjunto de resultados.
La duplicación puede ser menos visible cuando un resumen histórico y una base individual incluyen a las mismas personas. Para actualizar correctamente hace falta entonces conocer el solapamiento o construir una verosimilitud conjunta que lo represente. De otro modo, la combinación algebraica de fuentes aparentemente distintas exagera la información disponible por correcto que sea el cálculo posterior, porque el problema está en la procedencia de los datos.
Una posterior definida para parámetros que los datos no separan
Supongamos ahora que cada observación continua mide la suma de dos contribuciones desconocidas, y , con error normal de varianza conocida igual a uno,
Las observaciones son condicionalmente independientes y ningún registro mide por separado las dos contribuciones, por lo que pares distintos, como y , producen exactamente la misma distribución de datos.
Si definimos y , la verosimilitud depende de , en tanto que desaparece de ella. Esta parametrización separa lo que los registros pueden informar de lo que ese diseño de observación deja sin identificar. Gustafson (2010) estudia la inferencia bayesiana en modelos donde la distribución de las observaciones es compatible con más de un valor del parámetro de interés.
Tomemos la previa , donde cuatro es la varianza, con independiente de en la previa. Para cien observaciones con media dos, la distribución posterior de la suma es normal, con
Su intervalo creíble central del 95 por ciento, que va aproximadamente de 1,7993 a 2,1908, muestra que los registros informan la suma con bastante precisión.
En este ejemplo la distribución posterior de permanece exactamente igual a su previa, igualdad que se debe a la independencia previa elegida y a la ausencia de en la verosimilitud. Cuando la previa relaciona la parte identificada con la no identificada, los datos pueden modificar indirectamente la segunda a través de esa relación. La información así transmitida sigue dependiendo de la estructura previa que une ambas partes.
Comparemos dos previas propias para , manteniendo idéntica la previa de . La primera es ; la segunda, , con varianza 0,04, expresa una expectativa mucho más concentrada de que las contribuciones y sean semejantes. Ambas producen la misma posterior para la suma y distribuciones diferentes para cada contribución.
Como , su media posterior es aproximadamente 0,9975 en ambos análisis y su varianza es . Con la primera previa el intervalo central del 95 por ciento para es aproximadamente . Con la segunda se reduce a , una diferencia de precisión grande para dos análisis que comparten exactamente los mismos cien registros y la misma verosimilitud.
Ambas posteriores están normalizadas y con ellas pueden calcularse probabilidades, pero las observaciones siguen sin identificar . Si el número de registros de la suma creciera indefinidamente, tendería a cero y la varianza de tendería, en cambio, a , una dispersión determinada por la previa del contraste.
Gelman et al. (2017) analizan situaciones en las que la verosimilitud concentra la posterior alrededor de una región alargada del espacio paramétrico y la previa sigue distribuyendo el peso a lo largo de ella. Gustafson (2012) muestra cómo ese tipo de identificación parcial puede mantener intervalos creíbles de amplitud positiva en grandes muestras. En esas condiciones la distribución posterior puede ser una descripción útil de la información combinada y conservar, al mismo tiempo, una dependencia sustancial de supuestos que esas observaciones no contrastan.
Integrar parámetros y predecir una nueva observación
Cuando el modelo contiene varios parámetros suele interesar solo una parte de ellos. La distribución marginal posterior de se obtiene integrando la posterior conjunta sobre los demás. Fijarlos en su media o en su valor de máxima verosimilitud produce, en general, otro resultado, ya que la integración conserva la incertidumbre de las cantidades que no aparecen en el resumen final.
En el ejemplo aditivo, fijar por comodidad haría que y eliminaría toda la varianza , operación que equivaldría a imponer igualdad exacta entre las contribuciones. Para que el intervalo resultante tenga esa interpretación hay que declarar la restricción, de la que procede parte de su estrechez.
La predicción de observaciones futuras integra de otra manera. En el ejemplo binomial, la probabilidad de un resultado favorable adicional es la media posterior de , igual a dos tercios. Para varios intentos futuros, la distribución del recuento integra la variabilidad binomial y la incertidumbre sobre . Con diez intentos y la posterior , su media es 6,6667 y su varianza 3,0222.
Si se sustituyera por dos tercios y se tratara como conocido, la varianza binomial sería 2,2222. La media coincidiría, pero la incertidumbre del recuento disminuiría artificialmente. Aunque los resultados futuros sean independientes condicionados al valor de la probabilidad que comparten, marginalizar esa probabilidad desconocida introduce entre ellos una dependencia predictiva. Con esta distinción se identifica qué distribución se está calculando, cuestión previa a la de evaluar si reproduce adecuadamente un proceso, que requiere un análisis adicional.
Cuánto cambia la respuesta al cambiar la previa
Volvamos a los veinte intentos para comparar tres previas declaradas antes de realizar el cálculo. La uniforme no favorece ningún intervalo de probabilidades frente a otro de la misma longitud y la concentra moderadamente el peso alrededor de un medio. La tiene media 0,4 y una concentración mayor, por lo que expresa una información más firme y menos favorable a las probabilidades altas.
| Previa | Posterior tras 14 de 20 | Media posterior | Intervalo central del 95 % | Probabilidad de |
|---|---|---|---|---|
| Beta(1,1) | Beta(15,7) | 0,6818 | 0,4782–0,8541 | 0,9608 |
| Beta(2,2) | Beta(16,8) | 0,6667 | 0,4708–0,8362 | 0,9534 |
| Beta(8,12) | Beta(22,18) | 0,5500 | 0,3962–0,6991 | 0,7388 |
La tercera previa produce una posterior más estrecha y con menos probabilidad por encima de 0,5, porque su concentración añade precisión y su localización desplaza la estimación. Como el conjunto de observaciones es el mismo en las tres filas, esa menor incertidumbre posterior procede enteramente de la previa.
Esta comparación quedaría incompleta si se escogieran previas arbitrarias y su diferencia se tratara después como propiedad universal del método, porque la cuestión sustantiva es cuáles de ellas expresan información defendible para el proceso estudiado. Si la media previa de 0,4 procede de intentos realizados bajo otras condiciones, el análisis de sensibilidad ayuda a localizar cuánto depende la conclusión de transportarlos al nuevo contexto.
Consideremos ahora una muestra distinta, de doscientos intentos con ciento cuarenta resultados favorables, que mantiene la proporción de 0,70. La media posterior sería con la previa y con , de modo que la diferencia entre ambas medias baja de aproximadamente 0,1167 en la muestra pequeña a 0,0234 en la grande.
El efecto de la previa disminuye porque la verosimilitud acumula cada vez más información sobre la misma probabilidad identificable y las previas permanecen fijas. Este cálculo presupone que aumentar la muestra añade intentos comparables y condicionalmente independientes. Repetir muchas veces una medición que solo informa una suma, como en el ejemplo aditivo, reduciría la incertidumbre de esa suma y dejaría en cada componente la dispersión fijada por la previa del contraste.
En la muestra de doscientos intentos, la probabilidad posterior de que supera 0,999999 con ambas previas, frente a 0,9534 bajo y 0,7388 bajo en la muestra de veinte. Como la comparación mantiene la proporción observada y las distribuciones previas, el cambio calculado procede de aumentar de veinte a doscientos los intentos independientes.
Referencias
Berger, J. O. (2006). The case for objective Bayesian analysis. Bayesian Analysis, 1(3), 385–402. https://doi.org/10.1214/06-BA115
Bernardo, J. M. (1979). Reference posterior distributions for Bayesian inference. Journal of the Royal Statistical Society: Series B (Methodological), 41(2), 113–128. https://doi.org/10.1111/j.2517-6161.1979.tb01066.x
Gelman, A., Simpson, D., y Betancourt, M. (2017). The prior can often only be understood in the context of the likelihood. Entropy, 19(10), 555. https://doi.org/10.3390/e19100555
Gustafson, P. (2010). Bayesian inference for partially identified models. The International Journal of Biostatistics, 6(2). https://doi.org/10.2202/1557-4679.1206
Gustafson, P. (2012). On the behaviour of Bayesian credible intervals in partially identified models. Electronic Journal of Statistics, 6, 2107–2124. https://doi.org/10.1214/12-EJS741
Jeffreys, H. (1946). An invariant form for the prior probability in estimation problems. Proceedings of the Royal Society of London A, 186(1007), 453–461. https://doi.org/10.1098/rspa.1946.0056