Ocho mediciones pueden separar con precisión dos parámetros o dejar uno de ellos completamente indeterminado. La diferencia puede estar en dónde se mide, porque repetir ocho veces una misma condición y observar ocho condiciones diferentes son operaciones estadísticas distintas. Si se quiere estimar una recta y todas las observaciones se realizan en el mismo valor de la variable explicativa, las repeticiones afinan la altura de la recta en ese punto, pero su pendiente sigue sin distinguirse de un cambio compensatorio en la ordenada.
La información de Fisher describe esta diferencia a través de la sensibilidad de la distribución de las observaciones a los parámetros. Su cálculo depende de un modelo probabilístico que especifique qué variable se observa, cómo cambia su distribución y qué ruido acompaña a la medición. Un sensor cuya respuesta cambia mucho con un parámetro puede dar poca información si su variabilidad crece en la misma proporción. Una respuesta grande solo ayuda en la medida en que las respuestas plausibles bajo parámetros cercanos puedan distinguirse entre sí.
La teoría de estimación desarrollada por Fisher (1922) vinculó la información contenida en la muestra con la precisión de los procedimientos que la utilizan. En el diseño de observaciones esa relación se usa antes de recoger los datos, para comparar condiciones experimentales según la precisión que alcanzarían bajo supuestos explícitos. El cálculo da una propiedad local del experimento y del modelo, que solo se convierte en una decisión de medida cuando se especifica qué parámetro o predicción interesa y qué condiciones se consideran posibles.
Una derivada de la distribución
Sea el dato, su densidad o función de probabilidad bajo un parámetro escalar y su log-verosimilitud. Su derivada respecto al parámetro,
se denomina función de puntuación o score y mide cómo cambia la log-verosimilitud de ese resultado al modificar ligeramente el parámetro. Un valor positivo indica que, en ese punto, aumentar mejora la verosimilitud del dato observado. El signo depende del resultado, de manera que algunas observaciones empujan la estimación hacia arriba y otras hacia abajo.
Cuando el modelo es suficientemente regular, el promedio de esa derivada bajo el propio modelo es cero y la información esperada de Fisher se define como
Una distribución cuya puntuación varía mucho entre resultados contiene evidencia capaz de discriminar cambios pequeños en . Si, por el contrario, todos los resultados plausibles cambian muy poco cuando se modifica el parámetro, la información será pequeña. La esperanza se calcula suponiendo que el valor verdadero es precisamente el que se está evaluando.
La distinción entre resultado y distribución se ve con claridad cuando los errores son normales. Si , con normal de media cero y varianza conocida , la puntuación es y su segundo momento vale . Una medición con desviación típica dos tiene información sobre la media, en las unidades elegidas. Si esa desviación se reduce a uno, la información se multiplica por cuatro.
Con observaciones independientes se suman las log-verosimilitudes y, con ellas, las puntuaciones. Como cada puntuación tiene media cero, los productos cruzados tienen esperanza cero y la información total es la suma de las informaciones individuales, que para observaciones normales de igual varianza vale . La independencia interviene en ese paso concreto de la derivación, por lo que contar como datos nuevos varias copias de una misma lectura no da una suma equivalente.
La información admite también una lectura como medida local de separación entre distribuciones. Bajo condiciones de diferenciabilidad, la divergencia de Kullback–Leibler entre el modelo con y otro con tiene como primer término no nulo , una aproximación válida para desplazamientos pequeños. Para saber cuánto se separan valores lejanos, o si existe otra solución distante con la misma distribución, hace falta estudiar algo más que la curvatura local.
La curvatura observada y su promedio
La información observada se define como el negativo de la segunda derivada de la log-verosimilitud
A diferencia de la esperada, depende del dato que efectivamente llegó. Bajo regularidad su esperanza coincide con la información de Fisher, . De ahí los nombres de información observada y esperada, dos cantidades iguales en promedio que pueden diferir en cada muestra concreta.
Para diez observaciones Bernoulli independientes con probabilidad de éxito , llamemos al número de éxitos. Omitiendo constantes, la log-verosimilitud es , de la que se obtienen la puntuación y las dos informaciones
Supongamos, con fines didácticos, que hubo cuatro éxitos. Evaluado el modelo en , la información observada es y la esperada es . El primer número describe la curvatura que produce esa muestra en ese valor, mientras que el segundo promedia las curvaturas que generarían todas las muestras posibles si .
En el máximo de verosimilitud interior, , ambas expresiones coinciden y valen aproximadamente 41,667. La coincidencia se debe a que la Bernoulli pertenece a una familia exponencial y a que ambas se evalúan en el máximo. Fuera de las familias exponenciales, la curvatura observada en el máximo puede conservar información sobre la precisión específica de la muestra que el promedio esperado no recoge.
Efron y Hinkley (1978) estudiaron precisamente aproximaciones a la precisión de estimadores de máxima verosimilitud en familias de un parámetro. Su argumento a favor de la información observada se refiere a aproximaciones condicionales apoyadas en estadísticos auxiliares apropiados. Para que la inversa de una Hessiana dé una incertidumbre correcta, la función ajustada tiene que ser una verosimilitud adecuada y deben cumplirse las condiciones que justifican aproximar su forma mediante una parábola.
También el signo requiere cuidado. La información esperada, definida como un segundo momento, es no negativa, pero la observada puede ser negativa en zonas donde la log-verosimilitud es convexa. En un máximo interior no degenerado la curvatura de la log-verosimilitud es negativa y la información observada es positiva. Su lectura como precisión vale en las cercanías de ese máximo y, cuando la superficie es multimodal, describe solo el pico en el que se calculó.
Qué afirma la cota de Cramér–Rao
Para un estimador insesgado de , una forma escalar de la cota de Cramér–Rao es , donde la información corresponde a toda la muestra. La cota fija un límite inferior para una clase de estimadores dentro de un modelo regular, sin pronunciarse sobre si un algoritmo concreto lo alcanza con los datos disponibles.
La derivación muestra dónde intervienen los supuestos. Si y es válido derivar bajo el signo integral, se obtiene . Puesto que , la covarianza entre y la puntuación es uno, con lo cual la desigualdad de Cauchy–Schwarz da , siempre que existan esos momentos y la diferenciación sea legítima. Cuando se estima una función , el numerador pasa a ser el cuadrado de su derivada.
Entre las condiciones habituales figuran un parámetro interior, una familia diferenciable y un soporte que no cambie con el parámetro, o bien condiciones equivalentes que controlen los términos de frontera. Una cota para estimadores insesgados es, además, algo distinto de una aproximación asintótica para un estimador que puede tener sesgo en muestras finitas. La normalidad asintótica y la eficiencia de máxima verosimilitud requieren hipótesis adicionales, que van más allá de haber calculado una matriz invertible.
El ejemplo normal es un caso en que la cota se alcanza exactamente. Con observaciones independientes de varianza conocida , la media muestral es insesgada y su varianza coincide con el inverso de la información total . Con ocho observaciones y , esa varianza es 0,5 y la desviación típica aproximadamente 0,707. Duplicar la información reduce la varianza a la mitad, pero la desviación típica disminuye solo en un factor .
La familia uniforme entre cero y un límite desconocido se comporta de otra manera, pues el soporte de las observaciones depende de ese límite. Si se ignora esa dependencia y se deriva solo el factor , se pierde lo que significa observar un valor próximo al extremo, justamente la frontera de la que el máximo muestral obtiene su información. Aplicar mecánicamente una fórmula regular a las derivadas interiores de la densidad puede producir contradicciones, ya que por ese procedimiento deja de cumplirse la identidad de puntuación media cero.
En el caso Bernoulli, observar cero o diez éxitos sitúa el máximo en una frontera de , donde un intervalo simétrico construido como estimación más o menos dos errores estándar puede ser engañoso o degenerar. La información esperada para un valor interior de sigue estando definida, pero ante una muestra extrema la aproximación normal de la estimación deja de ser razonable y el método de intervalo tiene que respetar la forma y el dominio del problema.
Cambiar de coordenadas cambia el número
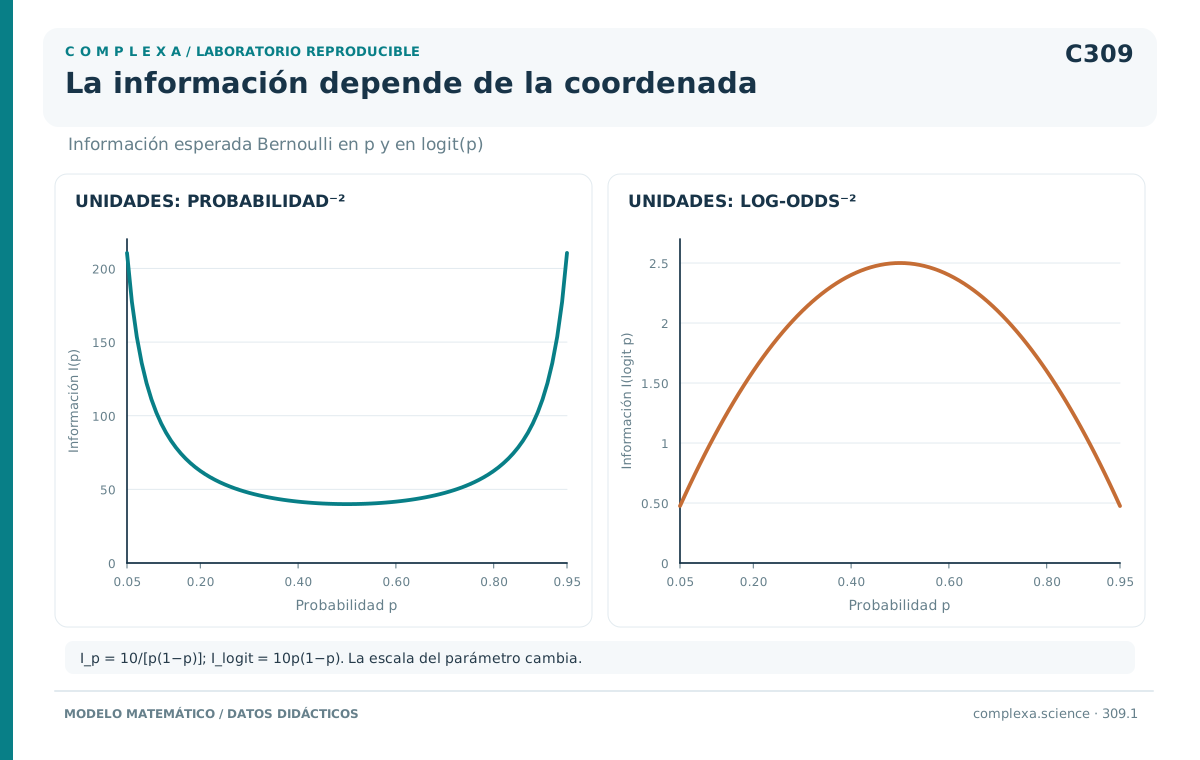
La información tiene unidades. Si se mide en segundos, la información escalar tiene unidades de segundos a la potencia menos dos y su valor numérico cambia si el mismo parámetro se mide en milisegundos, sin que el experimento se modifique. Por eso, al comparar magnitudes de información hay que especificar qué desplazamiento del parámetro se está considerando.
Sea una transformación diferenciable e invertible en la región estudiada. Como la puntuación se transforma según , la información esperada cumple
El producto local permanece igual a . Cambia el número, pero la separación infinitesimal entre distribuciones que describe el cálculo sigue siendo la misma. En varias dimensiones la transformación aplica el Jacobiano a ambos lados de la matriz.
Para la familia Bernoulli puede reemplazarse por el logaritmo de sus posibilidades, . Entonces y diez observaciones tienen información . En la información respecto de era 62,5 y respecto de es 1,6 sin que haya desaparecido ningún dato, porque un cambio unitario de probabilidad y un cambio unitario del logaritmo de posibilidades son desplazamientos diferentes.
La misma transformación aclara una paradoja aparente. Cuando se acerca a cero, crece mientras disminuye. Ambas tendencias son compatibles porque estimar una probabilidad absoluta muy pequeña y estimar con precisión sus posibilidades relativas son tareas diferentes. La inversa de la información solo tiene interpretación si se conserva la escala del parámetro estimado.
Fuera de un punto estacionario, la información observada se transforma con un término adicional según
Ese término se anula en un máximo interior, donde la puntuación vale cero, así como al tomar esperanza bajo las condiciones regulares. Con cuatro éxitos y , la puntuación es 12,5, la primera derivada de respecto de es 0,16 y la segunda es 0,096, de modo que la curvatura transformada vale . Multiplicar solo por el cuadrado de la primera derivada habría dado 2,8, un resultado incorrecto.
La dependencia de las coordenadas alcanza también a los criterios de diseño. Sumar varianzas de parámetros con unidades diferentes exige una escala o una ponderación científicamente justificada, ya que una suma de cuadrados puede ordenar los diseños de otra manera si una longitud se expresa en metros o en milímetros. El determinante no tiene ese problema. Un cambio fijo e invertible de coordenadas multiplica el determinante de la información local por un factor que no depende del diseño, así que, si la comparación mantiene ese mismo punto de evaluación, el orden de los diseños por determinantes se conserva.
Las transformaciones del dato plantean una cuestión distinta. Guardar una lectura como «por encima» o «por debajo» de un umbral descarta su magnitud. Bajo condiciones regulares, la puntuación de ese registro resumido es la esperanza condicional de la puntuación original dado el resumen. La descomposición de la varianza impide que su información supere la de la lectura completa, aunque puede igualarla si el resumen conserva toda la información pertinente para el parámetro.
El coste de discretizar puede calcularse en un caso concreto. Supóngase que de una lectura normal de media y desviación conocida se guarda únicamente si es positiva o negativa. En ambas respuestas tienen probabilidad un medio y la derivada de la probabilidad positiva respecto de la media es . Introducida en la fórmula Bernoulli, esa derivada da una información de , aproximadamente el 63,7 % del valor que tenía la lectura completa. Como el detector binario puede ser más barato y admitir más observaciones, el diseño tendría que comparar información y coste conjuntamente.
Hay resúmenes que conservan íntegramente la información relevante. Si se realizan lecturas normales independientes en la misma condición, con varianza conocida, su media tiene varianza e información sobre la media poblacional, la misma que tienen las lecturas completas. Para ese parámetro y ese modelo, promediar antes de guardar deja intacta la estimación. Cuando además interesa comprobar el ruido, detectar valores atípicos o estudiar una deriva temporal, preguntas que evalúan el modelo en que se apoya la estimación, conservar únicamente la media elimina información sobre ellas.
La matriz permite distinguir direcciones
Con un vector de parámetros la puntuación es un vector y la información esperada es la matriz . Para un desplazamiento pequeño , la cantidad mide la sensibilidad local en esa dirección. Valores grandes en unas direcciones y pequeños en otras indican que ciertas combinaciones de parámetros se distinguen mucho mejor que otras. Mirar únicamente la diagonal puede ocultar una compensación de este tipo entre parámetros.
En una regresión normal con media , errores de varianza conocida e independencia entre observaciones, cada condición suma a la información el término . Dos observaciones con gradientes proporcionales refuerzan la misma dirección. Una sola condición cuyo gradiente apunte hacia otra combinación puede añadir lo que muchas repeticiones de las anteriores no daban.
Si los errores tienen una matriz de covarianzas conocida , independiente de los parámetros, la información se escribe , donde las filas de son los gradientes de las medias observadas. Esta expresión incorpora la dependencia entre sensores o tiempos y hace del modelo de error una parte del diseño, porque tratar como independientes dos mediciones correlacionadas atribuye a la repetición una capacidad de discriminación que quizá no posee.
La precisión cambia también cuando, junto al parámetro de interés, debe estimarse otro auxiliar. Escrita la información por bloques para y un parámetro auxiliar , la información efectiva sobre es cuando la inversa requerida existe. El segundo término mide lo que se pierde por tener que distinguir los cambios del parámetro de interés de los cambios compensatorios del auxiliar.
Por eso, cuando hay varios parámetros, el recíproco de un elemento diagonal rara vez es la varianza relevante, que se obtiene invirtiendo primero la matriz completa y tomando después la posición correspondiente, o bien mediante la expresión por bloques. Un ejemplo es el de un instrumento con un desplazamiento de calibración desconocido, cuyas lecturas pueden ser muy sensibles al efecto buscado y a la vez incapaces de separarlo de ese desplazamiento.
Volvamos a las ocho observaciones de la recta , con desviación típica conocida dos y valores de que pueden elegirse entre menos uno y uno. Su matriz de información es
Si todas las mediciones se realizan en cero, donde la pendiente no altera la respuesta, la información sobre vale dos y la información sobre es cero. Con cuatro mediciones en menos uno y cuatro en uno, la suma de los es cero y la de sus cuadrados es ocho, de modo que la matriz es diagonal, con dos en ambas posiciones. Su inversa es diagonal con 0,5, así que las dos estimaciones tienen esa varianza y no están correlacionadas.
Acercar las condiciones entre sí empeora la estimación de la pendiente. Cuatro observaciones en menos medio y cuatro en medio mantienen la información sobre , pero bajan la de a 0,5 y elevan la varianza de la pendiente a dos, cuatro veces la obtenida en los extremos. Las ocho mediciones y su ruido son los mismos en ambos diseños. La ganancia de los extremos procede de que, al separar los valores de , un cambio de pendiente genera diferencias de respuesta mayores.
Para comprobar que el reparto en los extremos maximiza el determinante en todo el intervalo basta observar que
La desigualdad se apoya en y en que el cuadrado que se resta es no negativo. Con cuatro observaciones en cada extremo se alcanza la igualdad. El argumento abarca cualquier combinación de ocho puntos permitidos, más allá de los dos diseños simétricos que acabamos de comparar.
La eliminación del parámetro auxiliar se aplica aquí directamente. Si interesa y la ordenada es desconocida, su información efectiva es , que vale cero cuando todas las observaciones se hacen en uno. Si una calibración externa perfecta diera a conocer la ordenada, la información sobre la pendiente sería . Como el ruido de esas ocho lecturas es idéntico en ambas comparaciones, la pérdida procede por entero de la libertad de desplazar la recta.
Una calibración externa imperfecta da una situación intermedia. Si consiste en una observación normal independiente de , con varianza conocida y , añade información sobre la ordenada. La matriz para las ocho lecturas en uno pasa a ser y la información efectiva sobre la pendiente es . Para tanto esa información como la varianza correspondiente valen uno. Cuando crece indefinidamente, la varianza se aproxima a 0,5. Si se registra la incertidumbre de la calibración, esa diferencia puede calcularse, cosa imposible cuando se supone que el valor certificado carece de error.
Elegir qué precisión se quiere comprar
El diseño que maximiza el determinante se denomina D-óptimo y, en la aproximación normal, minimiza el volumen de la región elipsoidal de incertidumbre para el vector completo. Otros objetivos pueden minimizar una suma ponderada de varianzas o la varianza de una combinación específica. La elección traduce una pregunta científica. Determinar todos los coeficientes, estimar una respuesta en un lugar concreto o distinguir una hipótesis de otra requieren información distribuida de maneras distintas.
En la recta, si solo interesa la respuesta media en , la cantidad buscada es . El diseño equilibrado en los extremos la estima con varianza uno. Con ocho observaciones hechas directamente en la varianza baja a 0,5, aunque y quedan sin separar. Una matriz singular respecto del vector completo coexiste así con una estimación precisa de la combinación que efectivamente interesa.
Kiefer y Wolfowitz (1960) demostraron que maximizar el determinante equivale a minimizar la máxima varianza de estimación de la función de regresión sobre el espacio de diseño. Su marco es lineal y de diseños aproximados, en los que el diseño se representa como una distribución de proporciones de observaciones. El resultado se refiere a la peor precisión sobre un conjunto de condiciones, por lo que en un punto de predicción escogido aisladamente otro diseño puede superar al D-óptimo.
En el ejemplo, la varianza de la respuesta media bajo el diseño equilibrado es , con un máximo de uno en el intervalo. Medir solo en mejora ese punto a costa de perder la capacidad de predecir por separado qué ocurre en otros valores sin conocer la pendiente. La discrepancia entre ambas preferencias procede solo del objetivo declarado, puesto que los dos cálculos son compatibles.
La conclusión depende además del modelo de respuesta. Si la relación verdadera requiere un término , medir solo en menos uno y uno hace que ese término valga siempre y se confunda con la ordenada , así que el diseño óptimo para una recta deja de identificar un modelo cuadrático. Reservar algunas mediciones interiores puede servir para detectar la curvatura y estimar ese término, aunque reduzca parte de la precisión disponible para la pendiente bajo el modelo lineal original.
Una matriz invertible no demuestra unicidad global
La información describe diferencias en una vecindad del valor evaluado. Rothenberg (1971) relacionó la identificación local con la no singularidad de la información bajo condiciones de regularidad, entre las que figura trabajar en puntos donde el rango se mantiene constante en una vecindad. Un diagnóstico de rango que pase por alto esa condición puede confundir una parametrización singular con una verdadera equivalencia entre modelos.
Un ejemplo algebraico separa lo local de lo global. Si la media normal es y puede tomar cualquier valor real, la información de observaciones es . Es positiva para , pero y generan exactamente la misma distribución. La curvatura alrededor de la solución positiva deja en pie la solución negativa. Restringir el signo exigiría una definición o un conocimiento defendible del parámetro.
En el punto cero esa información se anula y las aproximaciones basadas en una expansión cuadrática regular deben revisarse. En general, una derivada de primer orden nula es compatible con que la función completa varíe alrededor del punto, dado que los términos de orden superior pueden distinguir valores. Estudiar la identificación exige, por tanto, examinar el mapa completo entre parámetros y distribuciones, junto con el dominio permitido.
Una información casi singular plantea una dificultad distinta de la singularidad exacta. Puede existir una solución única y, aun así, una dirección en la que grandes cambios de parámetros produzcan variaciones menores que el ruido disponible. Los autovalores ayudan a localizar esa dirección, si bien su magnitud y su condición numérica dependen de las escalas utilizadas. El perfil de verosimilitud y las predicciones a lo largo de la dirección débil sirven para comprobar cuánto depende la conclusión de una aproximación local.
Diseñar cuando el parámetro todavía es desconocido
En los modelos no lineales los gradientes suelen depender de los propios parámetros. Box y Lucas (1959) formularon el problema de seleccionar condiciones para estimar con precisión parámetros de respuestas no lineales. Un diseño evaluado en un valor nominal puede ser excelente cerca de ese valor y perder información si el sistema se encuentra lejos, de manera que el diseño necesita representar la incertidumbre que pretende reducir.
Tómese como ejemplo didáctico un detector de respuesta binaria que, ante una intensidad , responde uno con probabilidad
donde es un umbral desconocido y una escala conocida. La información de una observación sobre es y alcanza su máximo en , cuando la intensidad coincide con el umbral. Las intensidades que producen respuestas casi seguras, todas positivas o todas negativas, informan menos sobre la localización exacta de esa transición.
Si se diseña suponiendo y se mide en , la elección es localmente óptima. Con el umbral verdadero en , sin embargo, la probabilidad de responder uno es aproximadamente 0,0474 y la información cae a , alrededor del 18,1 % del máximo . Antes de concentrar todas las repeticiones en una transición cuya ubicación se desconoce conviene, por tanto, explorar un intervalo plausible.
Una estrategia puede distribuir observaciones entre varios umbrales plausibles y escoger un diseño con buen rendimiento en el peor caso considerado. Otra puede asignar una distribución previa a y promediar una utilidad sobre sus valores. En ese caso debe declararse qué se promedia, porque maximizar el determinante de una información promedio y promediar logaritmos de determinantes son operaciones diferentes. Sus soluciones pueden diferir, ya que el segundo procedimiento penaliza los diseños con información muy pequeña en algunos escenarios.
Sean dos escenarios igualmente probables y un solo parámetro, con valores didácticos expresados en una misma escala. El diseño A da información diez en el primer escenario y uno en el segundo, frente al diseño B, que da cuatro en ambos. Promediar la información favorece a A, con 5,5 frente a cuatro. Promediar el logaritmo favorece a B, cuyo promedio es , aproximadamente 1,386, mientras el de A es , aproximadamente 1,151. El segundo criterio concede más peso al escenario en que A tiene información escasa.
La evaluación del diseño debe conservar los resultados por escenario. Un promedio comunicado en solitario oculta qué valores del parámetro reciben mediciones poco informativas. Tampoco conviene estrechar la distribución previa con el único fin de que un diseño concentrado parezca eficiente. Su amplitud expresa la incertidumbre que se admite antes de medir y puede comprobarse con un análisis de sensibilidad.
El criterio informativo de Lindley (1956) incorpora una distribución previa y considera cuánto puede cambiar el conocimiento sobre los parámetros al observar el resultado del experimento. Su forma esperada puede expresarse como una divergencia entre posterior y previa promediada sobre los datos posibles, un cálculo de ganancia esperada que utiliza distribuciones completas. La información de Fisher da aproximaciones locales relacionadas con él en ciertos regímenes, aunque por definición son cantidades distintas.
Otra posibilidad es trabajar por etapas. Una primera tanda sitúa aproximadamente la transición del detector y las siguientes ajustan las intensidades al intervalo que aún conserva plausibilidad. El análisis debe tener en cuenta la regla con que se eligió cada intensidad a partir de los datos anteriores. Si además la escala fuera desconocida, medir solo en el umbral previsto dejaría poca o ninguna sensibilidad local a esa escala y habría que conservar intensidades a ambos lados para distinguir posición y anchura.
En la recta, el reparto de cuatro mediciones en cada extremo agota el presupuesto de ocho y alcanza el determinante máximo bajo el modelo lineal declarado. Para admitir una curvatura pueden conservarse tres observaciones en cada extremo y situarse dos en cero. Con gradientes , la información del modelo ampliado es un cuarto de la matriz con filas , y .
Esta matriz tiene ya rango tres y su inversa asigna varianzas dos a la ordenada, a la pendiente y a la curvatura. La covarianza entre ordenada y curvatura es menos dos, señal de que un aumento de una puede compensar parcialmente una reducción de la otra. Los dos datos centrales limitan esa compensación porque en ellos el término cuadrático desaparece.
La pendiente tiene ahora varianza , frente a 0,5 en el diseño lineal de extremos, una pérdida que es el precio de estimar un parámetro adicional con el mismo presupuesto. Como los determinantes de matrices de dimensiones distintas miden objetos diferentes, la comparación se hace sobre las varianzas de las cantidades comunes y sobre la posibilidad nueva de estimar la curvatura. La hoja de observación puede especificar entonces tres lecturas en menos uno, dos en cero y tres en uno, junto con el modelo de error con el que se calcularon esas precisiones.
Referencias
Box, G. E. P., y Lucas, H. L. (1959). Design of experiments in non-linear situations. Biometrika, 46(1–2), 77–90. https://doi.org/10.1093/biomet/46.1-2.77
Efron, B., y Hinkley, D. V. (1978). Assessing the accuracy of the maximum likelihood estimator: Observed versus expected Fisher information. Biometrika, 65(3), 457–483. https://doi.org/10.1093/biomet/65.3.457
Fisher, R. A. (1922). On the mathematical foundations of theoretical statistics. Philosophical Transactions of the Royal Society of London. Series A, 222, 309–368. https://doi.org/10.1098/rsta.1922.0009
Kiefer, J., y Wolfowitz, J. (1960). The equivalence of two extremum problems. Canadian Journal of Mathematics, 12, 363–366. https://doi.org/10.4153/CJM-1960-030-4
Lindley, D. V. (1956). On a measure of the information provided by an experiment. The Annals of Mathematical Statistics, 27(4), 986–1005. https://doi.org/10.1214/aoms/1177728069
Rothenberg, T. J. (1971). Identification in parametric models. Econometrica, 39(3), 577–591. https://doi.org/10.2307/1913267