Dos modelos describen una respuesta continua en función de una magnitud experimental, el primero mediante una recta y el segundo mediante una curva cúbica. Ambos se ajustan a las mismas cien observaciones, con errores normales independientes y varianza conocida. La curva alcanza una logverosimilitud de −136 y la recta, de −140. Era previsible que la curva ajustara mejor, porque la recta es un caso particular suyo y el modelo más amplio dispone de todas las posibilidades del otro y de algunas más.
Las cifras pertenecen a un ejercicio didáctico. Aun con una especificación tan sencilla, dos criterios habituales llegan a decisiones distintas, pues AIC favorece la curva y BIC la recta. La discrepancia se aclara al identificar qué estima cada criterio y qué precio asigna a la libertad adicional. El recuento de parámetros es solo una parte del problema, en el que también intervienen la información previa, la tarea predictiva y las decisiones que llevaron a comparar esos dos modelos.
La elección depende de lo que se quiere obtener
Una comparación predictiva pregunta qué procedimiento funcionará mejor ante observaciones futuras. Hace falta precisar cuáles serán y cómo se medirá el error, porque predecir una respuesta dentro del intervalo experimental ya estudiado no es lo mismo que predecirla muy por fuera de él. Estimar un promedio también difiere de asignar probabilidades a resultados extremos, de modo que dos modelos pueden intercambiar posiciones cuando cambia la tarea.
Para una predicción puntual puede utilizarse el error cuadrático. Cuando se desea una distribución predictiva completa, una opción es la puntuación logarítmica, que evalúa el logaritmo de la densidad o probabilidad asignada al resultado que finalmente ocurre. Una predicción que concede escaso apoyo a los resultados observados recibe una puntuación baja. En variables continuas se evalúan densidades, cuyo valor depende de las unidades, por lo que la comparación exige una escala común.
El objetivo poblacional sería el promedio de esa puntuación sobre nuevos datos generados por el proceso de interés. Cuando existen las integrales correspondientes, maximizarlo equivale a minimizar la divergencia de Kullback–Leibler desde la distribución generadora hacia la predictiva, ya que el término que depende únicamente de la primera es común a los modelos. Como esa distribución es desconocida, en la práctica la capacidad predictiva se estima con los datos disponibles.
Identificar una estructura verdadera es otro problema. Si se considera una lista fija de modelos y se supone que alguno describe exactamente el mecanismo generador, puede interesar seleccionar ese modelo con probabilidad creciente al aumentar la muestra. Esa propiedad, llamada consistencia de selección, es asintótica y puede coexistir con un error predictivo mayor que el de otro candidato con los cien datos que tenemos. Un componente débil puede existir y contribuir poco a una predicción estimada con incertidumbre.
También puede interesar un parámetro concreto, como el efecto de una intervención. En ese caso, añadir una variable que mejora la predicción puede cambiar lo que mide el coeficiente restante. El significado de un parámetro depende de qué se condiciona y de los supuestos del diseño, dos cuestiones ajenas a cualquier clasificación por ajuste predictivo.
Toda comparación, por último, está limitada por sus candidatos. Una recta puede ganar a una curva cúbica y reproducir mal las colas del error, la heterogeneidad entre unidades o la dependencia temporal. Esas propiedades se examinan con comprobaciones de adecuación, a las que la comparación añade una preferencia relativa para un propósito definido.
El optimismo que introduce el ajuste
El error calculado con los datos usados para estimar los parámetros suele favorecer al modelo ajustado, porque parte de su flexibilidad se emplea en describir fluctuaciones que no se repetirán. La penalización predictiva intenta estimar esa ventaja, llamada optimismo del ajuste.
En una regresión lineal sencilla el optimismo puede calcularse con exactitud. Sea , con observaciones, diseño fijo y errores de media cero y covarianza . Supongamos además que la media verdadera pertenece al espacio lineal ajustado, de dimensión . Con el ajuste por mínimos cuadrados , donde proyecta sobre ese espacio, el error dentro de la muestra cumple
Imaginemos ahora otra respuesta , independiente de la primera pero obtenida en las mismas posiciones del diseño. Si se conserva el ajuste calculado con , se obtiene
El segundo error incluye la variación de los nuevos resultados y la incertidumbre de los coeficientes estimados, mientras que el primero es menor porque el ajuste y sus residuos proceden de la misma muestra. La diferencia entre ambas esperanzas vale .
Con cien observaciones, varianza uno y una media realmente contenida en ambos modelos, los errores esperados serían 98 y 102 para el modelo de dos parámetros, frente a 96 y 104 para el de cuatro. Los parámetros añadidos reducen el error de entrenamiento aunque no haya una curvatura real que aprender y, en este escenario concreto, aumentan el error predictivo esperado.
Si la media verdadera queda fuera del espacio ajustado, aparece además un término de sesgo que una curva puede reducir lo suficiente para compensar el coste de estimarla. La penalización, por tanto, puede favorecer a la expresión más larga cuando la mejora de ajuste supera la estimación de cuánto de ella puede deberse a adaptar el modelo a fluctuaciones de la muestra.
En el modelo normal con varianza conocida, menos dos veces la logverosimilitud contiene el error cuadrático dividido por más una constante común y la corrección anterior se convierte así en . Con esa conexión, la penalización del criterio de Akaike se interpreta como una corrección del optimismo y deja de parecer una preferencia estética por las fórmulas pequeñas.
AIC y BIC cambian el precio de los parámetros
El criterio de Akaike se escribe
donde es la logverosimilitud maximizada y , el número de parámetros ajustados independientemente. Akaike (1974) fundamentó el procedimiento en una evaluación de la aproximación estadística. En su interpretación predictiva, la corrección estima el optimismo que supone predecir con la estimación de máxima verosimilitud, un objetivo que Gelman, Hwang y Vehtari (2014) distinguen del que persiguen otros criterios bayesianos.
La justificación habitual supone un problema regular, con parámetros identificables, una dimensión que se mantiene fija mientras crece la información y condiciones asintóticas que validen la aproximación utilizada. Fuera de ese régimen, por ejemplo con una regularización intensa, falta de identificabilidad o una especificación muy alejada del proceso generador, puede ser una corrección inadecuada y el cálculo debe revisarse.
El criterio de información bayesiano, propuesto por Schwarz (1978), utiliza
En nuestro ejemplo la recta tiene dos parámetros, el intercepto y la pendiente, a los que la curva cúbica añade dos coeficientes hasta sumar cuatro. La varianza del error se declaró conocida y, si se estimara, tendría que incluirse en el recuento pertinente. Los logaritmos son naturales y los valores de logverosimilitud incluyen las mismas constantes.
| Modelo | Parámetros | Logverosimilitud | AIC | BIC |
|---|---|---|---|---|
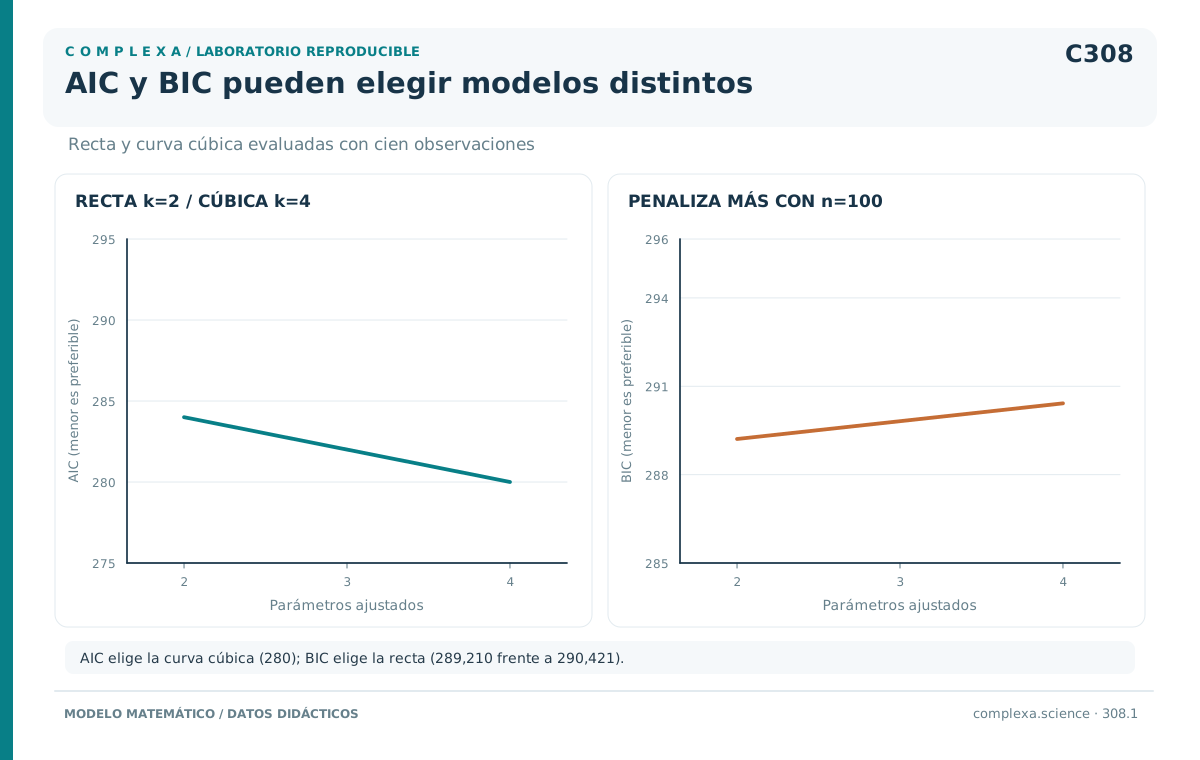
| Recta | 2 | −140 | 284 | 289,210 |
| Curva cúbica | 4 | −136 | 280 | 290,421 |
Ambos criterios prefieren el valor menor. La curva mejora en ocho unidades el término correspondiente a menos dos veces la logverosimilitud. Las decisiones opuestas proceden del precio de los dos parámetros adicionales, por los que AIC cobra cuatro unidades y BIC cobra , unas 9,21.
La tabla supone además que ambos modelos se evalúan sobre exactamente los mismos resultados. Si uno se ajustó tras eliminar observaciones difíciles y el otro las conserva todas, sus sumas de logverosimilitud corresponden a conjuntos distintos y no pueden compararse directamente. Cuando faltan covariables para algunas unidades, habrá que definir una muestra común o un procedimiento que evalúe las mismas observaciones futuras.
Una transformación de la respuesta exige otra comprobación. Para una variable positiva , un modelo sobre puede compararse con otro sobre si ambos se expresan como densidades de la respuesta original. Como la transformación produce , la logverosimilitud correspondiente es la calculada sobre los logaritmos menos . Omitir ese término equivale a comparar densidades en escalas diferentes.
Cuando todos los candidatos utilizan la misma transformación, el término es común y se cancela en sus diferencias. Cuando solo uno la utiliza, el término subsiste y basta para que la comparación sea incorrecta, incluso con un número idéntico de parámetros. Esta comprobación debe preceder a cualquier interpretación de una diferencia pequeña entre criterios.
BIC procede de una aproximación a la probabilidad marginal de los datos bajo cada modelo. En un problema regular, la integral que promedia la verosimilitud sobre la distribución previa se concentra cerca del máximo, en una región cuyo volumen decrece aproximadamente como . Al tomar menos dos veces el logaritmo aparece . La aproximación exige condiciones sobre la concentración y la curvatura, además de una previa fija, propia y positiva cerca de los valores relevantes.
Bajo condiciones de selección regular, con una colección finita que contiene la estructura verdadera, BIC puede seleccionar su dimensión con probabilidad que tiende a uno. AIC se comporta de otro modo. Si se añade un único coeficiente cuyo valor verdadero es cero, el incremento de dos veces la logverosimilitud tiene, bajo las condiciones usuales, un límite chi cuadrado con un grado de libertad. Como AIC acepta la ampliación cuando ese incremento supera dos, la probabilidad límite de aceptarla es aproximadamente 0,1573, valor que su objetivo predictivo no obliga a llevar a cero.
El umbral de BIC, en cambio, crece como y por eso rechaza esa ampliación superflua con probabilidad creciente en el escenario descrito. Si el coeficiente tiene un valor fijo distinto de cero y el diseño contiene información suficiente, la ganancia de ajuste puede crecer proporcionalmente a , con lo cual el mismo criterio acabará reteniéndolo. Estas afirmaciones cambian cuando aumentan a la vez el número de candidatos y su dimensión.
La libertad efectiva puede diferir del recuento nominal
Un coeficiente fuertemente restringido por una previa o una penalización se adapta a los datos menos que otro estimado libremente. Ambos figuran en la ecuación con contribuciones distintas al optimismo, diferencia que la complejidad efectiva intenta cuantificar para una medida de ajuste concreta.
Volvamos a una predicción lineal , en la que ahora es una matriz fija que puede contraer algunas direcciones de los datos. Con el mismo diseño y errores independientes de varianza , la diferencia esperada entre el error sobre una respuesta nueva y el error de entrenamiento es
La traza suma la sensibilidad de cada valor ajustado a su propia observación. Coincide con el rango cuando es la proyección de mínimos cuadrados y puede ser fraccionaria en un ajuste contraído.
Supongamos que el procedimiento anula todas las direcciones salvo tres, ortogonales entre sí, a las que aplica factores de contracción uno, 0,8 y 0,3. La traza vale 2,1 aunque haya tres componentes ajustables. Con varianza del error uno el optimismo total es 4,2, frente a la corrección de seis que produciría para este cálculo contar automáticamente tres parámetros.
Otras cantidades expresan propiedades diferentes. La suma de los cuadrados de esos factores es 1,73 y determina una contribución a la varianza del ajuste, en tanto que el optimismo aquí definido depende de la traza 2,1. Llamar «grados de libertad» a ambas sin indicar su función oculta esa diferencia.
El resultado supone que está fijada antes de observar las respuestas. Si se prueban muchas intensidades de contracción y se elige la que funciona mejor en esos mismos datos, la elección añade una adaptación propia del proceso de búsqueda, que queda fuera de la traza de la matriz finalmente escogida.
En los modelos bayesianos la complejidad efectiva también depende de las restricciones y de la distribución posterior. Gelman y colaboradores (2014) muestran por qué, en modelos jerárquicos, el número de coeficientes deja de ser una corrección general. Los criterios predictivos estiman el ajuste adicional que admite la incertidumbre restante, con definiciones que pueden dar valores distintos.
Hay además modelos singulares. En una mezcla de dos distribuciones cuyos componentes coinciden, cambiar el peso de la mezcla deja inalterada la distribución observable, de manera que algunos parámetros no pueden identificarse y falla la aproximación cuadrática regular. La teoría de Watanabe (2010) muestra que la geometría de estos problemas afecta a las medidas de complejidad. Por eso, introducir sin más el número de símbolos de una mezcla en la fórmula ordinaria de BIC puede dar un valor alejado de su evidencia marginal.
La evidencia marginal conserva las consecuencias de la previa
Para un modelo , la evidencia marginal es
Esta cantidad promedia la verosimilitud sobre la previa. Un modelo capaz de producir muchos resultados diferentes reparte su probabilidad entre ellos, de manera que puede ajustar muy bien la muestra en una región pequeña de parámetros y, aun así, haberle asignado poca probabilidad antes de observarla. Por esta vía, entre otras, la evidencia incorpora la amplitud de las posibilidades admitidas.
El factor de Bayes compara dos evidencias y multiplica las razones previas entre modelos para dar las razones posteriores. Un factor de dos equivale a una probabilidad posterior de dos tercios solo cuando las razones previas son de uno a uno. Kass y Raftery (1995) examinan esta relación y la sensibilidad de la comparación a las distribuciones previas.
Un ejercicio normal muestra la magnitud que puede alcanzar esa sensibilidad. Disponemos de 25 observaciones independientes con varianza conocida uno y media muestral 0,4, cuyo error estándar de 0,2 sitúa su distancia estandarizada a cero en . El modelo fija la media poblacional en cero y el modelo deja libre una media con previa normal de media cero y desviación típica .
En el cociente se cancelan las partes de la verosimilitud que describen los residuos alrededor de la media muestral y, con , queda
La tabla mantiene los datos, cambia únicamente la amplitud previa de y presenta también la posterior de dentro de ese modelo.
| Desviación previa | Media posterior de | Desviación posterior | |
|---|---|---|---|
| 1 | 1,3418 | 0,3846 | 0,1961 |
| 10 | 0,1476 | 0,3998 | 0,2000 |
Las dos posteriores de la media son parecidas y, sin embargo, el factor de Bayes pasa de favorecer ligeramente a a favorecer a . Con la previa de reparte mucha probabilidad sobre medias de magnitud muy superior a la observada. La concentración de las posteriores tras observar los datos deja intacta en la evidencia esa diferencia de predicción previa.
Elegir exige expresar qué magnitudes se consideraban plausibles para el efecto. Ampliarlo indefinidamente es también una elección previa, que cambia lo que predice antes de observar la muestra. Una previa impropia introduce constantes de normalización arbitrarias y, en general, deja indefinida esta evidencia y con ella el factor de Bayes ordinario, incluso cuando produce una posterior propia con la que estimar parámetros.
La escala también debe transformarse coherentemente. Si el efecto se mide en otras unidades, cambia el valor numérico de . Transformar a la vez el parámetro y su densidad previa conserva la evidencia; mantener la misma cifra de después del cambio de unidades define otra previa. BIC omite términos de orden constante de la aproximación marginal, en los que puede residir parte de esta sensibilidad y que, con muestras finitas, pueden decidir una comparación cercana.
Predicción con toda la distribución posterior
Una comparación bayesiana predictiva evalúa la distribución que integra los parámetros. Para una observación nueva se promedian las probabilidades condicionadas en cada valor posterior y solo después se aplica la puntuación logarítmica.
La diferencia entre ambos órdenes puede verse sin ajustar otro modelo. Si dos valores posteriores equiprobables asignan al mismo resultado probabilidades 0,2 y 0,8, la distribución predictiva le asigna 0,5, cuyo logaritmo vale aproximadamente −0,6931, en tanto que el promedio de los logaritmos de 0,2 y 0,8 vale −0,9163. Intercambiar los dos cálculos altera la puntuación.
Para observaciones condicionalmente independientes, la evaluación que deja una observación fuera utiliza
donde contiene todas las observaciones excepto la que se predice, es decir, cada densidad se calcula con la posterior ajustada sin . La suma estima la capacidad predictiva sobre unidades semejantes a las omitidas. Aunque cada entrenamiento usa observaciones, sigue siendo una estimación a partir de una muestra finita.
WAIC aproxima un objetivo predictivo relacionado a partir de la posterior calculada con todos los datos. Primero se obtiene la logdensidad predictiva puntual dentro de la muestra,
Después se aplica una corrección de optimismo,
La varianza se calcula entre valores posteriores para cada observación y luego se suma, por lo que difiere tanto de la varianza de las puntuaciones entre observaciones como de la varianza posterior de la suma de logverosimilitudes. La corrección puede ser fraccionaria y depende del modelo, de los datos y de la previa.
Watanabe (2010) estableció una equivalencia asintótica entre la validación bayesiana que deja una observación fuera y WAIC, bajo condiciones matemáticas que incluyen clases de modelos singulares. El resultado amplía el alcance de la teoría regular sin establecer una igualdad exacta en cada muestra o modelo. Vehtari, Gelman y Gabry (2017a) muestran diferencias prácticas cuando las previas son débiles o hay observaciones influyentes.
La unidad de predicción forma parte de estas fórmulas. Si se quiere predecir a una persona nueva con varias mediciones, el término omitido puede ser el conjunto completo de sus registros. Omitir una sola medición deja en el entrenamiento información de esa misma persona. Ambas evaluaciones pueden ser útiles, pero cuantifican tareas diferentes y la factorización adoptada para el cálculo debe corresponder a la tarea declarada.
Aproximar la validación y reconocer cuándo falla
Como ajustar posteriores puede ser costoso, el muestreo por importancia intenta reutilizar las extracciones de la posterior completa para aproximar las distribuciones que omiten cada observación. Si eliminar un dato cambia mucho la posterior, unas pocas extracciones reciben pesos enormes y el cálculo se vuelve inestable.
El procedimiento PSIS suaviza la cola de esos pesos mediante una distribución de Pareto generalizada, cuyo parámetro estimado, , informa de la dificultad de la aproximación. Vehtari y colaboradores (2017a, 2017b) utilizan ese diagnóstico para identificar los casos que requieren atención. El sombrero distingue la estimación diagnóstica de la cantidad teórica y del número de parámetros usado en AIC.
Un diagnóstico problemático puede resolverse recalculando directamente la posterior que excluye esa observación o mediante particiones apropiadas con nuevos ajustes. También puede motivar un modelo de observación menos sensible a valores extremos, siempre que esa modificación tenga una justificación sustantiva. El diagnóstico no autoriza a eliminar un registro porque perjudique la comparación.
WAIC presenta dificultades distintas cuando la variación posterior de ciertas contribuciones de logverosimilitud es grande. Pese a su equivalencia asintótica con LOO, en esos casos las dos aproximaciones pueden diferir mucho en precisión. Conviene distinguir entre el valor del criterio y el diagnóstico sobre cómo se obtuvo.
El error numérico tampoco coincide con la incertidumbre de la comparación. Generar más muestras posteriores puede reducir el error de Monte Carlo y, sin embargo, dejar casi intacta la incertidumbre debida a haber observado pocas unidades. Una cifra impresa con cuatro decimales puede ser numéricamente estable y corresponder a una preferencia predictiva débil.
Comparar diferencias sobre las mismas observaciones
Dos modelos ya ajustados predicen diez observaciones nuevas e independientes y, para cada una, calculamos la diferencia entre la puntuación logarítmica del modelo B y la del modelo A. En este otro ejemplo didáctico las diferencias son
La suma vale 1,2 y el promedio, 0,12 por observación. Con una varianza muestral de las diferencias de aproximadamente 0,04622 y tratando las observaciones como unidades independientes, el error estándar estimado de la suma es
El cálculo está emparejado, puesto que cada diferencia utiliza el mismo resultado para ambos modelos. Una observación difícil puede recibir puntuaciones bajas en los dos y contribuir poco a la incertidumbre de su diferencia, de modo que calcular por separado dos errores, ignorando ese emparejamiento, puede distorsionar la comparación.
La ventaja observada favorece a B, pero su magnitud debe leerse junto con la variabilidad y el tamaño reducido del conjunto de evaluación. Exponenciar 1,2 da aproximadamente 3,32, el cociente de los productos de las densidades predictivas individuales, que se interpreta dentro de esa puntuación. Para llegar a razones posteriores entre modelos habría que incorporar sus probabilidades de partida y utilizar las predictivas conjuntas pertinentes.
Vehtari y colaboradores (2017a) desarrollan comparaciones emparejadas análogas para LOO y explican las limitaciones de sus errores estándar aproximados, entre ellas que las contribuciones pueden ser asimétricas, compartir información de entrenamiento o concentrar la diferencia en unos pocos casos. En series temporales o datos agrupados, tratar cada fila como independiente infravalora variabilidad relevante cuando existen dependencias positivas.
Las contribuciones individuales indican dónde aparece la ventaja. Si un modelo mejora casi exclusivamente en el extremo del intervalo experimental, esa mejora puede ser relevante cuando el extremo es frecuente en el uso futuro. Si es raro, la media global debe ponderarse según la población de destino, con pesos definidos por la tarea antes de saber a qué modelo favorecen.
La selección también puede ajustarse al ruido
La validación estima el rendimiento con error. Cuando se prueban muchas especificaciones y se elige la de mejor puntuación, parte de la victoria puede proceder de una fluctuación favorable de esa estimación. La búsqueda se adapta entonces a los datos de validación. Cawley y Talbot (2010) analizaron este sobreajuste de la selección y mostraron que puede afectar tanto a la comparación de algoritmos como a la evaluación de su rendimiento.
Pensemos en una comparación de veinte intensidades de regularización, cinco conjuntos de variables y varias transformaciones. Aunque cada ajuste individual esté correctamente penalizado, el procedimiento completo ha buscado entre numerosas alternativas, búsqueda que se omite cuando la mejor puntuación encontrada se presenta como si correspondiera a un modelo fijado de antemano.
Una evaluación anidada reserva datos externos a todas las decisiones de selección. Dentro de cada partición de entrenamiento las alternativas se comparan mediante nuevas particiones internas, tras lo cual la elegida se ajusta con el entrenamiento externo completo y se evalúa en la parte externa reservada.
Con cien observaciones y cinco particiones externas iguales, cada ronda utiliza ochenta para desarrollar el procedimiento y veinte para evaluarlo. Si las ochenta se dividen en cuatro partes internas, cada ajuste interno usa sesenta y predice veinte. La especificación elegida dentro de esas ochenta se vuelve a ajustar con todas ellas antes de predecir las veinte externas, cuyos resultados no intervienen en la elección de esa ronda.
Las transformaciones aprendidas también forman parte del procedimiento, de modo que la selección de variables, la imputación y la estimación de escalas deben ajustarse con el entrenamiento correspondiente y aplicarse después a los datos reservados. Una conversión de unidades definida de antemano no aprende de la muestra, a diferencia de una transformación elegida porque mejoró los resultados.
El reparto debe respetar las oportunidades reales de información. Para predecir periodos futuros, el entrenamiento de cada ronda precede a su periodo de evaluación. Para grupos nuevos se retiran grupos completos. La validación anidada evalúa el proceso de aprendizaje y selección con los tamaños de entrenamiento utilizados y el procedimiento final puede ajustarse después con todos los datos disponibles si se deja explícita esa diferencia de tamaño.
Conservar alternativas cuando sus predicciones difieren
Una comparación puede concluir sin descartar de inmediato todos los candidatos salvo uno, pues si varias estructuras conservan apoyo es posible construir una distribución predictiva que las combine. Con probabilidades posteriores de modelo , el promedio bayesiano toma la forma
Kass y Raftery (1995) explican cómo la evidencia marginal y las probabilidades previas de los modelos producen esos pesos. La combinación mantiene la incertidumbre sobre la estructura dentro de la lista considerada, con pesos que dependen de esa lista y de sus previas y que solo reparten probabilidad entre mecanismos efectivamente propuestos.
Promediar las distribuciones conserva más información que comunicar solo el promedio de sus medias. Si el modelo predice una media y una varianza , la varianza de la mezcla es
El primer término promedia la variación dentro de cada predicción y el segundo incorpora el desacuerdo entre sus medias. En un ejemplo con pesos iguales, medias 0,3 y 0,5 y varianza 0,04 en ambos modelos, la media combinada es 0,4 y la varianza, 0,05. Informar una normal de media 0,4 y varianza 0,04 eliminaría la contribución 0,01 del desacuerdo. La mezcla, además, puede apartarse de la forma normal.
La utilidad de conservar alternativas depende de la tarea. Si los modelos predicen casi lo mismo en el intervalo observado y divergen fuera de él, la combinación puede ampliar la incertidumbre de extrapolación. Ese ensanchamiento refleja un desacuerdo específico que conviene examinar, aunque la cobertura de la combinación fuera del intervalo puede ser insuficiente si todas las estructuras comparten una suposición equivocada.
También pueden estimarse otros pesos buscando rendimiento predictivo en datos reservados. Son entonces parámetros de un procedimiento de combinación, que deben evaluarse como tales y cuyo significado es distinto del de las probabilidades posteriores de que cada estructura sea verdadera. Si se optimizan y se puntúan sobre las mismas observaciones, reaparece el sobreajuste de selección que motivó la evaluación anidada.
Volver al experimento que distingue las curvas
La recta y la curva cúbica iniciales pueden compararse ahora con preguntas precisas. Si interesa predecir nuevas respuestas dentro del mismo intervalo experimental, se evaluarán sus distribuciones predictivas sobre observaciones de ese intervalo. Sostener que el mecanismo tiene una curvatura concreta exige, además, una parametrización identificable, supuestos de observación defendibles y datos capaces de distinguir esa estructura de otras curvas.
Promediar los valores de AIC y BIC deja intacta la discrepancia entre ambos. El primero estimó con su corrección de optimismo una ventaja predictiva de la curva, mientras que el segundo aplicó una aproximación marginal que cobró un precio mayor por sus dos coeficientes adicionales. Una validación diseñada para el uso previsto puede dar una comparación más directa, que debe presentarse con su incertidumbre.
En el siguiente conjunto de mediciones, las predicciones se registrarían antes de observar las respuestas. Si el uso previsto se concentra en los extremos del intervalo, allí se situarían suficientes observaciones y se conservarían sus errores por posición. Una curva que mejore repetidamente esas predicciones y mantenga una dispersión adecuada mostrará una ganancia concreta con la que justificar su coste de estimación. Si la ventaja desaparece al salir de los cien registros originales, faltará una mejora predictiva observada que justifique conservar los términos cuadrático y cúbico para esa tarea.
Referencias
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
Cawley, G. C., y Talbot, N. L. C. (2010). On over-fitting in model selection and subsequent selection bias in performance evaluation. Journal of Machine Learning Research, 11, 2079–2107. https://www.jmlr.org/papers/v11/cawley10a.html
Gelman, A., Hwang, J., y Vehtari, A. (2014). Understanding predictive information criteria for Bayesian models. Statistics and Computing, 24, 997–1016. https://doi.org/10.1007/s11222-013-9416-2
Kass, R. E., y Raftery, A. E. (1995). Bayes factors. Journal of the American Statistical Association, 90(430), 773–795. https://doi.org/10.1080/01621459.1995.10476572
Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
Vehtari, A., Gelman, A., y Gabry, J. (2017a). Practical Bayesian model evaluation using leave-one-out cross-validation and WAIC. Statistics and Computing, 27, 1413–1432. https://doi.org/10.1007/s11222-016-9696-4
Vehtari, A., Gelman, A., y Gabry, J. (2017b). Erratum to: Practical Bayesian model evaluation using leave-one-out cross-validation and WAIC. Statistics and Computing, 27, 1433. https://doi.org/10.1007/s11222-016-9709-3
Watanabe, S. (2010). Asymptotic equivalence of Bayes cross validation and widely applicable information criterion in singular learning theory. Journal of Machine Learning Research, 11, 3571–3594. https://www.jmlr.org/papers/v11/watanabe10a.html