Una curva puede pasar muy cerca de todos los puntos observados y dejar sin resolver la pregunta que motivó el experimento. En un montaje con dos resortes, medir cuánto se estira el conjunto informa de su respuesta a una carga, pero saber cuál de los dos se deforma más requiere otra observación. Ambas preguntas caben en el mismo modelo, aunque la información necesaria para responderlas sea distinta.
El caso siguiente es didáctico. El montaje, las lecturas y las condiciones de medida se construyen para que todos los cálculos queden a la vista. Como la indeterminación tendrá una expresión algebraica exacta, podremos separar una limitación del experimento de un fallo del programa de ajuste. Después incorporaremos una medición con la que cada componente puede estimarse por separado.
Lo que registra el sensor
Se conectan dos resortes en serie. El primero está unido a un soporte fijo y el segundo prolonga el montaje desde la unión intermedia hasta el extremo donde se aplica la carga, de manera que en equilibrio ambos soportan la misma fuerza. El sensor mide el desplazamiento del extremo respecto de su posición sin carga, desplazamiento que reúne las elongaciones de los dos resortes.
Denotemos por y sus rigideces, en newtons por milímetro. Es más cómodo trabajar con las compliancias y , en milímetros por newton, que son mayores cuanto más se estira un resorte bajo la misma fuerza. Si cada pieza obedece una relación lineal, sus elongaciones son y , con lo cual la elongación total esperada vale
Estipulamos que esa relación es válida entre cero y cuatro newtons, que el sistema se mide después de alcanzar el equilibrio y que pueden omitirse el peso de los resortes y la deformación del soporte. El cero del sensor está calibrado y las fuerzas se tratan como conocidas sin error. Las lecturas de desplazamiento tienen errores normales independientes, con media cero y desviación estándar conocida milímetros, valor que procede de la calibración supuesta del instrumento y no de los cuatro residuos que aparecerán después.
El modelo de observación queda escrito como , con . El registro construido es pequeño.
| Fuerza , N | Elongación total , mm |
|---|---|
| 1 | 3,1 |
| 2 | 5,9 |
| 3 | 9,2 |
| 4 | 11,8 |
A simple vista la proporcionalidad es convincente, con un desplazamiento que se duplica aproximadamente al duplicar la fuerza. Para ajustar la recta que pasa por el origen basta definir la compliancia total , con la que la suma de cuadrados de los residuos y su minimizador son
El ajuste predice milímetros y los residuos, definidos como observación menos predicción, valen . Su suma de cuadrados es y la raíz del promedio de sus cuadrados es milímetros, una discrepancia compatible con la escala de error estipulada.
También puede calcularse un indicador descriptivo de ajuste. La media de las cuatro lecturas es y su suma de cuadrados respecto de esa media es , así que con la definición se obtiene . Hemos declarado la definición porque en un ajuste sin intercepto este indicador admite convenciones distintas. Ese valor describe la cercanía entre las lecturas y la recta. Las compliancias individuales siguen, por ahora, sin estimar.
Cuatro soluciones y una familia entera
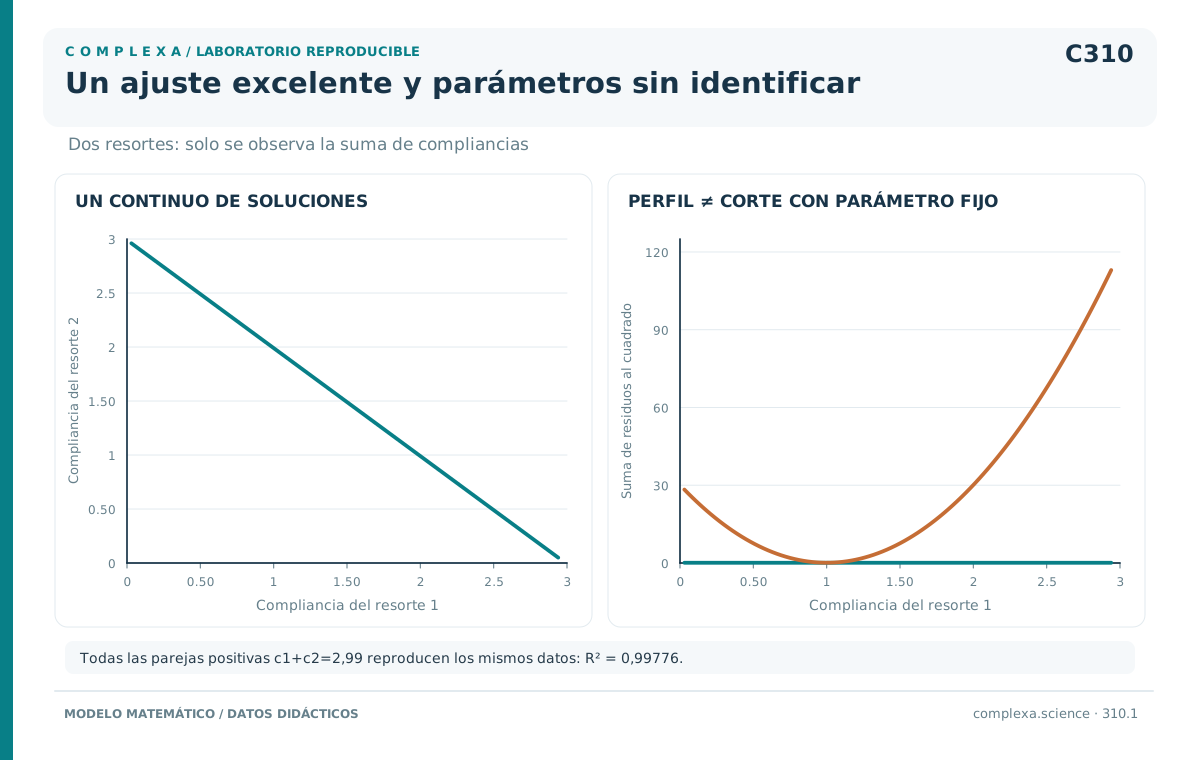
Los pares , , y , cuya suma es en todos los casos , producen exactamente las mismas cuatro predicciones. El primer par atribuye la mayor deformación al segundo resorte y el último se la atribuye al primero. Ninguna lectura del extremo distingue entre ellos.
La equivalencia se mantiene fuera de los cuatro puntos medidos. Dentro del modelo lineal, cualquier fuerza nueva produce para todos esos pares. Hacer veinte mediciones adicionales, reducir el error instrumental o introducir valores intermedios de fuerza puede mejorar la estimación de la suma, aunque las predicciones de los distintos pares seguirían coincidiendo incluso con observaciones perfectas para todas las fuerzas permitidas.
Para cualquier número que mantenga positivas las compliancias, la transformación
deja inalterada la distribución de los datos, cuya media se conserva y cuya varianza no depende de los parámetros. Esta invariancia demuestra la indeterminación estructural del modelo con esa salida observada. La formulación clásica de Bellman y Åström (1970) sitúa la identificabilidad precisamente en la posibilidad de distinguir parámetros a partir de la relación entre entradas y salidas. En nuestro montaje los parámetros indistinguibles pueden exhibirse directamente.
La restricción física recorta la familia, pero conserva un segmento completo de máximos del ajuste, aquel en que y . La positividad es información física que delimita el segmento, sin indicar en qué punto de él se encuentra el sistema.
La situación se ve también cambiando de coordenadas. Si tomamos y , las observaciones dependen de , mientras que desaparece de su ecuación. La condición de positividad impone y todo valor de dentro de ese intervalo describe un reparto físicamente admisible de la compliancia total.
La validación con datos reservados tampoco distingue esos repartos cuando conserva la misma salida. Al ajustar solo las tres primeras lecturas, la pendiente es y predice milímetros a cuatro newtons. La cuarta lectura, reservada, vale , con un residuo predictivo de . El error estándar de esa predicción individual, que incluye la incertidumbre del ajuste y el ruido de la lectura, es milímetros.
La comparación pone a prueba la predicción fuera de los puntos usados para ajustar, pero todos los pares que sumen la superan o la fallan exactamente de la misma manera. Reservar otras fuerzas, aumentar el número de particiones o repetir la comparación con nuevas muestras vuelve a evaluar la respuesta total. Para examinar el reparto hace falta que al menos una observación dependa de los componentes de otra forma.
Algo parecido ocurre al simular nuevos conjuntos de datos con el modelo ajustado. En cada simulación la suma estimada cambia por efecto del ruido y su reparto queda libre. Si el programa impone siempre el mismo desempate, los pares obtenidos pueden agruparse alrededor de una relación fija que refleja también el procedimiento numérico, por lo que antes de interpretar una nube estrecha como evidencia de precisión hay que comprobar qué restricciones aplica el ajuste en cada repetición.
Las coordenadas ayudan además a interpretar la salida de un programa. Si el algoritmo termina en y , la respuesta parece especialmente ordenada, con dos números iguales de tres decimales. Esa igualdad puede proceder del punto inicial, de una regla de desempate o de una restricción añadida por el usuario, dado que lo único que el experimento ha observado es una suma.
En este montaje ideal, intercambiar el orden de los dos resortes tampoco cambiaría la elongación total. La maniobra parecería una intervención experimental y, sin embargo, preservaría exactamente la función de observación. Una intervención ayuda a identificar los componentes cuando modifica la dependencia de las mediciones respecto de ellos, algo que el significado físico de la maniobra deja ver antes de que se invierta tiempo en realizarla.
Seguir el valle del ajuste
Con errores normales de varianza conocida, maximizar la verosimilitud equivale a minimizar . Alrededor del mínimo, la suma de cuadrados tiene aquí la expresión exacta
Esta fórmula da un diagnóstico más completo que el mensaje «convergencia alcanzada». La superficie aumenta cuando cambia la suma y permanece constante cuando una compliancia aumenta lo mismo que disminuye la otra. El conjunto de máximos de verosimilitud forma así una cresta, que en la representación de la suma de cuadrados aparece como el fondo de un valle.
Para evaluar podemos fijarlo en distintos valores y volver a ajustar en cada paso, con lo que se construye un perfil de verosimilitud. Raue et al. (2009) desarrollaron su uso para estudiar la identificabilidad en modelos dinámicos parcialmente observados. Como reoptimiza los demás parámetros, el perfil sigue compensaciones que una inspección aislada puede ocultar.
En nuestro caso el perfil alcanza tanto en , donde el mejor es , como en , donde el mejor es . Si en cambio mantenemos artificialmente y desplazamos desde hasta , la suma de cuadrados aumenta en , una subida propia de un corte de la superficie donde prohibimos la compensación.
Una comparación basada en ese corte daría una falsa impresión de precisión individual. El programa estaría respondiendo qué cambios de son admisibles bajo el supuesto de que se conoce exactamente, conocimiento que el experimento original nunca obtuvo. En un problema grande conviene registrar el valor del perfil junto con la trayectoria de los parámetros reajustados, trayectoria que suele revelar qué combinación se conserva.
La información de Fisher confirma el diagnóstico. Como cada observación tiene vector de sensibilidad ,
Sus autovalores son y cero. La dirección proporcional a carece de información, en tanto que la proporcional a cambia la elongación y queda restringida. El cero es exacto porque las columnas de sensibilidad son idénticas en todas las fuerzas. En otros modelos un autovalor pequeño puede reflejar incertidumbre práctica o una aproximación local, aunque aquí la invariancia algebraica había demostrado ya la equivalencia global.
Las grandes diferencias entre sensibilidades aparecen también sin que exista una dirección exactamente nula. Gutenkunst et al. (2007) estudiaron ese fenómeno en una colección de modelos de biología de sistemas y mostraron que algunas predicciones podían estar bien delimitadas mientras muchos parámetros seguían siendo imprecisos, un resultado que ayuda a separar las preguntas sobre parámetros y sobre predicciones. Nuestro montaje es un caso especialmente sencillo, con una dirección completamente ausente de los datos.
La dimensión efectiva interviene también al estimar el ruido. Si se desconociera y se quisiera estimarla con estas cuatro observaciones, habría tres grados de libertad residuales, dado que las predicciones ajustadas ocupan un espacio de dimensión uno. El estimador usual de la varianza sería . Restar dos grados de libertad por las dos compliancias que enumera la ficha del modelo daría , un cálculo que ignora la dependencia exacta entre sus columnas.
Con una varianza estimada a partir de tan pocos residuos, los intervalos para la suma se construirían con una distribución t de tres grados de libertad. El cambio afecta a su amplitud y deja intacta la familia de repartos equivalentes, porque la incertidumbre del ruido y la ausencia de información sobre el reparto son propiedades diferentes del mismo problema.
En el resto del caso se conserva la varianza instrumental conocida de , con la que los estimadores lineales tienen intervalos normales exactos dentro del modelo supuesto y el efecto de incorporar cada observación queda a la vista. El informe debe registrar esa elección. Una desviación estándar documentada por calibración y otra estimada a partir de cuatro lecturas descansan en bases de información distintas.
Qué añade una regla de regularización
Supongamos que el programa entrega una única solución escogiendo, entre todos los mínimos de , el de menor . Para una suma fija esa cantidad se minimiza repartiendo la suma por igual, de donde salen los valores y . La regla está perfectamente definida y puede ser útil para construir una representación convencional. Su fundamento es la preferencia por una norma pequeña.
Otra operación frecuente consiste en minimizar directamente
En este caso cambia también la suma estimada. Una vez repartida por igual, la penalización vale y el mínimo satisface
Con obtenemos y en milímetros por newton. La penalización ha elegido un reparto y, además, ha reducido la suma. Aquí tiene unidades de fuerza al cuadrado. Al pasar de milímetros a metros, tanto como se multiplican por , de modo que mantener conserva la solución física. Si se modifica la unidad de fuerza, en cambio, también debe convertirse el valor de .
Un análisis bayesiano puede incorporar información previa sobre las dos piezas, por ejemplo resultados de un ensayo anterior o tolerancias de fabricación documentadas, que la distribución posterior combinará con la restricción sobre la suma. Si la información previa favorece compliancias semejantes, la posterior puede concentrarse también alrededor de un reparto casi simétrico. Esa concentración debe leerse a la luz de su origen, sobre todo cuando procede de intervalos estrechos impuestos por conveniencia numérica, que fijan el reparto sin que se haya medido ningún componente.
Daly et al. (2018) examinaron la identificabilidad mediante la geometría de distribuciones inferidas y la selección de observaciones complementarias. En nuestro montaje esa geometría se reconoce sin simulaciones. La verosimilitud ocupa una franja alrededor de una suma y cualquier recorte adicional de la franja necesita una justificación propia.
Cuando solo interesa la elongación total hay una solución más económica, conservar como único parámetro. La rigidez equivalente del conjunto es entonces , cuyo valor ajustado es aproximadamente . Maiwald et al. (2016) utilizan las dependencias que revelan los perfiles para orientar la reducción de modelos según la información disponible. En este caso la reducción es exacta para la salida total y las fuerzas admitidas. Las compliancias individuales quedan fuera de lo que el modelo reducido pretende describir.
Una predicción precisa y una intervención pendiente
La incertidumbre de la suma puede calcularse a pesar de la indeterminación de sus componentes. Como es una combinación lineal de errores normales independientes,
Su error estándar es y, con la varianza conocida, un intervalo normal de confianza del 95 % es , aproximadamente de a . Ese intervalo cuantifica la incertidumbre de una combinación identificable y se calcula sin invertir la matriz singular de los dos parámetros originales.
A una fuerza de tres newtons, la elongación media estimada es milímetros, con varianza y error estándar milímetros. El intervalo para la media es, por tanto, aproximadamente . Una nueva lectura tendrá además su propio error de medida. Para predecirla se suma a la varianza anterior y se obtiene un intervalo de milímetros.
Las dos amplitudes corresponden a objetos diferentes. Promediar muchas lecturas a tres newtons aproximaría la media del desplazamiento, en torno a la cual cada lectura individual seguiría fluctuando. La variabilidad del siguiente registro es ajena a la calidad visual del ajuste, de ahí que la distinción se mantenga aunque los datos se ajusten casi perfectamente.
Consideremos ahora la operación física de retirar el segundo resorte y cargar únicamente el primero con tres newtons, cuya elongación esperada sería . Los cuatro pares de parámetros propuestos antes predicen milímetros, respectivamente. Los mismos pares que describían de manera idéntica las observaciones originales discrepan en cuanto la pregunta pasa de la respuesta del conjunto a la de una pieza.
En la familia exacta de máximos, puede tomar cualquier valor entre cero y milímetros. Esos extremos proceden de la positividad y de mantener fija la suma ajustada, por lo que delimitan una equivalencia del modelo. Asignarles un porcentaje de confianza, como si formaran un intervalo del 95 %, exigiría construir antes el procedimiento probabilístico correspondiente. Si además se incorpora la incertidumbre sobre , la región admisible cambia.
La medición total sí autoriza una predicción útil sobre el montaje intacto y una decisión sobre si su compliancia global queda cerca de un valor de interés. La pregunta sobre qué pieza debe reemplazarse sigue abierta porque depende del reparto interno, una limitación que puede advertirse durante la planificación cuando la intervención se define antes de elegir las mediciones.
Revisar el cero antes de interpretar la pendiente
Hasta aquí se ha supuesto conocido el cero del instrumento. Para evaluar qué cambiaría si existiera un desplazamiento constante desconocido , puede usarse el modelo ampliado , en el que se expresa en milímetros y la recta ya puede desplazarse verticalmente. Con las cuatro lecturas originales, el ajuste ordinario da y .
Las predicciones pasan a ser y la suma de cuadrados baja de a . Dividida por , la reducción vale , una mejora pequeña en relación con la varianza estipulada. Con un parámetro adicional la suma de cuadrados no podía aumentar, así que la decisión sobre qué versión describe el procedimiento de medida ha de apoyarse en el tamaño de esa mejora y en el conocimiento del instrumento.
La libertad añadida también reduce la precisión. Las fuerzas tienen media y suma de desviaciones cuadráticas igual a . Con varianza conocida, el error estándar de la pendiente es ahora , frente a cuando el cero se trataba como conocido. El error estándar del intercepto es milímetros. Con tan pocas fuerzas, el desplazamiento de la recta y el cambio de su pendiente se compensan en grado apreciable.
Una lectura sin carga es útil para el intercepto, ya que cuando la media observada es . Las compliancias individuales, sin embargo, siguen apareciendo a través de en todas las demás lecturas. Corregir la calibración del cero atiende a una incertidumbre instrumental, distinta de la indeterminación entre componentes, que permanece y exige otra decisión experimental.
Para continuar con el sensor parcial mantenemos el supuesto inicial de cero conocido, de manera que sus resultados puedan compararse con el ajuste de . Si el montaje real requiriera estimar offsets para ambas señales, habría que incluirlos y obtener observaciones adecuadas para separarlos de las pendientes. Una medición parcial a varias fuerzas que incluya controles sin carga serviría para estudiar esa ampliación antes de atribuir una discrepancia a las propiedades de un resorte.
Medir la unión entre las piezas
Se añade un sensor que mide la elongación del primer resorte respecto del soporte fijo, es decir, el desplazamiento de la unión intermedia. Para esa nueva variable, , el modelo es
En el cálculo principal los nuevos errores son normales, independientes entre sí y de los errores de , con la misma varianza conocida . Las lecturas parciales construidas a las cuatro fuerzas son milímetros y complementan las cuatro lecturas totales originales.
Del ajuste de se obtiene
Las unidades siguen siendo milímetros por newton. La compliancia del segundo resorte es la diferencia entre la del conjunto y la del primero. Por inversión, los valores puntuales de las rigideces son y .
En las coordenadas las dos series dan estimaciones independientes, cada una con varianza . Al volver a las compliancias individuales, la matriz de covarianza es
La correlación negativa tiene una interpretación directa. Un error positivo al estimar se resta al calcular . Si la estimación de la suma no cambia, el segundo componente se desplaza entonces en sentido contrario. El error estándar de es y el de es mayor, , al reunir la incertidumbre de dos estimaciones.
Calculados con los estimadores lineales y la varianza conocida, los intervalos marginales normales del 95 % son aproximadamente para y para . Con estas observaciones, las estimaciones y ambos intervalos quedan dentro del dominio físico positivo. Como la cobertura de cada intervalo es marginal, una región conjunta con la misma cobertura requiere una construcción propia.
Ahora la matriz de información de las dos compliancias es
La matriz es invertible. La sensibilidad de una lectura total es proporcional a y la de una lectura parcial a , con lo cual un cambio que preserve la suma ya no puede ocultarse al sensor intermedio. La identificación global se comprueba también directamente, pues dos pares que produjeran las mismas medias total y parcial a una fuerza distinta de cero tendrían necesariamente el mismo y el mismo .
Raue et al. (2011) desarrollaron estrategias de experimentación guiadas por la identificabilidad de modelos. En nuestro montaje el criterio se expresa sin una búsqueda compleja, como la elección de una observación cuyas predicciones difieran a lo largo de la familia antes indistinguible. La elongación parcial cumple esa condición, que ninguna medida total satisface, por mucha resolución que tenga.
Al reutilizar los resultados conviene conservar también la covarianza. La varianza de la suma reconstruida es , igual a la que ya teníamos. Si se descartara la covarianza negativa se obtendría y se exageraría la incertidumbre de la suma. El nuevo sensor ha resuelto el reparto interno sin añadir información sobre la suma, que en el modelo de errores independientes puede variar libremente respecto de .
Cuando las lecturas comparten la referencia
La independencia anterior depende de cómo se obtengan los desplazamientos. Consideremos una variante instrumental en la que cada pareja de lecturas total y parcial utiliza la misma referencia móvil, expuesta a un pequeño error que afecta a ambas. Supongamos que cada lectura conserva varianza pero que la covarianza dentro de cada pareja es , equivalente a una correlación . Las parejas correspondientes a fuerzas distintas siguen siendo independientes.
Esa estructura aparece, por ejemplo, si a las dos lecturas se suma un error común de varianza más un error propio de varianza para cada sensor. Al restar el error común desaparece, por lo que la correlación positiva puede beneficiar la estimación de la elongación del segundo resorte, que se calcula precisamente mediante esa diferencia.
Con los mismos valores observados y el mismo patrón de fuerzas, las estimaciones puntuales de las dos pendientes no cambian, aunque la covarianza de pasa a ser
De ahí se obtiene
Para , ambas compliancias tienen varianza y su covarianza es . La matriz de información correspondiente tiene entonces diagonal y elementos fuera de la diagonal . La correlación ha de conservarse tanto al ajustar como al calcular incertidumbres.
Este modelo de errores difiere del utilizado en los intervalos anteriores. Elegir entre ambos exige conocer la adquisición y calibración de las señales, puesto que dos dispositivos distintos pueden compartir referencia, fuente de alimentación o procedimiento de corrección. En esta variante conocemos la causa común y podemos escribir su contribución a cada lectura.
Elegir cuatro lecturas adicionales
Con el nuevo sensor pueden compararse diseños antes de medir. Volvamos al supuesto de errores independientes con y a las cuatro lecturas totales iniciales. Supongamos un presupuesto de cuatro lecturas adicionales de igual coste, cada una total o parcial, a cualquier fuerza entre cero y cuatro newtons, intervalo en el que se da por válida la ley lineal.
En las coordenadas , una lectura total solo contiene información sobre y una parcial solo sobre , en ambos casos por un valor de . Como esa cantidad crece con el cuadrado de la fuerza y la varianza es constante, cada lectura rinde más a la fuerza máxima de cuatro newtons, donde su información llega a .
Sea el número de nuevas lecturas totales. Las restantes son parciales y la información acumulada es sobre y sobre . Para maximizar el determinante de la información conjunta se comparan cinco asignaciones posibles.
| Nuevas totales | Nuevas parciales | Determinante | ||
|---|---|---|---|---|
| 0 | 4 | 750 | 1600 | 1 200 000 |
| 1 | 3 | 1150 | 1200 | 1 380 000 |
| 2 | 2 | 1550 | 800 | 1 240 000 |
| 3 | 1 | 1950 | 400 | 780 000 |
| 4 | 0 | 2350 | 0 | 0 |
La mejor asignación es una lectura total y tres parciales, todas a cuatro newtons. Como la transformación entre y tiene determinante de magnitud uno, esa misma asignación maximiza el determinante en ambas coordenadas. Cuatro lecturas totales, en el otro extremo, aumentarían mucho la precisión de la suma a costa de dejar el segundo parámetro sin información.
La asignación y su coste se interpretan en función del objetivo elegido, que aquí es conjunto. Si solo interesara , las cuatro lecturas parciales darían más precisión para ese parámetro, mientras que si interesara únicamente la compliancia total correspondería medir el desplazamiento total.
La diferencia puede expresarse en varianzas. Con una lectura total y tres parciales adicionales, la varianza de sería y la de , . Con las cuatro lecturas parciales, la primera bajaría a y la segunda subiría a . Son valores de diseño, que describen la precisión esperada antes de conocer las futuras lecturas.
La lectura total adicional es útil para el segundo componente porque su estimación combina la pendiente total con la parcial. Una observación que no mide directamente puede mejorar su precisión al reducir la incertidumbre de uno de los términos de la resta. Esa dependencia explica que el máximo de información conjunta se alcance reservando una de las cuatro lecturas para el desplazamiento total.
El cálculo sirve también para revisar la petición habitual de dar más decimales en el resultado. Con el diseño elegido, el error estándar previsto de es aproximadamente , de modo que mostrar seis decimales en su estimación equivaldría a anunciar diferencias de una millonésima, muy por debajo de esa incertidumbre. Lo que puede cambiar la decisión experimental es esa incertidumbre, junto con la magnitud de la diferencia entre componentes que interesa distinguir.
Según el criterio del determinante y bajo estos supuestos, las cuatro lecturas parciales realizadas antes, repartidas entre uno y cuatro newtons, son un diseño subóptimo. Su dispersión en fuerza sirve para examinar la proporcionalidad de la respuesta parcial. Concentrar todas las mediciones en cuatro newtons mejora la precisión dentro del modelo fijado a cambio de informar menos sobre posibles curvaturas a cargas intermedias. Ambas decisiones pueden compararse porque se ha explicitado qué modelo se considera válido y qué función de la incertidumbre se optimiza.
Para el problema ya medido, la pregunta pendiente sobre retirar el segundo resorte tiene ahora una respuesta cuantitativa. A tres newtons, la elongación media del primero se estima en milímetros, con un intervalo del 95 % de aproximadamente bajo el modelo principal de errores independientes. Una nueva lectura con el mismo error instrumental tiene intervalo de predicción . La estimación procede del desplazamiento de la unión intermedia, la observación que faltaba en el registro original.
Referencias
Bellman, R., & Åström, K. J. (1970). On structural identifiability. Mathematical Biosciences, 7(3–4), 329–339. https://doi.org/10.1016/0025-5564(70)90132-X
Daly, A. C., Gavaghan, D. J., Cooper, J., & Tavener, S. (2018). Inference-based assessment of parameter identifiability in nonlinear biological models. Journal of the Royal Society Interface, 15(144), 20180318. https://doi.org/10.1098/rsif.2018.0318
Gutenkunst, R. N., Waterfall, J. J., Casey, F. P., Brown, K. S., Myers, C. R., & Sethna, J. P. (2007). Universally sloppy parameter sensitivities in systems biology models. PLoS Computational Biology, 3(10), e189. https://doi.org/10.1371/journal.pcbi.0030189
Maiwald, T., Hass, H., Steiert, B., Vanlier, J., Engesser, R., Raue, A., Kipkeew, F., Bock, H. H., Kaschek, D., Kreutz, C., & Timmer, J. (2016). Driving the model to its limit: Profile likelihood based model reduction. PLoS ONE, 11(9), e0162366. https://doi.org/10.1371/journal.pone.0162366
Raue, A., Kreutz, C., Maiwald, T., Bachmann, J., Schilling, M., Klingmüller, U., & Timmer, J. (2009). Structural and practical identifiability analysis of partially observed dynamical models by exploiting the profile likelihood. Bioinformatics, 25(15), 1923–1929. https://doi.org/10.1093/bioinformatics/btp358
Raue, A., Kreutz, C., Maiwald, T., Klingmüller, U., & Timmer, J. (2011). Addressing parameter identifiability by model-based experimentation. IET Systems Biology, 5(2), 120–130. https://doi.org/10.1049/iet-syb.2010.0061