Una distancia entre dos trayectorias puede crecer por motivos diferentes. Puede ocurrir que sus estados iniciales se separen bajo una dinámica determinista inestable, o que ambas reciban perturbaciones distintas después de haber pasado cerca una de otra. Incluso el acto de buscar dos observaciones casi iguales puede seleccionar una coincidencia de errores de medición que desaparece en la lectura siguiente. En los tres casos veremos aumentar alguna distancia. El crecimiento, sin embargo, no estima necesariamente la misma propiedad.
Los exponentes de Lyapunov describen las tasas con que se expanden o contraen perturbaciones infinitesimales bajo una dinámica especificada. Estimarlos a partir de observaciones exige aproximar estados, localizar vecinos y seguir su evolución, de manera que la pendiente obtenida depende de una cadena de decisiones que no aparece en la definición matemática. Una estimación defendible necesita un intervalo en el que esas aproximaciones reflejen la expansión que se desea medir.
Una tasa de crecimiento multiplicativo
Consideremos primero un sistema discreto conocido, . Una perturbación suficientemente pequeña evoluciona aproximadamente según la derivada de la aplicación. En varias dimensiones esa derivada es una matriz que cambia a lo largo de la trayectoria y, después de varios pasos, la perturbación ha atravesado el producto ordenado de todas ellas.
Para una dirección inicial , una tasa asintótica se expresa como
cuando existe el límite. Aquí es la derivada de la aplicación iterada y no la potencia de una única matriz evaluada siempre en el punto inicial. Utilizamos logaritmos naturales y medimos el tiempo en iteraciones. Las condiciones bajo las cuales estas tasas se organizan en un espectro pertenecen a la teoría ergódica de los sistemas diferenciables, revisada en detalle por Eckmann y Ruelle (1985).
El crecimiento es multiplicativo, por lo que se promedian logaritmos de factores. Si una perturbación se multiplica por cuatro y después por un cuarto, vuelve a su magnitud inicial y la tasa media sobre esos dos pasos es cero. Tomar la media aritmética de los factores y luego su logaritmo daría aproximadamente , una cifra que no describe el producto realizado.
La tasa puede fluctuar durante un registro finito, ya que una zona del espacio de estados puede expandir perturbaciones mientras otra las contrae. El exponente asintótico integra esa historia según la trayectoria y, cuando corresponde, según su medida invariante. Una pendiente positiva observada durante un episodio breve puede reflejar una expansión transitoria sin describir la tasa de largo plazo.
Hay además un orden de límites implícito. La definición sigue perturbaciones infinitesimales a través de la dinámica linealizada, pero dos trayectorias reales separadas por una distancia finita no pueden alejarse exponencialmente para siempre dentro de una región acotada. Al alcanzar escalas comparables con esa región, la aproximación local deja de ser apropiada. Por eso el aplanamiento tardío de una curva de distancias no contradice la existencia de un exponente positivo.
En sistemas con varios exponentes, una dirección genérica suele adquirir alguna componente en la dirección de expansión dominante y, bajo las condiciones pertinentes, ese crecimiento termina predominando. Una dirección restringida a un subespacio estable puede comportarse de otra manera. El procedimiento que sigue distancias ordinarias entre vecinos busca principalmente el exponente máximo y no recupera automáticamente todas las direcciones del espectro.
Del registro escalar a pares que puedan seguirse
Si solo observamos una variable, los vecinos se buscan en un espacio reconstruido, en el que cada instante se representa mediante un vector de valores retrasados
donde es el número de coordenadas y el retardo expresado en muestras. La reconstrucción debe distinguir los estados relevantes para predecir su evolución. Una dimensión insuficiente puede superponer estados alejados; una observación que pierde una variable necesaria puede impedir la reconstrucción aun cuando añadamos coordenadas.
Para estimar divergencia necesitamos algo más específico que una nube geométrica razonable, ya que cada vecino inicial debe disponer de un tramo futuro observable. Si seguimos los pares durante veinte pasos, los dos miembros de cada par necesitan al menos veinte observaciones posteriores. Mantener el mismo conjunto de pares a lo largo de todo el intervalo evita que la curva cambie también porque van desapareciendo los pares próximos al final del archivo.
Seleccionamos un vecino de cada referencia y seguimos la distancia . El vecino se elige una vez, al inicio. Buscar un nuevo vecino en cada horizonte mediría otra cantidad, que es la proximidad al conjunto de puntos disponibles tras cada desplazamiento y no la separación del par seleccionado.
La proximidad temporal requiere una exclusión propia. En una trayectoria muestreada con mucha frecuencia, los puntos de instantes consecutivos estarán cerca simplemente porque el movimiento es continuo. Su relación puede seguir la dirección tangente al recorrido sin reflejar el crecimiento transversal que interesa, por lo que se excluyen los candidatos cuyos índices caen dentro de una ventana temporal alrededor de la referencia.
La condición , con fijado en muestras, separa esta exclusión del radio espacial que define la vecindad. Un punto puede estar muy lejos en el calendario y muy cerca en el espacio reconstruido; son precisamente esas revisitas las que hacen posible comparar evoluciones que comenzaron en estados parecidos. La ventana adecuada depende del número de coordenadas, pero también del muestreo y de los tiempos de dependencia.
Rosenstein, Collins y De Luca (1993) usan en su implementación una exclusión relacionada con el período medio de la serie. Hegger, Kantz y Schreiber (1999) discuten cómo examinar la separación entre puntos según su distancia temporal. Ambas propuestas son criterios de trabajo y ninguna da una ventana universal que pueda copiarse entre registros con escalas temporales distintas.
Una exclusión demasiado estrecha deja vecinos redundantes, mientras que una ventana excesiva puede eliminar gran parte de las revisitas disponibles y obligar a usar vecinos más lejanos. Junto con el valor escogido, resulta informativo observar cuánto cambia la distribución de distancias iniciales al modificarlo. Una pendiente estable que solo se obtiene con pares espacialmente grandes ya no guarda la misma relación con una perturbación infinitesimal.
Las distancias exactamente nulas, que pueden aparecer por redondeo, por cuantización o por repetición de estados, necesitan un tratamiento explícito porque su logaritmo no está definido. Añadir una constante arbitraria a todas las distancias modifica sobre todo el tramo de crecimiento más pequeño. Es preferible fijar una resolución mínima compatible con el instrumento, describir qué pares quedan fuera y comprobar cómo afecta esa decisión al conjunto seguido.
Promediar antes o después del logaritmo
El método de Rosenstein y colaboradores (1993) sigue un vecino próximo por referencia y promedia los logaritmos de sus distancias. En una notación que mantiene la unidad temporal fuera del promedio,
Si durante un intervalo las separaciones se comportan aproximadamente como , la curva es aproximadamente lineal y su pendiente es . Las diferencias entre distancias iniciales contribuyen al intercepto. Expresar cada distancia respecto de una unidad fija hace explícito que el argumento del logaritmo es adimensional sin cambiar esa pendiente.
Restar equivale a promediar los logaritmos de los cocientes , siempre que se mantengan los mismos pares y pesos. La resta desplaza verticalmente la curva, pero no corrige automáticamente un sesgo debido a vecinos falsos, a ruido o a escalas iniciales demasiado grandes.
La selección de referencias determina también qué regiones pesan en el promedio finito. Si tomamos una referencia por instante de una serie muestreada regularmente, las zonas donde el sistema permanece más tiempo aportan más términos. Elegir el mismo número de referencias por celda espacial cambiaría esa ponderación y podría ayudar a estudiar regiones poco visitadas, aunque la curva resultante ya no correspondería exactamente al mismo promedio sobre el registro. En un sistema con expansiones locales desiguales conviene conservar esta distinción, porque equilibrar una nube para visualizar su geometría y promediar la expansión observada a lo largo del tiempo son operaciones con objetivos diferentes.
Kantz (1994) propone seguir conjuntos de vecinos iniciales dentro de una escala espacial. En la formulación que describen Hegger y colaboradores (1999), primero se promedian las separaciones de los vecinos de una referencia, después se toma el logaritmo y finalmente se promedian los resultados entre referencias. Ese orden permite estudiar explícitamente varias escalas de vecindad.
Promediar logaritmos y tomar el logaritmo de un promedio no son operaciones intercambiables. La primera se relaciona con una media geométrica de distancias, mientras la segunda concede más peso a las distancias grandes del conjunto promediado. Con un solo vecino por referencia las operaciones internas coinciden, pero con varios pueden producir curvas diferentes, así que es necesario saber qué estadística implementa el programa que se utilice.
El algoritmo de Wolf y colaboradores (1985) sigue otra estrategia, que consiste en acompañar una trayectoria de referencia y sustituir el vecino cuando la separación deja de ser adecuada, procurando conservar la orientación de la perturbación. Acumula los crecimientos de los segmentos y los relaciona con el tiempo total transcurrido. La elección de los reemplazos introduce decisiones distintas de las que exige el promedio de pares iniciales.
La diversidad de métodos no implica que cualquier promedio de distancias estime la misma cantidad en cualquier muestra; todos intentan aproximar el crecimiento local dominante, aunque difieren en sus escalas, sus pesos y sus transitorios. Compararlos sobre un sistema conocido permite localizar qué parte de una diferencia procede del algoritmo y qué parte de las observaciones.
Tampoco basta con que una recta tenga un ajuste visual excelente, porque una curva suave y curvada puede parecer lineal dentro de un intervalo muy corto. La evidencia más informativa es un tramo de crecimiento que siga siendo reconocible cuando se cambian moderadamente la escala espacial, la reconstrucción y los límites del ajuste. En esa comparación, las distancias deben conservar su significado físico.
Un ejemplo con una tasa conocida
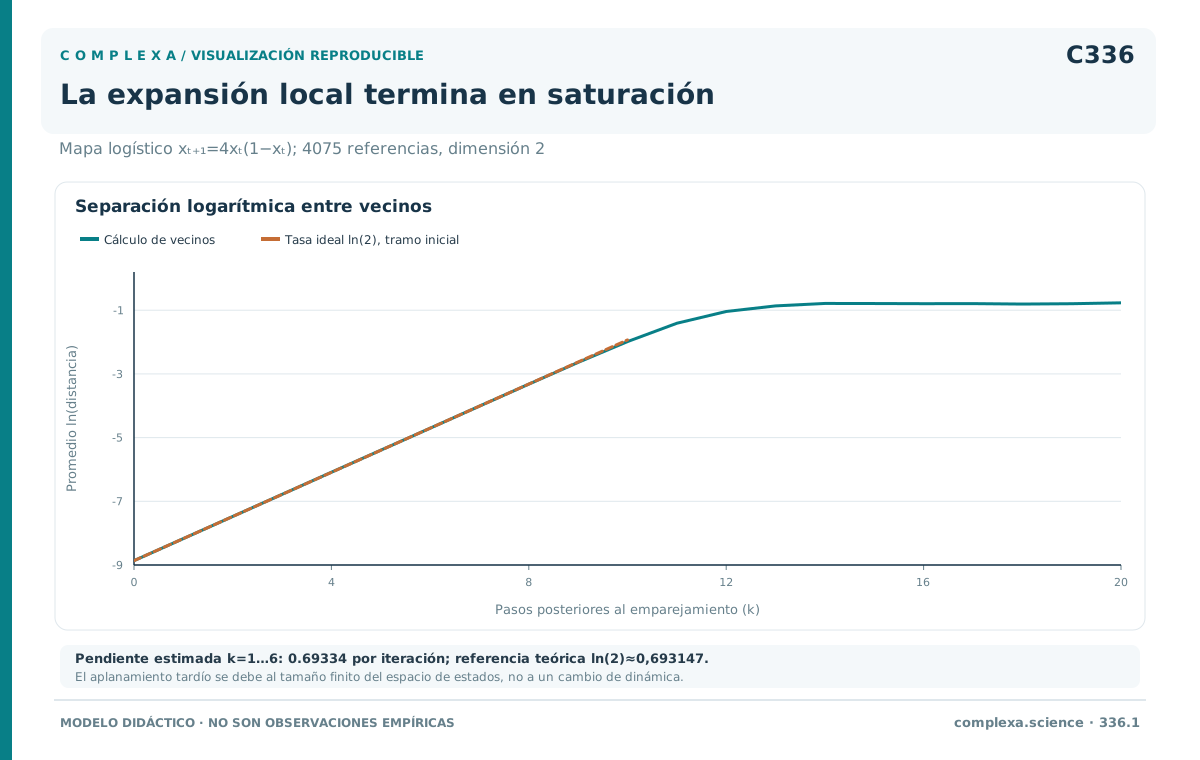
Utilicemos el mapa logístico , que es una construcción matemática para comprobar el estimador y no una serie empírica. Para trayectorias típicas respecto de su medida invariante natural, el exponente es , aproximadamente por iteración, aunque esta afirmación no asigna el mismo exponente a cada órbita excepcional del mapa.
Ese valor puede obtenerse si se conoce cómo se distribuyen los estados en el régimen invariante. La transformación , con uniforme entre cero y uno, produce la densidad . La identidad del ángulo doble relaciona el mapa logístico con la duplicación de módulo uno. Así se obtiene una distribución invariante, aunque la transformación no sea una correspondencia uno a uno entre todos los ángulos y los estados.
El promedio del logaritmo de la derivada bajo esa distribución es la integral de entre cero y uno. El término constante aporta y el promedio de aporta , de modo que su suma da la tasa citada. El cálculo muestra qué distribución pondera las expansiones y contracciones locales. Promediar uniformemente sobre los valores de respondería a otra ponderación, porque la trayectoria no visita con igual frecuencia todos los intervalos del mismo tamaño.
El estado exactamente igual a cero es una excepción sencilla. Permanece allí y su derivada local vale cuatro en cada paso, así que su exponente es . La existencia de esa órbita no contradice el resultado típico, pero muestra por qué la afirmación incluye la especificación de la trayectoria o de la medida.
Como conocemos la ecuación, disponemos de otra referencia, que es el promedio de a lo largo de la trayectoria. En el cálculo reproducible comenzamos en , descartamos quinientas iteraciones y conservamos cuatro mil noventa y seis valores. Ese promedio finito de derivadas vale aproximadamente y nos da una forma independiente de comprobar la estimación que se basa en vecinos.
Construimos vectores de dos coordenadas con retardo uno, usamos la distancia euclídea y excluimos los candidatos separados por veinte muestras o menos. Cada referencia se empareja con el vecino admisible más próximo y ambos se siguen durante veinte pasos. Al reservar el pasado necesario para reconstruir y el futuro necesario para seguirlos, quedan cuatro mil setenta y cinco referencias.
En este registro no aparecen distancias nulas entre los pares utilizados y la distancia inicial media es aproximadamente , pequeña frente a la escala del mapa. Esa media no es la exponencial del promedio de logaritmos, porque las distancias iniciales son desiguales. Mantener separadas ambas cantidades evita confundir el centro aritmético de las distancias con la curva que realmente se ajusta. La tabla siguiente recoge algunos valores de esa curva, en los que se ve cómo el crecimiento se desarrolla y luego se agota.
| Pasos posteriores | Promedio del logaritmo de distancia |
|---|---|
| 0 | −8,864 |
| 2 | −7,476 |
| 4 | −6,087 |
| 6 | −4,704 |
| 10 | −1,985 |
| 14 | −0,788 |
| 20 | −0,768 |
Una recta ajustada entre los pasos uno y seis da por iteración y otra entre los pasos dos y siete da . Ambos resultados se aproximan al valor conocido y corresponden al tramo de crecimiento previo a la saturación. El acuerdo es una propiedad de este ensayo, hecho con un sistema simple, con observaciones sin error añadido y con vecinos suficientemente próximos.
Si aplicamos la misma operación entre los pasos doce y veinte, la pendiente baja a aproximadamente . El sistema no ha cambiado de régimen. Los pares ya han alcanzado distancias que reflejan la extensión del conjunto visitado. Ajustar una tasa exponencial a esa parte de la curva cambia el objeto estimado.
Al aumentar la reconstrucción a tres y cuatro coordenadas, manteniendo retardo, exclusión y ventana de ajuste, las pendientes entre uno y seis son aproximadamente y . Las distancias iniciales medias aumentan y la saturación aparece antes. La estabilidad del primer tramo es útil; la variación tardía muestra, en cambio, por qué añadir dimensiones no mejora indefinidamente un registro de longitud fija.
En este mapa, la variable escalar ya contiene el estado que determina el siguiente valor. La comparación entre dimensiones es una prueba del comportamiento del algoritmo y no una demostración general de ningún teorema de reconstrucción. Un sistema con estados ocultos diferentes puede requerir otra observación y otras coordenadas.
El cálculo numérico también tiene un horizonte de fidelidad. Las iteraciones se hicieron con precisión finita, por lo que una trayectoria digital no es literalmente una órbita matemática infinitamente larga. En este ensayo, el estimador se contrastó con el promedio de derivadas del mismo registro y con el valor analítico. Alargar arbitrariamente el archivo no elimina los efectos de la representación numérica.
Con la ecuación conocida podemos examinar además qué significa usar una separación finita. Para dos estados escalares separados por , la diferencia exacta después de un paso es
La aproximación tangente conserva el primer término y su error depende tanto de la separación como del lugar visitado. Con y , la parte lineal predice una diferencia de , frente al valor exacto de . El término omitido equivale aproximadamente al de la predicción lineal.
Con la misma separación inicial, pero partiendo de , la predicción lineal es y el resultado exacto es . El error relativo llega a la mitad. Cerca del máximo de la parábola, donde la derivada tiende a cero, una separación pequeña en términos absolutos puede ser grande para la aproximación tangente de ese punto.
Si partimos de y aumentamos la separación a , los dos estados quedan en posiciones simétricas respecto del máximo y sus imágenes escalares coinciden. El pliegue ha llevado a cero una distancia que era positiva, sin que eso describa una contracción exponencial sostenida. El ejemplo ayuda a interpretar las fluctuaciones de cada par antes de promediarlas. La escala espacial admisible depende de la geometría local. Un radio elegido como fracción fija del rango total no controla por igual toda la trayectoria.
Escala de medida y reloj
Multiplicar toda la serie por una constante positiva multiplica las distancias euclídeas por esa misma constante, siempre que todas las coordenadas se transformen igual. Sus logaritmos reciben entonces una constante aditiva. En el ejemplo, multiplicar los valores por mil desplaza la curva en y deja la pendiente del tramo uno a seis en , dentro del redondeo numérico.
Una transformación suave e invertible más general puede conservar los exponentes asintóticos cuando sus derivadas y las de su inversa están adecuadamente acotadas en el conjunto considerado. Las distancias se deforman por factores limitados, cuya contribución desaparece al dividir sus logaritmos por tiempos crecientes. Esta propiedad no afirma que todas las estimaciones finitas obtenidas con vecinos coincidan.
Una deformación de coordenadas cambia qué puntos resultan más próximos y qué escala espacial corresponde a una vecindad, por lo que en registros finitos puede modificar los pares, sus orientaciones y el intervalo útil. En un análisis multivariante, estandarizar cada componente por separado cambia la métrica. Esa transformación puede estar justificada por las unidades o por la precisión del instrumento, pero debe declararse y examinarse.
La escala temporal tiene un efecto directo incluso sobre el valor teórico. Si cada paso del ejemplo se interpreta convencionalmente como dos décimas de segundo, la tasa de por paso equivale a unos por segundo. El tiempo en que una perturbación crece por un factor es entonces de segundos y el tiempo de duplicación, de segundos.
Observar cada dos iteraciones equivale a estudiar la aplicación compuesta de dos pasos. Su exponente teórico por observación es , aproximadamente . Como cada observación abarca ahora cuatro décimas de segundo, la tasa por segundo no cambia. Un estimador aplicado al registro reducido puede variar, en cambio, porque dispone de menos puntos y de un tramo de crecimiento peor resuelto.
El logaritmo elegido también importa. La duplicación por paso tiene tasa uno en base dos y tasa con logaritmos naturales. Wolf y colaboradores (1985) usan base dos en su definición, así que una comparación numérica con fórmulas que emplean logaritmos naturales necesita esa conversión. Antes de comparar una pendiente hay que identificar su base logarítmica y su unidad temporal.
En un flujo continuo, el intervalo entre observaciones debe relacionarse con los tiempos de evolución. Un muestreo muy denso aporta muchos puntos cercanos sobre el mismo recorrido sin añadir necesariamente más revisitas independientes, mientras que uno demasiado espaciado puede dejar pocos puntos entre la escala inicial y la saturación. La duración física observada y la frecuencia de muestreo cumplen funciones diferentes.
Con intervalos irregulares, avanzar el mismo número de filas desde dos referencias puede corresponder a duraciones distintas, con lo que la distancia obtenida deja de comparar evoluciones bajo un mismo horizonte temporal. Dividir al final por el intervalo promedio no corrige automáticamente ese problema. Haría falta definir comparaciones a tiempos equivalentes o un modelo continuo de la evolución y de la observación.
Qué hace el error de medición a los vecinos
Añadamos ahora errores gaussianos independientes a la trayectoria logística sin modificar su dinámica subyacente y volvamos a seleccionar el vecino con los valores observados, que ya contienen el error. La perturbación afecta tanto a las distancias que se siguen como a la decisión de qué estados se consideran próximos.
Tomemos dos estados fijados con independencia del error, con errores independientes de varianza en cada coordenada. La esperanza de la distancia cuadrática observada es entonces la distancia cuadrática real más . Con dos coordenadas y una desviación típica de error de , la parte debida únicamente al error tiene una raíz cuadrática media de .
Esa cuenta no puede aplicarse sin cambios después de condicionar a que dos observaciones fueron elegidas por ser las más cercanas. La selección favorece coincidencias de errores. Dos estados reales diferentes pueden parecer próximos porque sus errores se compensan. En el futuro, los nuevos errores ya no se compensan y la separación observada salta, aunque ese salto no refleje la expansión de ninguna perturbación del estado.
Si mantenemos la reconstrucción de dos coordenadas y todos los demás parámetros y añadimos un error de desviación típica , la pendiente entre los pasos uno y seis es aproximadamente . Con desviación típica baja a . Si en cambio incluimos el instante inicial y ajustamos entre cero y cinco, obtenemos y respectivamente.
La misma contaminación puede, por tanto, elevar o reducir la cifra según el intervalo elegido. Para el ruido mayor, el tramo dos a siete da aproximadamente y el tramo tres a ocho, aproximadamente . Que la pendiente deje de ser estable entre intervalos cercanos describe el problema mejor que cualquier estimación positiva aislada.
Rosenstein y colaboradores (1993) estudian ejemplos con ruido aditivo y muestran cómo se acorta el intervalo útil de crecimiento, aunque sus resultados de robustez corresponden a los sistemas y condiciones que examinaron. Hegger y colaboradores (1999) insisten en buscar una región de crecimiento consistente a través de escalas y dimensiones y muestran casos en los que el registro no permite llegar a ninguna conclusión razonable.
Un radio de vecindad mayor puede reducir el predominio del ruido, pero aleja la comparación del régimen infinitesimal. El análisis necesita una zona espacial intermedia, situada por encima de la resolución efectiva y bastante por debajo de la escala en la que la dinámica se curva o se pliega. Hay registros en los que esas escalas no están suficientemente separadas.
Filtrar no es una corrección neutra. Un filtro combina tiempos, cambia distancias y puede suavizar diferencias que pertenecen al proceso. Si se usa, hay que estudiar el comportamiento del estimador después de la misma transformación, preferentemente en señales de control con propiedades conocidas. Una curva más lisa no garantiza que su pendiente esté más cerca del exponente del sistema original.
Una separación creciente en un sistema con contracción
La distinción entre ruido de medición y perturbaciones dinámicas puede examinarse con la autorregresión estocástica sencilla
cuyas innovaciones son independientes, de media cero y varianza uno. Si iniciamos dos versiones del sistema en estados próximos y les aplicamos exactamente la misma secuencia de innovaciones, su diferencia se multiplica por en cada paso. La tasa logarítmica correspondiente es , aproximadamente por paso.
Si las dos versiones reciben innovaciones independientes, la diferencia obedece a otra ecuación. Para una separación inicial fija , su segundo momento es
El primer término corresponde a la contracción de la diferencia inicial y el segundo acumula perturbaciones nuevas y distintas. Con una separación inicial de , la raíz del segundo momento salta a aproximadamente en el primer paso y se acerca a a largo plazo.
La expansión que se observa en esa comparación no se debe a que la dinámica amplifique las diferencias iniciales, que de hecho se contraen. Lo que aumenta es la contribución de impulsos nuevos que las dos trayectorias no comparten. Al seguir fragmentos de un registro estocástico que comenzaron en estados parecidos, puede incorporarse precisamente esa fuente de separación.
La cuenta no describe todos los sistemas estocásticos. Tampoco excluye que puedan definirse exponentes de Lyapunov para dinámicas aleatorias bajo un acoplamiento especificado del ruido. Muestra, eso sí, que hace falta indicar qué se mantiene común entre las trayectorias comparadas. Una estimación hecha con vecinos observados no responde automáticamente a la pregunta de qué ocurriría al perturbar un estado manteniendo idénticas sus perturbaciones futuras.
Este es uno de los motivos para recurrir a pruebas con datos sustitutos cuando se busca distinguir una explicación determinista de alternativas estocásticas. Como explican Schreiber y Schmitz (2000), esas pruebas contrastan la hipótesis nula que realmente generan los sustitutos. Rechazar una familia lineal no señala por sí solo el mecanismo responsable de la pendiente.
Precisión de la pendiente y precisión de la inferencia
Una regresión sobre unos cuantos puntos de puede devolver un error estándar muy pequeño. Esos puntos no son mediciones independientes, porque comparten las mismas referencias, los mismos vecinos y largos segmentos de evolución. Tampoco los pares son necesariamente independientes entre sí, ya que dos referencias cercanas pueden seguir casi la misma pareja, desplazada una muestra.
El error de una recta condicionado a esa curva responde a una pregunta más limitada que la incertidumbre del exponente. No incluye automáticamente la selección del intervalo, la reconstrucción, el conjunto de vecinos ni el error del instrumento, por lo que presentarlo como precisión total puede ocultar las fuentes que más afectan al resultado.
Cuando existen registros independientes del mismo régimen, repetir el análisis completo permite observar la variabilidad entre realizaciones. Con un único registro largo pueden compararse tramos separados, cuidando que cada uno conserve duración y revisitas suficientes. Las diferencias entre segmentos pueden deberse a variabilidad de muestreo o a cambios del mecanismo. Interpretarlas exige examinar ambas posibilidades.
Un cambio lento de parámetros plantea un problema específico para la selección de vecinos, porque dos segmentos pueden pasar por casi el mismo vector observado y pertenecer, sin embargo, a dinámicas distintas. Si una propiedad del sistema cambia con la fecha, el futuro de cada miembro del par depende también de esa propiedad. Una distancia inicial pequeña deja entonces de indicar por sí sola que los estados completos están próximos. Al combinar ambos regímenes, parte de la separación posterior se atribuiría erróneamente a la sensibilidad a las condiciones iniciales. Comparar segmentos definidos en el tiempo, o introducir el parámetro cambiante en un modelo, permite formular una pregunta más precisa a costa de disponer de menos revisitas o de estimar más variables.
Reordenar observaciones individuales para obtener réplicas destruiría las trayectorias que el estimador pretende seguir. Un remuestreo por bloques conserva parte de la dependencia, pero introduce uniones y necesita una escala y una justificación propias. Un intervalo nominal no debe producirse simplemente porque se disponga de un procedimiento genérico de remuestreo.
La sensibilidad a los parámetros aporta otra clase de información. Es útil distinguir los cambios pequeños dentro de una región estable de los cambios grandes que alteran los vecinos o eliminan el tramo de crecimiento. Informar todos los resultados de una cuadrícula de parámetros sin explicar cuáles responden a la misma pregunta no sustituye esa evaluación.
También debe conservarse una regla reproducible para elegir el intervalo. En el ensayo logístico conocemos la tasa verdadera y podemos diagnosticar por qué ciertos tramos funcionan. En datos empíricos, elegir el tramo porque coincide con una expectativa previa introduce una preferencia que la cifra final no deja ver. La selección debe apoyarse en la forma de las curvas, en la resolución disponible y en la estabilidad frente a cambios pertinentes.
La ausencia de un intervalo defendible es un resultado posible y no obliga a escoger la pendiente positiva más larga que encuentre un algoritmo. Puede indicar que el registro es demasiado corto, que el error domina las escalas pequeñas o que la representación determinista propuesta no describe adecuadamente las observaciones.
Qué parte del espectro se ha estimado
El promedio de separación de pares apunta al crecimiento dominante. Para obtener varios exponentes hay que representar la evolución de distintas direcciones o elementos de volumen. Como las direcciones tienden a alinearse con la expansión más rápida, seguir varios vecinos arbitrarios y ajustar varias rectas no identifica automáticamente el resto del espectro.
Los métodos basados en aproximaciones locales de la dinámica estiman matrices y propagan perturbaciones con procedimientos de reortogonalización. Wolf y colaboradores (1985) y Hegger y colaboradores (1999) describen estrategias diferentes para esta tarea. Estimar matrices locales exige datos que cubran las direcciones relevantes; los grados de libertad que añade una reconstrucción, además, pueden generar exponentes espurios.
Un máximo próximo a cero también necesita contexto. Una órbita periódica estable de un mapa discreto y un ciclo límite de un flujo autónomo no tienen la misma estructura de exponentes, porque en el flujo existe una dirección tangente asociada al avance temporal. Por otra parte, que no se detecte una pendiente positiva en un registro ruidoso no demuestra que el sistema subyacente carezca de expansión.
Cuando la tasa positiva está bien sustentada, puede relacionarse con un horizonte local de precisión. Si un error inicial crece aproximadamente como hasta una tolerancia , el tiempo correspondiente es . Esa cuenta describe el crecimiento de la incertidumbre inicial dentro del régimen exponencial, sin añadir errores de modelo ni perturbaciones nuevas.
Con la convención temporal del mapa logístico, la tasa es aproximadamente por segundo. Reducir diez veces el error inicial añade , unos segundos, al tiempo necesario para alcanzar la misma tolerancia, siempre que ambos umbrales permanezcan en el tramo local pertinente. Son unas tres iteraciones y un tercio adicionales, de modo que mejorar diez veces la precisión inicial no multiplica por diez ese horizonte.
Referencias
Eckmann, J.-P., & Ruelle, D. (1985). Ergodic theory of chaos and strange attractors. Reviews of Modern Physics, 57(3), 617–656. https://doi.org/10.1103/RevModPhys.57.617
Hegger, R., Kantz, H., & Schreiber, T. (1999). Practical implementation of nonlinear time series methods: The TISEAN package. Chaos, 9(2), 413–435. https://doi.org/10.1063/1.166424
Kantz, H. (1994). A robust method to estimate the maximal Lyapunov exponent of a time series. Physics Letters A, 185(1), 77–87. https://doi.org/10.1016/0375-9601(94)90991-1
Rosenstein, M. T., Collins, J. J., & De Luca, C. J. (1993). A practical method for calculating largest Lyapunov exponents from small data sets. Physica D: Nonlinear Phenomena, 65(1–2), 117–134. https://doi.org/10.1016/0167-2789(93)90009-P
Schreiber, T., & Schmitz, A. (2000). Surrogate time series. Physica D: Nonlinear Phenomena, 142(3–4), 346–382. https://doi.org/10.1016/S0167-2789(00)00043-9
Wolf, A., Swift, J. B., Swinney, H. L., & Vastano, J. A. (1985). Determining Lyapunov exponents from a time series. Physica D: Nonlinear Phenomena, 16(3), 285–317. https://doi.org/10.1016/0167-2789(85)90011-9