La secuencia uno, dos, tres, cuatro, cinco, seis parece ordenada de un modo que una mezcla aleatoria de esos mismos valores difícilmente reproduciría. Esa impresión puede medirse y su probabilidad puede calcularse bajo una hipótesis concreta. Por pequeño que sea el resultado, no distinguirá por sí solo una tendencia determinista de una trayectoria correlacionada ni establecerá que el mecanismo sea no lineal. La respuesta depende de cuáles de esas posibilidades se hayan incluido en la comparación.
Los datos sustitutos son registros artificiales construidos para representar una hipótesis sobre la serie observada; conservan ciertas propiedades y modifican otras. El contraste compara una estadística calculada en el registro original con la misma estadística calculada en esos registros. Theiler y colaboradores (1992) organizaron el procedimiento como una secuencia de decisiones en la que se especifica la hipótesis nula, se generan realizaciones compatibles con ella y se elige una cantidad capaz de detectar las desviaciones relevantes.
La dificultad suele estar en la segunda decisión. Producir una serie que se parezca visualmente a otra es relativamente fácil. Producirla con la distribución que requiere una prueba estadística obliga a justificar qué se conserva, cómo se aleatoriza y por qué el registro observado puede compararse con los generados.
Una prueba enumerable por completo
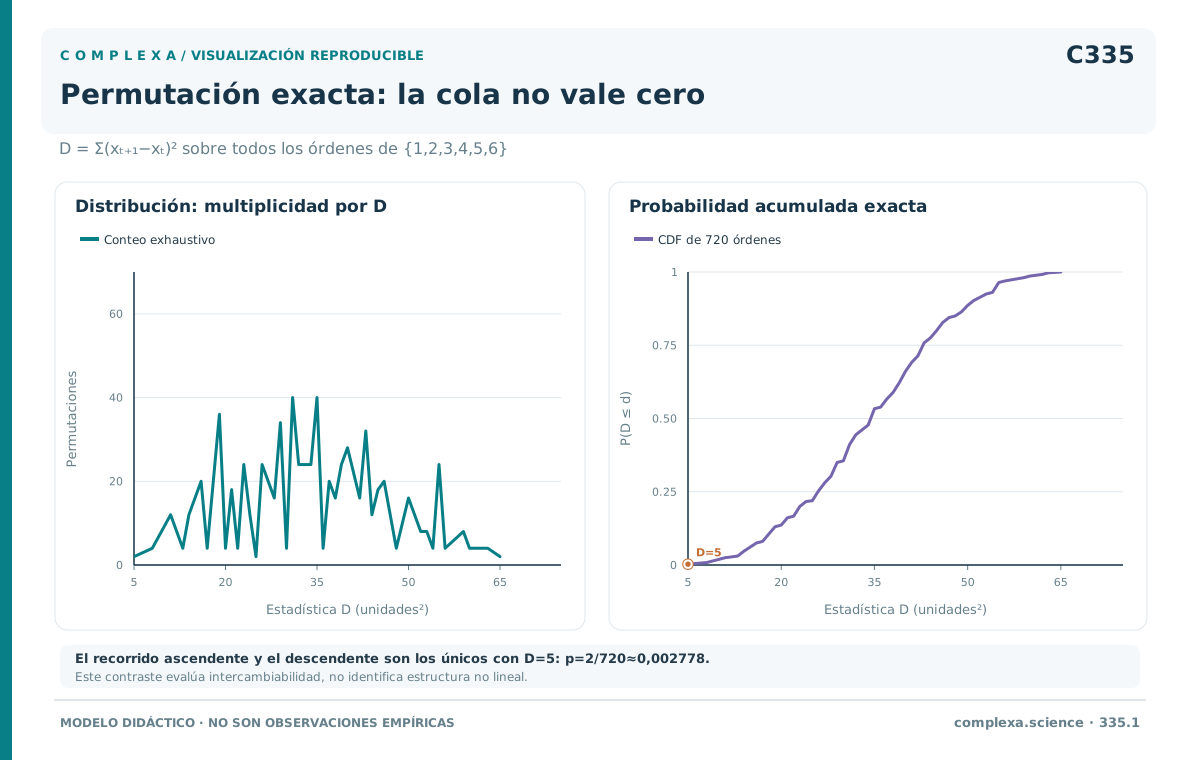
Tomemos los seis valores iniciales como ejemplo didáctico y supongamos, bajo la hipótesis nula, que proceden de observaciones independientes con una misma distribución continua. Dado el conjunto de valores observado, todos sus órdenes son igualmente probables. Esa intercambiabilidad elimina la forma desconocida de la distribución marginal, porque para estudiar el orden basta con considerar las permutaciones de los valores disponibles.
Antes de compararlos elegimos una medida de la variación entre observaciones consecutivas,
Un valor pequeño indica un recorrido suave. En la secuencia ascendente cada diferencia vale uno y vale cinco. Hay setecientas veinte permutaciones de seis valores distintos y solo dos alcanzan ese mínimo, el recorrido ascendente y el descendente. Como cada salto mide al menos uno, para que los cinco cuadrados sumen cinco todos los saltos deben unir enteros contiguos sin repetir ninguno.
La probabilidad de encontrar, bajo esta distribución condicional, una secuencia al menos tan suave como la observada es dos dividido por setecientos veinte, aproximadamente . La enumeración incluye el orden observado y cuenta también el descendente, que empata en la estadística. Contar solo los valores distintos de la estadística daría una distribución incorrecta, porque no todos los valores de aparecen con la misma multiplicidad.
La media de sobre todas las permutaciones es treinta y cinco. Esa distancia respecto del cinco observado ayuda a describir el contraste, aunque la prueba usa la distribución completa y no necesita suponer que la estadística siga una distribución normal ni convertir la diferencia en un número de desviaciones típicas.
Lo que se rechaza es el orden aleatorio de observaciones intercambiables. Un proceso autorregresivo lineal con fuerte persistencia podría producir recorridos suaves y sería rechazado por esta comparación, igual que una tendencia. La estadística elegida ni siquiera pretende aislar una característica específicamente no lineal, ya que mide una dependencia temporal que la permutación completa destruye.
La permutación conserva exactamente el conjunto de amplitudes, su media, su varianza y cualquier resumen que no dependa del orden, mientras destruye la asociación sistemática entre esas amplitudes y sus posiciones temporales. Si el objetivo fuera estudiar una dependencia adicional a la autocorrelación, esta hipótesis nula sería demasiado restrictiva y la autocorrelación tendría que formar parte de lo que se admite bajo ella.
La independencia no es el único camino matemático hacia una prueba de permutación válida, pues existen modelos conjuntos intercambiables que no suponen independencia. En el ejemplo se ha declarado una hipótesis sencilla que garantiza la propiedad necesaria. En una serie temporal general, la intercambiabilidad de las posiciones no se deduce de que todas las observaciones tengan la misma media y la misma varianza.
La hipótesis nula antes de las réplicas
Una hipótesis nula habitual admite que el registro provenga de un proceso lineal, estacionario y gaussiano, cuya dependencia entre tiempos queda descrita por sus covarianzas. Esa hipótesis incluye fluctuaciones correlacionadas, posibles oscilaciones y predicción lineal, de modo que una irregularidad visual no es una discrepancia con ella. Lo que interesa es una estructura que esa descripción probabilística no explique.
Cada palabra restringe la comparación. Una ecuación lineal impulsada por innovaciones no gaussianas pertenece a una familia más amplia, cuyas distribuciones conjuntas pueden contener información que no se reduce a las covarianzas. Con una prueba construida para una nula gaussiana, el rechazo no puede atribuirse automáticamente a una ecuación dinámica no lineal, porque también la distribución de las innovaciones puede haber quedado fuera de la nula.
Otra familia admite una transformación estática de un proceso lineal gaussiano. Escribimos , donde es el proceso subyacente y una función fija, instantánea, monótona e invertible en el dominio considerado. Un instrumento con respuesta exponencial puede producir una distribución muy asimétrica a partir de una dinámica lineal en la variable subyacente.
El adjetivo «estática» indica que la misma función transforma cada valor por separado. Si la observación combina varios tiempos, cambia con el calendario o pierde información mediante una transformación no invertible, la representación deja de ser la nula propuesta. Elevar al cuadrado una variable con valores positivos y negativos, por ejemplo, borra su signo. El orden de las observaciones ya no permite reconstruir el de la variable original.
Schreiber y Schmitz (1996) estudiaron esta ampliación de la nula y mostraron las dificultades para generar sustitutos que la representen bien. Su formulación permite separar una deformación de la escala de medida de ciertos tipos de dependencia dinámica, sin que ello equivalga a admitir cualquier transformación de cualquier proceso lineal.
Conviene precisar también la alternativa que motiva la estadística, porque una dependencia no lineal puede ser enteramente estocástica. Consideremos, como construcción didáctica, innovaciones gaussianas independientes de media cero y varianza uno multiplicadas por una escala que depende del pasado,
La esperanza condicional sigue siendo cero y la varianza condicional vale medio cuando el valor anterior es cero y cuando es dos. Los valores pasados no predicen el signo siguiente, aunque sí informan sobre la magnitud probable de la fluctuación. Si existen los momentos pertinentes, las autocovarianzas en retardos positivos son nulas porque la esperanza condicional lo es.
Una estadística sensible a la dependencia entre magnitudes puede detectar esta estructura, aun cuando el mecanismo recibe en cada paso una innovación aleatoria nueva. Incluso una detección bien calibrada de dependencia no lineal no basta, entonces, para tomar el registro como evidencia de caos determinista. Esa distinción afecta directamente a la conclusión que puede acompañar al valor p.
Fases aleatorias y extremos del registro
La transformada discreta de Fourier expresa una serie igualmente espaciada mediante componentes de frecuencia, cada una con una amplitud y una fase. El procedimiento de fases aleatorias mantiene las amplitudes y sustituye las fases por valores uniformes independientes, respetando las simetrías necesarias para que la transformación inversa produzca una serie real.
La frecuencia cero determina la media y, cuando el número de observaciones es par, la componente de Nyquist también es real. Ambas requieren un tratamiento distinto del que reciben los pares de frecuencias complejas conjugadas. Si se cambia la fase de todas las entradas sin respetar esas condiciones, el resultado puede no ser siquiera una serie real con la media prevista.
El periodograma se conserva exactamente, salvo redondeo numérico. Por la relación de Fourier entre espectro y covarianza también se conserva exactamente la autocovarianza circular. Esta última trata el registro como un círculo, en el que tras la última observación vuelve a aparecer la primera. La autocovarianza ordinaria, calculada solo con los pares disponibles dentro del registro, no tiene por qué coincidir.
Puede verse con otro ejemplo artificial, de ocho observaciones,
Su media es un cuarto, su varianza (con divisor ocho) vale y su autocovarianza circular en el primer retardo, . Una aleatorización de fases produce, redondeada para mostrarla, la secuencia
Con los valores sin redondear se conservan la media, la varianza, el periodograma y la autocovarianza circular indicados. La autocovarianza ordinaria en el primer retardo, en cambio, pasa de aproximadamente a cuando en ambas series se resta la media global y se promedian los siete productos consecutivos disponibles. No hay contradicción, porque el producto que une el último valor con el primero entra en la versión circular y queda fuera de la ordinaria.
Los valores nuevos ya no son una permutación de los originales. Las fases aleatorias pueden modificar la distribución empírica de las amplitudes aunque conserven su media y su varianza. En una serie muy asimétrica, esa diferencia puede afectar a una estadística que en apariencia apunta a la dependencia temporal.
Schreiber y Schmitz (2000) analizaron además el salto artificial que aparece al continuar periódicamente un registro cuyos extremos no encajan. Ese salto aporta componentes espectrales que la aleatorización reparte por toda la serie. Elegir una subsecuencia con extremos compatibles puede reducirlo en ciertos problemas, aunque cambia el registro analizado y debe formar parte del procedimiento declarado.
Conservar exactamente el periodograma no hace de cualquier prueba de fases una prueba exacta para toda serie gaussiana estacionaria finita. Hay una justificación condicional exacta, por ejemplo, para un vector gaussiano con media constante y covarianza circular, en el que las fases de las componentes complejas independientes son uniformes dadas sus amplitudes. Si se fijan también las componentes reales pertinentes, el registro observado y los sustitutos pueden pertenecer al mismo conjunto condicional.
Un segmento finito de un proceso estacionario general no cumple automáticamente esa estructura circular y sus coeficientes de Fourier pueden conservar dependencias de borde. En ese caso, el procedimiento habitual es una aproximación cuya calidad depende del proceso y del registro. Los rangos que se calculen después no eliminan el error introducido al generar las réplicas.
Ajuste de amplitudes y espectro
El algoritmo conocido como AAFT añade un ajuste por rangos para representar la nula de una transformación monótona estática. Primero sustituye los valores observados por valores gaussianos con el mismo orden relativo, de manera que la observación menor recibe el valor gaussiano menor y así sucesivamente, mientras la posición temporal de cada rango se mantiene.
Después aleatoriza las fases de esa serie aproximadamente gaussianizada y, por último, ordena los nuevos valores y los reemplaza, según sus rangos, por los valores originales. Esta última operación garantiza que la salida contenga exactamente el mismo conjunto de amplitudes que el registro, aunque la transformación de vuelta puede alterar el espectro ajustado en la escala intermedia.
El orden de las operaciones explica el problema sin atribuir al algoritmo ninguna propiedad misteriosa. Una transformación no lineal aplicada punto a punto modifica en general las correlaciones, de modo que el espectro conservado antes de esa transformación puede perderse después. En registros finitos, además, las aproximaciones al proceso gaussiano latente y a la función de observación tienen sus propios errores.
Schreiber y Schmitz (1996) propusieron el ajuste iterativo conocido como IAAFT. Se parte, por ejemplo, de una permutación aleatoria de los datos. Una operación sustituye sus amplitudes de Fourier por las del registro original, conservando las fases actuales; la siguiente reordena los valores para recuperar exactamente la distribución empírica original. Ambas se repiten alternadamente.
Si el algoritmo se detiene tras reordenar los valores, la distribución empírica es exacta y el espectro puede conservar un residuo. Si se detiene tras imponer las amplitudes de Fourier, el espectro es exacto y los valores pueden diferir de los originales. Kugiumtzis (1999) distingue estas dos salidas y muestra por qué incluso una discrepancia pequeña puede importar cuando la dispersión de las estadísticas entre sustitutos es reducida.
Para examinarlo generamos una serie didáctica de doscientas cincuenta y seis observaciones. El proceso latente es una autorregresión gaussiana de coeficiente y varianza estacionaria uno, inicializada desde esa distribución; lo observado es su exponencial. La construcción pertenece a la nula de transformación monótona estática aunque la serie observada sea positiva y asimétrica.
El error espectral se mide en las frecuencias positivas, Nyquist incluida, como la distancia euclídea entre los vectores de amplitudes de Fourier del original y del sustituto dividida por la norma del vector original en esas mismas frecuencias. El ajuste de valores se mide comparando ambos vectores ordenados y dividiendo la distancia por la norma de la serie original centrada. Son diagnósticos de esta realización y no niveles universales de aceptación.
| Salida del procedimiento | Error relativo de amplitudes de Fourier | Error relativo de valores ordenados |
|---|---|---|
| AAFT | 0,450 | 0 |
| IAAFT después de ordenar valores | 0,0970 | 0 |
| IAAFT después de ajustar el espectro | Menor que | 0,0966 |
La iteración se detuvo tras setenta y una vueltas, cuando el reordenamiento dejó de cambiar la secuencia. La mejora respecto de AAFT es clara, pero alcanzar ese punto fijo no eliminó el error espectral. La correlación circular en el primer retardo era de unos en el original y de en la salida final por rangos, mientras que en la salida espectral volvió a coincidir a costa de alterar los valores.
Estas cifras corresponden a una realización y a una inicialización concretas, guardadas en el cálculo reproducible. Repetir con otros puntos de partida permite estudiar la variabilidad de las soluciones del algoritmo. Quedarse solo con la réplica que da el resultado inferencial deseado alteraría el procedimiento de generación, por lo que el criterio de parada y los de aceptación deben definirse según el ajuste requerido, antes de usar la estadística de contraste.
Límites de una buena coincidencia
La distribución marginal y el espectro son restricciones parciales sobre una distribución conjunta. Muchas series pueden compartirlas y diferir en dependencias de orden superior. Que una construcción encuentre alguna serie compatible con esas restricciones no demuestra que esté muestreando con las probabilidades correctas bajo la nula.
Räth y colaboradores (2012) mostraron que los ajustes de AAFT e IAAFT pueden introducir correlaciones entre las fases de Fourier en sus ejemplos. El hallazgo cuestiona que esas salidas sean réplicas adecuadas, sin más, para cualquier contraste. No significa que todas las realizaciones de ambos algoritmos tengan el mismo defecto ni que toda inferencia basada en ellos sea necesariamente errónea.
En una implementación práctica conviene examinar la distribución de los errores de ajuste en el conjunto de sustitutos, porque su promedio puede ocultar réplicas deficientes. Si se exige una tolerancia y se regeneran las que no la cumplen, esa selección pasa a formar parte del generador cuya calibración hay que estudiar.
La calibración puede investigarse simulando repetidamente procesos que cumplen la nula, aplicando a cada registro el procedimiento completo y contando los rechazos. El estudio debe cubrir longitudes, correlaciones y distribuciones pertinentes al problema. Una frecuencia de rechazo cercana al nivel nominal en un diseño particular respalda ese diseño, pero no establece la exactitud del procedimiento para una familia ilimitada de procesos.
Kugiumtzis (1999) recomendó comprobar las propiedades lineales junto con las estadísticas no lineales. Si aparece una diferencia ya en un resumen de las correlaciones que el sustituto debía conservar, existe una explicación técnica disponible antes de invocar ninguna estructura adicional. El diagnóstico localiza el desacuerdo entre lo que la nula pretende y la muestra artificial efectivamente producida.
En el ejemplo de la exponencial autorregresiva, la discrepancia que queda pertenece justamente a ese nivel. Como sabemos cómo se generó el registro, no hace falta atribuirla a una dinámica desconocida. Con este caso puede ensayarse el procedimiento en condiciones controladas, incluida la posibilidad de declarar insuficiente el ajuste alcanzado.
Sustitutos multivariantes
Si se registran varias variables a la vez, las restricciones se amplían. Cada canal depende de su propio pasado y puede estar correlacionado con los demás a distintos retardos. Una nula que admita un proceso lineal multivariante tiene que representar esas relaciones cruzadas. Si solo se conserva el espectro de cada variable, parte de la estructura lineal queda fuera de la comparación.
Prichard y Theiler (1994) propusieron una extensión de la aleatorización de fases que conserva esa información. En cada frecuencia se suma el mismo ángulo aleatorio a todos los canales; el ángulo puede variar de una frecuencia a otra, pero dentro de cada frecuencia es común a los canales. Se modifican así las fases absolutas manteniendo las diferencias de fase entre canales.
Si e son los coeficientes de Fourier de dos canales, el espectro cruzado depende del producto , donde el asterisco indica conjugación compleja. Multiplicar ambos coeficientes por no altera ese producto, porque el factor del segundo coeficiente aparece conjugado y cancela el del primero. Tampoco altera las magnitudes individuales. La transformación inversa conserva, por tanto, las covarianzas cruzadas circulares además de las autocovarianzas circulares de cada canal.
Con fases independientes para los dos canales los factores ya no se cancelan, de modo que cada espectro individual se mantiene mientras cambian las relaciones cruzadas. Ambas operaciones pueden ser útiles y corresponden a comparaciones diferentes. Si se buscaba una estructura adicional a una relación lineal ya existente entre variables, destruir esa relación desde el principio da una referencia inadecuada para la pregunta.
Un caso extremo muestra la diferencia. Supongamos dos sensores didácticos que registran exactamente la misma señal, uno con ganancia doble, . Con fases comunes, los sustitutos conservan esa igualdad en todo instante; con fases independientes, por lo general la pierden. Una estadística que mida la cercanía a una relación lineal detectaría enseguida la diferencia entre el original y estos últimos sustitutos, aunque el vínculo entre los sensores fuera una simple multiplicación.
Si la pregunta fuera investigar una relación entre canales frente a una nula que no la admite, eliminar sus fases relativas podría formar parte de un contraste distinto. Aun entonces habría que precisar las dependencias permitidas y las condiciones de muestreo. La operación no demuestra que bajo la nula falte todo acoplamiento ni identifica la dirección causal de una asociación detectada.
La distinción importa cuando varias señales responden a una perturbación común, de la que pueden proceder sus correlaciones. Una prueba que elimina todas las relaciones cruzadas compara también contra la ausencia de esa respuesta común. Para estudiar una interacción adicional entre canales, la referencia debe incluir el mecanismo compartido que se considera una explicación admisible.
Recuperar después las distribuciones empíricas canal por canal añade otro compromiso, ya que los ajustes por rangos pueden alterar las fases y las correlaciones cruzadas aunque dejen exactos los valores de cada variable. La extensión iterativa que discutieron Schreiber y Schmitz (2000) obliga a comprobar el ajuste conjunto. Verificar por separado los histogramas y los espectros individuales no descubre necesariamente un error en el espectro cruzado.
Deben preservarse, además, las unidades de observación. Dos canales de una misma persona no son intercambiables con registros de personas distintas. Desplazar al azar uno respecto del otro cambia qué eventos aparecen alineados. El desplazamiento puede ser la operación adecuada para una nula temporal concreta, pero su elección depende del intervalo considerado, de los bordes y de la estacionariedad. Que dos curvas parezcan plausibles por separado no informa sobre la validez de su emparejamiento.
Rangos, empates y número de sustitutos
Supongamos ahora que se dispone de un generador justificado bajo la nula y de una estadística cuyos valores grandes indican mayor discrepancia. Se calcula el valor observado y los valores de sustitutos. Si de estos últimos son mayores o iguales que el observado, la regla habitual es
La unidad añadida corresponde al propio registro observado. Bajo intercambiabilidad y sin empates, su rango entre todos los valores es uniforme, porque cualquiera de ellos podría ocupar la posición del observado. De ahí procede el control del error de rechazo, con la resolución discreta que permite el número de registros. Si hay empates, incluirlos en la cola da una regla conservadora bajo esas mismas condiciones.
Phipson y Smyth (2010) explicaron por qué dividir sin más el número de excedencias por el número de simulaciones puede producir pruebas mal calibradas y valores p nulos. Distinguieron también la simulación de Monte Carlo de las permutaciones sorteadas con o sin reemplazo. Con reemplazo, la fórmula anterior puede ser una cota conservadora válida sin coincidir necesariamente con el valor exacto que se obtendría considerando el espacio finito de permutaciones.
En la enumeración inicial se usaron directamente las setecientas veinte configuraciones con sus multiplicidades, sin añadir otra unidad a una enumeración que ya contenía el registro observado. Cuando se recurre solo a un subconjunto aleatorio, hay que indicar el mecanismo de selección y aplicar la regla correspondiente. Son dos experimentos computacionales emparentados cuyos denominadores no pueden intercambiarse por conveniencia.
Con diecinueve sustitutos, el menor valor posible de la regla unilateral es ; con ciento noventa y nueve, ; con novecientos noventa y nueve, . Si tres de ciento noventa y nueve sustitutos igualan o superan al observado, se obtiene . Si ninguno lo hace, el resultado es y no cero.
Una prueba que rechaza cuando una estadística con signo cae en cualquiera de los dos extremos reparte el error entre ambas colas. Con rangos sin empates necesita treinta y nueve sustitutos para que la probabilidad conjunta de ambos extremos sea . También puede definirse de antemano una estadística de magnitud absoluta y contrastar su cola superior, lo que es otra construcción. El número de sustitutos se deduce de la regla elegida y no de una etiqueta genérica de prueba bilateral.
La resolución del valor p y la variabilidad de Monte Carlo son cosas distintas. Si las excedencias proceden de simulaciones independientes y su probabilidad condicional es , la desviación típica de la proporción estimada con ciento noventa y nueve simulaciones ronda y con mil novecientas noventa y nueve baja a . Estas cuentas describen la fluctuación al muestrear la cola, mientras que la validez del contraste descansa en el argumento de los rangos.
La dispersión entre sustitutos no es, por definición, la incertidumbre de cualquier estimador aplicado al proceso real, porque el conjunto de réplicas representa la nula y las restricciones impuestas. Si todas conservan exactamente la media muestral, la varianza de sus medias es cero, por incierta que siga siendo la media poblacional. Un intervalo de confianza requiere un procedimiento que represente la variación pertinente del estimador. Usar sustitutos con ese fin exige otra justificación, diferente de la empleada para situar una estadística dentro de una referencia nula.
Aumentar el número de sustitutos puede aclarar una decisión cercana al umbral, pero no corrige una nula inapropiada ni una distribución de generación incorrecta. Tampoco autoriza a seguir generando réplicas, con el mismo nivel nominal, hasta que aparezca el resultado buscado; una regla de parada adaptativa necesita su propia justificación.
Elección de la estadística y repetición del análisis
Las estadísticas discriminantes responden a alternativas distintas. Un error de predicción local puede ser sensible a una relación entre estados vecinos que la predicción lineal no recoge. Una medida de asimetría temporal compara el registro con su versión invertida. Una dependencia entre cuadrados puede detectar cambios predecibles de amplitud cuando las correlaciones entre valores son pequeñas.
Para la asimetría temporal puede estudiarse, por ejemplo, con un retardo fijo, el promedio de , que cambia de signo al invertir el tiempo. Los procesos gaussianos estacionarios univariantes son reversibles y, si existen los momentos necesarios, la esperanza de ese promedio es cero. Una transformación estática aplicada en cada instante conserva esa reversibilidad. Que la estadística resulte cercana a cero no descarta, sin embargo, todas las formas de dependencia no lineal.
Una medida de predicción exige especificar cómo se ajusta el predictor, qué observaciones se reservan y cómo se excluyen los vecinos temporalmente próximos. Esas decisiones deben aplicarse del mismo modo al original y a cada sustituto. Comparar un predictor cuidadosamente optimizado en el original con predictores mal ajustados en las réplicas introduce una ventaja que puede tomarse por estructura.
Si la elección del retardo, del número de vecinos o de la complejidad usa los datos, puede hacer falta repetir esa elección dentro de cada réplica. Otra opción es fijarla con información externa o con un tramo independiente, según el experimento estadístico que se quiera reproducir. Repetir automáticamente todos los pasos no corrige, en cualquier caso, la aproximación propia del generador.
La misma cuestión surge al generar sustitutos desde un modelo paramétrico estimado, como una autorregresión ajustada al registro. Simular con los parámetros estimados trata una cantidad incierta como valor de generación. Cuando la estadística incluye residuos o estimaciones normalmente hay que volver a ajustar el modelo en cada simulación. Este remuestreo paramétrico requiere evaluar su aproximación y no hereda una intercambiabilidad exacta por usar la misma familia de ecuaciones.
Probar muchas estadísticas y presentar solo la más favorable cambia además la probabilidad de rechazo. Con diez pruebas independientes de nivel , la probabilidad de al menos un rechazo falso es de unos . Las estadísticas de una misma serie suelen ser dependientes, por lo que ese número no describe cualquier análisis, aunque sí muestra el efecto de multiplicar las oportunidades.
Una corrección de Bonferroni para diez contrastes compara cada valor p válido con sin requerir independencia. Así, el del ejemplo anterior pasaría a expresado como valor ajustado. Otra posibilidad es definir una estadística conjunta (por ejemplo, el máximo de discrepancias bien escaladas) y generar después su distribución bajo la nula. En ese caso el mismo conjunto de sustitutos debe conservar la dependencia relevante entre esas discrepancias.
Los retardos examinados, los tramos elegidos y las transformaciones ensayadas pueden ser también oportunidades de selección. Decidir el análisis después de ver dónde aparece la mayor separación obliga a incorporar esa decisión al procedimiento o a tratar el resultado como exploratorio. La reproducción computacional debe conservar el camino que llevó a la estadística final, además de su último valor.
Estacionariedad y una transformación conocida
Una media que cambia durante el registro puede provocar el rechazo frente a sustitutos estacionarios, igual que una interrupción del instrumento que concentre valores extremos en un tramo. Schreiber y Schmitz (2000) mostraron cómo estas características afectan a la interpretación y discutieron restricciones que permiten conservar algunas formas de no estacionariedad.
Permutar dentro de segmentos o conservar medias locales puede responder a otra pregunta, siempre que esos segmentos y restricciones estén justificados. Preservar una tendencia conocida evita contrastarla sin advertirlo como dependencia adicional, aunque preservar demasiadas características puede eliminar la alternativa que interesaba detectar. El contenido del contraste queda definido por la parte de la organización temporal que todavía varía entre sustitutos.
Las ausencias y los intervalos irregulares exigen especial cuidado. Una transformada ordinaria aplicada a una tabla interpolada trabaja sobre el registro reconstruido y la interpolación aporta dependencias propias. Para incluir ese procedimiento en la comparación habría que representar la toma de muestras y el tratamiento de las ausencias de forma compatible con la nula. Obtener una columna sin huecos no convierte las observaciones originales en una serie medida a intervalos regulares.
Volvamos a la construcción de doscientas cincuenta y seis observaciones. Como la transformación exponencial usada es conocida, la relación entre ambas escalas puede examinarse con exactitud. La variable latente cumple
Su esperanza condicional en la escala observada es , que para un valor actual de uno predice cerca de y para un valor actual de cuatro, unos . La curva es no lineal en esa escala y procede exactamente de la nula que admite una transformación monótona de un proceso gaussiano lineal. Al aplicar el logaritmo conocido se recupera la variable cuya media condicional sigue la recta de pendiente .
Referencias
Kugiumtzis, D. (1999). Test your surrogate data before you test for nonlinearity. Physical Review E, 60(3), 2808–2816. https://doi.org/10.1103/PhysRevE.60.2808
Phipson, B., & Smyth, G. K. (2010). Permutation p-values should never be zero: Calculating exact p-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1), artículo 39. https://doi.org/10.2202/1544-6115.1585
Prichard, D., & Theiler, J. (1994). Generating surrogate data for time series with several simultaneously measured variables. Physical Review Letters, 73(7), 951–954. https://doi.org/10.1103/PhysRevLett.73.951
Räth, C., Gliozzi, M., Papadakis, I. E., & Brinkmann, W. (2012). Revisiting algorithms for generating surrogate time series. Physical Review Letters, 109(14), 144101. https://doi.org/10.1103/PhysRevLett.109.144101
Schreiber, T., & Schmitz, A. (1996). Improved surrogate data for nonlinearity tests. Physical Review Letters, 77(4), 635–638. https://doi.org/10.1103/PhysRevLett.77.635
Schreiber, T., & Schmitz, A. (2000). Surrogate time series. Physica D: Nonlinear Phenomena, 142(3–4), 346–382. https://doi.org/10.1016/S0167-2789(00)00043-9
Theiler, J., Eubank, S., Longtin, A., Galdrikian, B., & Farmer, J. D. (1992). Testing for nonlinearity in time series: The method of surrogate data. Physica D: Nonlinear Phenomena, 58(1–4), 77–94. https://doi.org/10.1016/0167-2789(92)90102-S