Módulo 26. Agentes adaptativos y aprendizaje
253.1. Interacción, consecuencias y cambio de conducta
Un agente puede aprender sin recibir una instrucción que indique la acción correcta en cada situación. Prueba una acción, observa consecuencias y usa esa experiencia para modificar decisiones posteriores. El aprendizaje por refuerzo estudia formalmente una familia de problemas con esta estructura, en los que la información evaluativa puede llegar tarde, ser variable y depender de una secuencia completa de acciones.
La formulación distingue agente y entorno. En cada paso, el agente recibe información, selecciona una acción y obtiene después una nueva observación y una recompensa. Su objetivo se expresa mediante un retorno, que agrega recompensas a lo largo del tiempo. Sutton y Barto presentan esta interacción como el núcleo del problema y la separan de los algoritmos particulares que intentan resolverlo [1].
Aquí la recompensa tiene un sentido técnico; es una señal numérica con la que se define o aproxima el objetivo. No implica necesariamente placer consciente, aprobación social ni bienestar. Un programa puede recibir una recompensa negativa por consumir energía, una positiva por completar una tarea y cero durante muchos pasos intermedios. La interpretación depende del modelo y de cómo se construyó la señal.
Tampoco toda mejora producida después de una consecuencia pertenece a un mismo algoritmo. Un agente puede estimar valores de acciones, modificar directamente probabilidades de elección o aprender un modelo del entorno y planificar. Estas arquitecturas comparten un problema de interacción, pero difieren en la información que conservan y en cómo transforman experiencia en decisiones.
Usaremos primero un problema de dos opciones sin consecuencias diferidas, cuya sencillez permite examinar por separado la actualización de valores y la selección de acciones. Después añadiremos estados y recompensas tardías. Esta progresión evita atribuir al caso elemental propiedades que solo aparecen cuando las acciones cambian las oportunidades futuras.
Aprender sobre una acción requiere observar resultados, aunque observarlos no garantiza identificar sus causas. En un simulador podemos definir exactamente cómo se generan; en datos de conducta debemos considerar selección, variables ocultas y cambios del entorno. Un modelo de aprendizaje puede describir una secuencia sin demostrar que el agente usa ese mecanismo.
La pregunta operativa es qué variable cambia después de cada experiencia y cómo ese cambio modifica la acción siguiente. Escribir la actualización permite comprobarla, comparar alternativas y localizar condiciones donde el aprendizaje puede fallar.
253.2. Dos opciones y resultados variables
Imaginemos dos dispositivos, A y B. Cada activación produce una recompensa de uno o cero. A produce uno con probabilidad de cuatro quintos y B con probabilidad de dos quintos. Los resultados son independientes entre activaciones, las probabilidades permanecen constantes y el agente desconoce sus valores. Solo observa el resultado del dispositivo elegido.
El valor esperado verdadero de A es 0,8 y el de B es 0,4. Si el objetivo fuera maximizar la recompensa media de una única elección y esas probabilidades fueran conocidas, elegir A sería suficiente. El problema de aprendizaje surge porque el agente debe descubrir qué opción conviene mientras sus elecciones producen tanto recompensa como información.
Un fracaso de A no demuestra que B sea mejor, ya que A puede producir cero en una quinta parte de sus activaciones. Del mismo modo, un éxito de B no convierte su valor esperado en uno. La variabilidad de resultados obliga a distinguir entre experiencia individual y propiedad estadística del entorno.
El agente puede conservar estimaciones y que resumen lo que espera obtener al elegir cada dispositivo y que son distintas de las recompensas recibidas. La diferencia entre estimación y resultado observado es la señal de actualización. La selección de acciones usa después las estimaciones y puede incorporar exploración.
Supongamos que inicialmente ambas estimaciones son cero. El agente elige A y recibe uno; luego elige B y recibe uno. Si usa promedios de observaciones, ambas opciones quedan empatadas en uno, aunque sus probabilidades verdaderas sean distintas. Dos experiencias favorables no bastan para resolver la incertidumbre.
La duración del aprendizaje depende de la diferencia entre opciones, de la variabilidad y de la frecuencia con que se prueban. En condiciones comparables, distinguir valores esperados de 0,8 y 0,4 suele requerir menos evidencia que distinguir 0,51 y 0,49. No existe un número universal de ensayos que garantice descubrir la mejor acción en todos los problemas.
Este ejemplo es un problema de bandido de múltiples brazos con dos acciones. La acción actual no modifica las probabilidades futuras ni introduce un nuevo estado relevante del entorno. Más adelante estudiaremos decisiones secuenciales donde una elección cambia qué oportunidades aparecen después. Allí una acción con recompensa inmediata baja puede convenir porque abre acceso a consecuencias posteriores.
Mantener separadas ambas situaciones evita usar una regla adecuada para recompensas inmediatas como si resolviera cualquier problema de planificación temporal.
253.3. Actualizar una estimación a partir del error
Una actualización elemental del valor de la acción elegida es
Las estimaciones de acciones no elegidas permanecen iguales en esta versión. La expresión entre corchetes compara resultado y expectativa. Si la recompensa supera la estimación, el valor aumenta; si queda por debajo, disminuye. La tasa de aprendizaje determina qué fracción del error se incorpora.
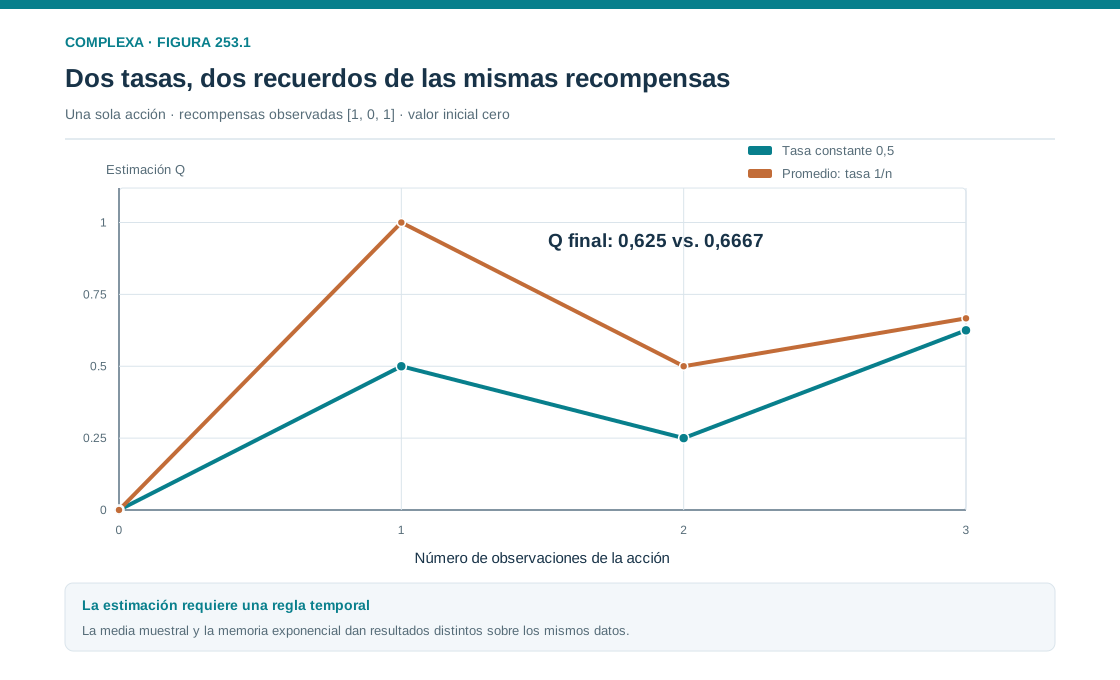
Con tasa de un medio y estimación inicial cero, una secuencia de recompensas uno, cero y uno produce valores 0,5; 0,25 y 0,625. El resultado reciente pesa más que los anteriores. Después de tres observaciones, la estimación no coincide con el promedio de dos tercios porque la tasa constante conserva una ponderación exponencial y todavía mantiene influencia de la inicialización.
Si en la visita número a una acción usamos tasa , la actualización reproduce su media muestral. Para la misma secuencia, los valores son uno, un medio y dos tercios. El contador relevante es el número de veces que se eligió esa acción, que puede diferir del número total de decisiones.
Un agente puede haber tomado cien decisiones y haber probado B solo dos veces. Aplicar una tasa de una centésima a la segunda observación de B no equivale a calcular su promedio. La notación debe indicar qué reloj gobierna cada actualización.
La tasa constante permite seguir cambios persistentes, pero no hace desaparecer toda fluctuación en un entorno ruidoso. Una tasa decreciente puede estabilizar una estimación en condiciones estacionarias, aunque responde más lentamente cuando el entorno cambia. El compromiso entre seguimiento y conservación de información reaparece aquí en una variable que guía decisiones.
También influye la inicialización. Valores iniciales altos pueden favorecer la prueba de opciones todavía no visitadas, porque parecen prometedoras. Sin embargo, ese efecto depende de la regla de selección, de los empates y de cómo se actualizan. En problemas complejos no garantiza una exploración suficiente.
Tal como está escrita, la actualización no usa información sobre acciones no elegidas. Si el entorno entrega resultados contrafácticos de todas las opciones, podemos diseñar otra regla que los use, pero habremos cambiado el problema informativo.
Al documentar un agente debemos declarar tasa, inicialización, manejo de acciones no observadas y orden temporal. Pequeñas diferencias en estos elementos pueden producir trayectorias distintas, incluso entre programas que reciben el mismo nombre general. Conviene calcular a mano las primeras actualizaciones antes de ejecutar miles de episodios o interpretar una curva agregada.
253.4. De valores a decisiones
Las estimaciones no determinan una conducta hasta que especificamos una política, que asigna acciones, o probabilidades de acciones, a la información disponible. Elegir siempre el valor estimado más alto es una posibilidad; introducir elecciones aleatorias o incertidumbre sobre valores son otras. Aprendizaje y selección cumplen funciones relacionadas, pero diferentes.
Una política voraz elige una acción con estimación máxima y debe definir qué ocurre ante empates, porque seleccionar siempre la primera, alternar o sortear producen experiencias posteriores diferentes. En nuestro ejemplo, un desempate fijo a favor de A puede hacer que B permanezca sin probar durante mucho tiempo.
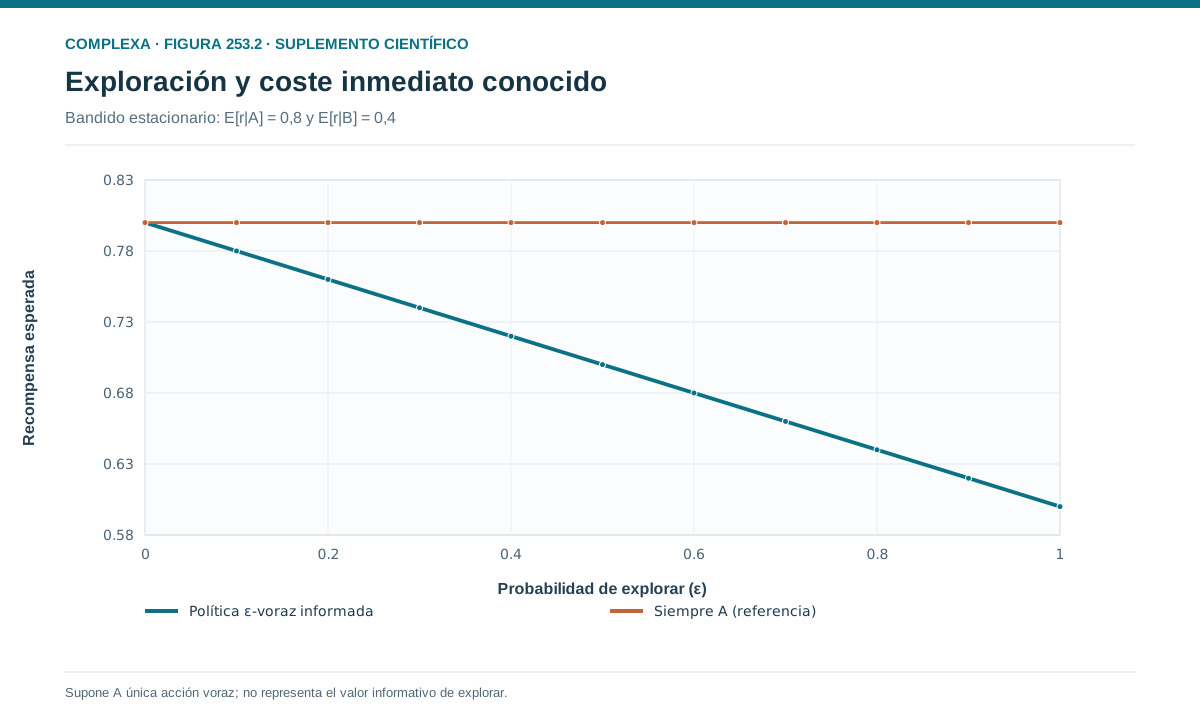
Una política épsilon-voraz elige al azar con probabilidad y, en caso contrario, elige una acción de valor máximo. Si la selección aleatoria es uniforme entre dos acciones y A es la única acción voraz, su probabilidad total es , mientras que B recibe probabilidad .
Con , A se elige con probabilidad 0,9 y B con 0,1. Si las estimaciones ya identifican correctamente el orden verdadero, la recompensa esperada por paso es . La diferencia de 0,04 frente a elegir siempre A es un costo inmediato de exploración en este escenario conocido.
Durante el aprendizaje, explorar puede producir información que compense ese costo. No debemos evaluar la política como si el agente ya conociera la mejor opción desde el comienzo. Tampoco debemos suponer que seguir explorando con intensidad constante siempre conviene una vez que el entorno resulta estable y suficientemente conocido.
Otra política asigna probabilidades mediante una transformación exponencial de los valores. Su sensibilidad depende de un parámetro y de la escala de recompensa. Multiplicar todas las recompensas por diez sin ajustar esa sensibilidad puede volver la conducta mucho más determinista. La regla de decisión necesita unidades coherentes con las estimaciones que recibe.
La política puede ser fija mientras los valores cambian, o puede incluir parámetros que también se aprenden. En ambos casos conviene registrar las probabilidades usadas antes de cada elección. Una acción poco frecuente no indica necesariamente un error, porque pudo formar parte de la exploración prevista por el procedimiento.
La comparación de políticas debe considerar recompensa acumulada, información adquirida y comportamiento después de cambios. El capítulo sobre exploración desarrollará estas tensiones. Aquí basta reconocer que una buena estimación y una buena política son componentes distintos de un agente eficaz.
253.5. Cuando las acciones cambian el futuro
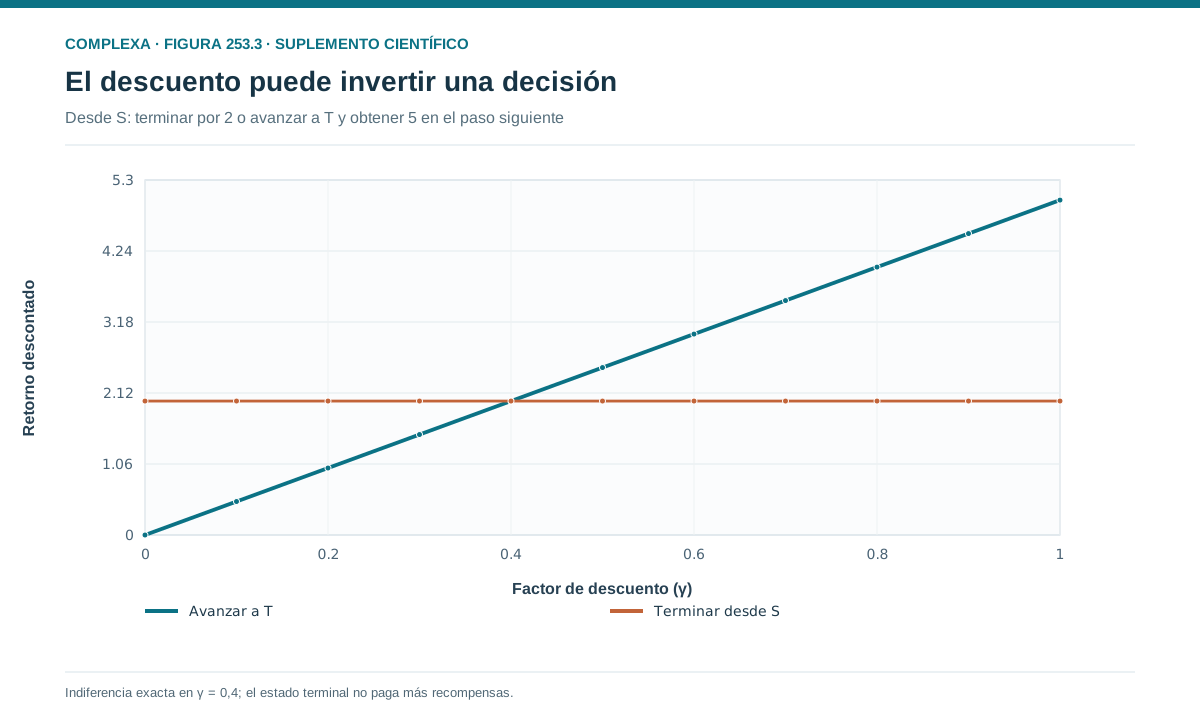
Añadamos estados. En el estado inicial S, el agente puede tomar una salida directa que produce recompensa dos y termina el episodio, o avanzar a T con recompensa cero. Desde T hay una acción que produce cinco y termina. La elección inicial determina qué consecuencia futura será accesible.
Si evaluamos únicamente la recompensa inmediata, la salida directa parece mejor (dos supera a cero). Si evaluamos la suma de recompensas del episodio, avanzar produce cinco y resulta preferible. El valor de la primera acción depende de lo que permite hacer después. Esta dependencia del futuro distingue el problema actual del de los dos dispositivos independientes.
Podemos introducir un factor de descuento entre cero y uno. El retorno desde S al avanzar será cinco multiplicado por ese factor, porque la recompensa llega un paso después que la recompensa directa. Con , el retorno es 4,5 y avanzar sigue siendo mejor. Con , el retorno es uno y la salida directa resulta preferible.
El descuento forma parte del objetivo matemático. Interpretarlo como una característica psicológica, una probabilidad de supervivencia o una tasa económica exige justificar esa conexión. En ciertos modelos admite esas interpretaciones; en otros se usa para definir un problema de horizonte efectivo o garantizar propiedades analíticas.
El retorno descontado se escribe como una suma ponderada de recompensas futuras. En episodios finitos, la suma termina al llegar al estado terminal, que no genera recompensa adicional salvo que el modelo lo especifique. Introducir accidentalmente una recompensa repetida después de terminar puede cambiar por completo el problema.
Ahora la estimación de una acción debe incorporar consecuencias posteriores. Podemos estimar el retorno completo después de cada episodio o usar valores de estados siguientes para aproximarlo antes de que el episodio termine.
La segunda posibilidad conduce al aprendizaje por diferencias temporales, que combina una recompensa observada con una predicción revisada del futuro. La actualización puede hacerse con experiencia parcial, aunque depende de la calidad de otras estimaciones. Esta dependencia será importante al estudiar estabilidad y aproximación de funciones.
El pequeño recorrido S–T permite verificar cada paso sin una simulación extensa. También muestra que definir la recompensa y definir cómo se acumula son decisiones distintas. Un agente puede aprender correctamente una tarea cuyo objetivo acumulado no coincide con lo que el diseñador pretendía.
253.6. Aprender a partir de otra predicción
Los métodos de diferencias temporales actualizan predicciones con recompensas y predicciones posteriores. Sutton desarrolló resultados fundamentales para esta familia de procedimientos [2]. En una versión básica de evaluación de estados, el error compara el valor actual con una recompensa observada más el valor descontado del estado siguiente; en símbolos,
El valor del estado terminal se fija en cero. La expresión contiene una observación (la recompensa) y una estimación (el valor siguiente). Este uso de una predicción dentro del objetivo de actualización se llama arranque o bootstrap. Permite aprender antes de observar todo el retorno, pero introduce dependencia entre estimaciones.
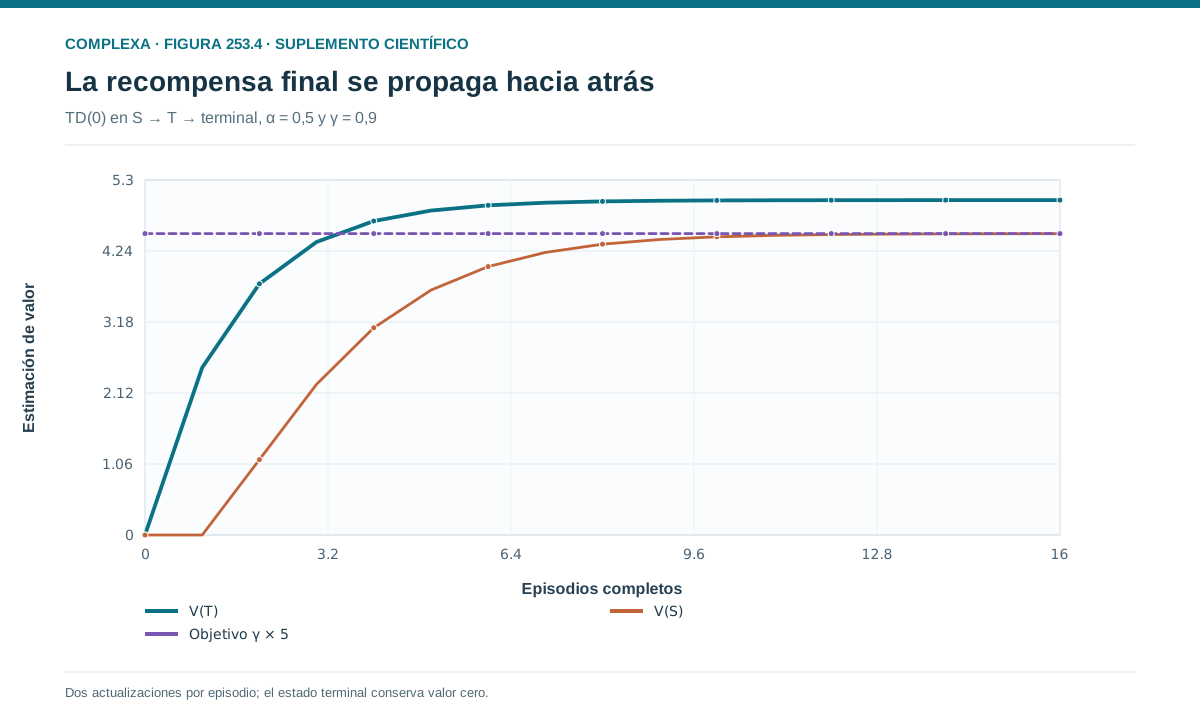
Volvamos al recorrido S–T–terminal con recompensas cero y cinco. Supongamos que siempre se avanza, que todos los valores iniciales son cero, que la tasa es un medio y que el descuento es 0,9. En el primer episodio, la transición desde S no modifica su valor porque tanto la recompensa como el valor de T son cero.
Después, la transición desde T produce error cinco y actualiza su valor a 2,5. En el segundo episodio, al salir de S, el objetivo es , por lo que su valor pasa de cero a 1,125. Al salir de T, su valor aumenta de 2,5 a 3,75. La información de la recompensa final se propaga gradualmente hacia estados anteriores.
Estas cifras suponen actualizaciones en línea en el orden indicado. Si al finalizar cada episodio recorriéramos las transiciones hacia atrás con valores recién actualizados, obtendríamos otra trayectoria. Bajo ciertas condiciones la convergencia eventual puede coincidir, pero las primeras experiencias no serían iguales.
Evaluar estados bajo una política fija tampoco equivale a aprender qué acción elegir. Para controlar el comportamiento necesitamos comparar acciones o modificar una política. Q-learning usa un objetivo que incluye el máximo de valores estimados en el estado siguiente; su análisis clásico establece convergencia bajo condiciones específicas de representación tabular, visitas y tasas de aprendizaje [3].
En el resultado clásico, la tabla de estados y acciones es finita, las recompensas están acotadas y cada pareja estado–acción recibe infinitas visitas. Las tasas de esas visitas deben satisfacer condiciones de sumabilidad que mantienen aprendizaje acumulado y controlan ruido. El caso principal supone un descuento estrictamente entre cero y uno y un entorno con dinámica fija.
No debemos trasladar esa garantía sin cambios a redes neuronales, observaciones incompletas o entornos que varían mientras se aprende. La forma compacta de una actualización puede ocultar supuestos fuertes. Precisar el alcance del resultado teórico evita presentar toda implementación de una ecuación como si heredara automáticamente el mismo comportamiento.
253.7. Recompensa, objetivo y consecuencias no registradas
La señal de recompensa define qué diferencias cuenta el algoritmo al actualizar. Si solo recompensa terminar rápido, puede favorecer estrategias que consumen más recursos; si solo recompensa producción, puede ignorar la calidad. Un agente que maximiza correctamente una señal incompleta puede generar resultados indeseables sin que haya un error en la actualización.
Consideremos un robot que recibe una unidad por cada paquete entregado y ninguna penalización por desgaste. Entre dos rutas con igual número de entregas, el objetivo no distingue una que deteriora el equipo de otra que lo preserva. Si el diseñador esperaba cuidado mecánico, esa expectativa todavía no figura en la tarea.
Podemos añadir costos, pero debemos declarar unidades, pesos y horizonte. Una penalización inmediata elevada puede impedir una acción necesaria para obtener beneficios posteriores. Una penalización demasiado pequeña puede resultar irrelevante frente a recompensas acumuladas. Ajustar números hasta observar la conducta deseada es una decisión de diseño que deja sin demostrar que el objetivo represente todas las consecuencias importantes.
La recompensa también puede depender de una medición imperfecta. Si se usa una estimación de calidad, el agente aprende respecto de esa estimación. Cuando puede influir en la medición, aparecen incentivos que no existían en el problema idealizado. Conviene distinguir desempeño real, indicador observado y señal entregada al algoritmo.
En estudios de conducta, llamar recompensa a un resultado no demuestra que todos los individuos lo valoren igual. Una cantidad monetaria, una señal social o una reducción de esfuerzo pueden tener significados diferentes según el contexto. Un modelo necesita relacionar la señal experimental con la variable que supone actualizada; esa relación puede requerir parámetros o hipótesis adicionales.
Las categorías psicológicas de refuerzo y castigo tampoco se deducen solo del signo numérico. Transformaciones de la escala, referencias y expectativas afectan la interpretación. En la ecuación elemental, una recompensa positiva puede producir un error negativo si se esperaba algo todavía mayor, porque la actualización depende de la diferencia entre resultado y expectativa.
Una auditoría del objetivo compara lo que el agente optimiza con lo que se desea evaluar. Puede incluir medidas secundarias que no entran en la recompensa y pruebas bajo condiciones nuevas. Si la conducta cambia de manera problemática, debemos preguntar si falló el aprendizaje, si cambió el entorno o si el objetivo siempre estuvo incompleto.
Estas preguntas pertenecen al diseño científico del modelo y evitan atribuir al algoritmo una finalidad más amplia que la señal y el retorno efectivamente especificados.
253.8. Qué se observa y qué puede inferirse
Una secuencia de elecciones y resultados permite ajustar modelos de aprendizaje, pero en general no identifica un mecanismo único. Tasas de aprendizaje, sensibilidad de elección, valores iniciales y cambios de contexto pueden compensarse entre sí. Diferentes combinaciones producen probabilidades de respuesta parecidas en conjuntos de datos pequeños.
Supongamos que un agente repite A después de recibir uno. Esa repetición es compatible con una actualización positiva de su valor, con una preferencia previa muy fuerte por A o con una regla que repite siempre la última acción. Para distinguirlas necesitamos observar qué ocurre después de resultados diferentes y en situaciones donde sus predicciones divergen.
Una tarea con inversión de contingencias puede dar información de este tipo. Al principio A es mejor; después B pasa a serlo sin aviso. La rapidez y la forma del cambio conductual ayudan a estudiar actualización y persistencia. Sin embargo, el agente podría detectar explícitamente la ruptura y reiniciar sus estimaciones. El diseño debe considerar esa alternativa a la tasa constante.
También hay diferencias entre experiencia elegida y experiencia impuesta. Si el agente selecciona qué acción probar, sus observaciones dependen de su política. Si el experimentador fuerza algunas elecciones, puede dar información que el agente habría evitado. Comparar ambas condiciones ayuda a separar aprendizaje de selección, aunque modifica el problema original.
La estimación de parámetros debe acompañarse de recuperación en datos simulados. Generamos secuencias con parámetros conocidos y comprobamos si el procedimiento los recupera en condiciones similares a las observadas. Si dos parámetros permanecen confundidos incluso en esa prueba, una interpretación precisa de datos reales será frágil.
Predecir decisiones nuevas es otra forma de evaluación. Un modelo que reproduce el conjunto usado para ajustarlo puede deberlo a su flexibilidad sin capturar una regularidad estable. Reservar sujetos, episodios o condiciones exige que la hipótesis se sostenga fuera de la muestra de ajuste. El tipo de reserva determina qué generalización se está examinando.
En aplicaciones reales, además, la correlación entre una señal y una elección posterior no demuestra que la señal haya causado la actualización, porque variables no registradas pueden afectar a ambas. Las intervenciones controladas y la comparación de mecanismos ayudan, pero no eliminan todas las limitaciones.
La inferencia debe conservar esas incertidumbres. Un parámetro llamado tasa de aprendizaje es una cantidad dentro de un modelo particular; tratarlo como una propiedad fija y universal de la persona que produjo los datos requiere justificación adicional.
Un ejemplo de confusión aparece cuando multiplicamos la escala de valores por una constante y dividimos por esa misma constante la sensibilidad de una política exponencial. Los productos que determinan sus probabilidades pueden permanecer iguales. Sin restricciones sobre la escala, elecciones idénticas no permiten identificar ambos componentes de manera independiente. Fijar las unidades de recompensa y explicar cualquier transformación previa ayuda a evitar interpretaciones demasiado precisas de la sensibilidad.
253.9. Verificar un agente antes de interpretarlo
Una implementación debe superar primero casos donde conocemos el resultado. Para el dispositivo determinista que siempre entrega uno, la actualización con tasa de un medio e inicio cero produce después de visitas. Si el programa no reproduce esa secuencia, no tiene sentido interpretar su conducta en un entorno complejo.
También debemos comprobar que las acciones no elegidas permanezcan sin cambios cuando así lo define el algoritmo. Un error de índice puede actualizar toda la tabla con una recompensa que corresponde a una sola acción. La curva de recompensa podría parecer razonable y aun así proceder de un mecanismo diferente.
El registro temporal necesita separar estimaciones antes de actuar, acción elegida, recompensa recibida y estimaciones después de actualizar. Usar accidentalmente una recompensa futura para seleccionar la acción actual introduce información imposible. Este tipo de filtración puede mejorar resultados aparentes mientras invalida la comparación.
En tareas episódicas, el tratamiento del estado terminal merece una prueba específica. El objetivo de la última transición debe usar valor futuro cero cuando así está definido. Reiniciar el entorno no significa que el primer estado del episodio siguiente continúe el retorno del anterior. Confundir ambas cosas puede propagar recompensas entre episodios indebidamente.
Las políticas aleatorias requieren documentar el generador y evaluar varias realizaciones cuando la variabilidad importa. Una sola trayectoria favorable no estima el rendimiento esperado. Sin embargo, repetir miles de veces un programa incorrecto tampoco lo valida. Las comprobaciones deterministas y las evaluaciones estadísticas cumplen funciones complementarias.
La comparación entre algoritmos debe igualar las oportunidades relevantes (número de interacciones, información disponible y criterios de evaluación). Si uno recibe resultados de todas las acciones y otro solo de la elegida, sus curvas no aíslan la diferencia entre reglas de aprendizaje. Si uno hace planificación adicional, conviene informar también el costo computacional.
Para nuestro ejemplo de dos dispositivos, podemos registrar recompensa acumulada, número de visitas por acción y error de las estimaciones respecto de probabilidades conocidas. Estas medidas distinguen aprendizaje insuficiente, exploración costosa y ejecución de una política ya informada. Una única cifra final puede ocultar esas diferencias.
Otra comprobación usa el valor esperado de la actualización. Si una acción recibe recompensas independientes con media , se visita repetidamente con tasa constante y parte de cero, su estimación media después de visitas es . Para A, con media 0,8 y tasa de un medio, las medias de las tres primeras estimaciones son 0,4; 0,6 y 0,7. Estas medias resumen muchas secuencias posibles; una trayectoria particular puede apartarse de ellas. Comparar promedios simulados con esta expresión verifica la actualización estocástica sin exigir que cada realización coincida con su esperanza. La prueba debe imponer visitas a esa acción para que la selección adaptativa no cambie inadvertidamente el condicionamiento usado en el cálculo.
La verificación prepara la interpretación. Primero comprobamos que el código implementa las reglas declaradas; después preguntamos cómo se comportan esas reglas; finalmente evaluamos si ayudan a explicar el sistema que interesa. Saltar cualquiera de esos pasos debilita las conclusiones.
253.10. Aprender consecuencias dentro de un modelo explícito
El aprendizaje por refuerzo es una forma precisa de estudiar cambios de decisión a partir de experiencia evaluativa. Su fuerza está en separar interacción, recompensa, retorno, estimaciones y política. Esa separación permite construir modelos pequeños, calcular sus trayectorias y ampliar después la complejidad sin perder de vista qué función cumple cada componente.
En el problema de dos opciones, actualizar un valor consistía en corregirlo hacia una recompensa observada. La política determinaba qué opción producía la siguiente experiencia. Cuando introdujimos estados, la acción adquirió valor por sus consecuencias posteriores y apareció la necesidad de estimar retornos. Las diferencias temporales permitieron propagar información mediante predicciones intermedias.
Cada ampliación añadió supuestos. Las probabilidades podían permanecer constantes o cambiar; el estado podía observarse completamente o solo parcialmente; la recompensa podía representar bien el objetivo o dejar consecuencias fuera. Un resultado favorable depende de esas condiciones, de modo que no debe atribuirse a una capacidad abstracta de aprender cualquier tarea.
El término refuerzo tampoco reemplaza una explicación causal detallada de una conducta. Observar repetición después de un resultado favorable es un punto de partida. Identificar un mecanismo requiere comparar reglas, examinar la información disponible y probar predicciones que las distingan. Los parámetros solo adquieren significado dentro de esa comparación.
Una descripción reproducible declara valores iniciales, tasas, política, secuencia de actualizaciones y criterio de finalización. También identifica qué recibe el agente y qué conoce únicamente el investigador. Estas decisiones determinan el problema efectivo que resuelve el programa y permiten entender por qué dos implementaciones aparentemente similares divergen.
El siguiente capítulo desarrollará la relación entre valores, políticas y ecuaciones de Bellman. Allí expresaremos de manera recursiva cómo una decisión conecta recompensa inmediata y futuro. La recursión servirá para evaluar una política y para comparar acciones, sin borrar la distinción entre definir una solución y aprenderla de la experiencia.
El módulo busca mecanismos explícitos que puedan calcularse, contrastarse y descartarse cuando sus predicciones no coincidan con la evidencia, sin pretender reducir toda conducta a una tabla de valores. Esa posibilidad de comparación hace del aprendizaje por refuerzo una herramienta científica.
Referencias
[1] Sutton, R. S., y Barto, A. G. (2018). Reinforcement Learning: An Introduction, 2.ª edición. MIT Press. Página de los autores.
[2] Sutton, R. S. (1988). Learning to predict by the methods of temporal differences. Machine Learning, 3, 9–44. DOI.
[3] Watkins, C. J. C. H., y Dayan, P. (1992). Q-learning. Machine Learning, 8, 279–292. DOI.