Módulo 26. Agentes adaptativos y aprendizaje
255.1. Dos formas de aprovechar una experiencia
Una experiencia puede modificar directamente la valoración de una acción o cambiar una representación de cómo funciona el entorno. En el primer caso, el agente puede conservar que una elección suele resultar conveniente sin representar explícitamente todas sus consecuencias. En el segundo, puede aprender qué estados siguen a cada acción y usar esa información para calcular decisiones nuevas.
Esta distinción organiza la comparación entre aprendizaje libre de modelos y aprendizaje basado en modelos. En su uso habitual, la expresión libre de modelos indica que el procedimiento no necesita un modelo explícito de transiciones y recompensas para hacer la actualización considerada, aunque puede tener supuestos, memoria y representaciones.
Un agente basado en modelos conserva alguna representación de consecuencias que permite planificar. Puede conocerla de antemano, aprenderla mediante experiencia o combinar conocimientos previos con datos. Esa representación no tiene por qué copiar exhaustivamente el mundo; puede ser una tabla pequeña, una función predictiva o un simulador aproximado.
Un agente libre de modelos puede aprender directamente valores de acciones o una política. Cuando cambia el entorno, esas cantidades suelen requerir experiencia relevante o mecanismos adicionales para actualizarse. Sin embargo, no conviene convertir esta observación en una oposición absoluta entre agentes flexibles e inflexibles. Hay arquitecturas intermedias y múltiples formas de reutilizar experiencia.
La arquitectura Dyna de Sutton integró interacción real, aprendizaje de un modelo y actualizaciones a partir de experiencias simuladas [1]. Con ella, Sutton mostró que planificación y aprendizaje no tienen que ocupar sistemas completamente separados. Una misma actualización de valor puede recibir transiciones observadas o generadas por un modelo.
En estudios de conducta se han usado tareas de varios pasos para contrastar predicciones de procedimientos basados y libres de modelos [2]. La interpretación de sus resultados exige comparar algoritmos concretos, porque una misma respuesta puede surgir por rutas computacionales distintas.
Desarrollaremos un ejemplo de revaluación para localizar esas diferencias y después examinaremos costos, errores de modelo y arquitecturas híbridas. El objetivo será comprender qué información puede reutilizar cada procedimiento y qué cambios del entorno requieren nuevas experiencias.
255.2. Un árbol de decisiones con dos resultados
Consideremos un estado inicial S con dos acciones, izquierda y derecha. Izquierda lleva determinísticamente a A y derecha a B, ambas con recompensa inmediata cero. En A hay una única acción, que entrega seis y termina; en B, la única acción entrega cuatro y termina. El descuento es 0,9.
Si el modelo es conocido, izquierda vale 5,4 y derecha, 3,6. Las recompensas de seis y cuatro llegan un paso después de la primera acción, por lo que se multiplican por el descuento una vez. Elegir izquierda maximiza el retorno esperado; no hay incertidumbre de transición en este ejemplo.
Un agente basado en modelos puede conservar que izquierda conduce a A, derecha a B y cada estado final tiene una recompensa determinada. Planificar consiste en combinar esas relaciones. Si el problema es pequeño, puede recalcular ambos valores antes de cada decisión. Si es grande, quizá necesite limitar la búsqueda.
Un agente libre de modelos puede conservar directamente valores de izquierda y derecha en S. Después de suficiente experiencia y con un procedimiento apropiado, puede aproximarse a 5,4 y 3,6 sin representar explícitamente la estructura completa del árbol. En condiciones estables, ambos agentes pueden elegir lo mismo.
La coincidencia conductual inicial no identifica una arquitectura. Cien elecciones de izquierda podrían ser compatibles con planificación repetida, un valor almacenado, una regla fija o una preferencia instruida. Para distinguirlas necesitamos modificar alguna relación y observar cómo se transfiere el cambio.
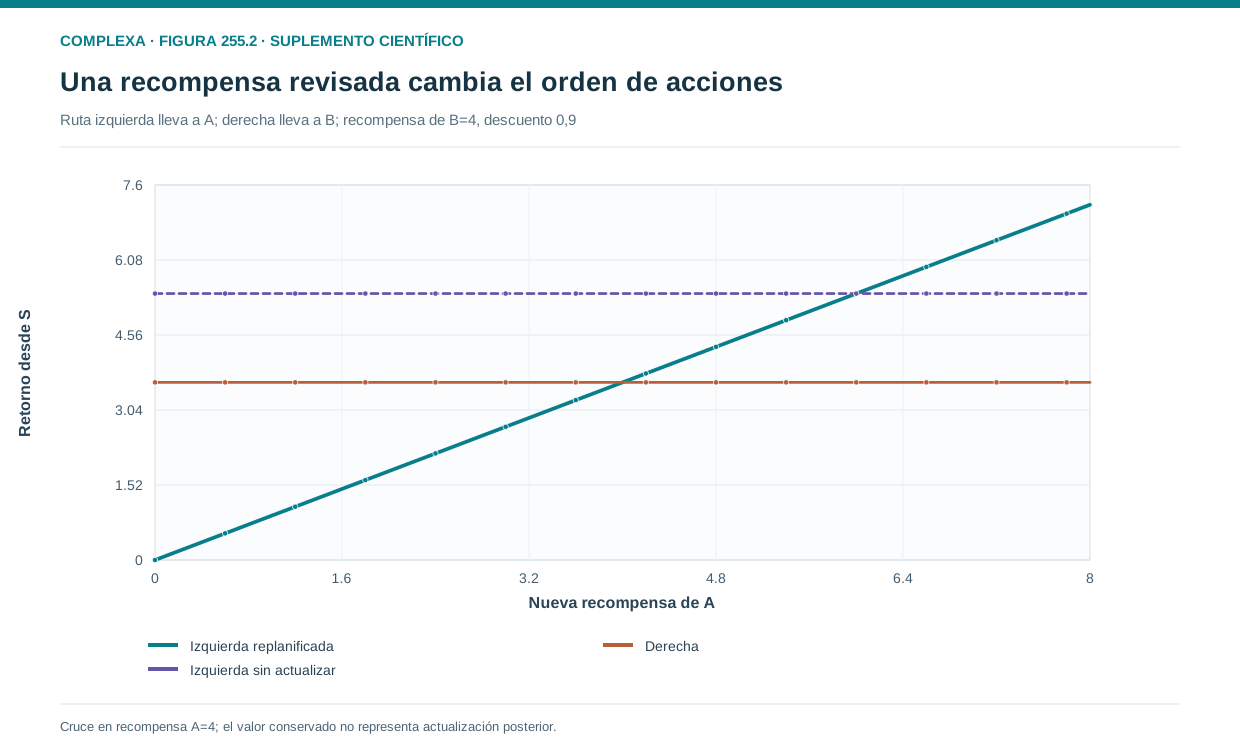
Supongamos que presentamos A de manera aislada y su recompensa cambia de seis a uno. El agente aprende ese nuevo resultado sin volver todavía a S. La transición de izquierda hacia A permanece igual. En la próxima visita a S, ¿cambiará su elección antes de experimentar de nuevo izquierda?
Un agente que dispone del modelo correcto y planifica con la recompensa revisada calcula izquierda con valor 0,9 y derecha con 3,6. Cambia a derecha inmediatamente. Un agente que conserva los valores iniciales de S y no los actualiza fuera de experiencia directa seguirá prefiriendo izquierda.
Esta diferencia solo es nítida si se cumplen ciertas condiciones. El primer agente debe reconocer A como el mismo estado, confiar en la nueva información y hacer el cálculo. El segundo debe carecer de reproducción interna u otro mecanismo que propague la actualización.
255.3. Revaluar recompensas y revaluar transiciones
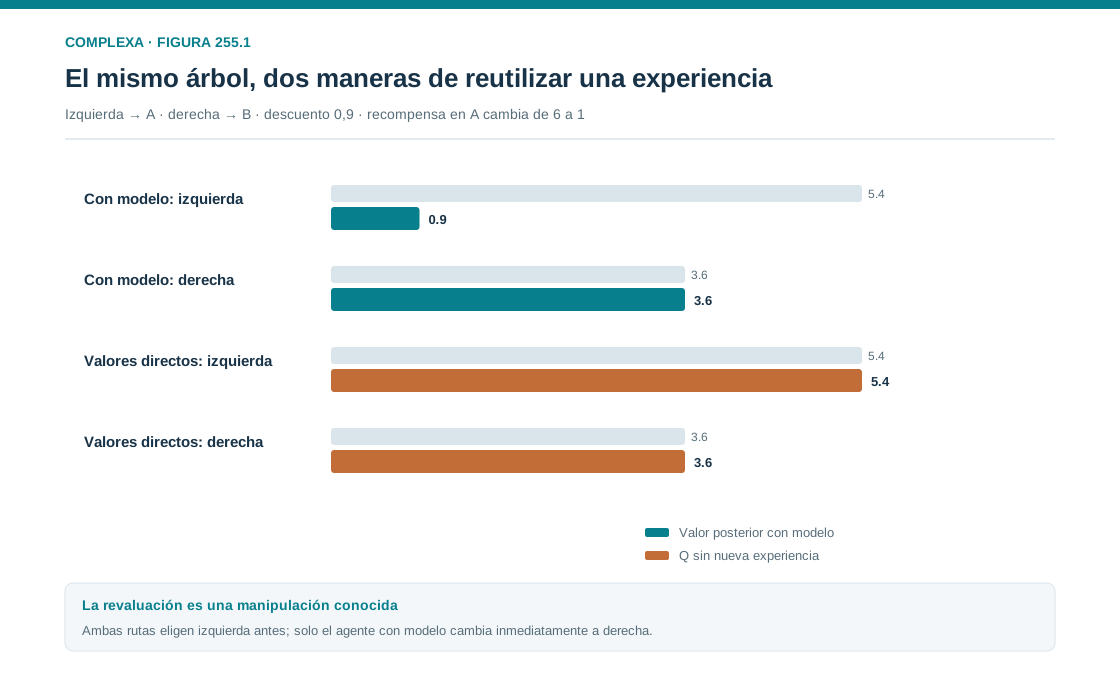
Cambiar una recompensa y cambiar una transición no son intervenciones equivalentes. Un agente puede representar por separado qué resultados espera y cuánto valen, pero conservar una descripción rígida de cómo llegar a ellos. Otro puede actualizar rutas con facilidad y mantener una valoración antigua de sus consecuencias. La flexibilidad debe evaluarse respecto de la modificación concreta.
En nuestro árbol, reducir la recompensa de A modifica una propiedad del resultado. Si el agente conoce esa reducción y conserva la ruta hacia A, puede combinar ambas informaciones; es un ejemplo de revaluación de recompensa. El comportamiento posterior informa sobre transferencia entre una experiencia local y una decisión anterior.
Ahora mantengamos recompensas de seis en A y cuatro en B, pero intercambiemos las transiciones, de modo que izquierda lleve a B y derecha a A. Si el agente recibe información fiable sobre ese intercambio y puede actualizar su modelo, la mejor acción pasa a ser derecha. Los valores almacenados de las acciones iniciales quedan desactualizados.
Podemos diseñar una intervención en la que el agente observe el cambio de transición sin recibir recompensas nuevas. Así separamos el aprendizaje sobre la estructura del aprendizaje sobre la valoración. La respuesta posterior permite examinar si combina ambos componentes o necesita repetir la secuencia completa para modificar su elección.
Una tercera modificación cambia qué acciones están disponibles. Si el acceso a A queda bloqueado, planificar con un modelo que todavía incluye esa ruta produce una elección inviable. Conocer bien las recompensas no compensa una representación incorrecta de restricciones, porque la planificación solo es tan útil como los elementos relevantes del modelo.
También puede cambiar la identidad del estado. Si una señal nueva hace que el agente interprete A como una situación distinta, quizá no transfiera la recompensa revisada a la ruta original. Esa falta de transferencia podría deberse a una representación contextual aun cuando el agente planifique. El diseño debe verificar qué situaciones trata el agente como equivalentes.
Las pruebas de revaluación son informativas porque separan componentes que coinciden durante la adquisición. Sin embargo, ninguna respuesta aislada demuestra una arquitectura completa. Un procedimiento con memoria de transiciones, un sistema de reproducción de experiencias y una regla de generalización pueden generar adaptaciones parecidas.
La comparación más sólida combina varias intervenciones (recompensa, transición, disponibilidad y contexto). Un modelo debe predecir dónde se transferirá el cambio y dónde no. Esa pauta restringe mecanismos mejor que una clasificación binaria basada en una única tarea.
255.4. Aprender un modelo también cuesta
Un modelo del entorno debe adquirirse, almacenarse y revisarse. Si hay muchos estados y acciones, observar todas las transiciones puede ser costoso. Un agente puede conocer muy bien regiones frecuentes y tener información escasa sobre otras. Planificar con una tabla no convierte automáticamente esas regiones desconocidas en conocidas.
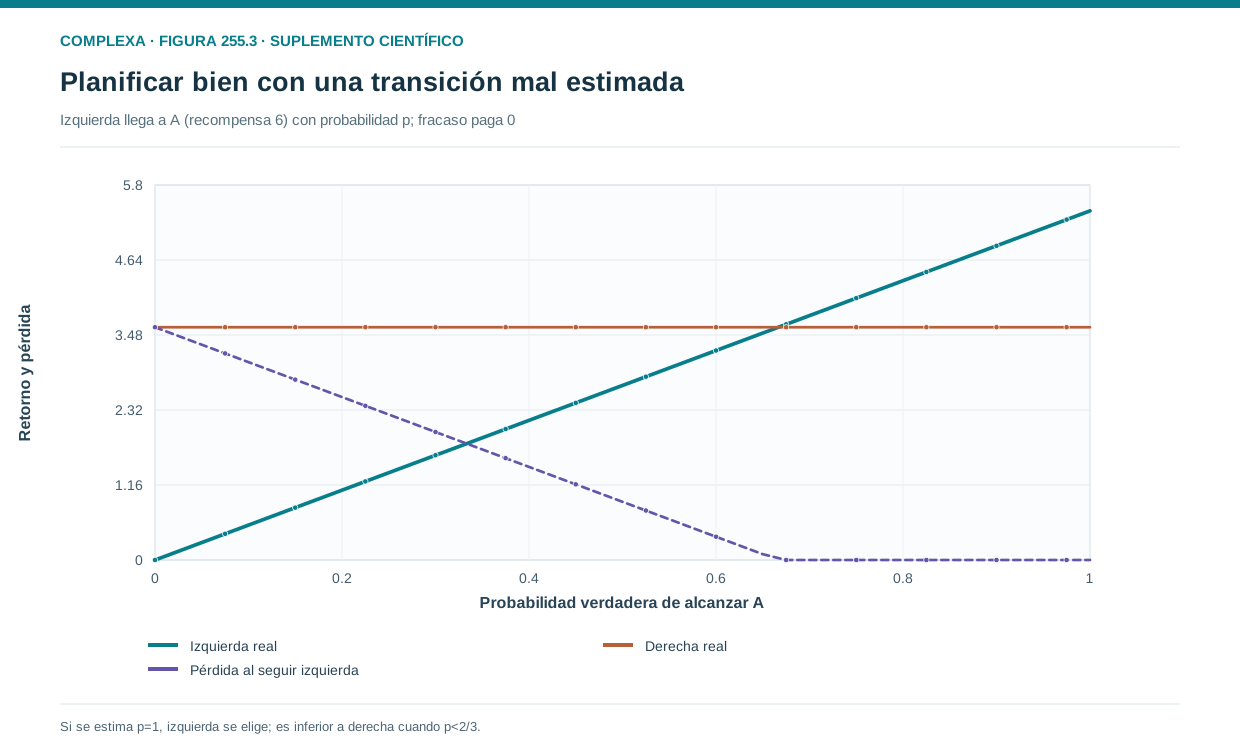
Supongamos que izquierda conduce a A con probabilidad desconocida y a un estado sin recompensa en los demás casos. Después de dos éxitos, una estimación ingenua asignaría probabilidad uno a A. Esa estimación reproduce los datos observados, pero expresa una seguridad excesiva. La incertidumbre sobre transiciones debe distinguirse de la aleatoriedad que persiste aun con probabilidades conocidas.
Un modelo puede incorporar distribuciones sobre sus parámetros, intervalos o procedimientos de regularización. Estas herramientas modifican qué decisiones se consideran prometedoras y qué experiencias conviene buscar. La planificación bajo incertidumbre sobre el modelo es un problema más amplio que sustituir cada probabilidad por una estimación puntual.
Los errores también pueden acumularse al proyectar muchas transiciones. Una pequeña desviación en cada paso puede producir trayectorias poco realistas después de un horizonte largo. Aunque las predicciones de un paso sean razonables en promedio, debemos comprobar cómo se comportan cuando el modelo usa sus propias salidas para seguir simulando.
El agente puede planificar en regiones que apenas visitó. Allí una función aproximadora puede predecir recompensas altas por extrapolación incorrecta. La optimización encuentra esas predicciones y las explota, aunque no correspondan al entorno real. Mejorar la búsqueda dentro de un modelo equivocado puede intensificar el problema.
La evaluación debe incluir calibración de transiciones, errores de recompensa y desempeño de la política al ejecutarse fuera del simulador aprendido. También conviene examinar qué estados visita la política resultante. Una buena precisión promedio sobre datos antiguos no garantiza precisión en la distribución inducida por nuevas decisiones.
Podemos cuantificar un error de transición en el árbol. Supongamos que izquierda alcanza A con probabilidad p y, si falla, llega a un estado que entrega cero un paso después; A conserva su recompensa de seis y derecha sigue llevando a B, con recompensa cuatro. El valor de izquierda es 5,4 veces p y supera 3,6 solo cuando p es mayor que dos tercios. Si el modelo estima p igual a uno, elegirá izquierda; si la probabilidad verdadera es un medio, esa elección vale 2,7 y pierde 0,9 respecto de derecha. La planificación puede ser exacta y la decisión resultar inferior porque la entrada estaba equivocada.
Esta frontera indica qué información conviene obtener. Si las estimaciones plausibles de p están todas muy por encima de dos tercios, una precisión adicional pequeña quizá no cambie la acción. Si atraviesan el umbral, observar más transiciones puede cambiar la decisión. La importancia decisional de un error depende de su magnitud y también de su posición respecto de las alternativas competidoras.
El costo computacional es otro componente. Un modelo correcto puede requerir demasiado tiempo para explorar consecuencias antes de actuar. Limitar profundidad, número de simulaciones o amplitud de búsqueda convierte la planificación en una aproximación que necesita documentación propia.
Por tanto, comparar aprendizaje basado y libre de modelos exige contar experiencia real y cálculo interno. Un agente puede ahorrar interacciones mediante más planificación, mientras otro actúa rápidamente después de una adquisición extensa. El criterio adecuado depende del costo relativo de experimentar, almacenar y calcular.
255.5. Actualizaciones directas y reutilización de experiencia
En una actualización libre de modelos, una transición observada puede modificar el valor de una acción sin construir explícitamente una distribución de estados siguientes. Q-learning usa recompensa, estado siguiente y valores estimados para formar un objetivo. La experiencia es una muestra de consecuencias y la actualización aproxima una relación de optimalidad bajo condiciones específicas.
En el árbol determinista, un agente puede aprender primero el valor de A y después propagarlo hacia la acción izquierda cuando vuelve a recorrer esa transición. Si la recompensa de A cambia durante una presentación aislada, el valor de A se modifica, pero el valor de izquierda en S no cambia automáticamente si nunca se actualiza esa relación.
Ahora bien, si el agente conserva la transición S–izquierda–A y la reproduce internamente, puede actualizar el valor de izquierda sin volver físicamente a S. Ese procedimiento reutiliza memoria. Según la arquitectura y la terminología elegida, puede acercarse a planificación o a aprendizaje con reproducción de experiencias.
Por eso no debemos identificar libre de modelos con aprendizaje exclusivamente durante la acción presente. Un algoritmo puede repetir transiciones almacenadas, ordenar actualizaciones por prioridad y usar representaciones que permiten generalizar. Estas capacidades cambian la rapidez con que una información local alcanza decisiones anteriores.
Sin embargo, reproducir datos antiguos no elimina los problemas de distribución e información. Si una transición dejó de existir, repetirla sin revisar su vigencia refuerza un modelo implícitamente desactualizado. Si los datos proceden de una política muy diferente, ciertos métodos requieren correcciones para evaluar la política actual.
Un agente puede almacenar valores y actuar con rapidez una vez aprendidos. Esa ventaja de ejecución no implica que adquirirlos haya sido barato. Una tabla puede requerir muchas visitas para representar correctamente acciones raras. La comparación entre arquitecturas debe separar costo de aprendizaje y costo de decisión.
También importa la generalización entre estados. Una representación compartida puede transferir una actualización a situaciones relacionadas sin un modelo explícito de transiciones, de modo que la falta de un simulador interno no significa ausencia de estructura. Esa transferencia puede ser útil o producir interferencia.
La descripción adecuada identifica exactamente qué se almacena y qué operaciones se hacen después de una experiencia. Etiquetar el sistema antes de describir esas operaciones puede ocultar mecanismos decisivos para interpretar su flexibilidad.
255.6. Dyna y la combinación de experiencia real y simulada
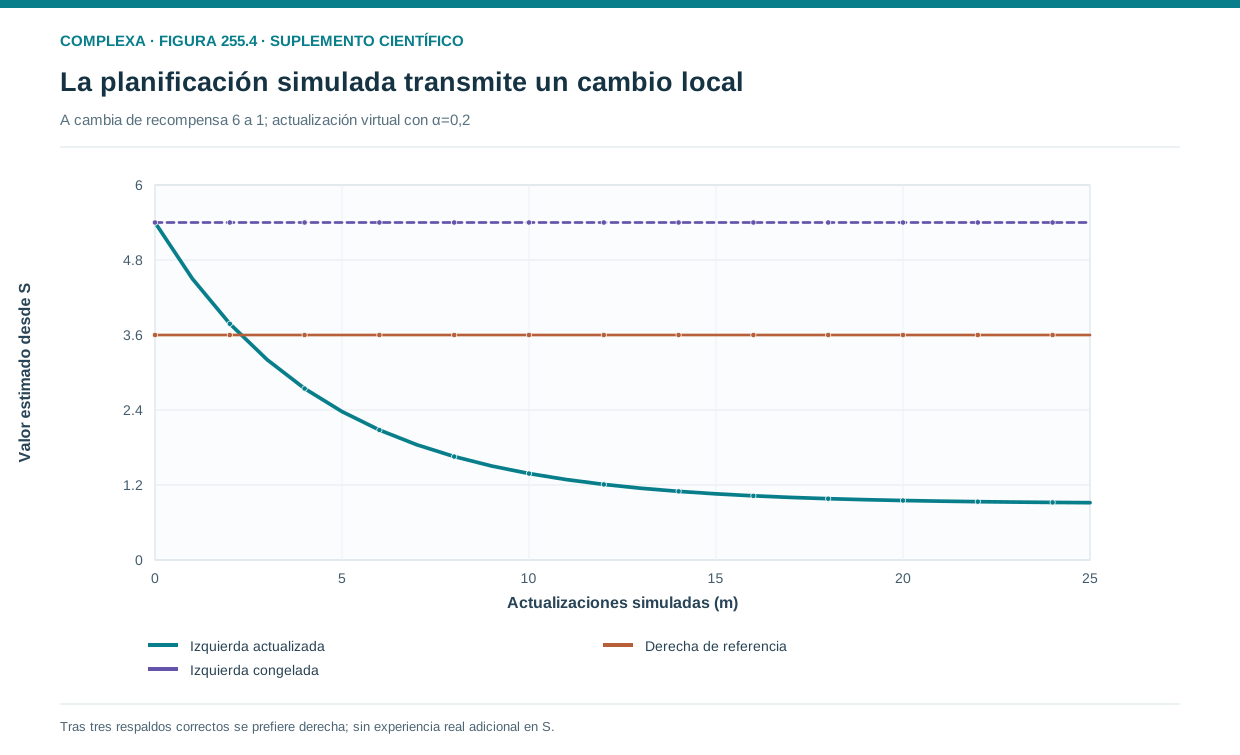
Dyna integra la acción en el entorno, el aprendizaje a partir de la transición observada y el uso de un modelo para generar actualizaciones adicionales [1]. Así, cada experiencia real puede influir varias veces sobre los valores y quizá reducir la interacción necesaria para propagar información.
Una versión sencilla conserva, para cada par estado–acción observado, una recompensa y un estado siguiente estimados. Después de una transición real, actualiza el valor correspondiente y modifica el modelo. Luego selecciona pares almacenados y aplica actualizaciones usando sus consecuencias simuladas. En un entorno determinista, el último resultado observado puede usarse como modelo elemental.
En nuestro árbol, después de aprender que A entrega uno, el modelo de recompensa de A se revisa. Si la planificación vuelve a simular la ruta desde S hacia A y la salida de A, puede propagar ese cambio hacia izquierda. El agente puede elegir derecha en la siguiente visita a S aunque no haya recorrido físicamente izquierda desde la modificación.
El orden de las actualizaciones influye en la propagación. Si se revisa primero el valor de A y después el de izquierda, el cambio se propaga en una ronda; si se actualiza izquierda antes de modificar A, puede requerir otra. La cantidad de simulaciones no describe completamente la eficacia de planificación, porque también importa qué transiciones reciben atención.
Una planificación priorizada puede concentrar cálculo donde un cambio de valor afecta a predecesores relevantes. Ese principio usa la estructura del problema, pero necesita información sobre conexiones y criterios de prioridad. No debemos atribuir sus ventajas a cualquier selección aleatoria de experiencias simuladas.
Cuando el entorno se modifica, Dyna debe detectar la modificación y actualizar el modelo. Si una acción nunca vuelve a probarse, su representación puede permanecer antigua. Por mucho que se planifique con esa representación, el cambio externo no se revela; la arquitectura sigue necesitando exploración y observaciones informativas.
Dyna también admite modelos probabilísticos, que asignan probabilidades a varias transiciones posibles. En ese caso, simular requiere muestrear consecuencias o calcular expectativas. La incertidumbre de estimación y el ruido de simulación se añaden al análisis. Un modelo determinista aplicado a resultados variables puede confundir una observación reciente con una regla estable.
Actuar, aprender y planificar pueden compartir componentes; la clasificación de un sistema debe reflejar esa organización. Vista de forma aislada, una actualización de valor no revela si el dato procede del mundo, de una memoria o de una simulación generada internamente.
255.7. Representaciones intermedias y flexibilidad desigual
Entre una tabla de valores completamente almacenados y un modelo detallado de cada transición hay representaciones intermedias. Algunas conservan expectativas sobre qué estados se visitarán en el futuro. Otras aprenden fragmentos de políticas, subobjetivos o rutas frecuentes. Estas estructuras pueden reutilizar experiencia de manera selectiva y producir perfiles de flexibilidad diferentes.
La representación sucesora propuesta por Dayan describe ocupaciones futuras esperadas de estados bajo una política [4]. Al combinar esas expectativas con las recompensas de cada estado, puede calcular valores. La separación entre ocupación y recompensa permite actualizar ciertas valoraciones sin reaprender toda la estructura temporal, siempre que esa estructura siga siendo pertinente.
En nuestro árbol, una representación que conserva que izquierda conduce a A puede modificar su valor cuando cambia la recompensa de A. Esa transferencia se parece a la de un modelo completo en esta tarea sencilla. Si, por el contrario, cambian transiciones que alteran las ocupaciones futuras, la representación almacenada también necesita revisión.
La distinción ayuda a evitar una inferencia apresurada, porque la sensibilidad a la revaluación de recompensa no demuestra necesariamente planificación exhaustiva mediante un modelo de un paso. Un agente puede conservar información suficiente para esa modificación y resultar menos flexible ante otras. Las intervenciones deben explorar varias dimensiones.
Las representaciones comprimidas intercambian detalle por eficiencia. Si muchas rutas comparten estados futuros, un resumen puede reutilizar regularidades. Si una intervención rompe esa estructura, la compresión puede ocultar diferencias decisivas. No hay una representación universalmente suficiente para todos los cambios posibles.
También pueden coexistir valores aprendidos y planificación limitada. Un agente puede usar valores almacenados para estimar el final de una búsqueda corta; ese procedimiento no es puramente retrospectivo ni explora todo el futuro desde cero. La calidad depende tanto de la búsqueda como de las estimaciones terminales.
Otra arquitectura decide cuándo planificar según incertidumbre o costo. Daw, Niv y Dayan desarrollaron un modelo de competencia entre formas de control que incorpora incertidumbre [3]. Su propuesta es una hipótesis computacional específica; no autoriza a localizar toda decisión flexible en una única región cerebral ni toda repetición en otra.
La diversidad de arquitecturas aconseja describir capacidades en términos operativos. ¿Puede incorporar una recompensa nueva? ¿Puede reorganizar una ruta? ¿Necesita experimentar desde el comienzo? ¿Cuánto cálculo adicional usa? Estas preguntas producen comparaciones más informativas que una clasificación rígida entre dos tipos de agente.
255.8. Conducta dirigida a metas, hábitos y cautela inferencial
En investigación conductual, la conducta dirigida a metas y el hábito suelen distinguirse por su sensibilidad a consecuencias y contingencias. En modelos computacionales, basado en modelos y libre de modelos describen la organización de la información y su actualización. Las dos parejas pueden conectarse mediante hipótesis, pero sus definiciones no coinciden.
Una conducta insensible a una modificación puede tener varias causas. El agente quizá no percibió el cambio, no lo generalizó al contexto de prueba, no tuvo tiempo de planificar o consideró incierta la información. También puede conservar una respuesta aprendida que no incorpora el nuevo valor. La interpretación requiere descartar alternativas pertinentes.
Del mismo modo, una elección flexible puede proceder de una regla sencilla instruida. Si alguien recibe explícitamente la orden de cambiar de izquierda a derecha, no necesitamos inferir reconstrucción detallada del modelo. La tarea debe exigir combinar información de una manera que distinga las hipótesis propuestas.
Daw y colaboradores usaron una tarea de decisiones en dos etapas para estudiar influencias de modelos sobre elecciones y señales de error de predicción [2]. El diseño cruza resultados y tipos de transición para separar predicciones de algoritmos concretos. Esa tarea no es una prueba universal que clasifique cualquier conducta humana con una sola medida.
En una simulación podemos verificar que un patrón aparece bajo un algoritmo y desaparece bajo otro. En datos empíricos deben considerarse estrategias alternativas, comprensión de instrucciones y parámetros no identificados. Una pauta agregada puede ocultar mezclas de procedimientos entre individuos o cambios dentro de una misma persona.
Una respuesta rápida tampoco es necesariamente un hábito. Un cálculo puede ser rápido porque el problema es pequeño o porque hay experiencia previa. Una respuesta lenta puede reflejar dificultad perceptiva, incertidumbre o conflicto sin planificación prospectiva. Tiempo de respuesta y elección deben interpretarse dentro de un modelo del proceso.
Con estas precauciones podemos afirmar, por ejemplo, que bajo las condiciones de la tarea los datos favorecen cierto mecanismo frente a las alternativas examinadas, formulación más informativa que convertir un parámetro ajustado en una etiqueta permanente del agente.
En fenómenos cotidianos rige la misma disciplina. De la persistencia de una rutina no se deduce una arquitectura libre de modelos; para explicar esa persistencia necesitamos identificar información, oportunidades de cambio y mecanismos que mantienen la conducta.
255.9. Un protocolo comparativo reproducible
Podemos construir tres agentes para el árbol S–A–B. El primero conserva valores de acciones y solo actualiza con transiciones experimentadas en el momento. El segundo conserva transiciones y recompensas exactas aprendidas y recalcula valores antes de cada elección. El tercero combina valores con un modelo y hace un número declarado de actualizaciones simuladas.
Durante la adquisición, los tres reciben las mismas oportunidades de observar ambas rutas. Si queremos aislar la arquitectura de actualización, podemos imponer una secuencia de entrenamiento común. Si dejamos que elijan libremente, la distribución de experiencia también será parte de la comparación y deberá registrarse.
Después reducimos la recompensa de A de seis a uno y presentamos A aisladamente. Debemos indicar cuántas observaciones recibe cada agente y qué tasa usa para incorporar el cambio. Una tasa menor que uno en un entorno determinista puede conservar temporalmente parte del valor antiguo, incluso en un agente que dispone de modelo.
La prueba posterior se hace en S, antes de nuevas experiencias de las rutas. El primer agente mantiene sus valores iniciales si ninguna operación los modificó. El segundo puede recalcular izquierda como 0,9 y derecha como 3,6. La respuesta del tercero dependerá de qué actualizaciones simuladas hizo y en qué orden.
Por ejemplo, si la estimación de recompensa de A comienza en seis y se actualiza hacia uno con tasa de un cuarto, después de una observación vale 4,75; incluso una planificación exacta todavía asignaría 4,275 a izquierda y la preferiría. Después de dos observaciones, la estimación baja a 3,8125 y el valor inicial correspondiente es 3,43125, inferior al de derecha. Así, con una estimación gradual, una arquitectura basada en modelos puede tardar una experiencia adicional en cambiar de elección, de modo que ese retraso es compatible con la planificación.
Esta predicción es condicional; se deduce del protocolo sin haberlo ejecutado. Para convertirla en experimento computacional debemos implementar las reglas, registrar estados internos y verificar cálculos. El pequeño árbol permite hacerlo sin ambigüedad y comparar luego los resultados con las predicciones analíticas.
Podemos repetir la prueba intercambiando transiciones, cambiando solo señales de contexto o limitando el tiempo de planificación. Cada intervención examina una capacidad distinta. Conviene decidirlas antes de observar resultados para no seleccionar solo las condiciones que favorecen una explicación.
Las medidas incluyen primera elección tras revaluación, número de experiencias necesarias para cambiar, recompensa acumulada y operaciones internas realizadas. Contar solo interacciones externas favorece arquitecturas que hacen mucho cálculo oculto; contar solo tiempo de decisión ignora costos de entrenamiento. Ambas dimensiones deben permanecer visibles.
Finalmente, comprobamos que la información nueva llega solo a los componentes previstos. Si el programa modifica directamente todos los valores cuando cambia una recompensa, habrá incorporado propagación perfecta sin declararla. Una prueba de revaluación pierde sentido si la implementación entrega a todos los agentes la solución que pretendía comparar.
255.10. Comparar mecanismos de transferencia
El aprendizaje basado en modelos permite combinar conocimientos sobre transiciones y consecuencias para calcular decisiones. El aprendizaje libre de modelos puede conservar valores o políticas que resumen experiencia sin representar explícitamente esas relaciones. La diferencia se manifiesta sobre todo cuando cambia una parte del problema y preguntamos cómo se transfiere la nueva información.
En condiciones estables, ambos procedimientos pueden alcanzar conductas similares. La revaluación de una recompensa, el cambio de una ruta o una restricción nueva revelan dependencias que la adquisición ordinaria puede ocultar. Sin embargo, interpretar esas pruebas exige describir mecanismos concretos y reconocer arquitecturas intermedias.
Planificar tiene ventajas y costos. Puede ahorrar experiencias y responder con rapidez a información localizada, pero necesita un modelo pertinente y recursos de cálculo. Un modelo equivocado puede producir decisiones sistemáticamente erróneas. Actualizar directamente valores puede ser eficiente durante la ejecución, pero requerir nuevas experiencias para revisar consecuencias anteriores.
Dyna muestra que ambas formas de procesamiento pueden integrarse. La reproducción de experiencia y las representaciones sucesoras amplían las posibilidades. Por eso es preferible preguntar qué información se conserva, cómo se actualiza y qué operaciones la convierten en acción.
Las etiquetas computacionales tampoco sustituyen evidencia sobre conducta humana o mecanismos neurales. Una hipótesis debe predecir diferencias observables frente a alternativas y respetar las limitaciones del diseño. La coincidencia de una elección con un algoritmo no demuestra que el agente ejecute todas sus operaciones.
El capítulo siguiente abordará una decisión que todas estas arquitecturas deben tomar, la de cuándo usar lo aprendido y cuándo buscar información nueva. Un modelo permite planificar con conocimiento existente, pero no revela cambios que nunca se observan. Una tabla de valores permite elegir con rapidez, pero puede conservar errores si ciertas acciones dejan de probarse.
Comprender exploración y aprovechamiento completa, por tanto, la pregunta sobre transferencia. Aprender implica procesar los datos recibidos y también seleccionar qué experiencias producirán los datos siguientes. Esa selección determina qué partes del entorno llegan a ser conocidas y qué incertidumbres permanecen ocultas.
Referencias
[1] Sutton, R. S. (1991). Dyna, an integrated architecture for learning, planning, and reacting. ACM SIGART Bulletin, 2(4), 160–163. DOI.
[2] Daw, N. D., Gershman, S. J., Seymour, B., Dayan, P., y Dolan, R. J. (2011). Model-based influences on humans' choices and striatal prediction errors. Neuron, 69(6), 1204–1215. DOI.
[3] Daw, N. D., Niv, Y., y Dayan, P. (2005). Uncertainty-based competition between prefrontal and dorsolateral striatal systems for behavioral control. Nature Neuroscience, 8, 1704–1711. DOI.
[4] Dayan, P. (1993). Improving generalization for temporal difference learning: The successor representation. Neural Computation, 5(4), 613–624. DOI.