Módulo 26. Agentes adaptativos y aprendizaje
254.1. El futuro puede escribirse de forma recursiva
Una decisión secuencial conecta una consecuencia inmediata con las oportunidades que aparecen después. Si intentamos enumerar de una vez todas las secuencias posibles, el cálculo puede crecer rápidamente. La programación dinámica usa una estructura más sencilla, en la que el valor de la situación actual puede expresarse mediante la recompensa del siguiente paso y el valor de la situación posterior.
La ecuación de Bellman formaliza esa relación como una condición de consistencia entre valores definidos por un objetivo y transiciones definidas por un modelo, aunque por sí sola no es una teoría psicológica ni un algoritmo de aprendizaje. Según cómo tratemos las acciones, puede evaluar una política fija o caracterizar el mejor valor alcanzable [1].
Comenzaremos con un proceso de decisión de Markov finito. En cada estado hay acciones disponibles, una distribución del estado siguiente y una recompensa. La propiedad de Markov significa que el estado elegido resume la información del pasado necesaria para predecir esas consecuencias, una vez especificada la acción. El sistema puede tener historia; la parte relevante de ella queda incorporada en la representación.
Supondremos recompensas acotadas y un factor de descuento estrictamente menor que uno. Estas condiciones permiten definir retornos finitos incluso cuando el proceso continúa indefinidamente. Más adelante examinaremos qué cambia al retirar el descuento o introducir un horizonte finito. Las garantías no deben trasladarse entre formulaciones sin revisar sus supuestos.
El valor de un estado depende de una política, es decir, de cómo se elegirá ahora y en situaciones posteriores. Para dos agentes en el mismo estado físico, ese valor puede ser diferente porque seguirán reglas distintas. Hablar del valor de un estado sin indicar política u optimalidad deja incompleta la descripción.
Una política puede ser determinista o probabilística. En el caso estacionario, depende del estado actual, sin referencia explícita al tiempo. Si quedan pocas oportunidades para actuar, quizá sea necesario incluir el tiempo restante en el estado o usar políticas que cambian con el horizonte. La representación debe contener las variables que afectan la decisión.
Trabajaremos con un ejemplo de dos estados y una terminación. Su tamaño permite calcular valores exactos, comprobar iteraciones y detectar errores de interpretación. La finalidad es comprender la recursión antes de aplicarla a tablas grandes o funciones aproximadas.
254.2. Definir valores de estados y acciones
Sea el retorno descontado desde el instante actual. El valor de un estado bajo una política es la esperanza de ese retorno cuando comenzamos allí y seguimos la política. El valor de una acción añade la condición de ejecutar primero esa acción y seguir después la política.
La diferencia entre ambas cantidades es funcional. El valor de estado promedia la primera elección según la política; el valor de acción permite comparar primeras elecciones manteniendo definido el comportamiento posterior. Una tabla de valores de acciones puede producir una política, pero no debe confundirse con la política misma.
Si conocemos probabilidades de transición y recompensas medias condicionales, podemos calcular el valor de acción como recompensa inmediata esperada más valor descontado del estado siguiente. Cuando la recompensa depende también de la transición, debe permanecer dentro de la suma correspondiente. Separarla incorrectamente puede introducir un promedio que no corresponde al modelo.
Para una política probabilística, el valor del estado es el promedio de los valores de sus acciones ponderado por sus probabilidades. Si dos acciones tienen valores cuatro y diez y se eligen con probabilidades tres cuartos y un cuarto, el valor del estado es 5,5. No es el máximo, porque la política no elige siempre la mejor acción.
El valor óptimo es el mejor retorno esperado alcanzable dentro de la clase de políticas y del modelo definidos. En un problema finito descontado existen políticas estacionarias deterministas óptimas. Esa afirmación no implica que cualquier procedimiento de aprendizaje las encuentre rápidamente ni que el modelo represente fielmente un sistema real.
También conviene distinguir esperanza y garantía. Una acción de valor diez puede producir resultados individuales inferiores a una acción de valor ocho. El criterio esperado combina probabilidades y consecuencias; no asegura que cada trayectoria favorezca la misma elección. Si interesan riesgo, restricciones o probabilidades de fallo, quizá debamos formular otro objetivo.
Los valores tienen unidades. Si la recompensa se mide en puntos por paso, el valor acumula puntos descontados y no es una probabilidad, salvo en problemas construidos especialmente para que lo sea. Presentar un valor de 6,4 como una confianza del sesenta y cuatro por ciento sería un error de interpretación.
Estas definiciones preparan la recursión. Antes de resolverla debemos especificar qué sucede después de cada acción, incluido el tratamiento de la terminación.
254.3. Un problema pequeño completamente especificado
Consideremos los estados S, T y terminal. En S hay dos acciones. Salir produce recompensa dos y termina. Intentar lleva a T con probabilidad de un medio y, con la otra mitad, deja al agente en S; en ambos casos la recompensa es menos uno.
En T también hay dos acciones. Cobrar produce recompensa seis y termina. Mantener produce recompensa uno y deja al agente en T. El descuento es 0,9. El terminal tiene valor cero y no produce nuevas recompensas. Todas las transiciones son independientes del pasado una vez conocidos estado y acción.
El modelo es didáctico. La acción mantener permite recibir una unidad indefinidamente y no consume un recurso que se agote. Esa condición explica parte de sus resultados. Si quisiéramos representar desgaste, tiempo limitado o agotamiento, tendríamos que ampliar el estado y cambiar las transiciones. No podemos añadir esas consecuencias después de resolver el problema y esperar conservar los mismos valores.
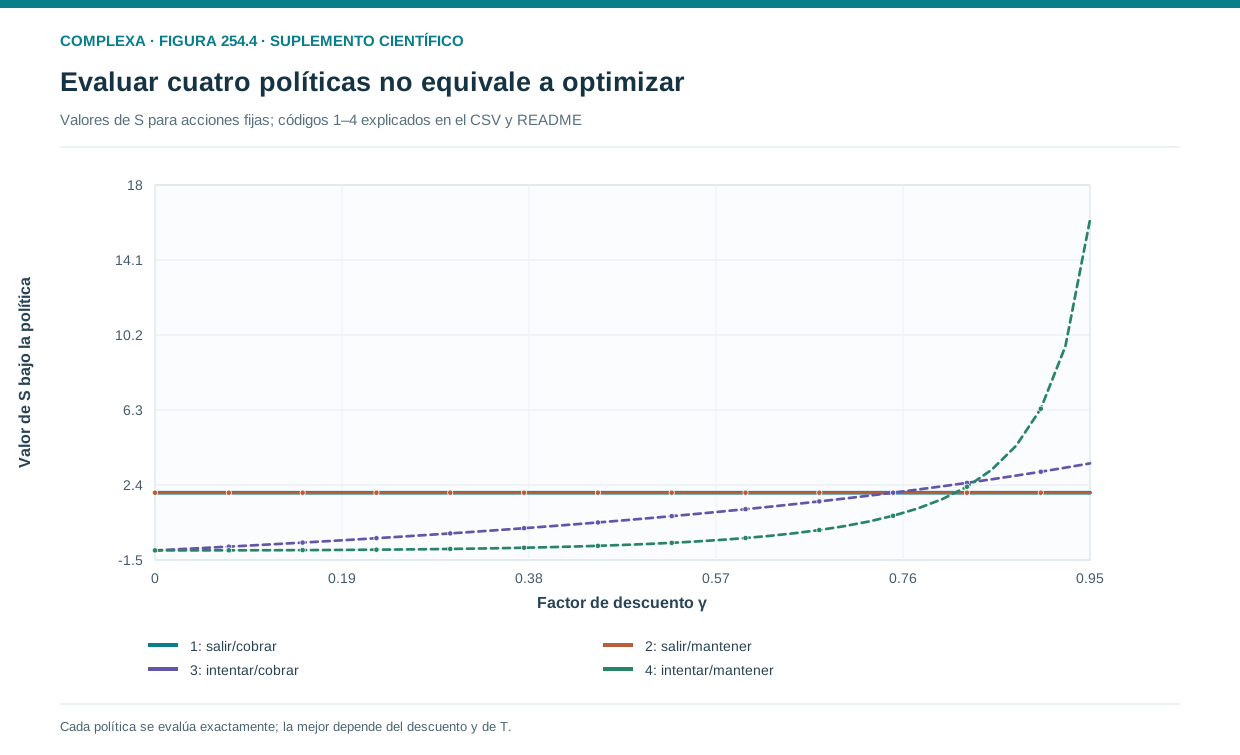
Evaluemos primero una política que sale en S y cobra en T. Sus valores son dos y seis. No hay recursión efectiva porque ambas decisiones terminan de inmediato. Esta política es una referencia sencilla para comprobar la evaluación y preguntar si conviene cambiar alguna acción.
Ahora evaluemos otra que intenta siempre en S y cobra en T. El valor de T permanece en seis y el valor de S satisface
Al resolver, obtenemos , aproximadamente 3,091. La posibilidad de varios intentos fallidos está incorporada en el término que devuelve a S.
Podemos comprobar el resultado por otra vía. El número de intentos hasta llegar a T es geométrico con probabilidad de éxito de un medio. Cada intento cuesta una unidad y el cobro final se descuenta según cuántos pasos hayan transcurrido. Sumar las contribuciones de todas las duraciones posibles produce el mismo valor. La recursión evita escribir esa suma completa.
Para hacer explícita la comprobación, llamemos N al número de intentos. El cobro de seis ocurre después de esos N pasos y su factor de descuento esperado es nueve onceavos. El costo descontado esperado de todos los intentos es veinte onceavos. El retorno es, entonces, seis veces nueve onceavos menos veinte onceavos, es decir, treinta y cuatro onceavos, el mismo valor que da la recursión.
La media de N es dos, pero descontar el cobro con esa duración media no da el cálculo exacto, porque pierde información sobre la distribución de tiempos. El promedio de una función no lineal de una variable aleatoria generalmente no coincide con la función de su promedio. El ejemplo permite localizar ese error sin recurrir a un problema grande, ya que las probabilidades geométricas y la serie descontada son conocidas.
Bajo esta política posterior, intentar (3,091) es mejor que salir (dos). Sin embargo, todavía no hemos optimizado lo que ocurre en T. Evaluar una decisión inicial requiere considerar también si la continuación elegida es adecuada.
254.4. Evaluar una política no es optimizarla
Para una política fija, la ecuación de Bellman promedia las acciones según esa política. En notación matricial, con estados no terminales, podemos escribir
Cuando excluimos el terminal, algunas filas de la matriz de transición pueden sumar menos de uno porque parte de la probabilidad abandona el conjunto representado. Si lo incluimos como estado absorbente, sus transiciones y recompensas deben mantener valor cero. Ambas convenciones pueden ser correctas, siempre que se apliquen de manera coherente.
La expresión con una inversa caracteriza la solución, pero no obliga a calcular explícitamente una inversa numérica. Resolver un sistema lineal o aplicar iteraciones puede ser más conveniente. La elección computacional depende del tamaño, la estructura y la precisión requerida.
En nuestro ejemplo, una política que intenta en S y mantiene en T tiene valor de T igual a , por lo que . El valor de S es igual a , de donde resulta , aproximadamente 6,364.
Estos valores evalúan esa política concreta. Para demostrar optimalidad debemos comprobar si alguna acción alternativa mejora el retorno usando la continuación adecuada. En T, bajo el valor calculado, cobrar vale seis y mantener vale diez. En S, salir vale dos y seguir intentando vale aproximadamente 6,364. Ambas acciones elegidas superan sus alternativas.
La comprobación puede expresarse mediante valores de acción. Bajo esta política, y ; en T, cobrar y mantener tienen valores de acción seis y diez. El valor de cada estado coincide con el de la acción que la política ejecuta.
Si mezclamos acciones, el resultado cambia. Una política que ocasionalmente cobra en T renuncia a parte de la secuencia futura de recompensas. Promediar seis y diez como si fueran premios inmediatos independientes es un error, porque diez ya presupone una continuación de mantener. Para evaluar una mezcla repetida debemos resolver su propia ecuación.
Veamos una mezcla concreta. En cada visita a T, una moneda independiente decide entre mantener y cobrar, con probabilidades iguales. La recompensa inmediata media es 3,5 y la probabilidad de continuar en T es un medio. Su valor satisface V igual a 3,5 más 0,45 veces V y resulta setenta onceavos, aproximadamente 6,364. No coincide con ocho, que sería el promedio ingenuo entre seis y diez.
La diferencia procede de que la moneda vuelve a lanzarse cada vez que se mantiene. Otra política podría lanzar una moneda una sola vez y comprometerse después a cobrar inmediatamente o mantener para siempre. Esa política sí tendría valor esperado ocho al comienzo, pero necesita conservar el compromiso como memoria. Ambas descripciones usan una moneda equilibrada y las mismas acciones; su organización temporal cambia la distribución de trayectorias. Hay que declarar cuándo se aleatoriza, además de con qué probabilidades.
Esta observación previene el error frecuente de combinar valores calculados bajo políticas incompatibles. Cada valor condicional incluye un comportamiento futuro. Cambiar ese comportamiento puede alterar toda la tabla, incluso en estados donde la acción actual permanece igual.
La evaluación de política responde qué ocurrirá si seguimos una regla. La optimización responde qué regla conviene dentro del modelo. Mantener separadas ambas preguntas hace más claro el papel de Bellman.
254.5. La ecuación de optimalidad
La ecuación de optimalidad sustituye el promedio de acciones por un máximo
Cada alternativa combina recompensa inmediata y continuación óptima. El máximo compara esperanzas condicionadas a acciones; no permite escoger retrospectivamente la mejor consecuencia aleatoria después de observarla. Confundir máximo de esperanzas con esperanza de máximos concede al agente información que no tenía al decidir.
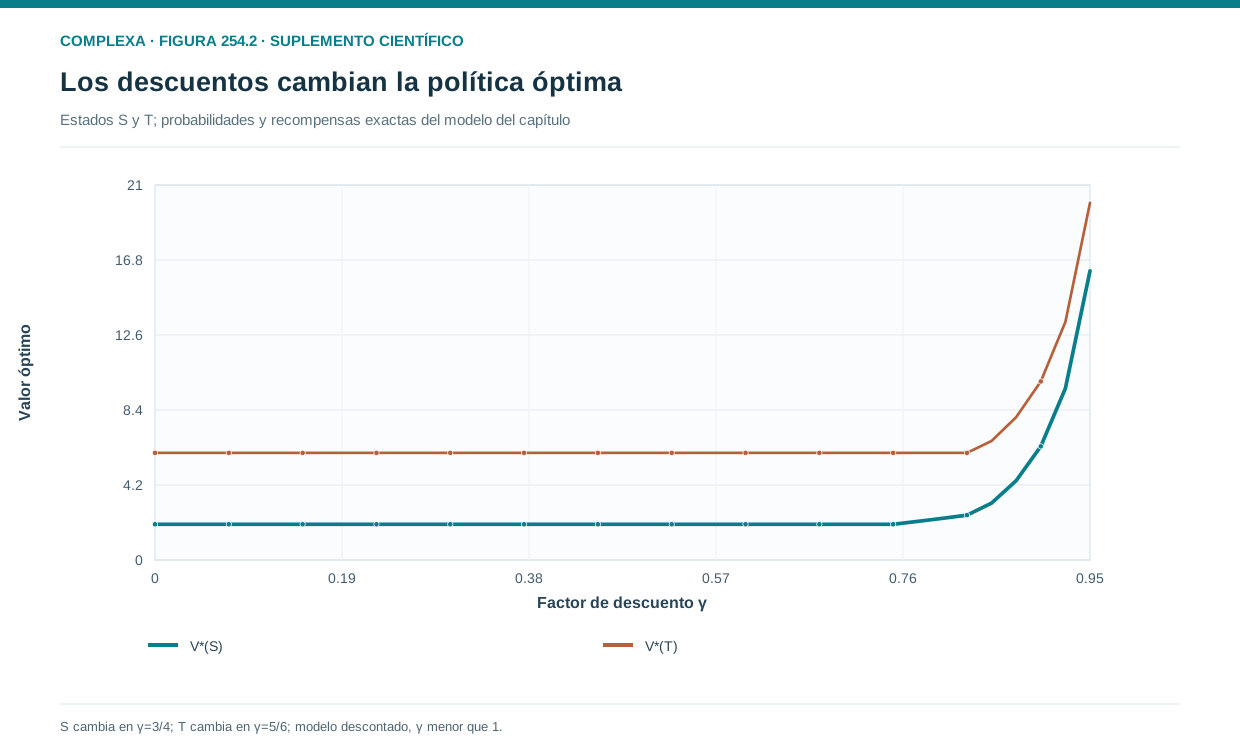
En nuestro problema, las ecuaciones son y . La solución diez para T y para S satisface ambas. La política óptima mantiene en T e intenta en S.
El resultado puede parecer sorprendente si interpretamos cobrar como recibir un premio grande y mantener como demorar innecesariamente, pero el modelo concede una unidad en cada paso sin límite. La suma descontada de esa corriente es diez. La solución depende de las consecuencias que asignamos a las acciones; sus nombres no intervienen.
Cambiar el descuento modifica la comparación. En T, mantener vale si se repite siempre y supera el cobro de seis cuando el descuento es mayor que cinco sextos. Con descuento 0,7, mantener indefinidamente vale aproximadamente 3,333, por lo que cobrar resulta preferible.
Si T se resuelve cobrando, intentar en S repetidamente vale , que supera el valor dos de salir cuando el descuento es mayor que tres cuartos. Con descuento 0,7, salir es mejor. La política óptima puede cambiar de manera abrupta al cruzar umbrales aunque los valores varíen continuamente.
Estos umbrales permiten estudiar sensibilidad. Una recomendación basada en un descuento muy cercano a un punto de cambio puede ser frágil respecto de la especificación del objetivo. Al presentar una acción óptima hay que informar qué supuestos la sostienen.
También hay empates. En los umbrales, varias acciones pueden ser óptimas y diferentes políticas obtener el mismo valor. Una implementación debe definir cómo selecciona entre ellas, especialmente si el desempate afecta otros criterios no incluidos en la recompensa.
La ecuación caracteriza el mejor desempeño dentro del modelo. Saber si el agente conoce las transiciones, si puede calcular la solución y si los parámetros son correctos plantea preguntas adicionales de información, aprendizaje y validación.
254.6. Iteración de valores y error controlado
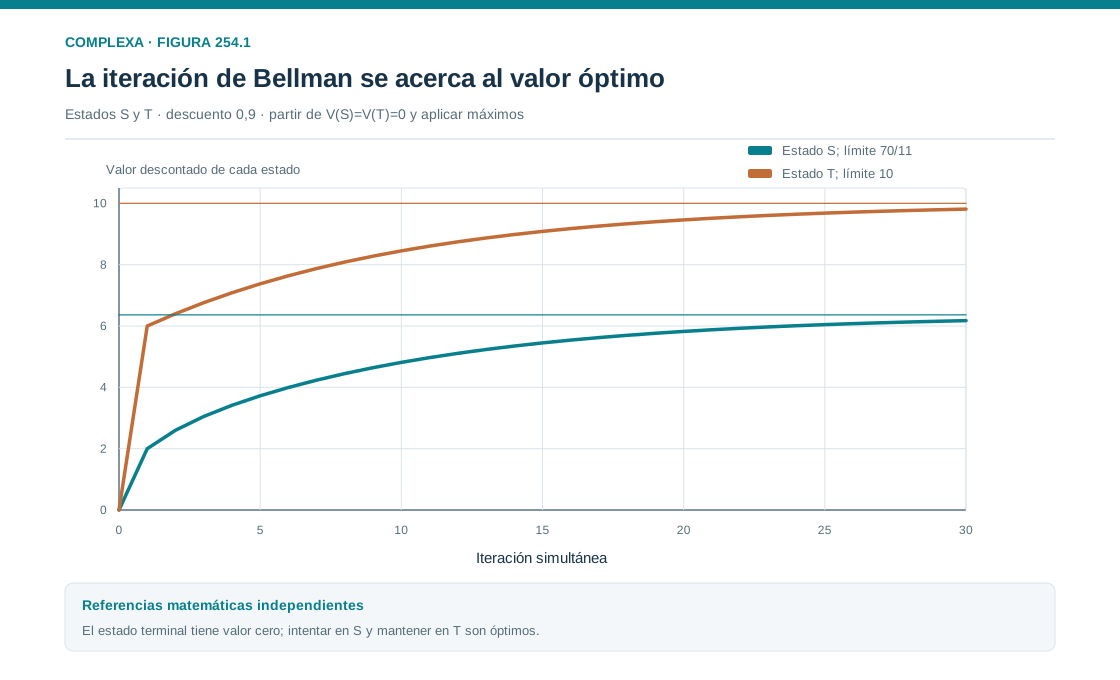
La iteración de valores comienza con una tabla y aplica repetidamente el operador de optimalidad. En un problema finito con descuento menor que uno y recompensas acotadas, ese operador es una contracción en la norma máxima, es decir, reduce las diferencias entre tablas por un factor no mayor que el descuento. Esta propiedad sostiene la convergencia hacia un punto fijo único [2].
Comencemos con valores cero para S y T. La primera actualización produce dos y seis, porque la continuación vale cero y solo cuentan recompensas inmediatas. La segunda produce 2,6 para S y 6,4 para T. La tercera produce 3,05 y 6,76; la cuarta, 3,4145 y 7,084.
Estas cifras usan actualización sincrónica, en la que cada tabla nueva se calcula enteramente a partir de la anterior. Si actualizáramos T primero y usáramos inmediatamente su valor nuevo al actualizar S, obtendríamos otra secuencia. Ambos esquemas pueden converger bajo condiciones apropiadas, pero no son intercambiables al verificar resultados intermedios.
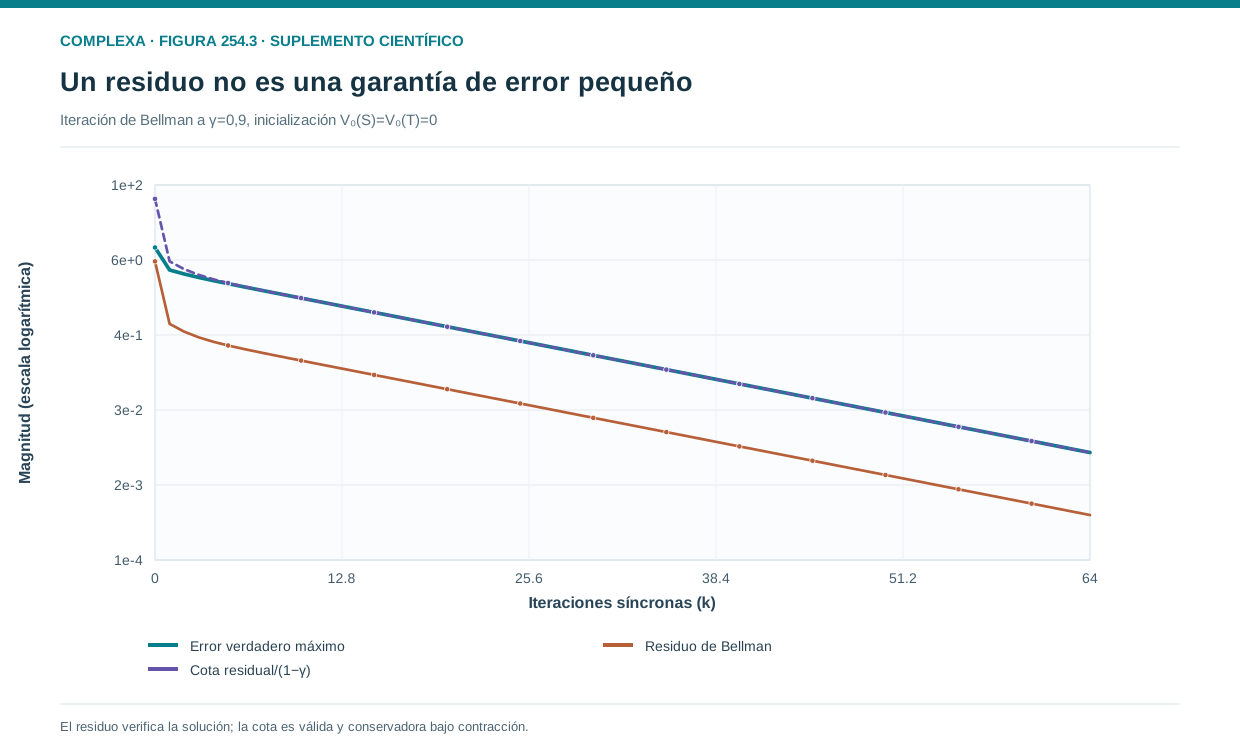
La contracción permite relacionar un residuo con un error. Si la máxima diferencia entre una tabla y su actualización de Bellman es , la distancia máxima a está acotada por . Con descuento 0,9 y residuo 0,01, la cota es 0,1.
La cota puede ser conservadora, pero es una garantía derivada de supuestos explícitos. Para afirmar precisión a partir de una diferencia visualmente pequeña entre iteraciones hay que considerar el descuento. Cuando este se aproxima a uno, el mismo residuo permite un error mayor y la propagación de información puede requerir más iteraciones.
No debemos confundir precisión de valores y precisión de decisiones. Si dos acciones tienen valores casi iguales, una tabla con error pequeño puede seleccionar cualquiera de ellas. Si hay una separación grande entre la mejor acción y las demás, una aproximación moderada puede bastar para elegir correctamente.
La iteración necesita el modelo de transiciones y recompensas para calcular esperanzas. Aprender desde muestras es un problema diferente, aunque pueda usar objetivos inspirados en Bellman. Una actualización basada en una transición observada incorpora ruido que no aparece en el respaldo exacto de toda la distribución.
Para verificar el algoritmo conviene registrar residuos, valores y acciones elegidas. El pequeño ejemplo permite comparar cada iteración con cálculos manuales. En problemas mayores, los casos reducidos con solución conocida siguen siendo útiles para detectar errores antes de interpretar políticas complejas.
254.7. Mejorar una política y volver a evaluarla
La iteración de políticas alterna la evaluación de una regla con la construcción de otra que elige acciones de mejor valor según esa evaluación. En el caso finito descontado, la mejora voraz respecto de una evaluación exacta no empeora el valor. Repetir el procedimiento permite alcanzar una política óptima, con cuidado en el tratamiento de empates.
Partamos de salir en S y cobrar en T. Sus valores son dos y seis. Si usamos esta tabla para evaluar intentar una sola vez en S y después seguir la política anterior, obtenemos . Esta alternativa mejora el valor dos de salir.
En T, mantener una vez y después cobrar vale , superior a seis. Por tanto, la política mejorada intenta en S y mantiene en T. Al evaluarla de nuevo, obtenemos aproximadamente 6,364 y diez. En este ejemplo, una sola mejora simultánea alcanza la política óptima.
Hay que distinguir el cálculo usado para mejorar de la evaluación de la política nueva. El valor 2,6 de intentar usaba una continuación que salía si regresaba a S, mientras que la política nueva seguirá intentando. Por eso su valor real es mayor y requiere resolver otra ecuación. Copiar 2,6 como evaluación definitiva confundiría dos continuaciones.
La mejora funciona localmente en la comparación, pero sus efectos se propagan por las transiciones. Cambiar la acción en T aumenta el atractivo de acciones que conducen a T. Un estado puede adquirir valor aunque su recompensa inmediata no cambie. Esta dependencia explica por qué optimizar decisiones una por una sin reevaluar puede resultar insuficiente.
Una evaluación aproximada introduce otro problema. Si los errores son grandes, la acción aparentemente mejor puede no serlo. Algunas variantes hacen evaluación parcial antes de mejorar y necesitan condiciones propias para analizar su comportamiento; la garantía de la evaluación exacta no se traslada automáticamente a los procedimientos aproximados.
En tablas pequeñas podemos comparar iteración de valores e iteración de políticas. Ambas resuelven el mismo objetivo, pero organizan el cálculo de manera diferente. Una aplica repetidamente respaldos de optimalidad; la otra mantiene explícita una política y alterna evaluación con mejora.
La elección práctica depende del costo de evaluar políticas, del número de estados y de la estructura de transiciones. En ambos casos conviene separar la regla que estamos evaluando de la que construiremos después. Esa separación será útil al estudiar agentes que aprenden mientras actúan.
254.8. Horizonte finito, promedio y estados omitidos
Un horizonte finito cambia la recursión porque importa cuánto tiempo queda. Con una sola decisión disponible en nuestro ejemplo, salir en S produce dos, mientras que intentar produce menos uno sin oportunidad de aprovechar T. En T, cobrar produce seis y mantener produce uno. La política óptima de último paso sale y cobra.
Con dos decisiones disponibles, intentar desde S puede conducir a T, donde se cobra en la última. Su valor es 2,6 con descuento 0,9, mientras que salir sigue valiendo dos. En T, mantener una vez y cobrar después vale 6,4. La acción adecuada depende del horizonte restante.
Esto no contradice la política estacionaria del problema infinito, porque los objetivos son distintos. Podemos recuperar una representación estacionaria ampliando el estado con el número de pasos restantes, pero el espacio de estados cambia. Omitir ese contador haría que una misma etiqueta física ocultara situaciones decisionales diferentes.
Retirar el descuento en un problema infinito requiere más cuidado. En nuestro ejemplo, si , mantener produce una suma infinita de recompensas, de modo que las ecuaciones descontadas no pueden usarse simplemente sustituyendo el descuento por uno.
Una formulación de recompensa promedio por paso plantea otra pregunta. Mantener en T produce promedio uno; cobrar y terminar produce una recompensa finita seguida de ausencia de actividad, si representamos la terminación con ceros. Comparar estos objetivos requiere declarar qué significa continuar después de terminar y qué criterio temporal interesa.
También puede fallar la propiedad de Markov de la representación. Si la probabilidad de éxito al intentar depende del número de intentos anteriores, el estado S no resume suficiente información. Necesitamos incorporar desgaste, experiencia o un contador pertinente. La ecuación sigue siendo aplicable a un estado adecuado, pero no corrige una descripción incompleta.
En observación parcial, el agente puede no saber si está en una condición favorable o desfavorable. Usar directamente un valor de estado oculto le concedería información inaccesible. Más adelante estudiaremos creencias y memoria como representaciones para decidir bajo esa limitación.
Estas variantes muestran que la ecuación de Bellman es una estructura de razonamiento que depende de cómo se define el problema. Antes de resolverla conviene verificar horizonte, recompensa, terminal y suficiencia del estado. Un cálculo exacto sobre una representación equivocada sigue respondiendo una pregunta equivocada.
254.9. Del modelo exacto a estimaciones aprendidas
En programación dinámica exacta conocemos las probabilidades necesarias para calcular esperanzas. En aprendizaje por refuerzo, con frecuencia solo observamos transiciones. Podemos estimar un modelo y resolverlo, o actualizar valores directamente a partir de muestras. Ambas estrategias usan la estructura temporal, pero introducen fuentes de error diferentes.
Si estimamos que la probabilidad de llegar a T es un medio cuando en realidad es un quinto, sobrevaloraremos intentar por un error del modelo de transición. Si conocemos correctamente la probabilidad pero detenemos la iteración demasiado pronto, el error es computacional. Si la recompensa observada no coincide con el objetivo real, aparece una discrepancia distinta.
Conviene mantener estas fuentes separadas. Aumentar el número de iteraciones reduce un error de solución, pero no corrige una probabilidad sesgada. Recoger más datos puede mejorar la transición estimada, pero no decide qué descuento corresponde a la tarea. Refinar el objetivo puede cambiar la política incluso con datos y cálculo perfectos.
El máximo de valores estimados también puede introducir sesgos cuando las estimaciones contienen ruido, porque seleccionar la mayor de varias estimaciones favorece errores positivos. Una operación correcta sobre valores verdaderos puede comportarse de otra manera cuando recibe estimaciones inciertas, sin que por ello la política voraz quede mal definida.
Una evaluación útil compara la política aprendida con el modelo verdadero cuando este está disponible en un experimento sintético. Podemos calcular su valor exacto sin exploración y distinguir la calidad de la política de la recompensa obtenida durante la adquisición. El entrenamiento puede incluir acciones informativas que reducen temporalmente la recompensa.
También conviene evaluar sensibilidad a parámetros. En nuestro ejemplo, los umbrales del descuento muestran regiones donde cambia la política. Podemos variar probabilidad de éxito y costo de intentar para identificar otras fronteras. Una solución aislada informa menos que comprender qué modificaciones la hacen cambiar.
La validación debe comprobar que cada fila de probabilidades esté normalizada, que las recompensas correspondan a la transición correcta y que el terminal no acumule beneficios accidentales. Estos errores suelen producir valores plausibles y pueden escapar a una inspección superficial.
La ecuación de Bellman es una referencia útil para esa auditoría, porque al sustituir una tabla candidata el residuo muestra si cumple la relación definida. Sin embargo, un residuo pequeño solo certifica consistencia con el modelo usado; la adecuación del modelo a datos externos requiere pruebas adicionales.
En particular, una transición que nunca aparece en los datos no tiene necesariamente probabilidad cero. Puede ser rara o haber quedado fuera de la política de muestreo. Declarar cómo se estiman esas probabilidades y qué incertidumbre conservan evita que una tabla numéricamente precisa oculte una evidencia empírica escasa.
254.10. Una recursión con un alcance preciso
Los valores resumen consecuencias futuras bajo una política y un objetivo. Las políticas especifican decisiones. La ecuación de Bellman conecta ambos mediante recompensas y transiciones. Esta relación permite evaluar reglas, mejorar acciones y controlar errores de cálculo en clases de problemas bien definidas.
Nuestro ejemplo mostró que una acción de recompensa inmediata negativa puede ser óptima porque abre acceso a una corriente futura de beneficios. También mostró que el resultado depende del descuento, del horizonte y de que mantener en T no agote recursos. Cambiar cualquiera de esos elementos puede modificar la decisión.
La optimalidad de una acción es relativa al estado, la continuación, el modelo y el criterio. Una política óptima bajo recompensa descontada puede no ser adecuada bajo una restricción de riesgo, un plazo breve o una información diferente. Presentar esa dependencia ayuda a interpretar recomendaciones computacionales.
La recursión no exige que un agente represente explícitamente toda la ecuación. Puede aprender valores mediante experiencias locales, planificar con un modelo aproximado o usar procedimientos que coincidan con la solución en ciertos escenarios. Para inferir qué mecanismo opera hace falta evidencia sobre la conducta y el procesamiento, más allá del resultado final.
Al documentar un problema conviene incluir una tabla de acciones, transiciones y recompensas, junto con el descuento y la condición terminal. Un ejemplo numérico pequeño puede acompañar la implementación para mostrar cómo se calcula un respaldo. Esa información vuelve revisable una solución que, de otro modo, podría parecer una cifra producida por una caja negra.
El capítulo siguiente comparará el aprendizaje de un modelo de consecuencias para planificar con el aprendizaje de valores o políticas sin construir ese modelo explícito. Ambas estrategias pueden relacionarse con Bellman, pero reaccionan de manera diferente a ciertos cambios y distribuyen de forma distinta el costo entre interacción y cálculo.
Comprender la ecuación permite formular esa comparación con precisión. Sabremos qué cantidad intenta estimar cada procedimiento, qué información necesita y qué parte del futuro incorpora. La claridad sobre esos elementos vale más que memorizar una fórmula aislada.
Referencias
[1] Bellman, R. (1957). A Markovian decision process. Journal of Mathematics and Mechanics, 6, 679–684. DOI.
[2] Bertsekas, D. P. (2015). Dynamic Programming and Stochastic Control, clase 15: propiedades de contracción y problemas descontados. MIT OpenCourseWare. Material del autor.
[3] Sutton, R. S., y Barto, A. G. (2018). Reinforcement Learning: An Introduction, 2.ª edición. MIT Press. Página de los autores.