Módulo 26. Agentes adaptativos y aprendizaje
257.1. Una consecuencia puede tener muchos antecedentes
Cuando una recompensa aparece inmediatamente después de una acción aislada, relacionarlas es relativamente sencillo en un modelo controlado. En una secuencia larga, muchas decisiones preceden al resultado. Algunas fueron necesarias, otras irrelevantes y otras pudieron perjudicarlo. La asignación de crédito estudia cómo una señal tardía modifica componentes de una conducta anterior.
Recordar es solo una parte del problema. Un registro perfecto de la secuencia indica qué ocurrió, pero no determina qué habría pasado si se hubiera elegido de otra manera. La proximidad temporal es una pista, aunque una acción lejana puede ser decisiva y una reciente, accidental. La interpretación causal requiere más estructura que una lista ordenada de eventos.
En aprendizaje por refuerzo, distintos algoritmos distribuyen la influencia de resultados mediante retornos completos, predicciones intermedias, trazas de elegibilidad o gradientes de políticas. Cada procedimiento conserva información diferente y usa supuestos propios. Ninguna regla asigna correctamente el crédito en toda tarea.
Sutton desarrolló métodos de diferencias temporales que permiten revisar predicciones antes de conocer el resultado final [1]. Williams presentó algoritmos de gradiente estocástico para modificar políticas a partir de refuerzo [2]. El primer enfoque aprende estimaciones que conectan estados sucesivos; el segundo relaciona decisiones probabilísticas con resultados acumulados.
Usaremos una cadena de tres estados para comparar actualizaciones exactas. Después examinaremos qué significa añadir señales intermedias y por qué una ayuda de aprendizaje puede cambiar accidentalmente el objetivo. El análisis mantendrá separadas rapidez de propagación, variabilidad de estimaciones e identificación causal.
Un ejemplo pequeño es especialmente útil porque el mismo resultado final puede distribuirse de varias maneras entre estados. Si solo observamos la recompensa acumulada, esas diferencias quedan ocultas. Registrar valores, trazas y cambios de parámetros permite entender cómo se construye una conducta persistente.
Nos haremos dos preguntas. La primera, qué decisiones reciben una modificación después del resultado, puede responderse leyendo un algoritmo. La segunda, qué justifica esa distribución, requiere analizar la tarea y contrastar si el procedimiento aprende relaciones que se sostienen fuera de la experiencia particular. Separarlas evita llamar explicación causal a una regla que, por diseño, solo distribuye cambios numéricos entre componentes recientemente activos de una representación.
257.2. Una cadena con recompensa final
Consideremos una secuencia determinista S0, S1, S2 y un estado terminal. Hay una sola acción disponible en cada estado, de modo que primero estudiaremos predicción sin elección. Las recompensas al pasar de S0 a S1 y de S1 a S2 son cero; al pasar de S2 al terminal, ocho. El descuento es 0,9.
El retorno desde S2 es ocho. Desde S1 es 7,2 porque la recompensa está un paso más lejos. Desde S0 es 6,48 porque se descuenta dos veces. Estos valores se calculan exactamente multiplicando ocho por las potencias correspondientes del descuento.
Aunque no hay decisiones alternativas, ya hay un problema de propagación temporal. Un algoritmo que empieza con valores cero debe relacionar la señal final con estados anteriores. La forma de hacerlo determinará cuántas experiencias necesita para aproximar los valores correctos.
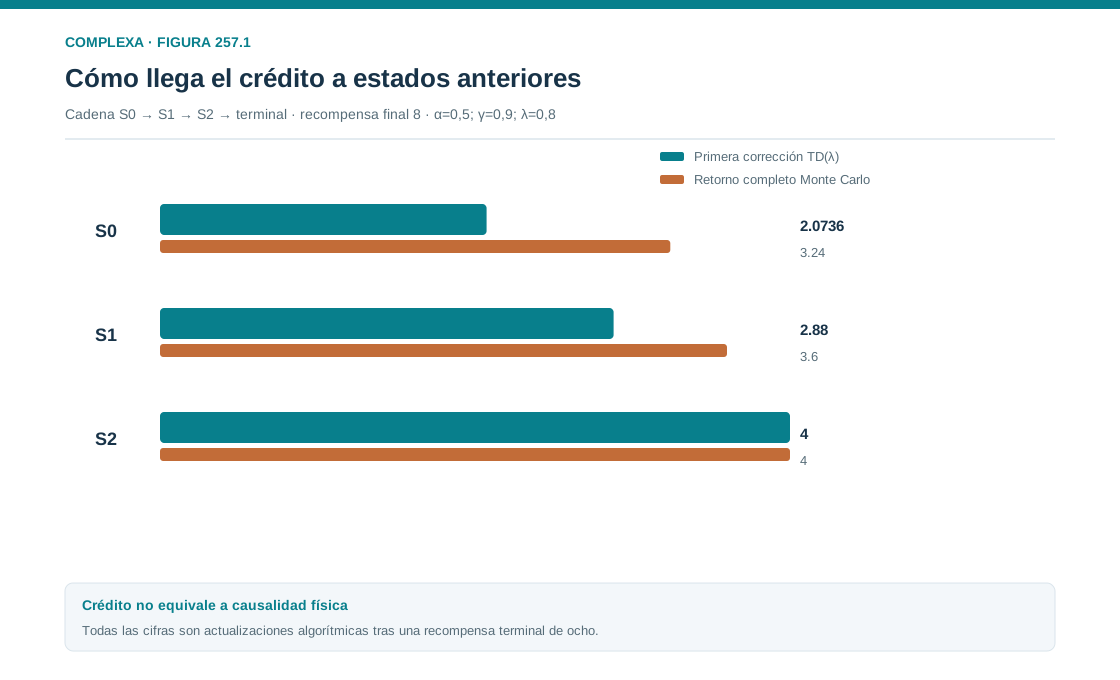
Supongamos una tasa de aprendizaje de un medio. Un método que espera a terminar el episodio y actualiza cada estado hacia su retorno observado produce, tras el primer episodio, valores 3,24; 3,6 y cuatro. Cada estado recibe la mitad de su retorno porque su estimación inicial era cero.
Un método TD de un paso, actualizado en línea, produce otra trayectoria. Al salir de S0, la recompensa y el valor de S1 son nulos, así que S0 no cambia. Lo mismo ocurre al salir de S1. Solo al abandonar S2 aparece un error de ocho y su valor aumenta a cuatro.
Tras el primer episodio, ambos procedimientos han observado la misma recompensa, pero uno ha modificado los tres estados y el otro solo el último. La diferencia procede únicamente de cuándo y con qué objetivo actualiza cada método.
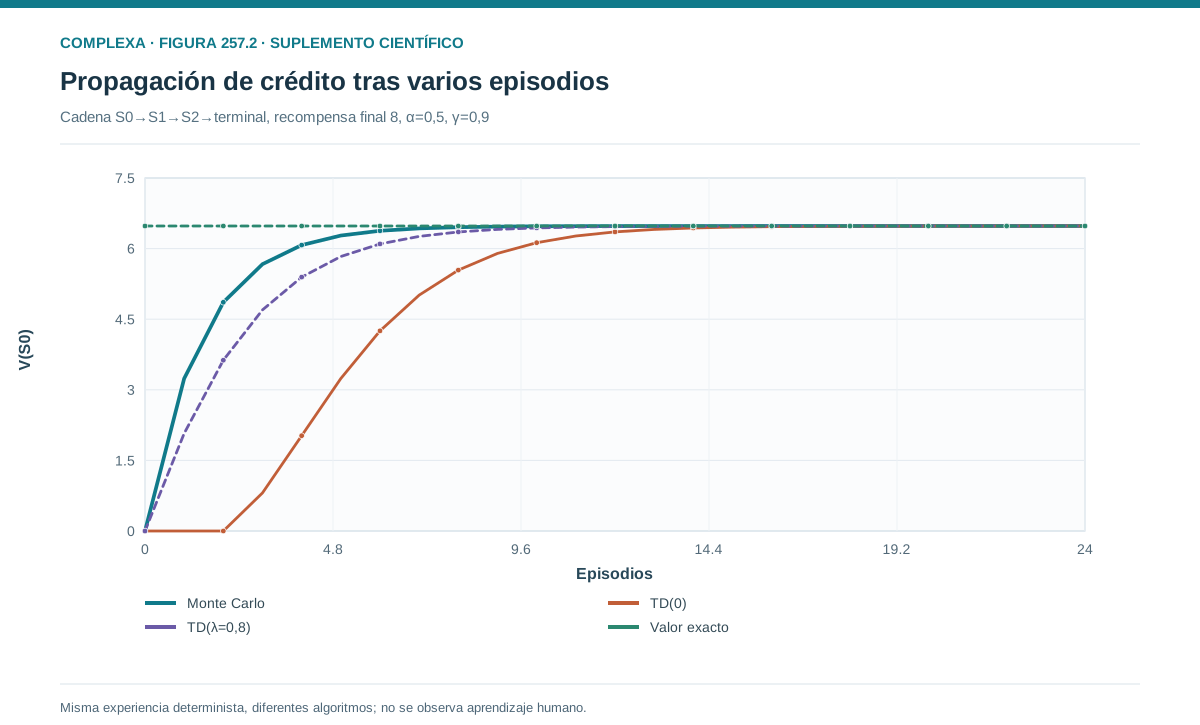
En el segundo episodio, TD usa el valor ya aprendido de S2 para modificar S1. La información avanza hacia atrás a través de visitas sucesivas. Este proceso puede ser adecuado, pero es lento cuando las cadenas son largas y las recompensas escasas. Otros procedimientos intentan propagar señales a mayor distancia.
Dos episodios más permiten ver esa propagación. En el segundo, S0 conserva todavía cero porque S1 no había aprendido cuando se produce la primera transición. S1 aumenta a 1,8 al usar el valor cuatro de S2; después S2 sube a seis. En el tercero, S0 llega a 0,81, S1 a 3,6 y S2 a siete. La recompensa ya se observó tres veces, pero las posiciones de la cadena siguen aprendiendo a ritmos diferentes.
Si alguien afirmara que el algoritmo actualizó todos los estados hacia el resultado final desde el primer episodio, esas cifras lo refutarían. También muestran por qué el número de episodios no equivale a la cantidad de información efectivamente incorporada en cada posición. El estado cercano al terminal recibe una señal directa; el lejano depende de estimaciones que inicialmente eran nulas. Alterar el orden de reproducción de transiciones puede cambiar esa velocidad sin modificar el entorno.
De ahí no se sigue que esperar al final sea siempre mejor. En tareas ruidosas, el retorno completo puede variar mucho; en procesos continuos quizá no haya un final cercano. Comparar métodos requiere considerar tanto el alcance temporal como la calidad y disponibilidad de las señales.
257.3. Retornos completos y predicciones parciales
Los métodos de Monte Carlo usan retornos observados después de completar una trayectoria. Su objetivo de actualización no necesita estimar la continuación de ese episodio, porque ya se observó. En cambio, los métodos TD de un paso combinan una recompensa con una estimación del estado siguiente.
Entre ambos extremos hay retornos de varios pasos. Un retorno de dos pasos incorpora dos recompensas reales y luego una predicción de continuación. Uno de tres pasos incorpora tres recompensas antes de usar un valor futuro, salvo que el episodio termine antes. El número de pasos determina cuánto resultado observado sustituye a la predicción.
En nuestra cadena, desde S0, el retorno de un paso es el valor descontado de S1 porque la primera recompensa es cero. Con valores iniciales cero, su objetivo es cero. El de dos pasos también es cero; el de tres incluye por fin la recompensa ocho y vale 6,48.
Esta comparación muestra por qué una señal tardía puede tardar en alcanzar estados anteriores cuando solo se usan respaldos cortos. A cambio, un respaldo largo incorpora más variabilidad de la trayectoria. Si hay muchas bifurcaciones aleatorias, el retorno observado mezcla consecuencias de varias decisiones y eventos externos.
No conviene resumir la diferencia diciendo que Monte Carlo siempre tiene mayor varianza y TD siempre menor. La comparación depende de la tarea, de la precisión de las estimaciones y de qué variable se mide. TD introduce dependencia de predicciones actuales, que pueden ser sesgadas o inestables. Los compromisos deben analizarse bajo condiciones concretas.
En un episodio truncado por un límite administrativo, asignar valor futuro cero equivale a suponer que nada ocurre después. Si la tarea realmente continúa, quizá debamos usar una estimación de continuación. Confundir truncamiento con estado terminal cambia el objetivo aprendido.
Podemos combinar retornos de diferentes longitudes para usar información a varias escalas. Esa combinación conduce a formulaciones con un parámetro lambda y a su relación con trazas de elegibilidad. La idea es distribuir la influencia de una señal entre estados visitados recientemente sin esperar siempre una actualización separada para cada distancia.
Antes de implementar una combinación, debemos fijar qué valores se usan para las predicciones intermedias (los del comienzo del episodio, los actuales o versiones almacenadas). La equivalencia entre formulaciones depende de ese detalle y no debe presumirse solo porque comparten un símbolo.
257.4. Trazas de elegibilidad
Una traza de elegibilidad conserva una medida de participación reciente de un estado o parámetro. En una versión tabular con trazas acumulativas, cada paso reduce las trazas anteriores y aumenta la del estado actual. El error TD modifica después todos los valores en proporción a sus trazas según
El parámetro lambda regula, junto con el descuento, cuánto persiste la elegibilidad. Una traza es una variable del algoritmo que determina cómo se distribuye una actualización. No mide la probabilidad de que el estado haya causado la recompensa.
En la cadena, usemos lambda 0,8, descuento 0,9, tasa de un medio y valores iniciales cero. El factor de decaimiento es 0,72. Cuando aparece la recompensa final, las trazas de S0, S1 y S2 valen 0,5184; 0,72 y uno, respectivamente.
El error final es ocho. Los cambios de valor son entonces 2,0736 para S0, 2,88 para S1 y cuatro para S2. Una sola experiencia modifica estados anteriores aunque sus propios errores inmediatos hayan sido cero. La influencia disminuye con la distancia temporal.
Con lambda cero, solo permanece elegible el estado actual y recuperamos TD de un paso en esta formulación. Con lambda uno, las trazas decaen únicamente por el descuento. En nuestro primer episodio, sin revisitas y con predicciones iniciales nulas, las actualizaciones coinciden con las de retorno completo.
Fuera de ese caso, una implementación en línea de TD con lambda uno no tiene por qué coincidir, paso por paso, con una actualización Monte Carlo de tasa finita. Si cambian valores durante el episodio o se revisitan estados, debemos precisar la formulación y el orden. Las equivalencias clásicas requieren condiciones y convenciones apropiadas.
En tareas episódicas, las trazas suelen reiniciarse al terminar. Si se conservan indebidamente, una recompensa del episodio siguiente puede modificar estados del anterior. En tareas continuas, el tratamiento es diferente y debe corresponder al objetivo.
Las revisitas también requieren una decisión. Con trazas acumulativas, visitar de nuevo un estado añade uno a su traza residual; con trazas de reemplazo, puede fijarse en uno. Si el residuo era 0,72, las dos opciones producen 1,72 y uno. Son algoritmos distintos y pueden asignar crédito de manera diferente.
257.5. Una lectura hacia delante de la misma señal
Podemos entender lambda como una combinación de retornos de distintas longitudes. En un episodio de tres transiciones desde S0, una combinación finita asigna pesos , y a los retornos de uno, dos y tres pasos. Los pesos suman uno.
Con lambda 0,8, los pesos son 0,2; 0,16 y 0,64. Si usamos las predicciones iniciales cero para los retornos cortos de nuestra cadena, únicamente contribuye el retorno completo de 6,48. El objetivo combinado es 4,1472 y una actualización de tasa un medio produce 2,0736 en S0.
La cifra coincide con la obtenida mediante la traza del primer episodio. La lectura hacia delante pregunta qué combinación de objetivos futuros actualiza un estado; la lectura hacia atrás, qué estados anteriores reciben el error actual. Son dos perspectivas sobre una distribución temporal de información.
La combinación no decide qué acción fue causalmente relevante. Si una secuencia contiene pasos irrelevantes que siempre aparecen antes de la recompensa, las trazas pueden modificarlos también. Para separar relevancia causal necesitamos variación de acciones, modelos de transición o intervenciones que permitan comparar consecuencias.
En un algoritmo, lambda define una mezcla de objetivos o una persistencia de elegibilidad. Relacionarlo con una capacidad de memoria de un organismo requiere una hipótesis adicional y datos que distingan esa interpretación de otras.
Un lambda alto puede propagar rápidamente información lejana, pero también distribuir ruido por más estados. Uno bajo mantiene la actualización local y depende más de estimaciones intermedias. El valor conveniente depende de la duración de los episodios, la estructura de las recompensas y la calidad de la representación.
La tasa de aprendizaje interactúa con lambda. Si muchos estados reciben cambios simultáneos, una tasa que funcionaba con actualizaciones locales puede producir oscilaciones o gran variabilidad. Comparar lambdas con una única tasa sin examinar esa interacción puede generar conclusiones dependientes de una configuración arbitraria.
La implementación debe documentar si usa trazas acumulativas, de reemplazo u otra variante; cómo maneja revisitas; cuándo reinicia; y qué política generó las trayectorias. En aprendizaje fuera de política aparecen dificultades adicionales.
La doble lectura tiene utilidad pedagógica y práctica, porque permite verificar números por dos vías y detectar si una traza implementada corresponde realmente al objetivo de retorno que se pretendía usar.
257.6. Crédito mediante gradientes de políticas
Otra vía modifica directamente los parámetros de una política probabilística. Sin aprender primero qué valor tiene cada estado, relaciona acciones elegidas y retornos para aumentar la probabilidad de las decisiones con mejores resultados esperados. Los algoritmos REINFORCE de Williams son un antecedente fundamental [2].
En una versión episódica sencilla, una actualización usa el retorno multiplicado por el gradiente del logaritmo de la probabilidad de la acción. Esa derivada indica cómo cambiar parámetros para hacer más o menos probable la elección observada. La esperanza de la expresión puede corresponder a un gradiente del objetivo bajo supuestos apropiados.
Consideremos una decisión binaria. La probabilidad de elegir la acción uno es una función logística de un parámetro. La derivada del logaritmo de la probabilidad respecto de ese parámetro es acción menos probabilidad. Si la acción uno entrega ocho y la acción cero entrega cero, el retorno esperado es ocho veces esa probabilidad.
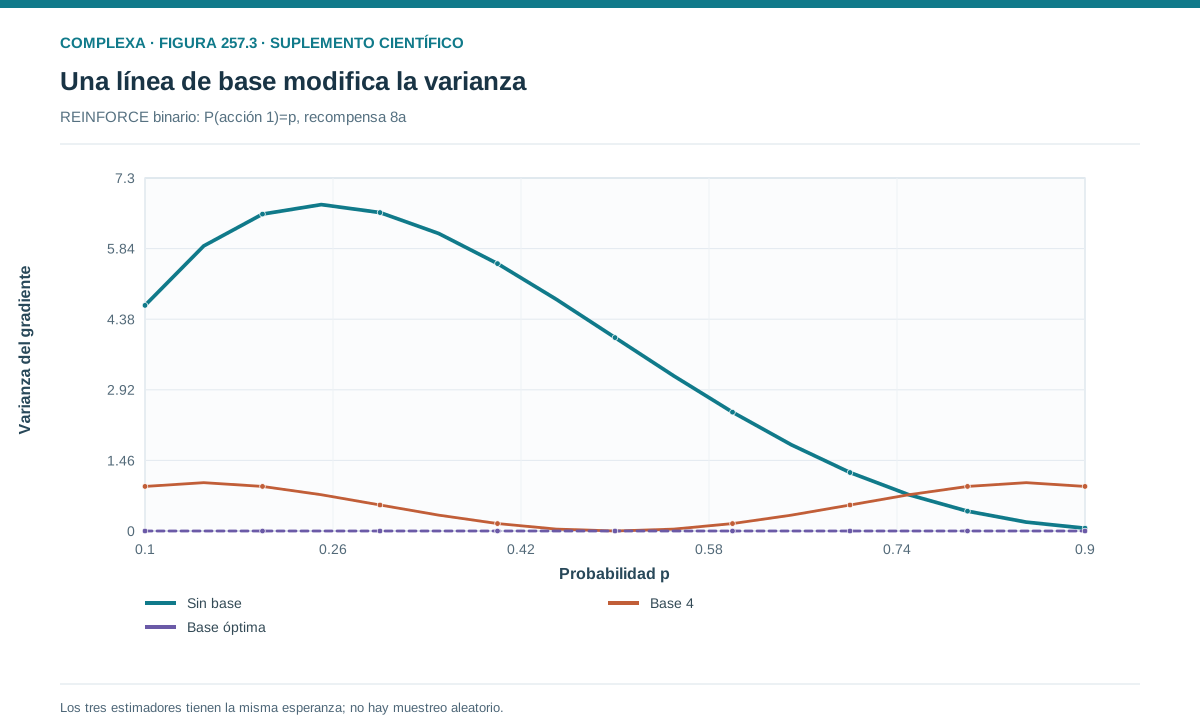
Con probabilidad inicial de un medio, el gradiente verdadero del retorno respecto del parámetro logístico es dos. Una muestra que elige uno produce una contribución de cuatro; una que elige cero produce cero. Ambas ocurren con probabilidad de un medio, de modo que su promedio es dos.
Podemos restar una línea de base que no dependa de la acción elegida, condicionada a la información pertinente. En este ejemplo, una línea de base de cuatro transforma ambas contribuciones en dos, porque al elegir uno obtenemos cuatro por un medio y al elegir cero, menos cuatro por menos un medio. La esperanza no cambia y, en este caso especial, la variabilidad desaparece.
Esa reducción perfecta de la varianza es propia del ejemplo. En tareas más complejas, una línea de base puede ayudar sin eliminar la incertidumbre; si depende incorrectamente de la acción, puede sesgar el estimador.
En secuencias largas, el retorno de una acción puede incluir consecuencias de muchos eventos posteriores. Usar solo recompensas futuras pertinentes y buenas estimaciones de ventaja puede reducir variabilidad. La asignación de crédito sigue dependiendo de la representación y de la estructura temporal.
Una acción irrelevante permite otra comprobación. Supongamos que una elección binaria no modifica en absoluto la distribución del retorno y que este es independiente de esa elección. Su contribución media al gradiente logístico es cero, ya que el promedio de acción menos probabilidad también lo es. Sin embargo, en una trayectoria particular el producto puede ser positivo o negativo. El algoritmo puede modificar temporalmente ese parámetro aunque, al promediar experiencias, no haya una dirección sistemática de mejora.
Esta diferencia explica parte del problema de crédito en secuencias largas. Muchas decisiones irrelevantes pueden recibir señales ruidosas antes de que la repetición cancele su influencia promedio. Una representación que identifica dependencias útiles puede reducir ese ruido. Si, en cambio, las acciones están correlacionadas con estados ocultos o cambian qué experiencias se observan, la independencia supuesta deja de valer y debemos analizar el proceso completo. La cancelación algebraica es una propiedad del ejemplo declarado y no garantiza que cualquier correlación espuria desaparezca rápidamente.
Un gradiente correcto en esperanza tampoco garantiza mejoras en cada actualización individual. Las muestras son variables, la tasa puede ser inadecuada y el objetivo puede tener múltiples regiones. La garantía local del estimador debe distinguirse del comportamiento global del aprendizaje.
257.7. Señales intermedias que pueden cambiar el objetivo
Una recompensa final escasa puede dificultar el aprendizaje. Una respuesta habitual es añadir recompensas intermedias por avanzar hacia una meta. Esta modificación puede acelerar la adquisición, pero también cambiar qué conducta es óptima. El agente optimiza la señal que recibe, aunque esta omita la intención del diseñador.
Imaginemos una recompensa adicional por entrar en una región cercana a la meta. Si el agente puede salir y volver a entrar repetidamente, quizá acumule más recompensa haciendo ciclos que completando la tarea. La ayuda diseñada para guiarlo se convierte en un objetivo alternativo. El problema surge de cómo se suman incentivos a lo largo de trayectorias.
Ng, Harada y Russell analizaron transformaciones de recompensa que preservan políticas óptimas y desarrollaron la idea de moldeado por potenciales [3]. Una forma compatible con el descuento añade a cada transición la diferencia entre el potencial descontado del estado siguiente y el potencial actual,
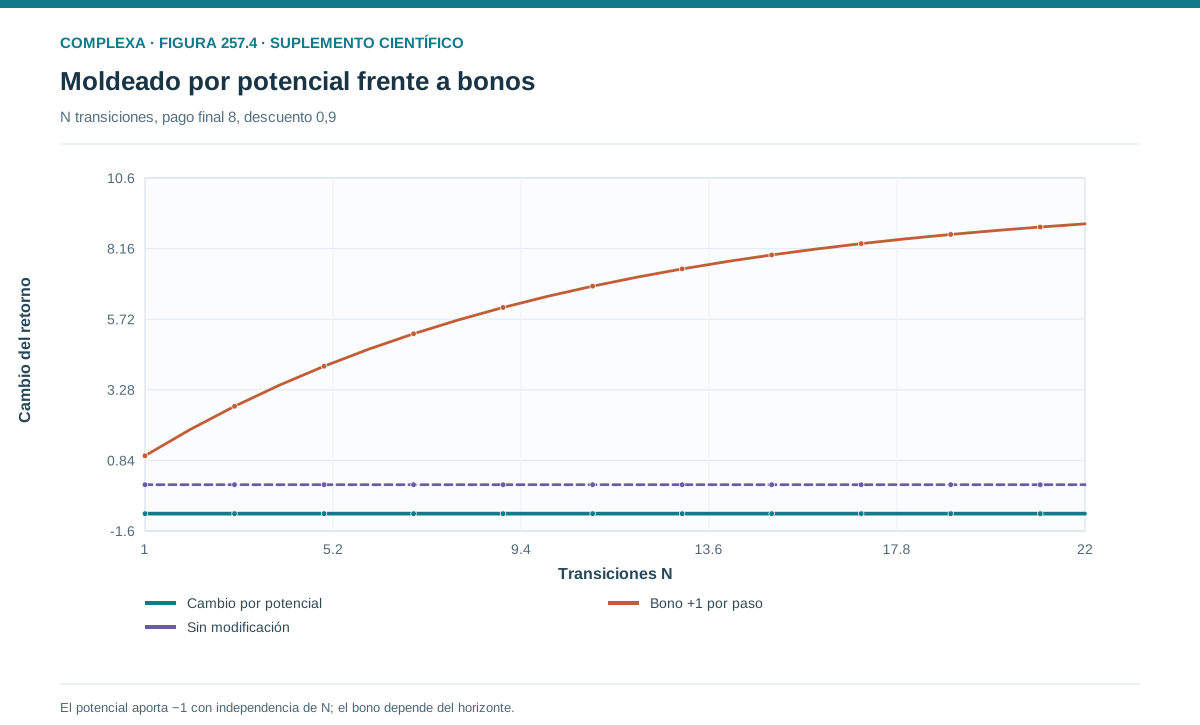
La suma descontada de estas diferencias se cancela telescópicamente. En un episodio con potencial terminal cero, el retorno añadido es menos el potencial inicial. Desde un estado inicial fijo, esa cantidad no depende de las acciones y no cambia su orden de preferencia bajo las condiciones del resultado.
Comprobémoslo en nuestra cadena. Asignamos potencial cero al terminal y potenciales uno, dos y tres a S0, S1 y S2. Las recompensas adicionales son 0,8; 0,7 y menos tres. Sumadas a las originales, las recompensas quedan 0,8; 0,7 y cinco.
El retorno desde S0 pasa a ser . Frente al retorno original de 6,48, la diferencia es menos uno, exactamente el negativo del potencial inicial. La señal se distribuye de otra manera sin alterar comparaciones desde ese mismo comienzo.
Si dejamos potenciales terminales distintos sin el tratamiento adecuado, el término residual puede depender de dónde termina la trayectoria y cambiar preferencias. También debe usarse el mismo descuento que define el retorno. Una diferencia de potencial ordinaria sin descuento no conserva necesariamente la propiedad cuando el objetivo sí descuenta.
Preservar la política óptima no garantiza acelerar cualquier algoritmo ni mejorar todas las trayectorias de aprendizaje. El potencial puede estar mal elegido, interactuar con aproximaciones o aumentar variabilidad.
257.8. Crédito temporal y explicación causal
Asignar una actualización a una acción anterior no demuestra que esa acción haya causado el resultado. Un algoritmo puede aprender asociaciones predictivas útiles sin identificar relaciones causales completas. Conviene recordarlo al interpretar modelos de conducta o al usar sus valores para justificar intervenciones.
Supongamos que un agente atraviesa siempre una sala azul antes de recibir recompensa. La sala puede ser necesaria para acceder al resultado o una característica incidental de la ruta. Si todas las experiencias mantienen esa asociación, ambos mecanismos son compatibles con los datos. Una traza de elegibilidad puede asignar valor a la sala en los dos casos.
Para distinguirlos, podemos cambiar la ruta conservando otras condiciones o permitir llegar a la recompensa sin atravesarla. Si el resultado permanece, la necesidad causal de la sala queda cuestionada. En un simulador conocemos las transiciones y podemos intervenir directamente; en un sistema real quizá haya restricciones y variables no observadas.
La representación influye en qué recibe crédito. Si el agente agrupa estados distintos bajo una misma etiqueta, una recompensa puede modificar decisiones en situaciones donde no corresponde. Si divide excesivamente situaciones equivalentes, puede no transferir información útil. La asignación temporal depende así de la generalización entre estados.
También puede haber acciones que produzcan información sin recompensa directa. Su valor depende de que mejoren decisiones posteriores. Un procedimiento que solo atribuye crédito al evento inmediatamente anterior puede ignorar la observación que permitió elegir correctamente. Para modelarlo debemos representar cómo la información modifica la política.
En sistemas con varios agentes, una consecuencia conjunta complica todavía más la atribución. Una recompensa global puede mejorar por la acción de otro participante. Actualizar todas las conductas como si cada una hubiera causado el resultado puede producir señales ruidosas o incentivos equivocados. Se requieren mecanismos acordes con la estructura de interacción.
La comparación contrafáctica pregunta qué habría ocurrido bajo otra acción manteniendo definidas las condiciones relevantes. Los valores de acción intentan resumir consecuencias de alternativas, pero aprenderlos requiere cobertura de experiencias o un modelo que permita inferirlas. Una tabla no crea evidencia sobre acciones nunca observadas.
El análisis debe distinguir utilidad predictiva, control de la conducta y explicación causal. Un mecanismo puede cumplir una función sin resolver completamente las otras. Esa separación permite usar modelos de aprendizaje con precisión y evita convertir toda señal de error en una explicación exhaustiva del comportamiento.
257.9. Verificación de la propagación temporal
Un protocolo de verificación debe registrar la secuencia completa de estados, recompensas, valores antes de cada actualización, errores y trazas. Con esos datos podemos reconstruir por qué cambió cada variable. Una curva de recompensa acumulada no permite detectar si el crédito llegó a estados equivocados.
En la cadena propuesta, el primer episodio da referencias exactas. Monte Carlo con tasa un medio produce 3,24; 3,6 y cuatro. TD de un paso produce cero, cero y cuatro. TD con trazas acumulativas y lambda 0,8 produce 2,0736; 2,88 y cuatro, bajo la secuencia y las convenciones declaradas.
La verificación debe incluir un segundo episodio porque ciertas implementaciones coinciden solo cuando los valores iniciales son cero. Al cambiar predicciones intermedias, aparecen diferencias entre actualizaciones en línea y cálculos hechos con una tabla congelada. Comparar únicamente el primer episodio puede ocultar un error de orden.
También añadimos una revisita a un estado para comprobar acumulación o reemplazo de trazas. Si el programa afirma usar reemplazo y genera una traza mayor que uno en el caso tabular básico definido, debemos revisar la implementación. Las variantes más generales requieren criterios propios, pero el ejemplo debe coincidir con su especificación.
Una prueba de terminal verifica que no se use valor futuro después de finalizar y que las trazas se reinicien cuando corresponde. Otra prueba cambia el descuento y comprueba sus potencias. Confundir distancia en estados con número de transiciones suele introducir un factor de descuento de más o de menos.
Para el moldeado por potenciales, calculamos retornos originales y transformados sobre varias trayectorias con el mismo inicio. La diferencia debe ser constante bajo las condiciones declaradas. Si depende de la ruta, quizá se haya omitido el descuento, alterado el terminal o añadido una recompensa que no pertenece a la forma potencial.
En gradientes de políticas, un caso binario permite comparar el promedio de estimadores con la derivada analítica. La prueba debe distinguir variabilidad muestral de sesgo sistemático. Una línea de base incorrecta puede producir una dirección estable pero equivocada.
Estas verificaciones son pequeñas y atienden riesgos concretos antes de ampliar el modelo. Una vez comprobado el mecanismo, la evaluación puede estudiar longitud de cadenas, ruido y aprendizaje de políticas sin confundir efectos científicos con errores de implementación.
257.10. Propagar información sin inventar una causa
La asignación de crédito conecta consecuencias con estados, acciones y parámetros anteriores. Los retornos completos usan resultados observados; las diferencias temporales se apoyan en predicciones intermedias; las trazas distribuyen errores hacia participantes recientes; los gradientes de políticas relacionan elecciones probabilísticas y retornos. Son mecanismos distintos para resolver aspectos del mismo problema.
La cadena didáctica mostró que una experiencia idéntica puede producir cambios internos muy diferentes. Algunos procedimientos modifican únicamente el estado más cercano a la recompensa; otros alcanzan estados anteriores de inmediato. Esa rapidez debe compararse con variabilidad, sesgo, costo de memoria y condiciones de estabilidad.
Las señales intermedias pueden facilitar el aprendizaje, pero necesitan una relación explícita con el objetivo. El moldeado por potenciales es una construcción cuya contribución se cancela de forma controlada. Añadir premios intuitivos sin revisar trayectorias completas puede favorecer conductas que contradicen la finalidad original.
Ninguna de estas operaciones identifica automáticamente causalidad. Un estado puede recibir valor solo porque predice una recompensa, aunque no sea necesario para producirla. Distinguir ambas posibilidades requiere intervenciones, cobertura de alternativas o modelos estructurales que justifiquen la comparación.
Al interpretar parámetros temporales debemos conservar su definición algorítmica. Lambda regula una combinación de retornos o una persistencia de elegibilidad; el descuento pondera el futuro; la tasa fija la magnitud de cada actualización. Relacionarlos con memoria, paciencia o flexibilidad psicológica exige hipótesis adicionales.
El capítulo siguiente examinará qué ocurre cuando el agente no observa el estado relevante. Una señal tardía puede ser difícil de atribuir porque falta información sobre el contexto en que se tomó una decisión. La memoria y las creencias sobre estados ocultos pueden cambiar tanto la selección de acciones como el aprendizaje posterior.
La propagación temporal se entiende mejor cuando se mantiene visible la cadena completa (representación, experiencia, error, actualización y nueva decisión). Esa descripción permite comprobar el mecanismo sin atribuirle capacidades que sus ecuaciones no contienen.
Referencias
[1] Sutton, R. S. (1988). Learning to predict by the methods of temporal differences. Machine Learning, 3, 9–44. DOI.
[2] Williams, R. J. (1992). Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine Learning, 8, 229–256. DOI.
[3] Ng, A. Y., Harada, D., y Russell, S. (1999). Policy invariance under reward transformations: Theory and application to reward shaping. Proceedings of the Sixteenth International Conference on Machine Learning, 278–287. Texto de los autores.