Módulo 26. Agentes adaptativos y aprendizaje
259.1. Cambiar lo suficiente sin perder lo aprendido
Un agente que modifica mucho sus estimaciones tras cada experiencia puede responder rápido a un cambio real, aunque también perseguir fluctuaciones accidentales. Otro que conserva casi intacto su conocimiento puede resistir el ruido, pero continuar aplicando una regularidad que dejó de existir. La plasticidad plantea este compromiso entre incorporación de información y preservación de estructura útil.
La tasa de aprendizaje regula parte de ese compromiso. En una actualización elemental, determina cuánto se mueve una estimación hacia una señal nueva. Sin embargo, no es una medida universal de flexibilidad. Su efecto depende de unidades, representación, algoritmo, frecuencia de visitas y estructura del entorno.
La estabilidad también tiene varios significados. Una secuencia puede permanecer acotada, converger a un valor, seguir un objetivo cambiante con error limitado o mantener un desempeño aceptable. Estas propiedades no son equivalentes. Un algoritmo puede ser estable y aprender una respuesta equivocada; otro puede fluctuar alrededor de una solución adecuada porque recibe observaciones ruidosas.
Conviene separar estabilidad del procedimiento y validez del objetivo. Si la recompensa omite consecuencias relevantes, reducir oscilaciones no corrige esa omisión. Si la representación mezcla estados distintos, una tasa pequeña puede estabilizar un promedio que no sirve para ninguno de ellos. La plasticidad debe analizarse dentro de una arquitectura completa.
La aproximación estocástica, iniciada por Robbins y Monro, estudia actualizaciones a partir de observaciones variables [1]. Sutton propuso adaptar las tasas durante el aprendizaje [2]; Tsitsiklis y Van Roy analizaron la estabilidad cuando los valores se aproximan mediante funciones compartidas [3]. Las garantías requieren condiciones que deben permanecer visibles.
Comenzaremos con una ecuación escalar para localizar exactamente cuándo converge. Después añadiremos ruido, cambio ambiental, parámetros compartidos y demoras. Cada ampliación mostrará por qué una tasa que funciona en un caso puede dejar de ser adecuada en otro.
El objetivo es reemplazar recomendaciones vagas sobre aprender más rápido por preguntas comprobables sobre qué magnitud se actualiza, qué señal recibe, qué escala temporal tiene el entorno y qué propiedad de estabilidad necesitamos.
259.2. Una condición exacta en el caso más sencillo
Consideremos una estimación que se actualiza sin ruido hacia un valor constante según
Si definimos el error como , obtenemos . La convergencia depende del valor absoluto del multiplicador. El error se reduce cuando , es decir, cuando la tasa está entre cero y dos.
Con una tasa entre cero y uno, la estimación se aproxima sin sobrepasar el objetivo si comienza a un lado. Con tasa igual a uno, llega al objetivo en una actualización. Con tasa entre uno y dos, lo sobrepasa y alterna de lado, pero la magnitud del error disminuye.
Supongamos objetivo uno e inicio cero. Con tasa 0,5, las estimaciones son 0,5; 0,75 y 0,875. Con tasa 1,5, son 1,5; 0,75 y 1,125. Ambas secuencias convergen, aunque la segunda oscila alrededor del objetivo.
Con tasa dos, el error cambia de signo sin reducir su magnitud (la secuencia alterna entre cero y dos). Con tasa mayor que dos, las oscilaciones aumentan. Una tasa negativa aleja la estimación en la dirección opuesta a la corrección prevista. Estos resultados son exactos para la ecuación declarada.
No debemos extrapolar el intervalo de estabilidad a cualquier algoritmo. Si la actualización incluye un gradiente con curvatura , el multiplicador puede ser , donde es el paso. La condición depende entonces del producto entre tasa y curvatura.
Por ejemplo, para una pérdida cuadrática de curvatura cuatro, un paso 0,2 produce multiplicador 0,2 y convergencia sin alternancia. Un paso 0,4 produce multiplicador menos 0,6 y oscilaciones decrecientes. Un paso 0,6 produce menos 1,4 y divergencia. Un paso que parece pequeño puede ser excesivo según la escala del problema.
El ejemplo también distingue estabilidad y restricciones de representación. Una estimación que es una probabilidad debe permanecer entre cero y uno. Una tasa 1,5 puede ser estable en el sentido dinámico y producir valores fuera de ese intervalo. Mantener probabilidades válidas requiere una parametrización o una restricción adicional.
259.3. El ruido deja una fluctuación persistente
Añadamos observaciones independientes de media y varianza . La actualización tiene la misma forma, con la observación como objetivo.
Con tasa constante y bajo independencia de la observación nueva respecto del error anterior, la media del error sigue la recursión determinista. Su varianza, en cambio, recibe una contribución nueva en cada paso. En el régimen estacionario, para tasas entre cero y dos, resulta
Una tasa pequeña reduce la fluctuación estacionaria, aunque tarda más en eliminar el efecto de la inicialización. Una tasa cercana a dos amplifica mucho el ruido. La convergencia de la media no implica que cada trayectoria deje de fluctuar.
Con varianza de observación uno, tasas de 0,1; 0,5 y uno producen varianzas estacionarias de aproximadamente 0,0526; 0,3333 y uno. Con tasa 1,5, la varianza es tres. El procedimiento sigue siendo estable en segundo momento bajo estos supuestos, pero su estimación puede ser mucho más variable que la propia observación.
La fórmula requiere independencia temporal y una media constante. Si las observaciones están autocorrelacionadas, aparecen covarianzas que modifican el resultado. Si el agente influye sobre lo observado, la independencia tampoco puede darse por supuesta. Un cálculo correcto para ruido externo independiente puede ser inadecuado en un sistema con retroalimentación.
También importa qué error queremos medir. La varianza de la estimación respecto de una media fija no incluye toda la variabilidad de predecir una observación futura. Si esa observación tiene ruido independiente, su error predictivo añade la varianza irreducible correspondiente. Confundir ambas medidas puede exagerar la precisión del agente.
Una tasa constante no pretende necesariamente converger a un punto exacto; puede elegirse para mantener capacidad de seguimiento. En ese caso, la fluctuación residual no tiene por qué ser un defecto de implementación, porque forma parte de un compromiso y debe compararse con el retraso ante cambios.
El análisis estacionario permite comprobar un simulador antes de introducir cambios de media, observaciones atípicas o dependencia. Si no reproduce los momentos esperados bajo condiciones simples, interpretar sus ventajas adaptativas en escenarios complejos sería prematuro.
259.4. Tasas decrecientes y aprendizaje que se congela
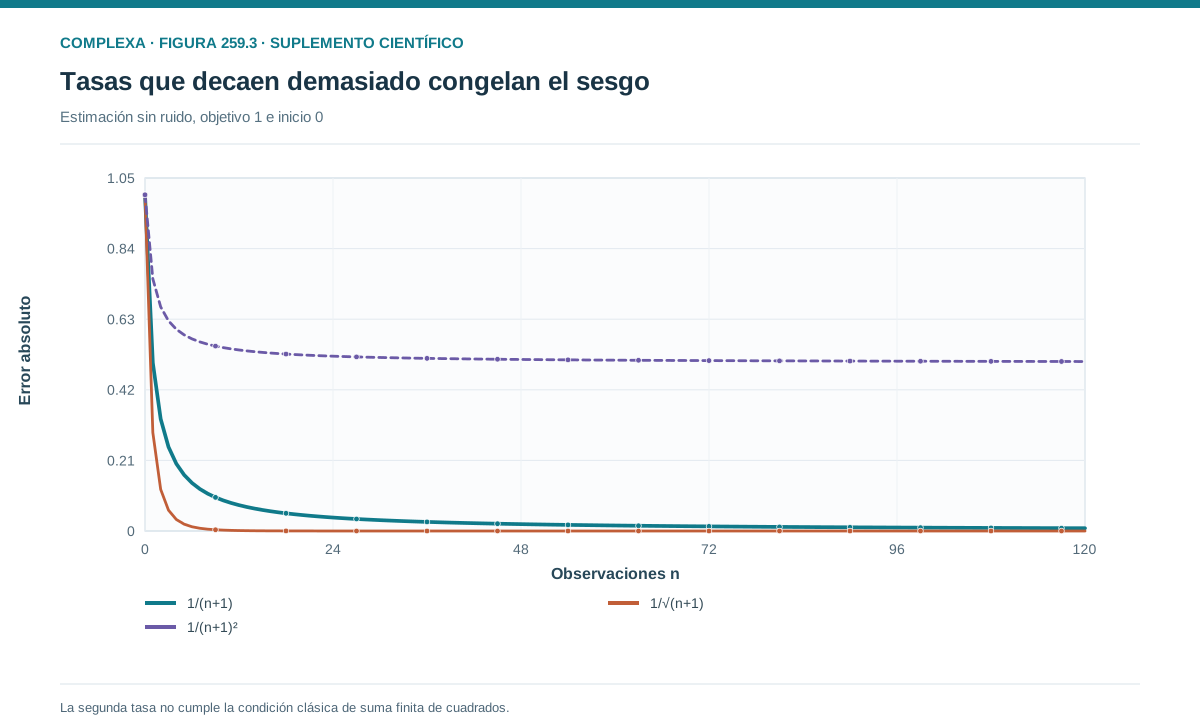
En problemas estacionarios, una tasa que disminuye puede permitir acumular evidencia y reducir el efecto del ruido. La media muestral usa una tasa inversa al número de observaciones. Cada dato nuevo pesa menos porque se combina con una historia creciente.
En resultados clásicos de aproximación estocástica aparecen condiciones como suma infinita de tasas y suma finita de sus cuadrados. La primera evita que el procedimiento deje de moverse demasiado pronto; la segunda limita la acumulación de variabilidad. Estas condiciones forman parte de teoremas que también requieren supuestos sobre dinámica, ruido y estabilidad [1].
Una actualización dirigida hacia una función equivocada, una representación inadecuada o un proceso sin condiciones de regularidad puede fallar aunque la secuencia de tasas cumpla ambas sumas. Hay que leer el conjunto completo de hipótesis de cada teorema.
Una tasa proporcional a satisface las condiciones habituales de sumabilidad. Una tasa proporcional a tiene cuadrados cuya suma diverge, por lo que no cumple esa condición clásica. Una tasa proporcional a tiene suma finita y puede detener el aprendizaje antes de corregir un sesgo inicial.
Un ejemplo sin ruido muestra el riesgo de reducir demasiado pronto. Queremos estimar uno partiendo de cero y, en la actualización número n (con n desde uno), usamos tasa . El error se multiplica sucesivamente por factores menores que uno, pero su producto no llega a cero. Después de n actualizaciones, la estimación es y su límite es un medio.
La primera estimación es un cuarto, la segunda un tercio y la tercera tres octavos. Todas avanzan hacia el objetivo, pero la cantidad total de corrección disponible se agota demasiado rápido. El agente recibe infinitas observaciones perfectas y, aun así, conserva la mitad del error inicial. La trayectoria separa la reducción monótona del error de la convergencia al objetivo correcto; una tasa decreciente puede dar una curva visualmente tranquila y dejar a la vez un sesgo permanente.
El contador n debe corresponder a las actualizaciones pertinentes. En una tabla de acciones, una acción rara necesita su propio número de visitas si pretendemos usar una media muestral. Reducir su tasa según el número global de decisiones puede congelarla aunque apenas haya sido observada.
Cuando el entorno cambia, conservar toda la historia con peso creciente puede ser perjudicial. Después de miles de observaciones de un régimen antiguo, unas pocas del nuevo apenas modifican la media. El procedimiento estima correctamente un promedio de experiencias acumuladas, pero quizá ya no estima la condición actual que interesa para decidir.
Podemos reiniciar contadores después de detectar cambios, usar ventanas o mantener tasas constantes. Cada opción introduce supuestos sobre persistencia y frecuencia de rupturas. Reiniciar demasiado a menudo desperdicia información; no reiniciar nunca puede retrasar la adaptación.
La elección entre tasa decreciente y constante depende, por tanto, del objetivo. Estimar un parámetro fijo y seguir un parámetro móvil son tareas diferentes. Un criterio de evaluación debe reflejar cuál de ellas se pretende resolver y durante qué horizonte.
259.5. Seguir una variable que cambia
Construyamos un modelo donde el objetivo latente sigue una caminata aleatoria. Entre pasos cambia mediante una perturbación de media cero y varianza Q. La observación añade un ruido independiente de media cero y varianza R. El agente actualiza su estimación después de cada observación con una tasa constante.
Definamos P como el error cuadrático medio después de actualizar, una vez alcanzado un régimen estable de ese error. Aunque la variable latente no tenga una varianza estacionaria finita, su error de seguimiento puede tenerla. Esa distinción evita aplicar estacionariedad al objeto equivocado.
La recursión del error combina incertidumbre previa, cambio latente y ruido de medición. Al resolverla obtenemos
El primer término del numerador penaliza seguir demasiado lentamente una variable móvil. El segundo penaliza incorporar demasiado ruido de observación. Cuando Q es cero, recuperamos la fórmula de la media fija. Cuando Q aumenta, conservar rígidamente el pasado se vuelve más costoso.
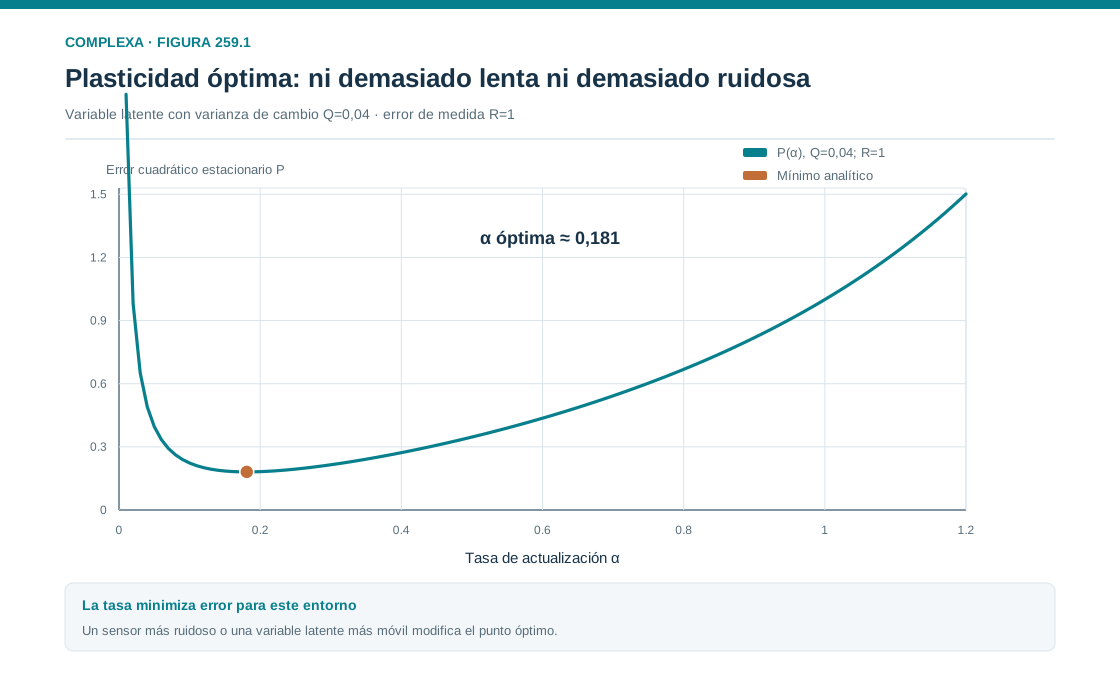
Tomemos Q igual a 0,04 y R igual a uno. Con tasa 0,1, el error estacionario es aproximadamente 0,2232. Con tasa 0,2, es 0,1822. Con tasa 0,5, es 0,3467. En este escenario, aumentar la tasa desde 0,1 hasta 0,2 mejora el seguimiento, pero aumentarla hasta 0,5 empeora el resultado.
La tasa constante que minimiza esta expresión es aproximadamente 0,181. En el caso escalar lineal, coincide con la ganancia estacionaria del filtro de Kalman [4]. Si además adoptamos supuestos gaussianos y un modelo correcto, el filtro tiene una interpretación inferencial más fuerte; aquí basta el cálculo de error cuadrático con las independencias declaradas.
La minimización puede comprobarse resolviendo la ecuación y tomando su raíz positiva. Para Q igual a 0,04 y R igual a uno, esa raíz es aproximadamente 0,180998. El error posterior estacionario correspondiente es aquí igual a la tasa multiplicada por R. Antes de incorporar la observación siguiente, el error predictivo añade Q y pasa a aproximadamente 0,220998.
Al comparar programas, un registro tomado antes de observar no debería contrastarse con la fórmula del error después de actualizar. Ambas cifras pueden ser correctas y diferir porque responden a información disponible diferente. Guardar el instante de cada medida evita atribuir esa diferencia a un fallo del algoritmo.
En los extremos, tasa uno copia la observación y deja error R después de actualizar. Tasa cero conserva para siempre la estimación inicial; si Q es positiva, el error de seguimiento crece con el tiempo y no tiene el régimen estacionario finito supuesto en la fórmula.
Los números no recomiendan una tasa general de 0,181. Cambiar Q o R modifica el compromiso. Un sensor más ruidoso favorece confiar menos en cada observación; una variable que cambia más rápidamente favorece incorporar antes información reciente. La tasa adecuada depende de una relación entre incertidumbres.
Si Q y R son desconocidas, estimarlas puede ser difícil. Una secuencia de errores grandes puede indicar mayor volatilidad latente o peor calidad de medición. Ambas explicaciones sugieren ajustes distintos. Por eso, adaptar la tasa a la magnitud del error sin un modelo adicional puede llevar a ajustes equivocados.
259.6. Aprender cómo aprender
La tasa puede convertirse en una variable ajustable. Un procedimiento modifica sus parámetros de predicción y, en otro nivel, modifica la velocidad con que esos parámetros aprenden. Esta posibilidad se denomina a menudo adaptación de tasa o metaprendizaje, pero necesita una regla concreta que evite describir el resultado deseado como si fuera el mecanismo.
Una heurística aumenta la tasa cuando los errores mantienen el mismo signo y la reduce cuando alternan. La intuición es que errores persistentes pueden indicar un objetivo desplazado, mientras que la alternancia puede indicar sobrecorrección. Sin embargo, correlación del ruido, cambios periódicos y retrasos pueden producir patrones similares.
Sutton presentó el algoritmo Incremental Delta-Bar-Delta para adaptar tasas por entrada en un sistema lineal [2]. Su trabajo muestra que la historia del aprendizaje puede usarse para ajustar parámetros de actualización. Una única regla de adaptación no tiene por qué ser adecuada para cualquier arquitectura o entorno.
Una tasa por componente puede ser útil cuando distintas variables cambian a velocidades diferentes. Un predictor puede conservar estable una relación de largo plazo y ajustar rápidamente otra que varía. No obstante, esas tasas interactúan con la escala de las entradas; multiplicar una característica cambia la magnitud de sus gradientes y puede alterar la dinámica.
Una regla didáctica podría usar tasa 0,5 cuando el error absoluto supera dos unidades y tasa 0,1 en los demás pasos. Esa especificación es ejecutable, pero todavía no sabemos si resulta conveniente. Un dato atípico puede activar la tasa alta precisamente cuando convendría desconfiar de la observación. Un desplazamiento pequeño y persistente puede mantener errores por debajo del umbral y no activar nunca una respuesta rápida. Comparar ambos escenarios permite identificar qué tipo de cambio detecta realmente la regla.
El umbral tiene también unidades. Si expresamos la misma variable en una escala diez veces mayor sin transformar el umbral, la regla cambiará de comportamiento aunque el problema físico sea idéntico. Documentar normalizaciones y escalas es parte de describir la adaptación. Una regla que usa errores estandarizados necesita, a su vez, explicar cómo estima la escala de referencia y cómo responde cuando esa escala cambia.
La adaptación de tasas también introduce parámetros, como una tasa de metaprendizaje. Desplaza así parte del problema de seleccionar escalas, que no desaparece automáticamente. Si la tasa cambia demasiado rápido, puede reaccionar a ruido y producir inestabilidad en el nivel inferior.
Conviene imponer límites o parametrizaciones cuando el algoritmo los requiere. Representar una tasa mediante una transformación positiva evita valores negativos, pero no garantiza que permanezca dentro de una región estable. Limitarla puede proteger el cálculo y, al mismo tiempo, impedir una respuesta rápida en ciertos escenarios. El efecto debe evaluarse.
Una comparación justa incluye tasas fijas bien elegidas como referencia y separa datos de ajuste de datos de evaluación. Si la tasa adaptativa se diseña después de observar exactamente dónde cambian los regímenes, puede usar información que un agente real no tendría. El procedimiento debe decidir con señales disponibles en ese momento.
Aprender cómo aprender es útil cuando explota regularidades transferibles sobre el entorno. Su valor se demuestra con mejoras fuera de las condiciones usadas para diseñarlo; la mera presencia de un nivel adicional de actualización no lo acredita.
259.7. Parámetros compartidos e interferencia
Cuando una misma variable se usa para varias situaciones, aprender una puede modificar otra. Esta interferencia puede deberse a una tasa grande o a una representación incapaz de expresar simultáneamente las relaciones necesarias.
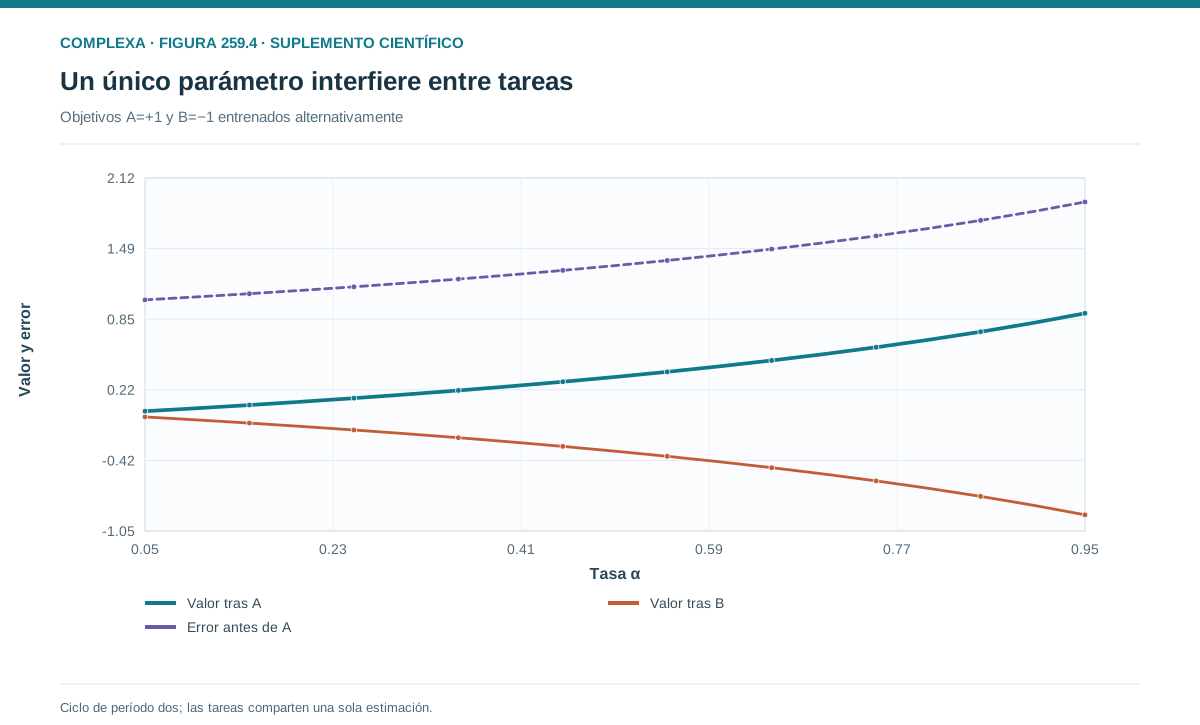
Imaginemos un único parámetro w que debe predecir uno en la tarea A y menos uno en la tarea B, sin recibir ninguna señal que distinga tareas. No existe un valor que satisfaga ambas. Si alternamos actualizaciones hacia cada objetivo con tasa constante, el parámetro puede oscilar indefinidamente aunque cada actualización aislada sea estable.
En el ciclo estable, después de aprender A el valor es y después de aprender B es su negativo. Con tasa 0,5, alterna entre un tercio y menos un tercio. Reducir la tasa acerca ambas posiciones a cero, pero no permite acertar simultáneamente los dos objetivos.
El problema es de representación, porque falta una variable que identifique la tarea o parámetros suficientes para separarlas. Una tasa pequeña reduce la oscilación y puede hacer que el sistema parezca estable, mientras conserva errores importantes.
Si añadimos una señal de contexto y parámetros separados, cada tarea puede aprender su objetivo sin sobrescribir directamente la otra. Sin embargo, separar todo elimina oportunidades de generalización útil. Cuando las tareas comparten estructura, algunos parámetros comunes pueden acelerar el aprendizaje. La cuestión es qué debe compartirse.
La frecuencia de tareas modifica el compromiso óptimo. Si A aparece tres cuartas partes del tiempo y B una cuarta parte, el mejor predictor constante bajo error cuadrático es 0,5. Su error cuadrático medio es 0,75, mientras que predecir cero produce error uno. Este promedio favorable no significa que el agente haya aprendido a distinguir tareas, puesto que sigue usando la misma respuesta en ambas. Evaluar solo el promedio ponderado puede ocultar ese límite. Si después cambian las frecuencias, también cambia el mejor compromiso escalar, aunque los objetivos de cada tarea permanezcan idénticos. La composición de experiencias y el conocimiento condicional deben analizarse por separado.
La reproducción de experiencias antiguas puede limitar el olvido al mantener presentes tareas anteriores durante la actualización. La regularización puede restringir cambios en parámetros importantes para ellas. Ambos mecanismos introducen costos de memoria, cálculo o flexibilidad y deben evaluarse respecto de tareas nuevas y antiguas.
Una métrica adecuada registra la adquisición de la tarea actual y la retención de las previas. Presentar solo el rendimiento reciente puede ocultar pérdida de conocimiento; presentar solo el promedio puede esconder que una tarea se aprende a costa de otra. También influye el orden de entrenamiento.
En agentes con funciones aproximadoras, interpretar una tasa como propiedad aislada resulta especialmente difícil. Su efecto depende de cómo se distribuye la información entre parámetros y de qué experiencias activan los mismos componentes. Analizar la interferencia requiere examinar esa geometría de representación.
259.8. Retroalimentación, demora y garantías limitadas
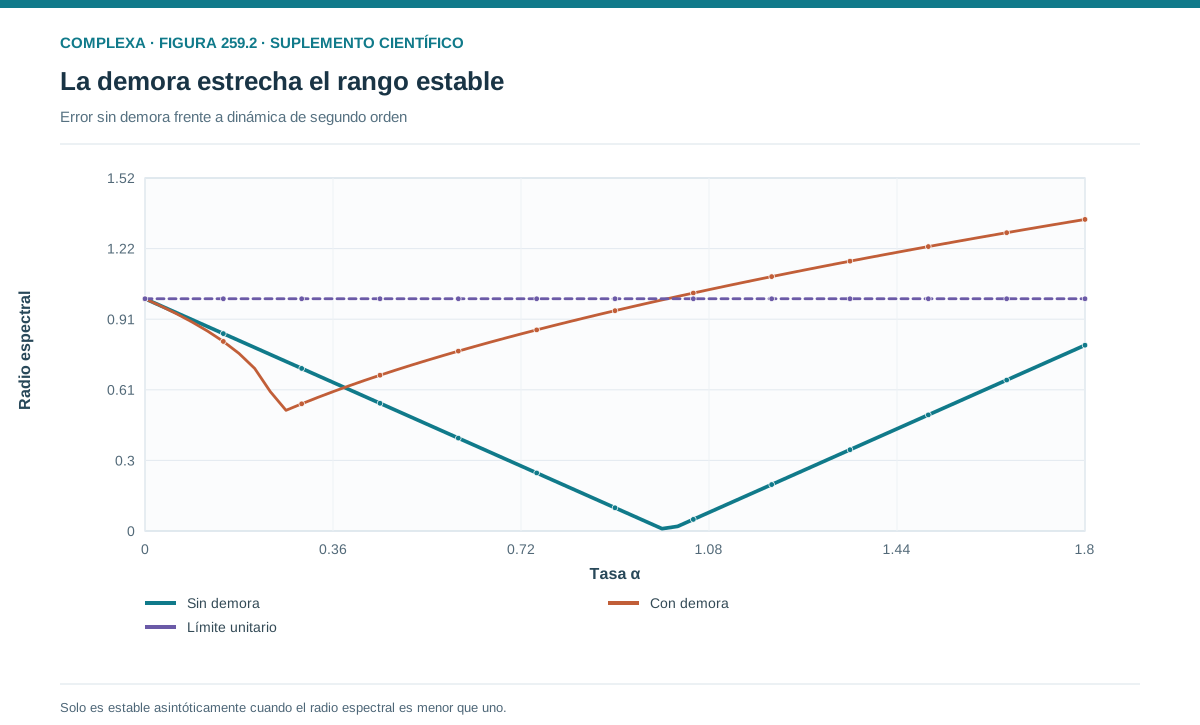
Una actualización puede usar una señal que llega con retraso y corregir así el estado actual con un error calculado sobre un estado anterior. La demora puede reducir el intervalo de tasas estables incluso cuando el objetivo es constante y no existe ruido.
Consideremos . El error satisface una ecuación de segundo orden con polinomio característico . Para esta dinámica discreta, la estabilidad asintótica requiere una tasa entre cero y uno, más restrictiva que el intervalo entre cero y dos del ajuste sin demora.
Con tasa 0,5, las raíces son complejas y tienen módulo aproximadamente 0,707, por lo que las oscilaciones disminuyen. Con tasa uno, su módulo es uno y no hay amortiguación asintótica. Con tasa 1,5, el módulo es aproximadamente 1,225 y la dinámica diverge.
El ejemplo muestra que una tasa estable en una actualización inmediata puede ser inestable cuando la información llega tarde. El orden de observación, cálculo y aplicación forma parte del sistema.
En aprendizaje TD con aproximación de funciones aparecen dependencias adicionales, ya que una estimación se usa como objetivo para modificar otra y ambas pueden compartir parámetros. Si además los datos proceden de una política distinta de la evaluada, las garantías requieren un análisis específico. Algunas combinaciones pueden divergir; no todas lo hacen necesariamente.
Tsitsiklis y Van Roy estudiaron el aprendizaje por diferencias temporales con aproximación de funciones y establecieron resultados bajo condiciones definidas, incluidos casos lineales [3]. El alcance de esos resultados no debe extenderse automáticamente a cualquier red, política de muestreo o actualización fuera de política.
La ausencia de divergencia en una simulación breve tampoco demuestra estabilidad general. Puede haber regiones iniciales problemáticas, escalas temporales largas o perturbaciones que no se probaron. Una conclusión empírica debe indicar qué escenarios y horizontes se evaluaron.
Por otro lado, una garantía matemática puede referirse a un límite asintótico y no describir los costos de aprendizaje durante un horizonte práctico. El análisis útil combina condiciones teóricas, ejemplos verificables y medidas de desempeño durante la adquisición, porque cada nivel responde a una pregunta distinta.
259.9. Evaluar plasticidad con escenarios separados
Un protocolo debe distinguir estabilidad en un entorno fijo, seguimiento de cambios y retención de conocimientos anteriores. Mezclar estas tareas en una única cifra dificulta interpretar ventajas. Una tasa puede destacar en seguimiento y perder precisión estacionaria, o conservar tareas antiguas a costa de aprender lentamente una nueva.
Podemos comenzar con un objetivo constante y ruido independiente. Registramos sesgo, varianza y sensibilidad a la inicialización. Después introducimos un cambio abrupto conocido y medimos el retraso de adaptación. Finalmente usamos una variable latente móvil con parámetros declarados para evaluar el error de seguimiento.
El agente no debe recibir el momento verdadero del cambio salvo que esa información forme parte de la tarea. El investigador puede usarlo para evaluar retrasos. Entregarlo accidentalmente al mecanismo de tasa adaptativa convertiría una detección difícil en una instrucción explícita.
Las observaciones atípicas requieren una condición separada. Una perturbación aislada y un cambio permanente pueden producir el mismo primer error grande. Un procedimiento debe decidir con evidencia posterior o con supuestos adicionales. Evaluarlo solo en rupturas permanentes favorece reglas que reaccionan intensamente a cualquier sorpresa.
Para estudiar interferencia, alternamos tareas con y sin señales de contexto. Así podemos distinguir límites de tasa y límites de representación. Si ninguna configuración escalar resuelve objetivos incompatibles, buscar indefinidamente una tasa mejor no solucionará el problema.
Las métricas deben incluir la trayectoria de tasas cuando son adaptativas. Una mejora final puede ocultar episodios de inestabilidad compensados después. También conviene registrar la magnitud de parámetros, gradientes y errores para localizar si una explosión procede de datos, escalas o retroalimentación.
La comparación usa escenarios reservados para evaluación. Ajustar límites y tasas de metaprendizaje sobre el mismo conjunto donde se informa el desempeño puede sobreestimar la generalización. La variación entre realizaciones debe acompañar los resultados cuando existe aleatoriedad.
Las comprobaciones analíticas del capítulo (multiplicadores del caso determinista, varianza con ruido, error de seguimiento, ciclo de interferencia y raíces con demora) son referencias para estas pruebas. Reproducirlas permite verificar componentes antes de combinarlos. Una vez resueltos los riesgos concretos, las pruebas deben concentrarse en la pregunta científica.
259.10. La flexibilidad depende de qué se conserva
La plasticidad regula cómo cambia un agente con experiencia, pero su utilidad depende del entorno y de la representación. Aprender rápido puede ser apropiado ante una transformación persistente y perjudicial ante ruido. Conservar conocimiento puede estabilizar predicciones o impedir reconocer que las condiciones cambiaron.
Los ejemplos mostraron que una tasa tiene significado dentro de una ecuación. El intervalo estable cambió al introducir curvatura y demora. El ruido dejó variabilidad residual. Un objetivo móvil produjo una tasa intermedia favorable. Parámetros compartidos generaron interferencia que no podía resolverse únicamente reduciendo la velocidad.
La adaptación de tasas puede usar información sobre regularidades del aprendizaje, aunque añade su propia dinámica y sus propios supuestos. No sustituye una representación adecuada ni corrige un objetivo mal definido. Su evaluación debe incluir costos, estabilidad y transferencia a escenarios nuevos.
También debemos evitar interpretar parámetros computacionales como rasgos psicológicos directos. Una tasa ajustada puede resumir volatilidad percibida, ruido, memoria, contexto omitido o características del procedimiento de elección. Identificar su significado requiere comparar modelos y diseñar condiciones donde esas explicaciones diverjan.
Una descripción rigurosa declara qué se actualiza, con qué señal, en qué momento y bajo qué límites. Añade el objetivo de estabilidad y las condiciones donde se comprobó. Esa información permite discutir por qué un agente persiste, oscila, olvida o se adapta sin convertir esas conductas en etiquetas generales.
El caso final del módulo reunirá varios de estos componentes para estudiar aprendizaje y persistencia de una conducta. Compararemos mecanismos que producen elecciones semejantes durante la adquisición y responden de manera diferente a cambios posteriores. La finalidad será mostrar cómo una explicación se fortalece al contrastar alternativas calculables.
La estabilidad útil, distinta de la inmovilidad, consiste en conservar las relaciones pertinentes mientras se incorporan los cambios que la evidencia justifica. Definir qué es pertinente y qué evidencia existe sigue siendo parte del problema científico.
Referencias
[1] Robbins, H., y Monro, S. (1951). A stochastic approximation method. The Annals of Mathematical Statistics, 22(3), 400–407. DOI.
[2] Sutton, R. S. (1992). Adapting bias by gradient descent: An incremental version of Delta-Bar-Delta. Proceedings of the Tenth National Conference on Artificial Intelligence, 171–176. Texto original.
[3] Tsitsiklis, J. N., y Van Roy, B. (1997). An analysis of temporal-difference learning with function approximation. IEEE Transactions on Automatic Control, 42(5), 674–690. DOI.
[4] Kalman, R. E. (1960). A new approach to linear filtering and prediction problems. Journal of Basic Engineering, 82(1), 35–45. DOI.