Módulo 26. Agentes adaptativos y aprendizaje
260.1. Una misma persistencia puede tener causas diferentes
Un agente continúa eligiendo una opción después de que dejó de producir un resultado favorable. Podemos describir la conducta como persistente, pero esa descripción no identifica su mecanismo. Quizá el agente todavía espera el beneficio anterior. Quizá conoce el cambio y, aun así, una tendencia a repetir la última elección domina temporalmente su decisión.
Este caso compara esas dos posibilidades mediante modelos completamente especificados. El primero actualiza lentamente el valor de la acción a partir de resultados experimentados. El segundo usa correctamente los resultados actuales, pero añade una bonificación transitoria a repetir la acción anterior. Construiremos condiciones donde ambos produzcan exactamente la misma secuencia observable.
La coincidencia es deliberada y muestra un problema de identificación. Que una conducta persista no permite decidir entre cualquier par de explicaciones; necesitamos información adicional o una intervención que haga divergir sus predicciones.
El ejemplo es un modelo didáctico; no está ajustado a personas ni es una explicación clínica. Las palabras aprendizaje e inercia designan operaciones numéricas. No equiparamos el primer mecanismo con una región cerebral ni el segundo con una categoría psicológica, porque esa correspondencia requeriría evidencia independiente.
Wilson y Collins recomiendan simular los modelos, comprobar su recuperación y evaluar si un diseño permite distinguirlos [1]. Akam y colaboradores mostraron, en una tarea diferente, que estrategias alternativas pueden producir patrones que invitan a interpretaciones computacionales demasiado rápidas [2]. Aquí usamos esas cautelas metodológicas para construir una comparación pequeña y original.
La pregunta que nos ocupa es qué observaciones bastan para separar los mecanismos en el experimento definido; cuál de ellos es verdadero en general queda fuera del caso.
El resultado final incluirá cálculos exactos, un programa reproducible y un barrido de nueve combinaciones. Todos los datos proceden de esas reglas y ejecuciones.
260.2. Entorno, adquisición y cambio
Hay dos acciones, A y B. Durante la adquisición, A entrega siempre una unidad y B entrega una cantidad beta, que en el escenario principal es 0,4. Cada resultado es determinista, no existe costo adicional y una acción no modifica la disponibilidad futura de la otra.
La preparación presenta ocho veces cada acción, alternando B y A, de modo que el último movimiento de adquisición es A. Las estimaciones de recompensa se calculan mediante medias muestrales y, como los resultados son constantes, al terminar valen exactamente uno para A y 0,4 para B. Así ambas opciones quedan experimentadas y los dos modelos parten de la misma última acción.
No usaremos esa preparación para inferir cómo se aprendió una regla de repetición; la intensidad inicial de la inercia se fija explícitamente como parámetro del modelo. La adquisición establece valores y antecedentes, pero no da cuenta del origen de todos los componentes que compararemos.
Después cambia únicamente A, que pasa a entregar cero; B conserva 0,4. Una pantalla anuncia de manera inequívoca las nuevas consecuencias antes de las decisiones libres. Ambos modelos reciben esa información, pero la procesan de manera diferente según sus reglas declaradas.
El modelo E, de actualización experiencial, no incorpora la instrucción a sus valores y solo los modifica cuando ejecuta una acción y observa su resultado. El modelo P, de persistencia en la elección, incorpora la pantalla y asigna valores actuales cero y 0,4. Esta diferencia en el uso de la información está declarada entre las hipótesis, de modo que P no tiene una ventaja oculta.
Los dos eligen de forma determinista la acción con mayor puntuación, resuelven los empates a favor de A y no exploran al azar. El horizonte de prueba tiene veinte decisiones libres. Con esos detalles fijos podemos comparar secuencias exactas sin variabilidad muestral.
La pantalla es una intervención informativa idealizada. En una tarea real habría que verificar que el anuncio se comprende y se cree. Si un participante no confía en él, conservar una expectativa anterior no demuestra una incapacidad de aprendizaje. Nuestro modelo elimina esa ambigüedad para localizar diferencias entre operaciones específicas.
260.3. Expectativa que cambia con la experiencia en el modelo E
El modelo E conserva valores y . En el escenario principal, la tasa alfa es 0,25. Las acciones no elegidas mantienen su estimación; después de ejecutar una acción, el modelo actualiza únicamente su valor mediante la regla delta
Al comenzar la prueba, E todavía tiene valor uno para A y 0,4 para B, porque el anuncio no modifica esos números por definición del mecanismo. Elige A, recibe cero y reduce su estimación a 0,75.
En la segunda decisión, 0,75 sigue superando 0,4, de modo que repite A y su valor baja a 0,5625. La tercera elección vuelve a ser A y deja valor 0,421875. Ese número todavía supera 0,4, por lo que la cuarta elección también es A.
Después de cuatro resultados nulos, el valor de A es 0,31640625. En la quinta decisión, B tiene mayor valor y el agente cambia. B entrega exactamente la recompensa que ya esperaba, así que su valor permanece en 0,4. A no vuelve a elegirse y conserva su estimación residual.
La persistencia dura cuatro decisiones libres y no requiere una preferencia explícita por repetir; el mecanismo sigue la mayor expectativa disponible y la revisa gradualmente. Que el entorno ya haya cambiado no significa que su representación interna haya incorporado toda la evidencia relevante.
Después de k elecciones de A con resultado cero, su valor es . El cambio ocurre cuando ese valor queda por debajo de beta, teniendo en cuenta el desempate a favor de A. Con esta expresión podemos calcular la duración sin simular.
El valor residual de A después del cambio es incorrecto, porque su recompensa verdadera es cero. Sin exploración, el agente deja de obtener datos sobre ella; sin embargo, ese error ya no cambia su decisión porque permanece por debajo de B. Una política correcta no exige estimaciones perfectas de todas las acciones.
El ejemplo distingue la adquisición de una conducta de la precisión global del conocimiento. El agente termina eligiendo la mejor acción disponible, pero no ha aprendido exactamente todas las consecuencias. Esa imprecisión puede tener efectos si el entorno vuelve a cambiar.
260.4. Valores correctos y bonificación por repetir en el modelo P
El modelo P usa los valores actuales indicados por la pantalla (cero para A y beta para B) y añade una bonificación a la acción ejecutada inmediatamente antes. Al iniciar la prueba, esa acción es A y la bonificación vale uno.
La puntuación con la que decide es
Después de cada acción, la bonificación se multiplica por . Usamos alfa como parámetro común de comparación, aunque en P controla el decaimiento de la inercia y en E el aprendizaje de la recompensa. La igualdad numérica no convierte ambos parámetros en la misma propiedad psicológica.
En la primera decisión, A recibe puntuación uno y B puntuación 0,4, así que P elige A aunque sabe que entrega cero. Después, la bonificación baja a 0,75. Mientras sigue eligiendo A, sus puntuaciones sucesivas son 0,75; 0,5625 y 0,421875.
Tras cuatro acciones, la bonificación queda en 0,31640625. B supera entonces a A y se elige en la quinta decisión. Desde ese momento, B recibe además la bonificación por ser la última acción. La repetición favorece la opción que ya tiene mayor recompensa y no produce un regreso a A.
La secuencia observable coincide exactamente con la del modelo E, cuatro A seguidas de dieciséis B. Las expectativas, en cambio, difieren desde el comienzo, porque E espera inicialmente uno de A y P espera cero. La persistencia aparece en componentes diferentes del proceso.
No afirmamos que una bonificación exponencial describa toda inercia conductual. Es una hipótesis mínima para estudiar la identificación, con intensidad y decaimiento especificados antes de comparar resultados.
La bonificación recae en la acción anterior, sea cual sea; si se ejecuta B, el sesgo cambia de destinatario. Esta propiedad será decisiva en la intervención. Una preferencia fija por A produciría otra respuesta y sería un tercer modelo.
La distinción entre valor y puntuación evita interpretar toda elección como expresión directa de una expectativa de recompensa. La política puede combinar expectativas con memoria de acciones, costos, restricciones u otros términos. Identificar esos componentes requiere observaciones que no sean redundantes con la elección final.
260.5. Coincidencia en la condición de referencia
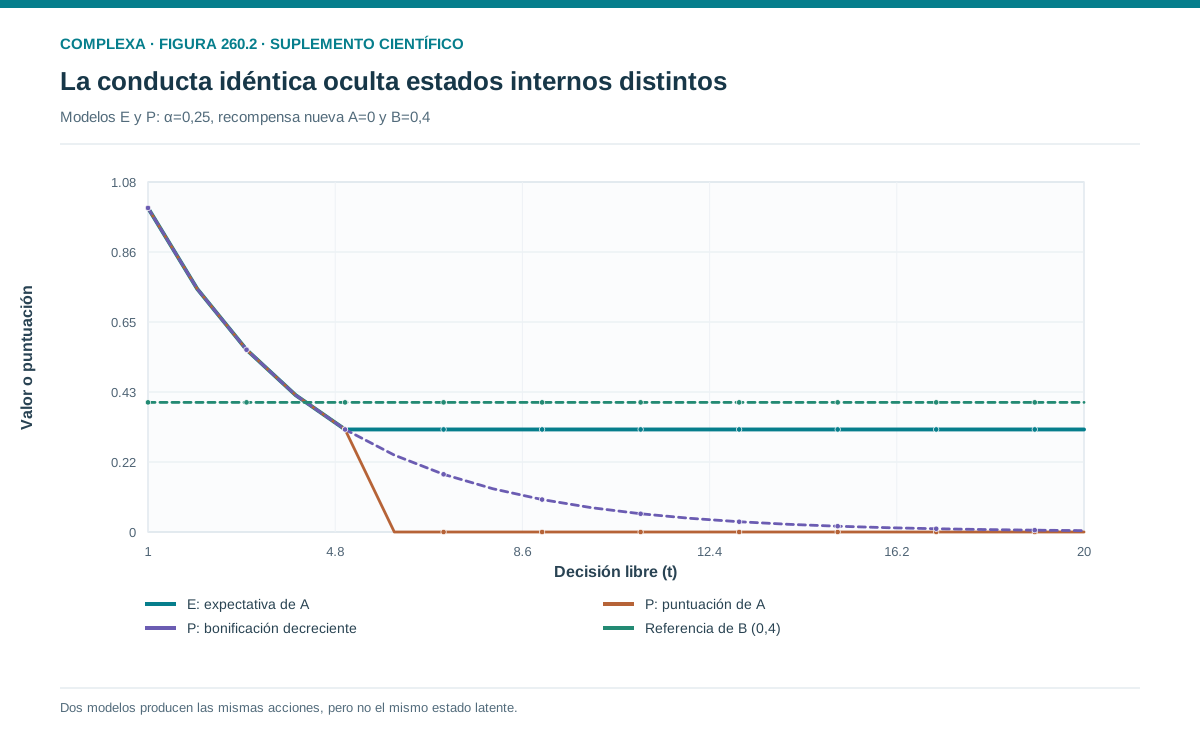
En las veinte decisiones libres posteriores al cambio, ambos modelos eligen A cuatro veces y B dieciséis, con la primera elección de B en la quinta decisión. Como A entrega cero y B 0,4, la recompensa total es 6,4. Un agente que eligiera B desde el comienzo obtendría ocho, de modo que la pérdida respecto de ese referente es 1,6.
El número de elecciones de A, el momento del cambio y la recompensa total serían indistinguibles si solo observáramos acciones y resultados. Los modelos difieren en el valor inicial que atribuyen a A tras el anuncio (uno en E, cero en P), que es una variable interna. En un simulador podemos leerla; en un estudio empírico necesitaríamos una medida que se relacione con ella de manera justificada.
La equivalencia abarca la secuencia completa, elección por elección. Durante la repetición inicial de A, la puntuación que guía a E es su valor decreciente y la que guía a P es la bonificación decreciente; ambas siguen la misma potencia de tres cuartos.
Una curva de adaptación agregada tampoco separaría los mecanismos, porque en ambos casos mostraría un cambio después de cuatro experiencias desfavorables. Describir a ambos como aprendices lentos atribuiría a P un error de expectativa que no tiene.
Podemos imaginar una pregunta explícita sobre la recompensa esperada antes de actuar. Con una lectura directa y fiel de los valores, E respondería uno y P cero. Esa medida separaría los modelos, pero necesita un modelo de respuesta, porque las personas pueden interpretar la pregunta de otra manera o informar con imprecisión.
Por eso construiremos además una intervención conductual, destinada a cambiar un antecedente que afecta la bonificación de P sin modificar el valor de A en E. Si ambos mecanismos están especificados correctamente, deberían reaccionar de manera diferente.
La condición de referencia muestra que datos completos dentro de una condición pueden ser insuficientes para distinguir ciertas hipótesis. De ahí no se sigue que todos los modelos de aprendizaje e inercia sean indistinguibles ni que ninguna cantidad de datos pueda separarlos.
260.6. Una acción forzada que separa los mecanismos
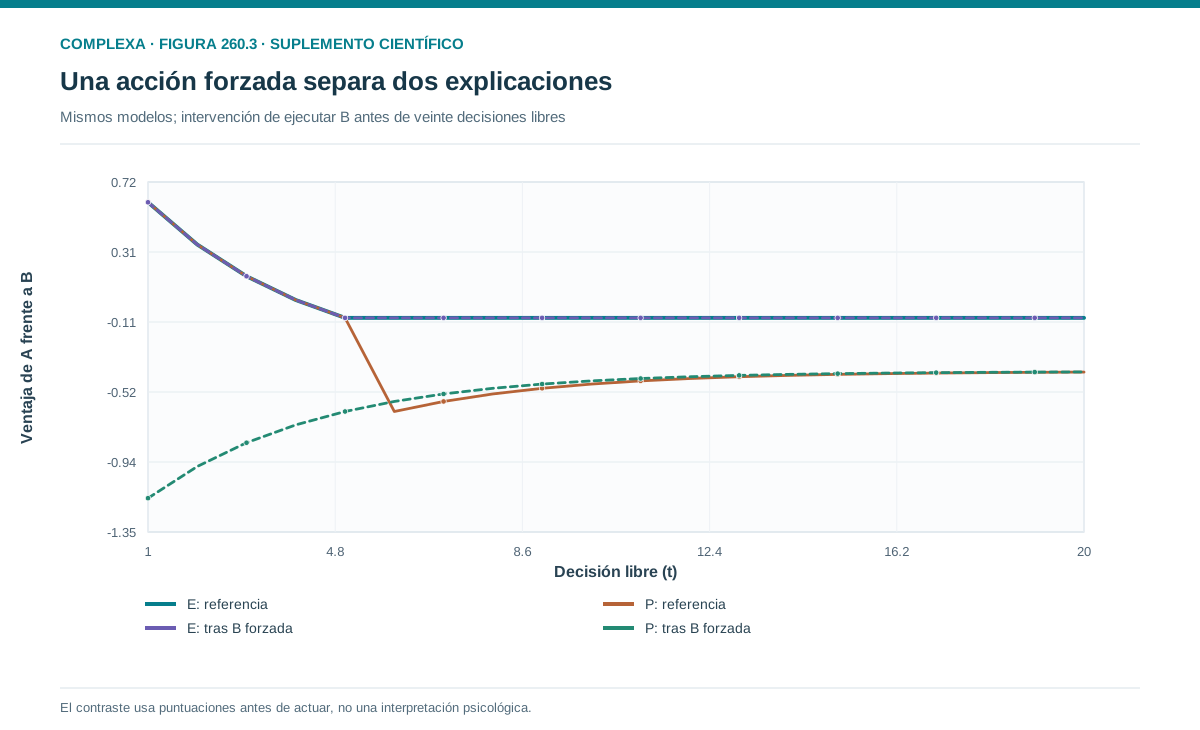
Antes de las veinte decisiones libres imponemos una única ejecución de B, que produce su recompensa habitual y establece B como acción anterior. La recompensa de esa acción forzada se registra conceptualmente aparte y no entra en el total de las veinte decisiones comparadas.
Para E, observar otra recompensa de 0,4 en B no cambia su valor, que ya era 0,4. A conserva valor uno porque no se ejecutó ni se actualizó. Por tanto, al comenzar la fase libre vuelve a elegir A cuatro veces y luego cambia a B, igual que en la referencia.
Para P, la acción forzada cambia el destinatario de la bonificación. Su intensidad se reduce a 0,75 después de esa acción y ahora se suma a B. A tiene puntuación cero; B tiene 1,15. Desde la primera decisión libre elige B y continúa haciéndolo.
E produce cuatro elecciones libres de A y una recompensa de 6,4, mientras que P no elige A en la fase libre y obtiene ocho. La intervención modifica un componente relevante para uno de los mecanismos y deja intacto el que sostiene al otro.
La comparación no iguala el número total de acciones entre referencia e intervención, porque la segunda añade una acción forzada; ambas contienen veinte decisiones libres después de su preparación. Por eso la conclusión se limita a la secuencia libre posterior y deja fuera cualquier comparación de eficiencia global con presupuestos idénticos.
Si quisiéramos comparar costos totales, deberíamos incluir la acción forzada, su tiempo y cualquier consecuencia adicional. En este modelo su recompensa es 0,4, pero en una tarea real podría tener otros costos. No convertimos la intervención didáctica en una recomendación práctica fuera de sus supuestos.
También hay que distinguir entre la acción forzada y la mera observación de B. Como nuestro mecanismo de inercia usa la acción ejecutada, mostrar un resultado ajeno sin cambiar la última acción no tendría el mismo efecto. Esta diferencia da otra predicción comprobable.
Una intervención en apariencia parecida puede ser poco informativa. Si imponemos A en lugar de B y entregamos su resultado cero, E reduce su valor de A a 0,75, mientras que P mantiene A como acción anterior y reduce la bonificación a 0,75. Los dos comenzarían la fase libre con la misma puntuación relevante y producirían tres elecciones adicionales de A. La utilidad de una intervención depende de la variable sobre la que actúa y de si rompe realmente la equivalencia.
Una pausa sin acciones tampoco separaría necesariamente estos modelos. Como la bonificación de P decae con cada acción ejecutada, con independencia del tiempo de reloj, y E no actualiza sin resultados, una demora vacía dejaría ambos mecanismos intactos. Si quisiéramos proponer que la inercia se disipa durante la espera, tendríamos que modificar explícitamente su regla y obtener nuevas predicciones. El nombre del mecanismo no autoriza a añadirle propiedades que no estaban especificadas.
La intervención indica cuál de los dos modelos definidos es compatible con cada respuesta ideal, aunque no excluye un tercer mecanismo capaz de producir el mismo patrón. La comparación científica siempre está limitada por el conjunto de alternativas consideradas y por la calidad con que se implementa la intervención.
260.7. Comprobar que el resultado no depende de un solo número
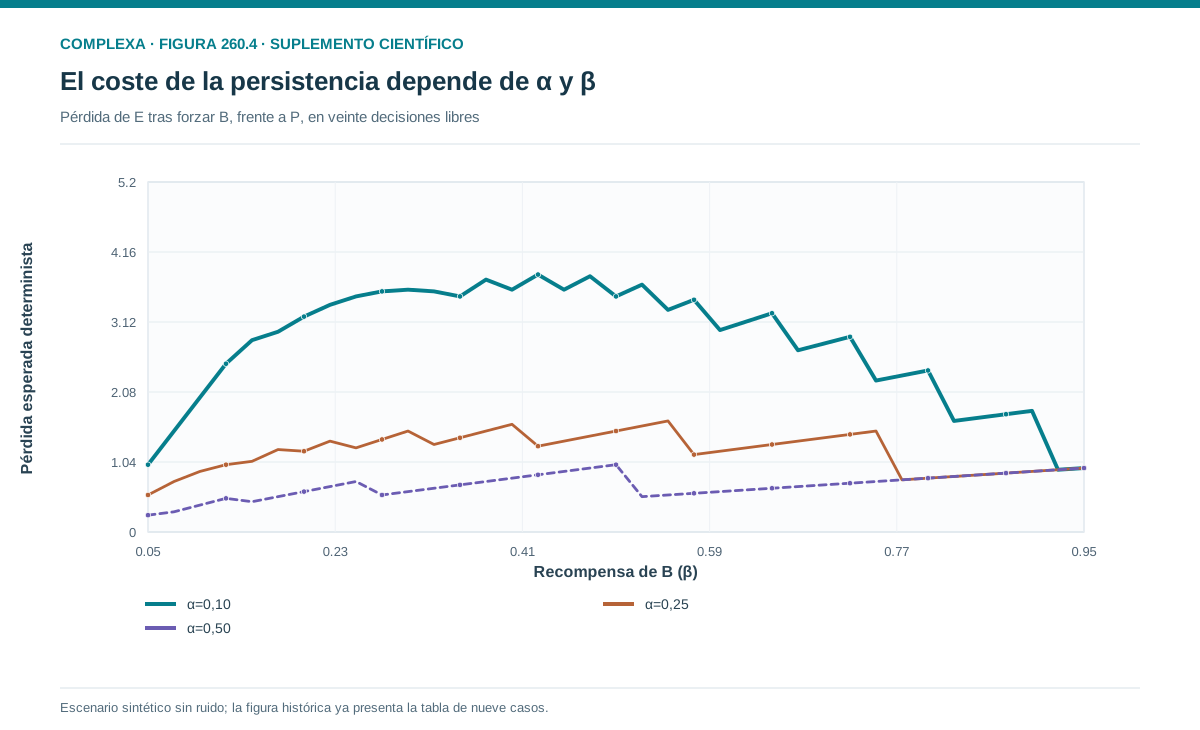
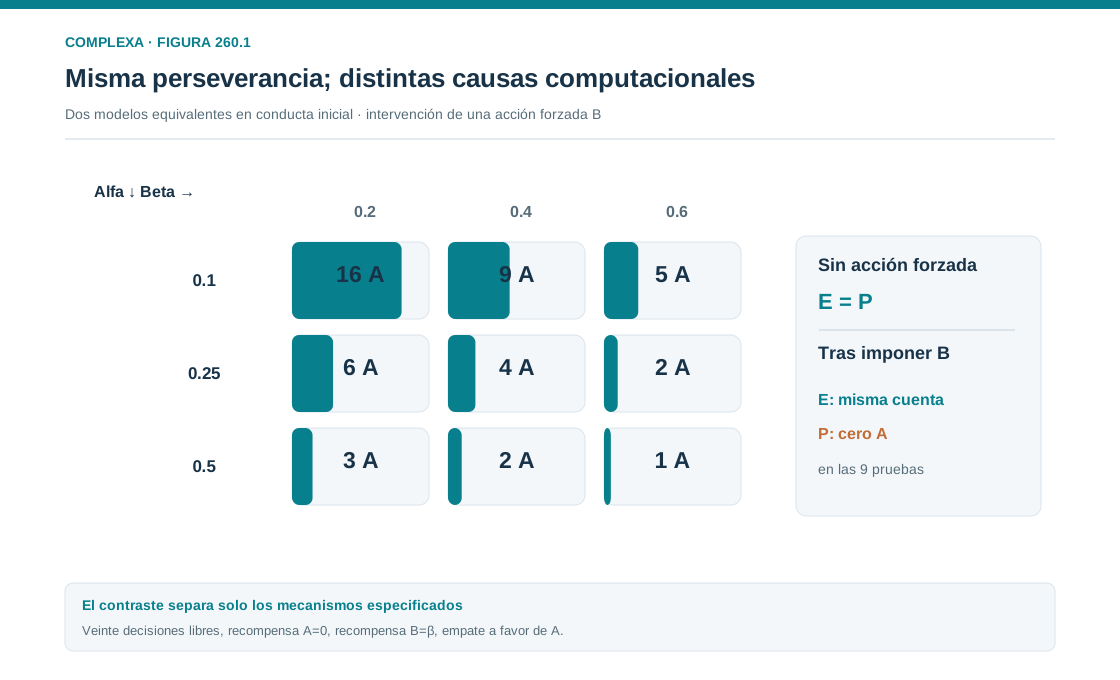
Repetimos el experimento con tres tasas alfa (0,1; 0,25 y 0,5) y tres recompensas beta (0,2; 0,4 y 0,6), sin cambiar las demás reglas. En cada combinación, la bonificación inicial de P es uno y su decaimiento coincide con uno menos alfa.
| Alfa | Beta | A en referencia, E y P | A tras B forzada, E | A tras B forzada, P |
|---|---|---|---|---|
| 0,1 | 0,2 | 16 | 16 | 0 |
| 0,1 | 0,4 | 9 | 9 | 0 |
| 0,1 | 0,6 | 5 | 5 | 0 |
| 0,25 | 0,2 | 6 | 6 | 0 |
| 0,25 | 0,4 | 4 | 4 | 0 |
| 0,25 | 0,6 | 2 | 2 | 0 |
| 0,5 | 0,2 | 3 | 3 | 0 |
| 0,5 | 0,4 | 2 | 2 | 0 |
| 0,5 | 0,6 | 1 | 1 | 0 |
El programa ejecutó las nueve combinaciones y verificó la igualdad de las secuencias completas en la referencia. La tabla es un barrido de condiciones especificadas para examinar una equivalencia construida analíticamente; ningún parámetro se ajustó después a datos empíricos.
Una tasa mayor reduce la persistencia de E porque corrige antes su expectativa. En P la reduce porque la bonificación decae antes. La misma relación entre tasa y conducta admite interpretaciones distintas; ajustar únicamente el número de repeticiones no identifica cuál corresponde.
Una recompensa beta mayor hace más atractiva B y permite que supere antes la puntuación decreciente de A. Como este efecto aparece en ambos modelos, dentro de este diseño tampoco bastaría separar las curvas según la recompensa alternativa para identificar el mecanismo.
La acción forzada sigue distinguiéndolos en todas las combinaciones examinadas. E conserva el número de A de referencia; P elige B desde el comienzo de la fase libre. La robustez observada solo está comprobada para esta familia de parámetros y estas reglas.
El horizonte de veinte decisiones basta para observar el cambio en todas las filas. Si la tasa fuera mucho menor o beta más pequeña, un agente podría no cambiar dentro del horizonte. En ese caso, contar veinte repeticiones no revelaría la duración total prevista, porque la observación quedaría censurada por el final de la prueba.
La igualdad del barrido es deliberada, porque fijamos el decaimiento de P en uno menos la tasa de E. Si estimáramos ambos parámetros por separado, podríamos encontrar pares que generan la misma conducta de referencia. No afirmamos que cualquier intensidad de inercia coincida con cualquier tasa de aprendizaje. La construcción demuestra la existencia de una familia de equivalencias y, por tanto, una limitación del diseño para distinguir esas familias.
Modificar libremente un parámetro de un modelo mientras mantenemos fijo el del otro podría romper la coincidencia, pero eso solo no resolvería la inferencia. Ante datos desconocidos, cada hipótesis puede ajustar su propio parámetro dentro de un rango justificado. La comparación debe evaluar si existen combinaciones alternativas compatibles con los datos, algo más exigente que comprobar que dos configuraciones arbitrarias producen curvas distintas.
Como la regla elige A cuando las puntuaciones son iguales, la condición de cambio es estricta. Una fórmula que redondea logaritmos sin revisar la igualdad puede equivocarse en una decisión. El programa compara puntuaciones directamente y el análisis conserva la convención.
Por ejemplo, con alfa 0,5 y beta 0,5, después de una elección desfavorable de A su puntuación queda exactamente en 0,5. El empate todavía favorece A, así que vuelve a elegirse; después su puntuación baja a 0,25 y solo entonces cambia a B. La persistencia es de dos elecciones, aunque el redondeo hacia arriba de un cociente de logaritmos daría una. Este caso de frontera es una prueba específica del desempate y muestra que esa expresión necesita una corrección cuando hay igualdad exacta.
260.8. Programa reproducible y controles
El siguiente programa usa únicamente la biblioteca estándar de Python e imprime las trayectorias del escenario principal y la tabla del barrido. Cada fila de trayectoria guarda valores previos, última acción, bonificación, puntuaciones, elección y recompensa, información que permite reconstruir el mecanismo además de contar resultados.
import json

def acquisition(beta):
    q = {"A": 0.0, "B": 0.0}
    visits = {"A": 0, "B": 0}
    for _ in range(8):
        for action in ("B", "A"):
            reward = 1.0 if action == "A" else beta
            visits[action] += 1
            q[action] += (reward - q[action]) / visits[action]
    return q

def run(model, alpha=0.25, beta=0.4, horizon=20, forced_b=False):
    q = acquisition(beta)
    reward = {"A": 0.0, "B": beta}
    last, bias = "A", 1.0
    if model == "P":
        q = dict(reward)
    if forced_b:
        if model == "E":
            q["B"] += alpha * (reward["B"] - q["B"])
        last = "B"
        bias *= 1.0 - alpha
    trace = []
    for t in range(1, horizon + 1):
        scores = dict(q)
        if model == "P":
            scores[last] += bias
        action = "A" if scores["A"] >= scores["B"] else "B"
        trace.append({
            "t": t, "q_A": q["A"], "q_B": q["B"],
            "last": last, "bias": bias if model == "P" else None,
            "score_A": scores["A"], "score_B": scores["B"],
            "action": action, "reward": reward[action]
        })
        if model == "E":
            q[action] += alpha * (reward[action] - q[action])
        last = action
        bias *= 1.0 - alpha
    return {
        "model": model, "alpha": alpha, "beta": beta,
        "forced_b": forced_b, "free_decisions": horizon,
        "A_choices": sum(row["action"] == "A" for row in trace),
        "free_reward": sum(row["reward"] for row in trace),
        "trace": trace
    }

def experiment():
    main = [
        run(model, forced_b=forced)
        for forced in (False, True)
        for model in ("E", "P")
    ]
    grid = []
    for alpha in (0.1, 0.25, 0.5):
        for beta in (0.2, 0.4, 0.6):
            e = run("E", alpha, beta)
            p = run("P", alpha, beta)
            ef = run("E", alpha, beta, forced_b=True)
            pf = run("P", alpha, beta, forced_b=True)
            assert [x["action"] for x in e["trace"]] == [
                x["action"] for x in p["trace"]
            ]
            grid.append({
                "alpha": alpha, "beta": beta,
                "baseline_A_E": e["A_choices"],
                "baseline_A_P": p["A_choices"],
                "forced_B_then_A_E": ef["A_choices"],
                "forced_B_then_A_P": pf["A_choices"]
            })
    return {"main": main, "grid": grid}

if __name__ == "__main__":
    print(json.dumps(experiment(), ensure_ascii=False, indent=2))
La función de adquisición usa medias muestrales y termina en A. Durante la prueba, E pasa a una tasa constante declarada para estudiar el seguimiento tras el cambio. Este cambio de regla forma parte del protocolo declarado.
P incorpora la información de recompensa actual antes de decidir, mientras que E conserva las estimaciones de adquisición. El código refleja así una diferencia en el procesamiento de la misma información anunciada y no interpreta el acceso a valores verdaderos como una capacidad adquirida espontáneamente.
La acción forzada se aplica antes del bucle de decisiones libres. En E actualiza B, cuyo error es cero; en P cambia la última acción y reduce la bonificación. El contador de elecciones de A se calcula únicamente sobre las veinte filas posteriores, para no mezclar preparación e intervención con la medida principal.
La prueba de igualdad compara secuencias completas en cada combinación. También comprobamos los valores de las primeras actualizaciones contra las potencias de uno menos alfa. La condición principal reproduce cuatro elecciones de A seguidas de dieciséis B y los totales de recompensa indicados.
El experimento es determinista. Ejecutarlo de nuevo no requiere semilla y debe producir las mismas decisiones, salvo que cambien el código o las convenciones numéricas. Las comparaciones de sumas decimales usan tolerancias por posibles diferencias de representación. Los contadores de acciones, en cambio, son enteros y deben coincidir exactamente con las predicciones de cada condición.
Una implementación independiente puede calcular directamente el primer entero k para el que la potencia queda por debajo de beta y construir la secuencia esperada. Esa comparación separa la lógica del simulador de la fórmula analítica. Que ambas coincidan da más evidencia que ejecutar dos veces el mismo programa.
El código no estima parámetros ni calcula significación estadística porque no hay datos empíricos ni variabilidad aleatoria. La verificación pertinente es comprobar que las reglas declaradas producen las trayectorias y que la intervención modifica los componentes previstos.
260.9. Qué permite concluir la comparación
El caso muestra que una persistencia observable no equivale a una expectativa persistente. E mantiene una expectativa antigua; P mantiene una tendencia a repetir pese a una expectativa actualizada. Ambos producen las mismas acciones en la referencia y divergen después de una intervención sobre la acción anterior.
Esta conclusión es interna al modelo. Para estudiar un sistema real habría que justificar que la información se comprende, que la acción forzada modifica el antecedente pertinente y que no introduce otros efectos. Una instrucción podría cambiar la motivación, la atención o la confianza además de la última acción. Esos mecanismos ampliarían el conjunto de hipótesis.
También necesitaríamos representar la variabilidad de elección. Con una política probabilística, las secuencias no coincidirían necesariamente de forma exacta. Podrían seguir siendo difíciles de distinguir estadísticamente, pero la identificación requeriría analizar distribuciones, tamaños de muestra y recuperación de modelos.
La recuperación consiste en generar datos con cada hipótesis y comprobar si el procedimiento de ajuste logra identificarla con el diseño previsto. Si clasifica mal con frecuencia datos cuyo origen conocemos, una clasificación contundente de datos reales sería poco defendible. La simulación permite evaluar esa limitación antes de interpretar datos de participantes.
Una estimación precisa de un parámetro tampoco resuelve una equivalencia entre modelos. Podemos conocer con gran precisión la velocidad de decaimiento de la puntuación de A y seguir sin saber si corresponde a expectativa o a inercia. La incertidumbre dentro de un modelo y la incertidumbre entre mecanismos son cosas distintas.
El ejemplo muestra además una limitación de las explicaciones verbales. Decir que un agente continúa porque aprendió fuertemente puede describir tanto un valor elevado como una regla de repetición o una representación contextual. Escribir las operaciones permite descubrir qué diferencias ocultaba la misma frase.
Otra cuestión pendiente es qué significa la identidad de una acción. En el programa, A y B son etiquetas abstractas; en un experimento podrían corresponder a botones, movimientos o resultados elegidos. Si intercambiamos la posición física de los botones manteniendo las etiquetas, una inercia motora y una inercia que recae en la opción pueden divergir. Nuestro modelo P solo representa la segunda si definimos sus etiquetas de ese modo. Declarar esa correspondencia evita interpretar como un único mecanismo procesos que operan sobre representaciones distintas. Una prueba adicional de remapeo podría ampliar la comparación, pero necesitaría nuevas reglas y no se ejecutó en este caso.
La intervención se eligió porque afecta de manera distinta a las variables internas. Ese principio, buscar antes de recoger datos condiciones en las que las hipótesis predigan cambios diferentes, puede orientar nuevos diseños. No garantiza una identificación universal, pero da contenido a la comparación.
Si un resultado empírico no coincide con ninguno de los dos modelos, lo adecuado sería revisar el conjunto de mecanismos, la representación o el protocolo. No conviene ajustar retrospectivamente cada regla hasta que todas puedan explicar cualquier trayectoria. La capacidad de equivocarse de manera identificable es parte del valor de una hipótesis.
260.10. Un cierre operativo del módulo
El módulo comenzó preguntando qué se adapta y terminó comparando dos cambios internos que producen la misma conducta. Entre ambos extremos distinguimos información, recompensa, valor, política, modelo, exploración, crédito temporal, memoria y tasa de aprendizaje. El caso muestra por qué esas distinciones son necesarias para explicar la persistencia.
Una secuencia de elecciones no revela directamente todos sus componentes. El mismo patrón puede surgir de una expectativa desactualizada, una política con inercia, una creencia sobre un estado oculto o una restricción de información. La explicación mejora cuando cada posibilidad se traduce en reglas y predicciones contrastables.
Aquí la referencia no separó los mecanismos, aunque contenía toda la secuencia de acciones y recompensas. La acción forzada sí los separó, porque modificó el antecedente que sostenía la bonificación de P y dejó intacta la expectativa de A en E. El valor informativo de una intervención depende de esa relación con las hipótesis.
La ejecución y el cálculo analítico coincidieron en el escenario principal y en nueve combinaciones de parámetros. Esa verificación confirma el comportamiento del ejemplo implementado, pero, sin otra evidencia, no convierte sus mecanismos en una teoría general de hábitos, aprendizaje humano o adaptación biológica.
Los próximos capítulos cambiarán de escala y estudiarán evolución, variación y restricciones. Allí también habrá que distinguir entre la modificación dentro de los individuos y los cambios en la composición de las poblaciones. Una mejora agregada puede proceder de procesos diferentes, del mismo modo que una conducta persistente puede sostenerse mediante variables distintas.
La continuidad metodológica consiste en especificar estados, reglas, información y criterios; calcular consecuencias; comparar mecanismos y diseñar observaciones que puedan separarlos. La complejidad exige conservar la precisión mientras aumentan los componentes y las escalas que interactúan.
Este caso deja una pregunta reutilizable. Si dos explicaciones producen el mismo resultado, ¿qué cambio controlado haría que dejaran de coincidir? Formularla antes de interpretar datos convierte una narración plausible en un programa de investigación que puede revisarse.
Referencias
[1] Wilson, R. C., y Collins, A. G. E. (2019). Ten simple rules for the computational modeling of behavioral data. eLife, 8, e49547. DOI.
[2] Akam, T., Costa, R., y Dayan, P. (2015). Simple plans or sophisticated habits? State, transition and learning interactions in the two-step task. PLOS Computational Biology, 11(12), e1004648. DOI.
[3] Sutton, R. S., y Barto, A. G. (2018). Reinforcement Learning: An Introduction, 2.ª edición. MIT Press. Página de los autores.